
Figure 1 From Transformer Based Knowledge Distillation For Efficient

Figure 1 from Knowledge Distillation for Detection Transformer with ...

Figure 1 from Vision Transformer Based on Knowledge Distillation in TCM ...
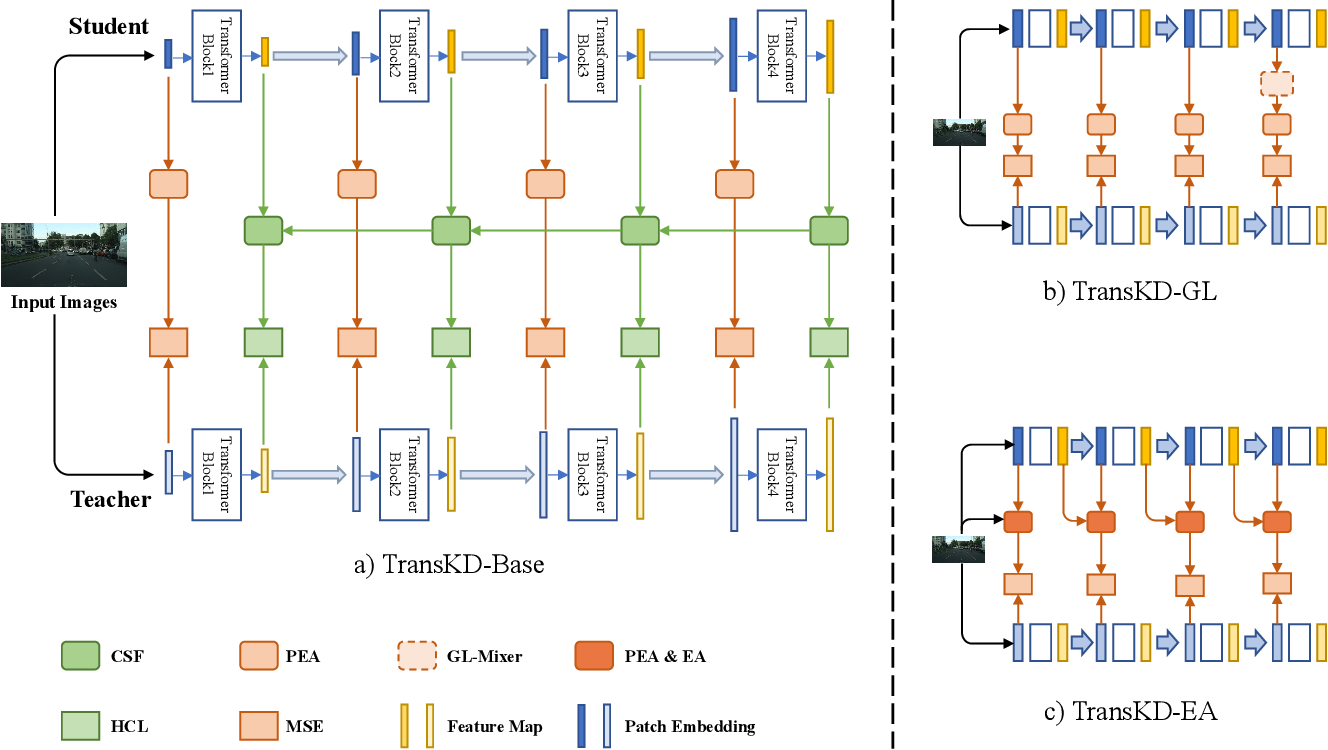
Figure 3 from TransKD: Transformer Knowledge Distillation for Efficient ...

Figure 1 from Multi-view knowledge distillation transformer for human ...
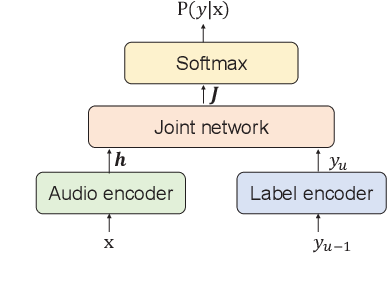
Figure 1 from Knowledge Distillation for Streaming Transformer ...

Figure 1 from Knowledge Distillation via the Target-aware Transformer ...

Figure 1 from The Role of Masking for Efficient Supervised Knowledge ...

Figure 1 from A Transformer-Based Knowledge Distillation Network for ...

Figure 1 from A Distributed Knowledge Distillation Framework for ...

Figure 1 from Knowledge Distillation from BERT Transformer to Speech ...
Advertisement Space (300x250)

Figure 1 from Federated Knowledge Distillation With 3D Transformer ...

Figure 1 from Adversarial Distillation for Efficient Recommendation ...

Figure 1 from Knowledge distillation- based lightweight network for ...
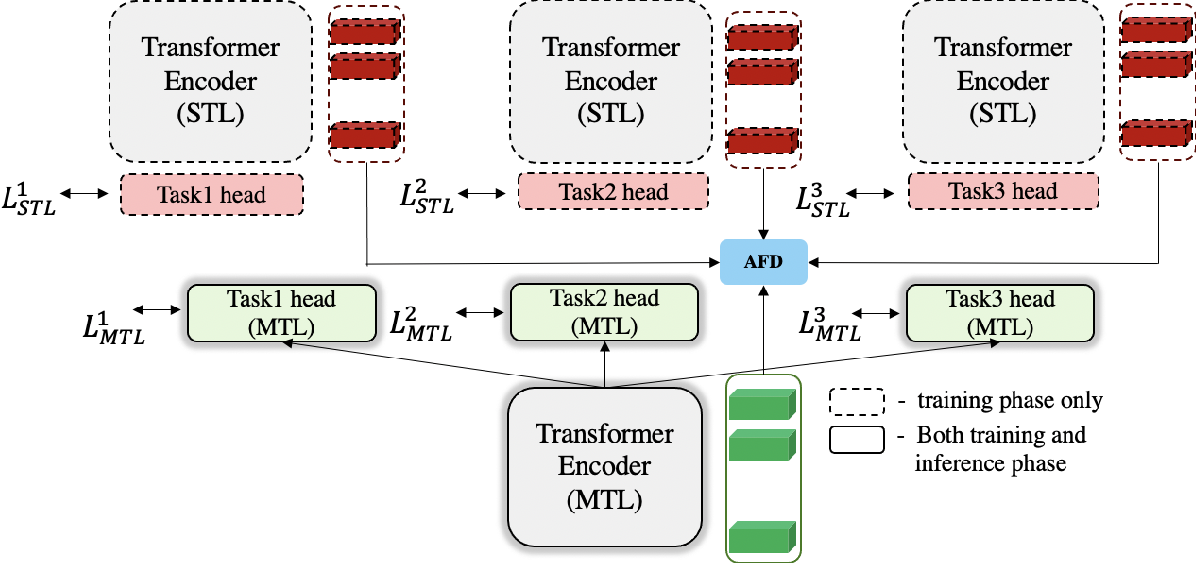
Figure 1 from Online Knowledge Distillation for Multi-task Learning ...
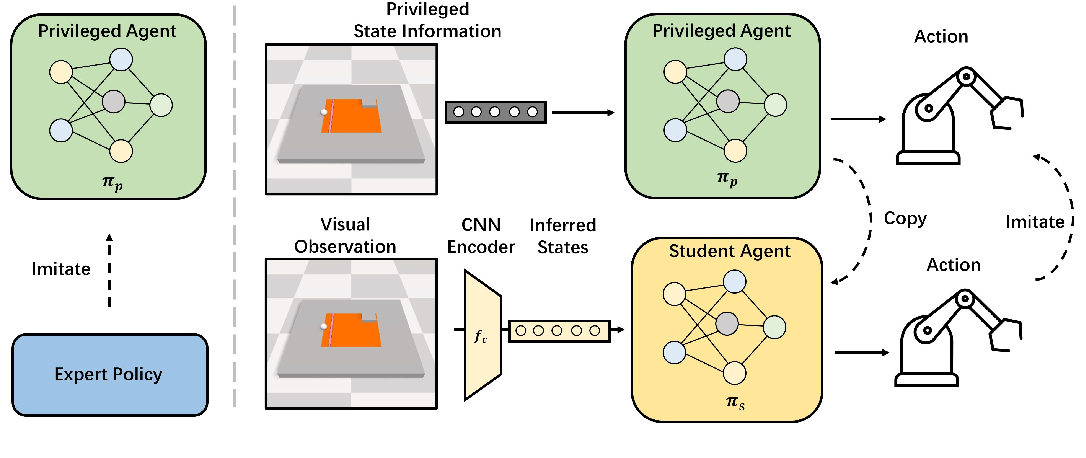
Figure 1 from TraKDis: A Transformer-Based Knowledge Distillation ...

Paper page - TransKD: Transformer Knowledge Distillation for Efficient ...

Figure 1 from Multi-Branch Mutual-Distillation Transformer for EEG ...

Figure 1 from Knowledge Distillation of Transformer-based Language ...
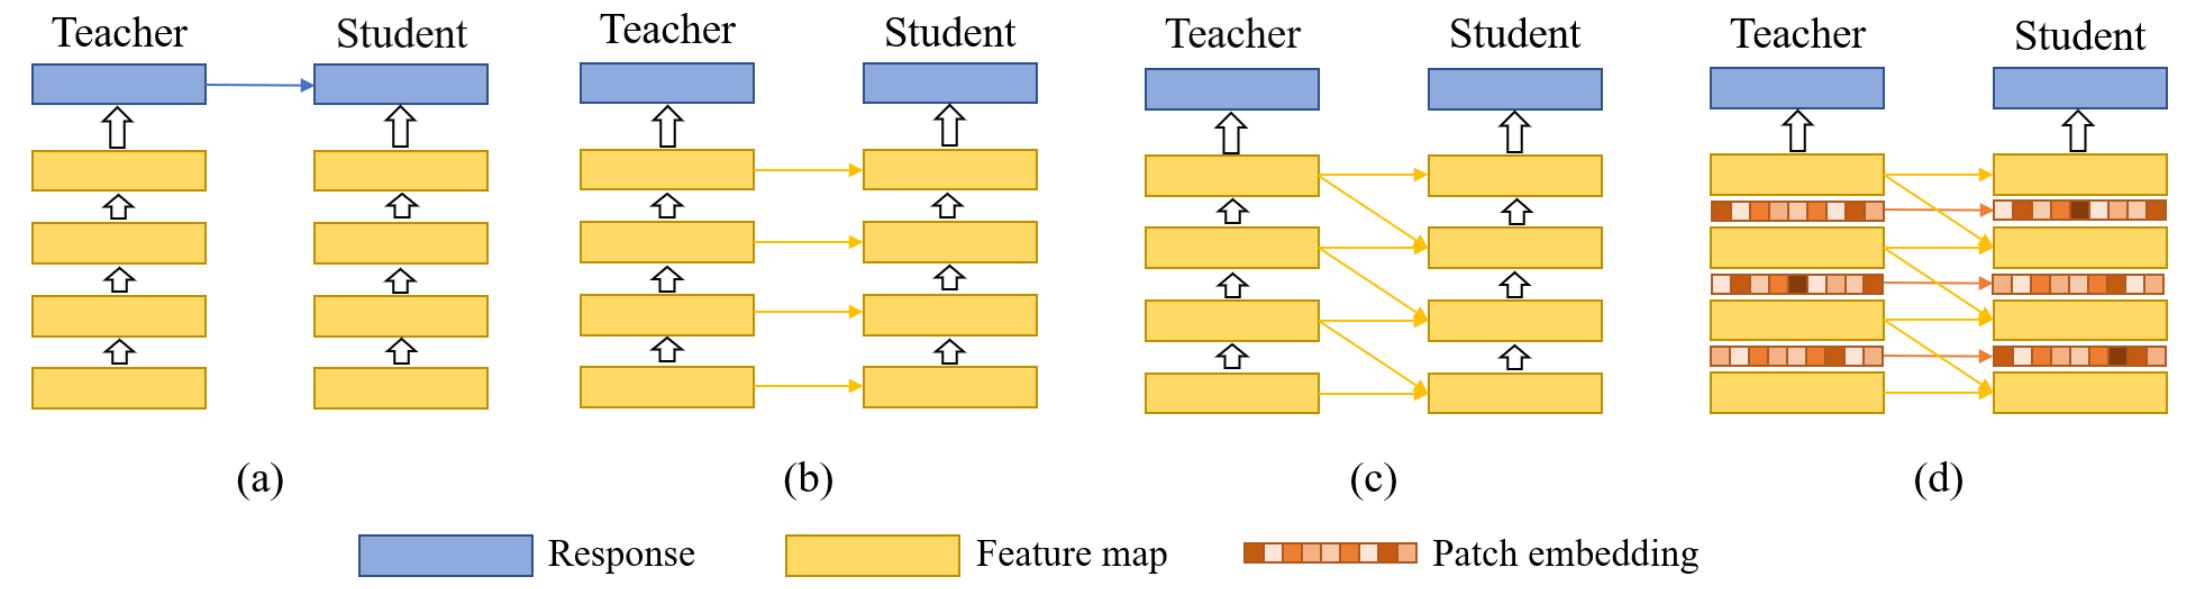
(PDF) TransKD: Transformer Knowledge Distillation for Efficient ...

Figure 1 from Collaborative Knowledge Distillation via Multiknowledge ...
Advertisement Space (336x280)

Transformer-based Knowledge Distillation for Efficient Semantic ...

Efficient knowledge distillation for hybrid models: A vision ...

Transformer-based Knowledge Distillation for Efficient Semantic ...

Transformer-based Knowledge Distillation for Efficient Semantic ...

Knowledge Distillation for Efficient Transformer-Based Reinforcement ...

(PDF) Transformer-based Knowledge Distillation for Efficient Semantic ...

Efficient Knowledge Distillation for Brain Tumor Segmentation

(PDF) Pruning‐guided feature distillation for an efficient transformer ...

Figure 1 from Replacing Attention With Modality-Wise Convolution for ...
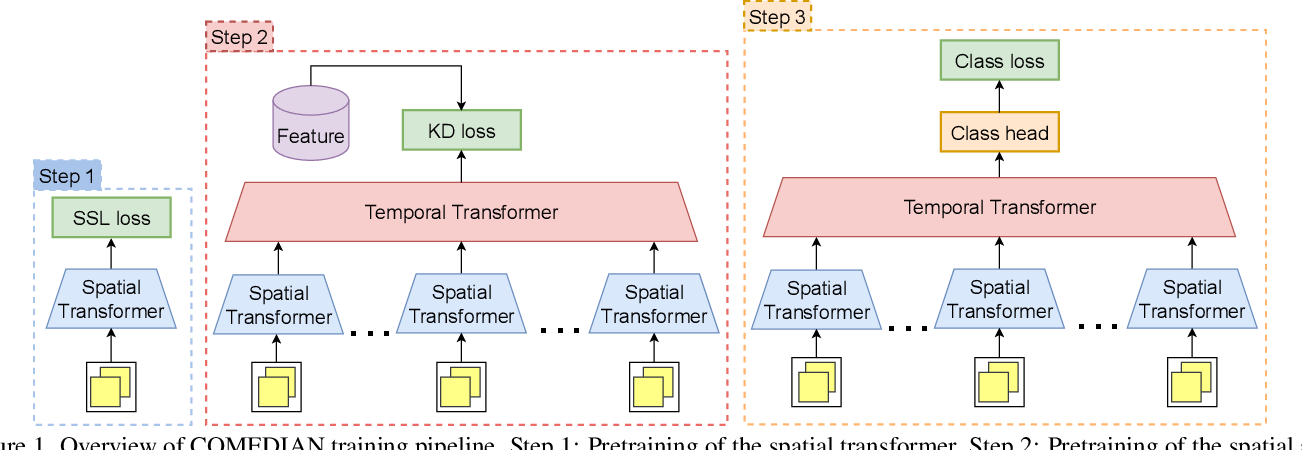
Figure 1 from COMEDIAN: Self-Supervised Learning and Knowledge ...
Advertisement Space (336x280)

Knowledge Distillation for Efficient Transformer-Based Reinforcement ...

Transformer-based Knowledge Distillation for Efficient Semantic ...
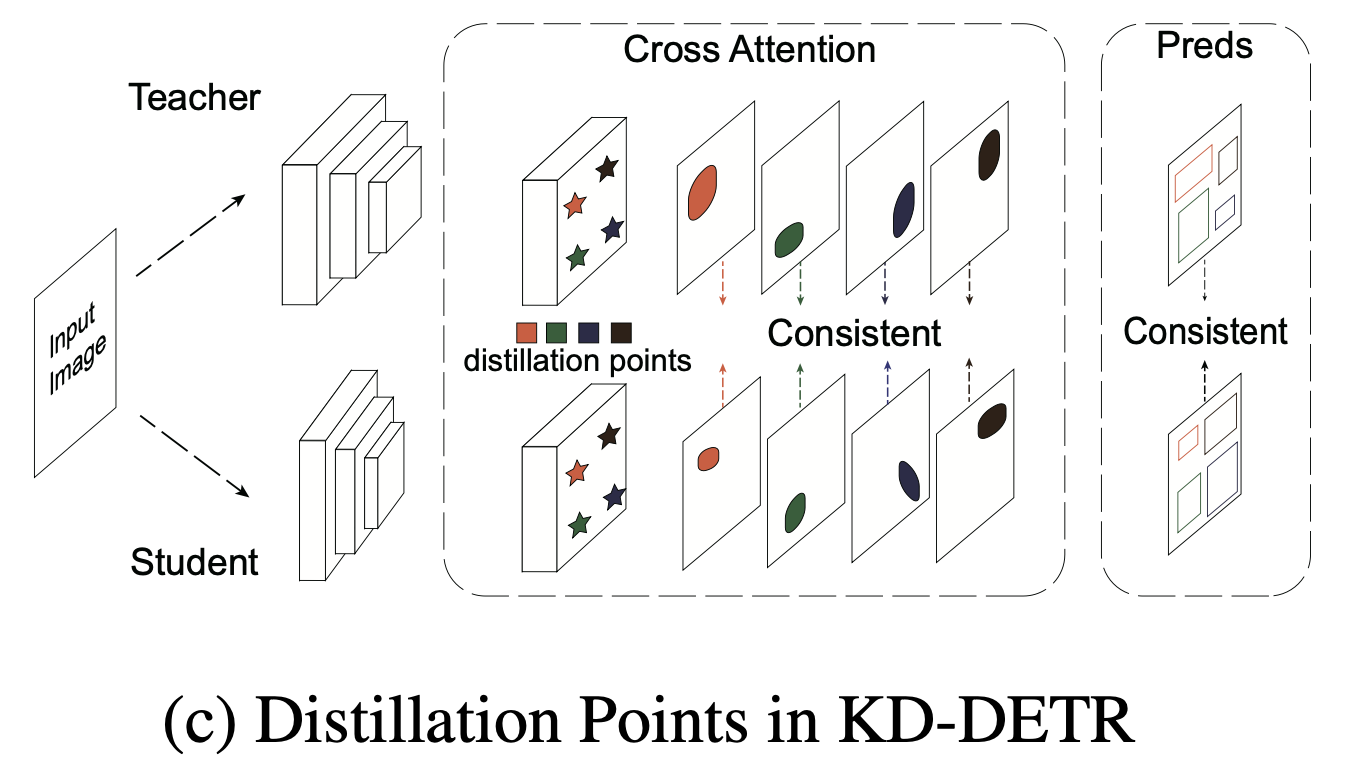
KD-DETR: Knowledge Distillation for Detection Transformer with ...

Figure 4 from TraKDis: A Transformer-Based Knowledge Distillation ...
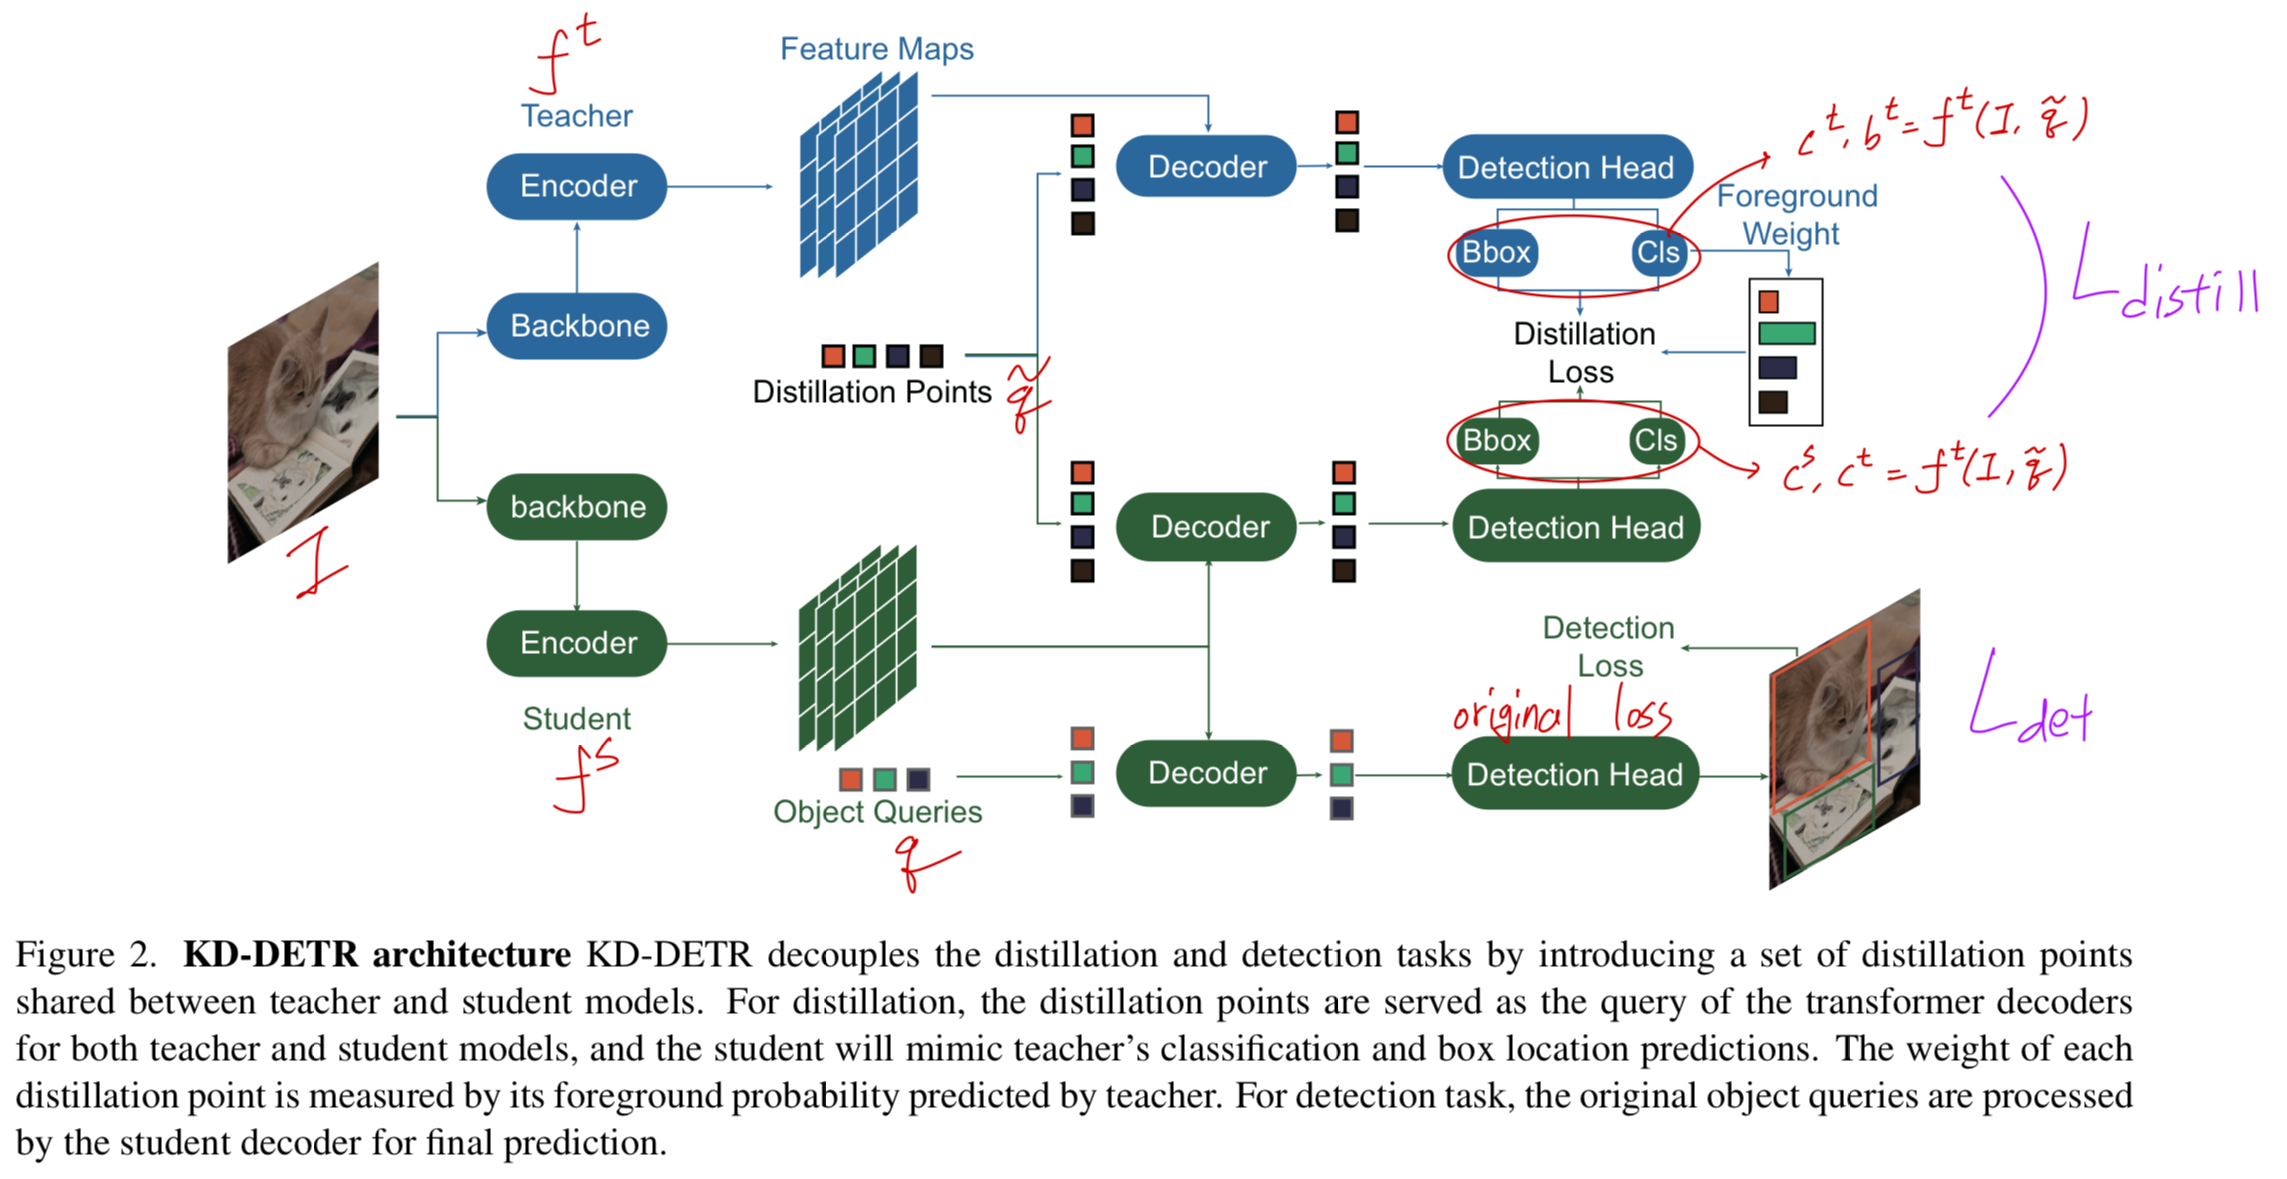
KD-DETR: Knowledge Distillation for Detection Transformer with ...

Figure 1 from From Multimodal to Unimodal Attention in Transformers ...