
Figure 2 From A Low Rank Matching Attention Based Cross Modal Feature

Figure 2 from Cross Model Attention based Deep Learning for Multi Modal ...

Figure 2 from Cross-Level Attention Based Adaptive Feature Alignment ...

A Low-rank Matching Attention based Cross-modal Feature Fusion Method ...

A Low-rank Matching Attention based Cross-modal Feature Fusion Method ...

A Low-rank Matching Attention based Cross-modal Feature Fusion Method ...

A Low-rank Matching Attention based Cross-modal Feature Fusion Method ...

Figure 2 from A CLIP-Based Cross-Modal Matching Model for Image-Text ...
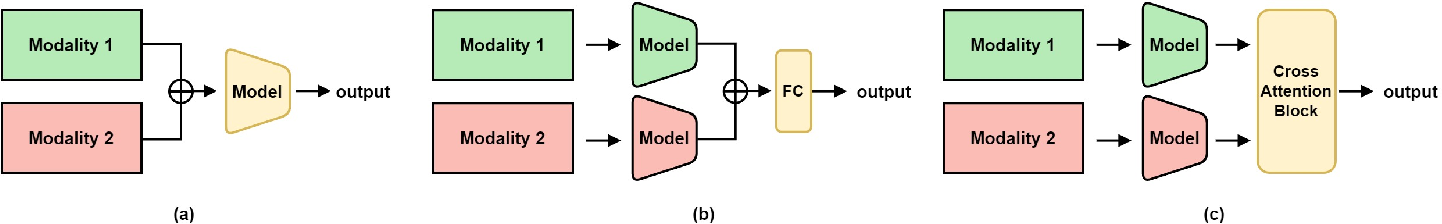
Figure 2 from Multi-Modal Cross Attention Network for Predicting ...
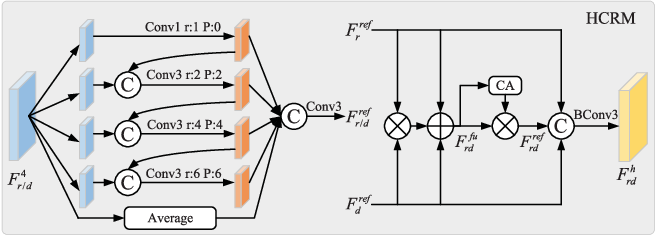
Figure 2 from Cross-Modal and Cross-Level Attention Interaction Network ...
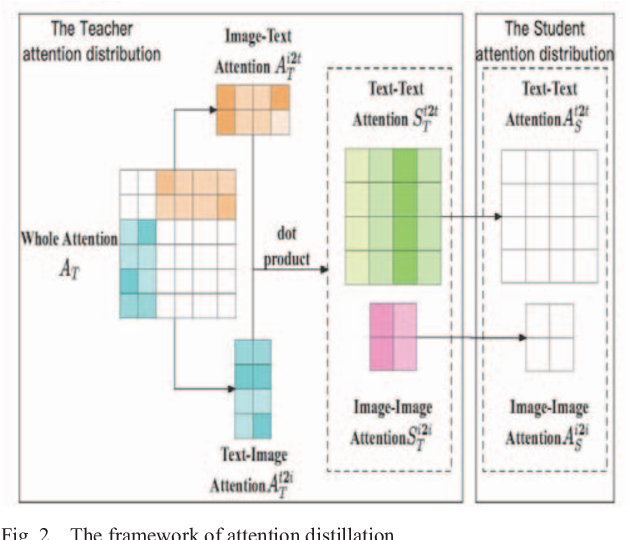
Figure 2 from Cross-modal Retrieval with Attention Knowledge ...
Advertisement Space (300x250)
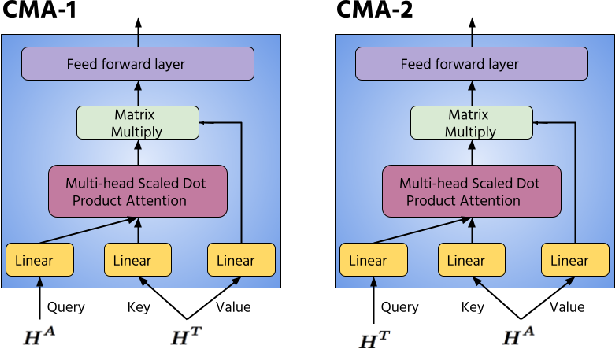
Figure 2 from Using Large Pre-Trained Models with Cross-Modal Attention ...

Figure 2 from Label-Guided Cross-Modal Attention Network for Multi ...

Figure 2 from Cross-modal Contrastive Attention Model for Medical ...
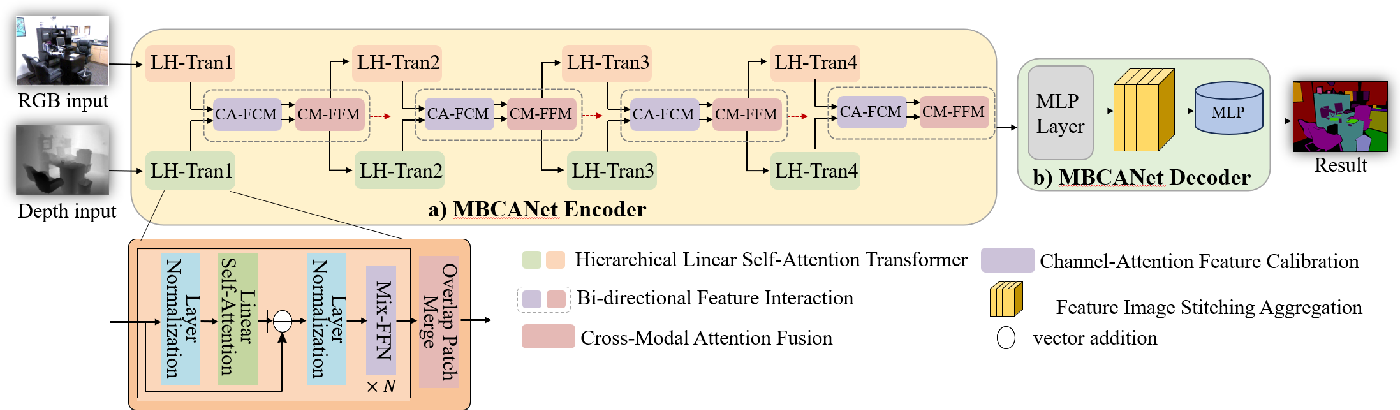
Figure 2 from Multi-Scale Bidirectional Cross-Modal Attention Network ...

Figure 2 from Cross-Modal Attention Preservation with Self-Contrastive ...

Figure 2 from Cross-Modal Graph Attention Network for Entity Alignment ...

Figure 2 from Cross-Modal Progressive Perspective Matching Network for ...

Figure 2 from Bidirectional Multi-modal Attention for Visible-Infrared ...

Figure 2 from Cross-modal attention network for retinal disease ...

Figure 2 from CMFAN: Cross-Modal Feature Alignment Network for Few-Shot ...
Advertisement Space (336x280)

Figure 2 from Additive Cross-Modal Attention Network (ACMA) for ...

Figure 2 from Attention-Based Multi-View Feature Collaboration for ...

Figure 2 from MMCLIP: Cross-modal Attention Masked Modelling for ...

CMMF-Net: a generative network based on CLIP-guided multi-modal feature ...

The structure of cross modal attention module | Download Scientific Diagram

Figure 2 from Multi-Level Multi-Modal Cross-Attention Network for Fake ...

A cross-modal conditional mechanism based on attention for text-video ...

Figure 2 from Cross-Modal Self-Attention Network for Referring Image ...

A Cross-Modal Feature Fusion Model Based on ConvNeXt for RGB-D Semantic ...

Figure 2 from Cross-Modal Remote Sensing Image Retrieval Via Intra- and ...
Advertisement Space (336x280)

Figure 2 from Cross-modal Local Shortest Path and Global Enhancement ...
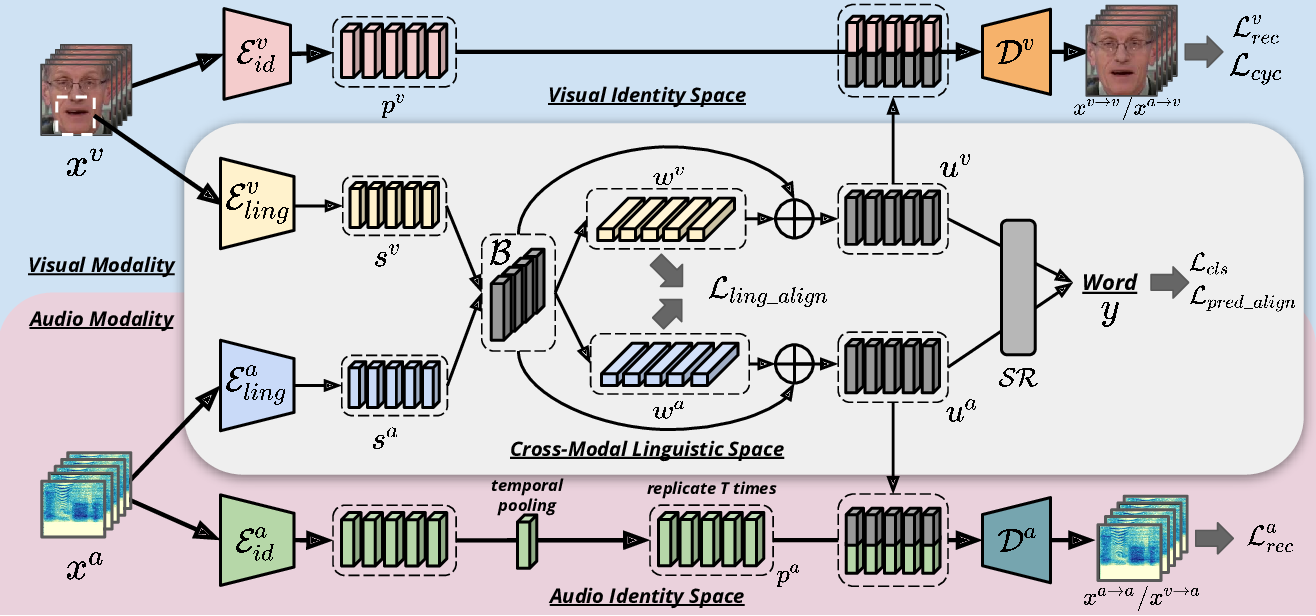
Figure 2 from Cross-Modal Mutual Learning for Audio-Visual Speech ...

Figure 2 from Modality-Specific Cross-Modal Similarity Measurement With ...
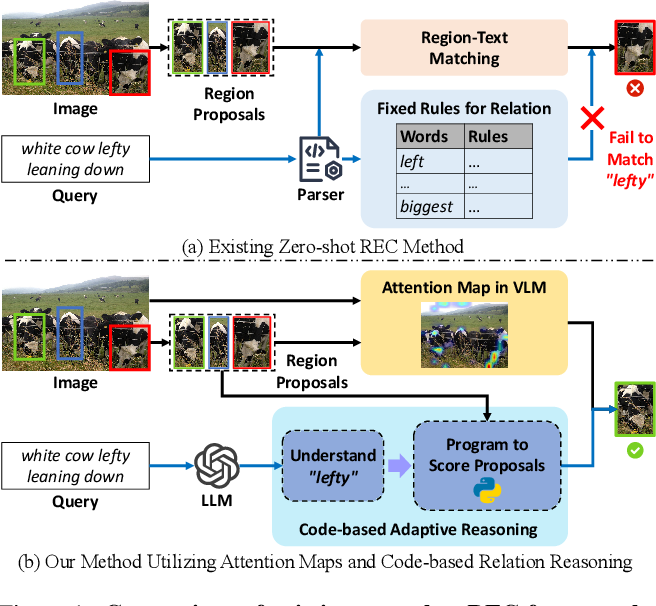
Figure 1 from Leveraging Debiased Cross-Modal Attention Maps and Code ...

A cross-modal conditional mechanism based on attention for text-video ...
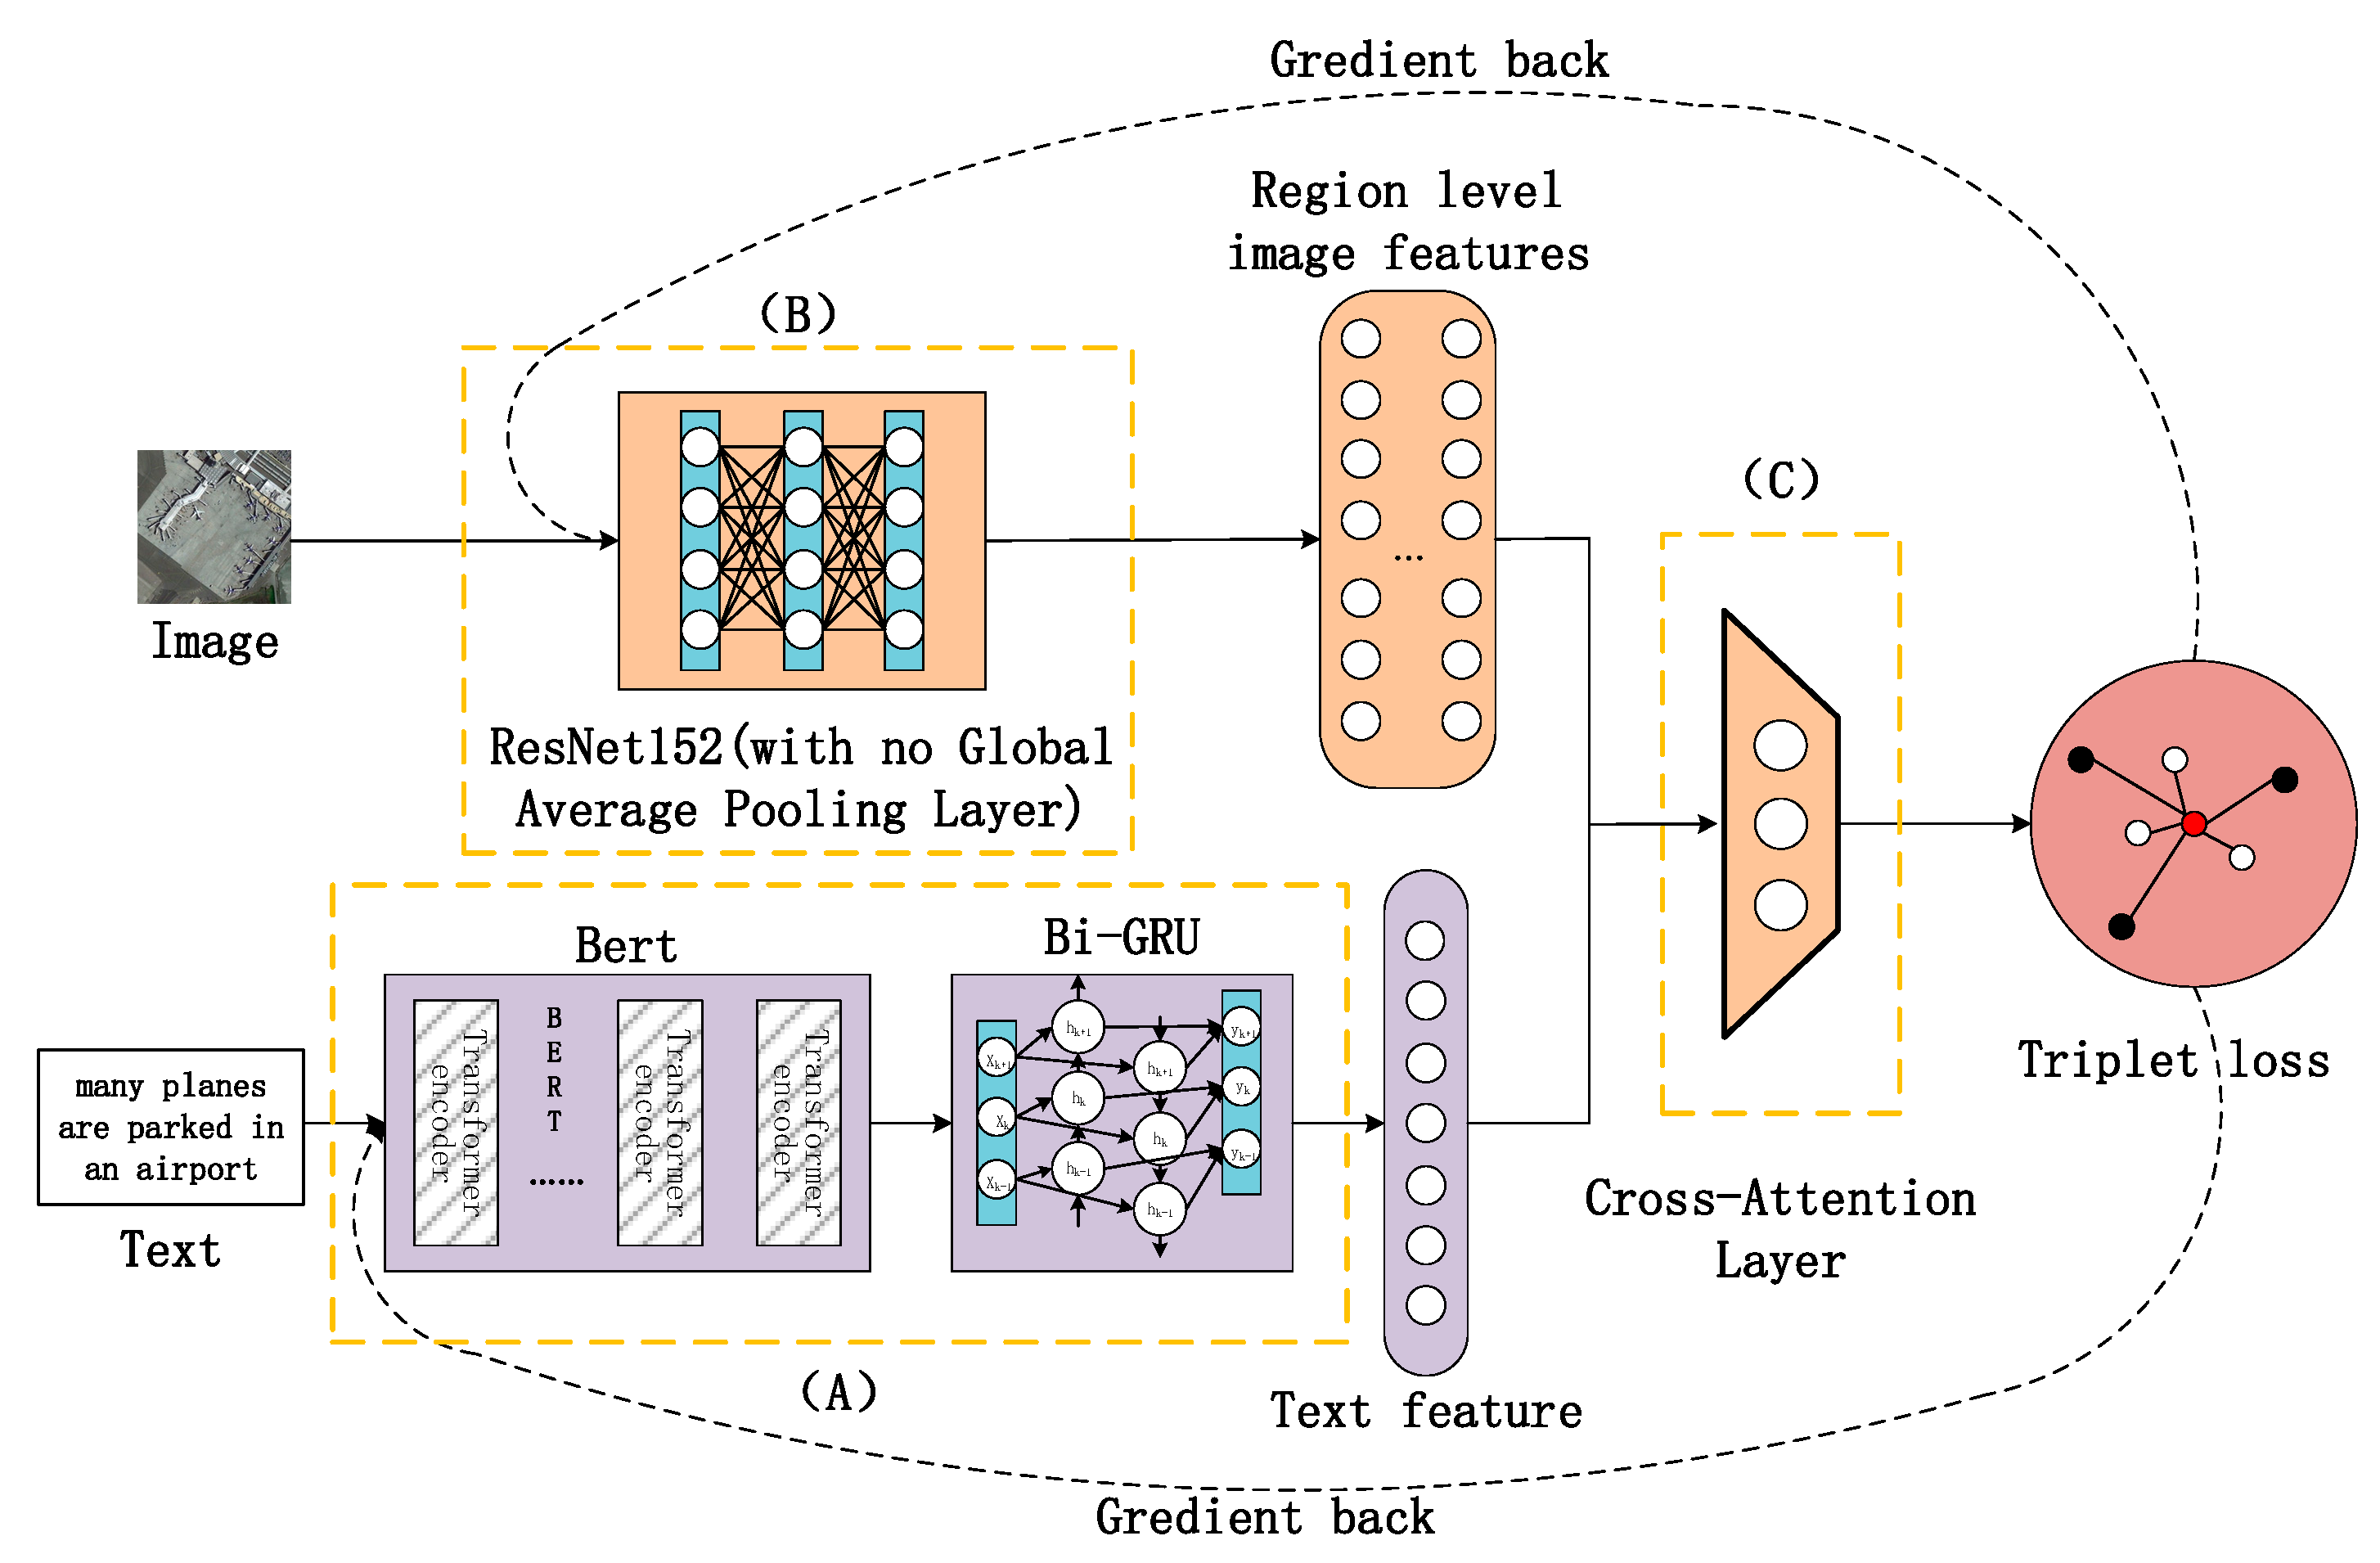
A Cross-Attention Mechanism Based on Regional-Level Semantic Features ...