
L1 2 Csdn

Sketch of the L1 2 and L1 0 structures. The arrow desig- | Download ...
L1 L2正则化、Smooth L1、优化器weight_decay、坐标轴下降、近端梯度下降 (proximal gradient ...
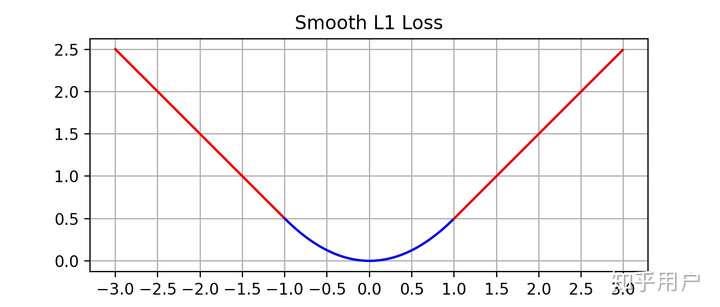
L1, L2以及smooth L1 loss_l1 l2范数混合的loss-CSDN博客

L1 L2 正则化_l1正则不稳定-CSDN博客

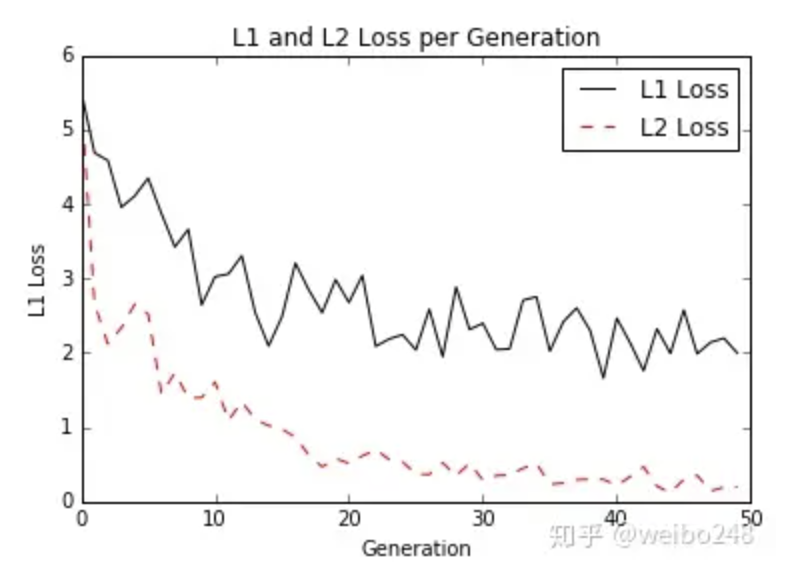
L1 Loss VS L2 loss(MSE Loss)对比_l1loss和l2loss的区别-CSDN博客

L1、L2正则化以及smooth L1 loss_l2正则化 和smoothl1-CSDN博客

L1 与 L2 正则化约束:几何直观_l2正则化约束-CSDN博客
L1 L2正则化、Smooth L1、优化器weight_decay、坐标轴下降、近端梯度下降 (proximal gradient ...

l1 loss和L2 loss的差异-CSDN博客

L1 神经网络和深度学习 Week3(吴恩达)_吴恩达深度学习 week3-CSDN博客
Advertisement Space (300x250)

L1 Loss VS L2 loss(MSE Loss)对比_l1loss和l2loss的区别-CSDN博客

L1 第2讲 算数运算符和字符型-CSDN博客
L1 和 L2正则化的区别,在机器学习中如何选择_l1正则化和l2正则化怎么选择-CSDN博客

L1、L2正则化以及smooth L1 loss_l2正则化 和smoothl1-CSDN博客
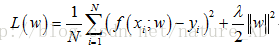
L1和L2的区别和各自的优势_emv l1 l2 区别-CSDN博客
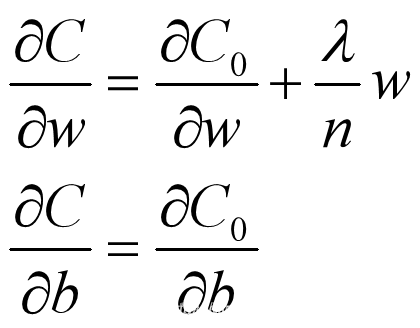
L1 VS L2(深度学习中的L1与L2)_深度学习 分级函数 l1 l2-CSDN博客

L1 与 L2 正则化约束:几何直观_l2正则化约束-CSDN博客
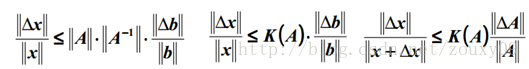
L1 L2范式的详解以及Scikit-learn上基于L1 L2范式正则化的实例_l2以虚控实实例-CSDN博客
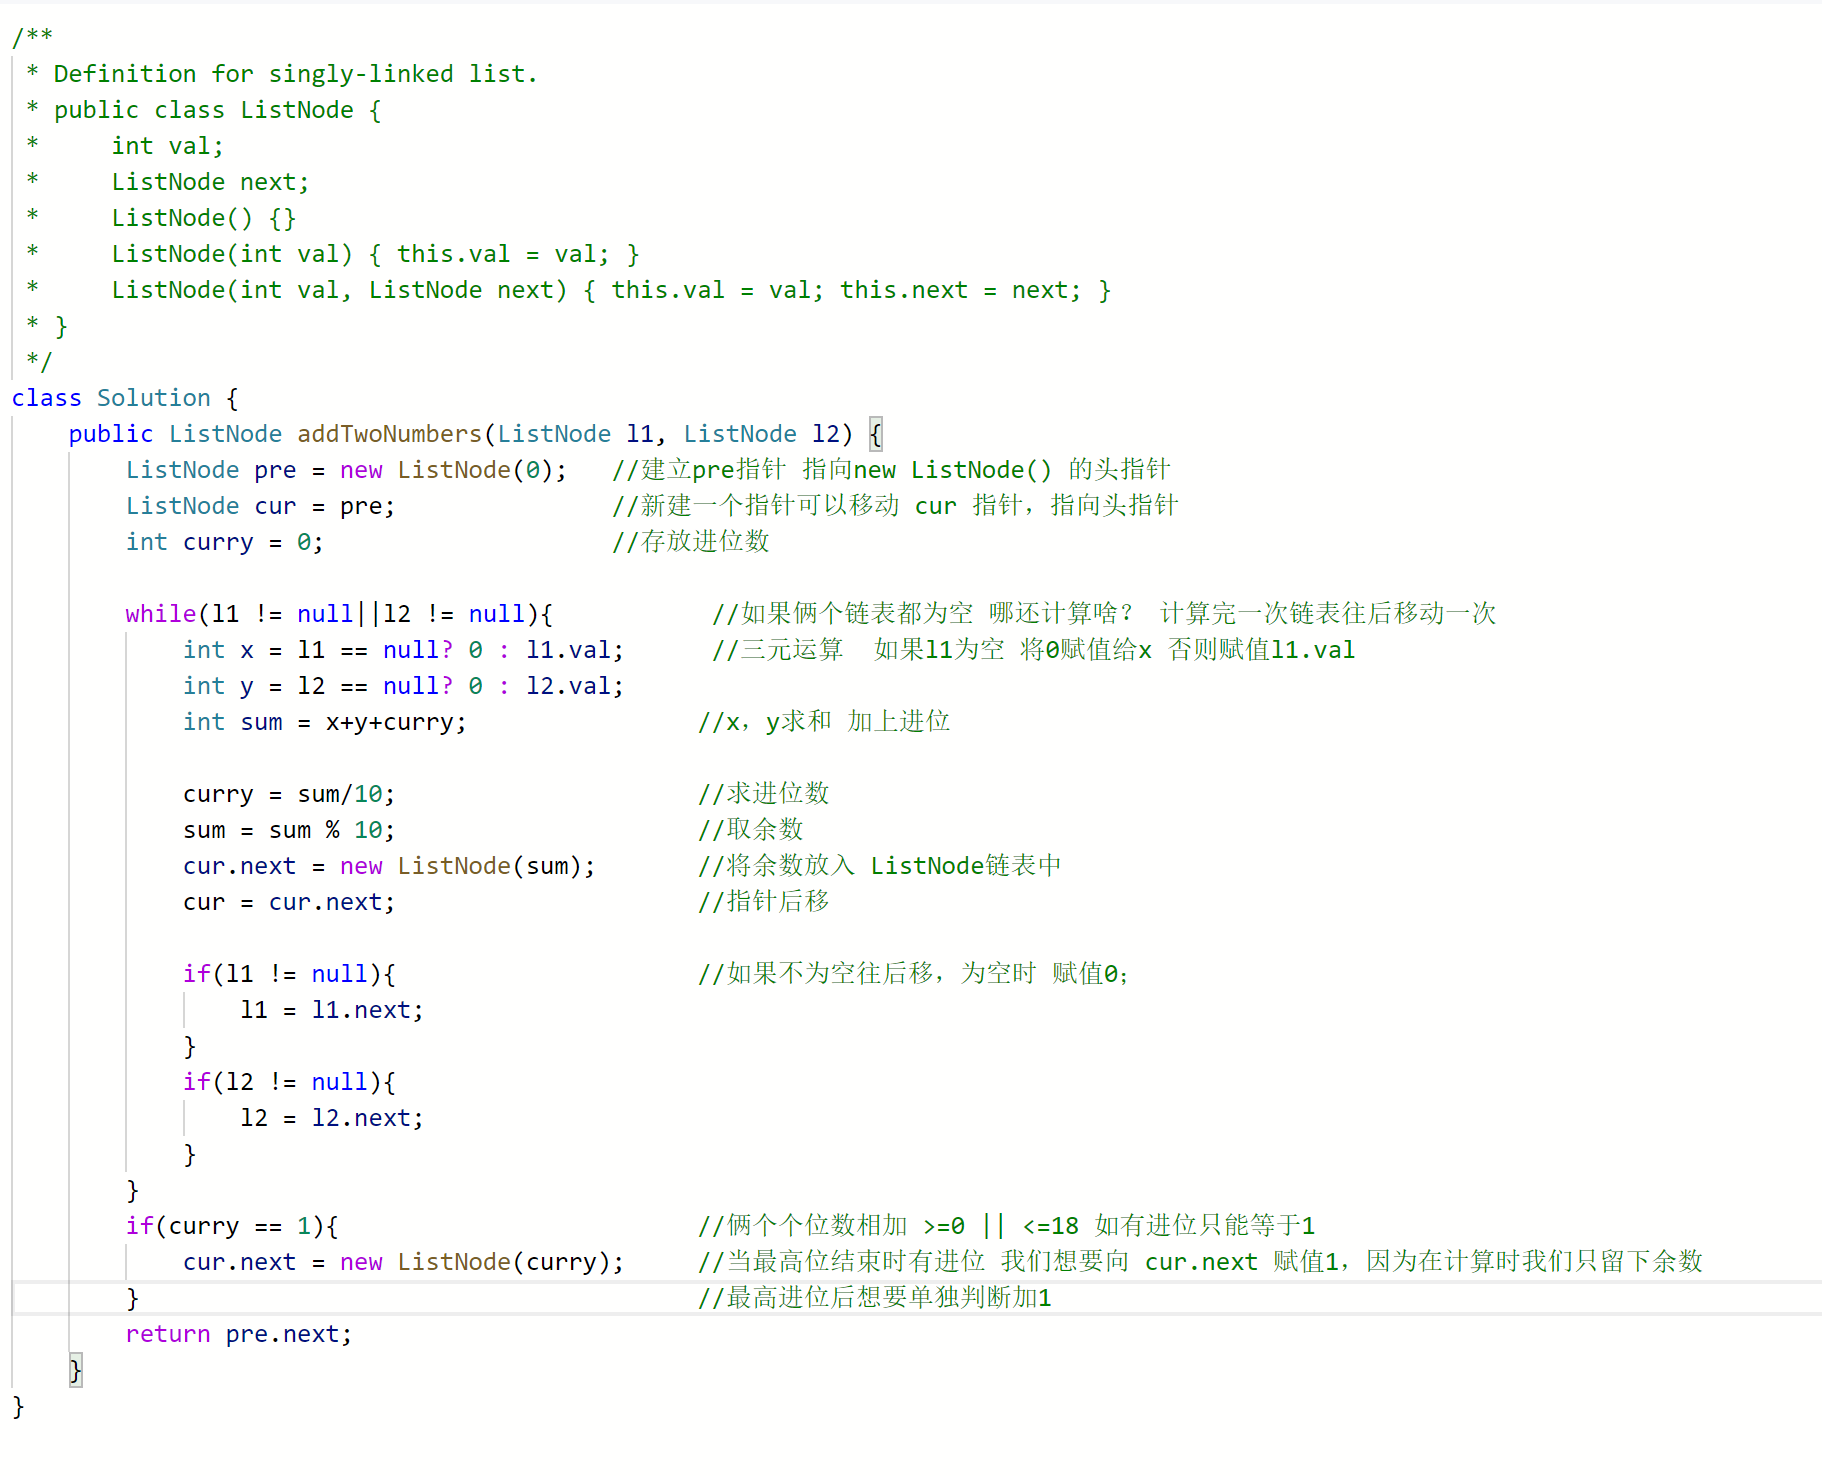
Leetcode 两数相加_int x = l1 == null ? 0 : l1.val;-CSDN博客

【回归损失函数】L1(MAE)、L2(MSE)、Smooth L1 Loss详解_mae损失函数-CSDN博客
Advertisement Space (336x280)

[机器学习]L21,L2,核范数-Csdn博客 | 超简单理解L0、L1、L2范数原理及作用_l0 l1 l2-CSDN博客 – PNFTZ
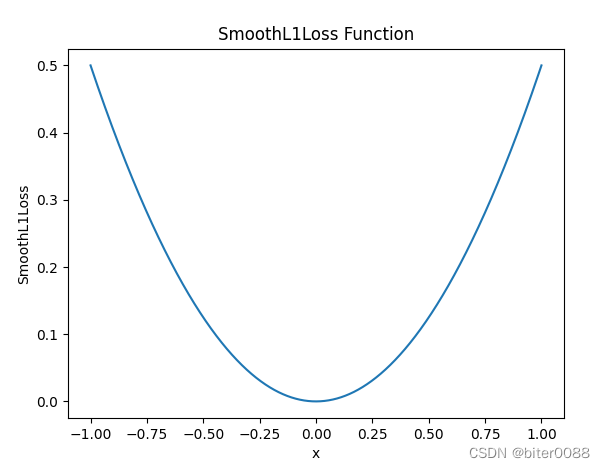
深度学习(23):SmoothL1Loss损失函数_smooth l1 loss-CSDN博客
L1 探索大模型能力边界_l1探索-CSDN博客
L1 探索大模型能力边界_l1探索-CSDN博客

Difference Between L1 L2 L3

[PCIe]LTSSM与电源管理_l1.1 和l1.2-CSDN博客

深度解构L1/L2正则化-CSDN博客

L1和L2范数,L1和L2损失函数,L1和L2正则化_l1 norm distance-CSDN博客

L1与L2正则化详解-CSDN博客
L1cache学习笔记_编程如何操作l1 cache-CSDN博客
Advertisement Space (336x280)

常说的cache机制到底是什么?L1 cache和 L2 cache是什么?_l1 l2 cache-CSDN博客
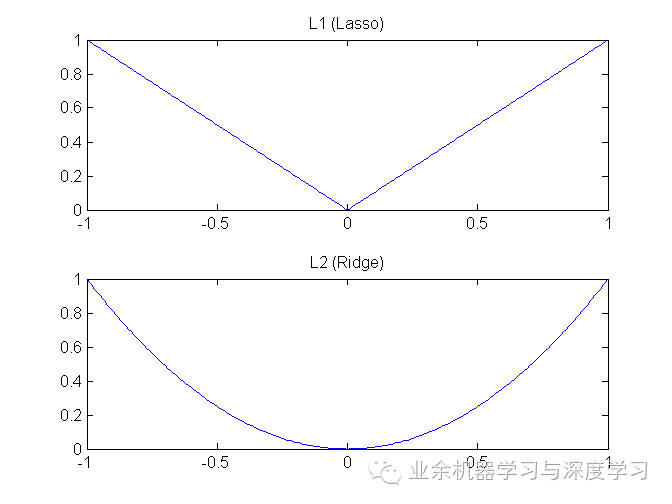
浅谈L1与L2正则化-CSDN博客

L1和L2范数,L1和L2损失函数,L1和L2正则化_l1 norm distance-CSDN博客
机器学习中的L1与L2正则化图解!-CSDN博客
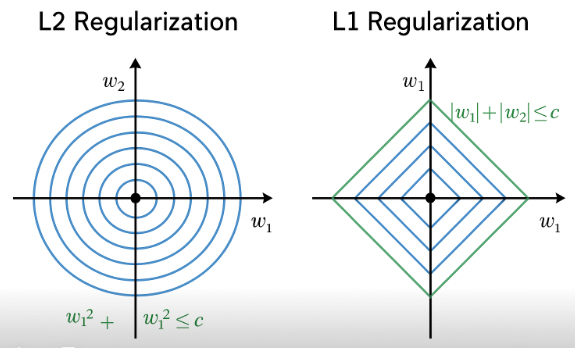
机器学习(10)L1 与 L2 正则化详解_l1 正则化和l2正则化的通俗讲解-CSDN博客

模型剪枝算法——L1正则化BN层的γ因子_l1正则化剪枝-CSDN博客