
Large Language Model Partitioning For Low Latency Inference At

[2505.02533] Large Language Model Partitioning for Low-Latency ...

Figure 1 from Large Language Model Partitioning for Low-Latency ...

[2505.02533] Large Language Model Partitioning for Low-Latency ...
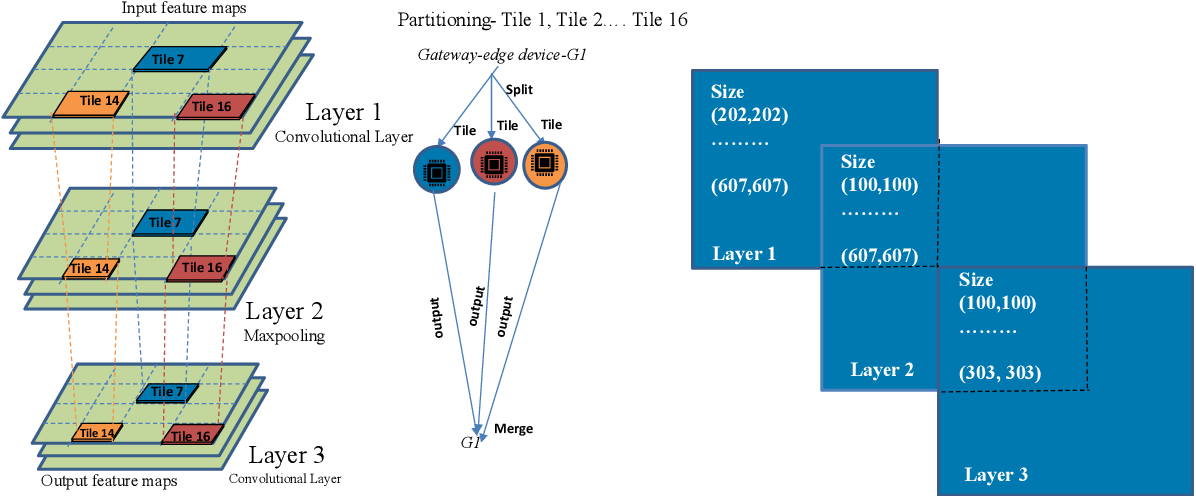
Figure 4 from LOW LATENCY DEEP LEARNING INFERENCE MODEL FOR DISTRIBUTED ...
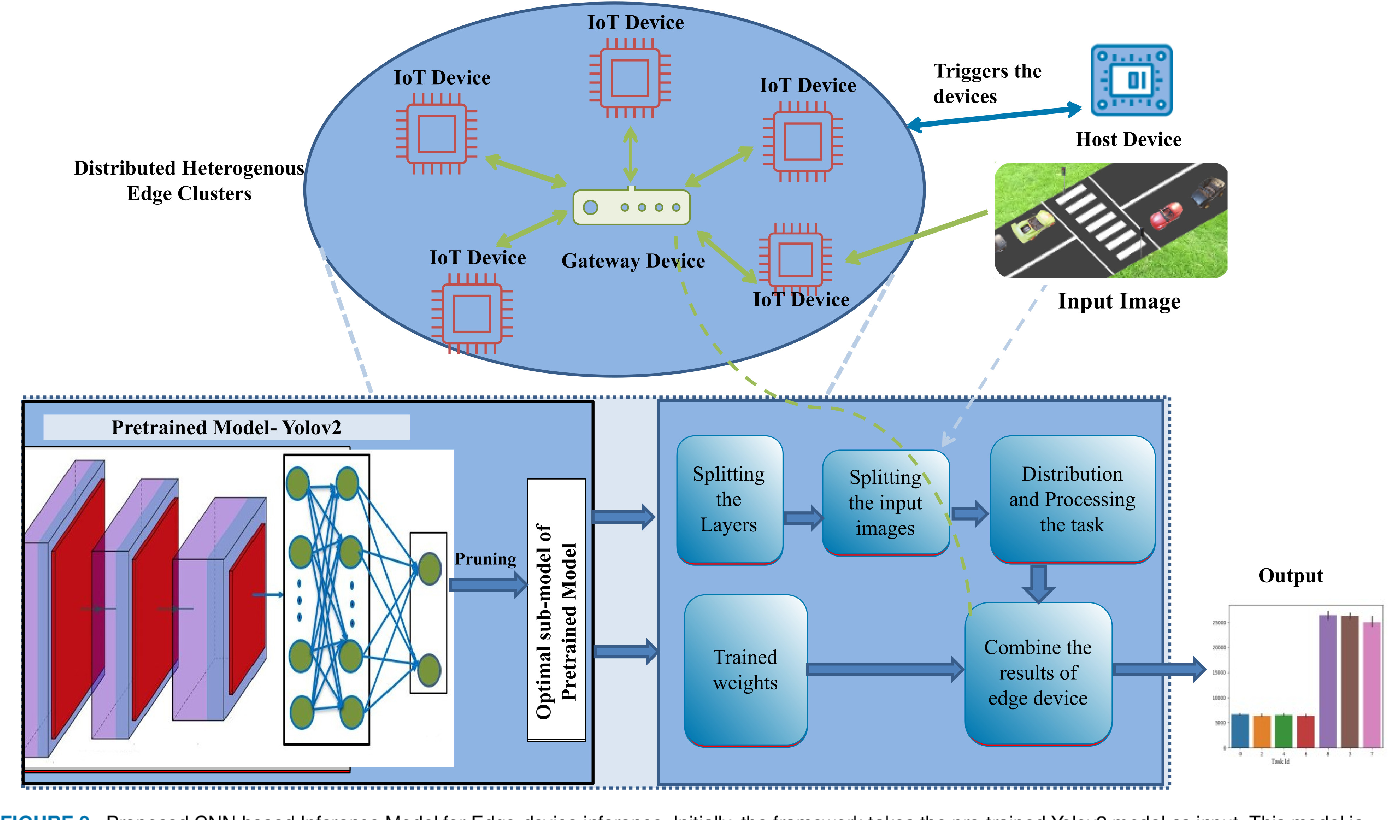
Figure 2 from LOW LATENCY DEEP LEARNING INFERENCE MODEL FOR DISTRIBUTED ...

(PDF) Low Latency Deep Learning Inference Model for Distributed ...
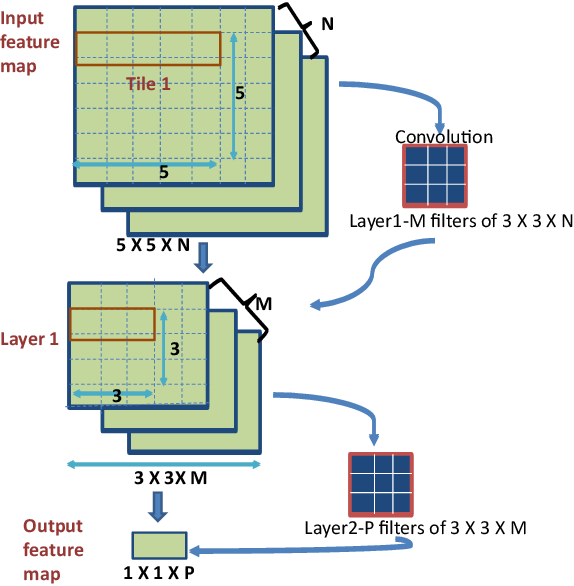
Figure 5 from LOW LATENCY DEEP LEARNING INFERENCE MODEL FOR DISTRIBUTED ...

[2505.18164] Model-Distributed Inference for Large Language Models at ...
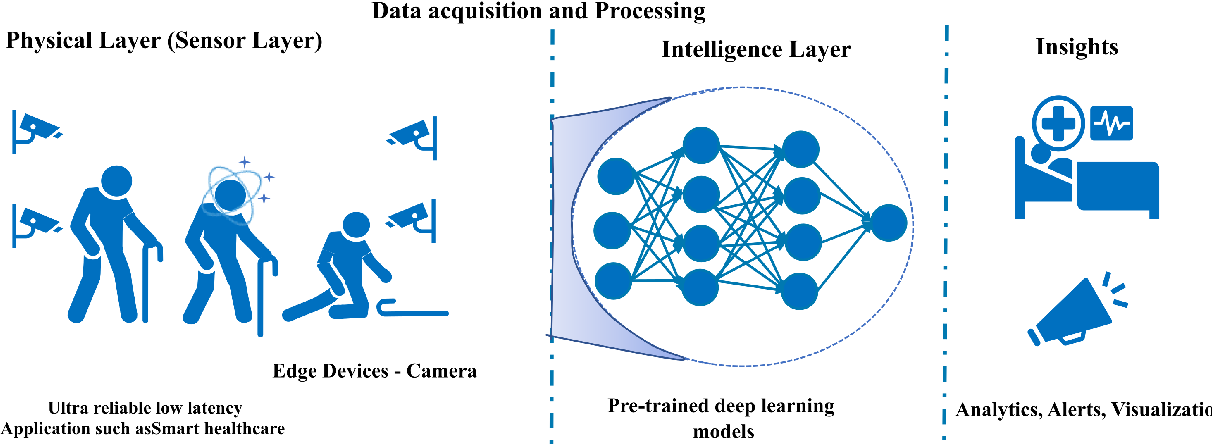
Figure 1 from LOW LATENCY DEEP LEARNING INFERENCE MODEL FOR DISTRIBUTED ...

[논문 리뷰] Scaling Large Language Model Training on Frontier with Low ...
Advertisement Space (300x250)
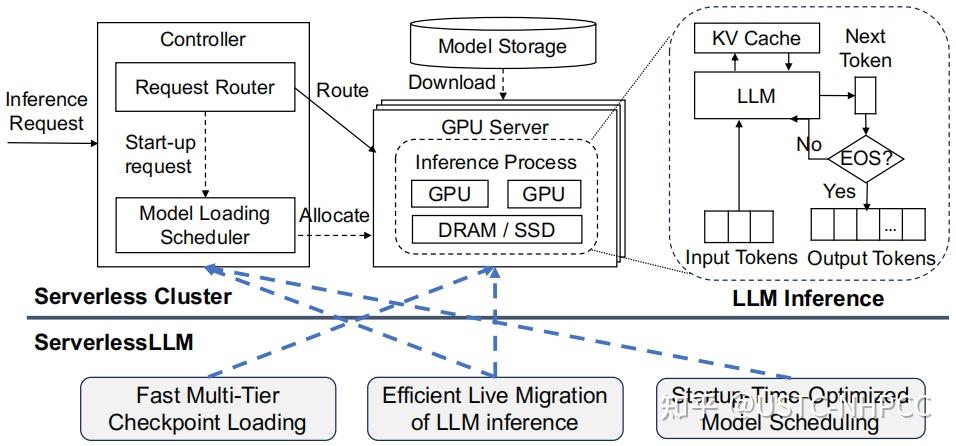
ServerlessLLM: Low-Latency Serverless Inference for Large Language ...
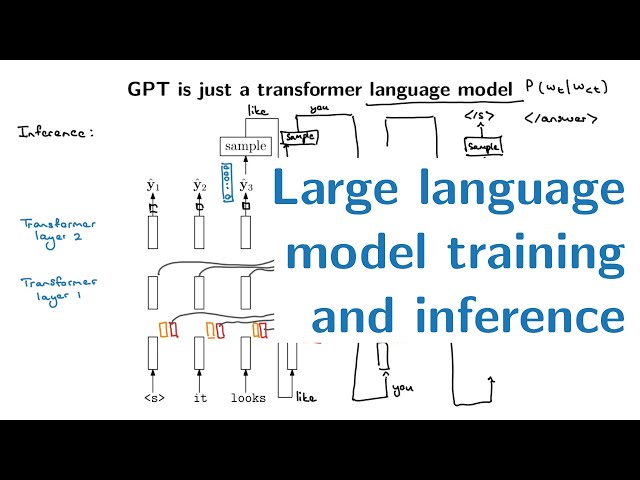
Ithy - Understanding and Optimizing Large Language Model Inference
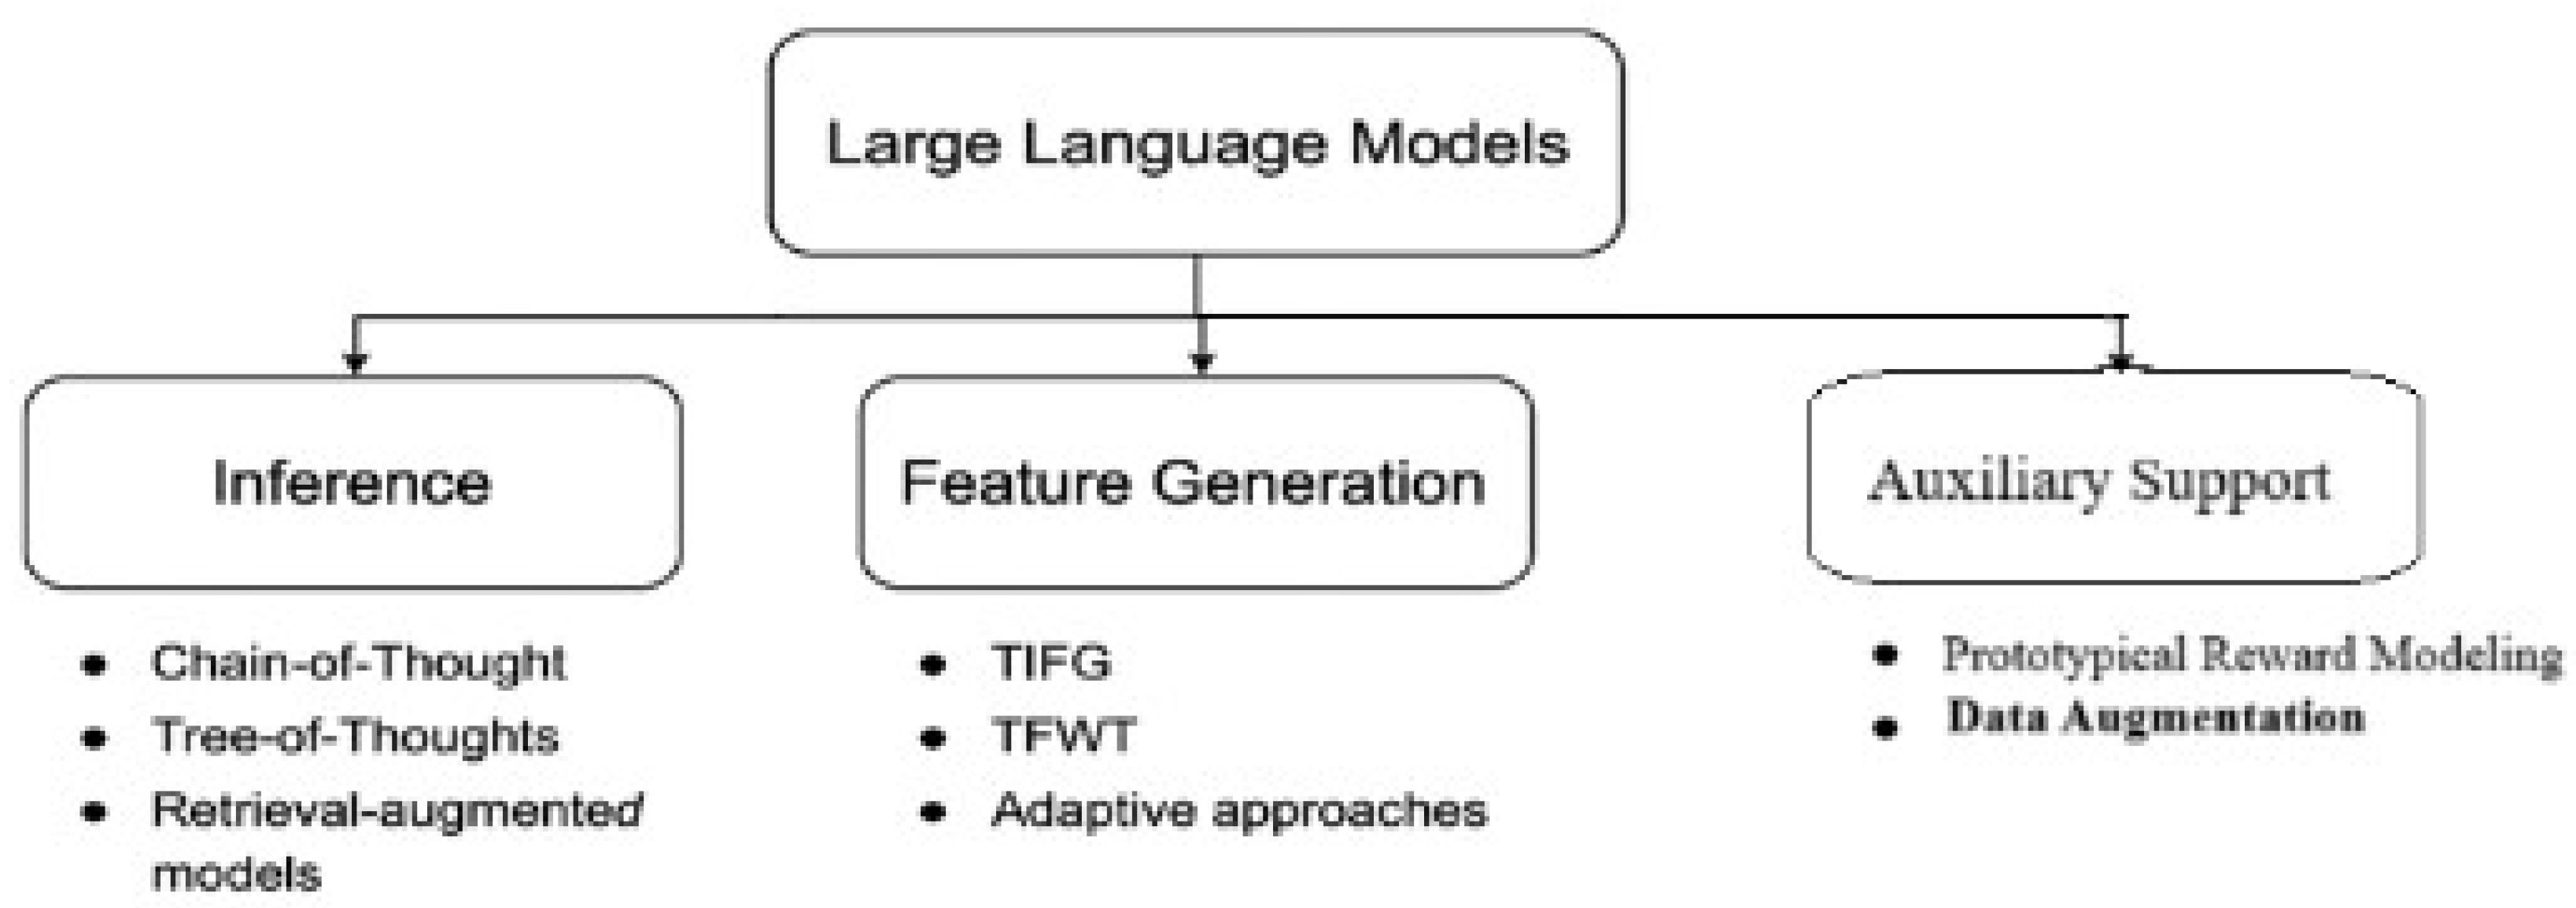
A Comprehensive and Critical Survey of Large Language Model Inference ...

Paper page - LUT-LLM: Efficient Large Language Model Inference with ...

[논문 리뷰] Large Language Model Inference Acceleration: A Comprehensive ...

The Future of Serverless Inference for Large Language Models – Unite.AI

LLM in a flash: Efficient Large Language Model Inference with Limited ...
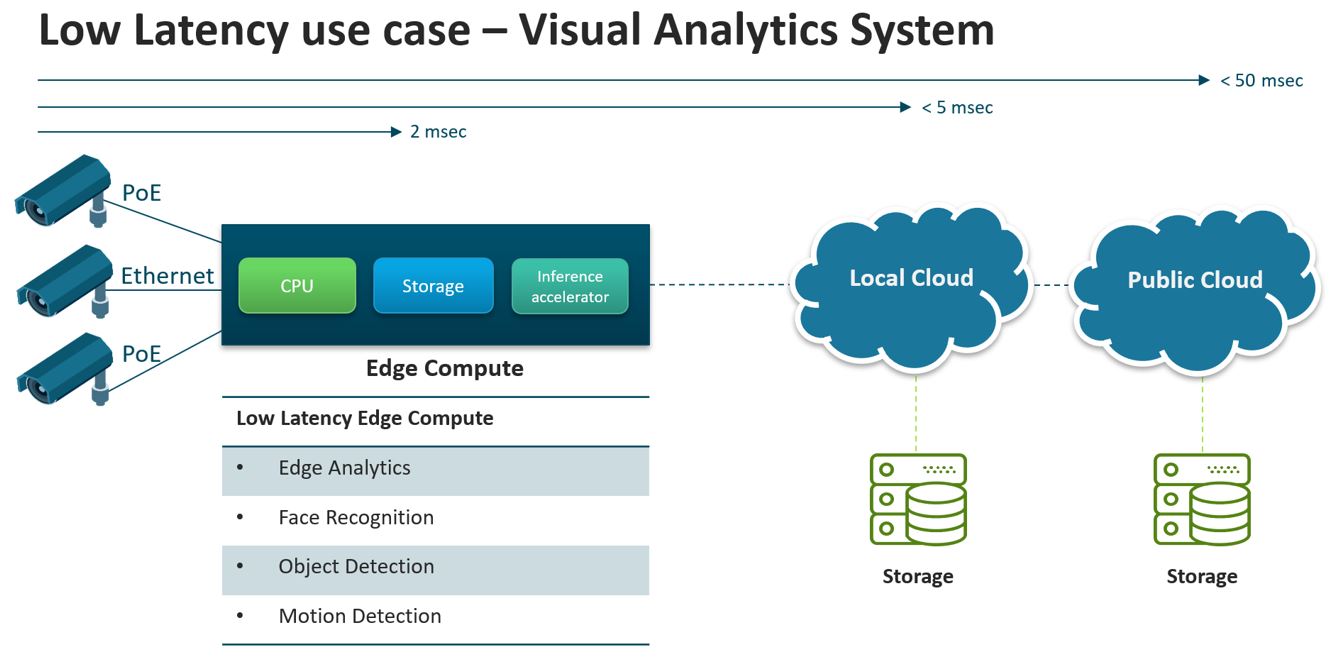
Empowering Low Latency AI Inference for Enhanced Efficiency
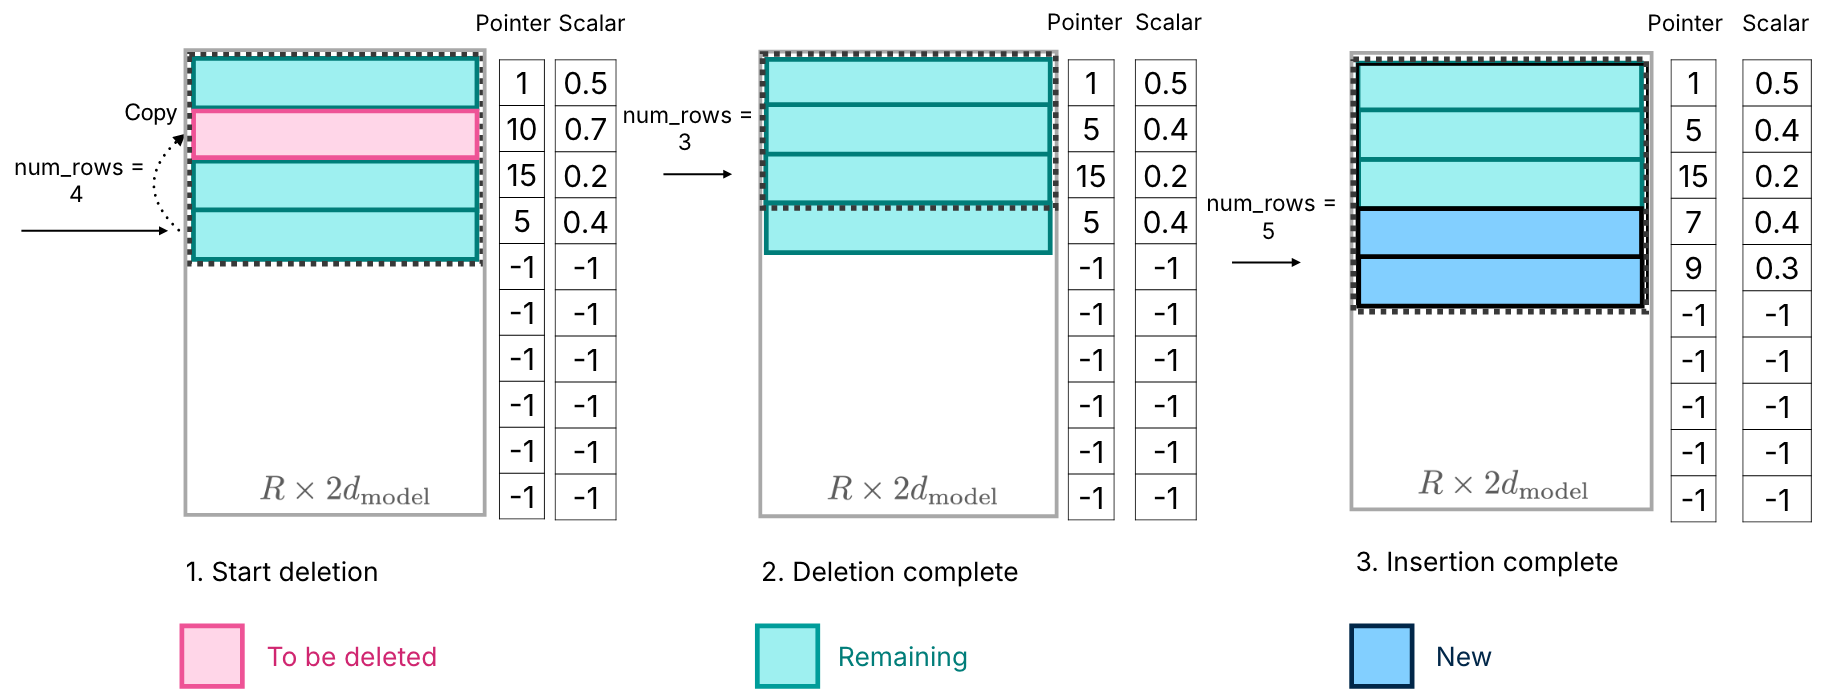
《LLM in a Flash: Efficient Large Language Model Inference with Limited ...
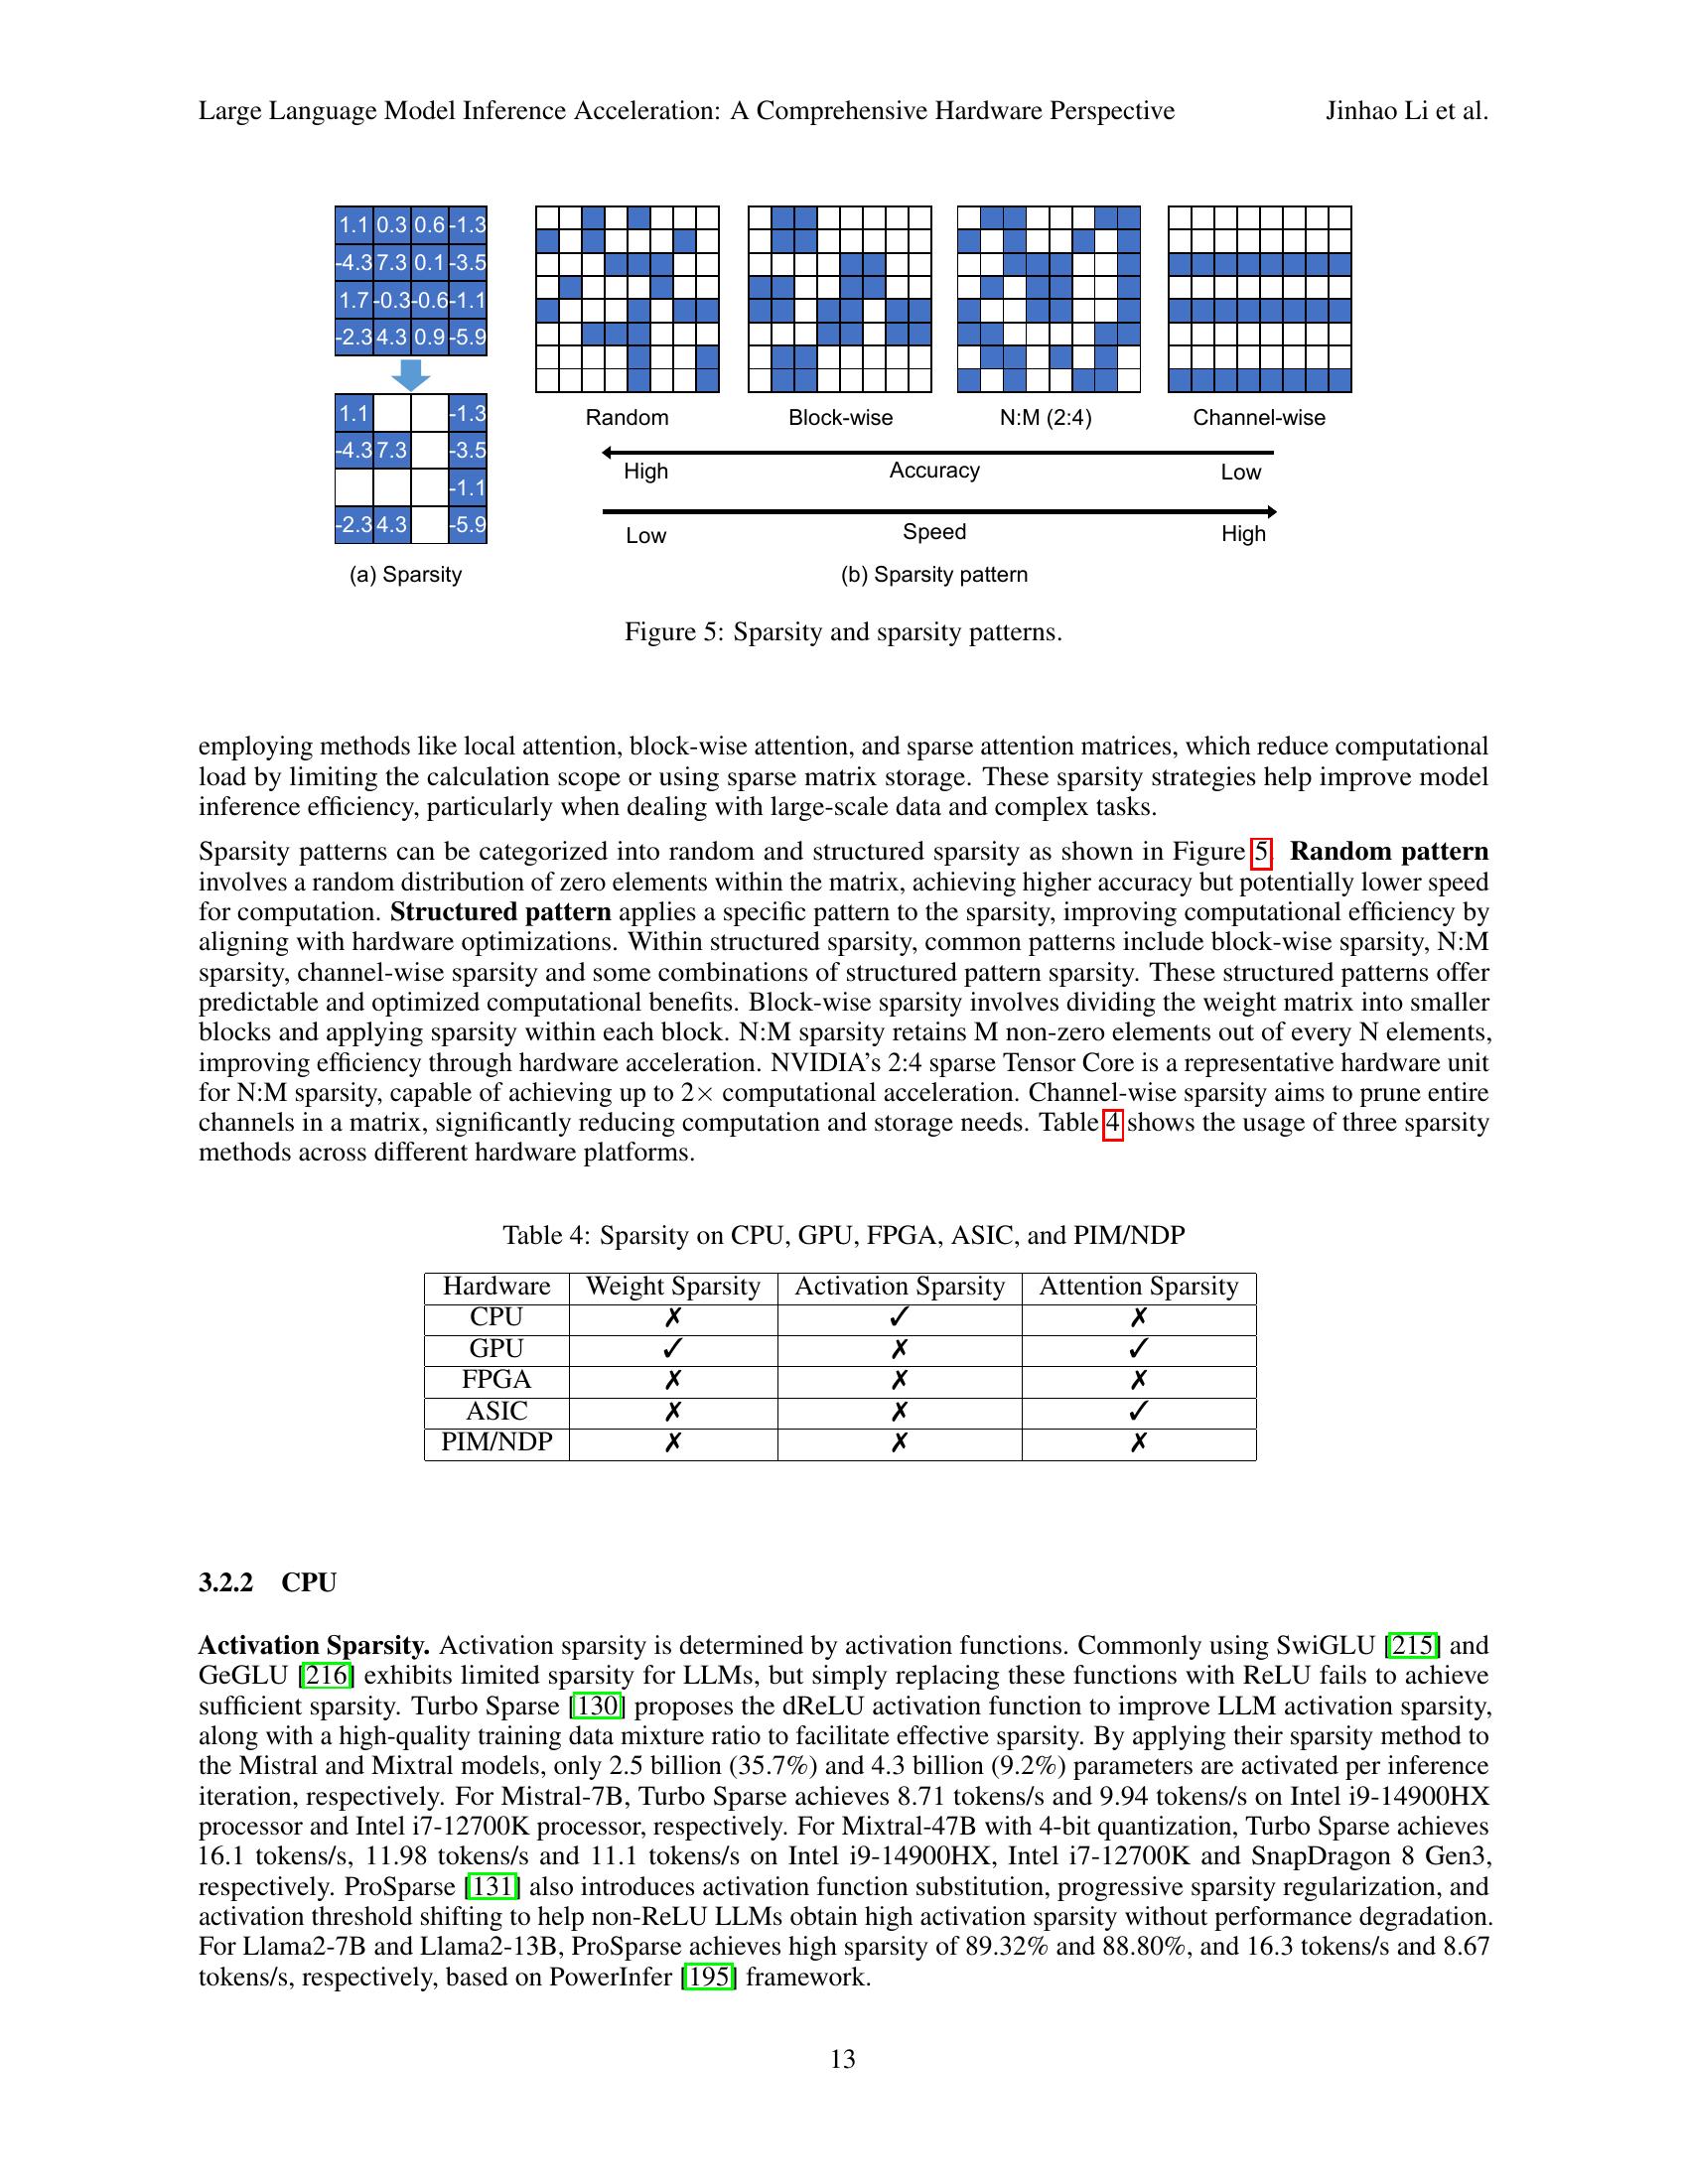
Large Language Model Inference Acceleration: A Comprehensive Hardware ...
Advertisement Space (336x280)

Network Edge Inference for Large Language Models: Principles ...

SpecEE: Accelerating Large Language Model Inference with Speculative ...
LUT-LLM: Efficient Large Language Model Inference with Memory-based ...
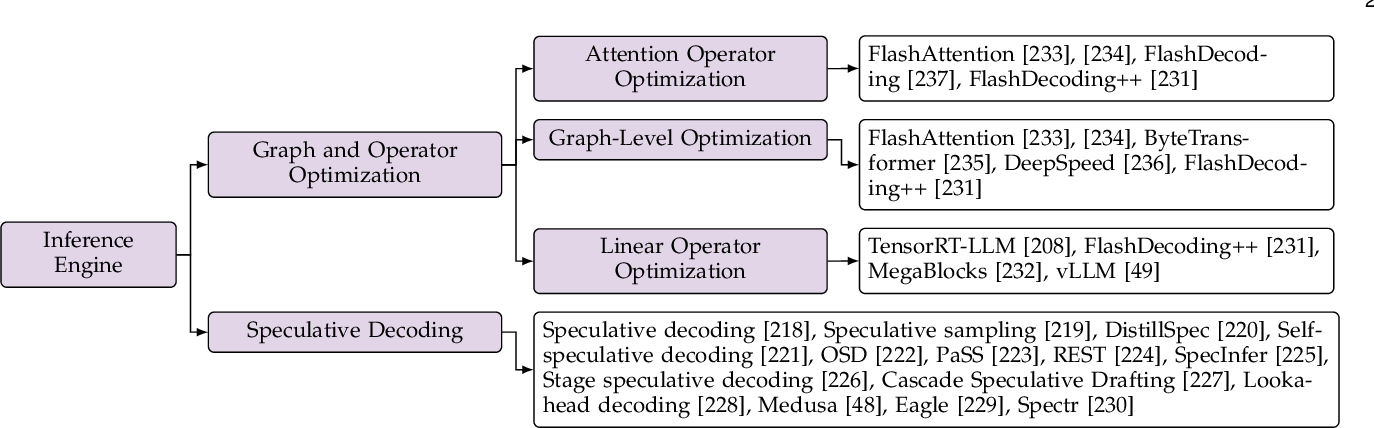
Figure 14 from A Survey on Efficient Inference for Large Language ...

Memory- and Latency-Constrained Inference of Large Language Models via ...
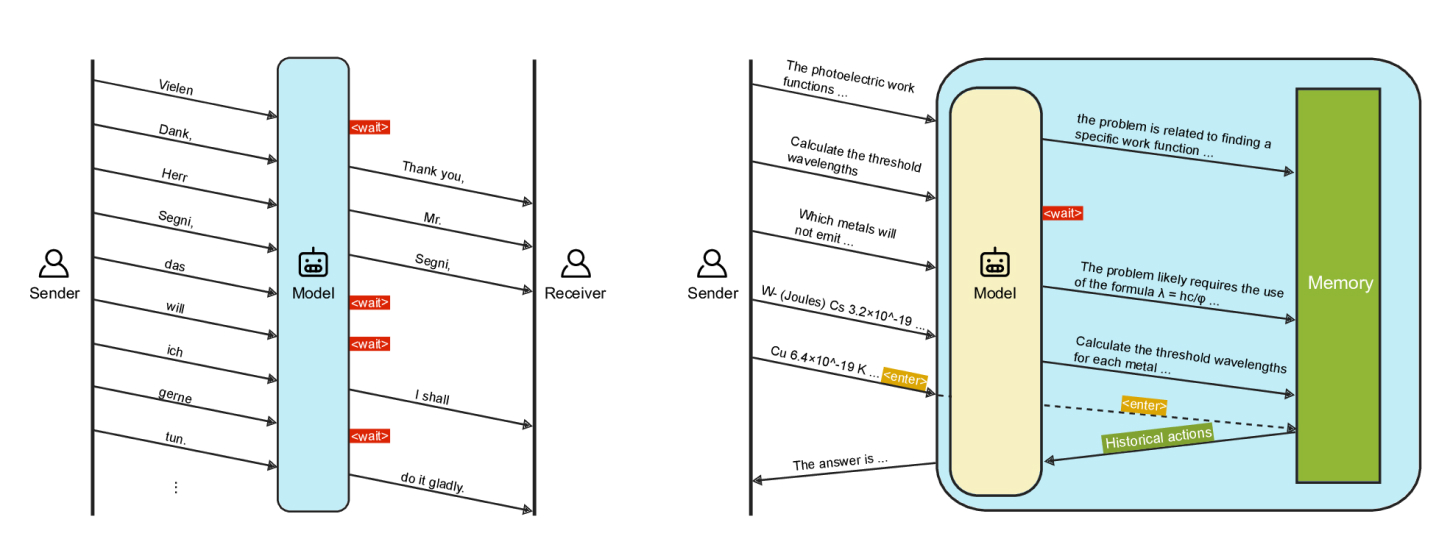
LiveMind: Low-latency Large Language Models with Simultaneous Inference ...
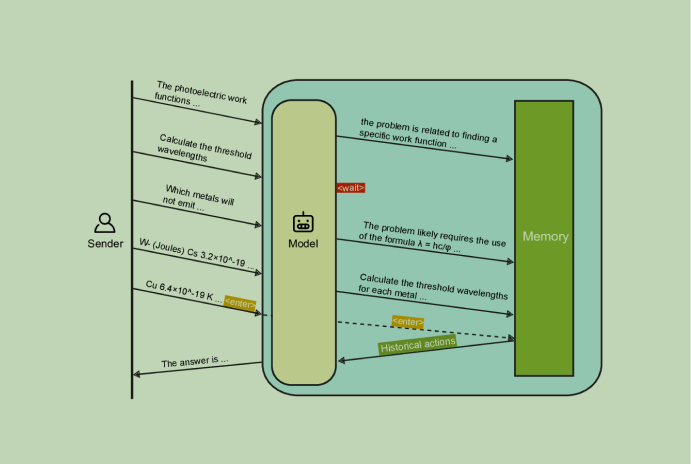
LiveMind: Low-latency Large Language Models with Simultaneous Inference ...
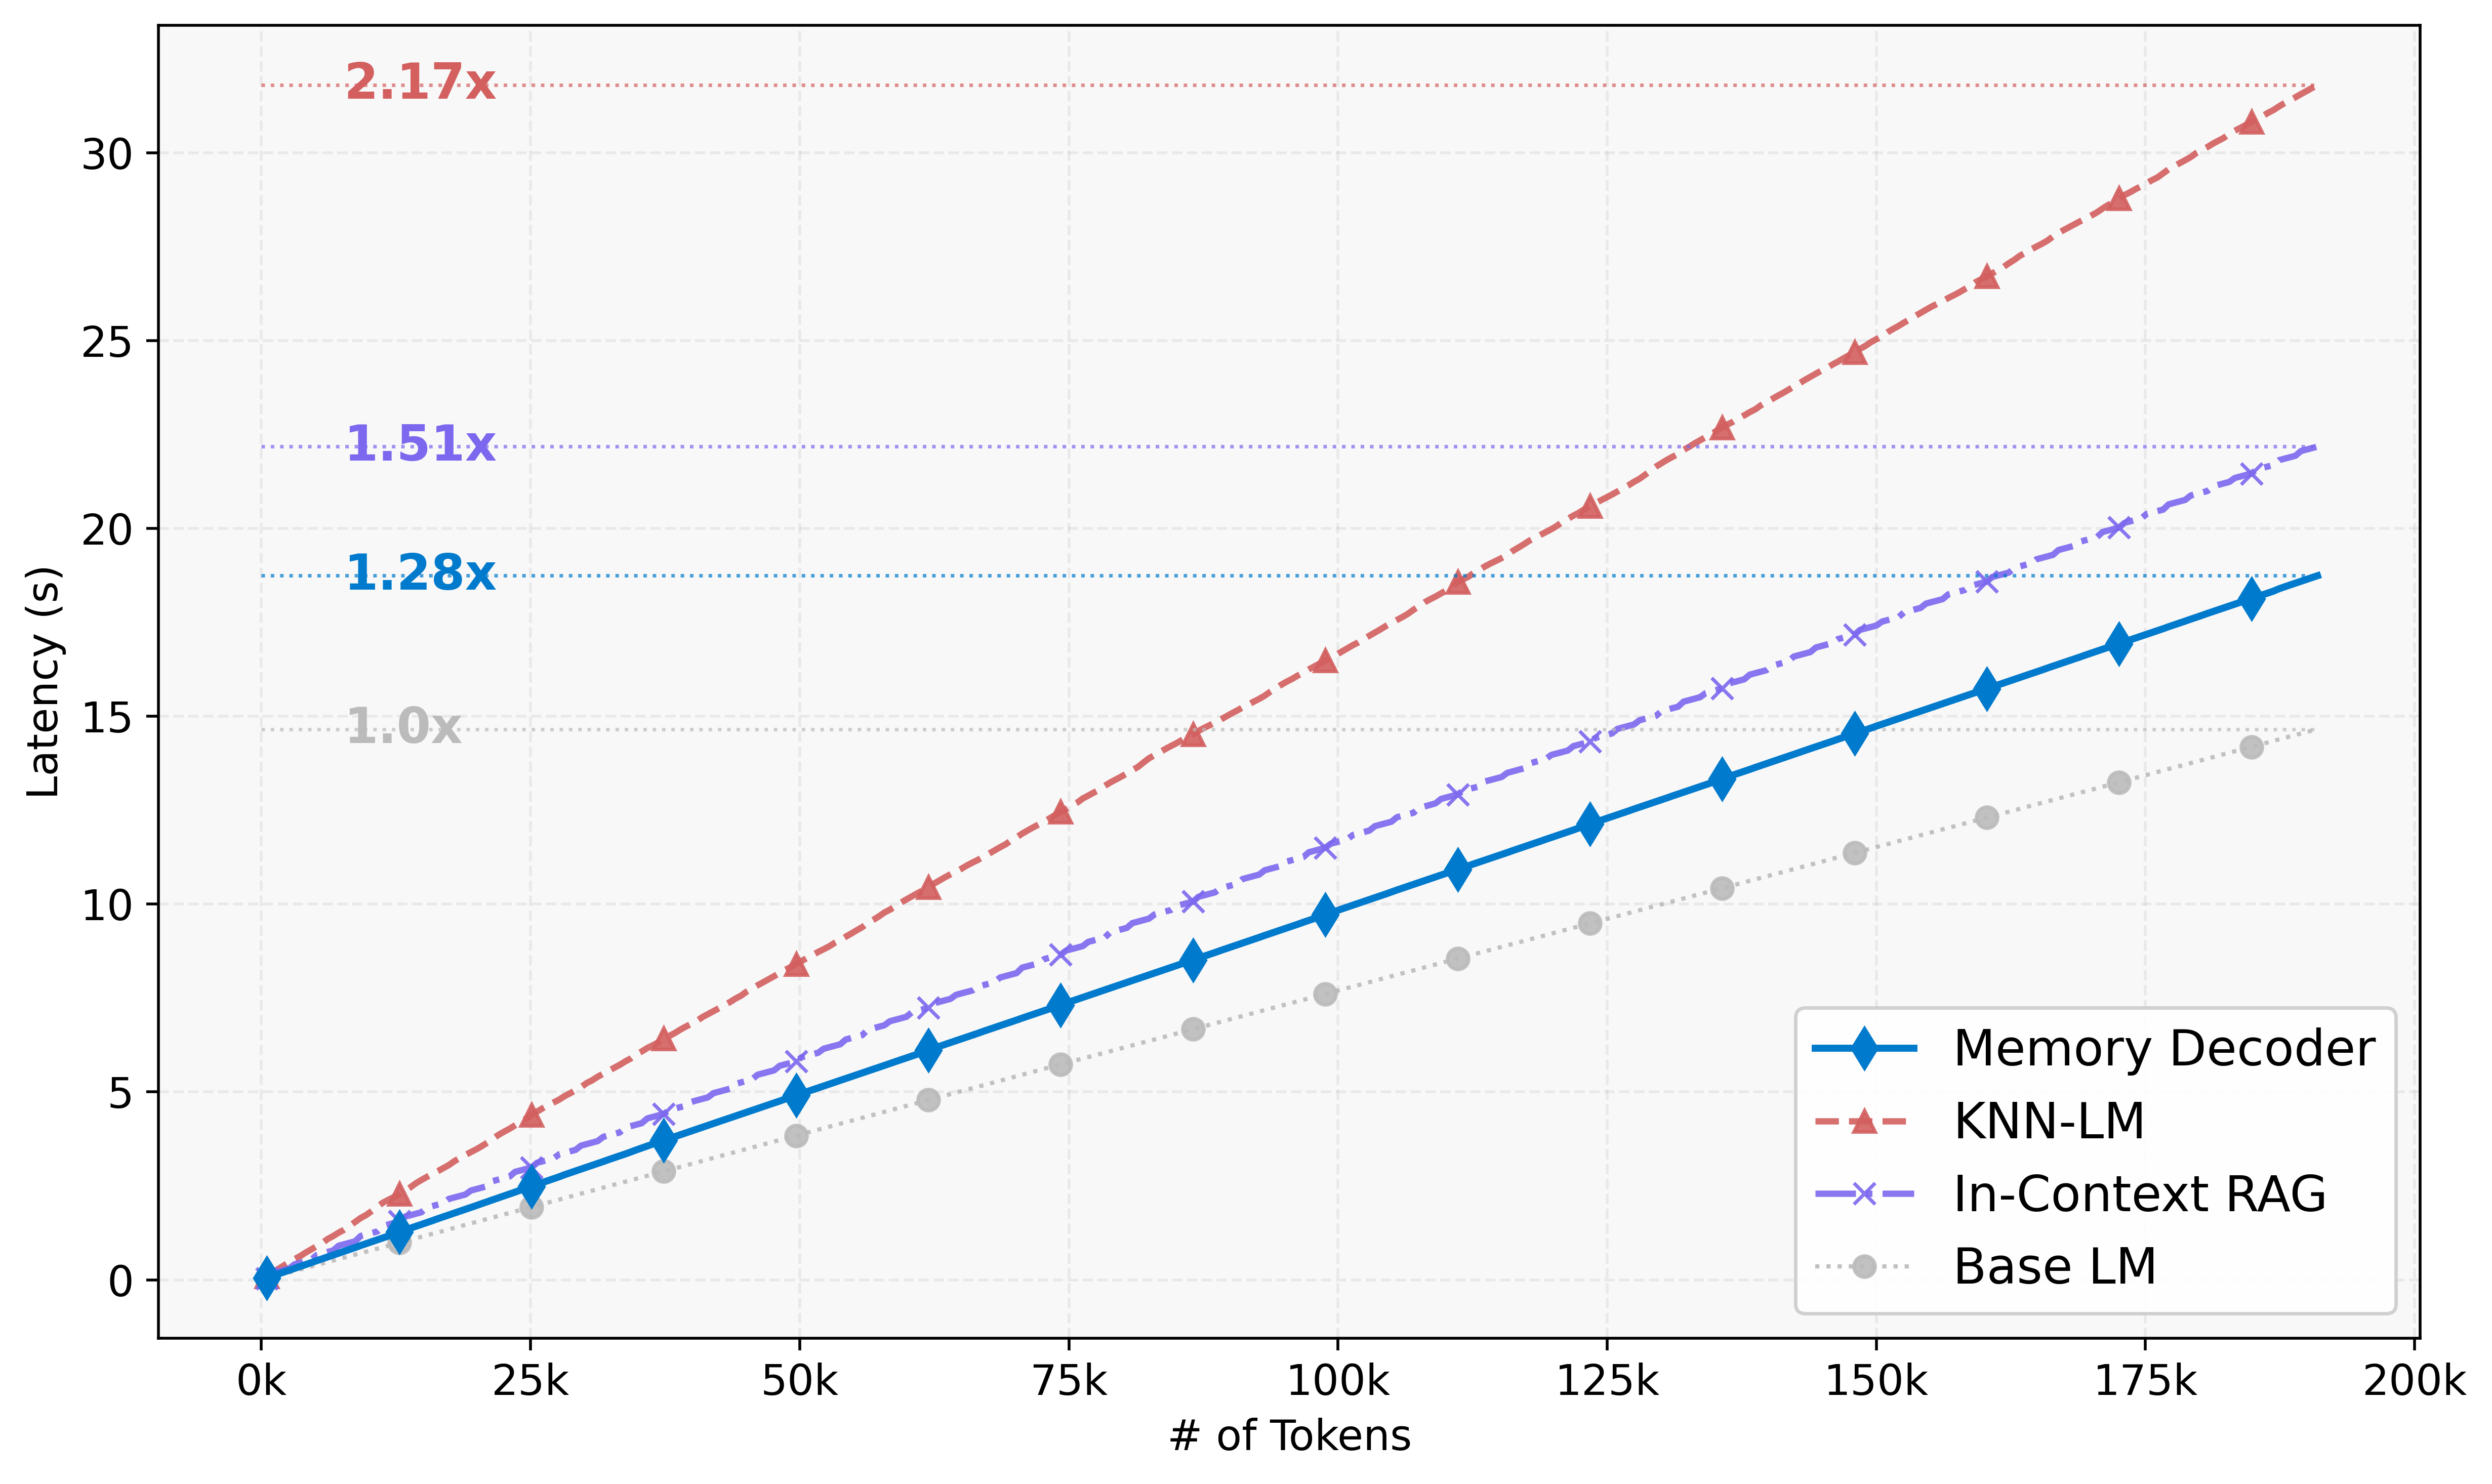
Memory Decoder: A Pretrained, Plug-and-Play Memory for Large Language ...

[R] Retentive Network: A Successor to Transformer for Large Language ...
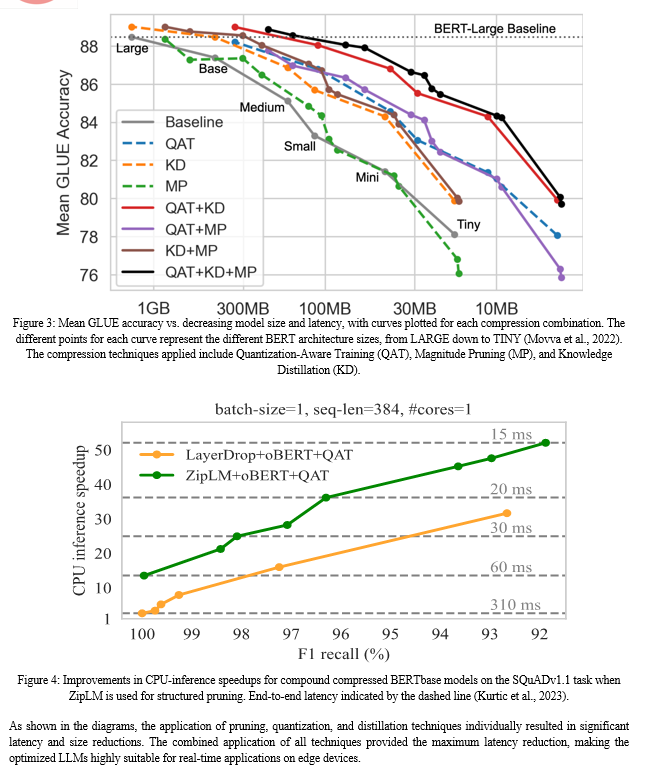
Latency-Optimized Language Model Inference in Edge Computing Environments
Advertisement Space (336x280)

Model size versus inference latency | Download Scientific Diagram

LiveMind: Low-latency Large Language Models with Simultaneous Inference ...
LiveMind: Low-latency Large Language Models with Simultaneous Inference ...
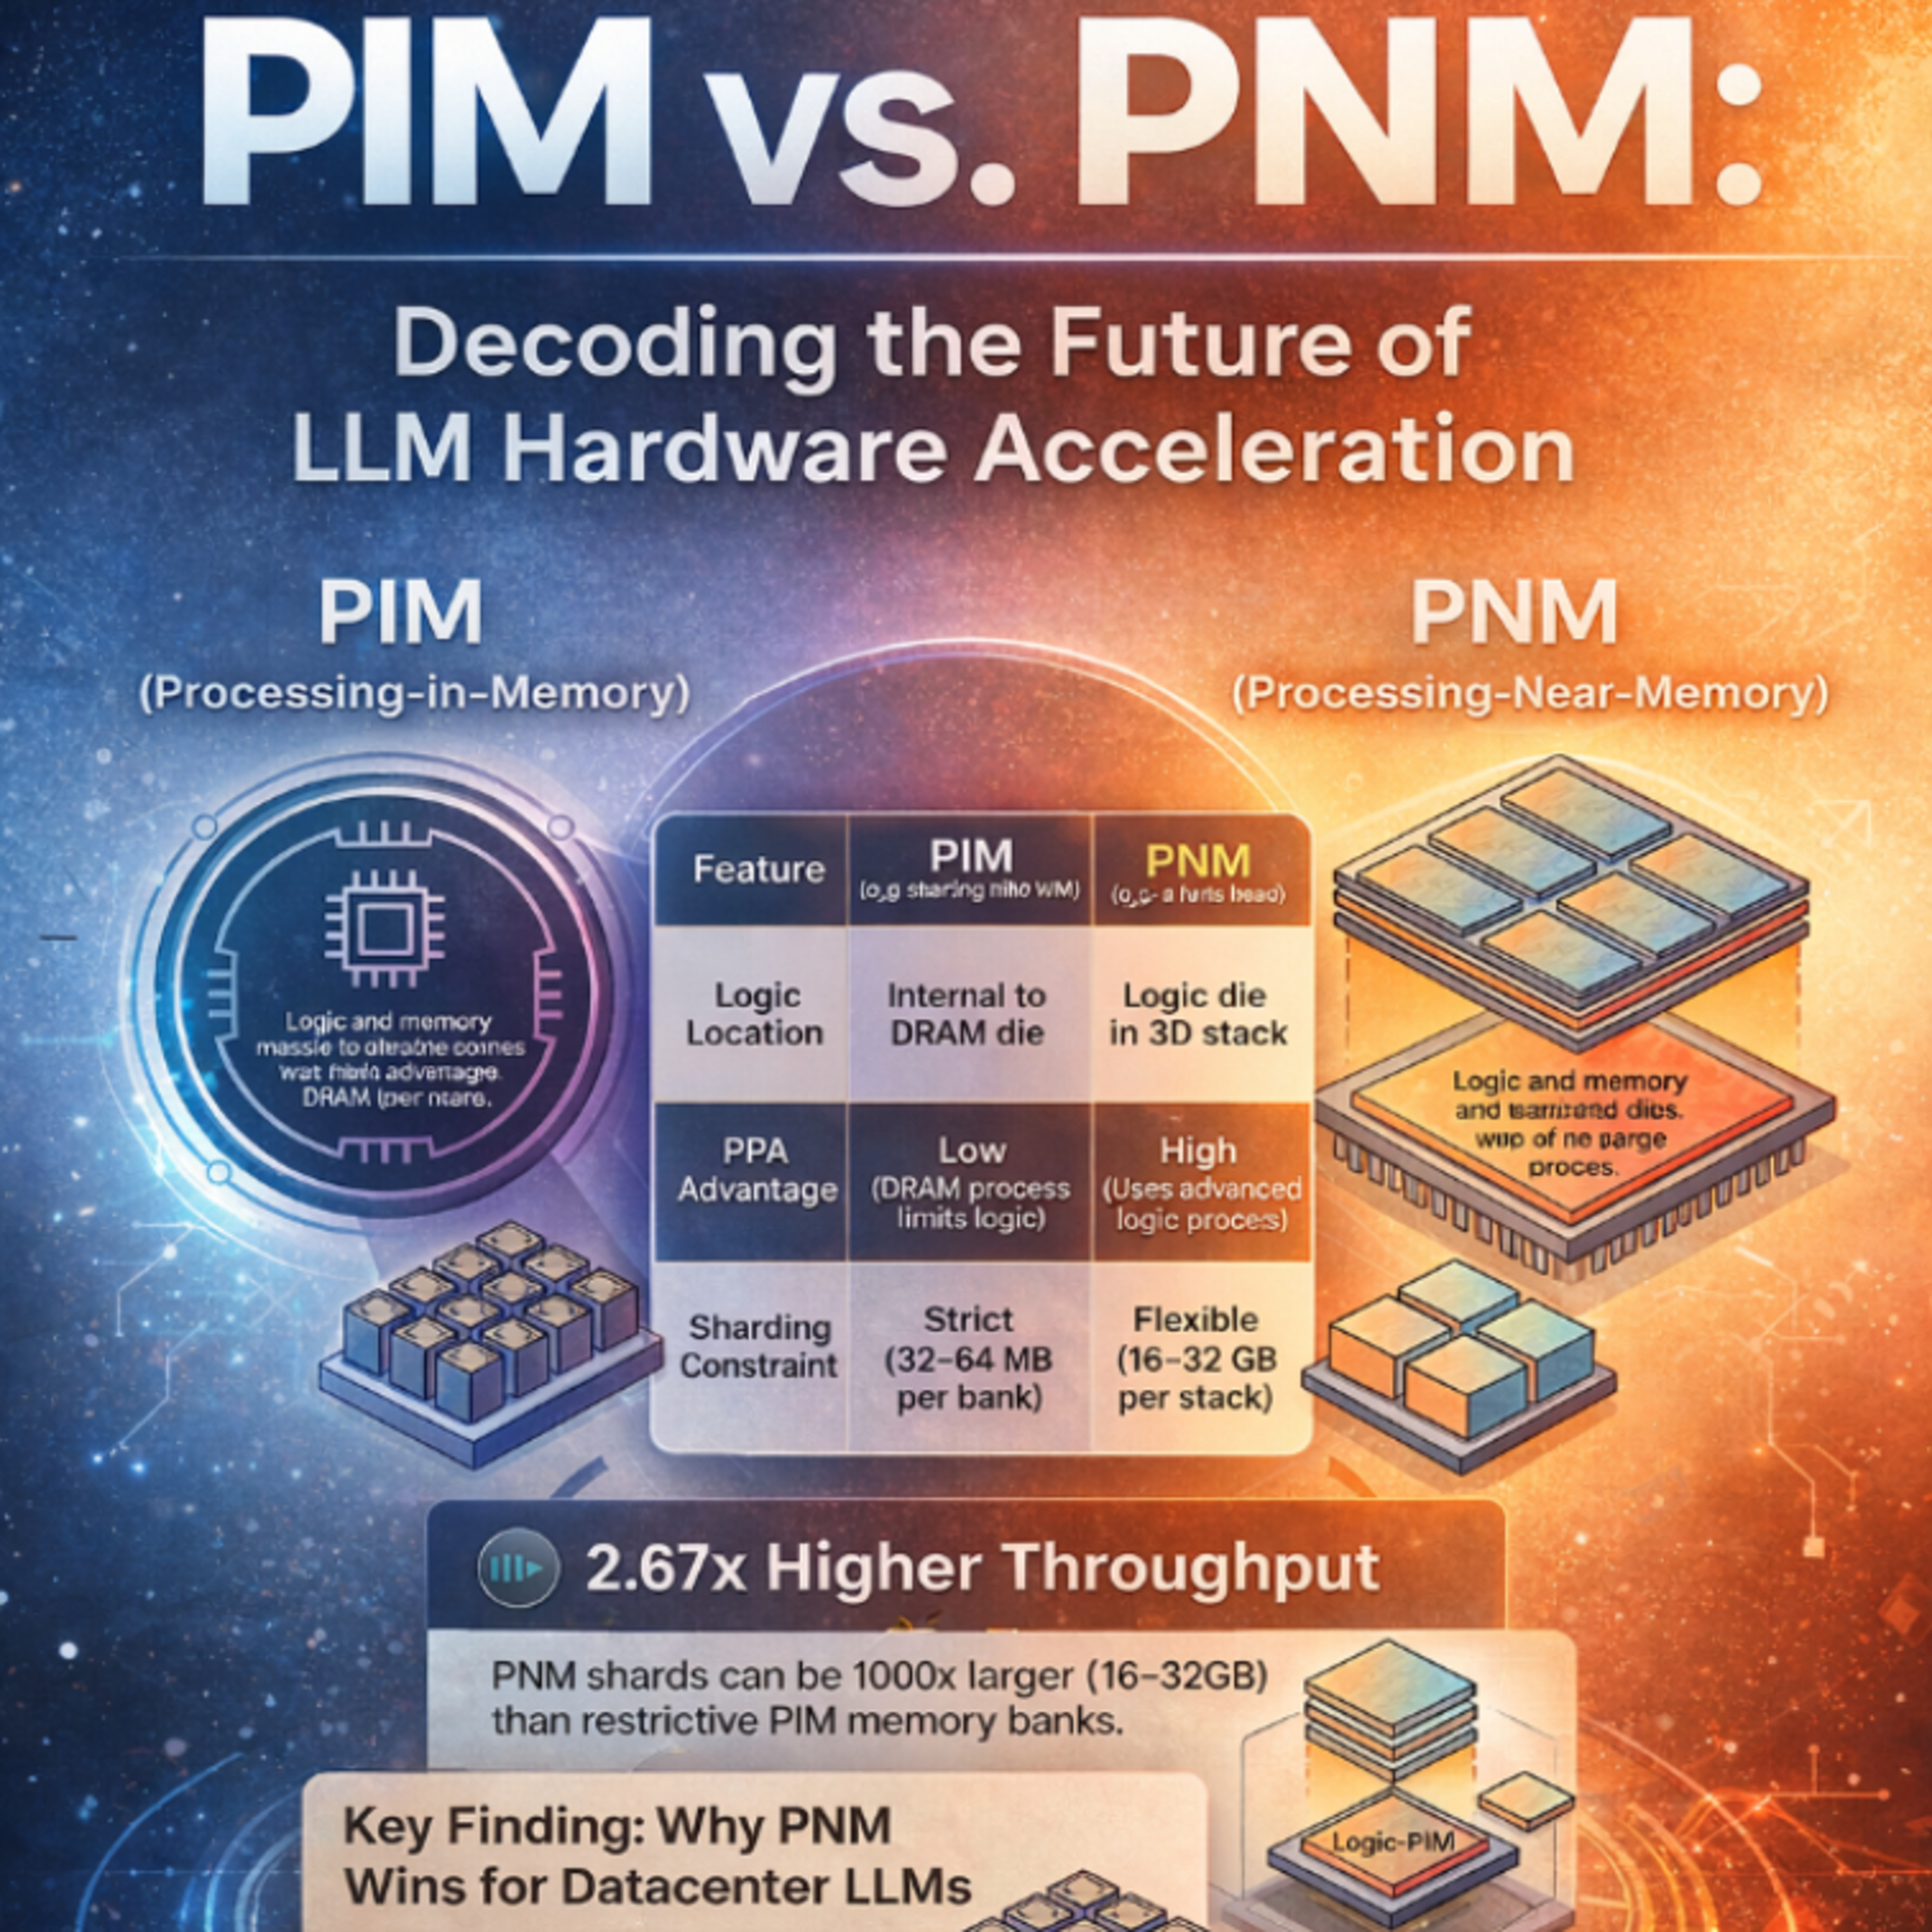
Google: R&D inference value on HBF + PNM + low latency interconnect ...

Model size versus inference latency | Download Scientific Diagram

(PDF) Unlocking Efficiency in Large Language Model Inference: A ...