
Learning Adaptive And View Invariant Vision Transformer With
Learning Adaptive and View-Invariant Vision Transformer with Multi ...

Learning Adaptive and View-Invariant Vision Transformer with Multi ...

Learning Adaptive and View-Invariant Vision Transformer with Multi ...

ICML Poster Learning Adaptive and View-Invariant Vision Transformer for ...

[2412.20002] Learning Adaptive and View-Invariant Vision Transformer ...

[Presentation] Learning Adaptive and View-Invariant Vision Transformer ...

[2412.20002] Learning Adaptive and View-Invariant Vision Transformer ...

[2412.20002] Learning Adaptive and View-Invariant Vision Transformer ...

[2412.20002] Learning Adaptive and View-Invariant Vision Transformer ...

Learning Adaptive and View-Invariant Vision Transformer for Real-Time ...
Advertisement Space (300x250)

[2412.20002] Learning Adaptive and View-Invariant Vision Transformer ...

[2412.20002] Learning Adaptive and View-Invariant Vision Transformer ...

[2412.20002] Learning Adaptive and View-Invariant Vision Transformer ...

[2412.20002] Learning Adaptive and View-Invariant Vision Transformer ...

[2412.20002] Learning Adaptive and View-Invariant Vision Transformer ...

Residual Vision Transformer and Adaptive Fusion Autoencoders for ...
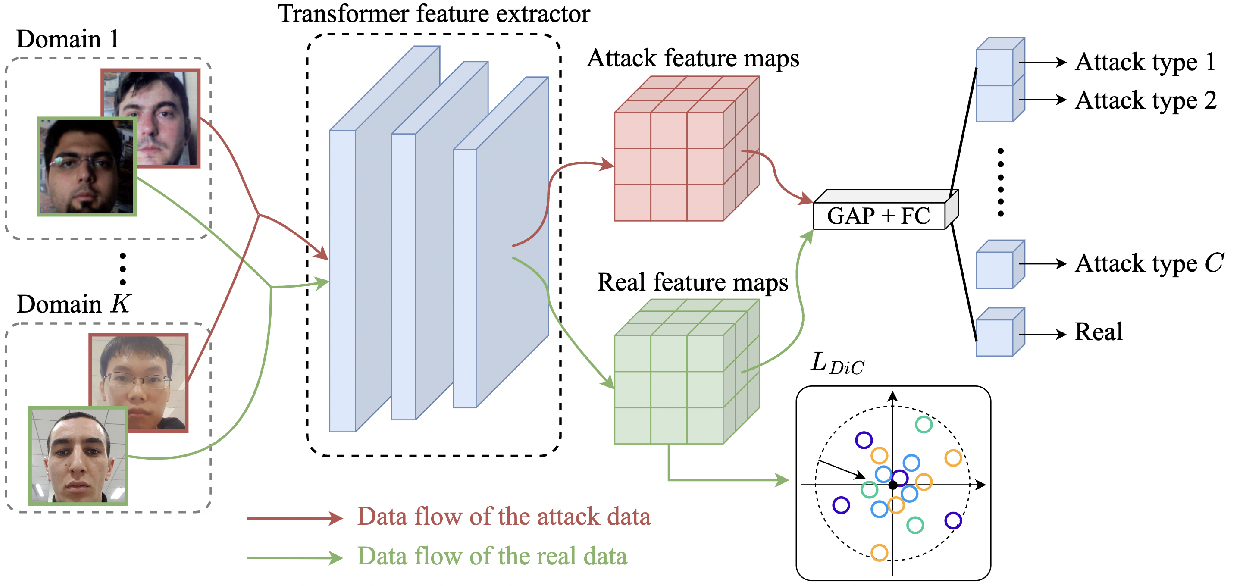
Figure 1 from Domain Invariant Vision Transformer Learning for Face ...
GitHub - wuyou3474/AVTrack: [ICML 2024] Learning Adaptive and View ...

Figure 1 from Token Adaptive Vision Transformer with Efficient ...

Improving Reinforcement Learning with Expert Demonstrations and Vision ...
Advertisement Space (336x280)

Figure 4 from Vision Transformer With Contrastive Learning for Remote ...
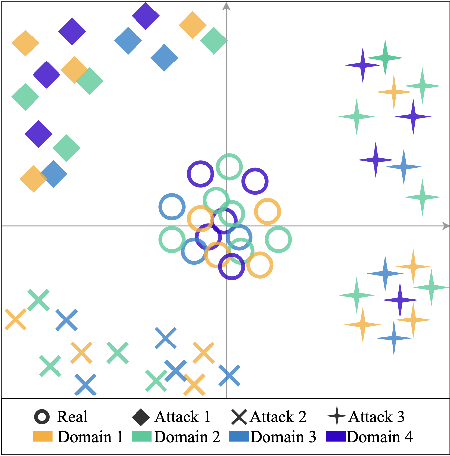
Figure 1 from Domain Invariant Vision Transformer Learning for Face ...
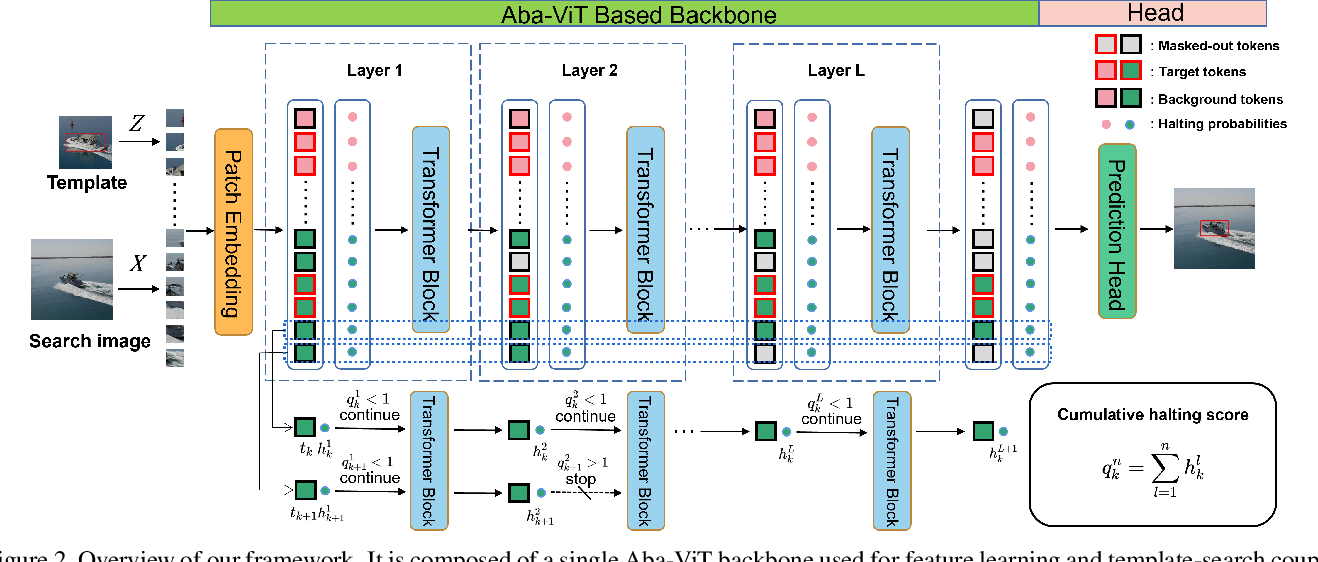
Figure 2 from Adaptive and Background-Aware Vision Transformer for Real ...

Vision Transformer Adapters for Generalizable Multitask Learning

Vision Transformer Customized for Environment Detection and Collision ...

Figure 1 from Online Continual Learning with Contrastive Vision ...

Accelerating Domain Adaptation with Cascaded Adaptive Vision ...

Vision Transformer Model: Architecture, development and applications

Vision Transformer Adapters for Generalizable Multitask Learning | DeepAI
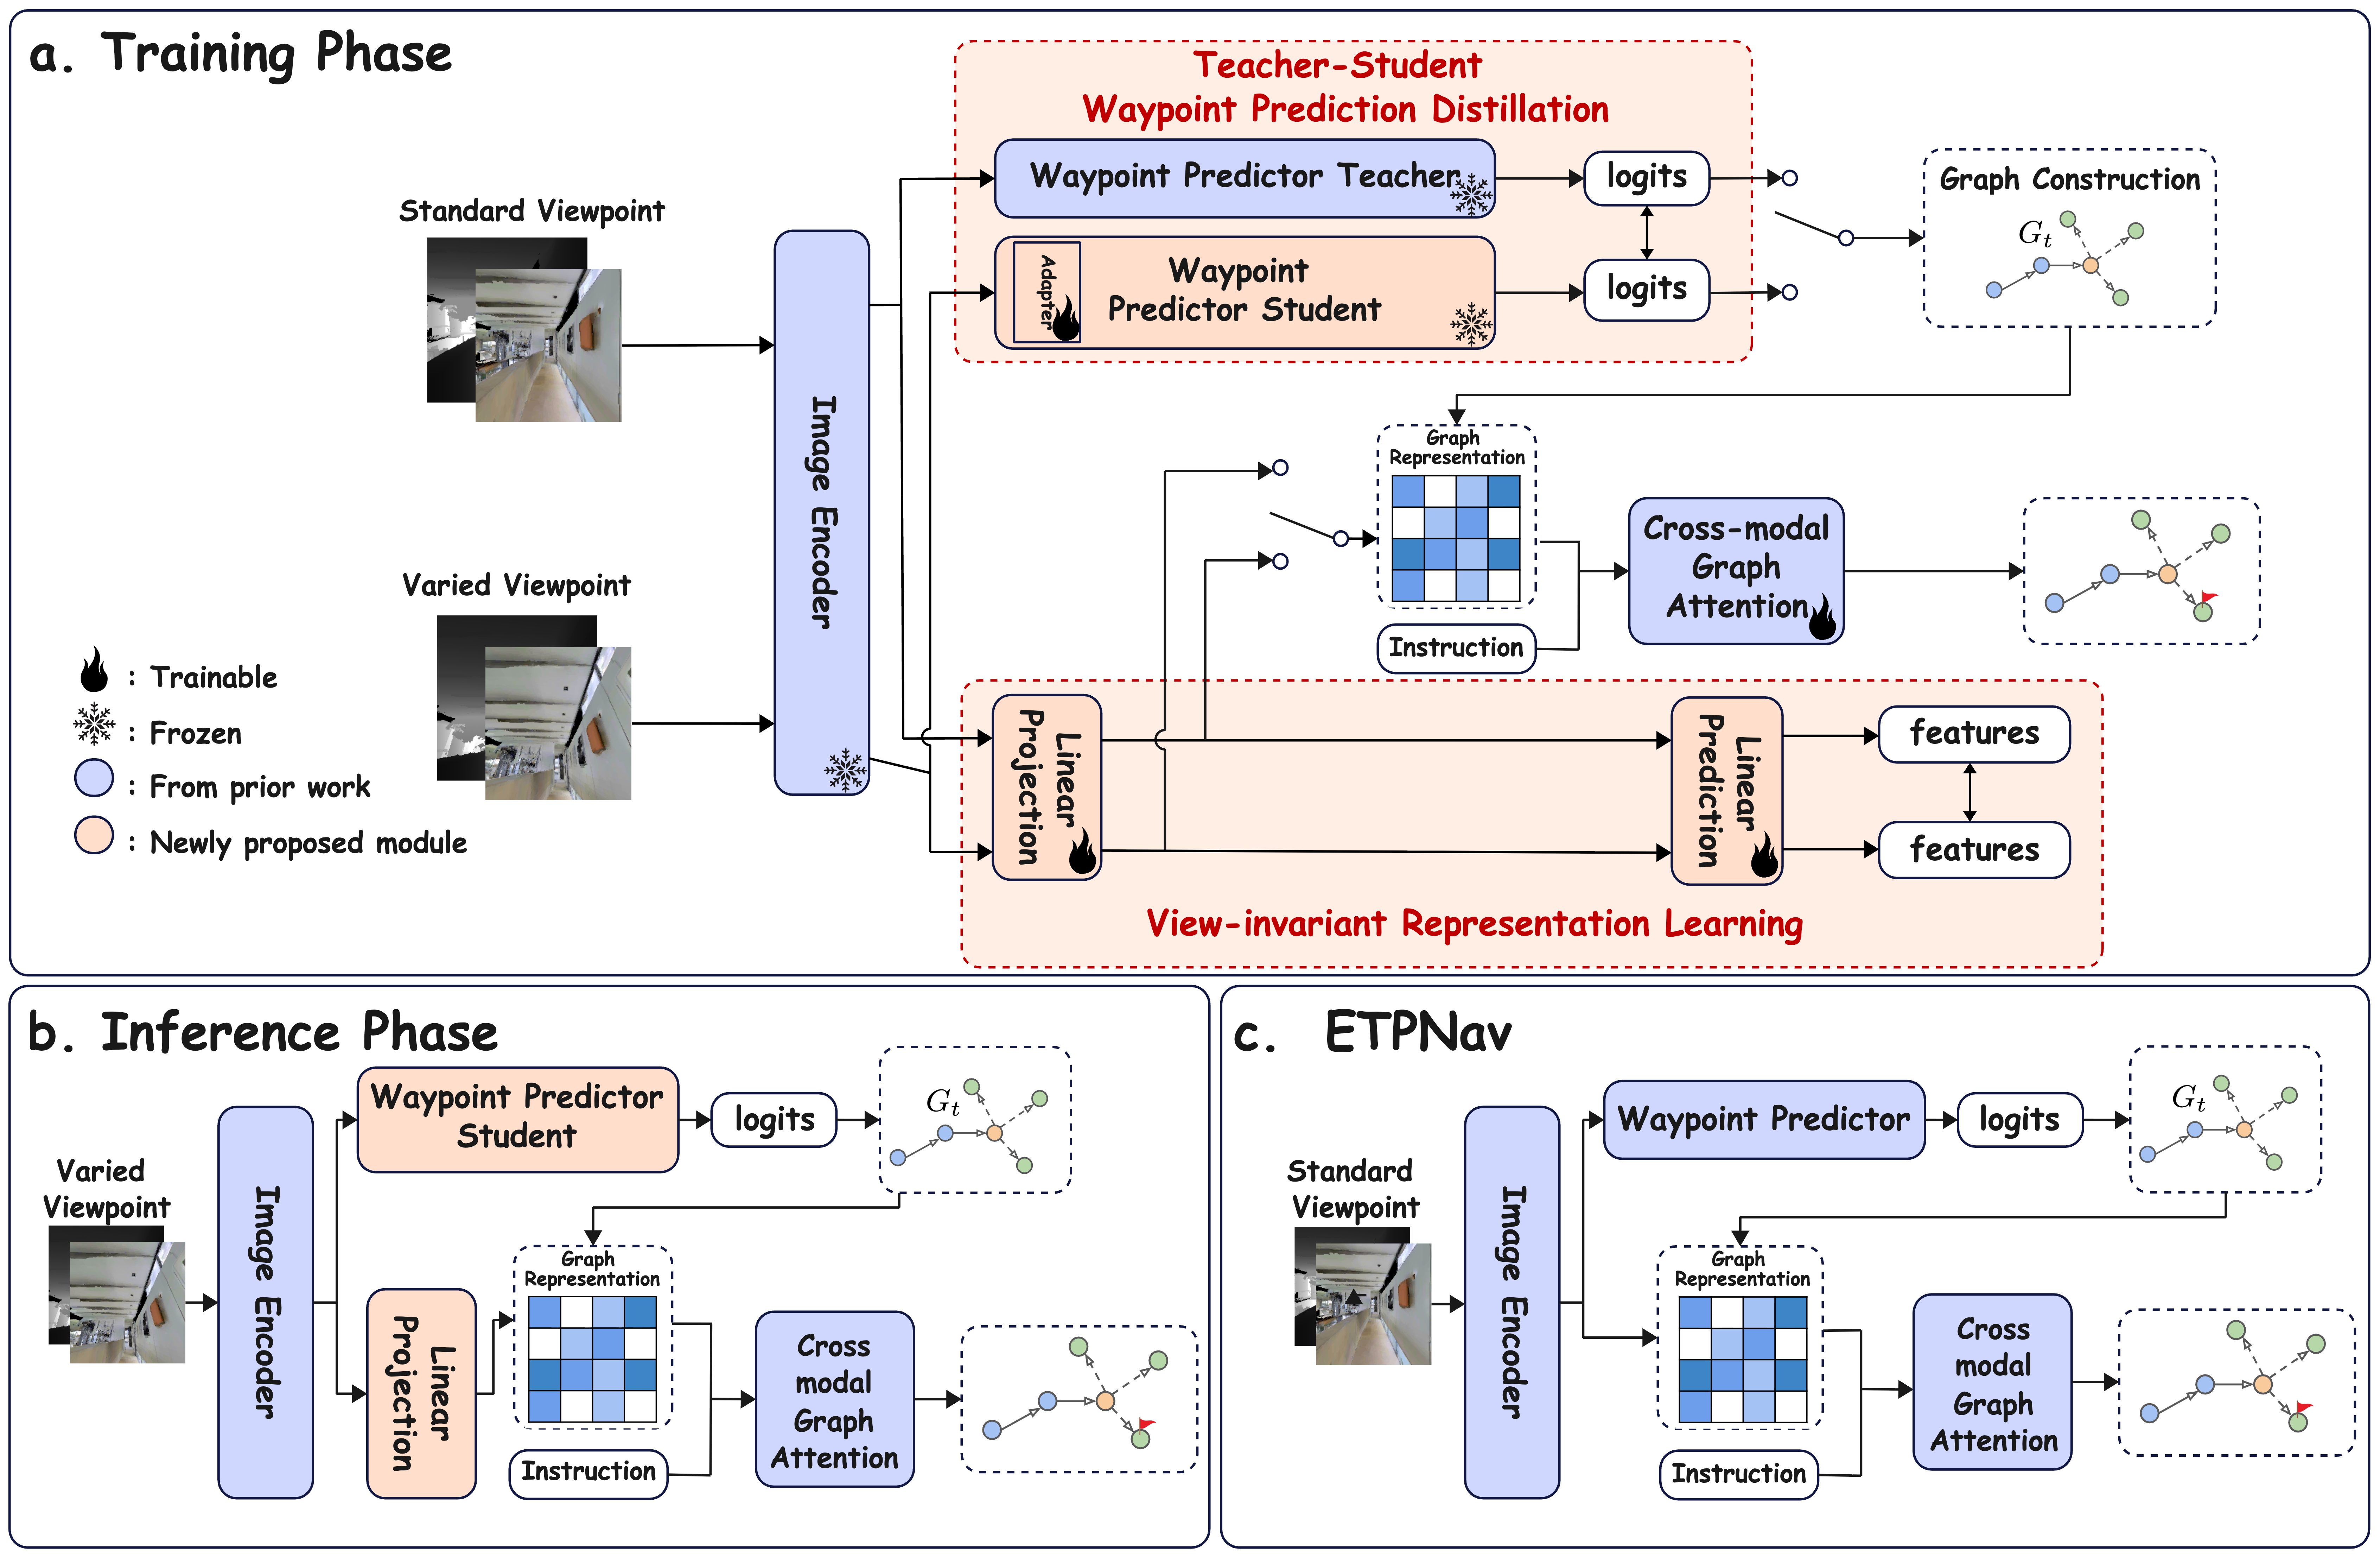
View Invariant Learning for Vision-Language Navigation in Continuous ...
Advertisement Space (336x280)

How to build a Vision Transformer Model (Vit) and Implement it?

Vision Transformer Adapters for Generalizable Multitask Learning
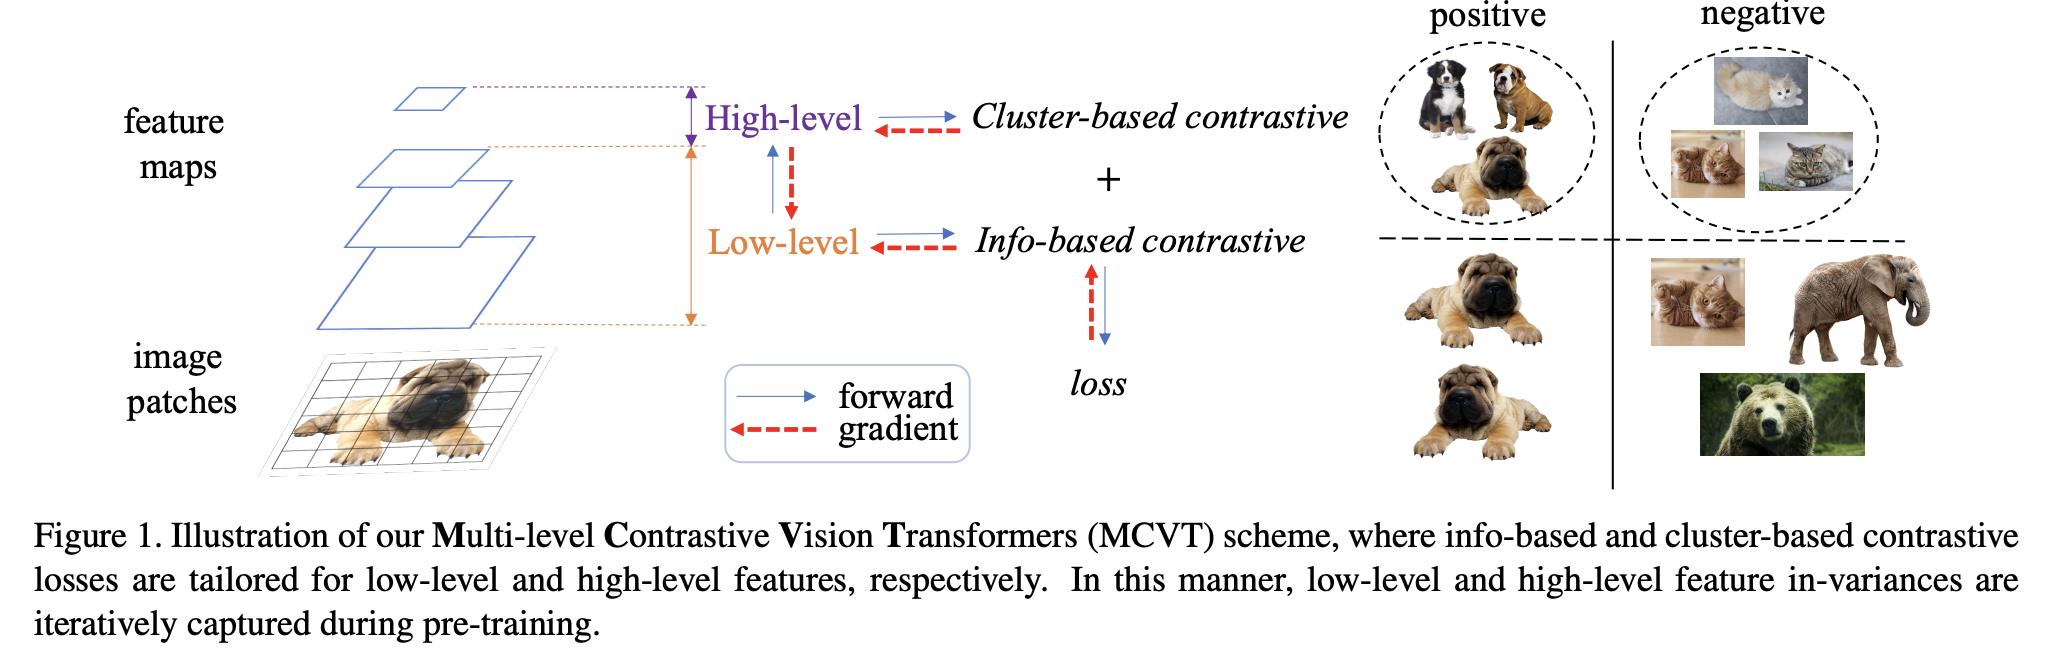
Self-Supervised Leaning with Vision Transformer

Leveraging Adaptive Vision Transformers Features Fusion and Machine ...

Dmg2Former-AR: Vision Transformers with Adaptive Rescaling for High ...

Adaptive Layer Selection for Efficient Vision Transformer Fine-Tuning ...