
Paper Page Pptc Benchmark Evaluating Large Language Models For

Paper page - A User-Centric Benchmark for Evaluating Large Language Models

Paper page - VerilogEval: Evaluating Large Language Models for Verilog ...

PPTC Benchmark: Evaluating Large Language Models for PowerPoint Task ...

Paper page - LTD-Bench: Evaluating Large Language Models by Letting ...

PPTC Benchmark: Evaluating Large Language Models for PowerPoint Task ...

Paper page - PlanBench: An Extensible Benchmark for Evaluating Large ...

Paper page - DesignQA: A Multimodal Benchmark for Evaluating Large ...

Paper page - Evaluating Large Language Models on Time Series Feature ...

Paper page - Benchmarking Benchmark Leakage in Large Language Models

Paper page - Evaluating Large Language Models at Evaluating Instruction ...
Advertisement Space (300x250)

PPTC Benchmark: Evaluating Large Language Models for PowerPoint Task ...

(PDF) RealFactBench: A Benchmark for Evaluating Large Language Models ...

(PDF) AdaptEval: A Benchmark for Evaluating Large Language Models on ...
Paper page - Instruction-Following Evaluation for Large Language Models
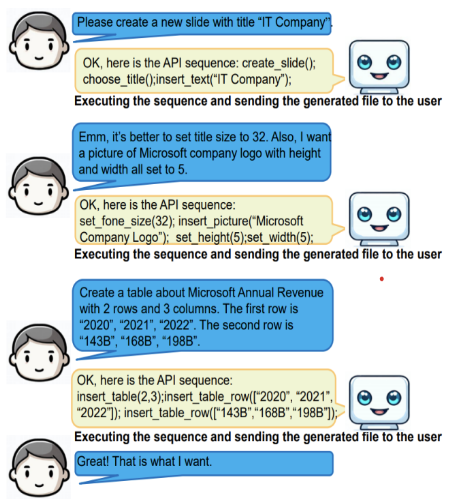
[2311.01767] PPTC Benchmark: Evaluating Large Language Models for ...

Paper page - LoCoBench: A Benchmark for Long-Context Large Language ...

Paper page - PM-LLM-Benchmark: Evaluating Large Language Models on ...
LLMsPark: A Benchmark for Evaluating Large Language Models in Strategic ...

Paper page - RAD-Bench: Evaluating Large Language Models Capabilities ...

Paper page - AdaptEval: Evaluating Large Language Models on Domain ...
Advertisement Space (336x280)

Paper page - PCA-Bench: Evaluating Multimodal Large Language Models in ...

Paper page - IdeaBench: Benchmarking Large Language Models for Research ...

Paper page - VGBench: Evaluating Large Language Models on Vector ...

Paper page - Evaluating Large Language Models in Theory of Mind Tasks

Paper page - RxnBench: A Multimodal Benchmark for Evaluating Large ...

Paper page - Benchmarking Large Language Models for Multi-Language ...

Paper page - ToolHop: A Query-Driven Benchmark for Evaluating Large ...

Paper page - PriceSeer: Evaluating Large Language Models in Real-Time ...

EMPEC: A Comprehensive Benchmark for Evaluating Large Language Models ...

AdaptEval: A Benchmark for Evaluating Large Language Models on Code ...
Advertisement Space (336x280)

Paper page - Evaluating Large Language Models on the GMAT: Implications ...

Harsh Joshi on LinkedIn: Paper page - PPTC Benchmark: Evaluating Large ...

Developing a Scalable Benchmark for Assessing Large Language Models in ...

Paper page - RoleEval: A Bilingual Role Evaluation Benchmark for Large ...

NovBench: Evaluating Large Language Models on Academic Paper Novelty ...
GitHub - gydpku/PPTC: PPTC Benchmark: Evaluating Large Language Models ...