
Speculative Diffusion Decoding Accelerating Language

Speculative Diffusion Decoding: Accelerating Language Generation ...
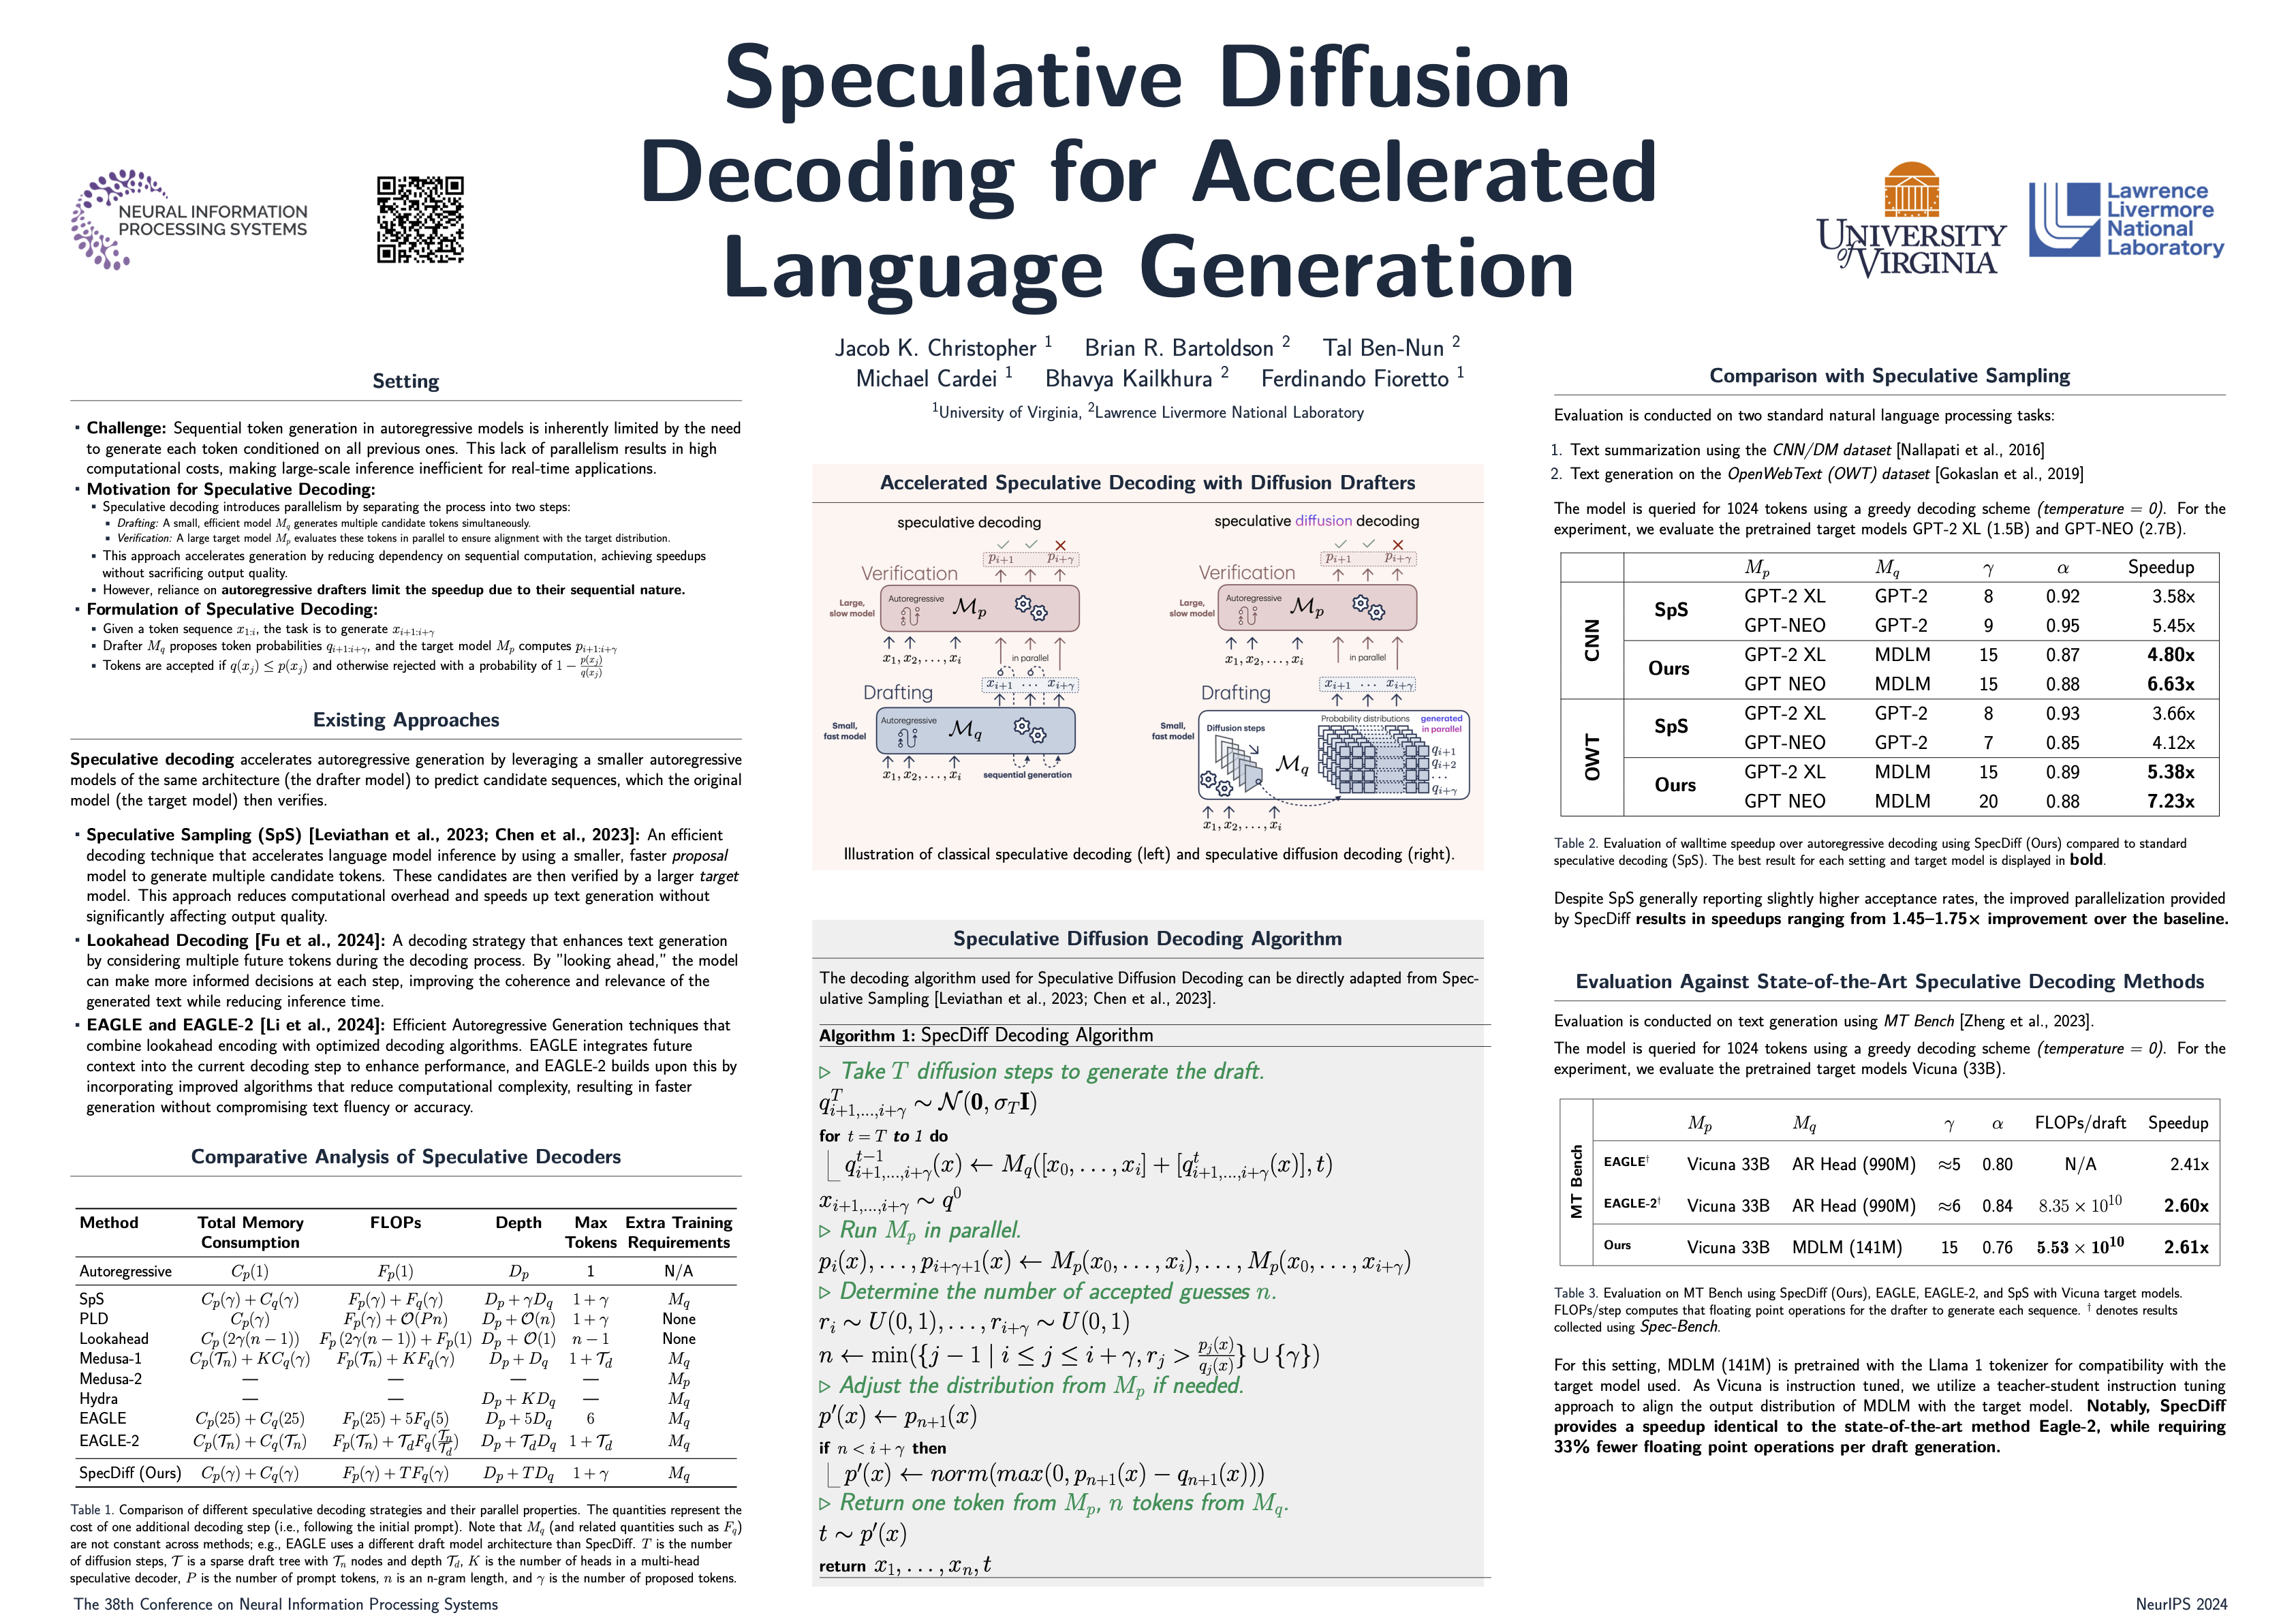
NeurIPS Speculative Diffusion Decoding for Accelerated Language Generation

Speculative Diffusion Decoding: Accelerating Language Generation ...

Speculative Diffusion Decoding: Accelerating Language Generation ...
Speculative Diffusion Decoding: Accelerating Language Generation ...

Paper page - Speculative Diffusion Decoding: Accelerating Language ...

SimSD: Simple Speculative Decoding in Diffusion Language Models | AI ...

Paper page - Self Speculative Decoding for Diffusion Large Language Models

(PDF) Accelerating Large Language Model Decoding with Speculative Sampling

Self Speculative Decoding for Diffusion Large Language Models | AI ...
Advertisement Space (300x250)

SimSD: Simple Speculative Decoding in Diffusion Language Models

Paper page - Accelerating Speculative Decoding with Block Diffusion ...
Accelerating Speculative Decoding with Block Diffusion Draft Trees ...
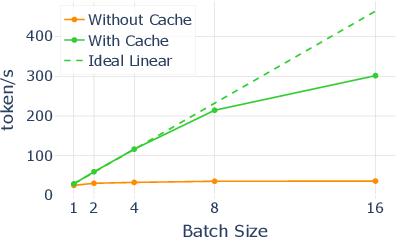
Figure 1 from Self Speculative Decoding for Diffusion Large Language ...
Accelerating Speculative Decoding with Block Diffusion Draft Trees ...
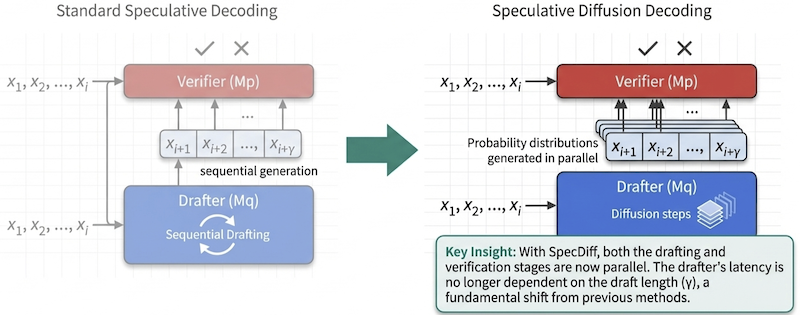
Massively Speeding up LLM inference with Speculative Diffusion Decoding ...

Speculative Decoding - Making Language Models Generate Faster Without ...
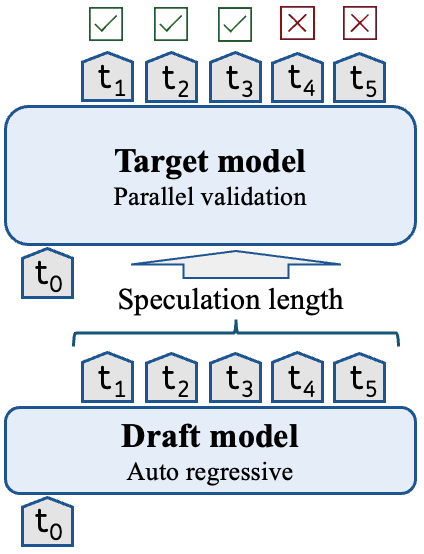
Accelerating Speculative Decoding using Dynamic Speculation Length | Home
DFlash: Block Diffusion for Flash Speculative Decoding

Paper page - Accelerating Large Language Model Decoding with ...
Advertisement Space (336x280)
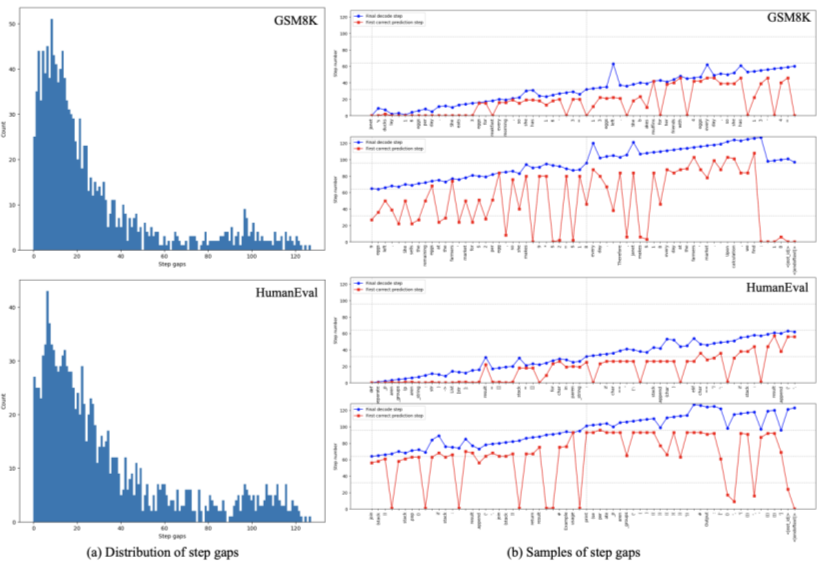
[논문 리뷰] Learning to Parallel: Accelerating Diffusion Large Language ...

Paper page - Accelerating Speculative Decoding using Dynamic ...

LogitSpec: Accelerating Retrieval-based Speculative Decoding via Next ...
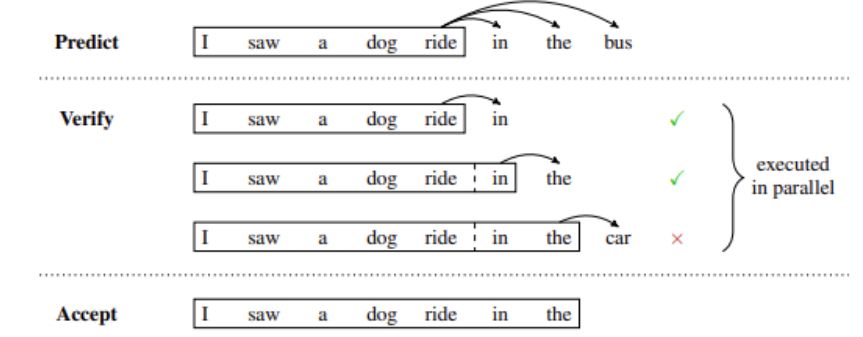
Speculative Decoding: Accelerating Language Model Inference | Sagar ...
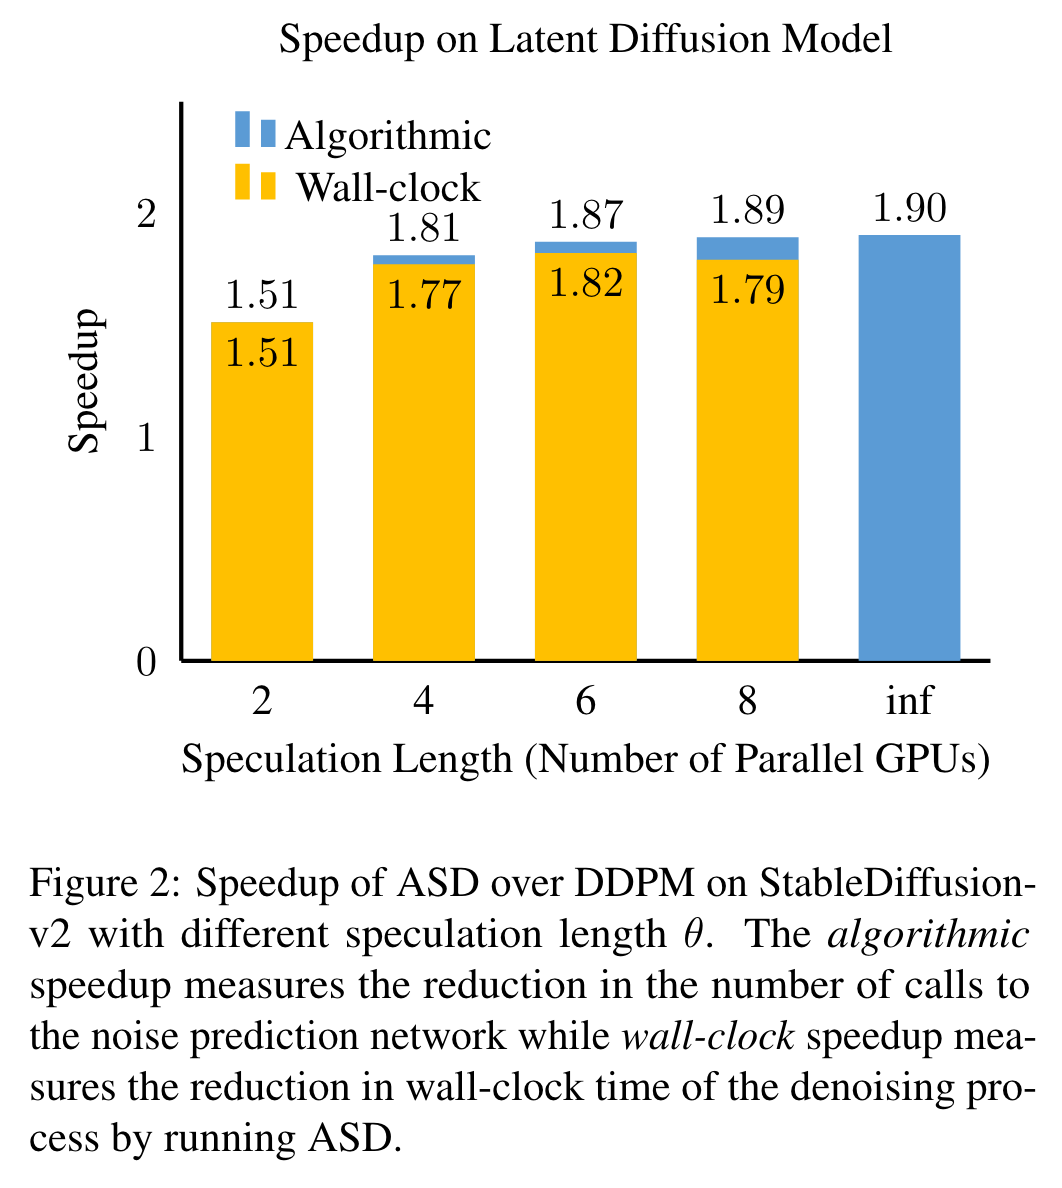
聊聊 Speculative Decoding 加速 Diffusion Models - 知乎

Paper page - Locally Coherent Parallel Decoding in Diffusion Language ...
Diffusion and Speculative Decoding | ai-dynamo/dynamo | DeepWiki

AdaSD: Adaptive Speculative Decoding for Efficient Language Model Inference

Paper page - On Speculative Decoding for Multimodal Large Language Models

Accelerating Speculative Decoding using Dynamic Speculation Length
Advertisement Space (336x280)
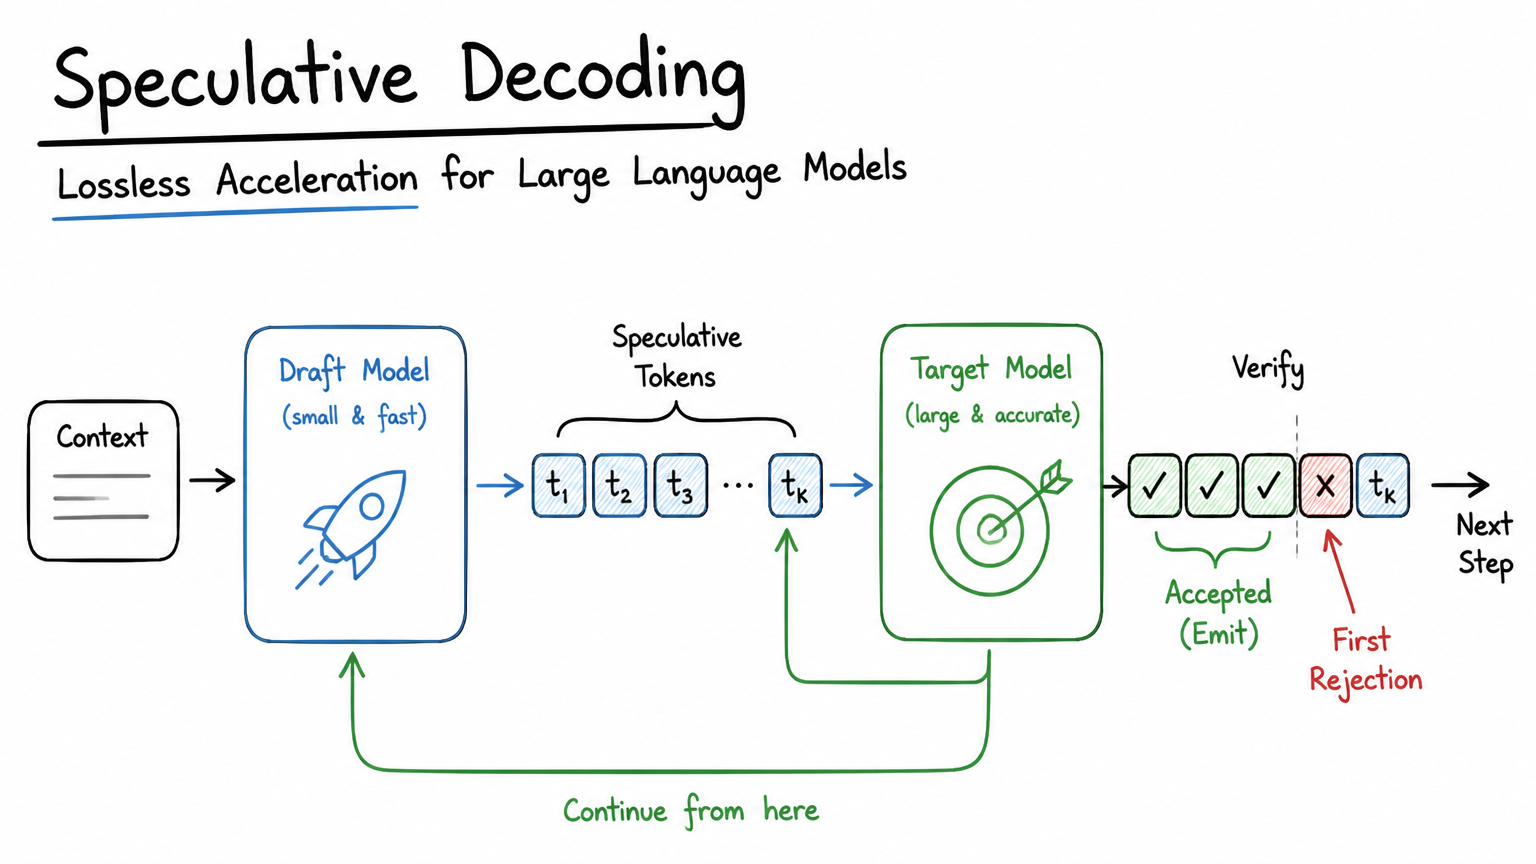
Speculative Decoding: Lossless Acceleration for Large Language Models ...
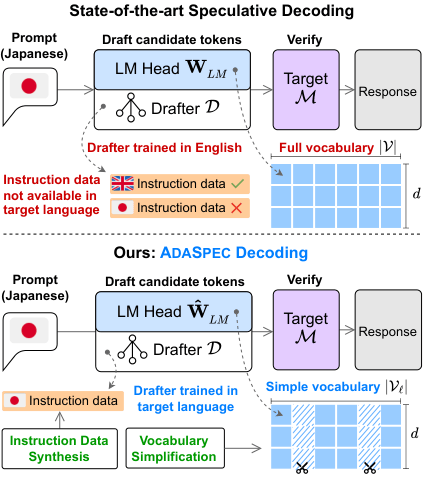
Nguyen Lab's Speculative Decoding Research Group
Accelerating Whisper Inference with Speculative Decoding: Doubling ...
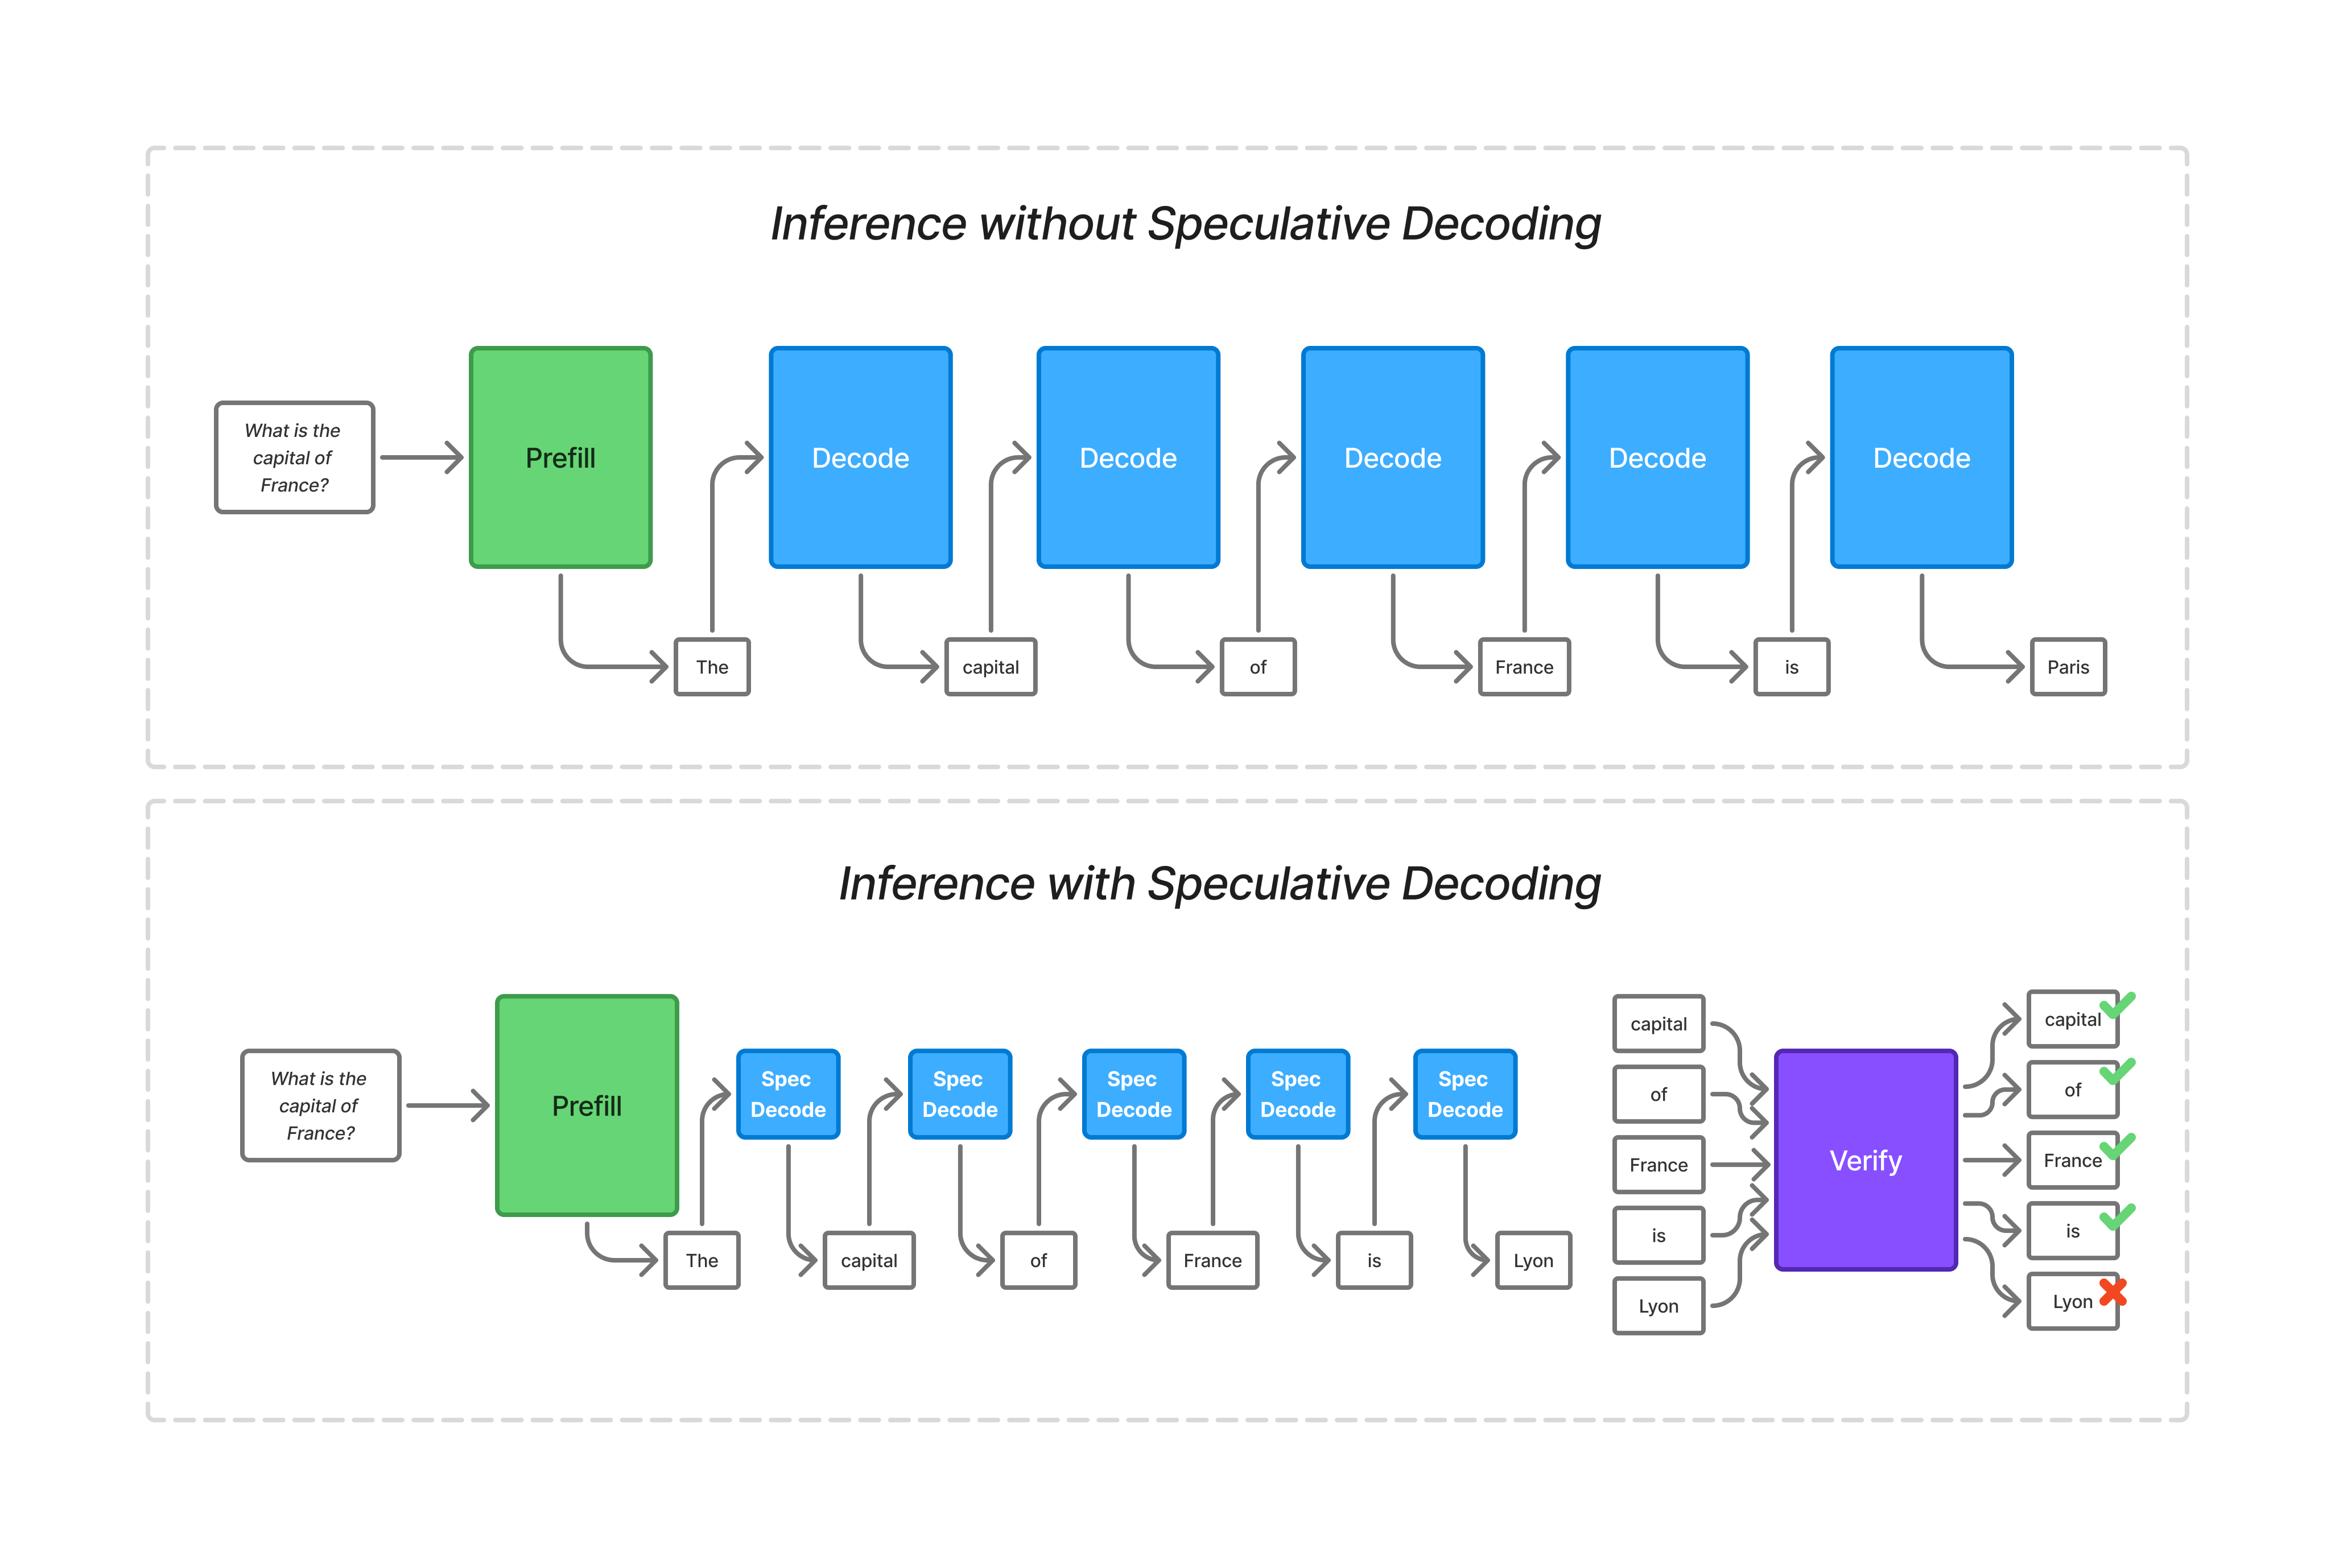
Low-Latency Inference with Speculative Decoding on d-Matrix Corsair and ...
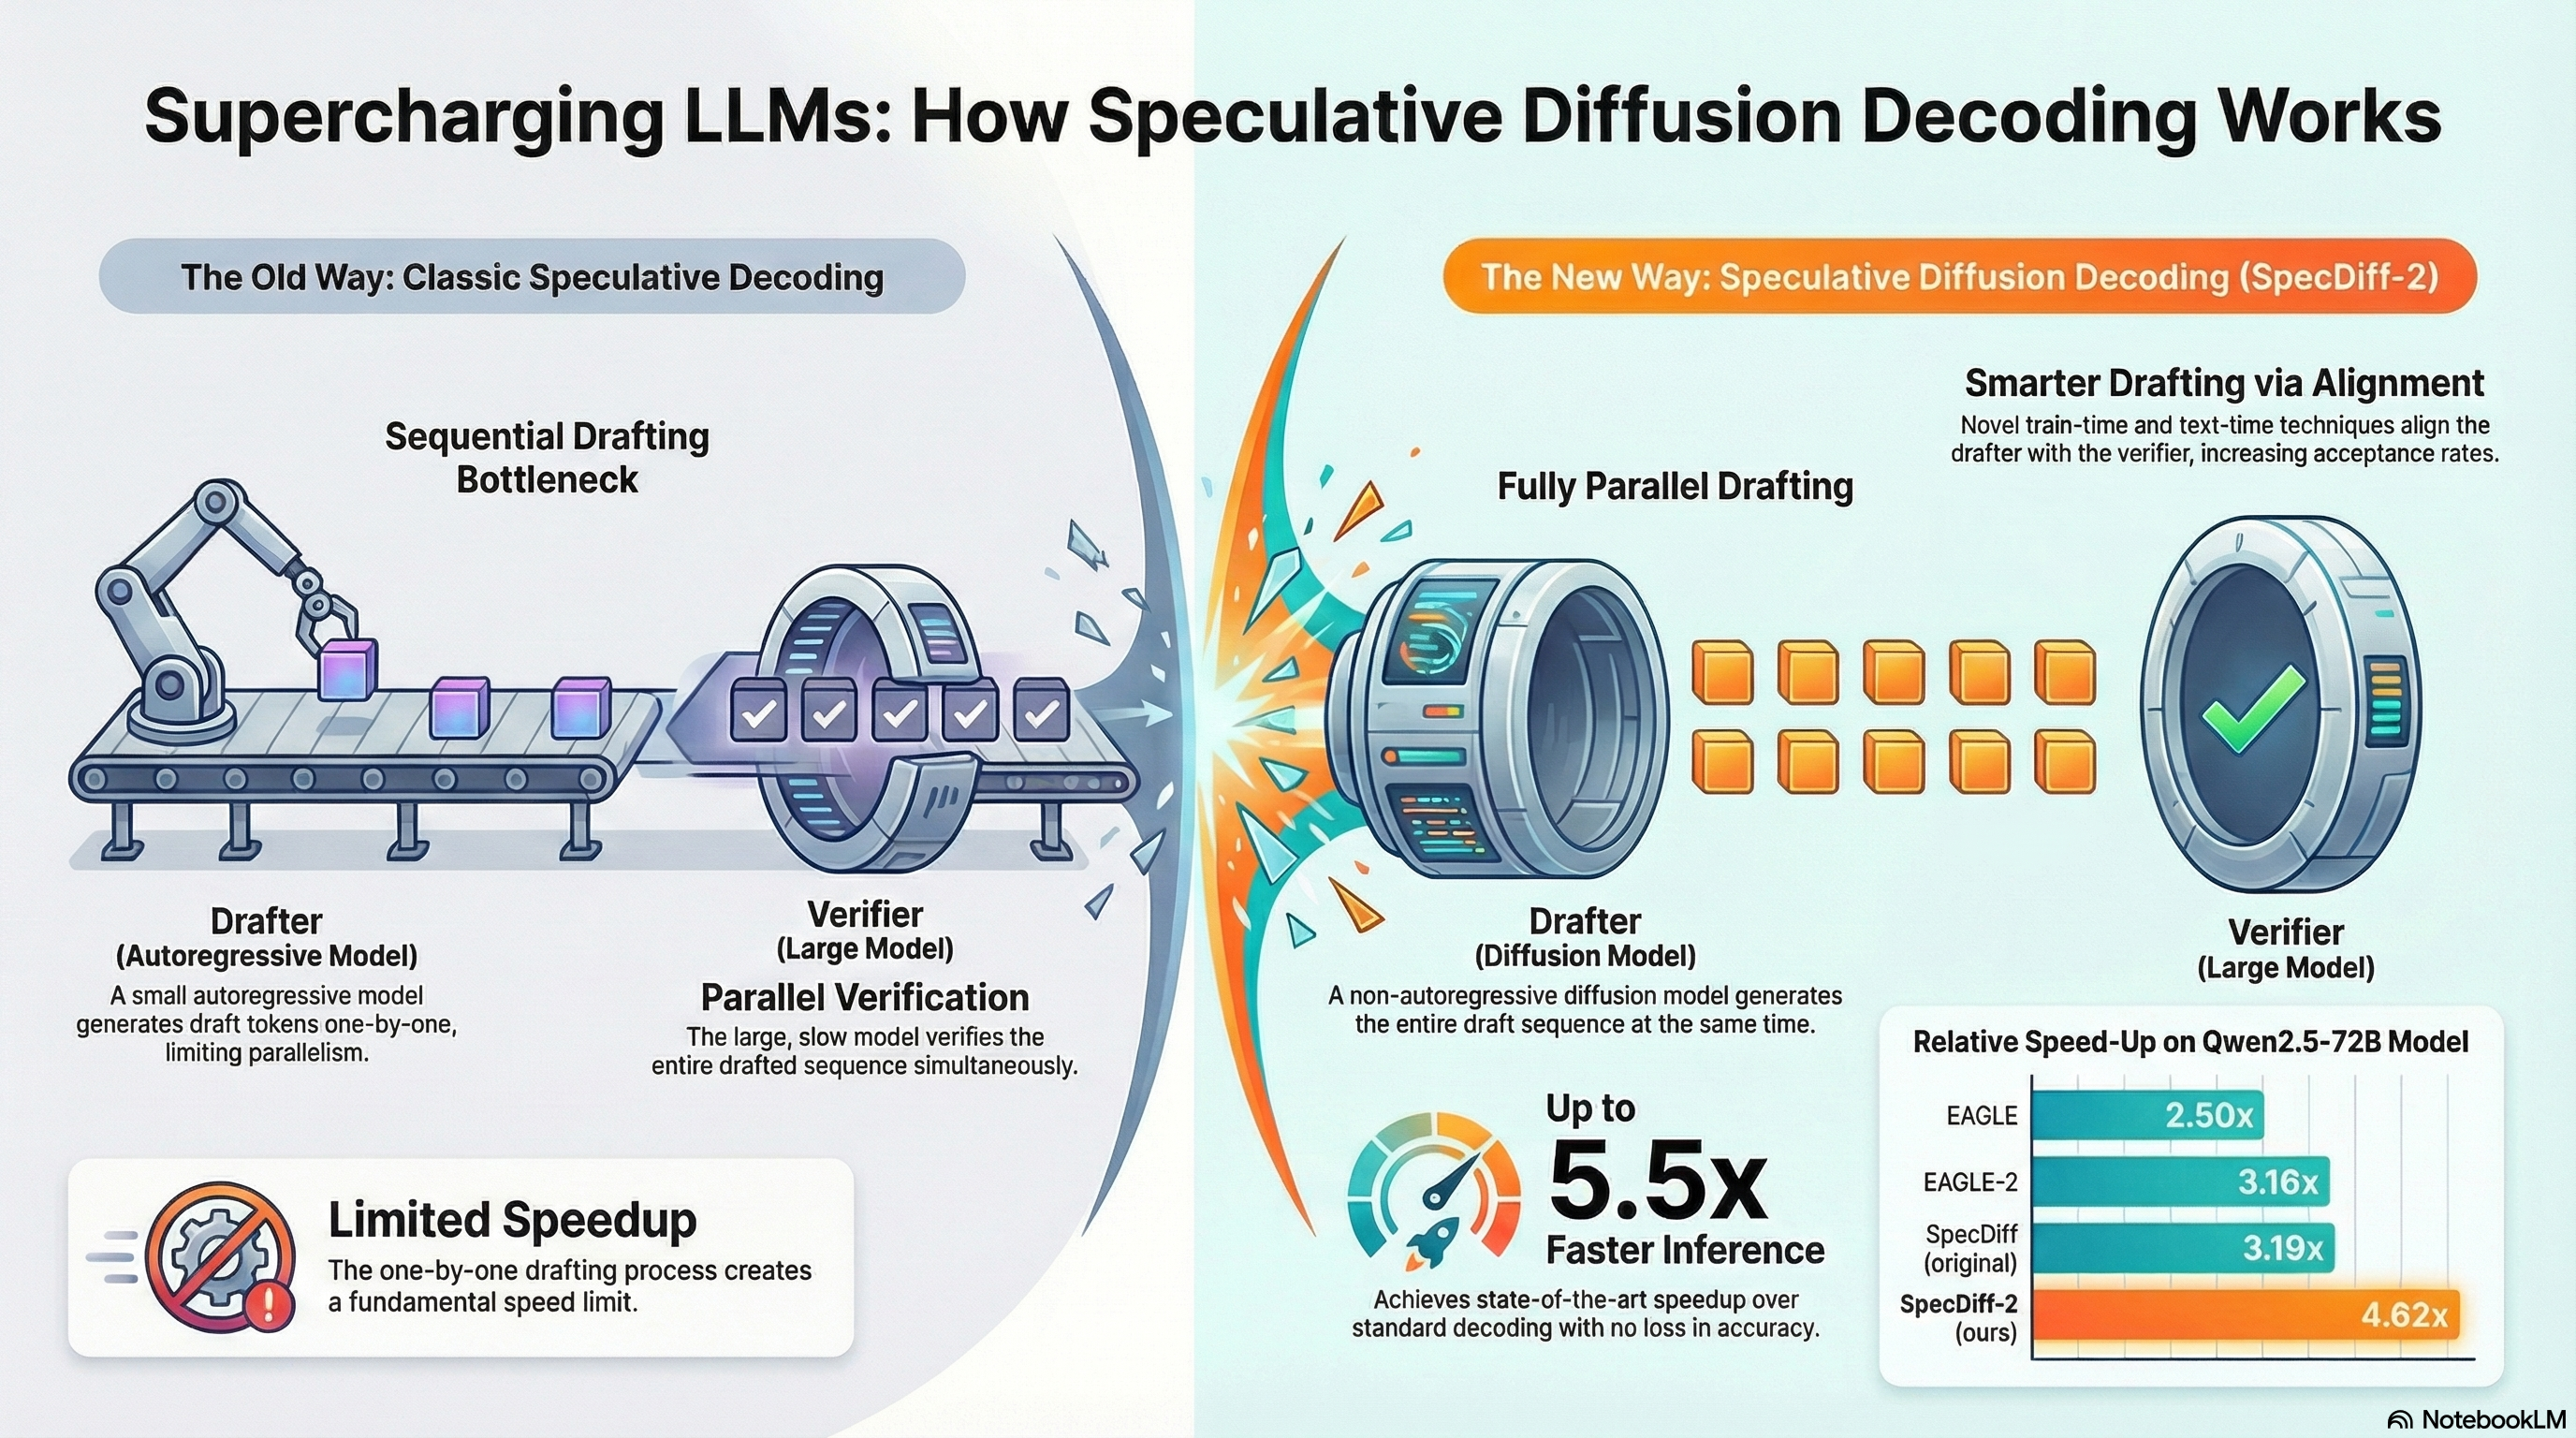
Speculative Diffusion (SpecDiff)
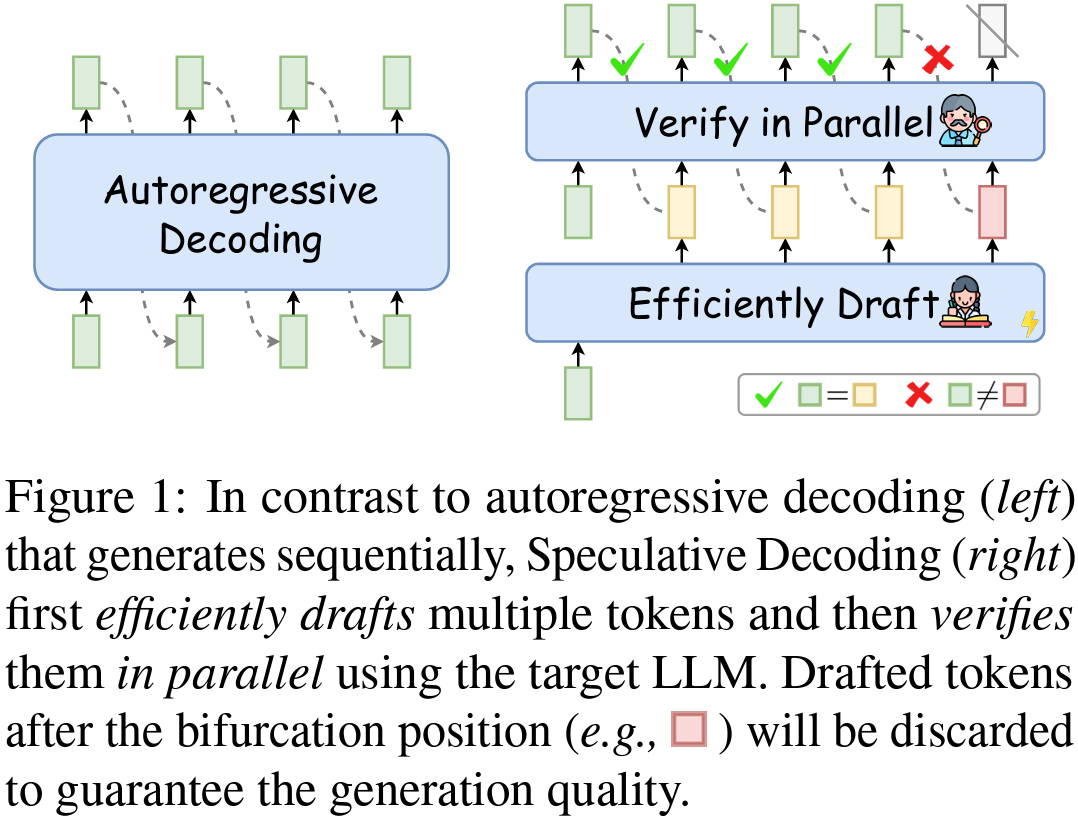
This AI Paper Unveils the Potential of Speculative Decoding for Faster ...