
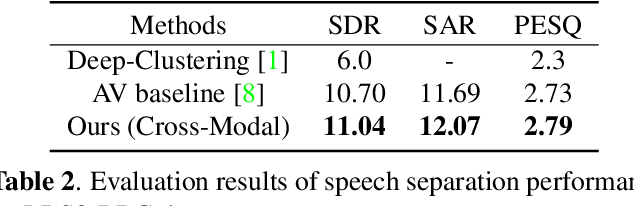
Table 2 From Audio Visual Speech Separation Based On Joint Feature
Audio-visual speech separation based on joint feature representation ...

Audio-visual speech separation based on joint feature representation ...

[PDF] Audio-visual speech separation based on joint feature ...

[PDF] Audio-visual speech separation based on joint feature ...

[2203.02655] audio-visual speech separation based on joint feature ...

(PDF) Audio-visual speech separation based on joint feature ...

[PDF] Audio-visual speech separation based on joint feature ...

Audio-visual speech separation based on joint feature representation ...
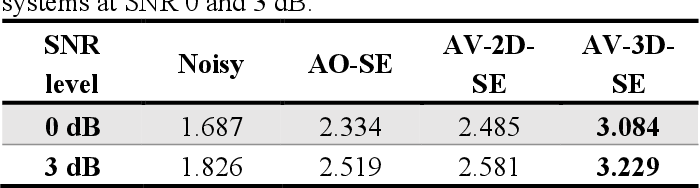
Table 2 from An Audio-Visual Speech Enhancement System Based on 3D ...

Table II from DNN-Based Speech Separation with Joint Improved ...
Advertisement Space (300x250)
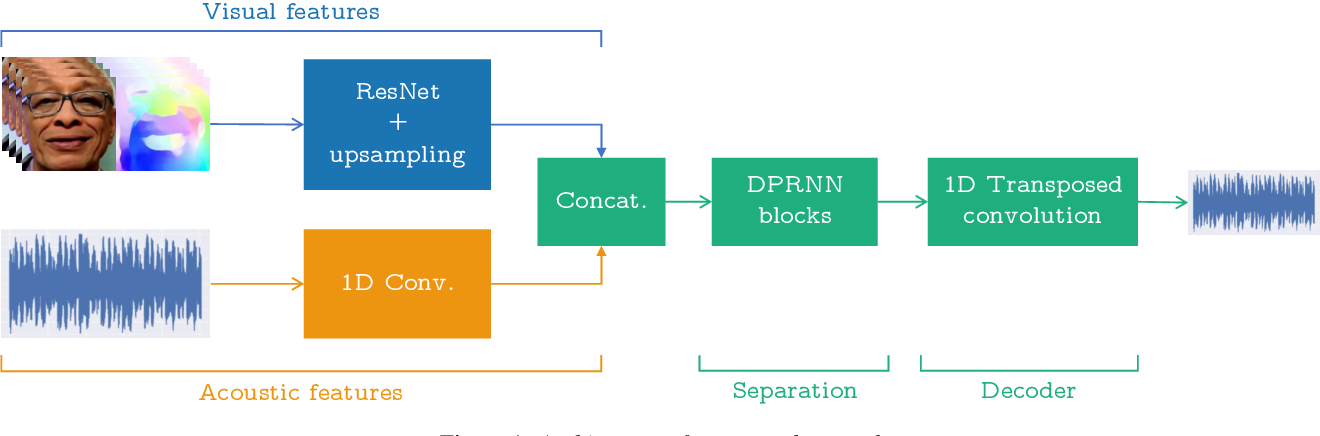
Figure 1 from Deep Audio-Visual Speech Separation Based on Facial ...
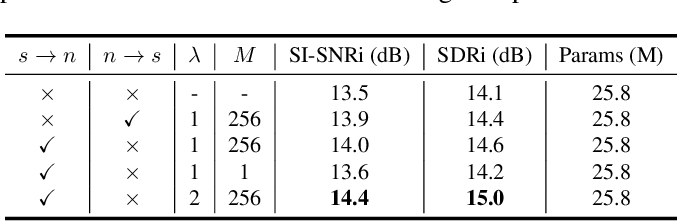
Table 2 from Noise-Aware Speech Separation with Contrastive Learning ...

The proposed audio-visual speech separation model architecture based on ...

Figure 1 from Pure Voice : Efficient Speech Separation with Audio ...

The proposed audio-visual speech separation model architecture based on ...

Table 2 from Fine-grained Audio-Visual Joint Representations for ...

Figure 1 from DNN-Based Speech Separation with Joint Improved ...

(PDF) Deep Audio-Visual Speech Separation Based on Facial Motion

Figure 3 from Joint Semantic and Spatial Feature Learning for Audio ...

Table I from A survey on Audio-Visual Speech Recognition System ...
Advertisement Space (336x280)

Table 2 from A Facial Feature and Lip Movement Enhanced Audio-Visual ...

PixIT: Joint Training of Speaker Diarization and Speech Separation from ...

The proposed audio-visual speech separation model architecture based on ...

Figure 2 from Deep Audio-Visual Speech Separation with Attention ...
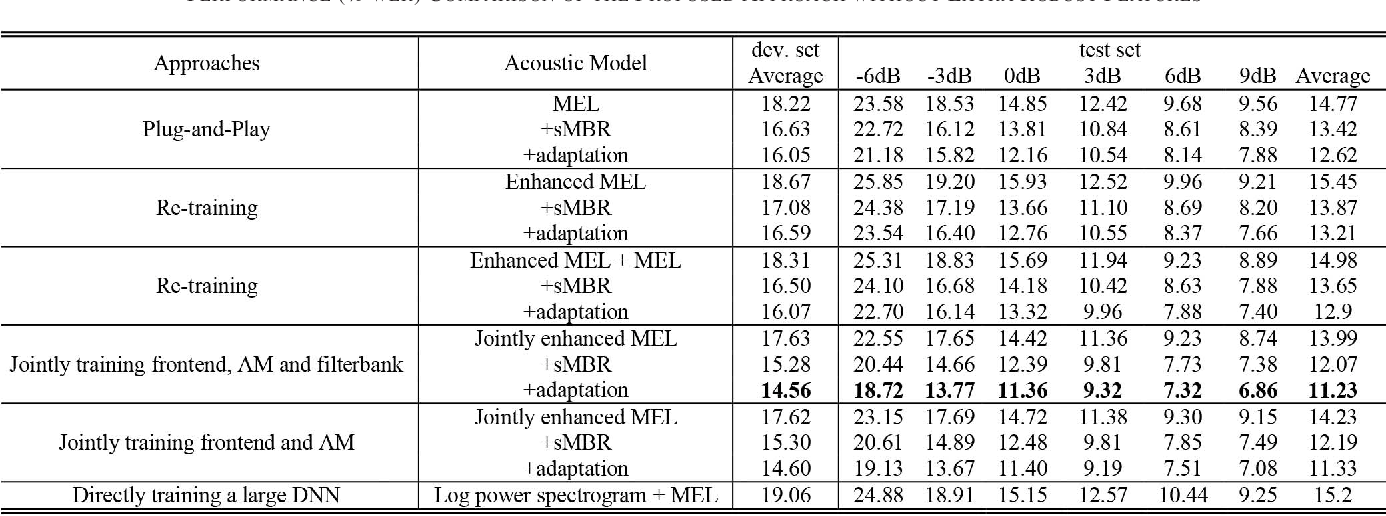
Table II from A Joint Training Framework for Robust Automatic Speech ...

Figure 1 from Joint single-channel speech separation and speaker ...
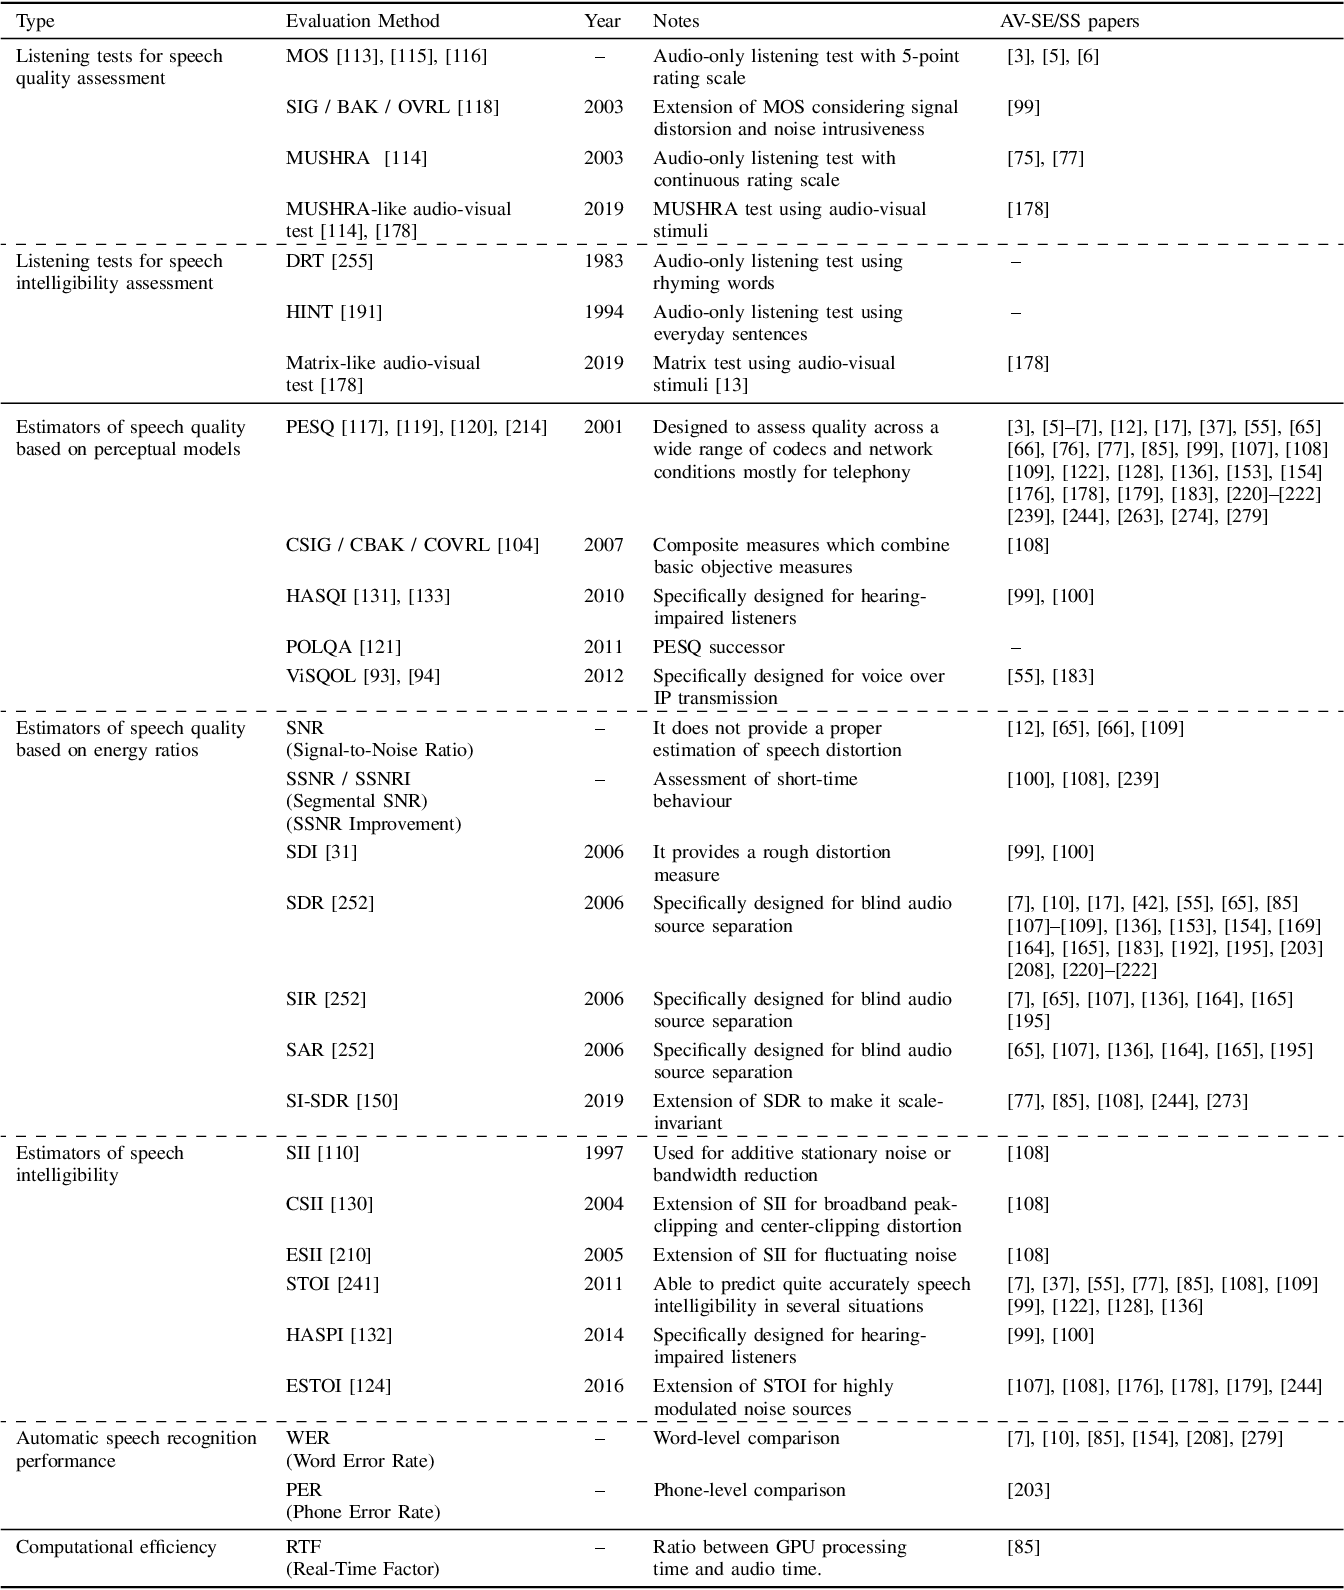
Table II from An Overview of Deep-Learning-Based Audio-Visual Speech ...

Figure 1 from Audio-Visual Speech Separation and Dereverberation With a ...
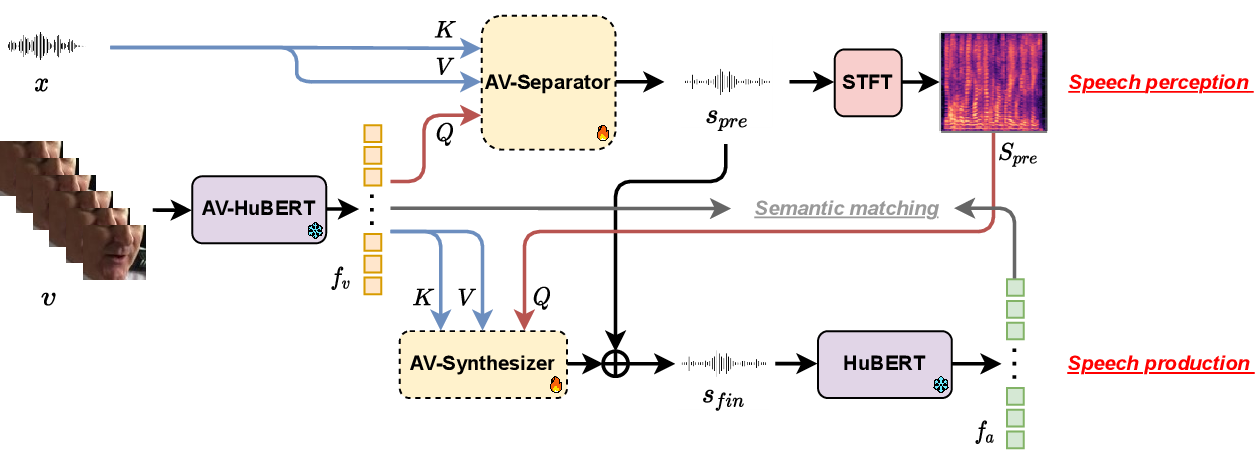
Figure 2 from Separate in the Speech Chain: Cross-Modal Conditional ...

An example for target speech separation on the task of two-speaker ...
Advertisement Space (336x280)

Audio-Visual Speech Enhancement Based on Deep Learning

Table 1 from An Improved End-to-End Audio-Visual Speech Recognition ...

Figure 1 from Audio-Visual End-to-End Multi-Channel Speech Separation ...
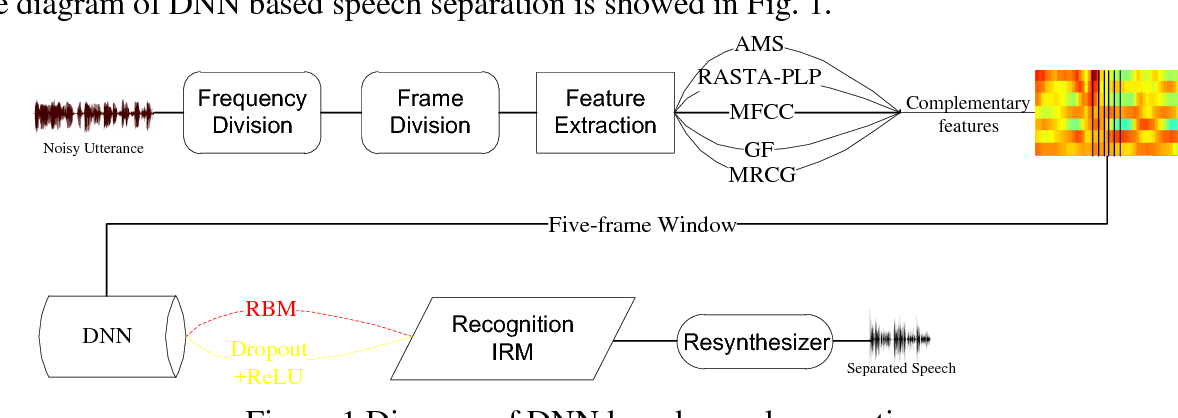
Figure 1 from Improvements of Acoustic Features for Speech Separation ...

Figure 2 from End-to-End Audio-Visual Speech Recognition for ...

Figure 1 from Audio-Visual Speech Separation and Dereverberation With a ...