
Table 2 From Multi View Self Attention Based Transformer For Speaker

Table 2 from Global–Local Self-Attention Based Transformer for Speaker ...

Table 2 from Multi-Dimensional Self Attention based Approach for ...

Figure 2 from Global–Local Self-Attention Based Transformer for Speaker ...

Table 2 from Graph Attention Transformer for Unsupervised Multivariate ...

Figure 2 from Multi-Scale Attention based Transformer U-NET for Change ...

Figure 1 from Multi-View Self-Attention Based Transformer for Speaker ...
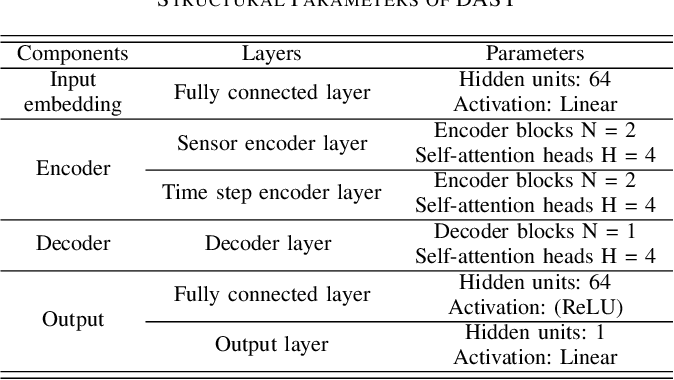
Table II from Dual-Aspect Self-Attention Based on Transformer for ...
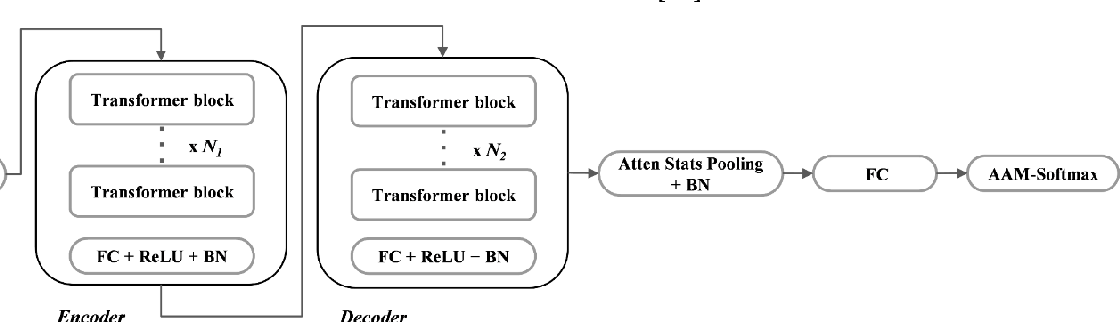
Figure 1 from Global–Local Self-Attention Based Transformer for Speaker ...
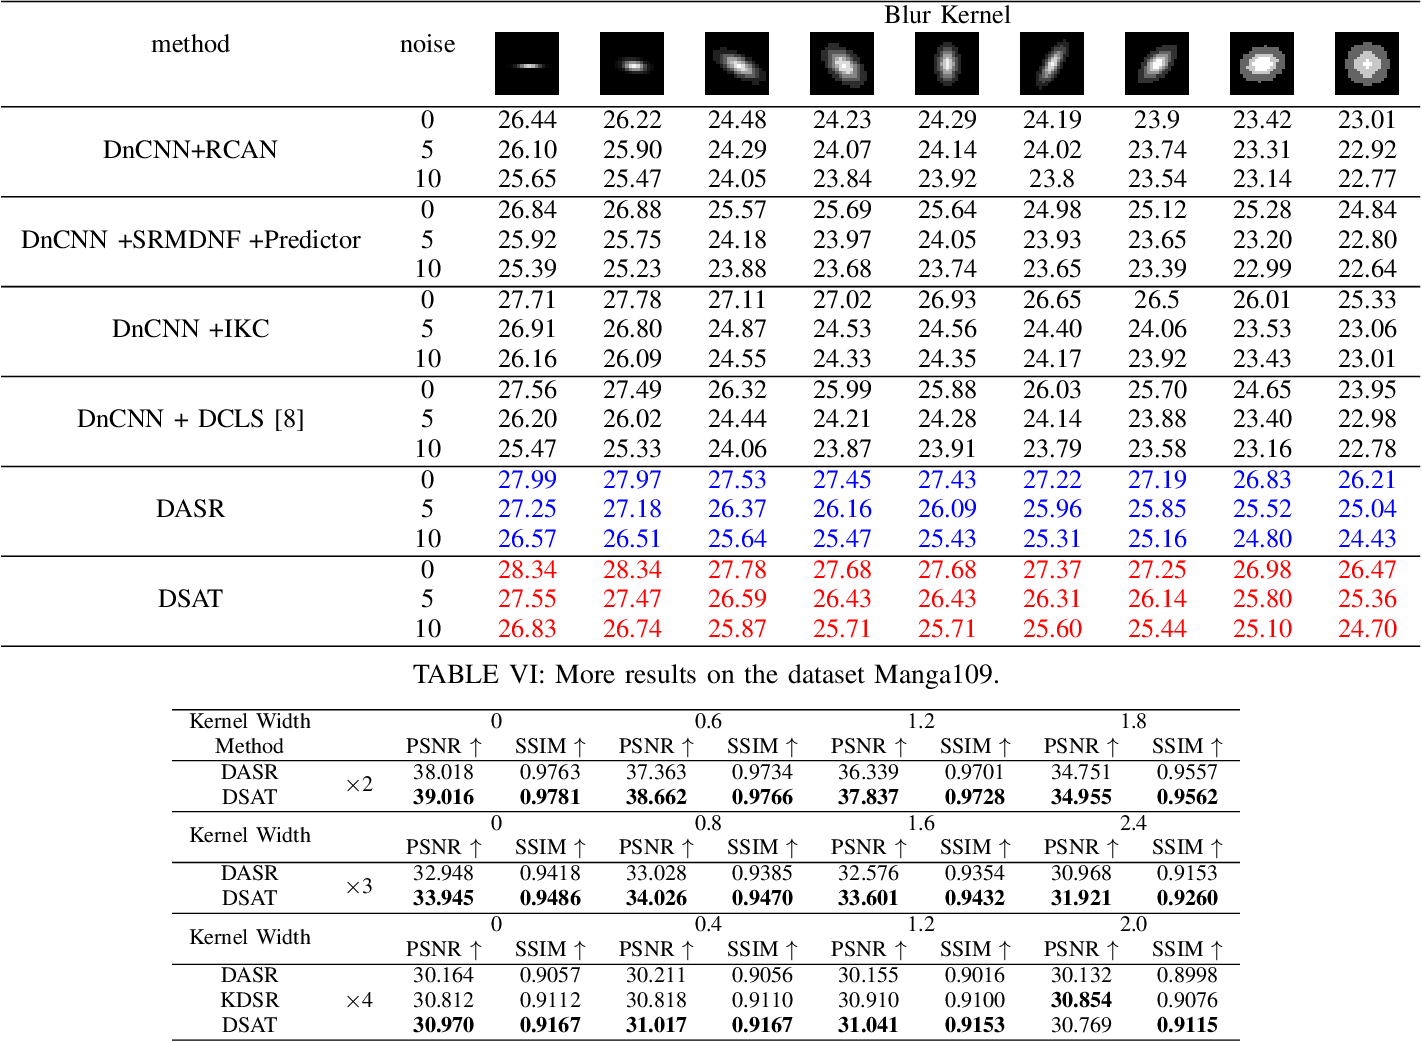
Table VI from Degradation-Aware Self-Attention Based Transformer for ...
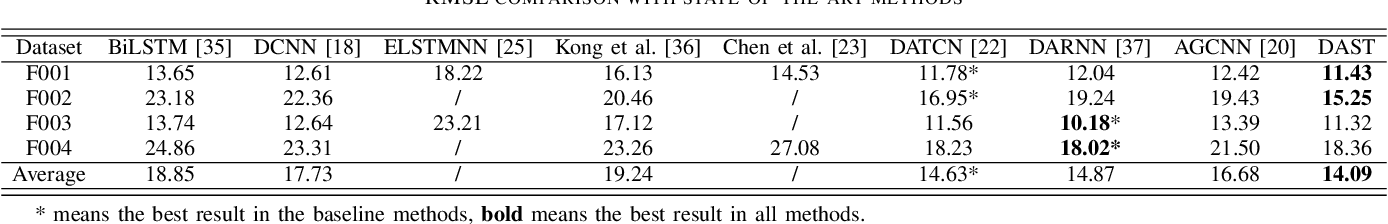
Table III from Dual-Aspect Self-Attention Based on Transformer for ...
Advertisement Space (300x250)

Multi-View Self-Attention Based Transformer for Speaker Recognition

Multi-View Self-Attention Based Transformer for Speaker Recognition
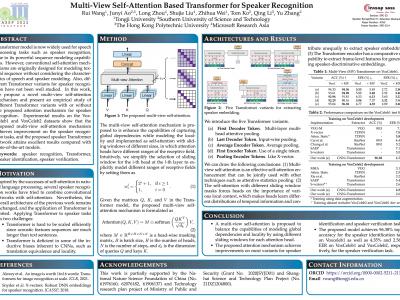
Multi-View Self-Attention based Transformer for Speaker Recognition ...

(PDF) Multi-View Self-Attention Based Transformer for Speaker Recognition

(PDF) Global–Local Self-Attention Based Transformer for Speaker ...

MULTI-VIEW SELF-ATTENTION BASED TRANSFORMER FOR SPEAKER RECOGNITION ...

Figure 1 from Adaptive Multi-Neighborhood Attention based Transformer ...
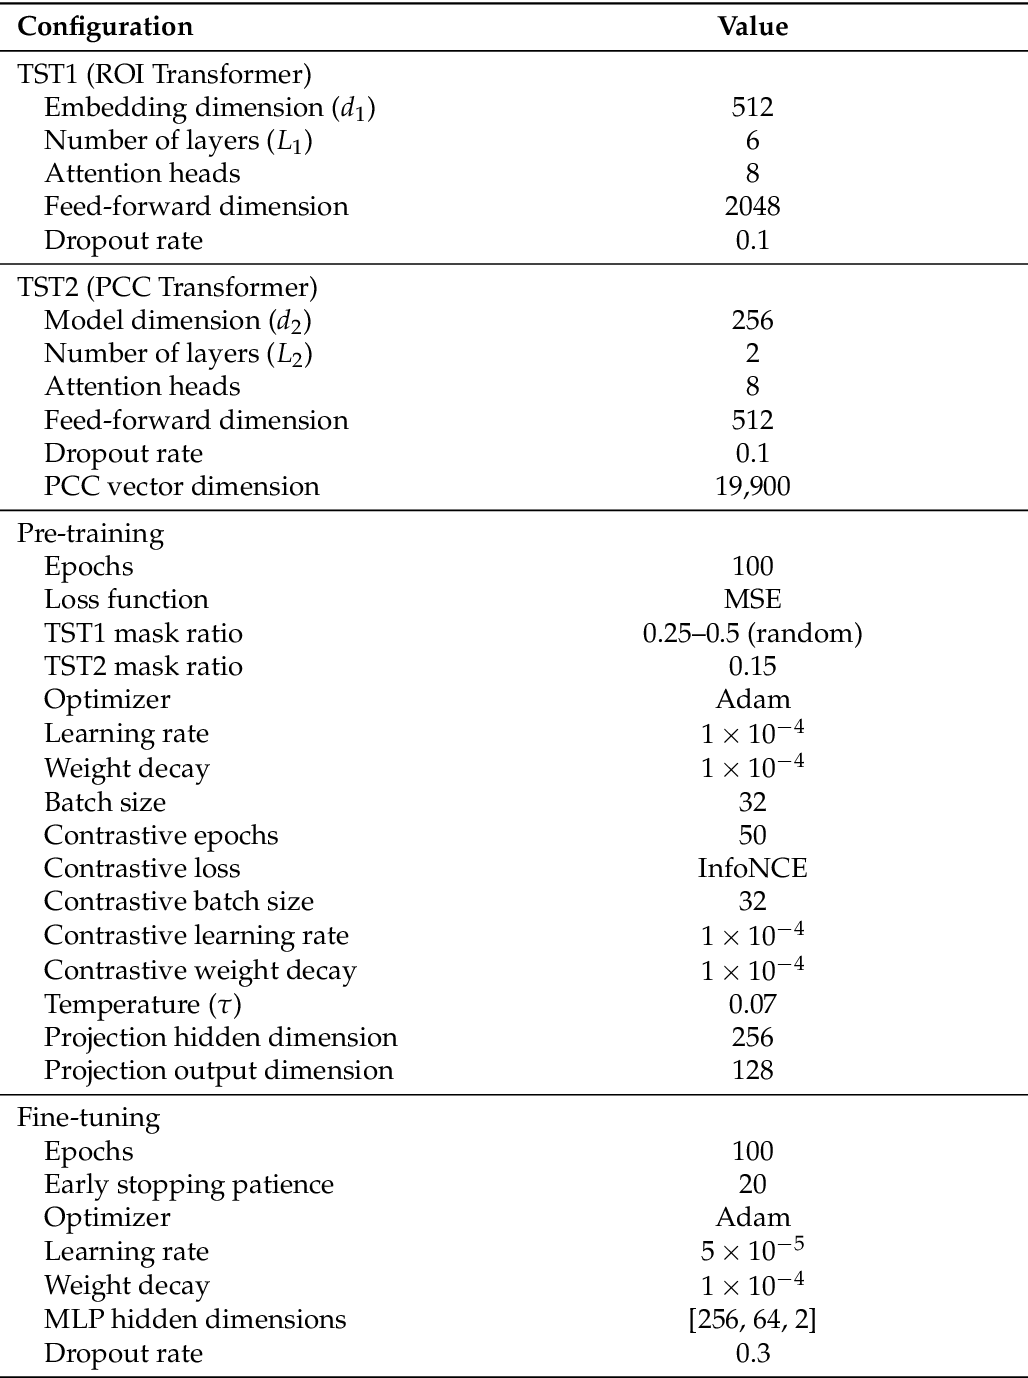
Table 2 from A Dual-Stream Transformer with Self-Supervised Contrastive ...

Table III from Self-Attention-Based Transformer for Nonlinear ...
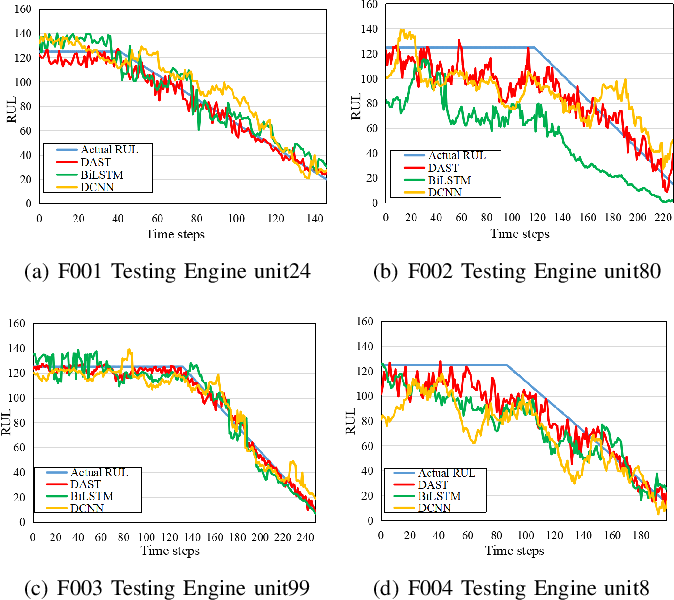
Figure 5 from Dual-Aspect Self-Attention Based on Transformer for ...
Advertisement Space (336x280)
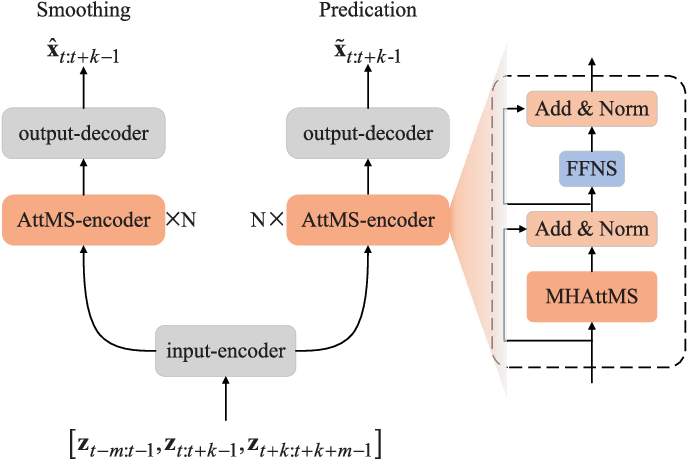
Figure 2 from Self-Attention-Based Transformer for Nonlinear ...

Dual Aspect Self-Attention based on Transformer for Remaining Useful ...

Dual Aspect Self-Attention based on Transformer for Remaining Useful ...

Dual Aspect Self-Attention based on Transformer for Remaining Useful ...

Relaxed Attention for Transformer Models
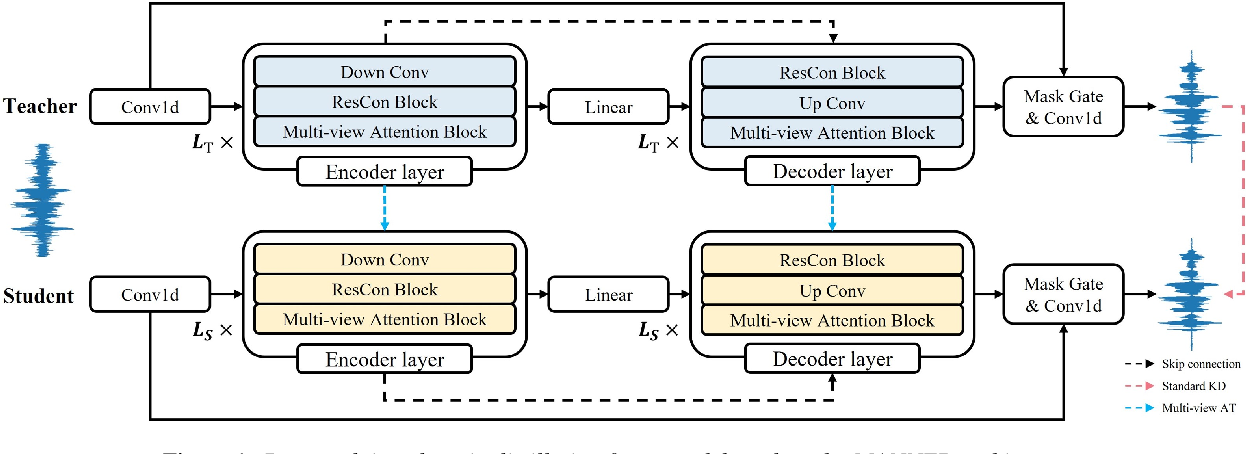
Figure 1 from Multi-View Attention Transfer for Efficient Speech ...
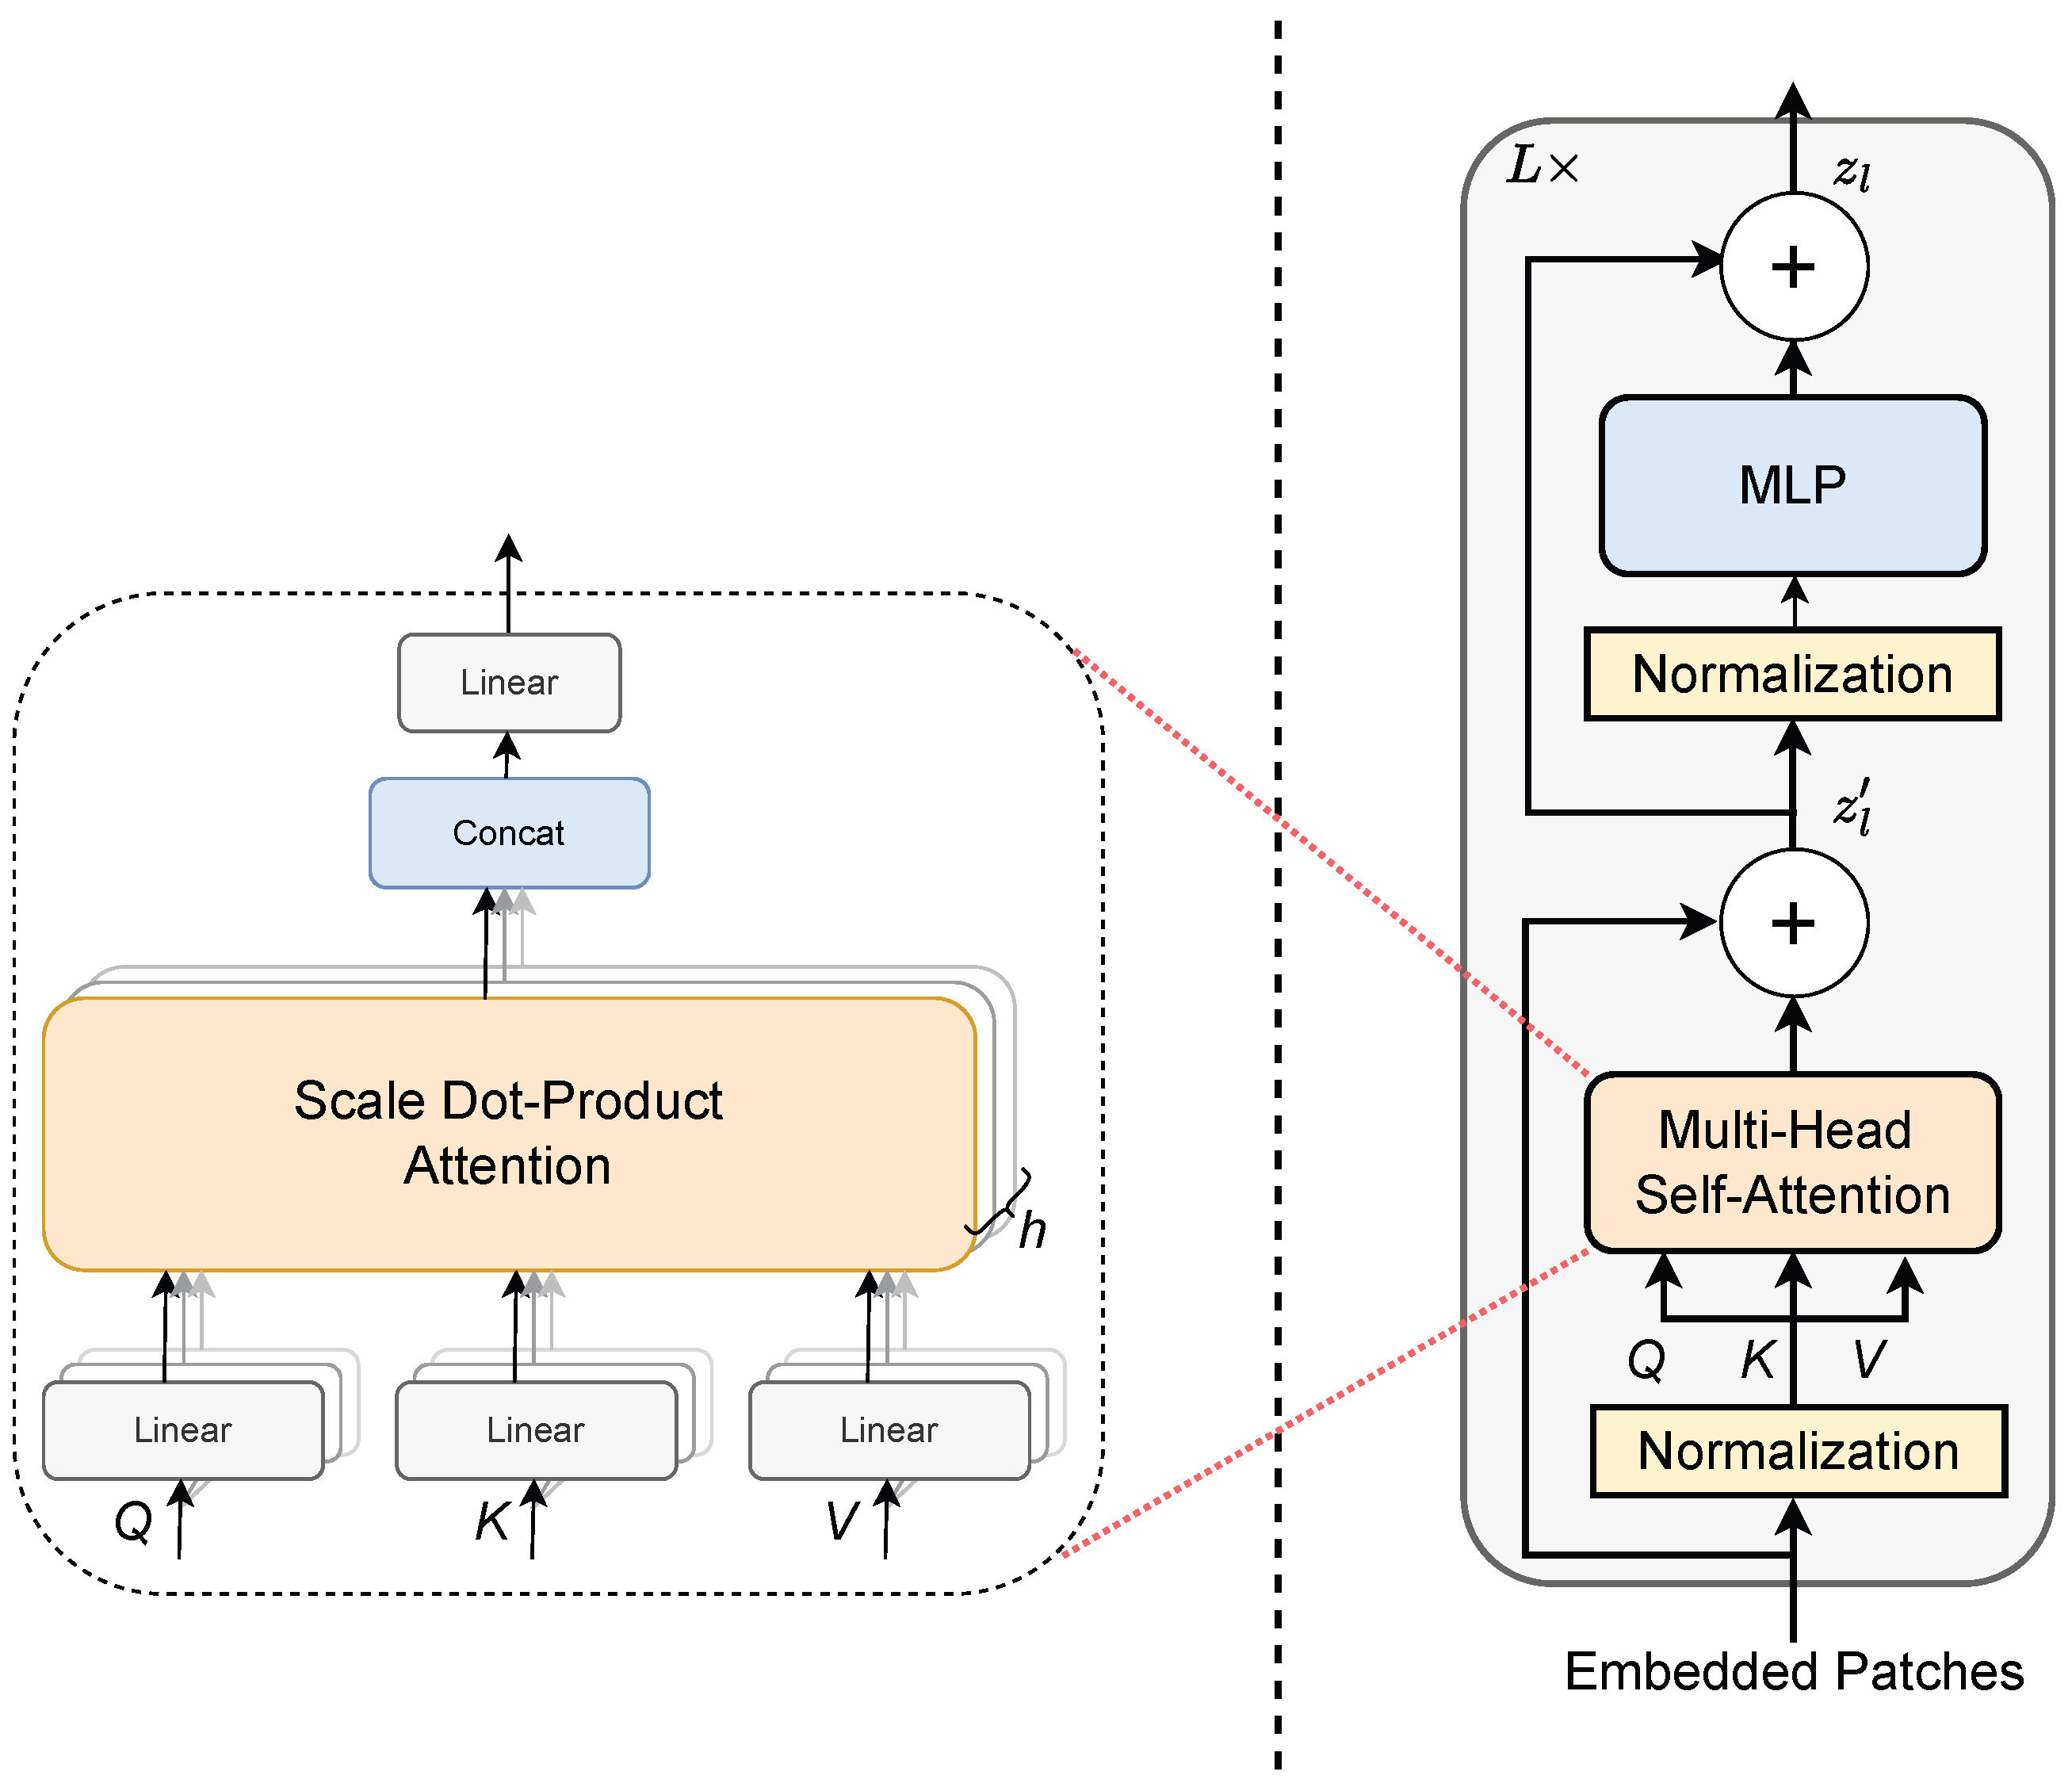
Attention-Fusion-Based Two-Stream Vision Transformer for Heart Sound ...

Illustration of the vision transformer (ViT) and multi self-attention ...

Transformer Architectures for Dummies - Part 1
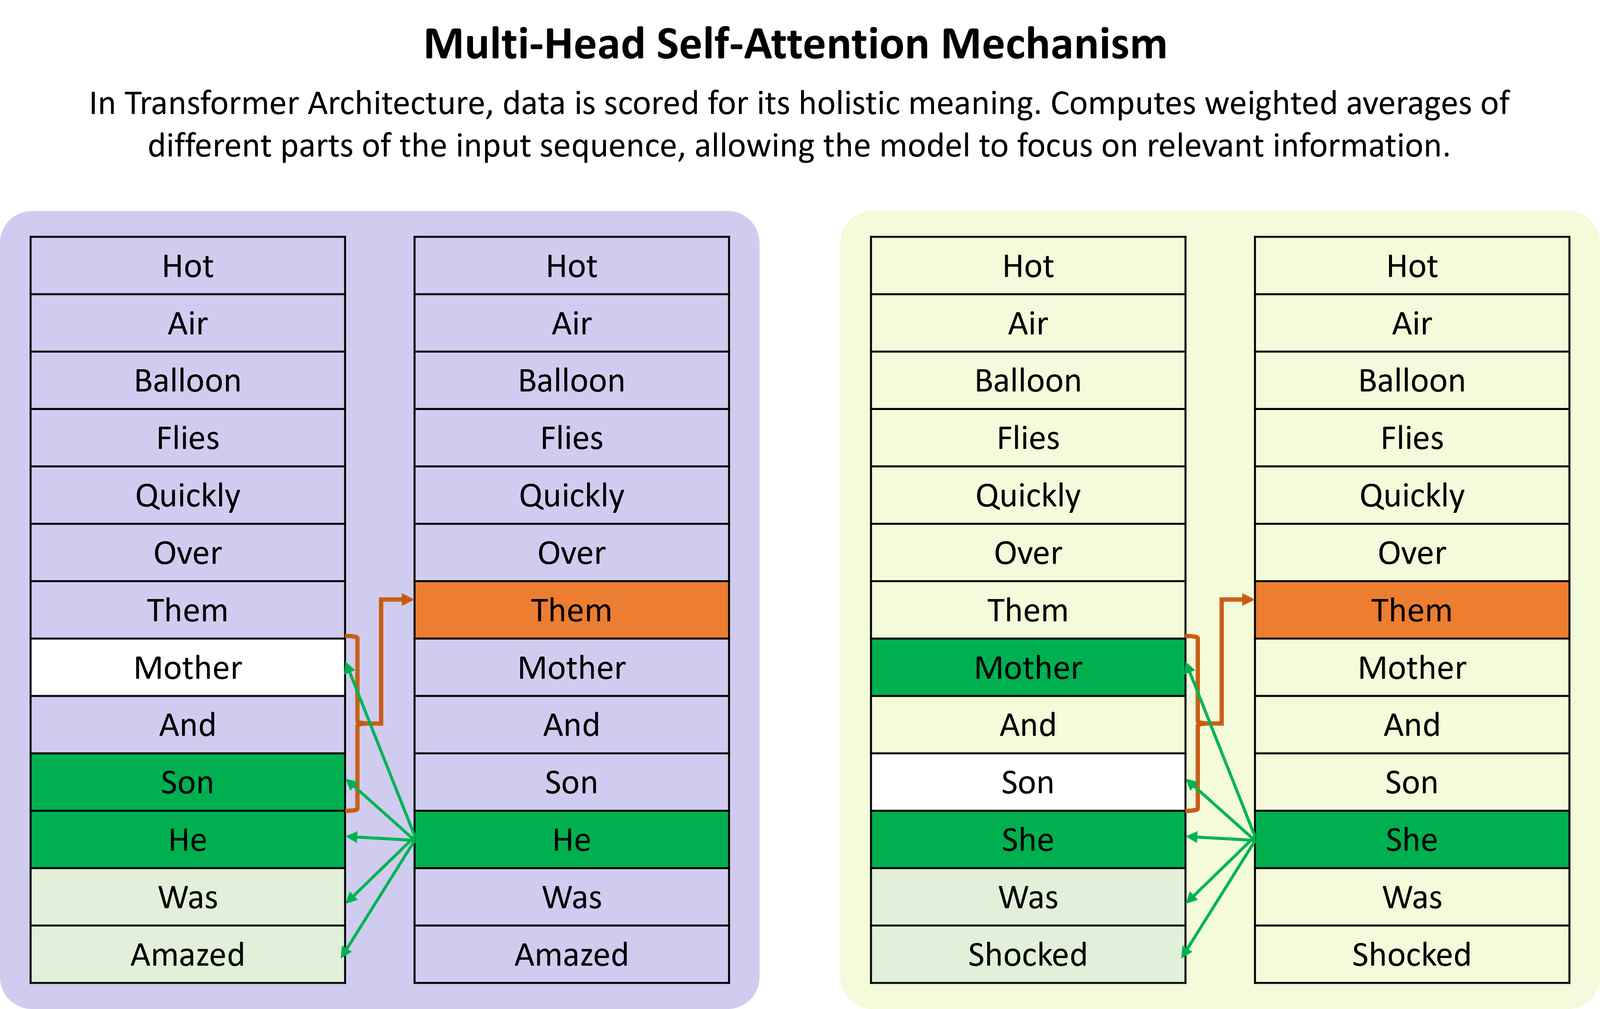
Transformer Architecture: Most Effective Deep Learning Model for Text
Advertisement Space (336x280)
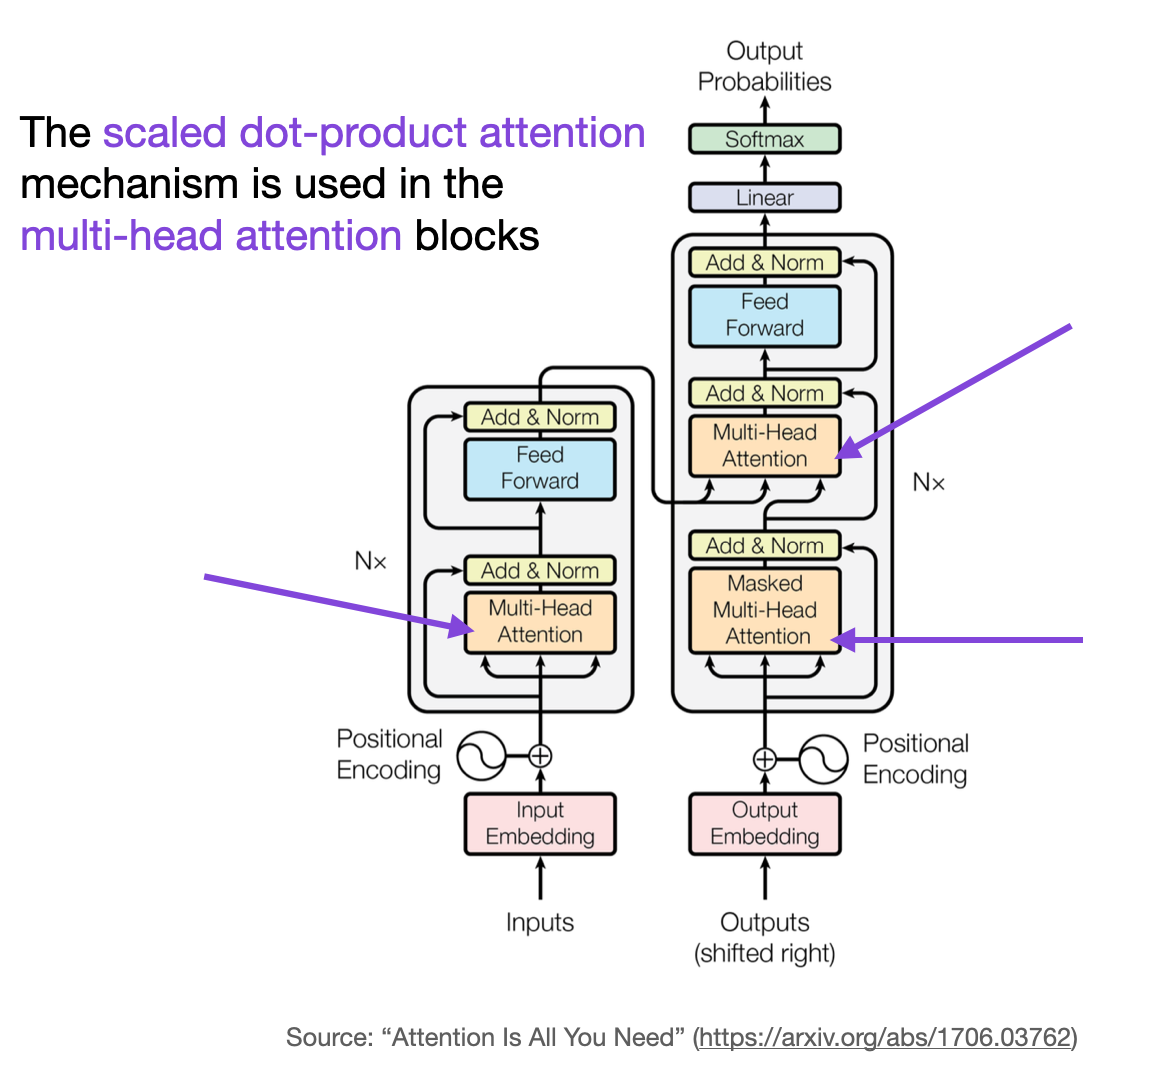
Attention Block Vs Transformer _ Transformer Architecture – SRYSF
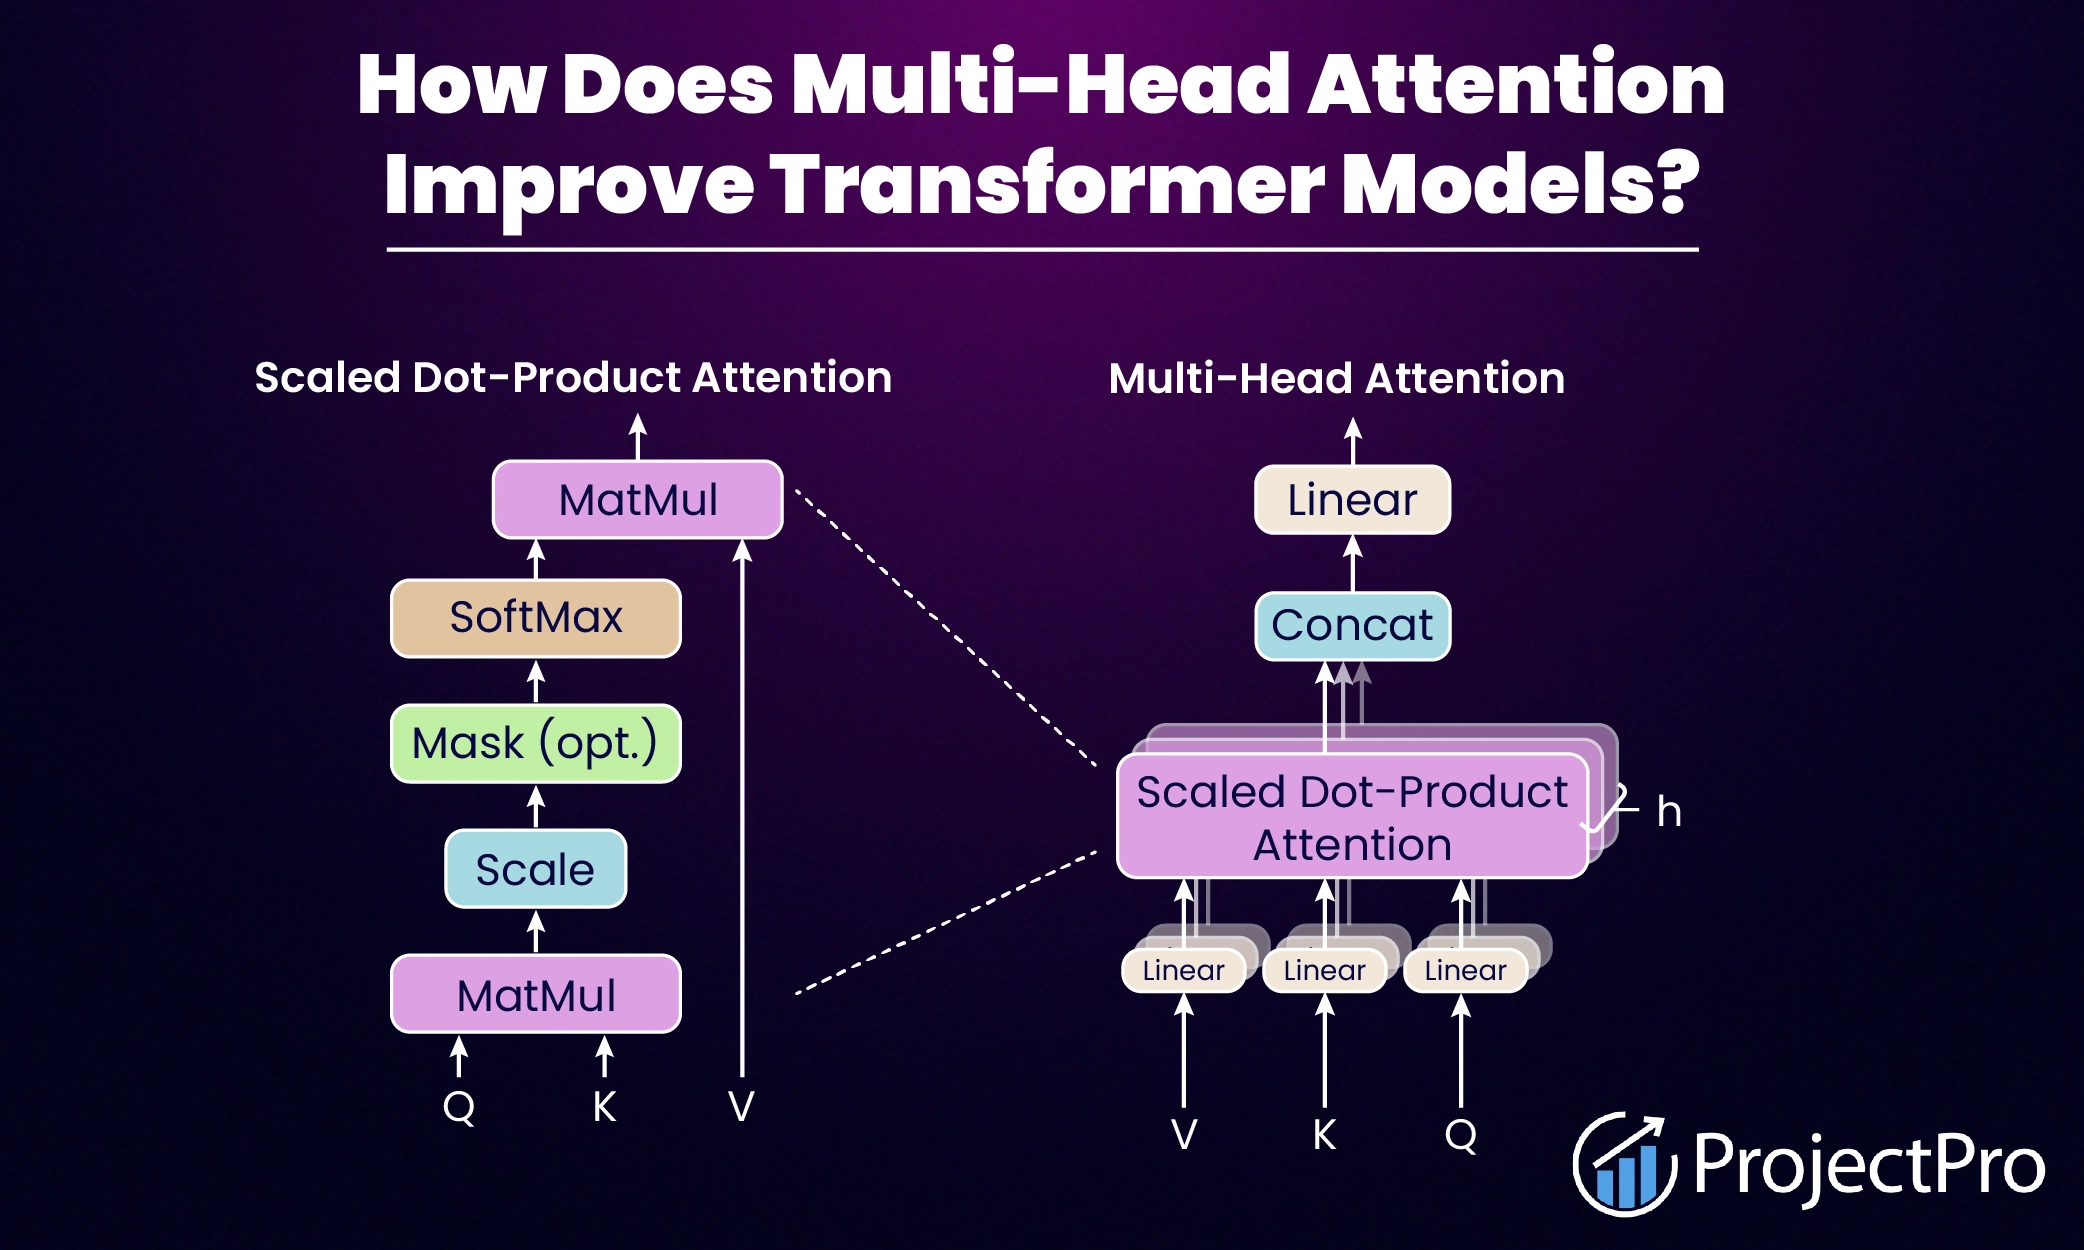
How Does Multi-Head Attention Improve Transformer Models?

An illustration of the attention mechanism in the transformer module ...

Multi-Head-Self-Attention based YOLOv5X-transformer for multi-scale ...
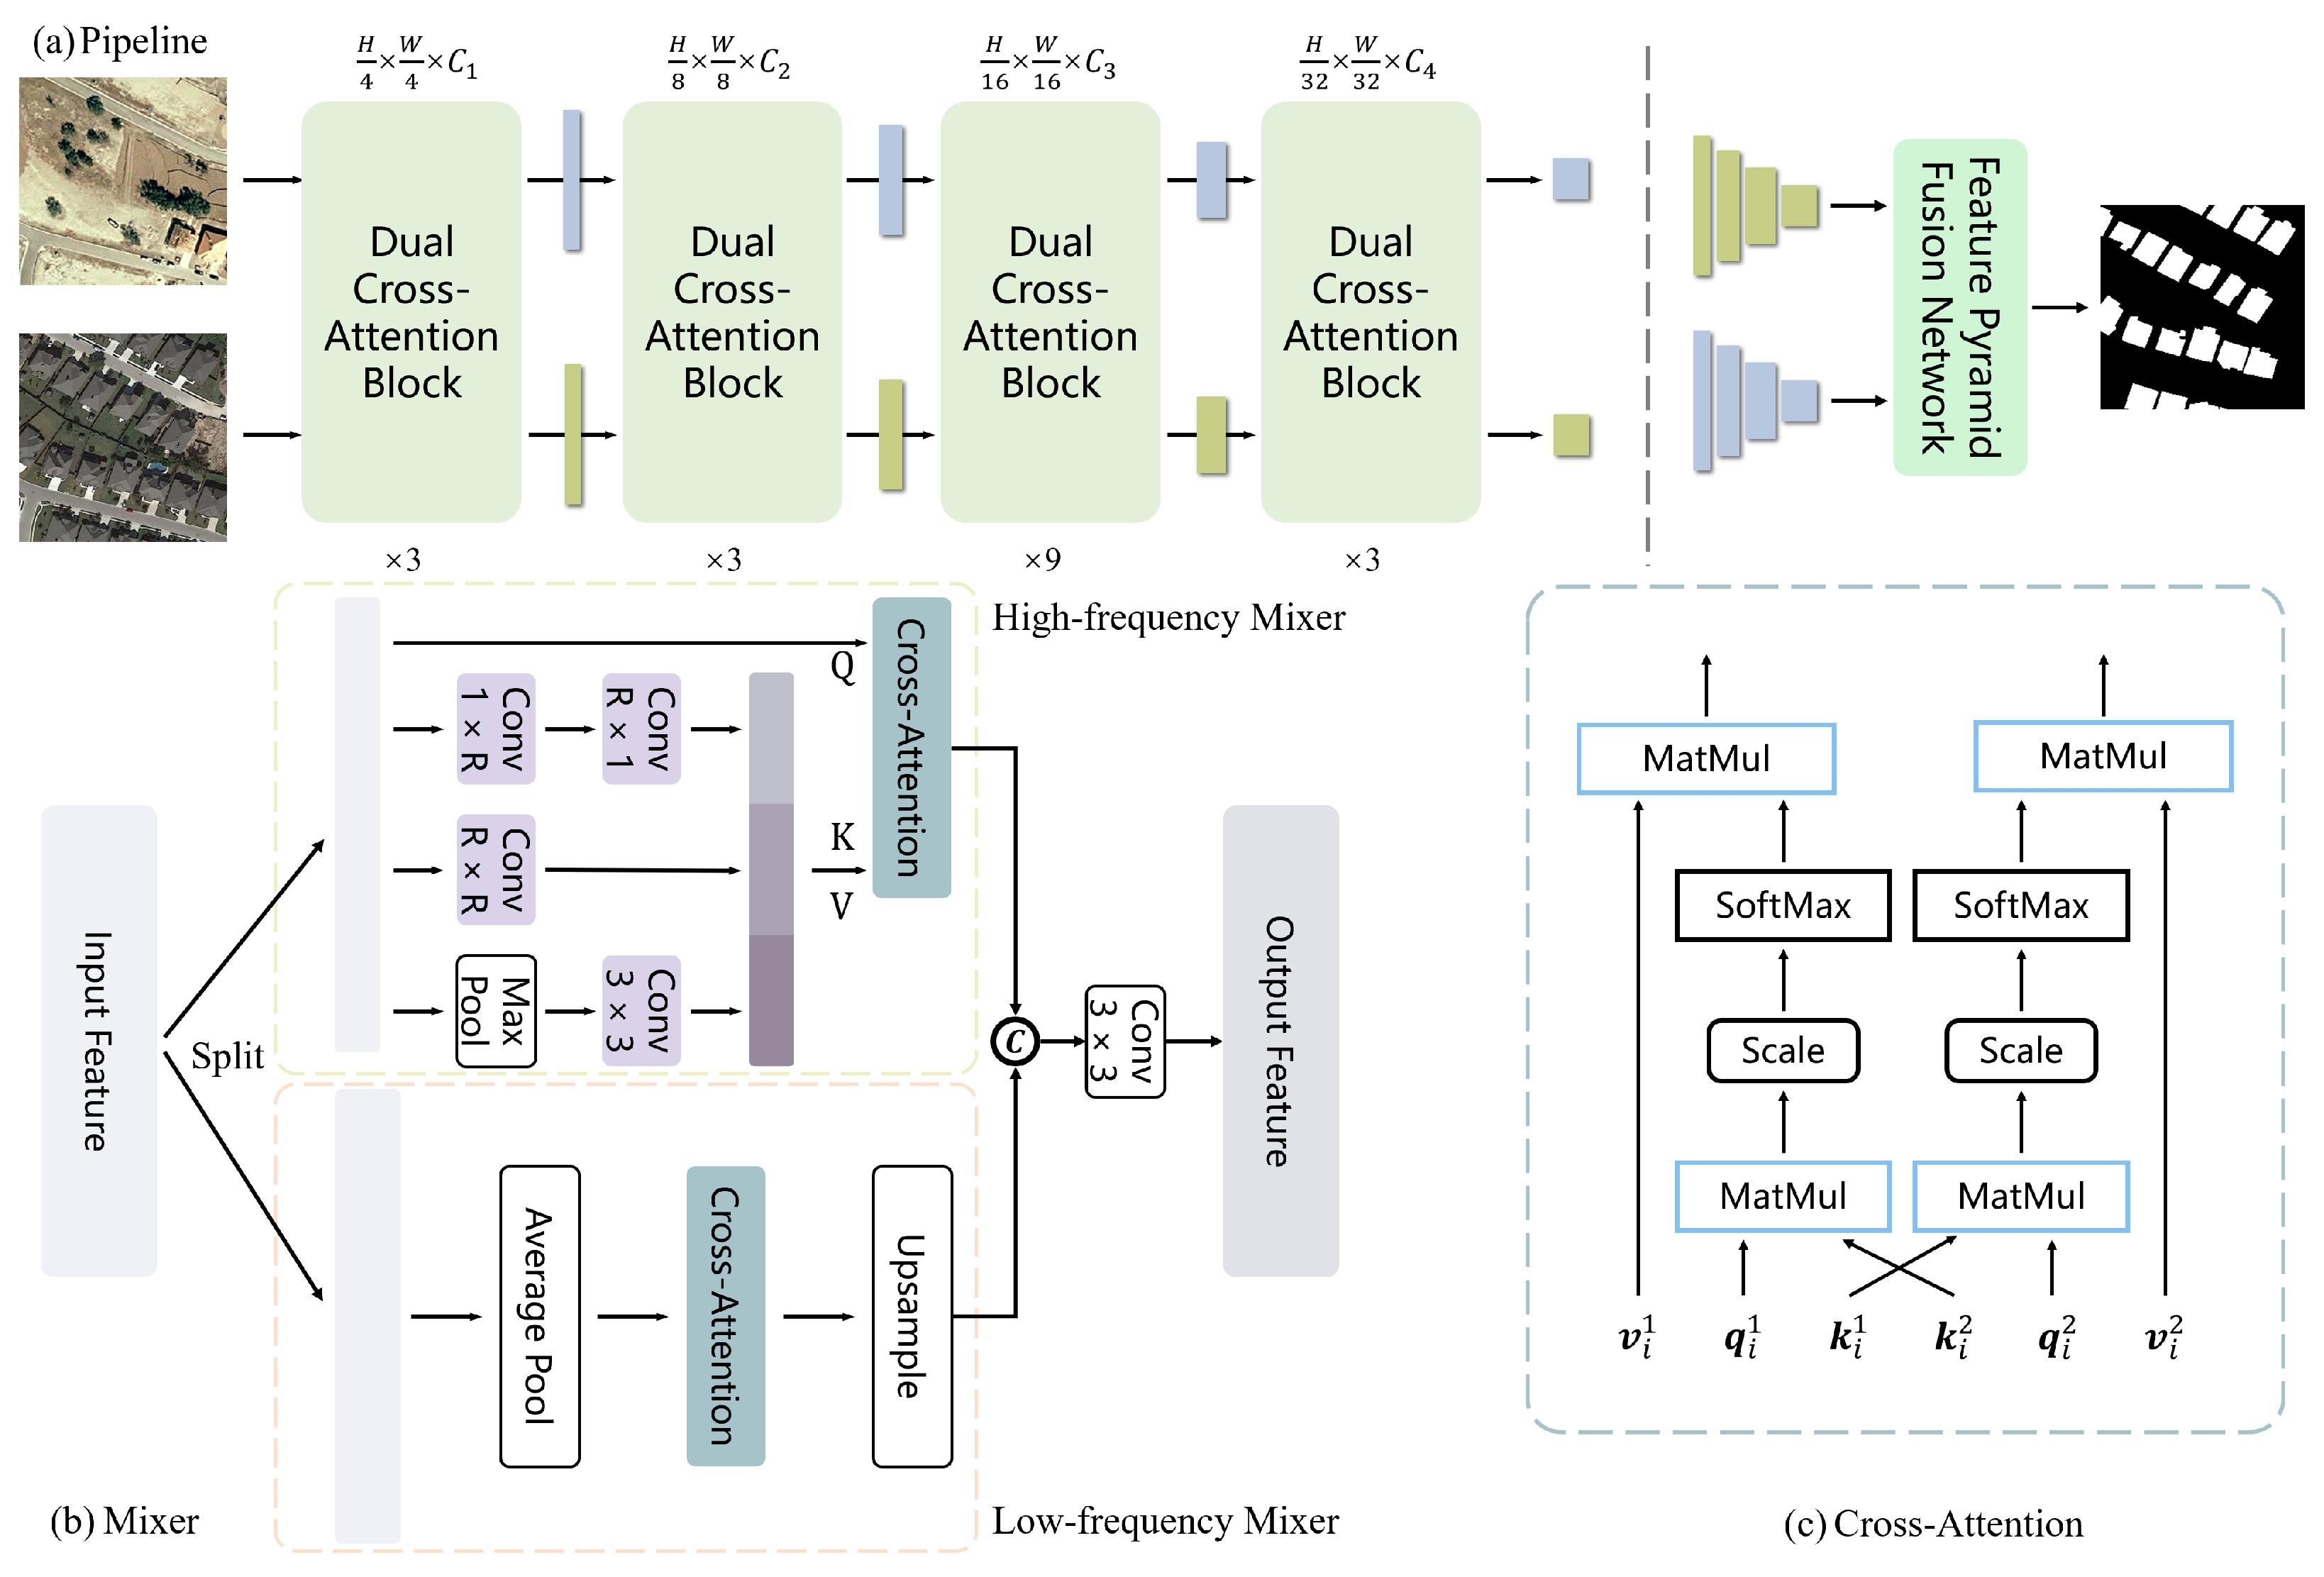
DCAT: Dual Cross-Attention-Based Transformer for Change Detection

Understanding Multi Head Attention in Transformers | by Sachin Soni ...