
231207814 A Foundational Multimodal Vision Language Ai Assistant For

A Foundational Multimodal Vision Language AI Assistant for Human ...

A Foundational Multimodal Vision Language AI Assistant for Human ...

[2312.07814] A Foundational Multimodal Vision Language AI Assistant for ...

[2312.07814] A Foundational Multimodal Vision Language AI Assistant for ...

[2312.07814] A Foundational Multimodal Vision Language AI Assistant for ...

A Foundational Multimodal Vision Language AI Assistant for Human Pathology

[2312.07814] A Foundational Multimodal Vision Language AI Assistant for ...

[2312.07814] A Foundational Multimodal Vision Language AI Assistant for ...

[2312.07814] A Foundational Multimodal Vision Language AI Assistant for ...
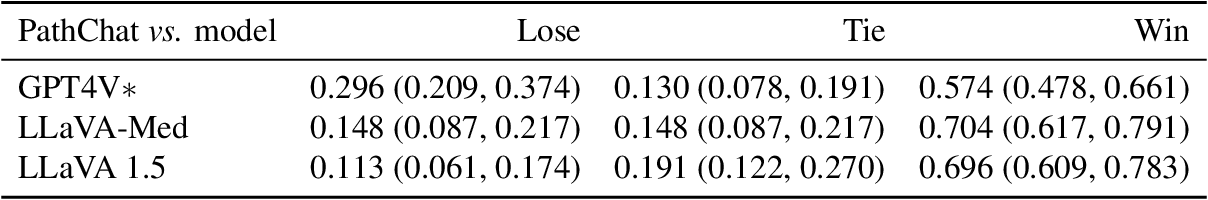
A Foundational Multimodal Vision Language AI Assistant for Human Pathology
Advertisement Space (300x250)
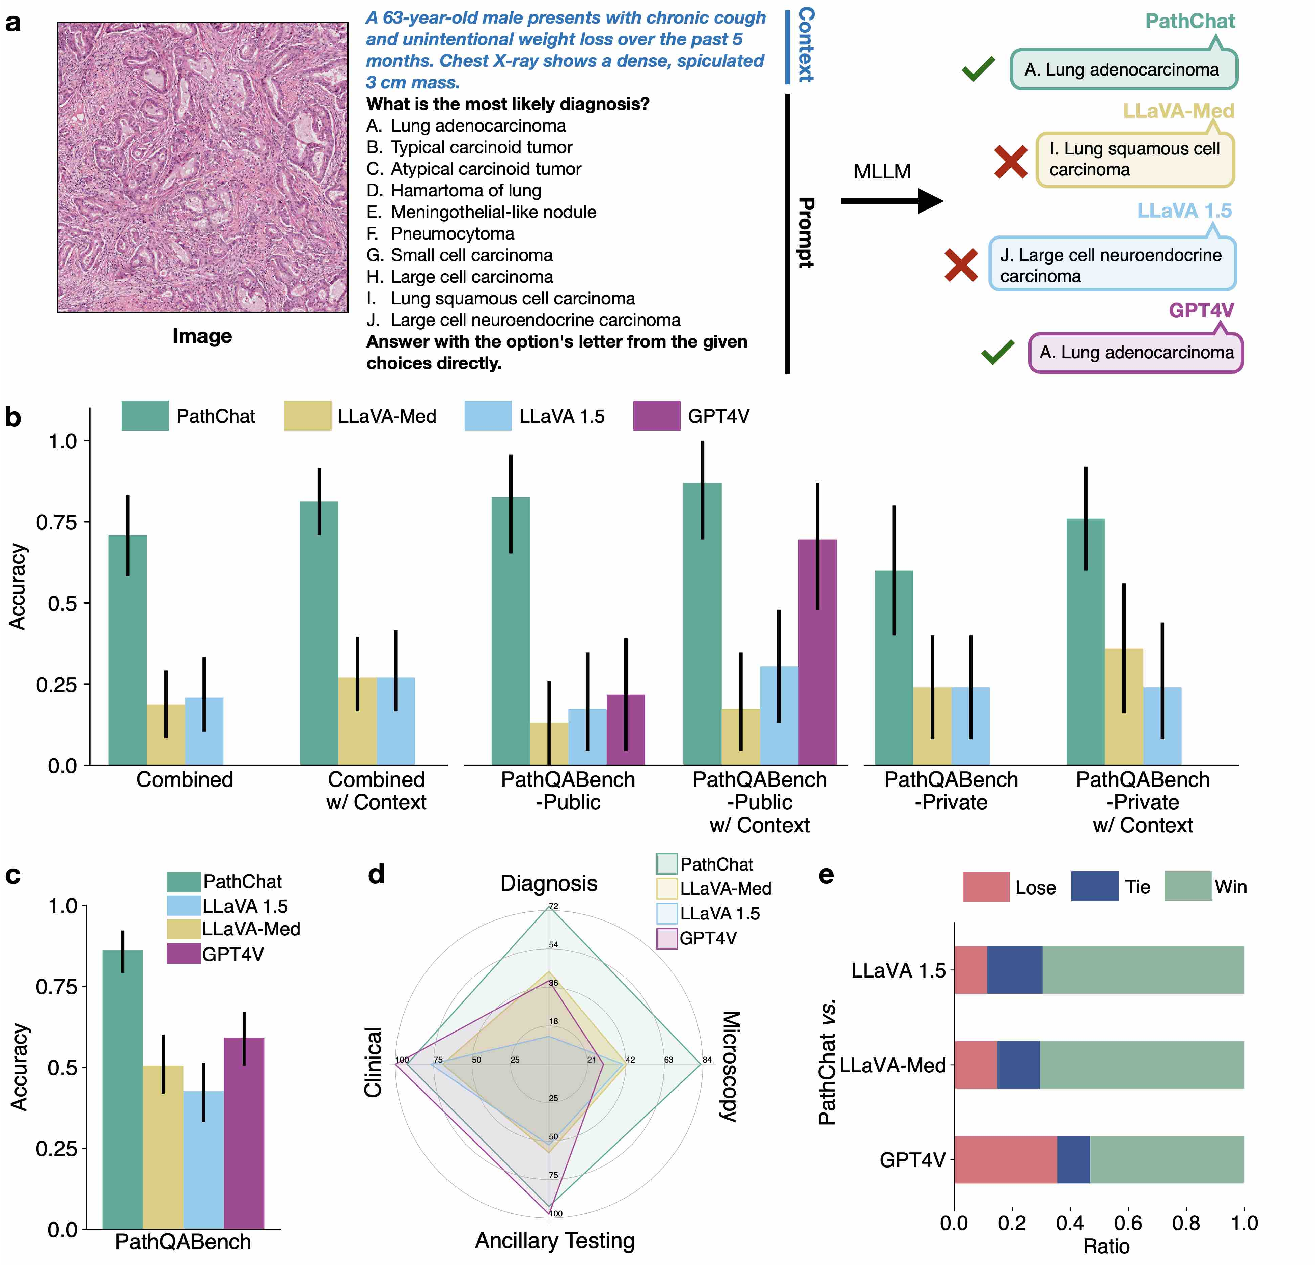
Figure 2 from A Foundational Multimodal Vision Language AI Assistant ...

Vision Language Models: The Future Of Multimodal AI 2025 - FireXCore
Multimodal AI Revolution 2026: Vision Language Action Convergence ...

Multimodal Fusion and Vision-Language Models: A Survey for Robot Vision ...
Demystifying Vision Language Models (VLMs): The Core of Multimodal AI
Multimodal AI: A Guide to Open-Source Vision Language Models
Best Vision Language Models 2026 - Multimodal AI Comparison | EvoArt.ai ...

VLA之Agent:《Magma: A Foundation Model for Multimodal AI Agents》翻译与解读 ...

Publications | Vision & Language for Autonomous AI (VL4AI) Research
Advancing Multimodal AI Beyond Vision and Language
Advertisement Space (336x280)

How vision language models are shaping multimodal AI | YourStory

Multimodal & Foundation Vision AI

mPLUG-Owl: Modular Multimodal AI for Real-World Vision-Language Tasks ...

Multimodal & Foundation Vision AI

Using Multimodal AI Models For Your Applications (Part 3) — Smashing ...

A multimodal vision–language model for generalizable annotation-free ...

Evaluating Multimodal Language Models as Visual Assistants for Visually ...

Microsoft Researchers Present Magma: A Multimodal AI Model Integrating ...
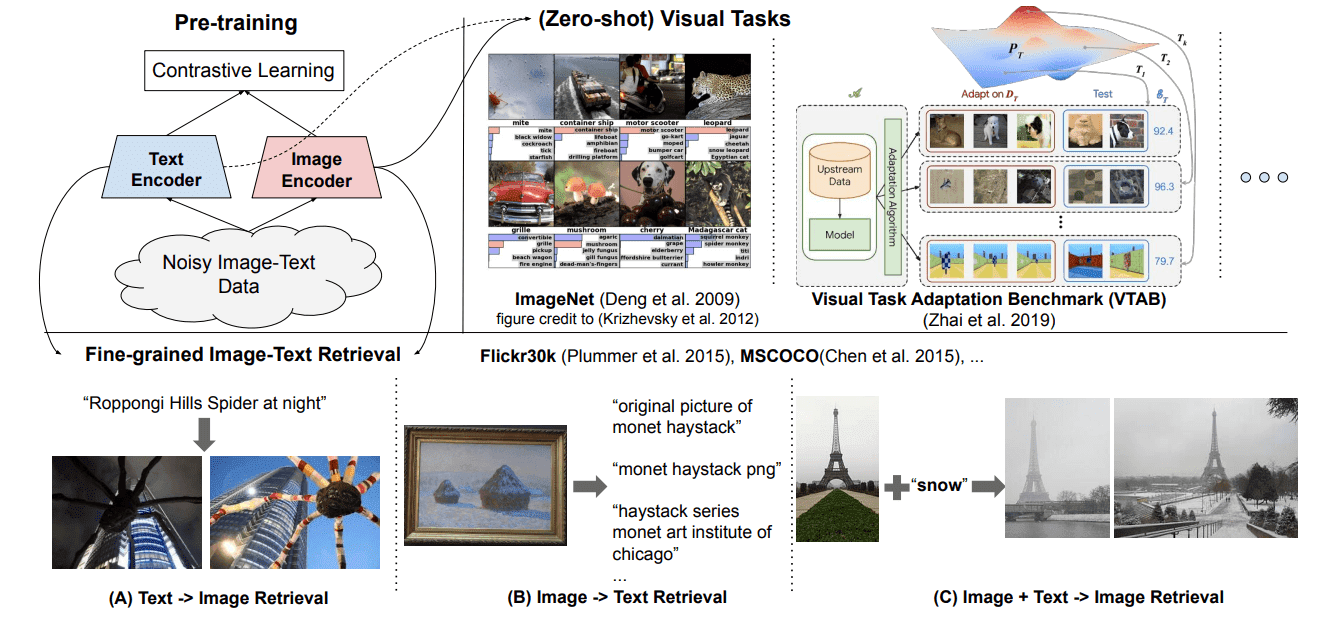
Vision Language models: towards multi-modal deep learning | AI Summer

Multi-Modal AI Assistant For Personalised Mental and Physical | PDF ...
Advertisement Space (336x280)

A Language-Signal-Vision Multimodal Framework for Multitask Cardiac ...
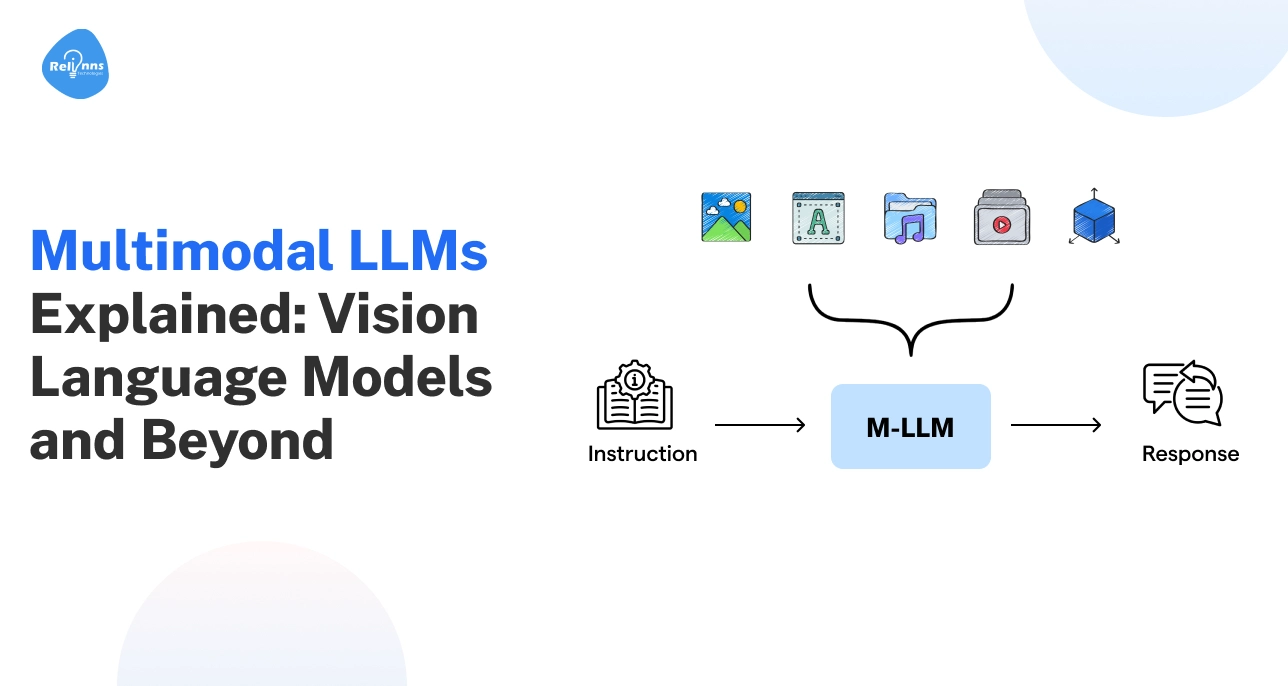
Multimodal LLMs Explained: Vision Language Models and Beyond

ELEV-VISION-SAM: Integrated Vision Language and Foundation Model for ...

Build Your Own Multimodal AI: A Complete Guide to Customizing Vision ...
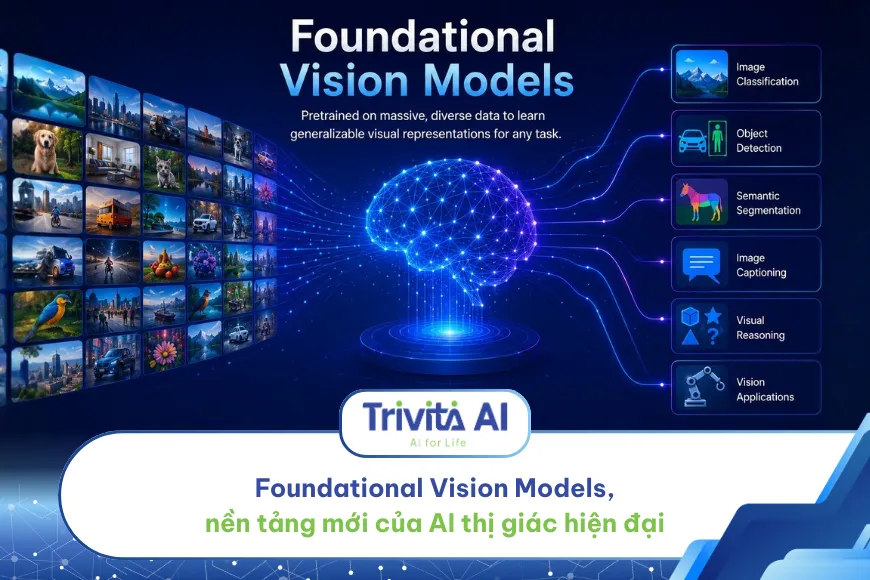
Foundational Vision Models, nền tảng mới của AI thị giác hiện đại ...
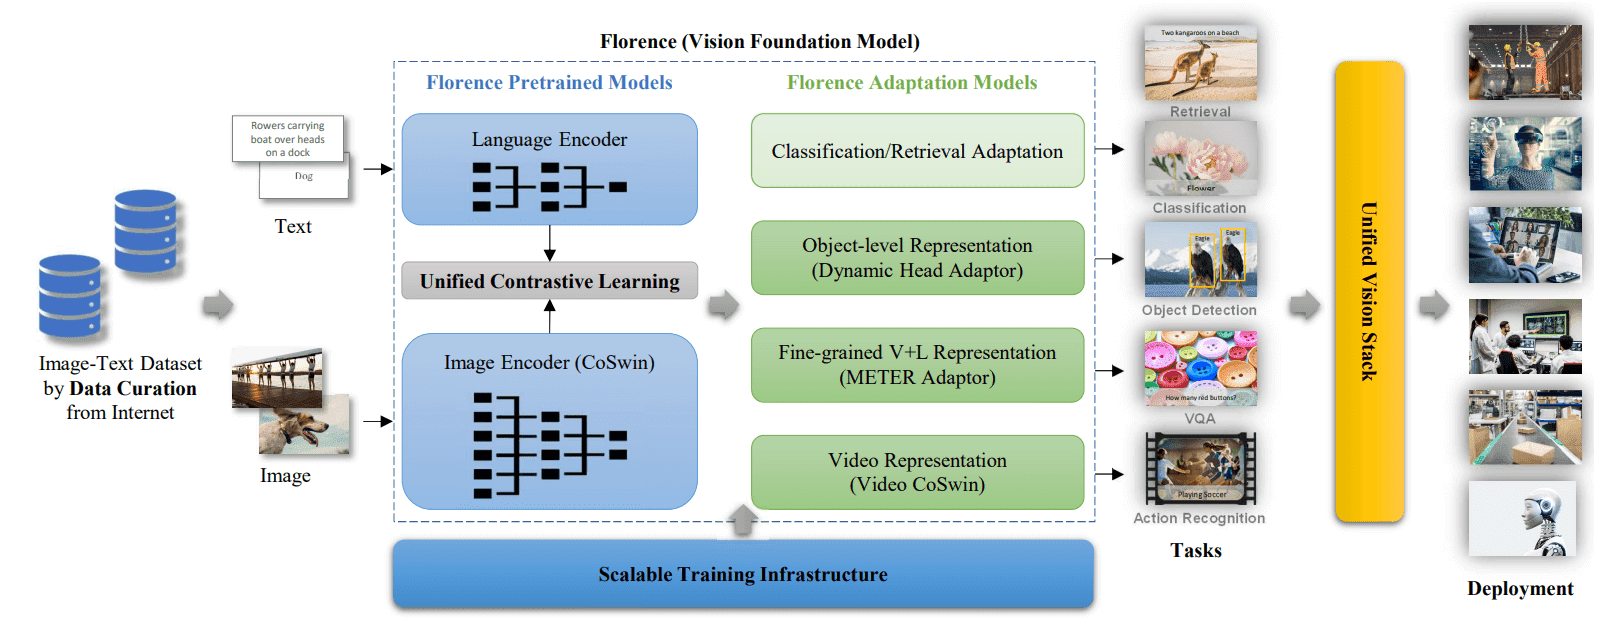
Vision Language models: towards multi-modal deep learning | AI Summer