
A New Promising Benchmark For Code Generation Models Rllmupdated

A new promising benchmark for code generation models : r/llm_updated

New benchmark for LLMs on secure code generation | Clint Gibler posted ...

A Survey on Large Language Models for Code Generation | ACM ...

DevBench: A Realistic, Developer-Informed Benchmark for Code Generation ...

DevBench: A Realistic, Developer-Informed Benchmark for Code Generation ...

A Survey on Large Language Models for Code Generation | ACM ...
1D-Bench: A Benchmark for Iterative UI Code Generation with Visual ...

(PDF) A Survey on Large Language Models for Code Generation (2024) | J ...

A Survey on Large Language Models for Code Generation | ACM ...

DevBench: A Realistic, Developer-Informed Benchmark for Code Generation ...
Advertisement Space (300x250)

(PDF) Tests as Prompt: A Test-Driven-Development Benchmark for LLM Code ...
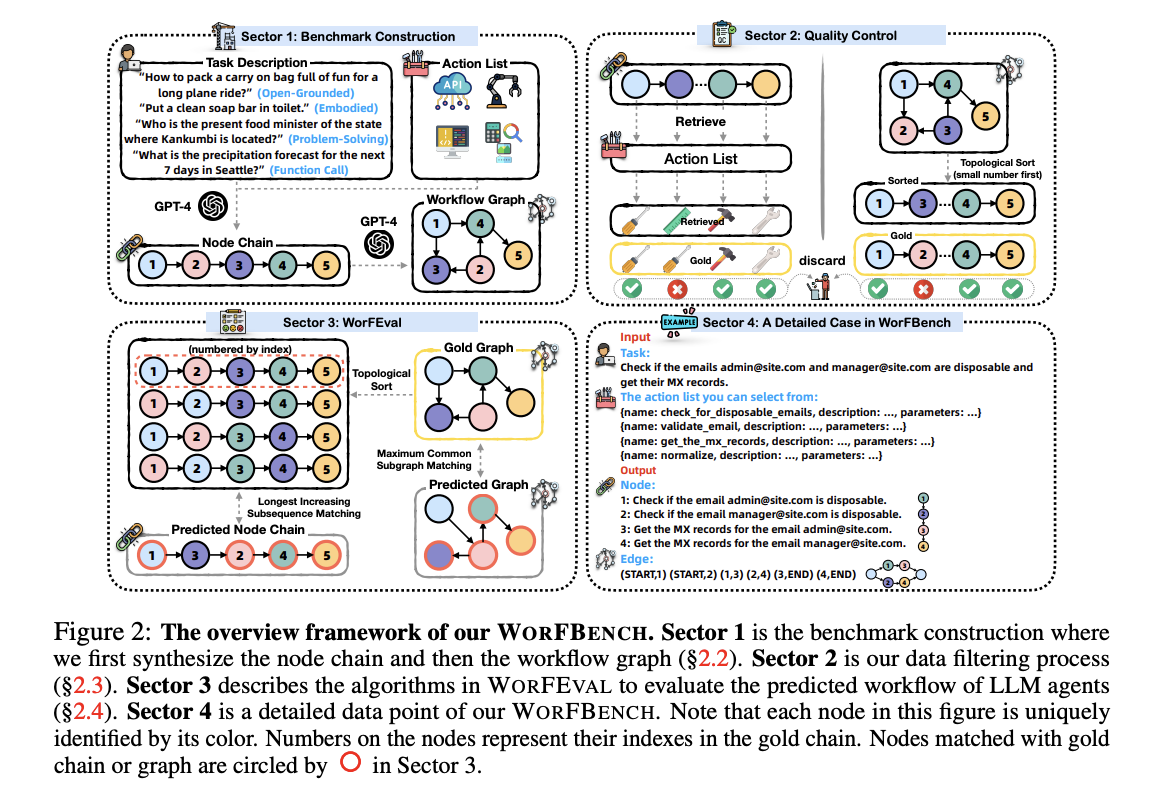
WorFBench: A Benchmark for Evaluating Complex Workflow Generation in ...

Announcing UA-Code-Bench: a New Benchmark for Evaluating LLMs on ...
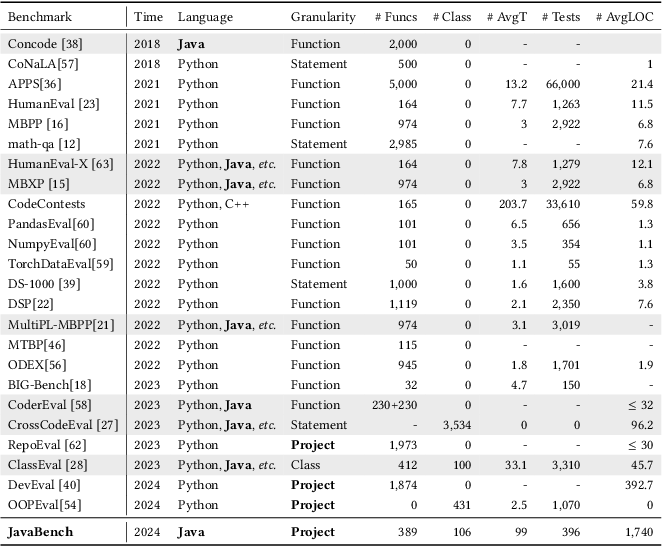
Table 1 from JavaBench: A Benchmark of Object-Oriented Code Generation ...

Paper page - DA-Code: Agent Data Science Code Generation Benchmark for ...

AI Code Generation: New DevQualityEval Benchmark Reveals Which LLMs ...

Rethinking Verification for LLM Code Generation: From Generation to ...

[论文评述] Large Language Models for Code Generation: The Practitioners ...
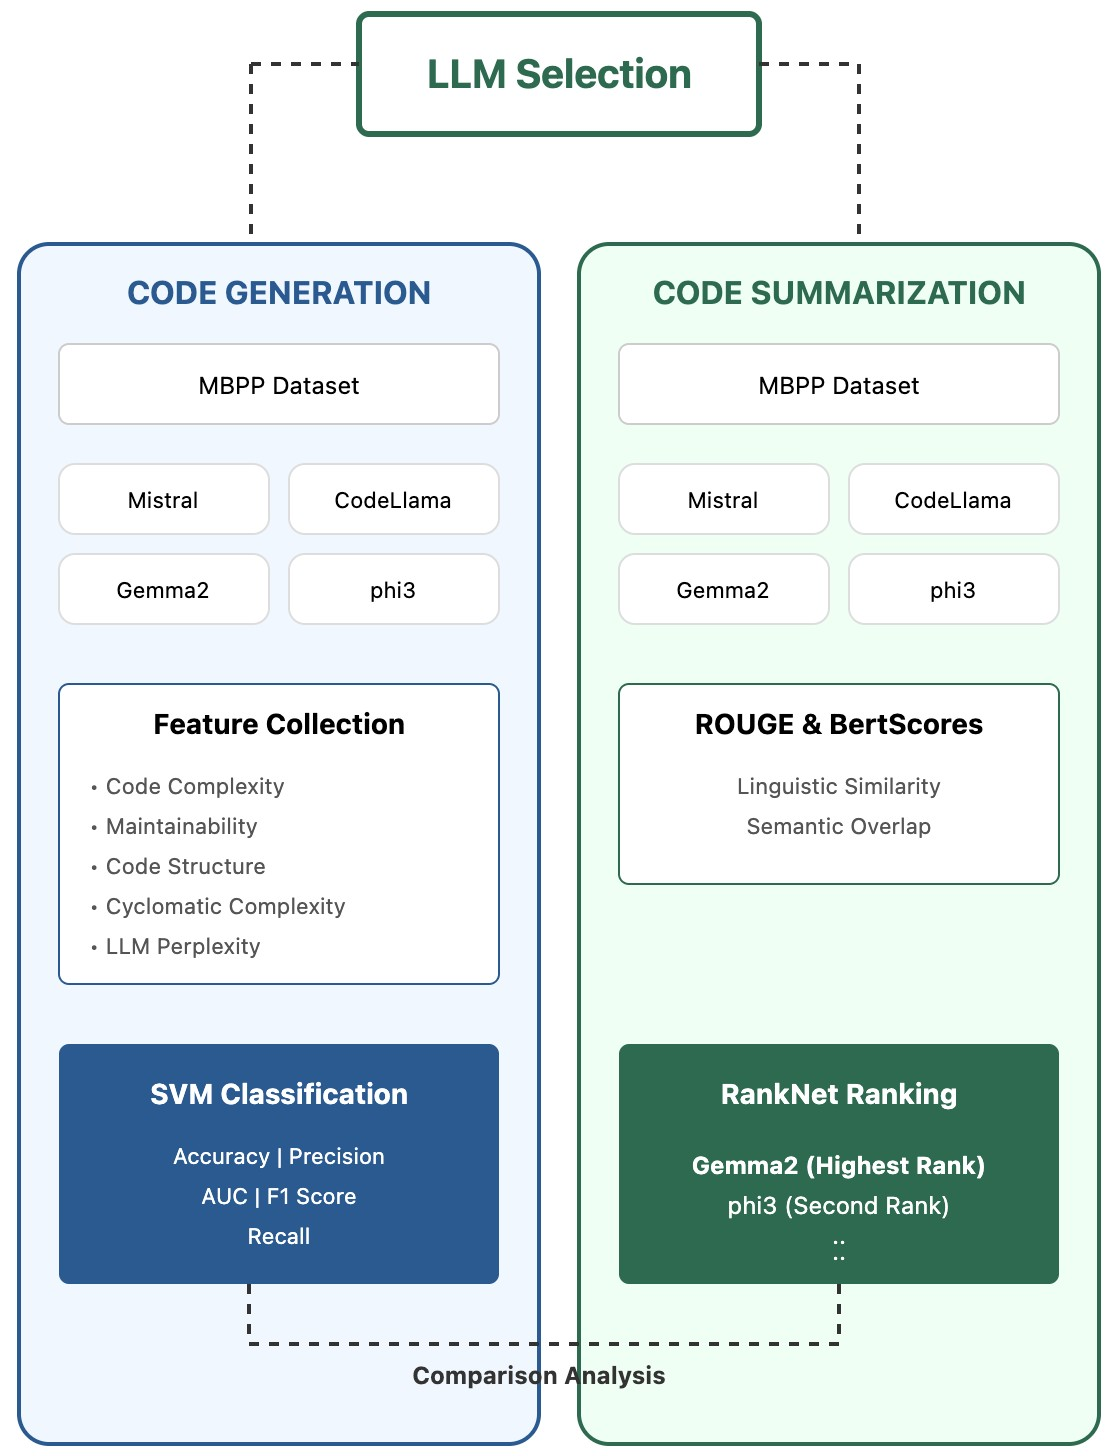
Evaluating LLMs for Source Code Generation and Summarization Using ...

RTLLM: An Open-Source Benchmark for Design RTL Generation with Large ...
Advertisement Space (336x280)

(PDF) REPOEXEC: Evaluate Code Generation with a Repository-Level ...

(PDF) Enhancing LLM-Based Code Generation with Complexity Metrics: A ...

Paper page - EvoCodeBench: An Evolving Code Generation Benchmark ...

[2504.02141] On Simulation-Guided LLM-based Code Generation for Safe ...

(PDF) ClassEval: A Manually-Crafted Benchmark for Evaluating LLMs on ...

Web-Bench: A LLM Code Benchmark Based on Web Standards and Frameworks ...

mHumanEval - A Multilingual Benchmark to Evaluate Large Language Models ...

GDPval Benchmark Explained: Best AI Models for Real-World Work Tasks (2026)

Paper page - FEA-Bench: A Benchmark for Evaluating Repository-Level ...

Figure 1 from PCEBench: A Multi-Dimensional Benchmark for Evaluating ...
Advertisement Space (336x280)

On Simulation-Guided LLM-based Code Generation for Safe Autonomous ...

Paper page - Plot2Code: A Comprehensive Benchmark for Evaluating Multi ...

Dynamic Benchmark Construction for Evaluating Large Language Models on ...

GDPval Benchmark Explained: Best AI Models for Real-World Work Tasks (2026)

[論文レビュー] Enhancing LLM Code Generation with Ensembles: A Similarity ...

[论文笔记] A Survey on Code Generation with LLM-based Agents - sysss - 博客园