
Accelerating Diffusion Language Model Inference Via Efficient
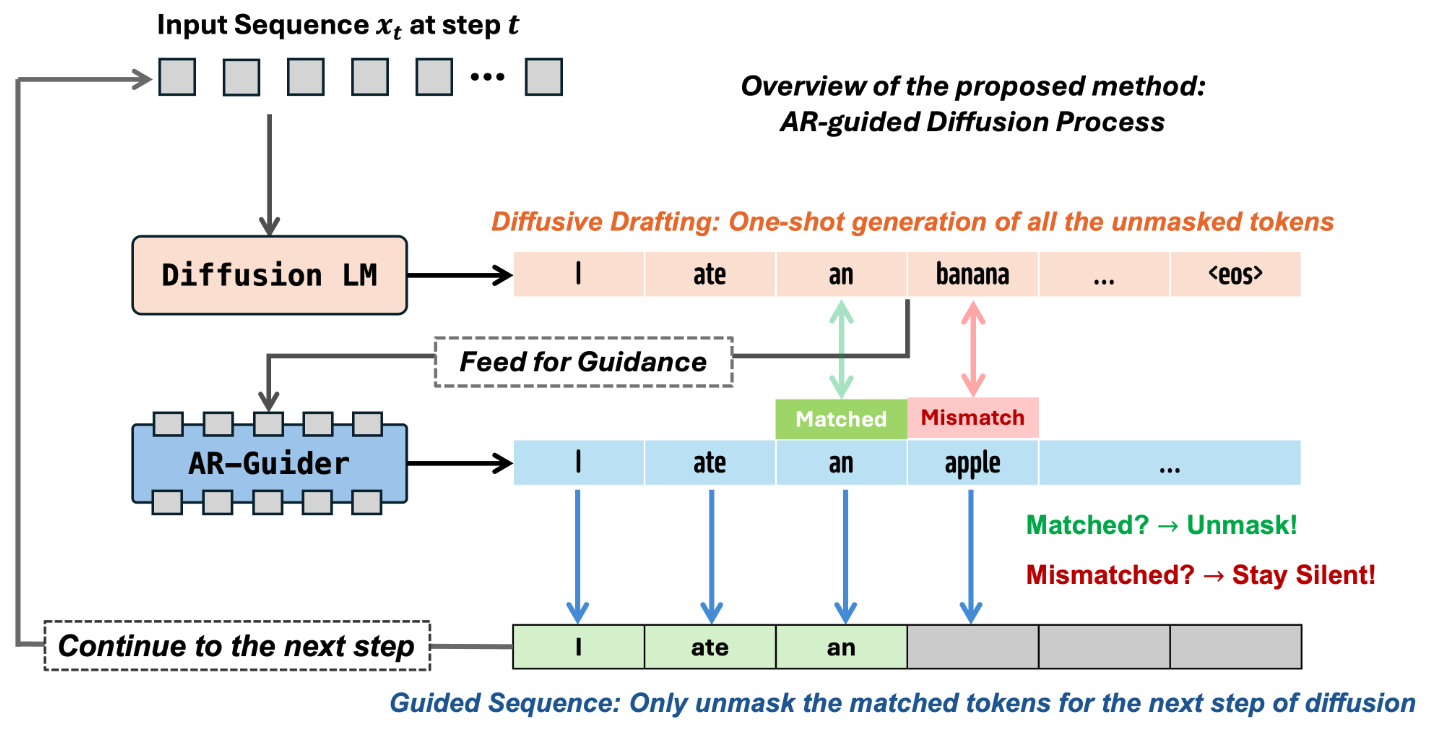
FlashDLM: Accelerating Diffusion Language Model Inference via Efficient ...

[논문 리뷰] Accelerating Diffusion Language Model Inference via Efficient ...

Paper page - Accelerating Diffusion Language Model Inference via ...
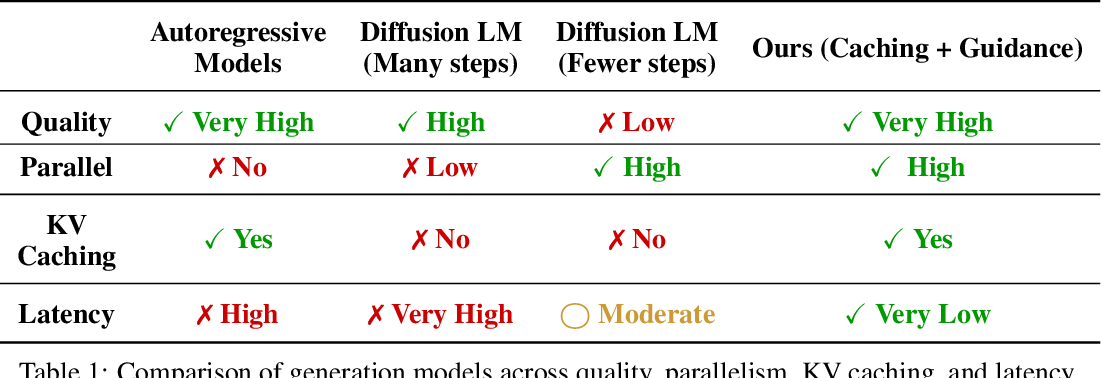
Table 1 from Accelerating Diffusion Language Model Inference via ...

Window-Diffusion: Accelerating Diffusion Language Model Inference with ...
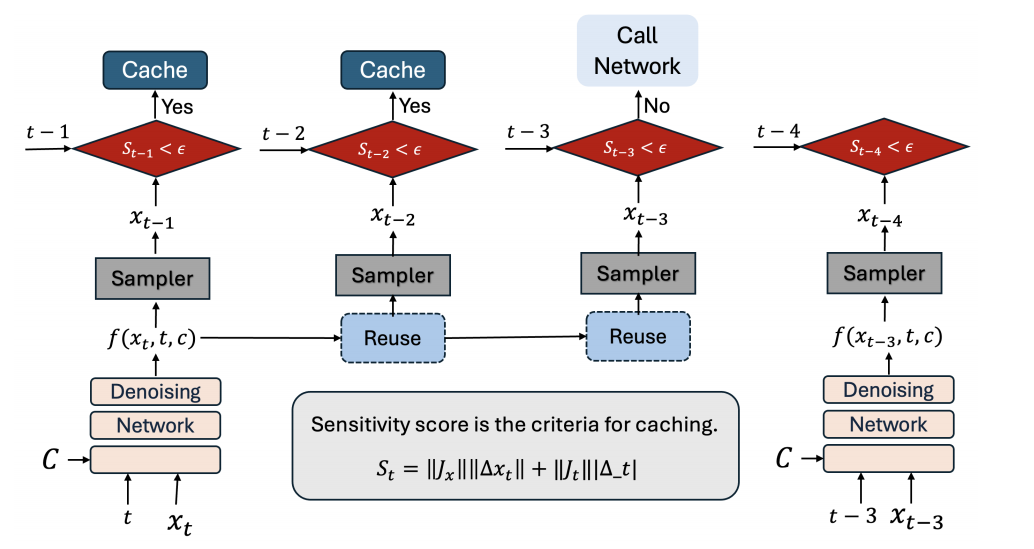
论文阅读:SenCache: Accelerating Diffusion Model Inference via Sensitivity ...
SenCache: Accelerating Diffusion Model Inference via Sensitivity-Aware ...

Paper page - SenCache: Accelerating Diffusion Model Inference via ...

Otil: Accelerating Diffusion Model Inference via Communication ...
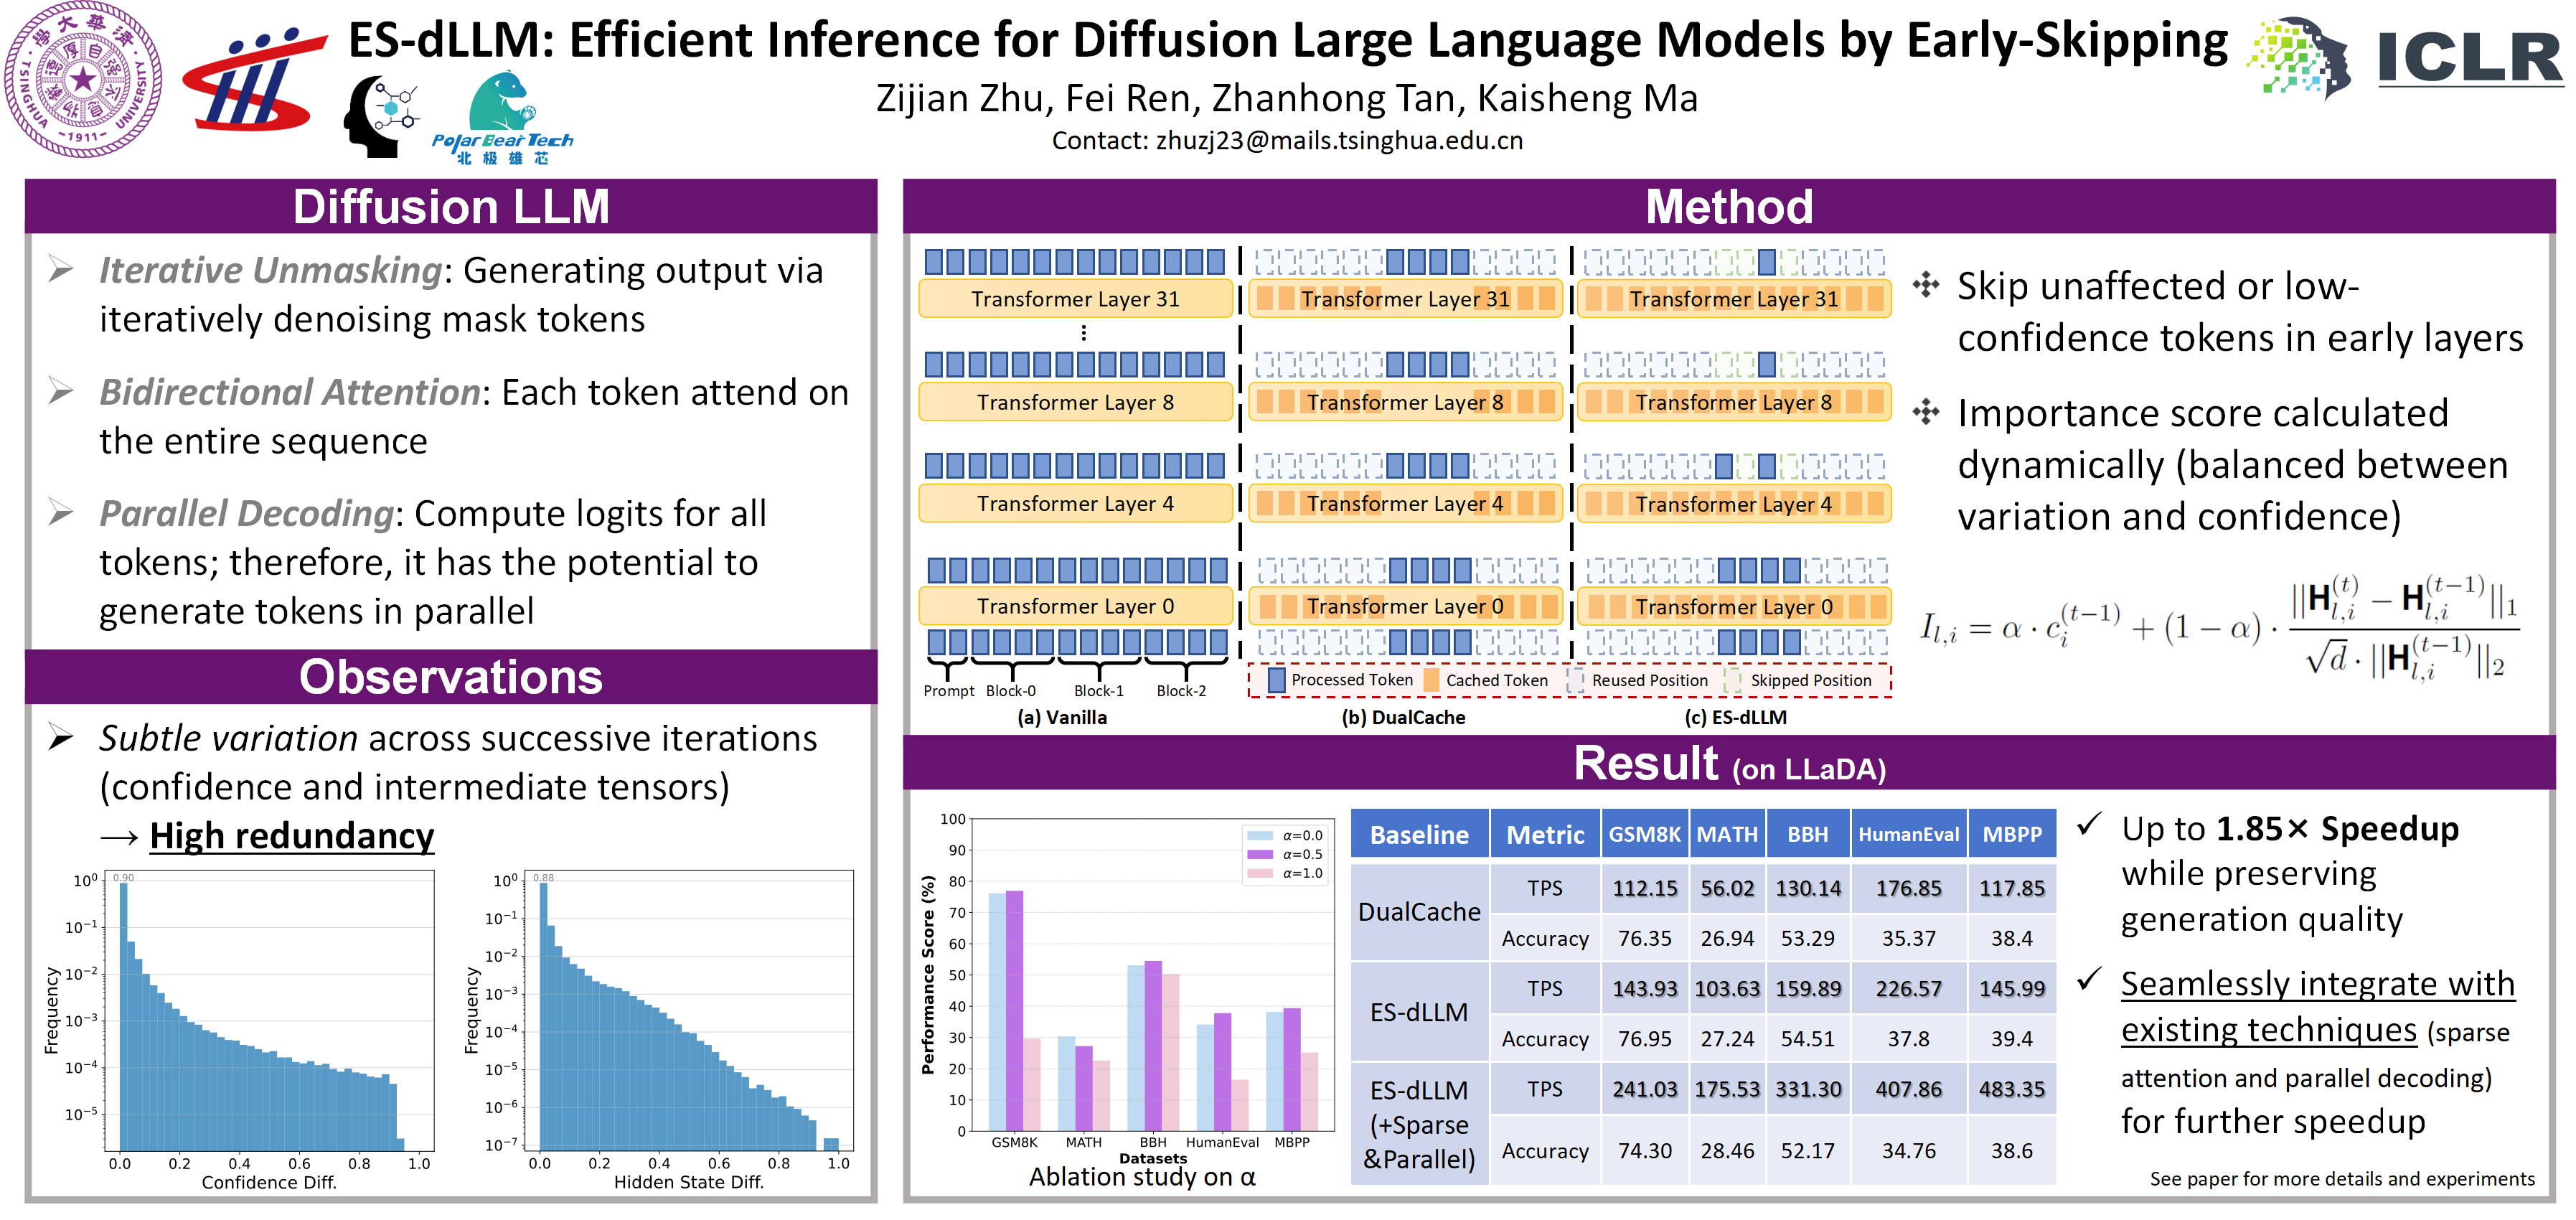
ICLR Poster ES-dLLM: Efficient Inference for Diffusion Large Language ...
Advertisement Space (300x250)

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...

Focus-dLLM: Accelerating Long-Context Diffusion LLM Inference via ...

Learning to Parallel: Accelerating Diffusion Large Language Models via ...

Efficient Self-Evaluation for Diffusion Language Models via Sequence ...

No Cache Left Idle: Accelerating diffusion model via Extreme-slimming ...
SpecDiff: Accelerating Diffusion Model Inference with Self-Speculation ...
SpecDiff: Accelerating Diffusion Model Inference with Self-Speculation ...
Diffusion Language Model Inference with Monte Carlo Tree Search | AI ...
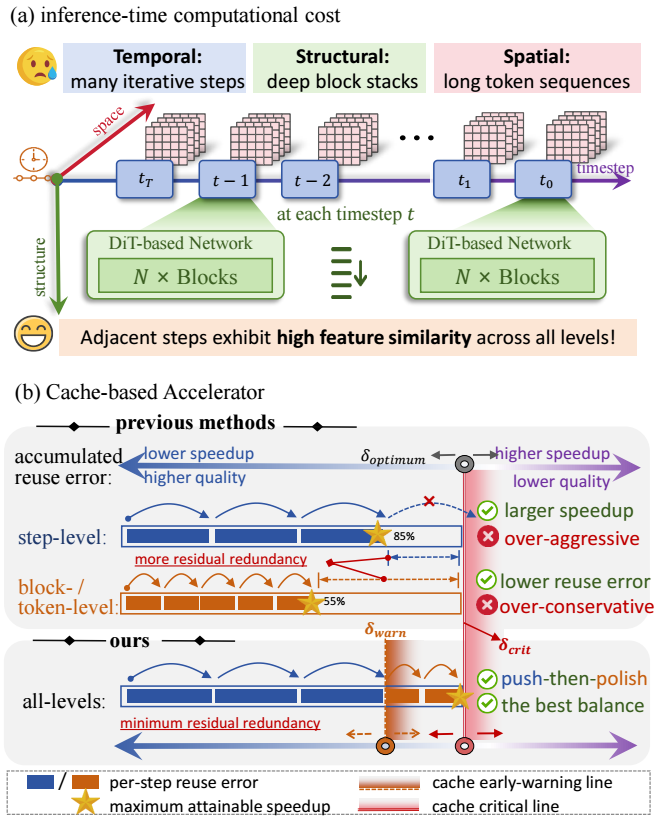
X-Slim: No Cache Left Idle -- Accelerating Diffusion Model via Extreme ...
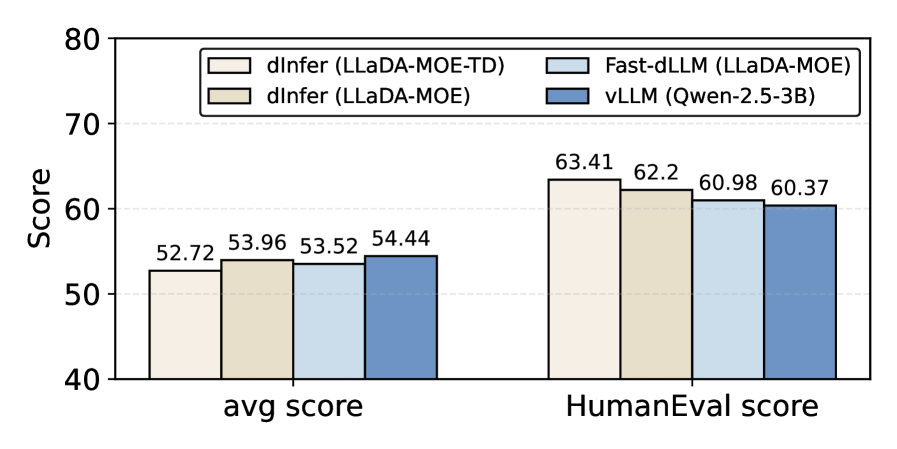
dInfer: An Efficient Inference Framework for Diffusion Language Models ...
Advertisement Space (336x280)

Accelerating Large Language Model Inference: Techniques for Efficient ...

Efficient Self-Evaluation for Diffusion Language Models via Sequence ...

dInfer: An Efficient Inference Framework for Diffusion Language Models ...

Accelerating Diffusion via Hybrid Data-Pipeline Parallelism Based on ...

Accelerating Diffusion Language Models with Unmasking Schedules and ...

Speculative Diffusion Decoding: Accelerating Language Generation ...

How Efficient Are Diffusion Language Models? A Critical Examination of ...

Speculative Diffusion Decoding: Accelerating Language Generation ...

Accelerating Inference in Molecular Diffusion Models with Latent ...

Accelerating Inference in Molecular Diffusion Models with Latent ...
Advertisement Space (336x280)

LLM Inference Acceleration via Efficient Operation Fusion | AI Research ...
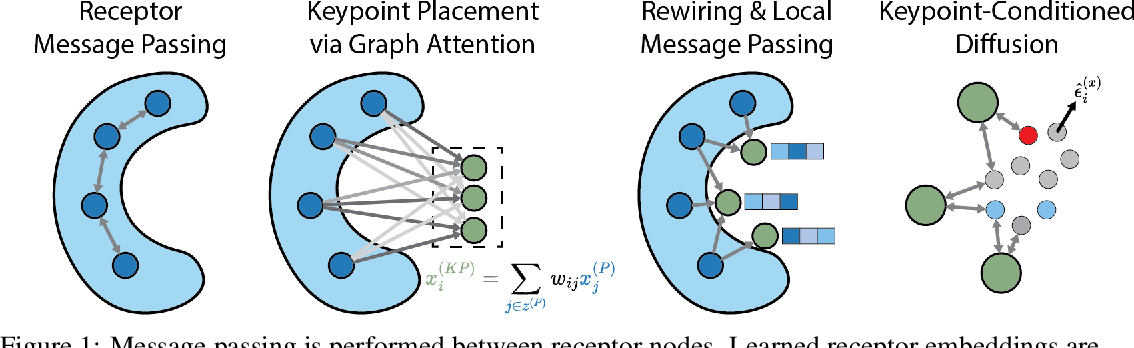
Figure 1 from Accelerating Inference in Molecular Diffusion Models with ...

Accelerating Diffusion Models with Parallel Sampling: Inference at Sub ...
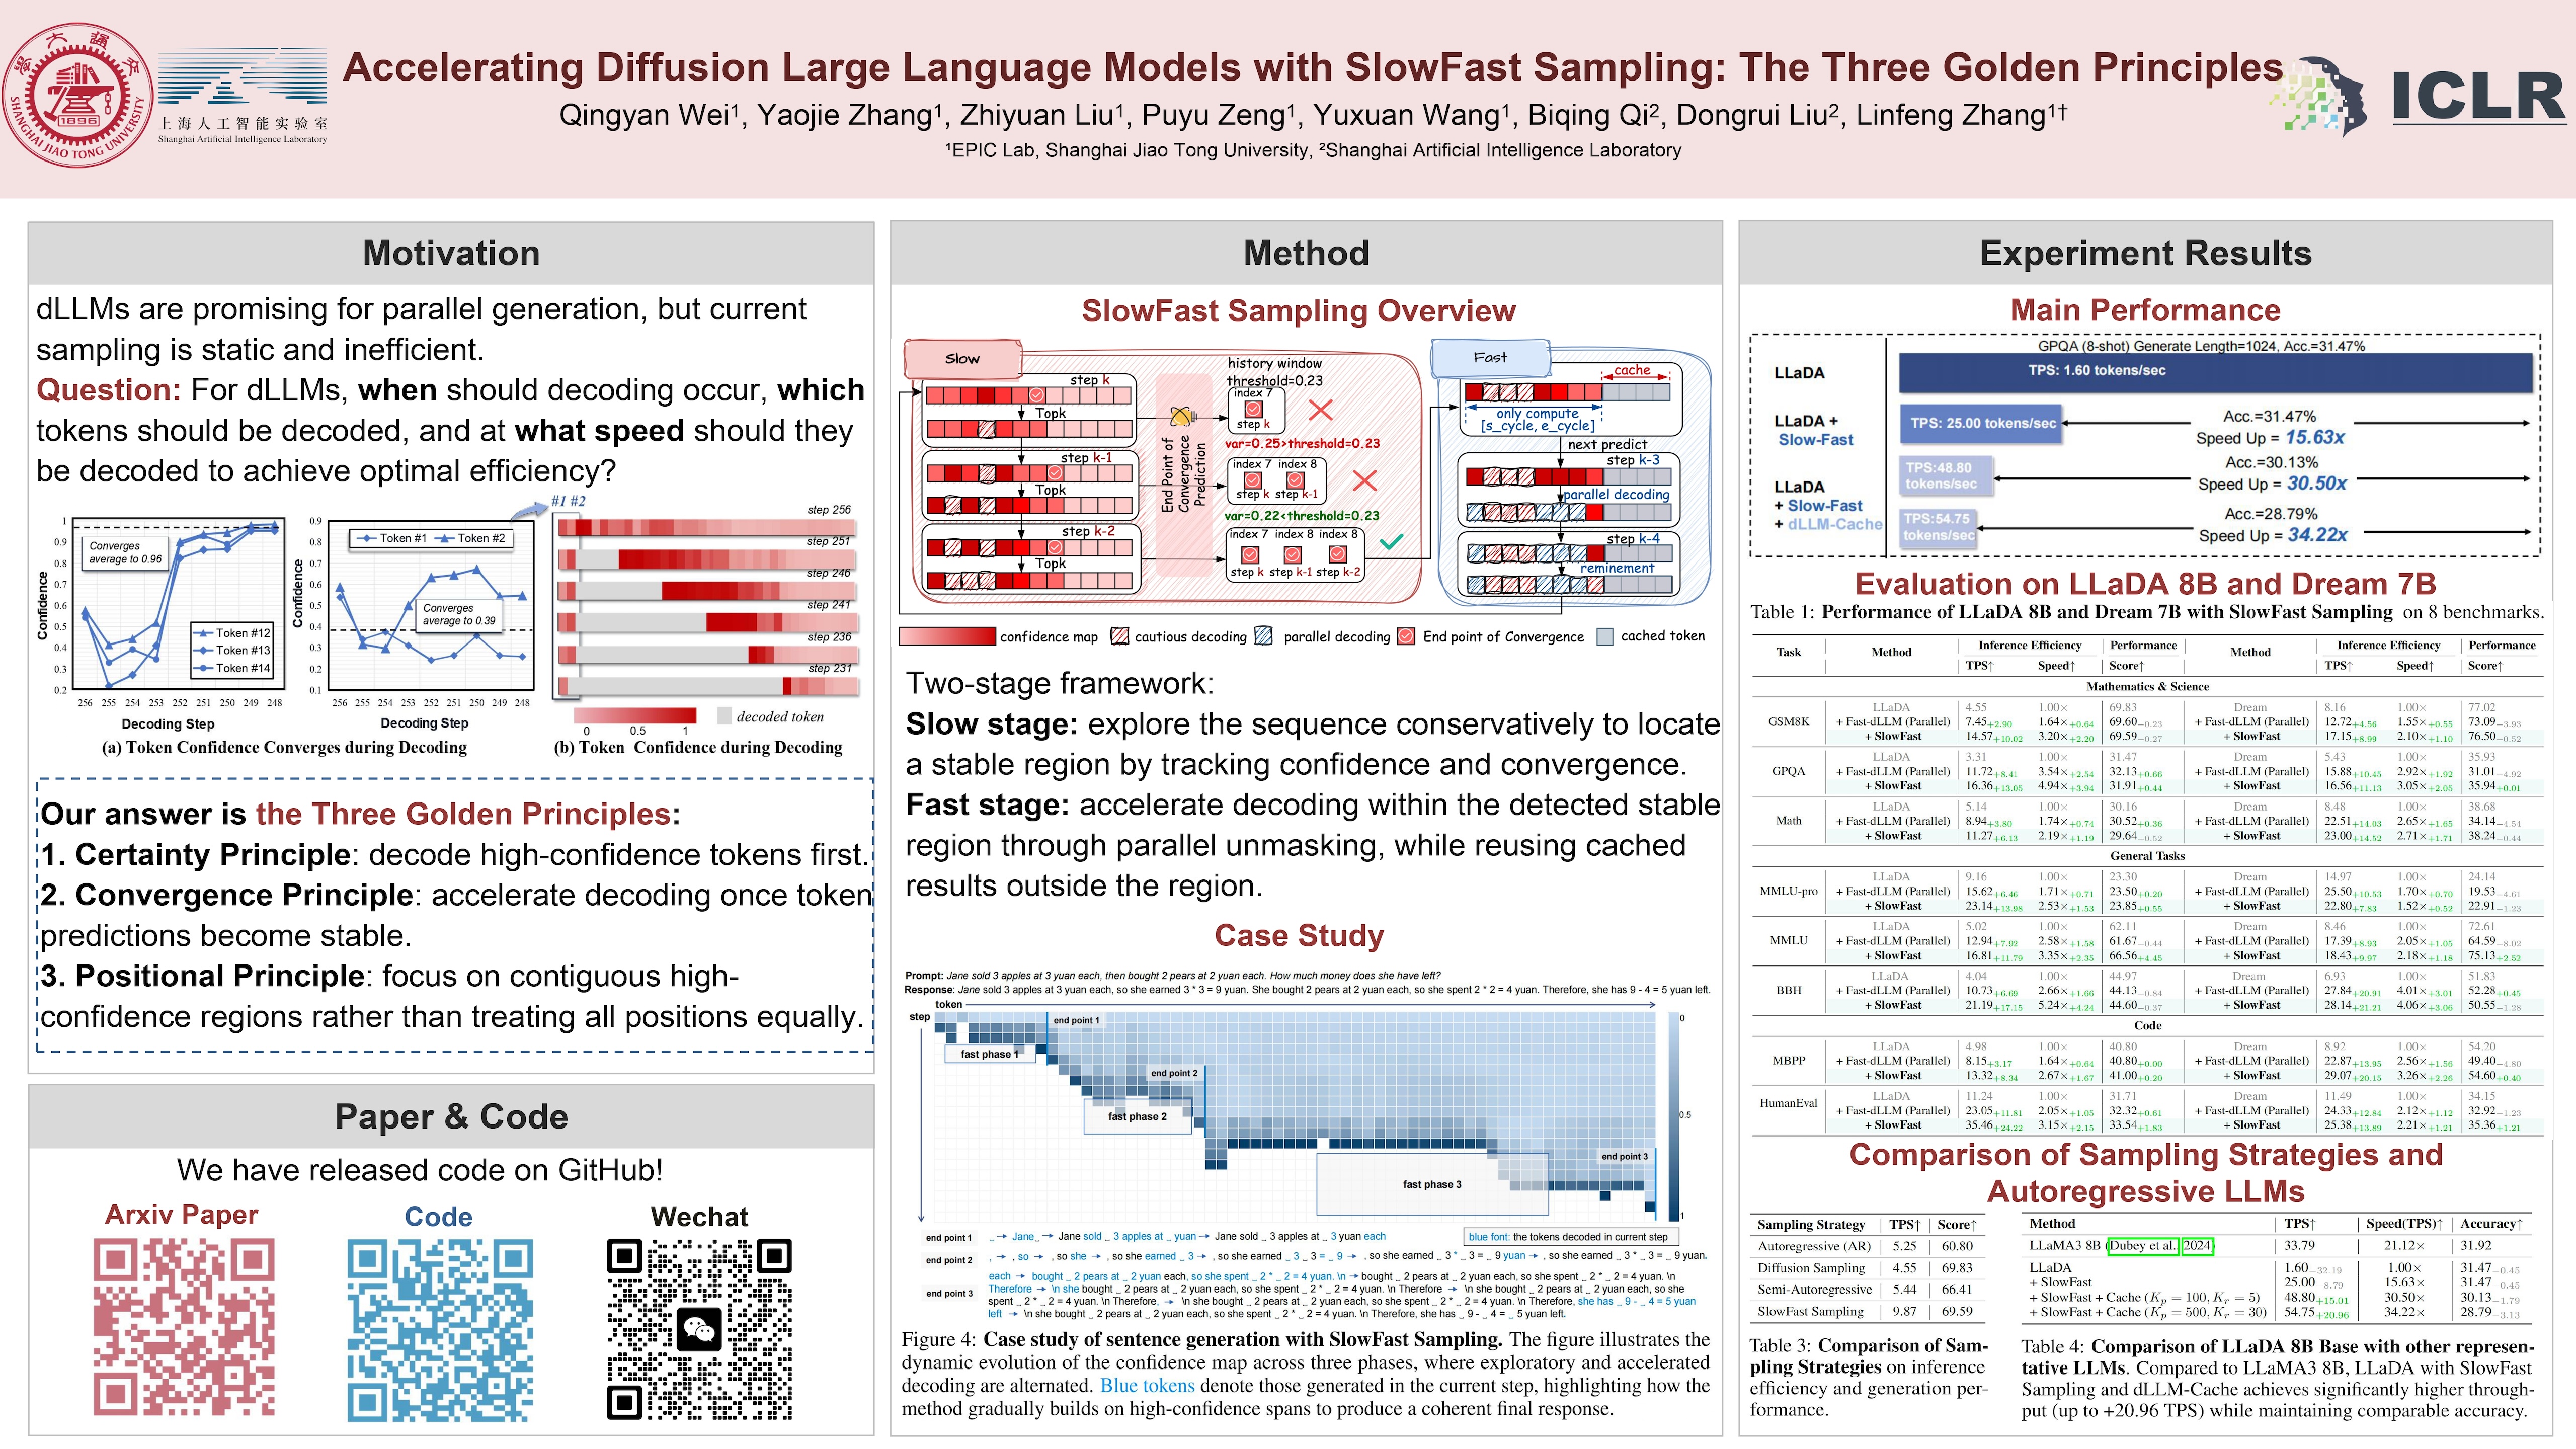
ICLR Poster Accelerating Diffusion Large Language Models with SlowFast ...
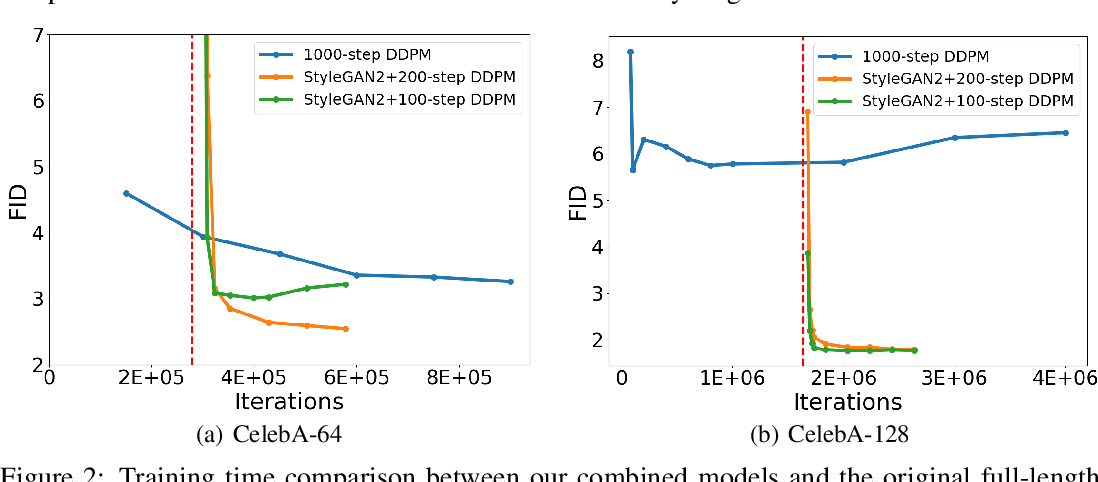
Accelerating Diffusion Models via Early Stop of the Diffusion Process ...

Efficient Inference for Large Language Model-based Generative ...