
Accelerating Diffusion Llms Via Adaptive Parallel Decoding Ai
Accelerating Diffusion LLMs via Adaptive Parallel Decoding - AI ...

Accelerating Diffusion LLMs via Adaptive Parallel Decoding - YouTube

(PDF) Accelerating Diffusion LLMs via Adaptive Parallel Decoding
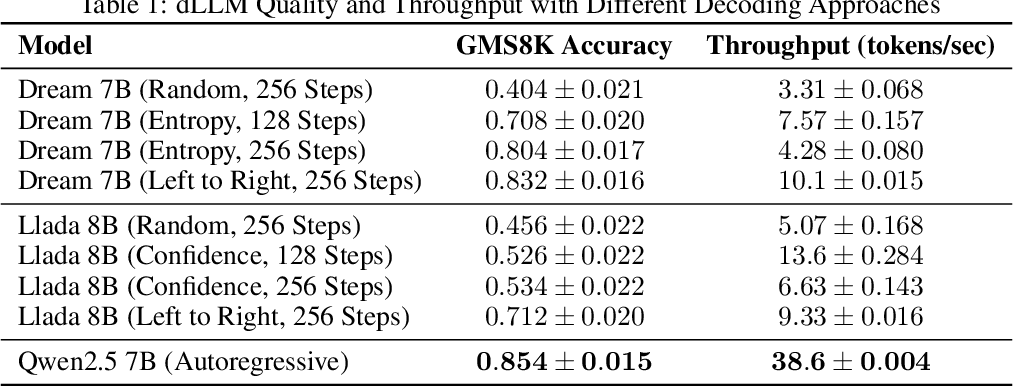
Table 1 from Accelerating Diffusion LLMs via Adaptive Parallel Decoding ...
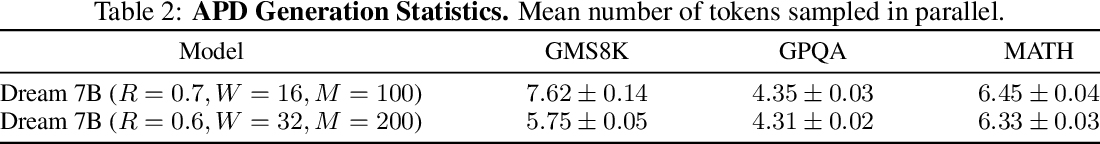
Table 2 from Accelerating Diffusion LLMs via Adaptive Parallel Decoding ...
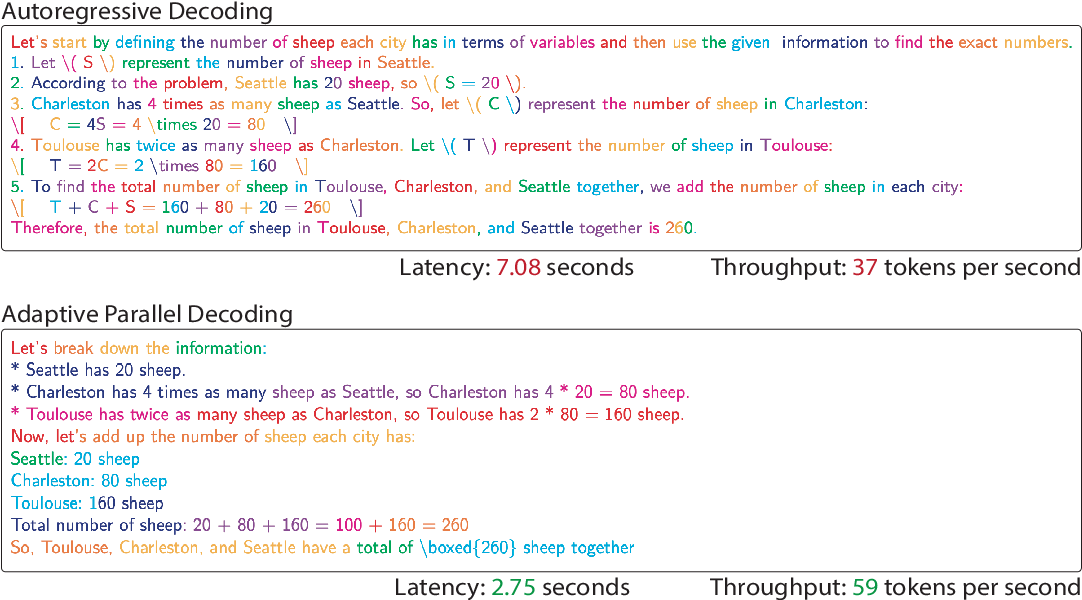
Figure 1 from Accelerating Diffusion LLMs via Adaptive Parallel ...
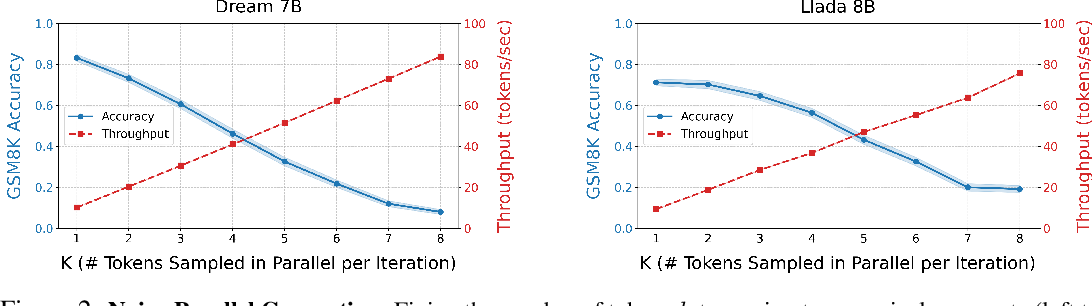
Figure 2 from Accelerating Diffusion LLMs via Adaptive Parallel ...
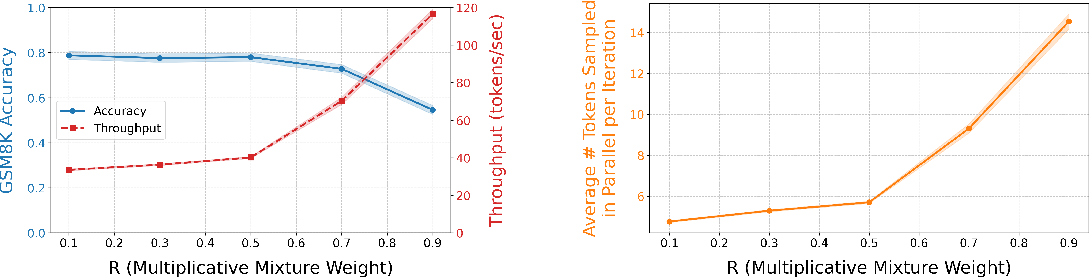
Figure 3 from Accelerating Diffusion LLMs via Adaptive Parallel ...
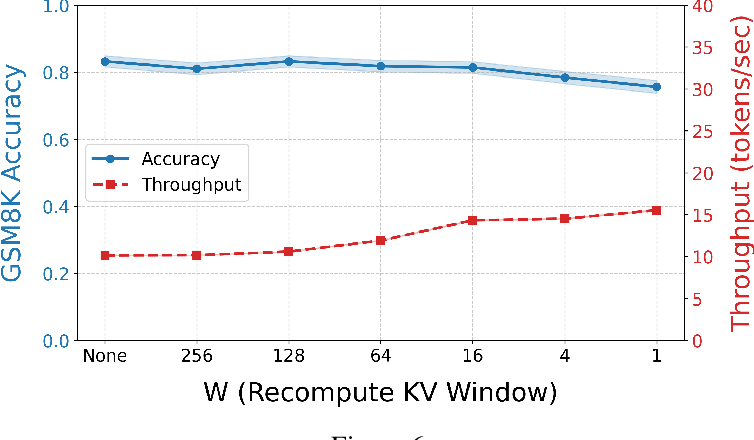
Figure 6 from Accelerating Diffusion LLMs via Adaptive Parallel ...

Dependency-Aware Parallel Decoding via Attention for Diffusion LLMs
Advertisement Space (300x250)
Unlock Parallel Decoding for Diffusion LLMs with Fast-dLLM on Nebula Block
Bridging the Parallel Decoding of LLMs with the Diffusion Process ...
Bridging the Parallel Decoding of LLMs with the Diffusion Process ...

Streaming-dLLM: Accelerating Diffusion LLMs via Suffix Pruning and ...

Paper page - Streaming-dLLM: Accelerating Diffusion LLMs via Suffix ...

A-FloPS: Accelerating Diffusion Models via Adaptive Flow Path Sampler ...

Accelerating Diffusion Transformer via Gradient-Optimized Cache | AI ...

PSD: Pushing the Pareto Frontier of Diffusion LLMs via Parallel ...
PSD paper — Parallel speculative decoding for diffusion LLMs — What ...

How Diffusion LLMs revolutionize AI with parallel processing | KeyValue ...
Advertisement Space (336x280)
DepCap: Adaptive Block-Wise Parallel Decoding for Efficient Diffusion ...
Accelerating AI Inference: Adaptive Speculative Decoding Across ...
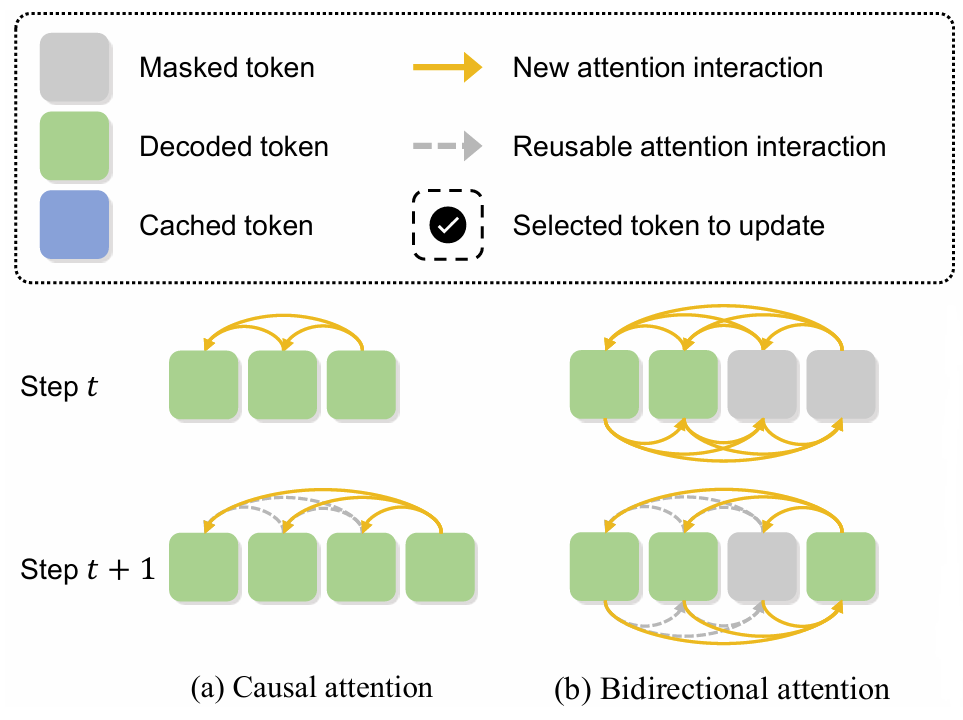
d2Cache: Accelerating Diffusion-Based LLMs via Dual Adaptive Caching ...
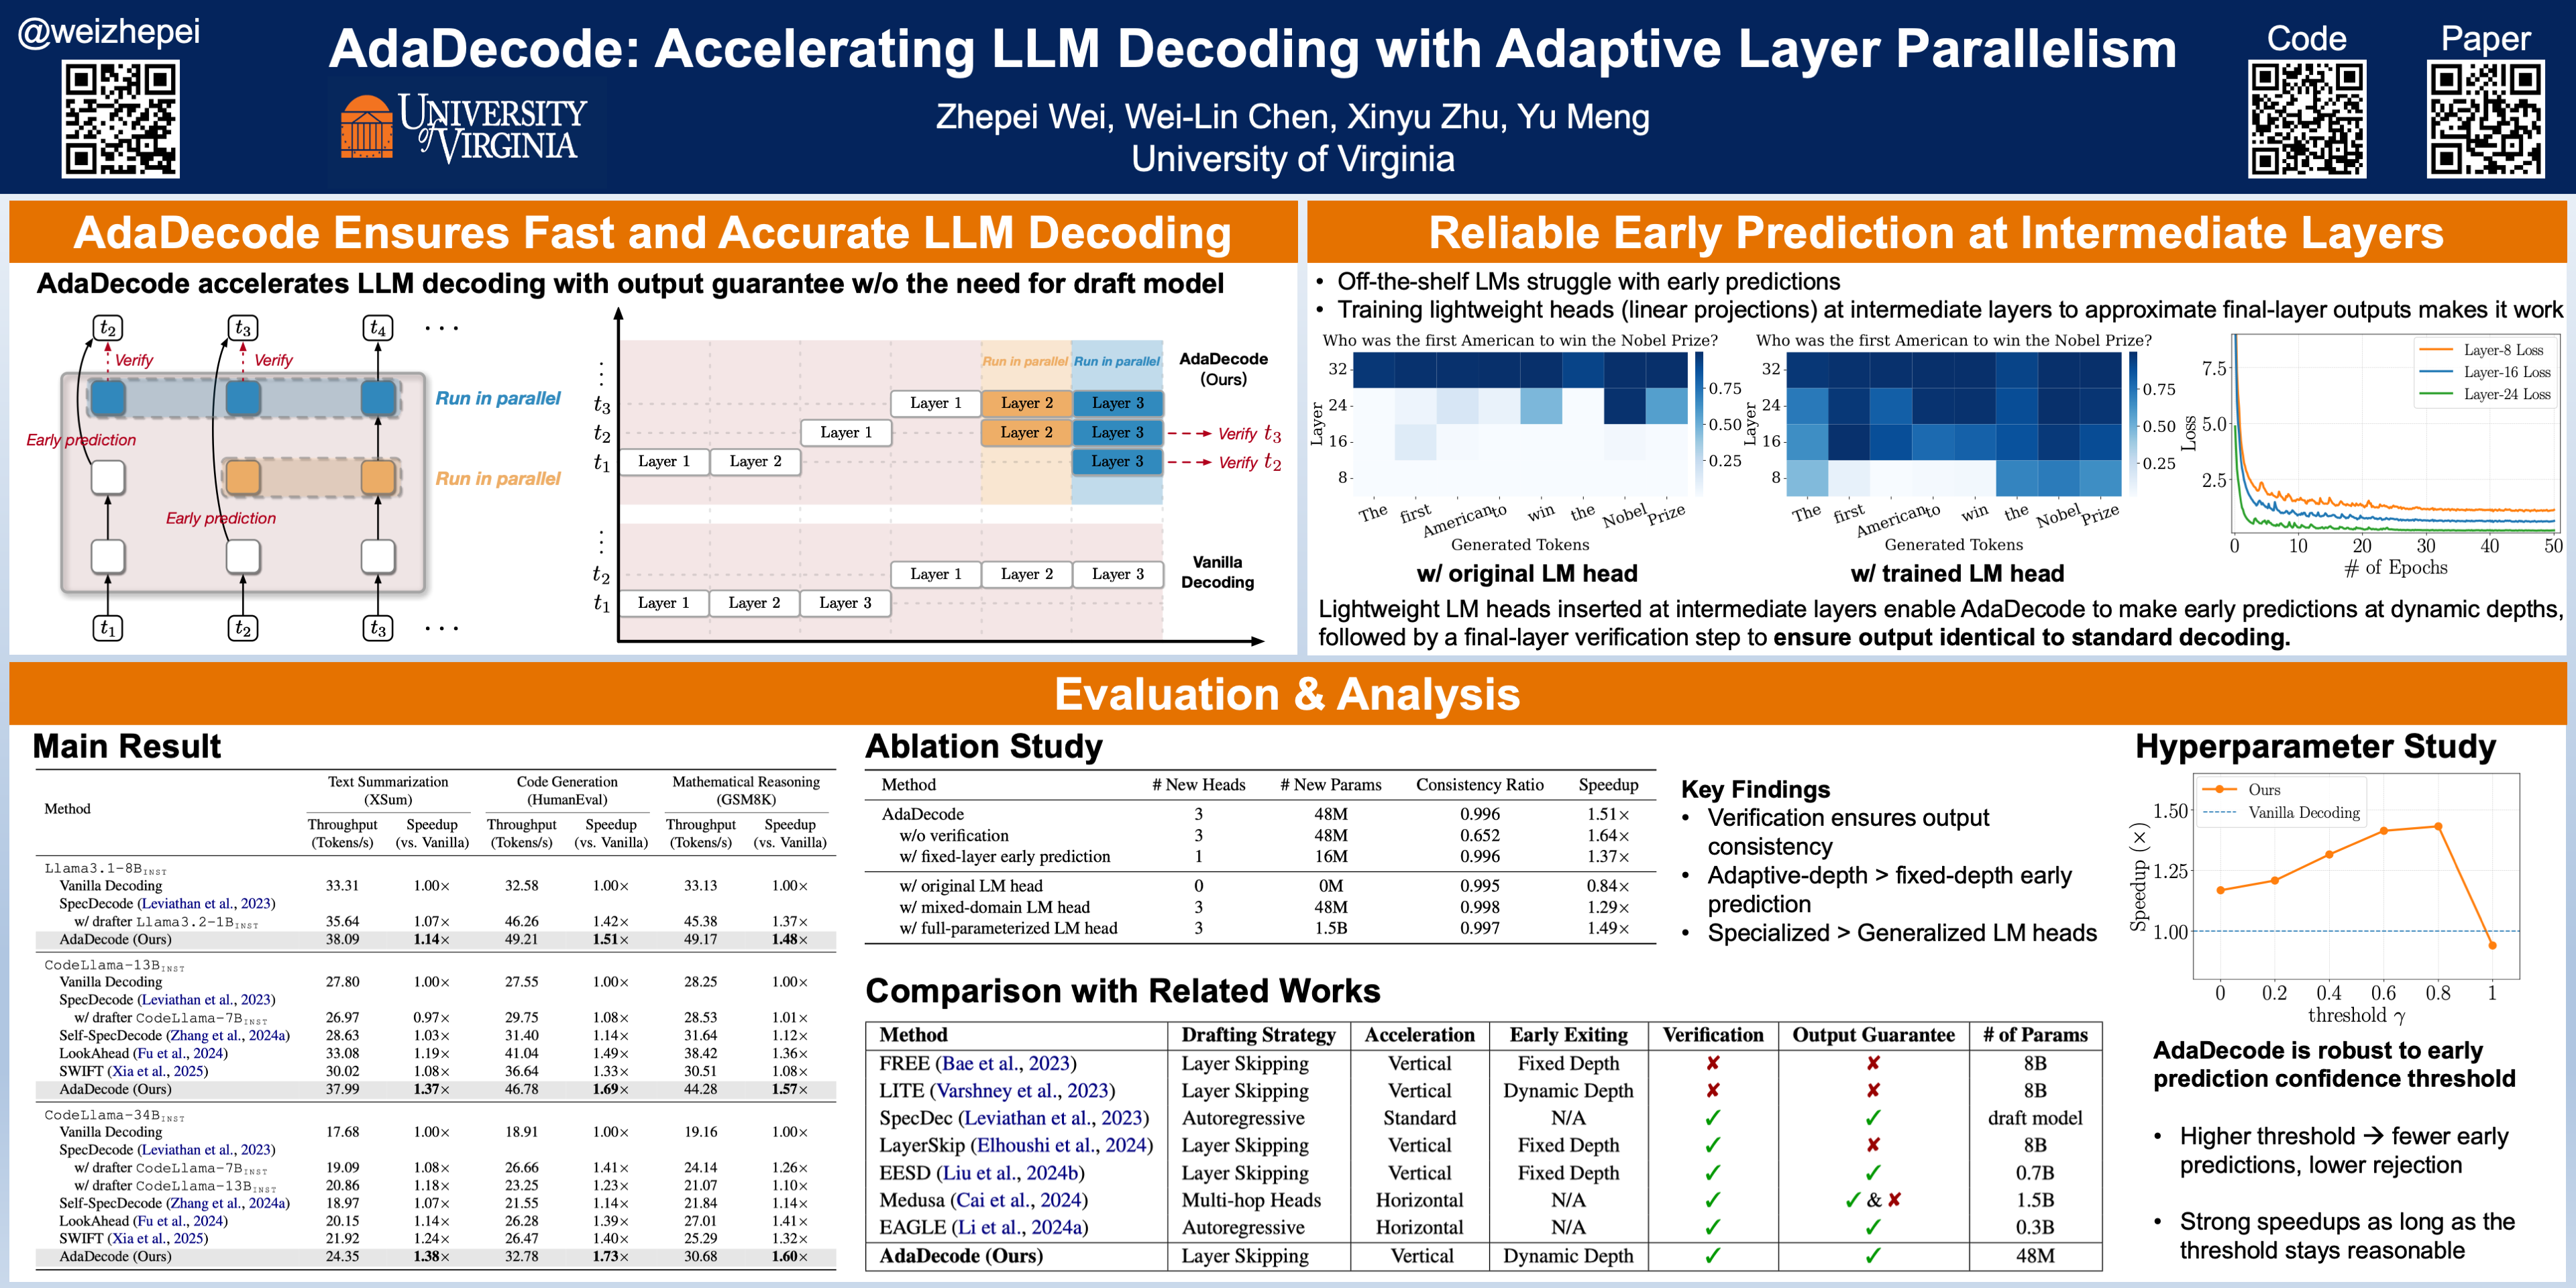
ICML Poster AdaDecode: Accelerating LLM Decoding with Adaptive Layer ...

Figure 1 from d2Cache: Accelerating Diffusion-Based LLMs via Dual ...

Dynamic-dLLM: Dynamic Cache-Budget and Adaptive Parallel Decoding for ...

Learning to Parallel: Accelerating Diffusion Large Language Models via ...

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...

Dynamic-dLLM: Dynamic Cache-Budget and Adaptive Parallel Decoding for ...

Dynamic-dLLM: Dynamic Cache-Budget and Adaptive Parallel Decoding for ...
Advertisement Space (336x280)
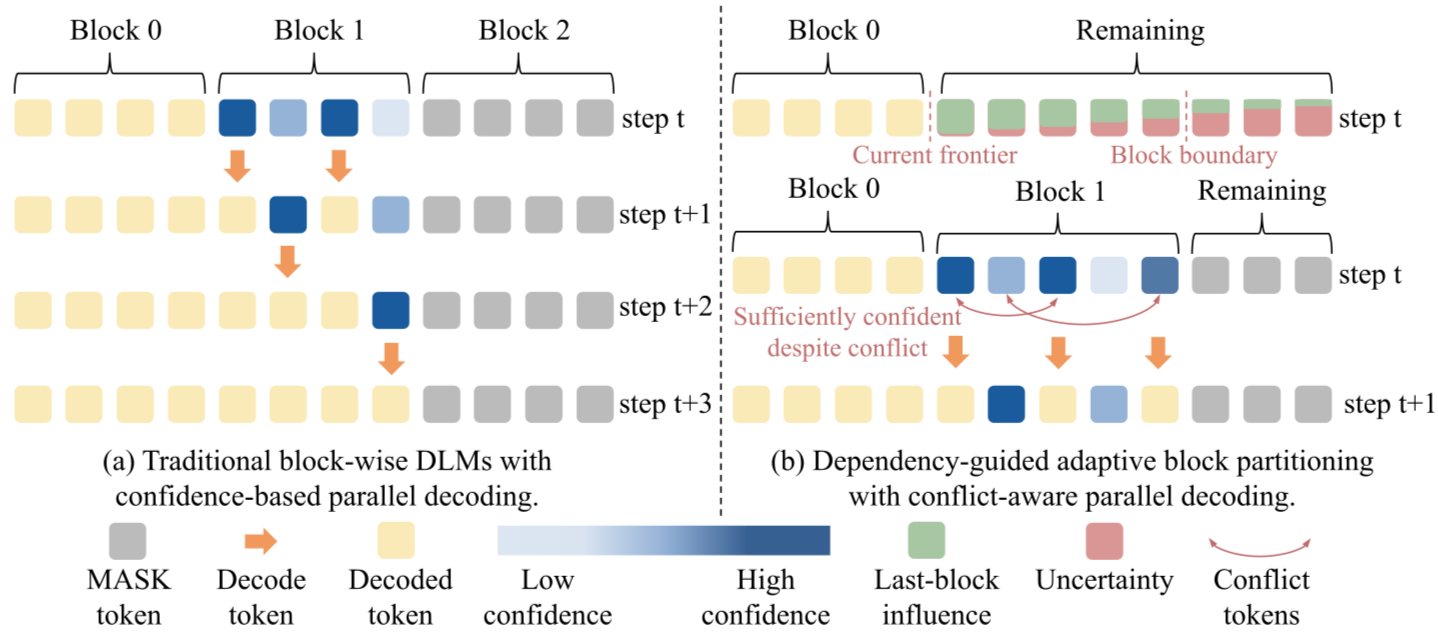
[论文评述] DepCap: Adaptive Block-Wise Parallel Decoding for Efficient ...

[论文评述] Accelerate Parallelizable Reasoning via Parallel Decoding within ...
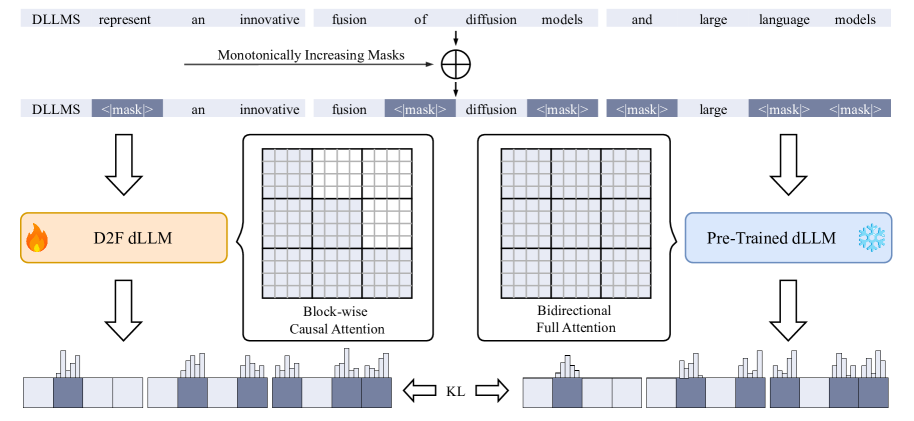
Diffusion LLMs Can Do Faster-Than-AR Inference via Discrete Diffusion ...

Dynamic-dLLM: Dynamic Cache-Budget and Adaptive Parallel Decoding for ...

Paper page - Sparse-dLLM: Accelerating Diffusion LLMs with Dynamic ...
Berkeley AI Research rivoluziona i LLM con Adaptive Parallel Reasoning ...