
Accelerating Diffusion Llms Via Adaptive Parallel Decoding Paper Details

(PDF) Accelerating Diffusion LLMs via Adaptive Parallel Decoding
Accelerating Diffusion LLMs via Adaptive Parallel Decoding - AI ...

[QA] Accelerating Diffusion LLMs via Adaptive Parallel Decoding - YouTube
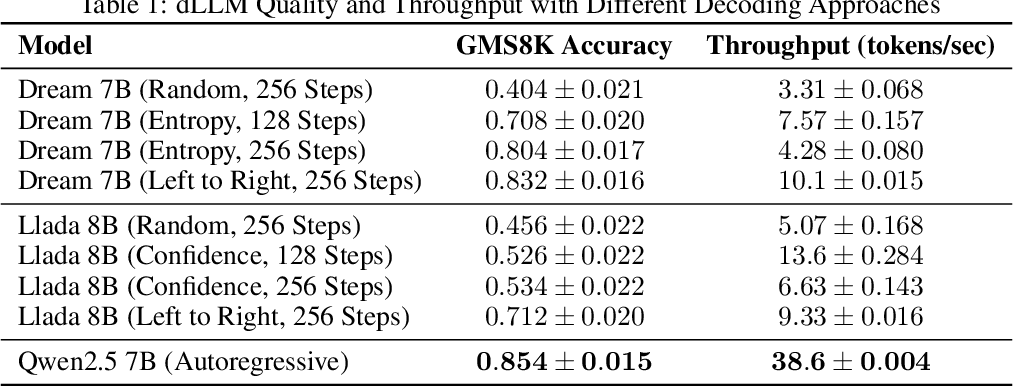
Table 1 from Accelerating Diffusion LLMs via Adaptive Parallel Decoding ...
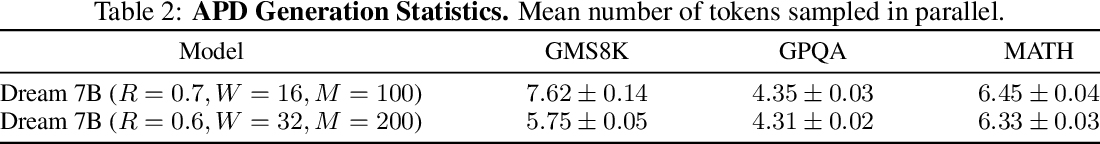
Table 2 from Accelerating Diffusion LLMs via Adaptive Parallel Decoding ...
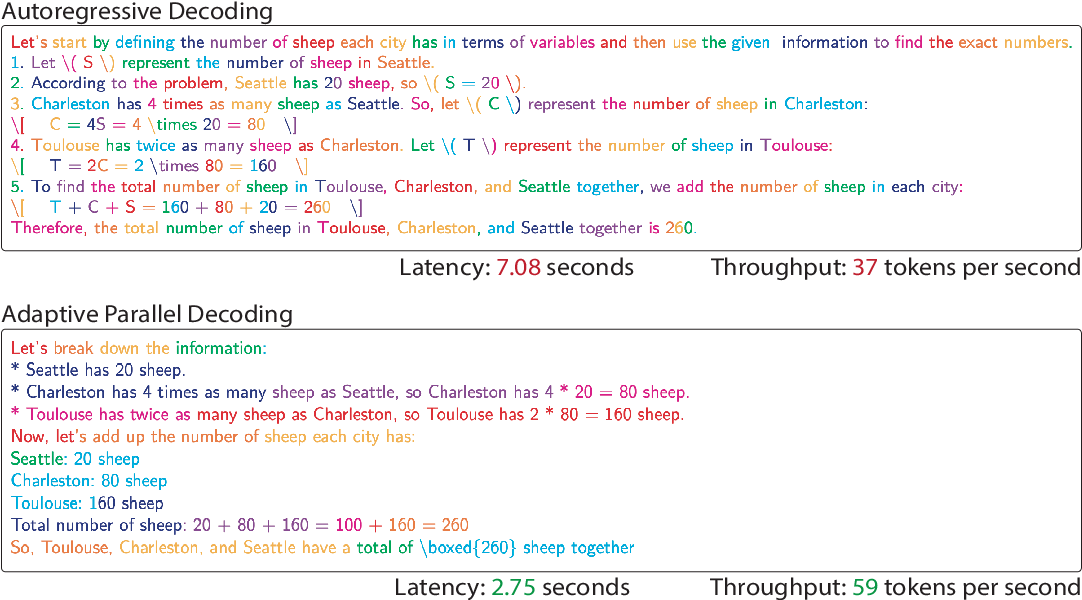
Figure 1 from Accelerating Diffusion LLMs via Adaptive Parallel ...
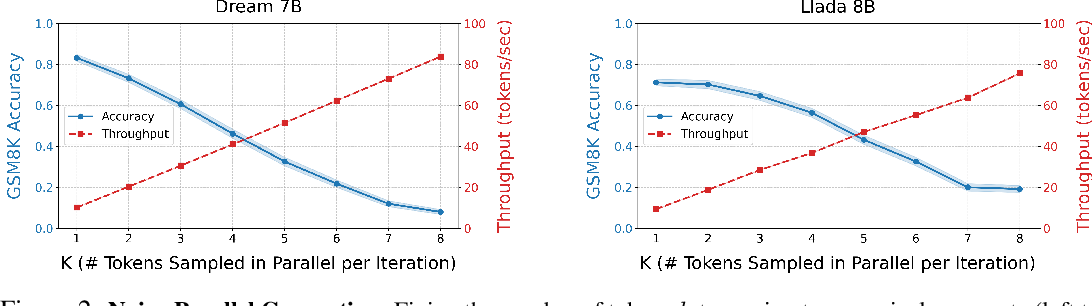
Figure 2 from Accelerating Diffusion LLMs via Adaptive Parallel ...
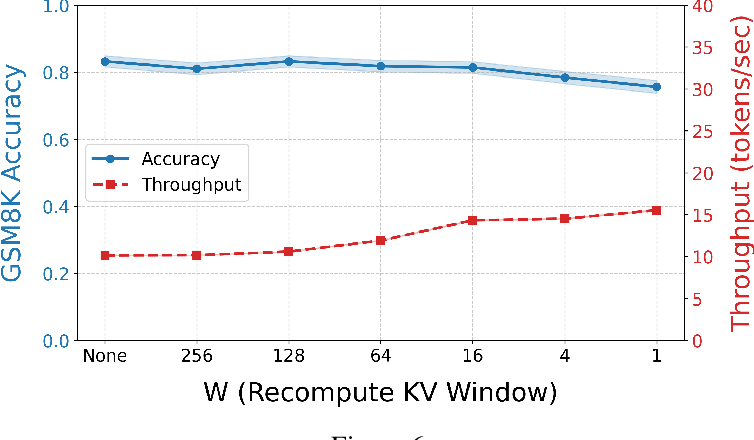
Figure 6 from Accelerating Diffusion LLMs via Adaptive Parallel ...
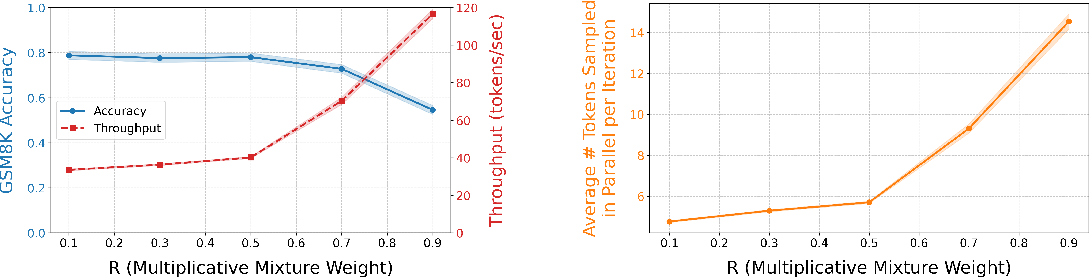
Figure 3 from Accelerating Diffusion LLMs via Adaptive Parallel ...

Paper page - Streaming-dLLM: Accelerating Diffusion LLMs via Suffix ...
Advertisement Space (300x250)
PSD paper — Parallel speculative decoding for diffusion LLMs — What ...

Dependency-Aware Parallel Decoding via Attention for Diffusion LLMs
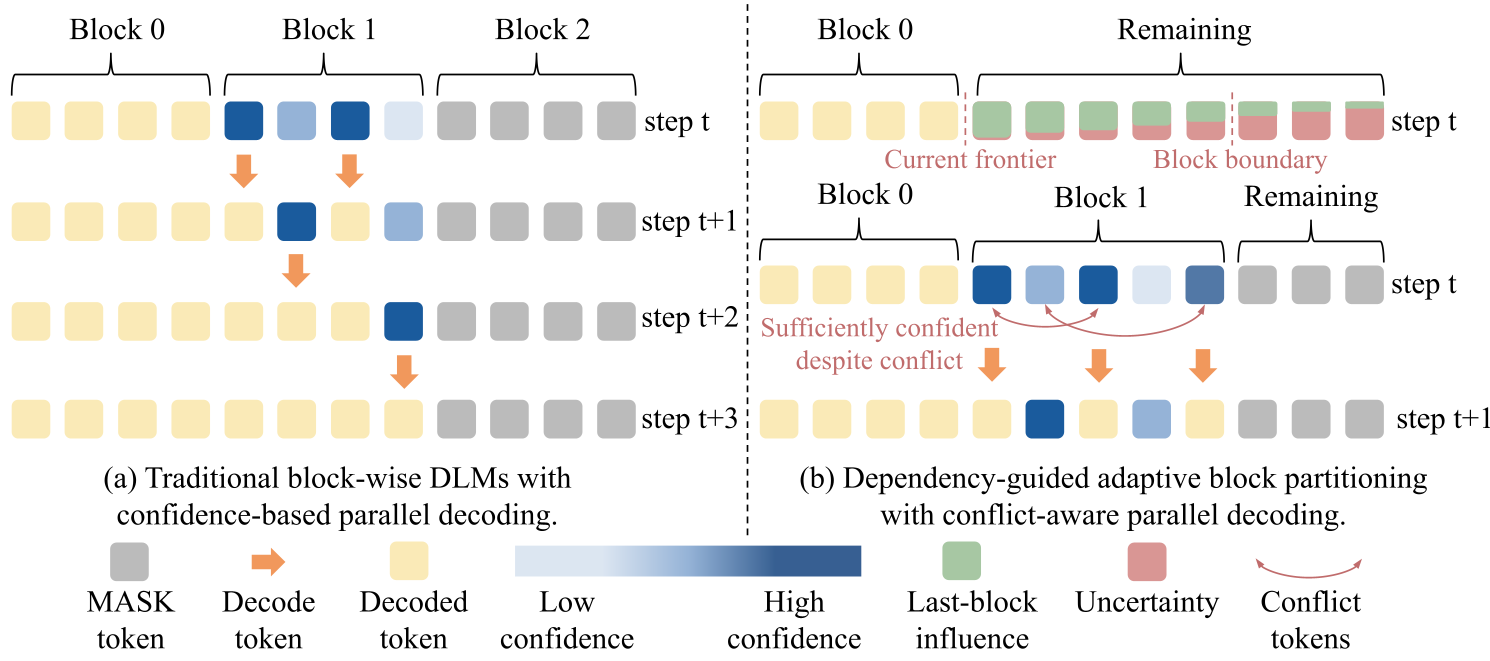
DepCap: Adaptive Block-Wise Parallel Decoding for Efficient Diffusion ...

Paper page - d^2Cache: Accelerating Diffusion-Based LLMs via Dual ...

Paper page - Sparse-dLLM: Accelerating Diffusion LLMs with Dynamic ...

CreditDecoding: Accelerating Parallel Decoding in Diffusion Large ...

Streaming-dLLM: Accelerating Diffusion LLMs via Suffix Pruning and ...

A-FloPS: Accelerating Diffusion Models via Adaptive Flow Path Sampler ...

Paper page - Accelerating Diffusion via Hybrid Data-Pipeline ...

Paper page - Locally Coherent Parallel Decoding in Diffusion Language ...
Advertisement Space (336x280)
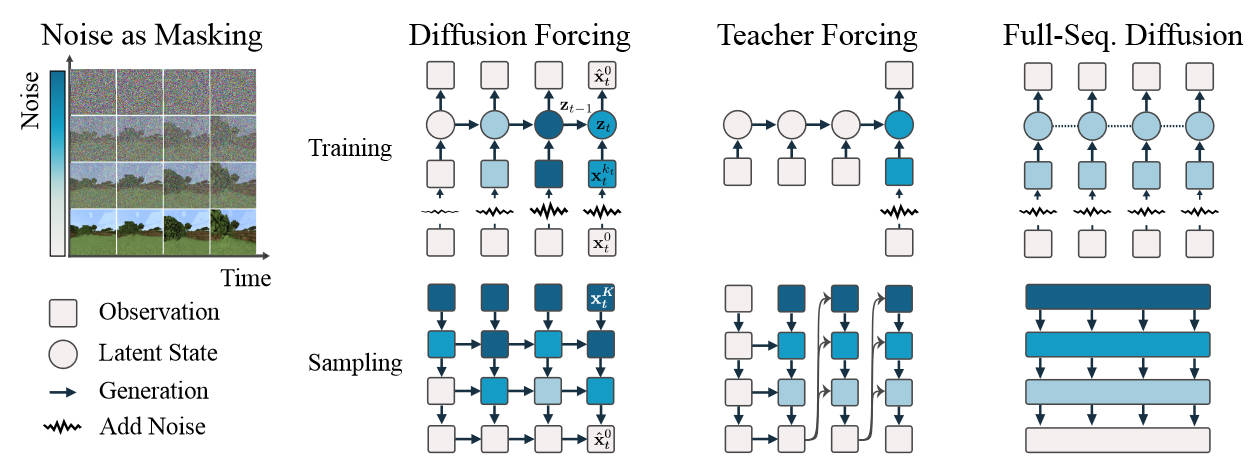
Bridging the Parallel Decoding of LLMs with the Diffusion Process ...
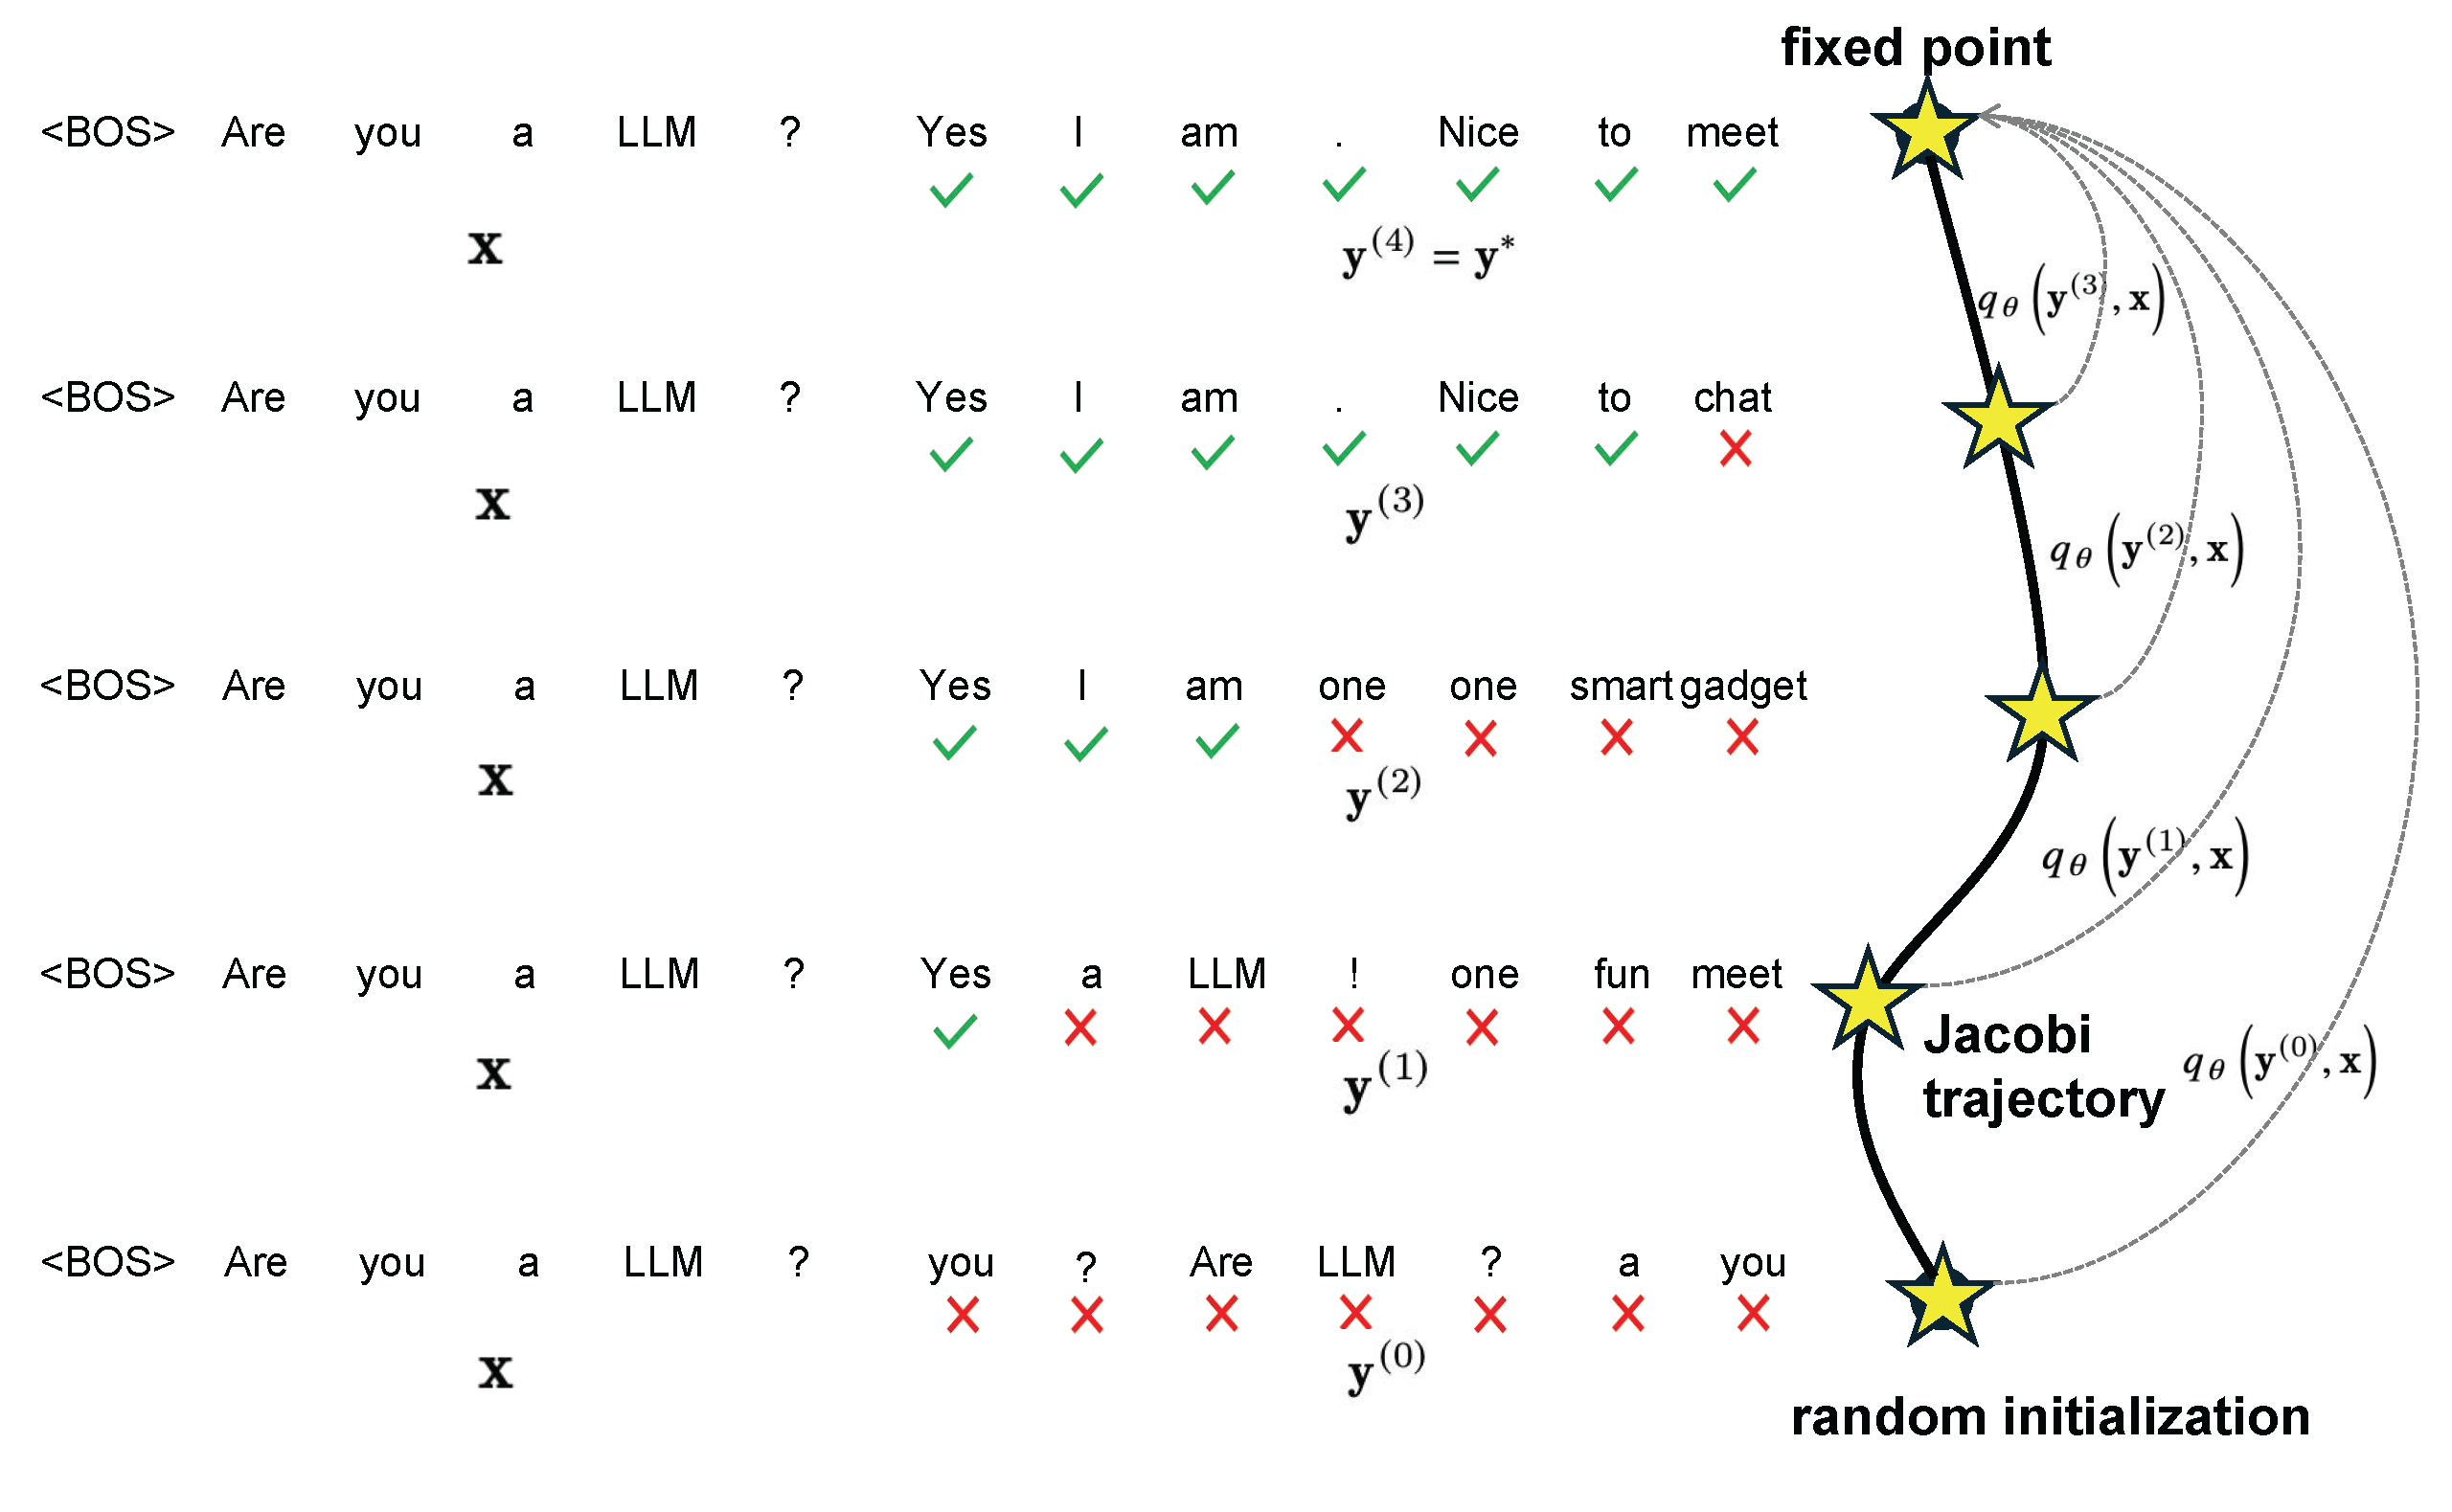
Bridging the Parallel Decoding of LLMs with the Diffusion Process ...

DMax: Aggressive Parallel Decoding for dLLMs | AI Research Paper Details

PSD: Pushing the Pareto Frontier of Diffusion LLMs via Parallel ...
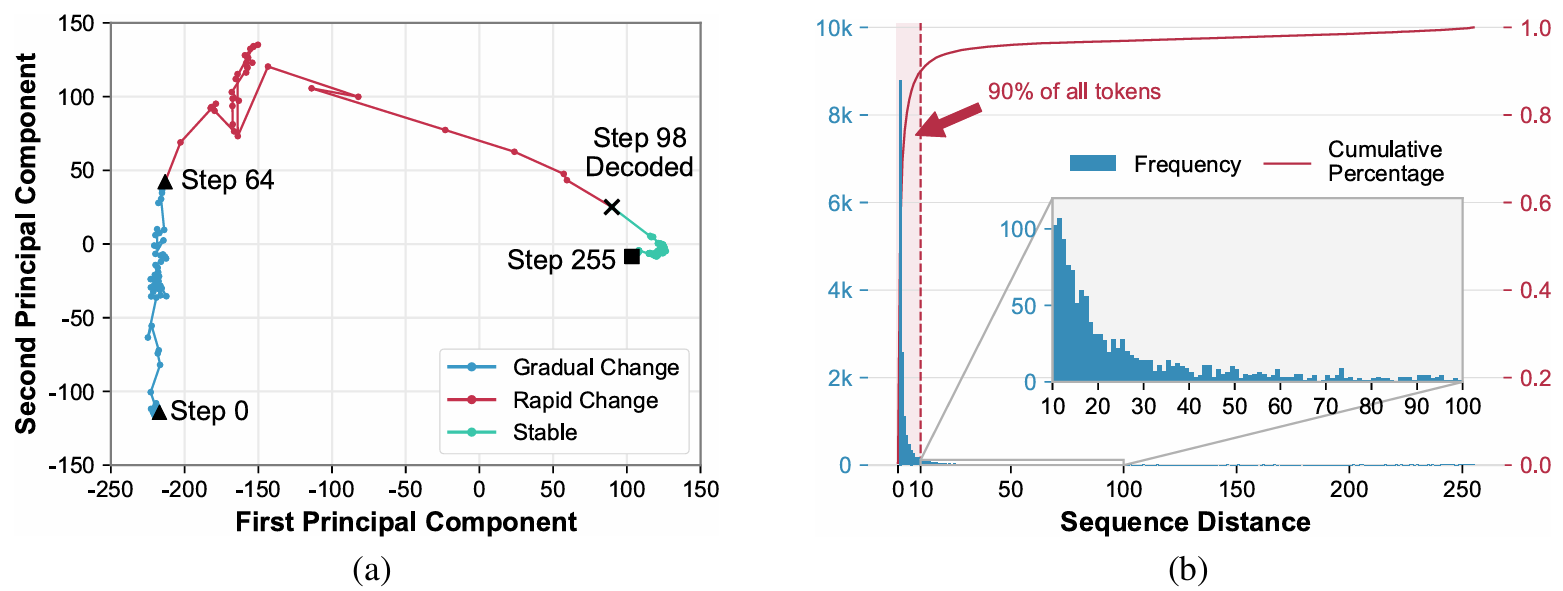
d2Cache: Accelerating Diffusion-Based LLMs via Dual Adaptive Caching ...
S2D2: Fast Decoding for Diffusion LLMs via Training-Free Self ...
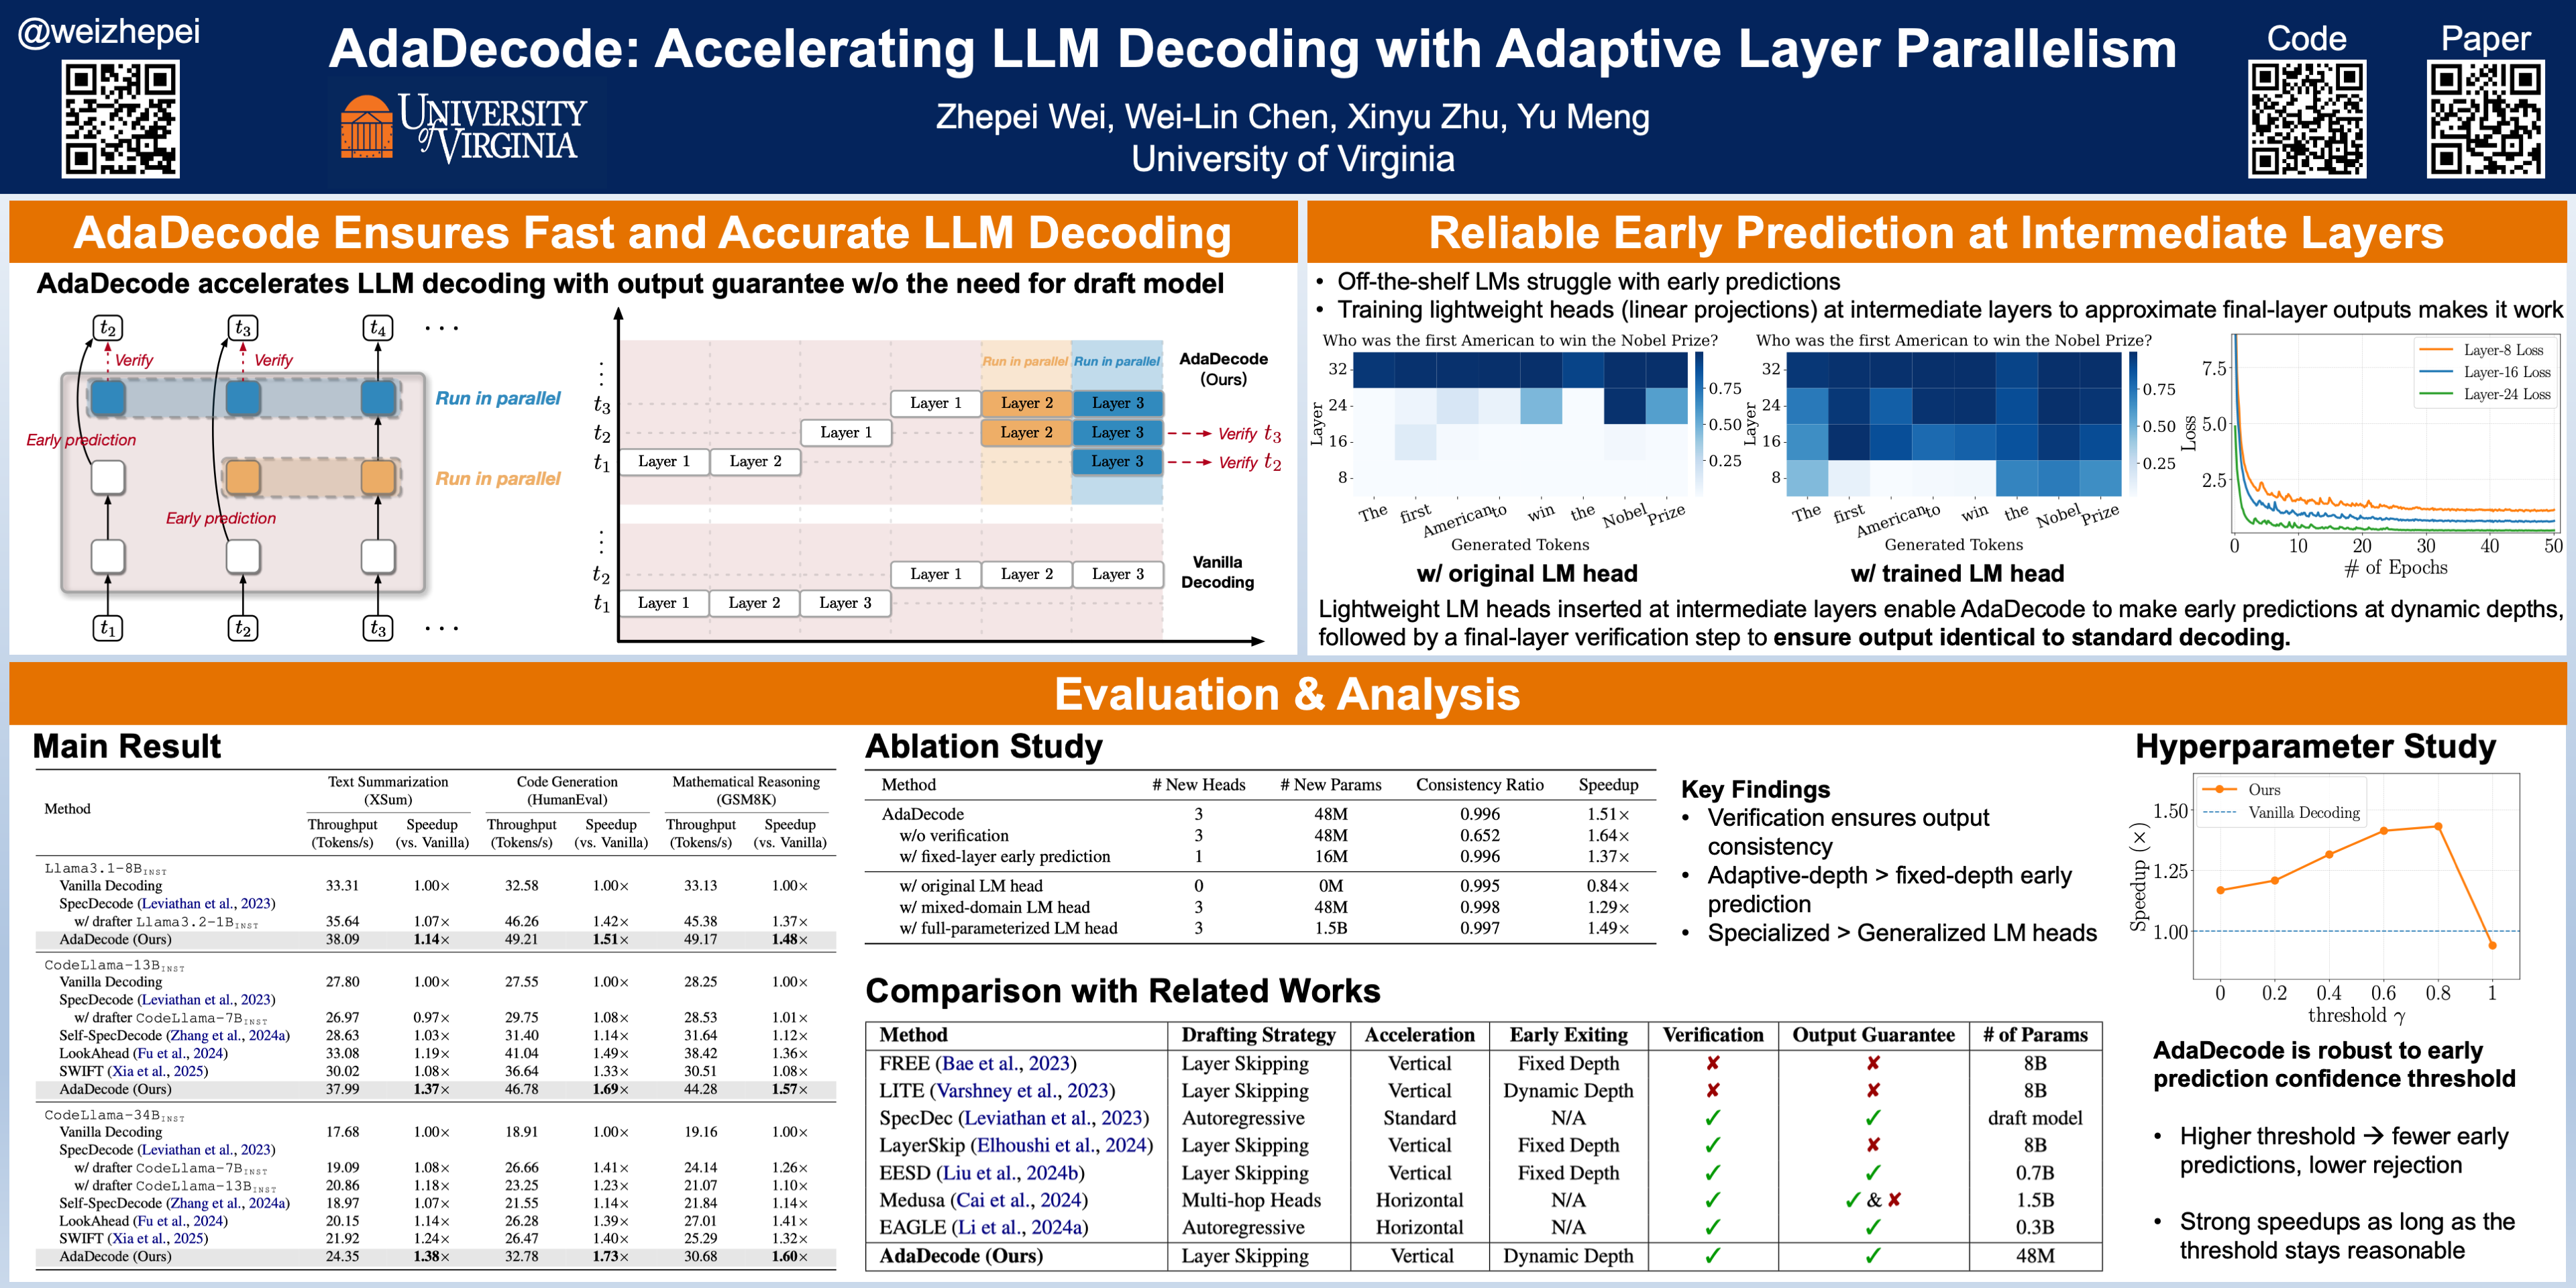
ICML Poster AdaDecode: Accelerating LLM Decoding with Adaptive Layer ...

Paper page - Learning to Parallel: Accelerating Diffusion Large ...

Dynamic-dLLM: Dynamic Cache-Budget and Adaptive Parallel Decoding for ...

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...
Advertisement Space (336x280)

Figure 1 from d2Cache: Accelerating Diffusion-Based LLMs via Dual ...

Learning to Parallel: Accelerating Diffusion Large Language Models via ...

Dynamic-dLLM: Dynamic Cache-Budget and Adaptive Parallel Decoding for ...

Locally Coherent Parallel Decoding in Diffusion Language Models | AI ...

Dynamic-dLLM: Dynamic Cache-Budget and Adaptive Parallel Decoding for ...

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...