
Accelerating Speculative Decoding Using Dynamic Speculation Length Home
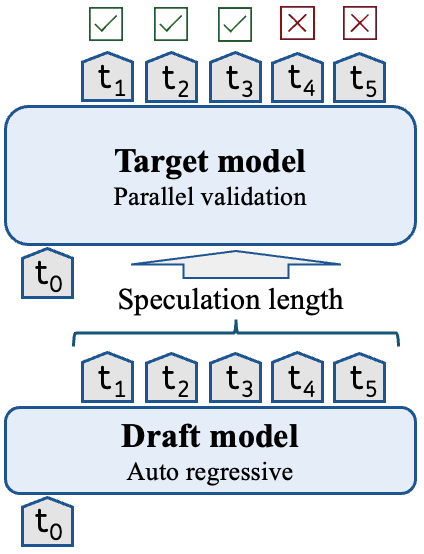
Accelerating Speculative Decoding using Dynamic Speculation Length | Home

Accelerating Speculative Decoding using Dynamic Speculation Length

Accelerating Speculative Decoding using Dynamic Speculation Length

Accelerating Speculative Decoding using Dynamic Speculation Length

Paper page - Accelerating Speculative Decoding using Dynamic ...
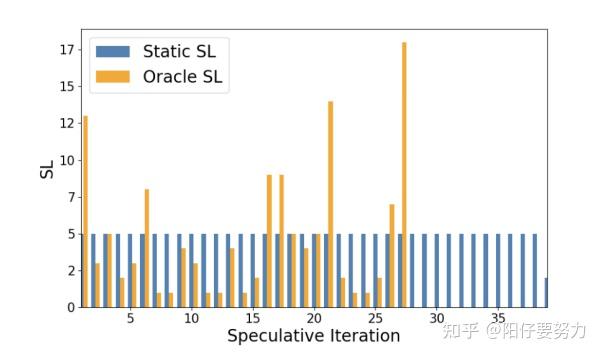
Dynamic Speculation Lookahead Accelerates Speculative Decoding of Large ...
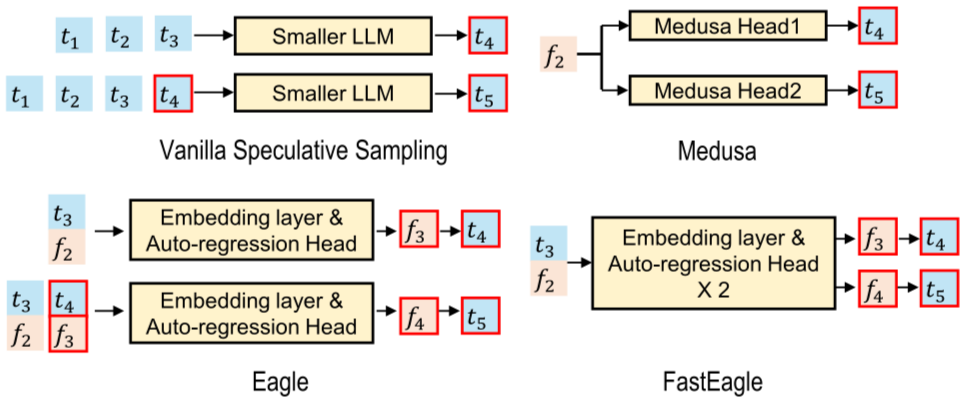
[논문 리뷰] FastEagle: Cascaded Drafting for Accelerating Speculative Decoding

LogitSpec: Accelerating Retrieval-based Speculative Decoding via Next ...

[논문 리뷰] PEARL: Parallel Speculative Decoding with Adaptive Draft Length

(PDF) Accelerating LLM Inference with Staged Speculative Decoding
Advertisement Space (300x250)

(PDF) LogitSpec: Accelerating Retrieval-based Speculative Decoding via ...

Parallel Speculative Decoding with Adaptive Draft Length
SpecKV: Adaptive Speculative Decoding with Dynamic Gamma — Effloow
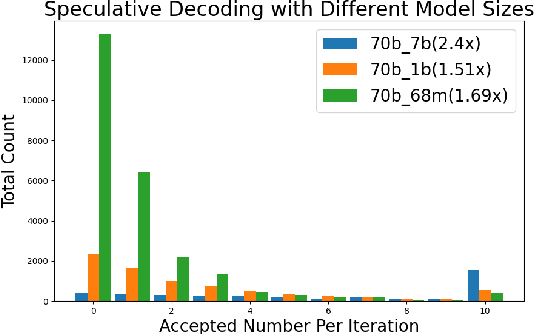
Figure 1 from Hierarchical Speculative Decoding with Dynamic Window ...
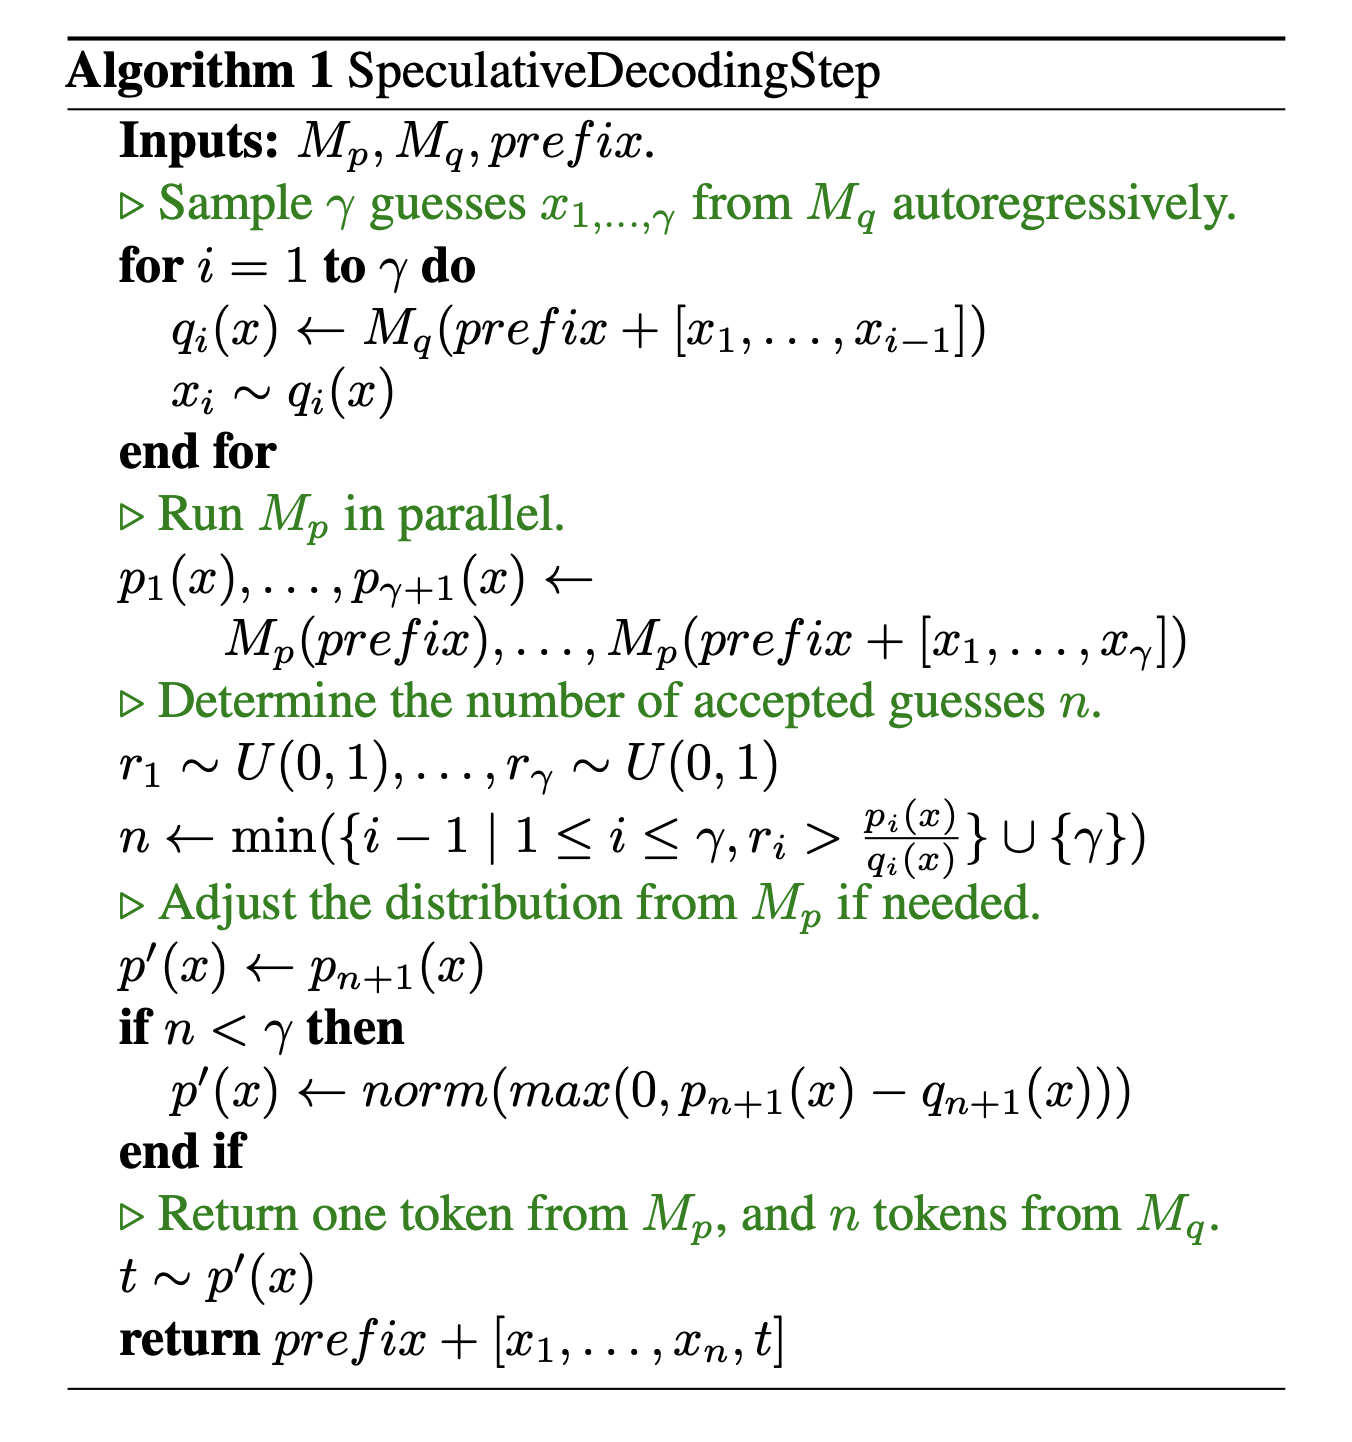
Accelerating large model inference with speculative decoding - 6.s898 ...

Accelerating Inference with Staged Speculative Decoding — Ben Spector ...

[논문 리뷰] SDSAT: Accelerating LLM Inference through Speculative Decoding ...
Paper page - Accelerating LLM Inference with Staged Speculative Decoding

Dynamic Depth Decoding: Faster Speculative Decoding for LLMs | AI ...

Paper page - Accelerating Speculative Decoding with Block Diffusion ...
Advertisement Space (336x280)
LogitSpec: Accelerating Retrieval-based Speculative Decoding via Next ...

[논문 리뷰] DySpec: Faster Speculative Decoding with Dynamic Token Tree ...
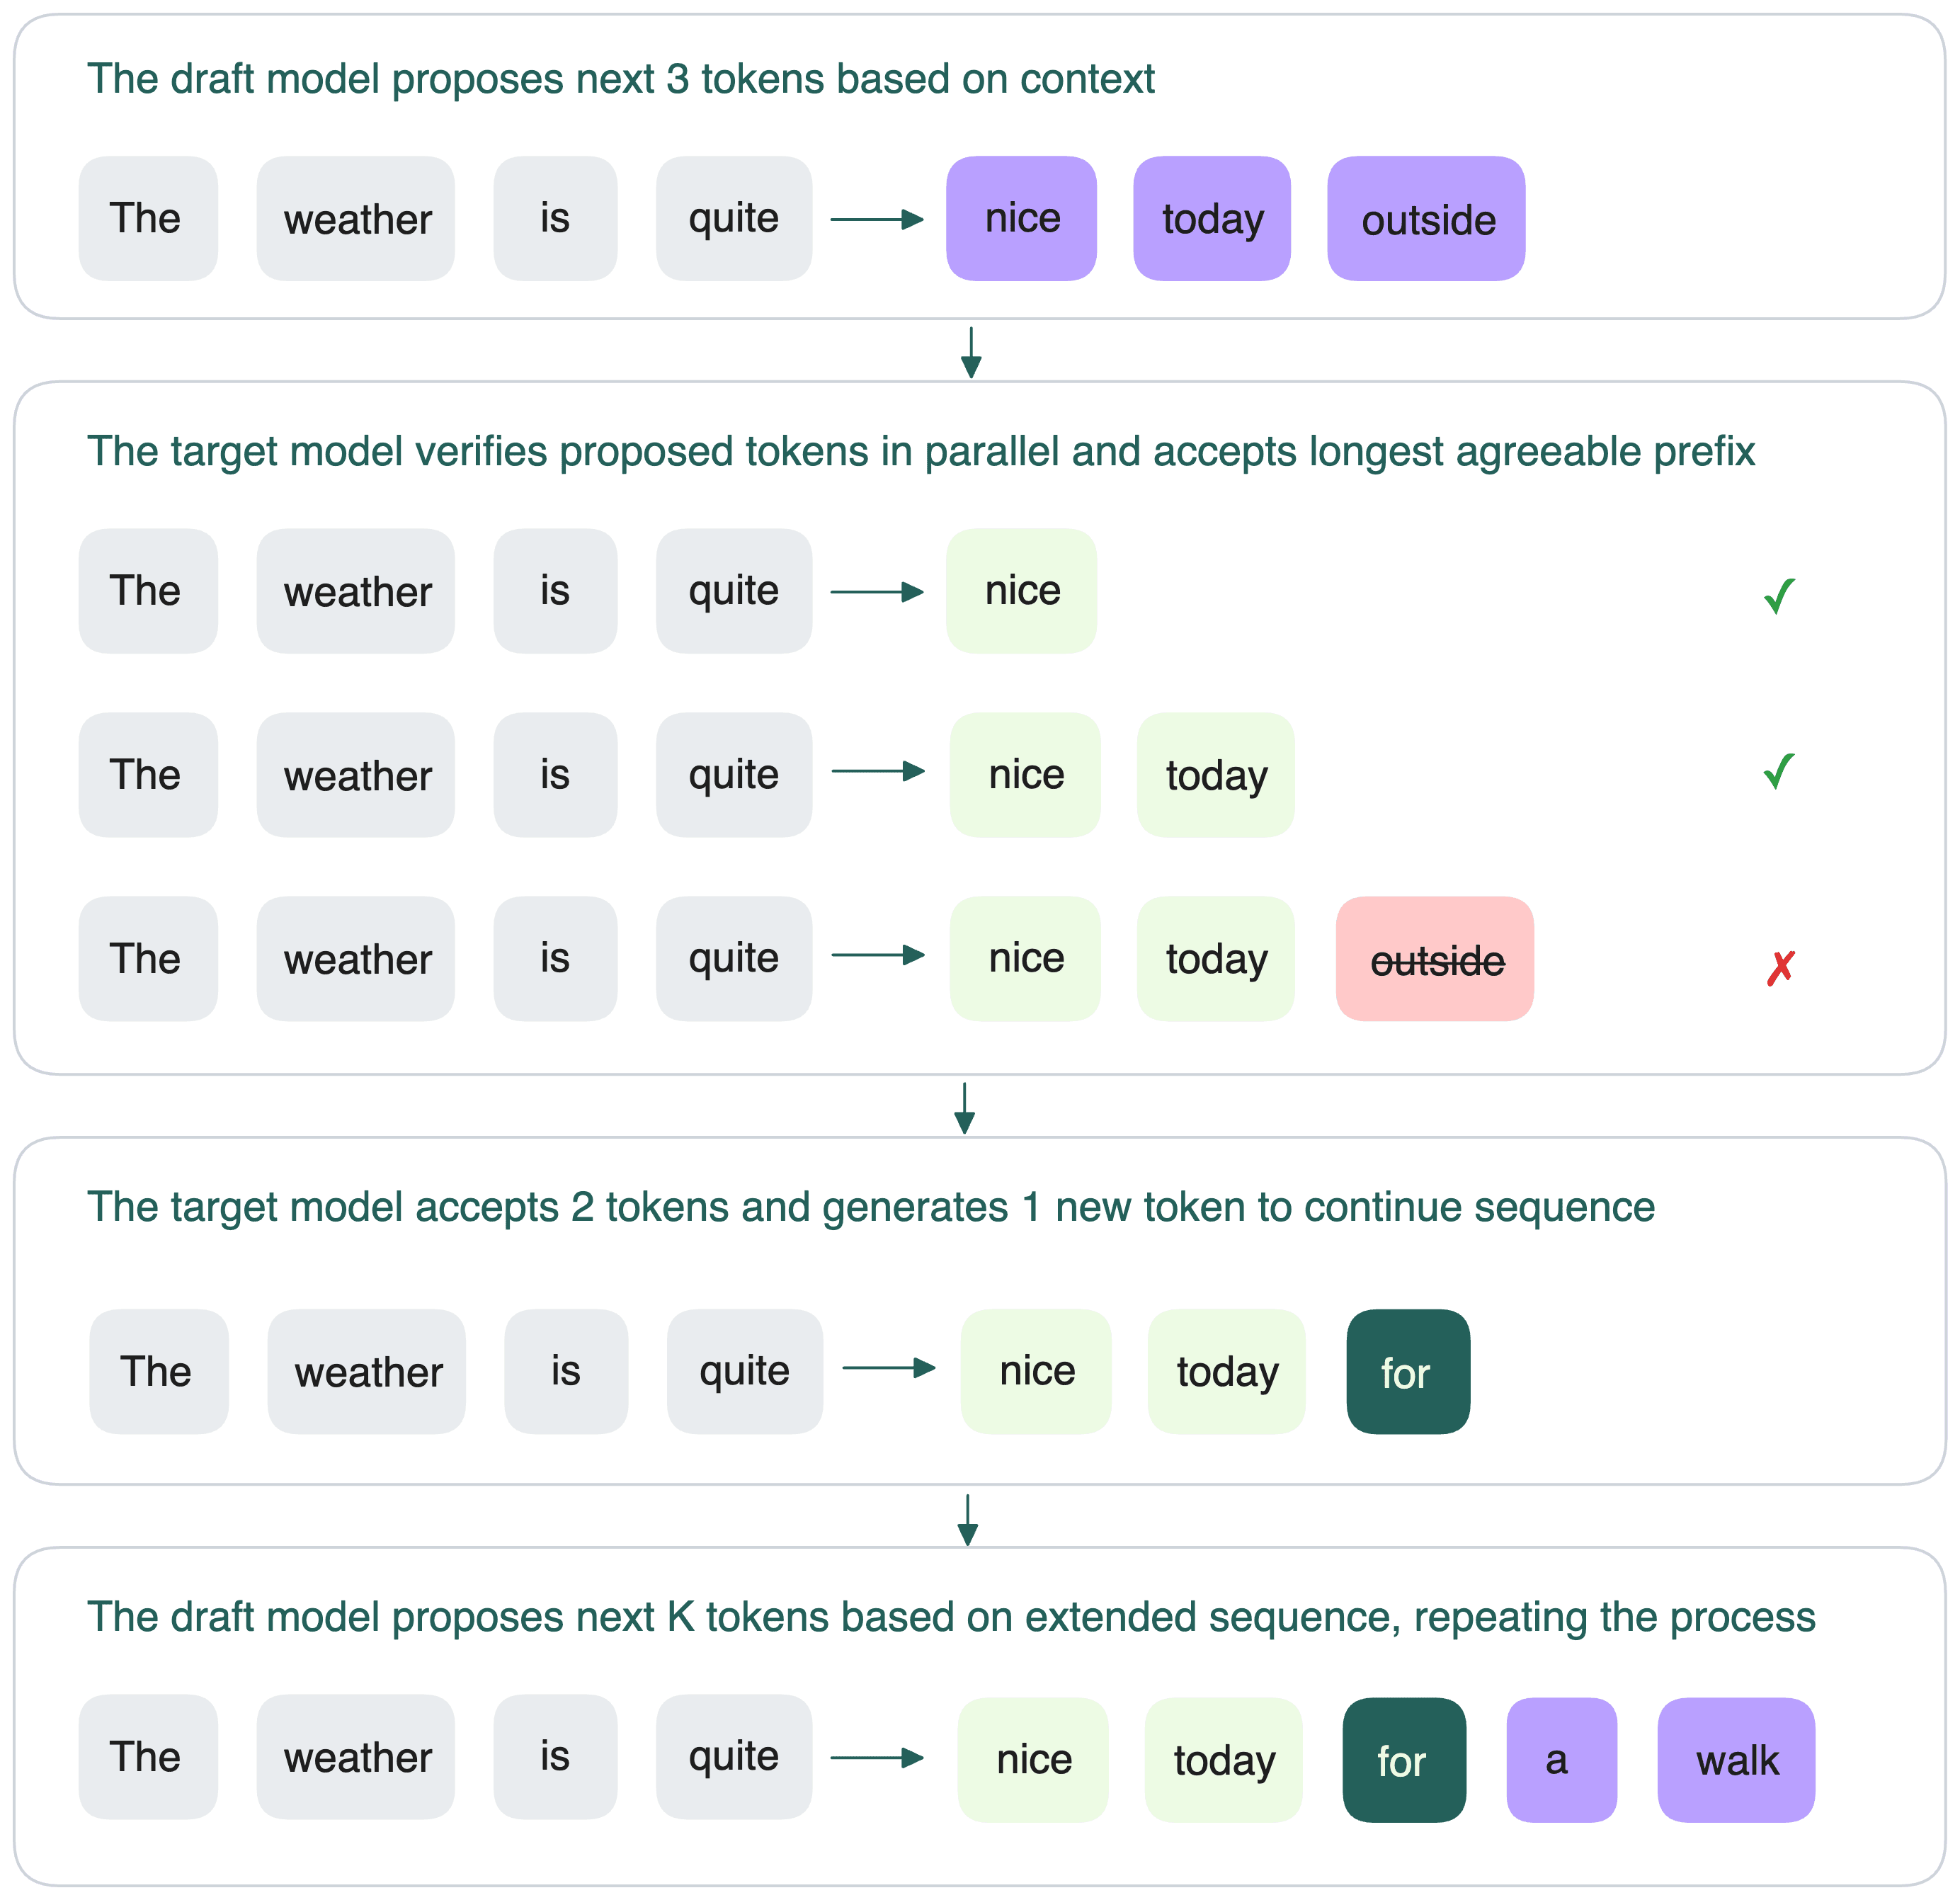
Get 3× Faster LLM Inference with Speculative Decoding Using the Right ...
Accelerating Whisper Inference with Speculative Decoding: Doubling ...
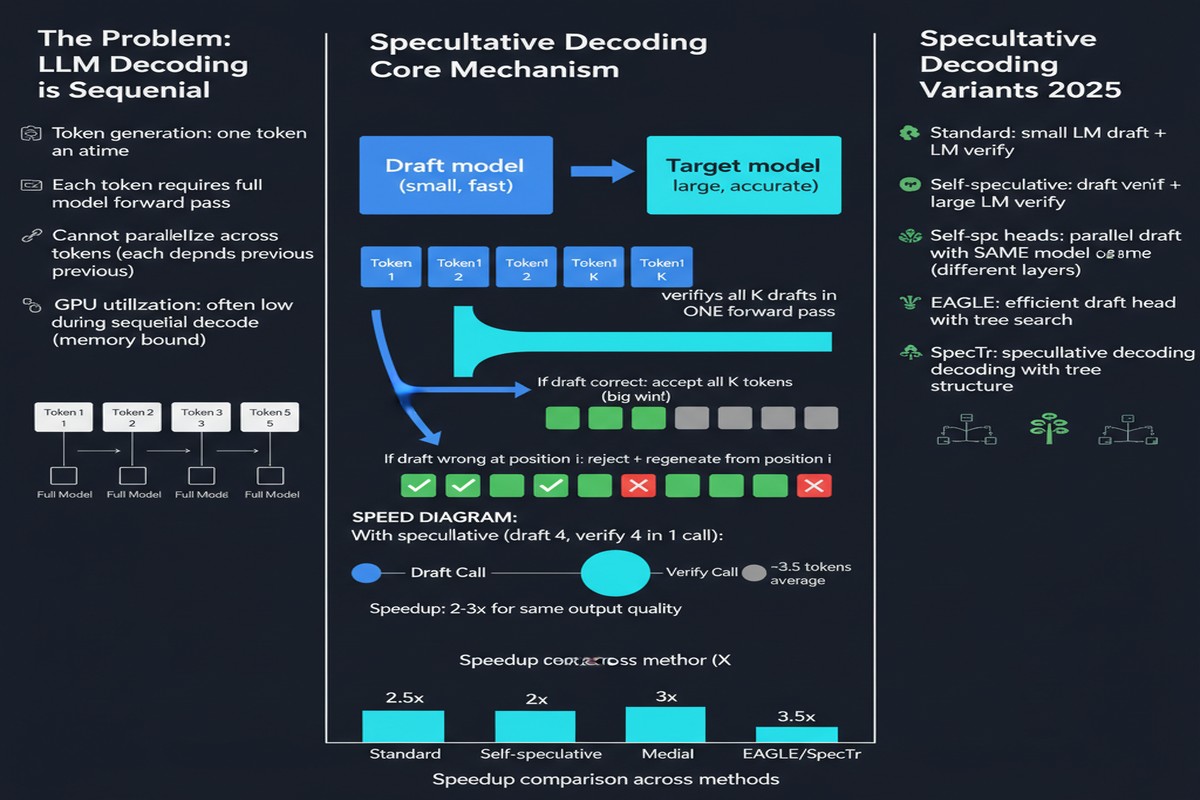
Speculative Decoding in 2025: The Inference Acceleration Technique That ...
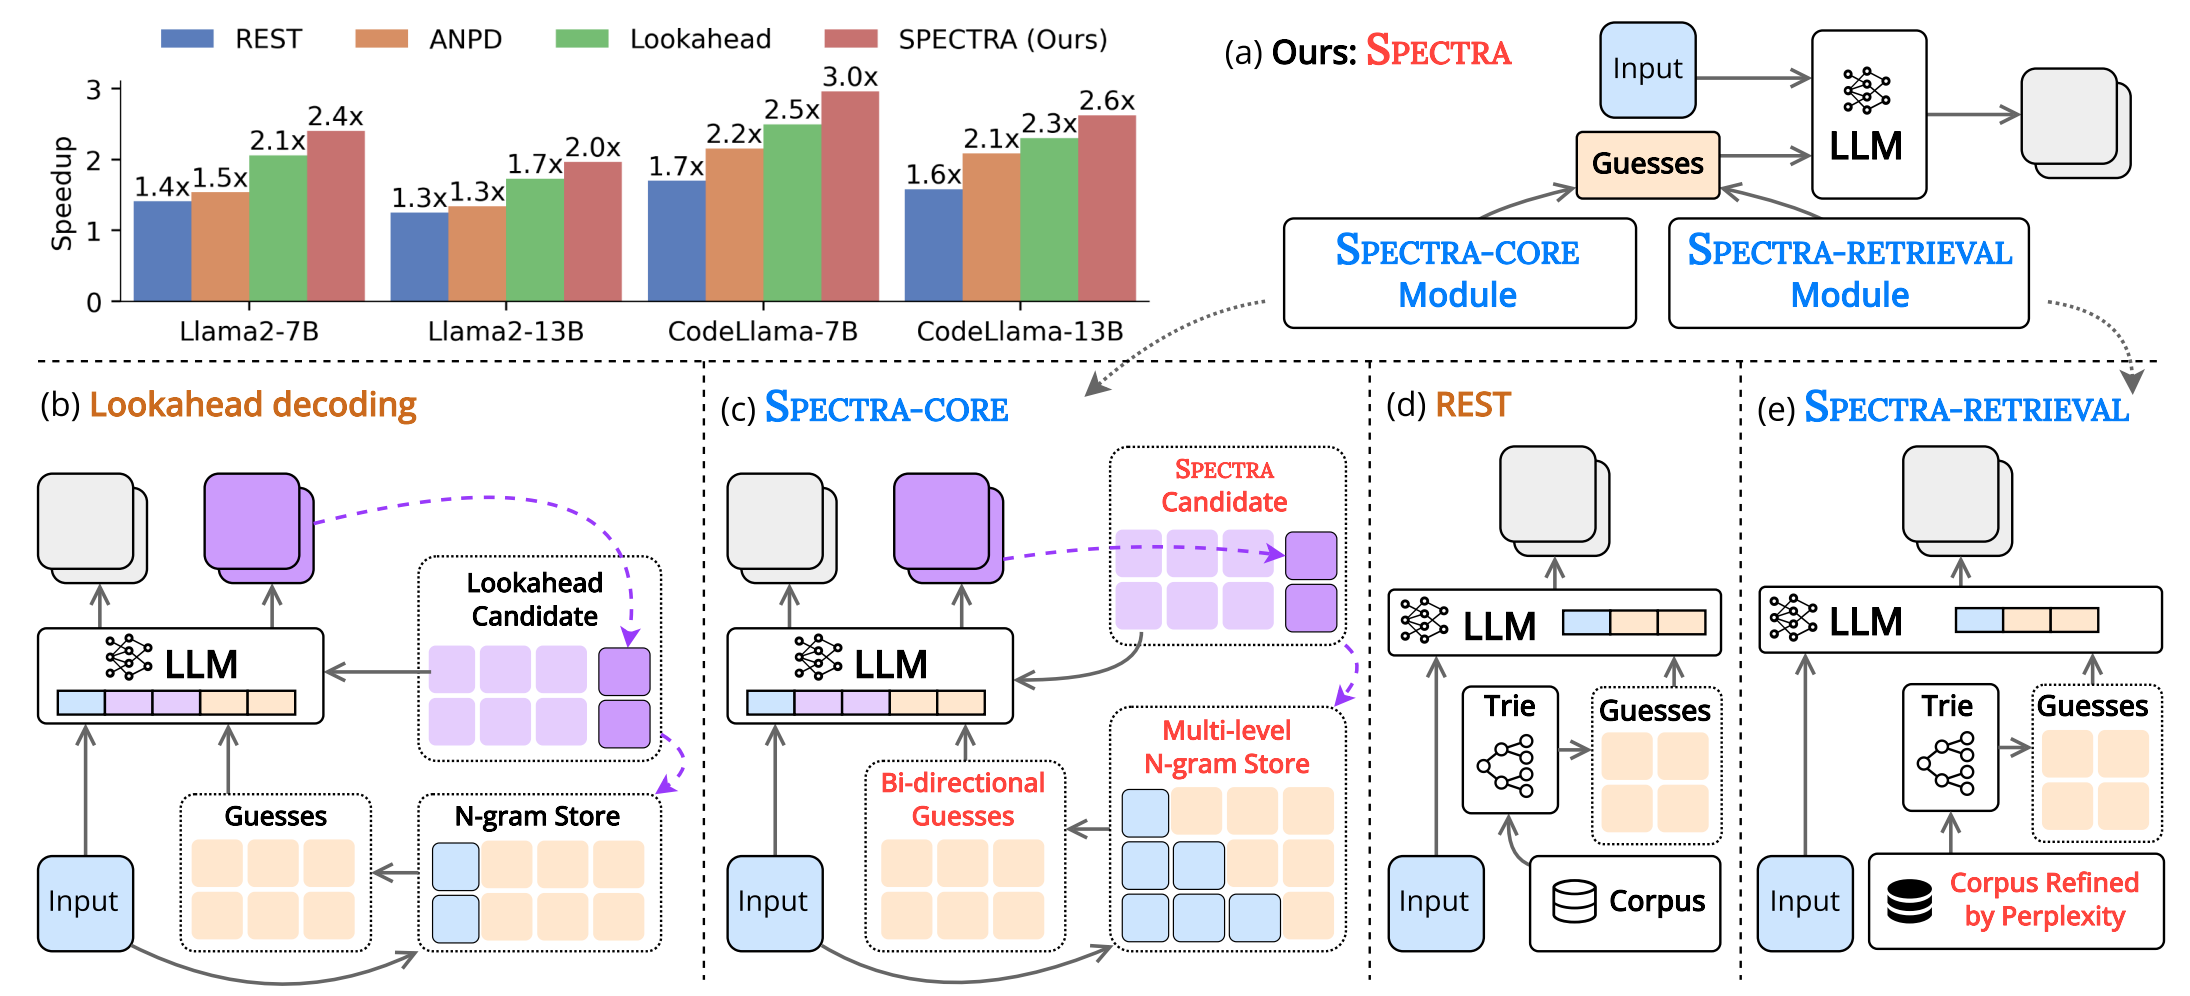
Nguyen Lab's Speculative Decoding Research Group
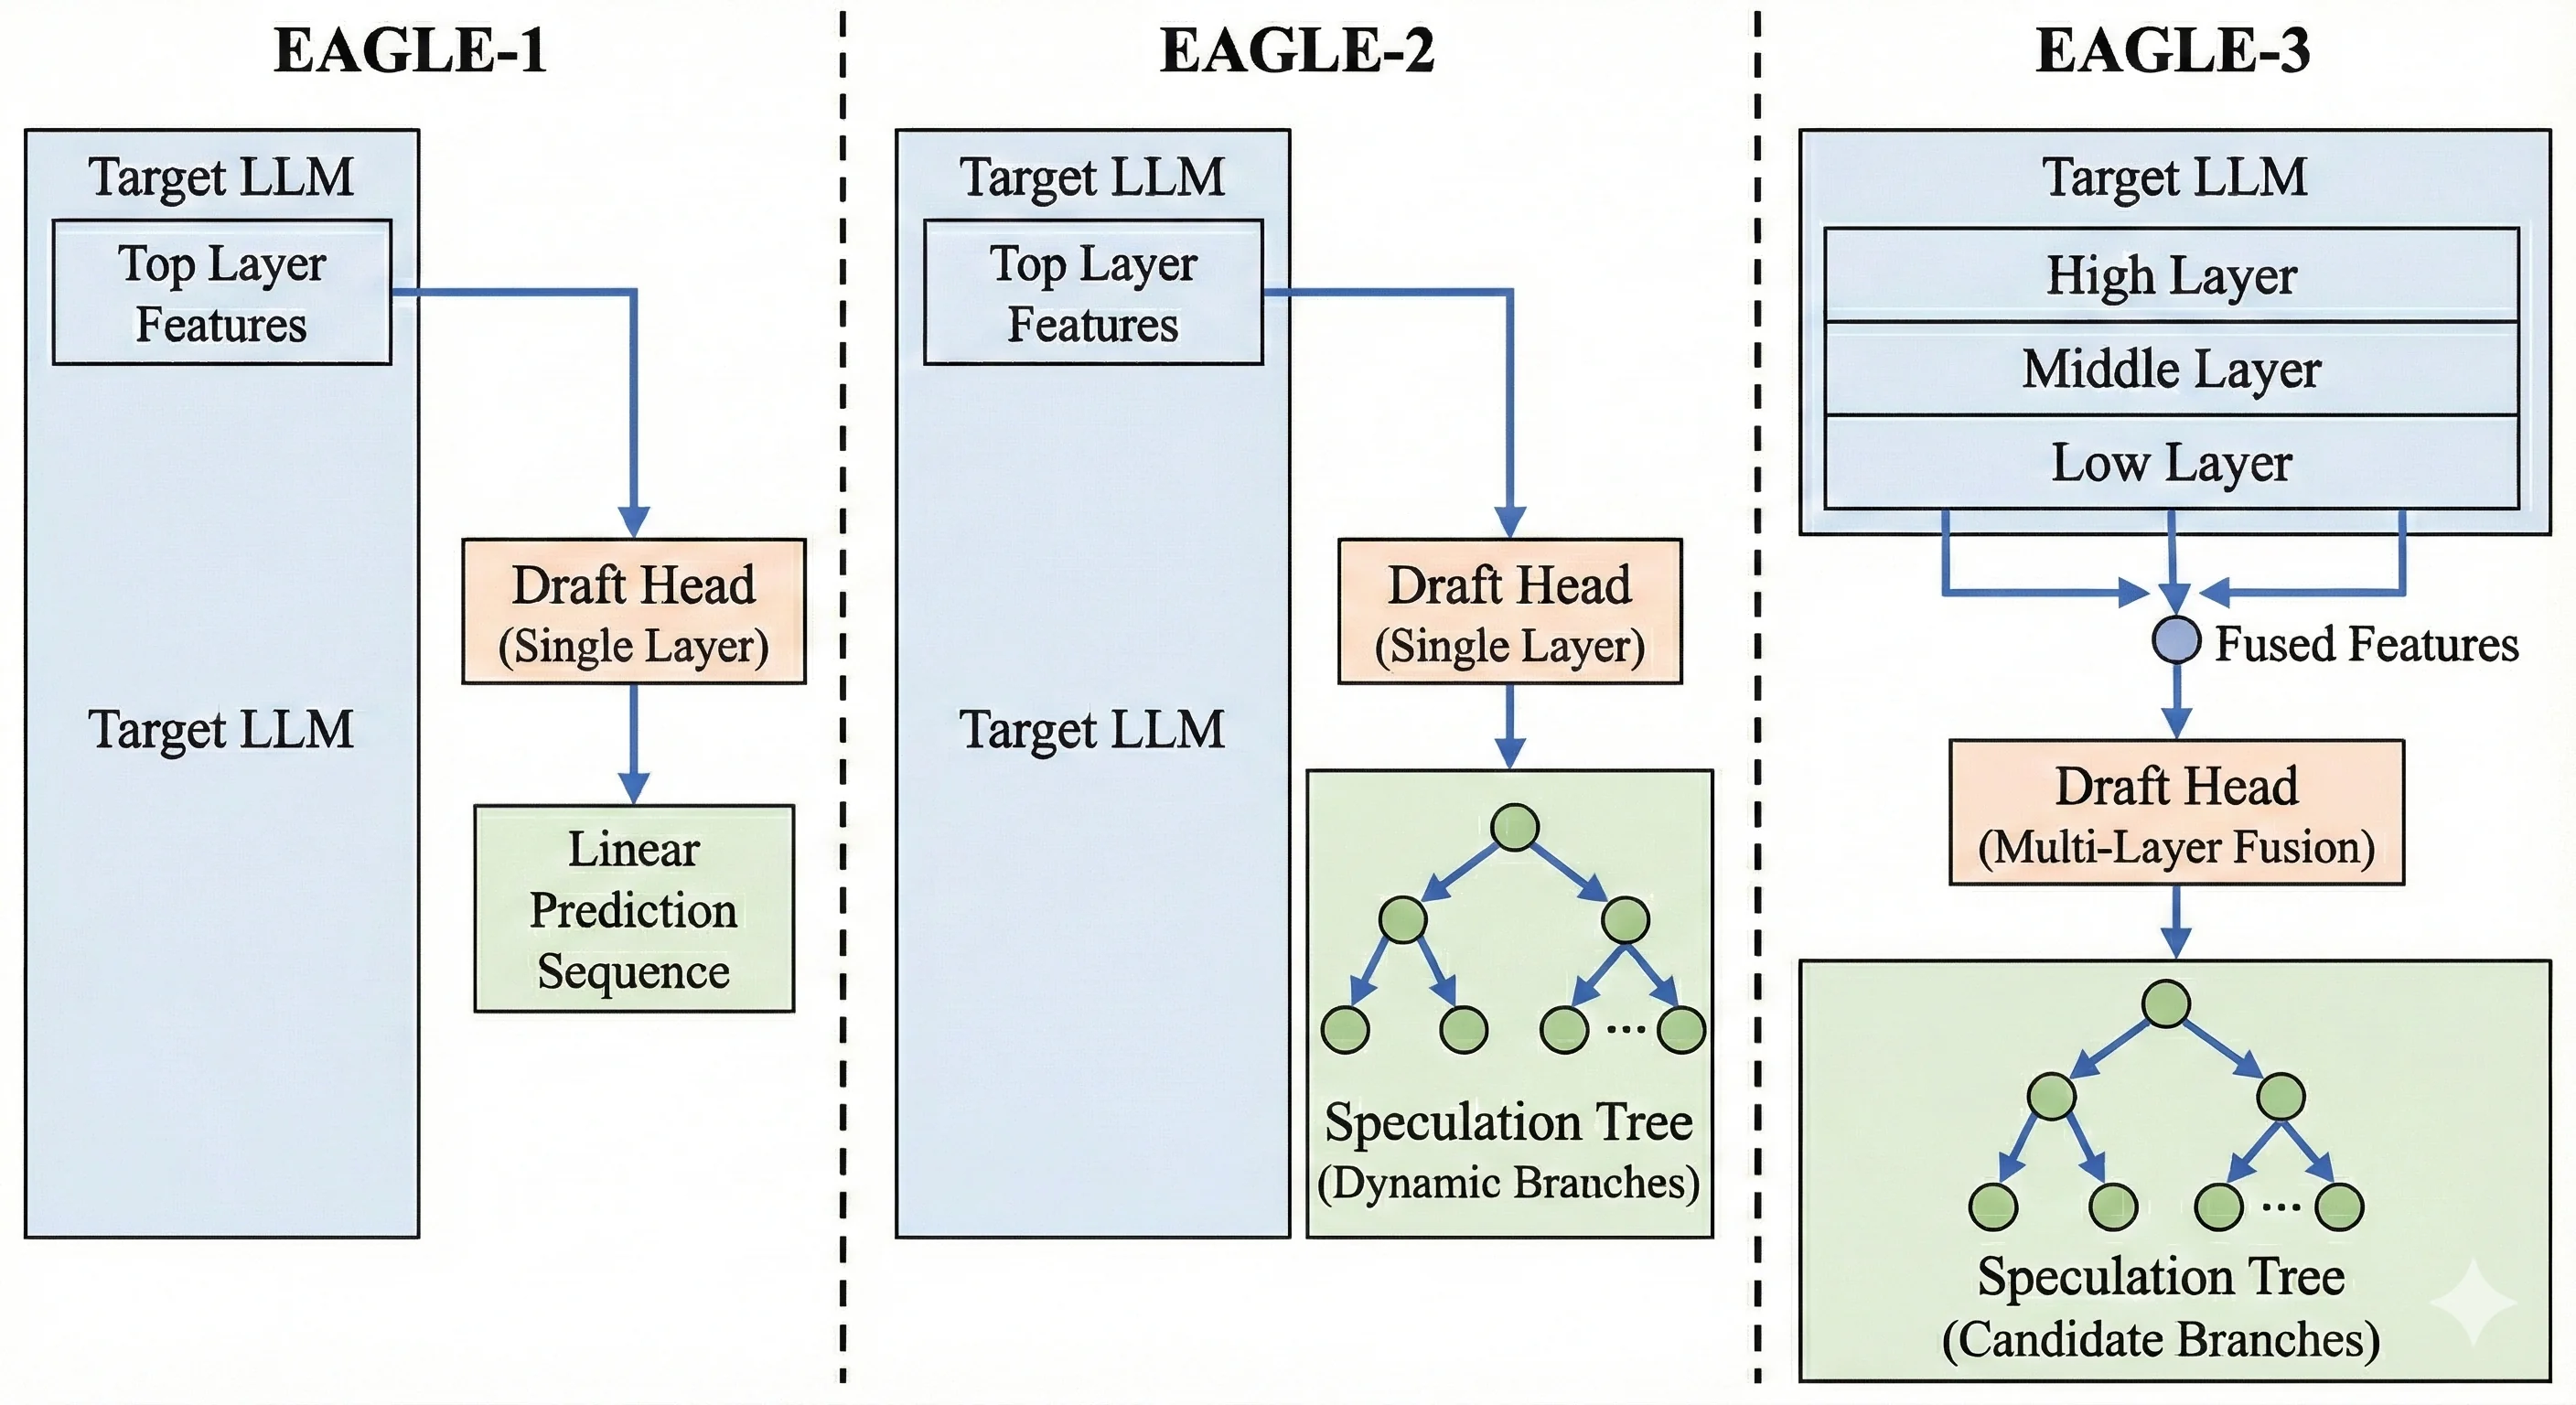
Speculative Decoding in vLLM: Complete Guide to Faster LLM Inference ...
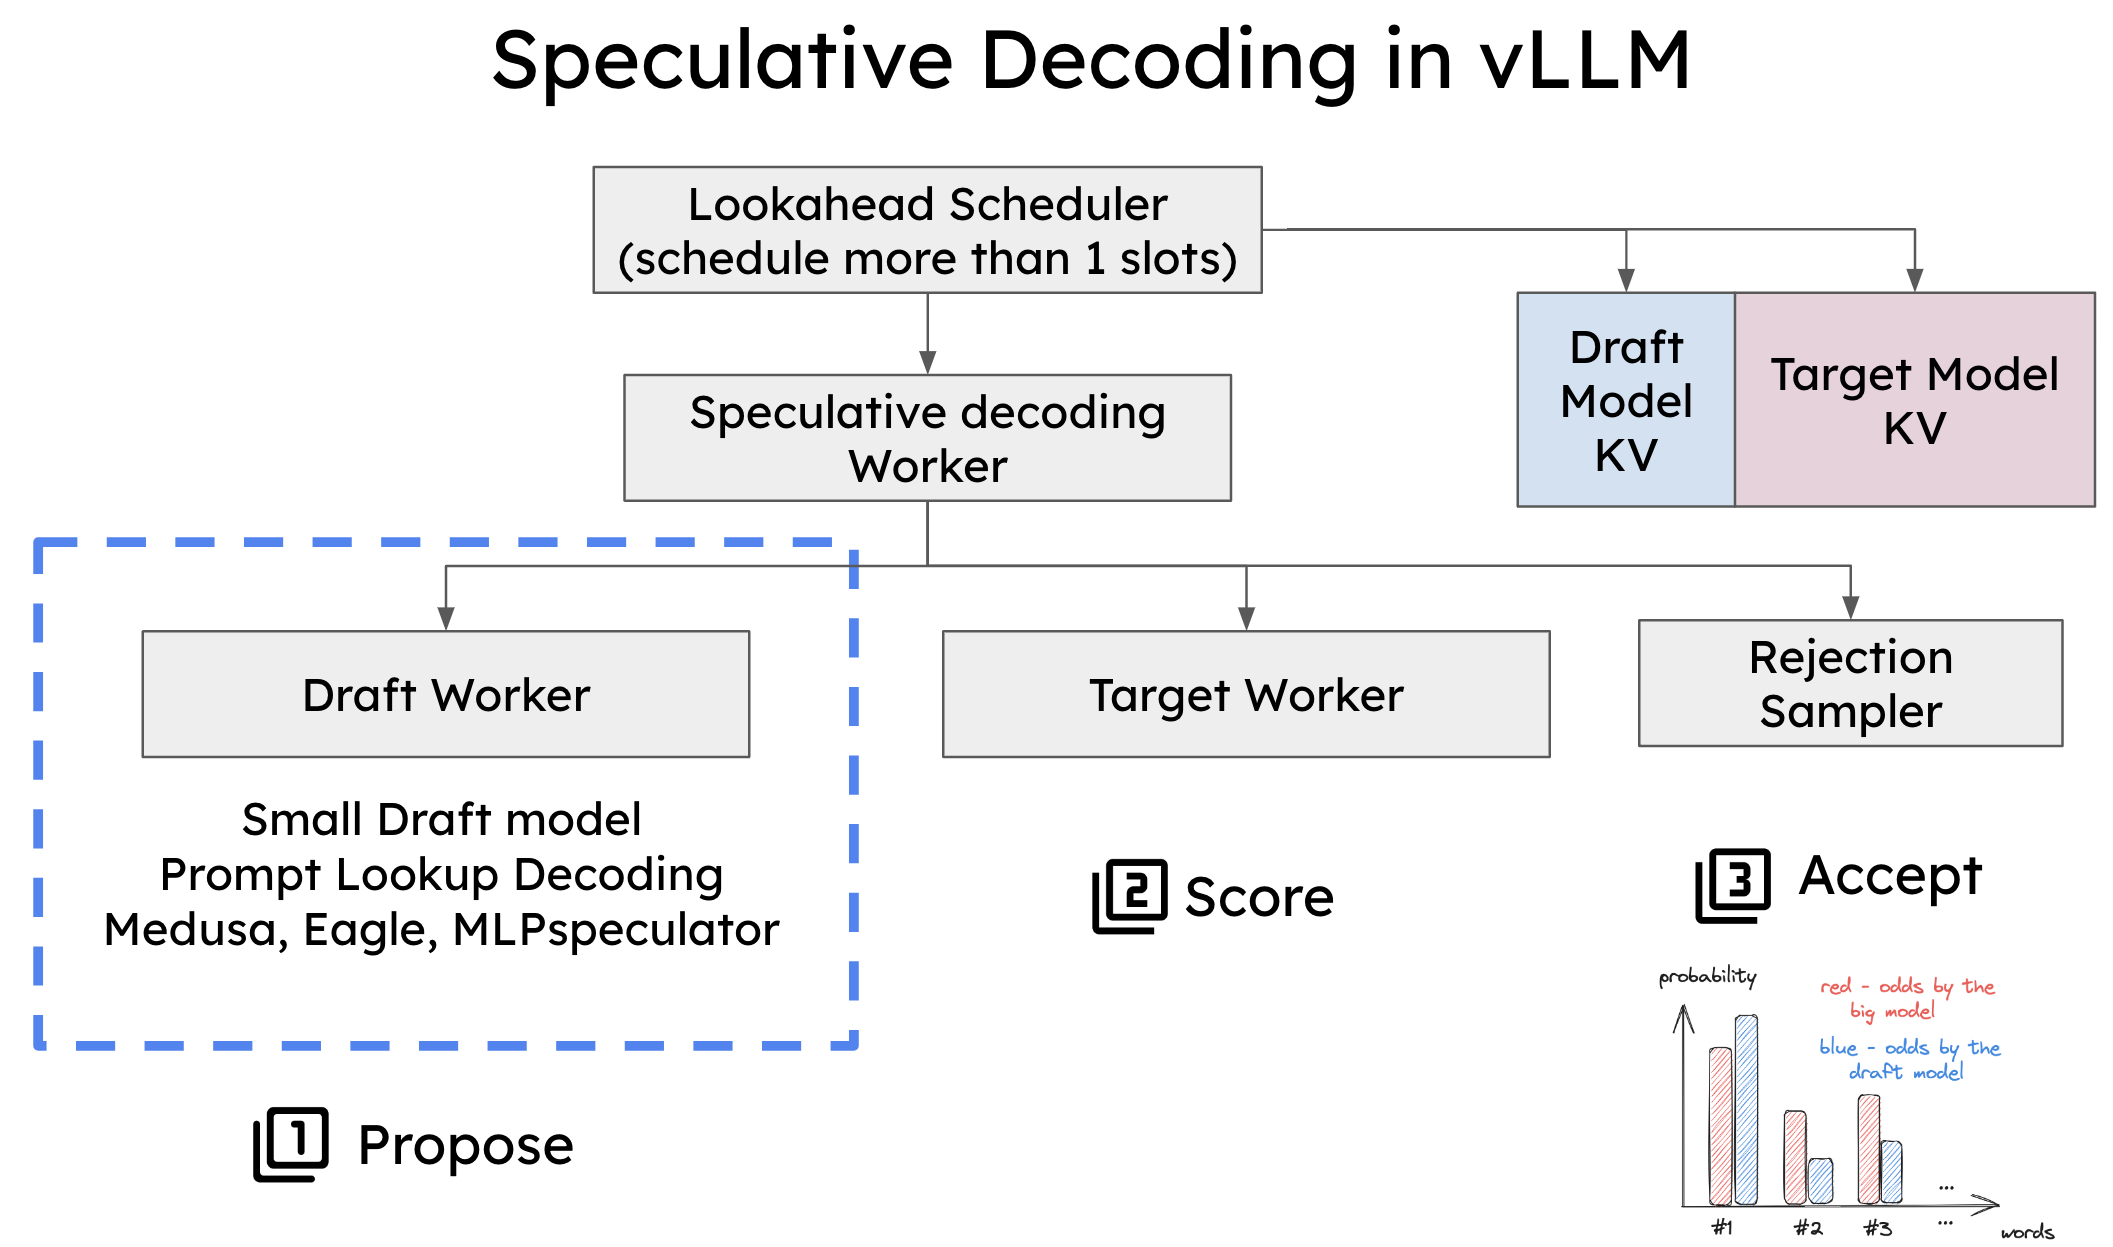
Speculative Decoding in vLLM | OpenLM.ai
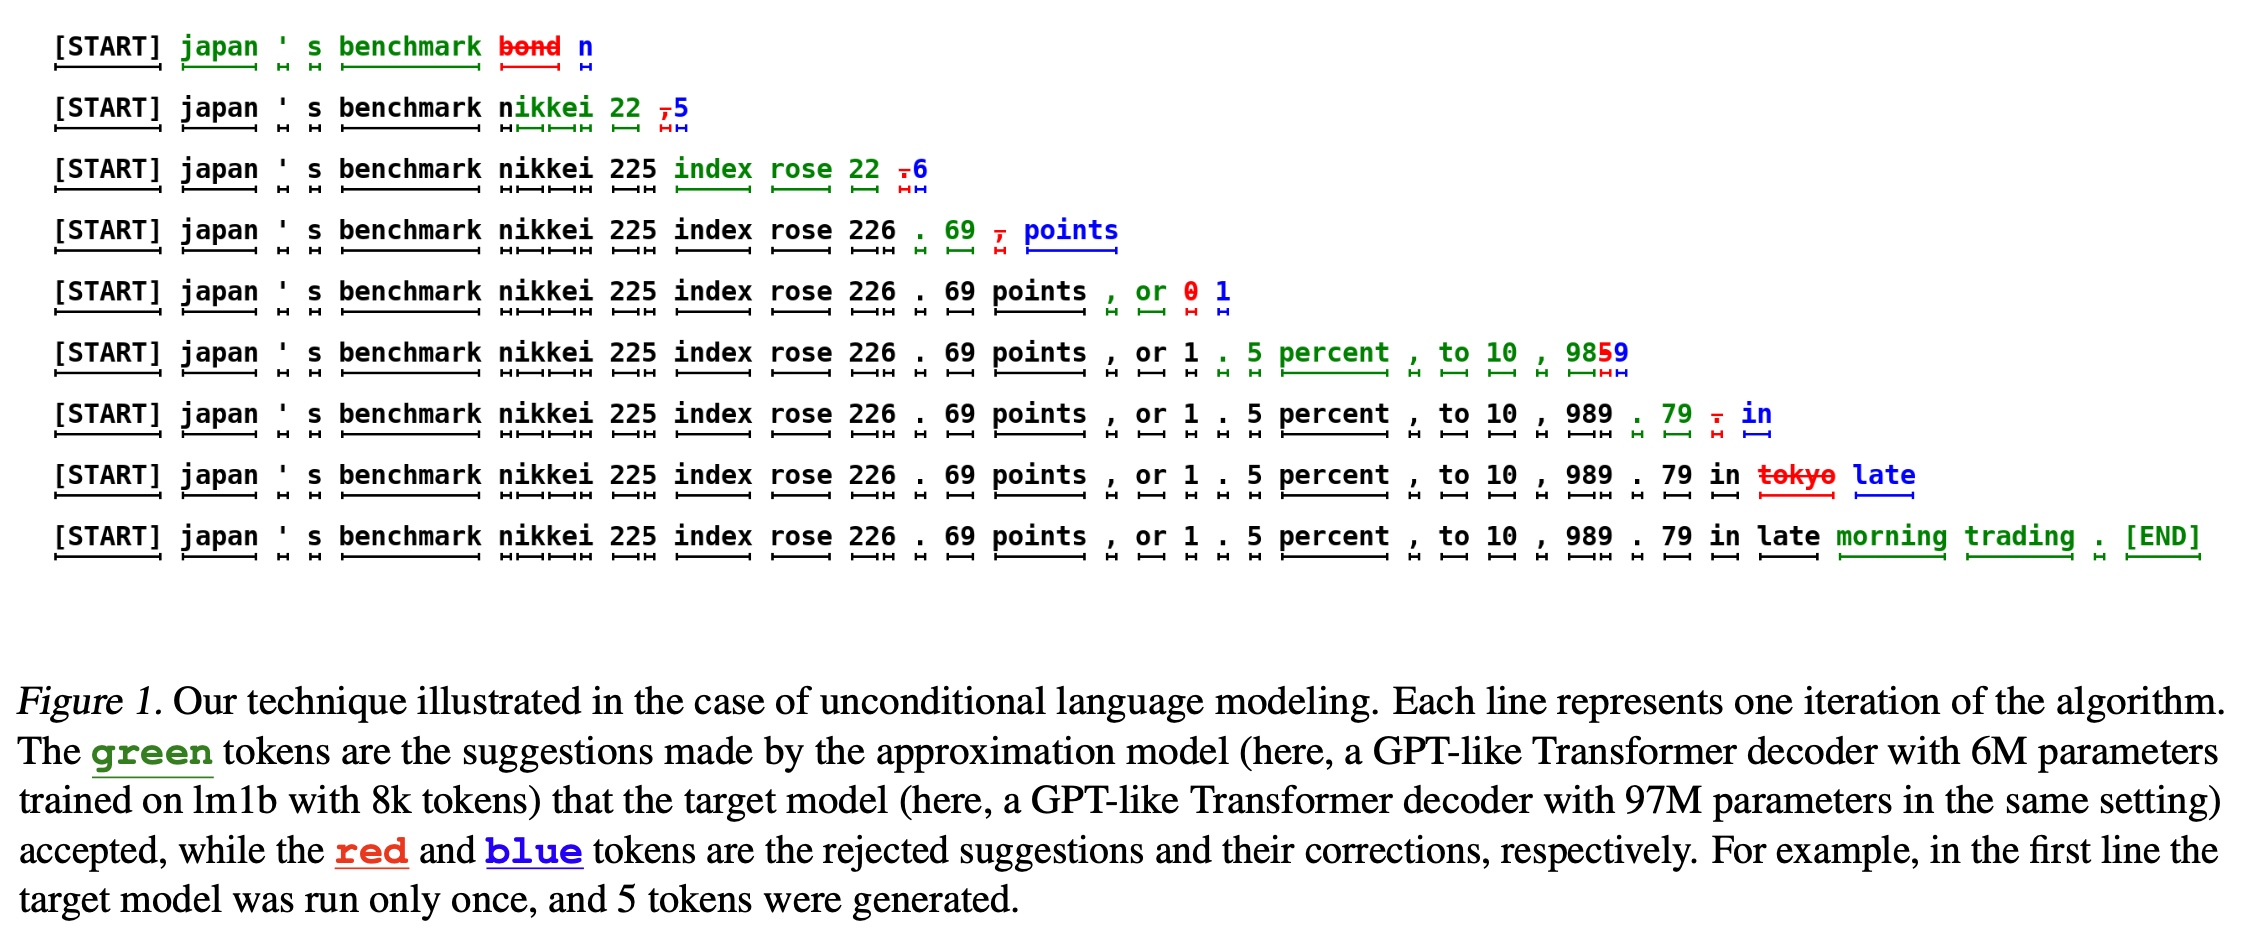
Accelerate LLM Inference with Speculative Decoding | Charles Xu

Speculative Decoding - Making Language Models Generate Faster Without ...
Advertisement Space (336x280)
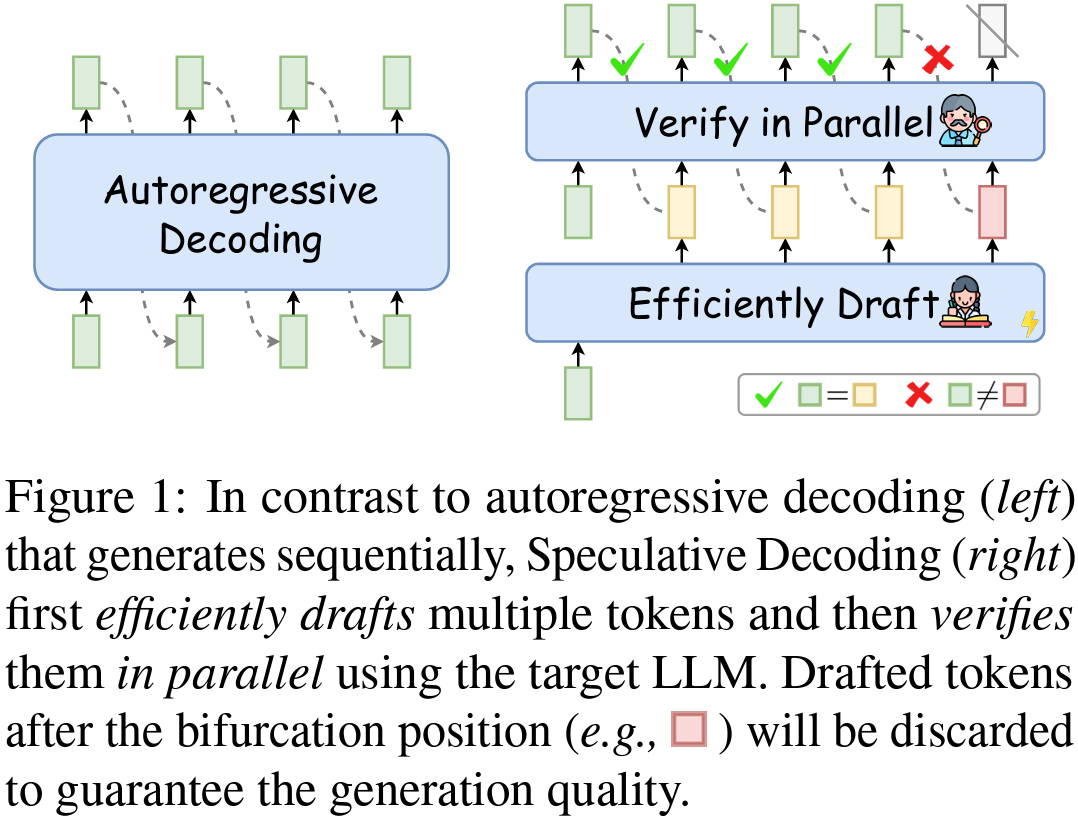
Speculative decoding — papers and benchmarks | Papers with Code
Speculative Decoding Explained: Faster Inference Without Quality Loss
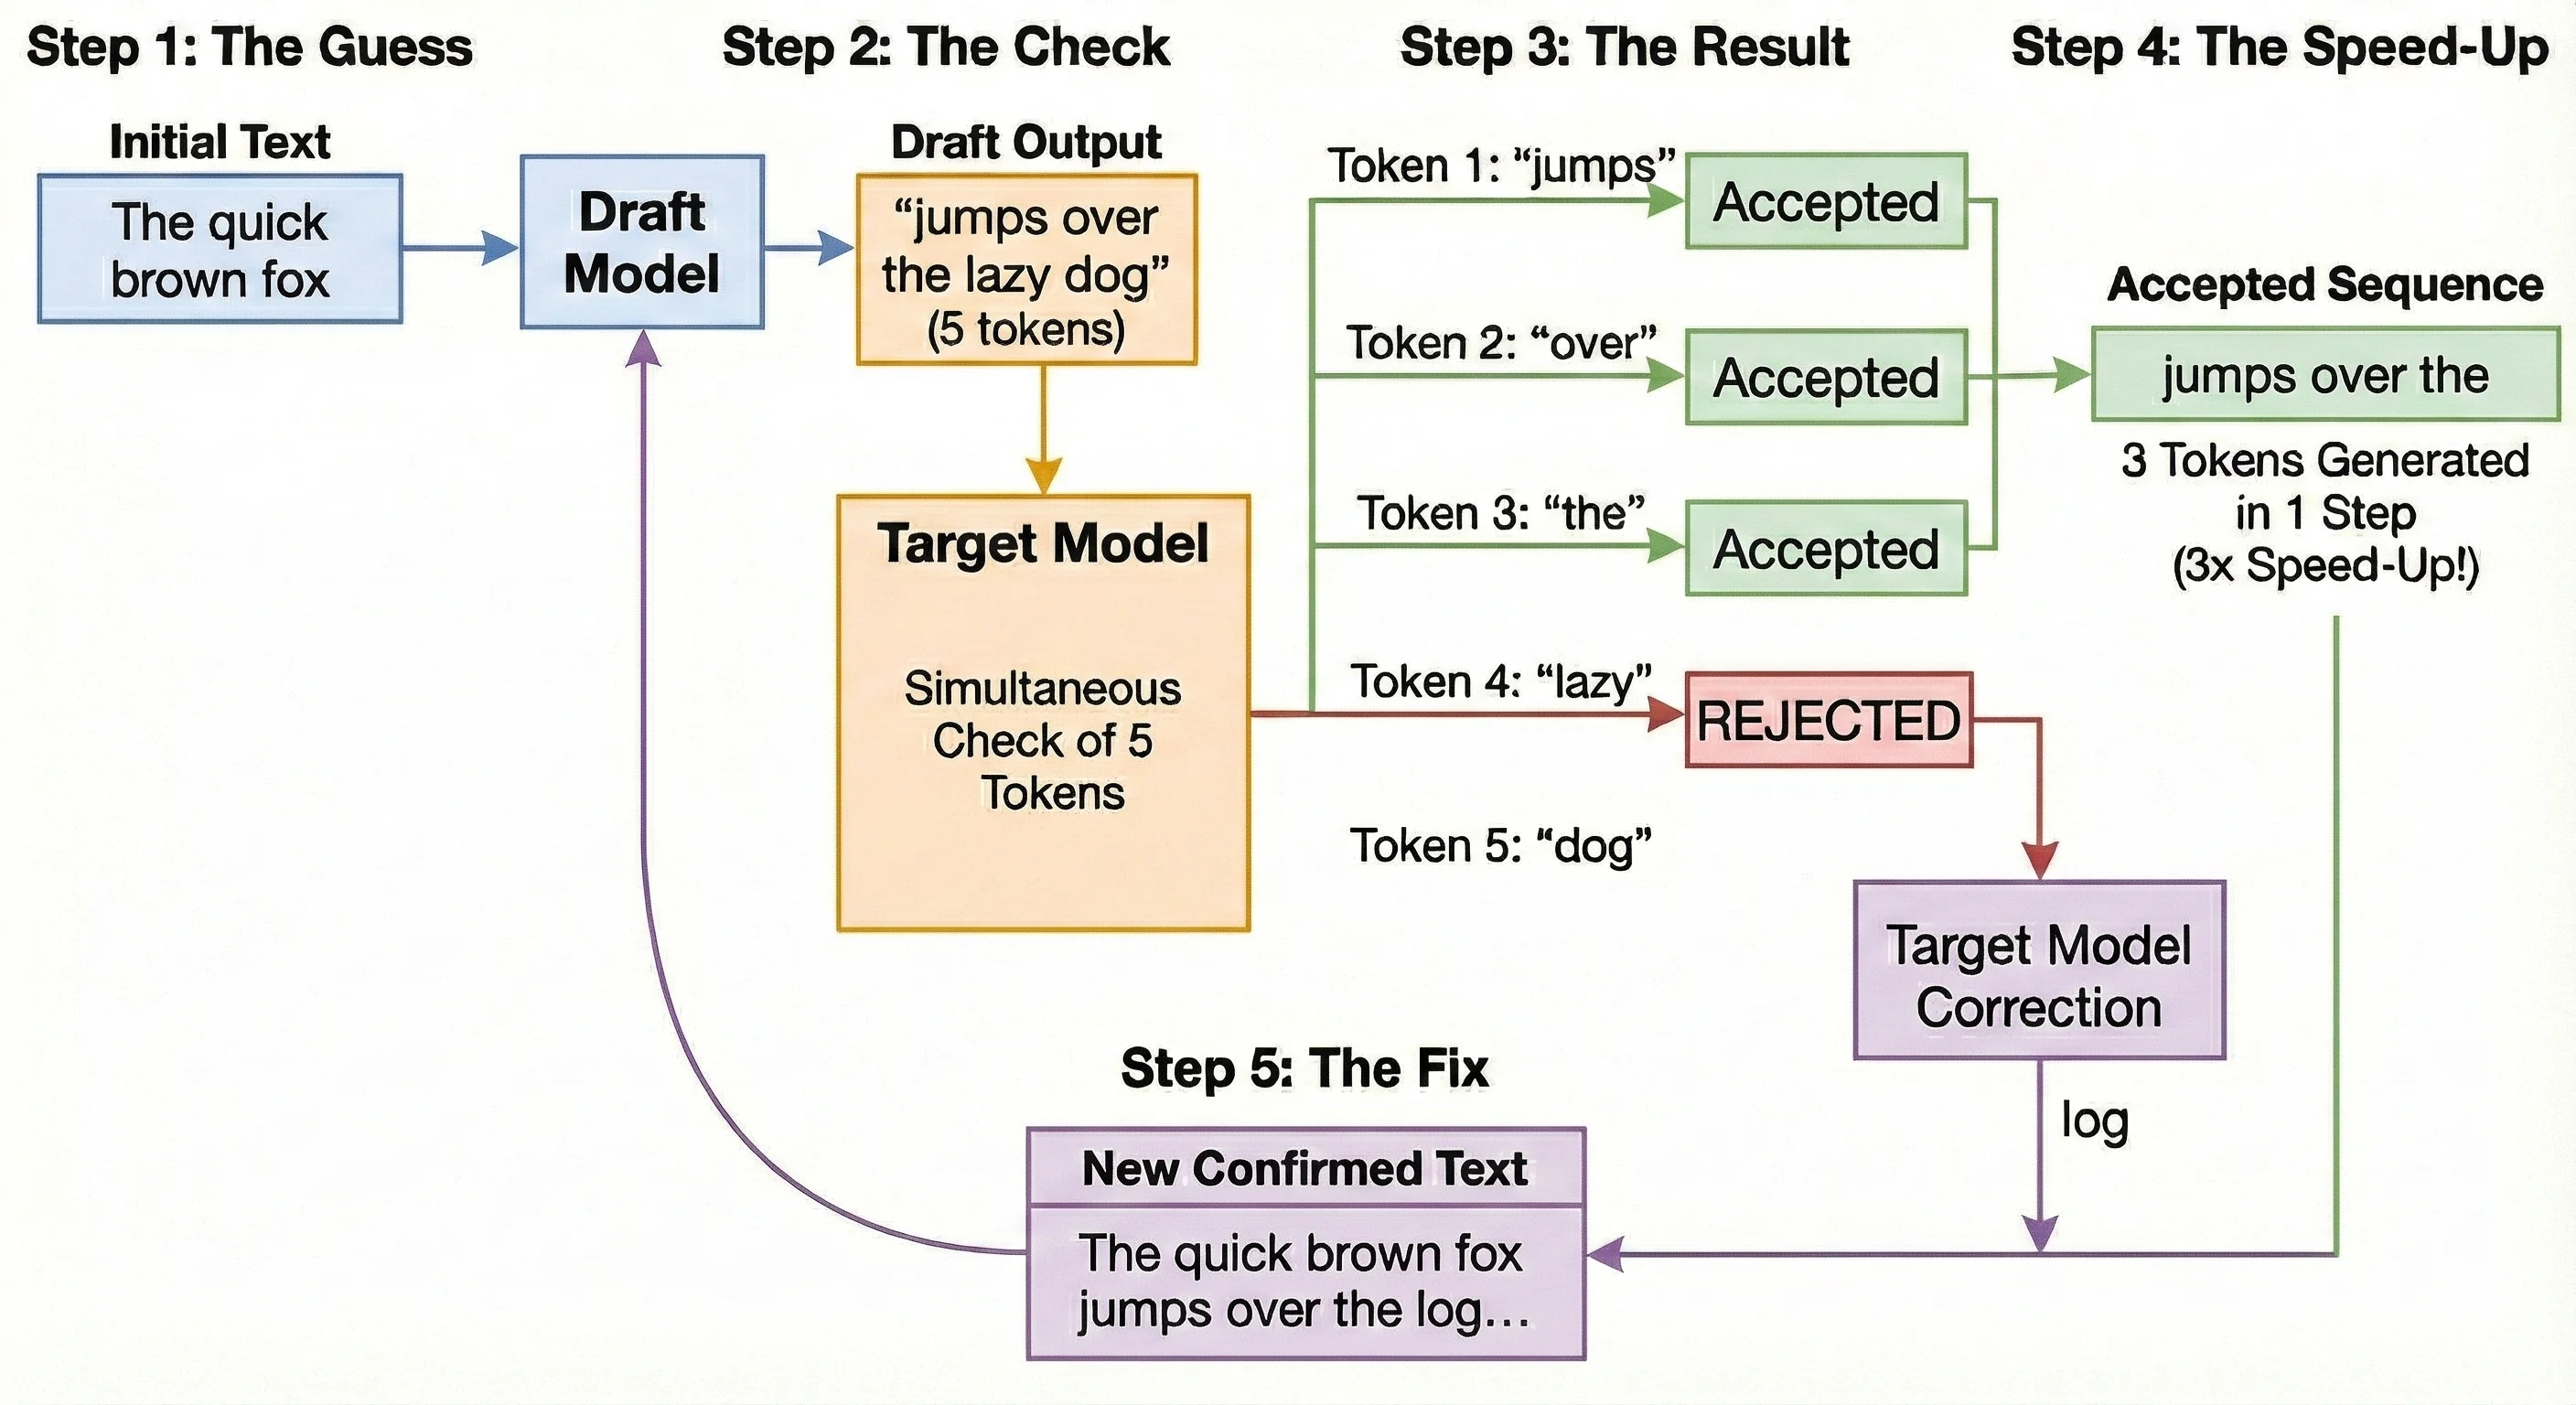
Speculative Decoding in vLLM: Complete Guide to Faster LLM Inference ...

Figure 1 from Speculative Speculative Decoding | Semantic Scholar
Speculative Decoding - Infocusp
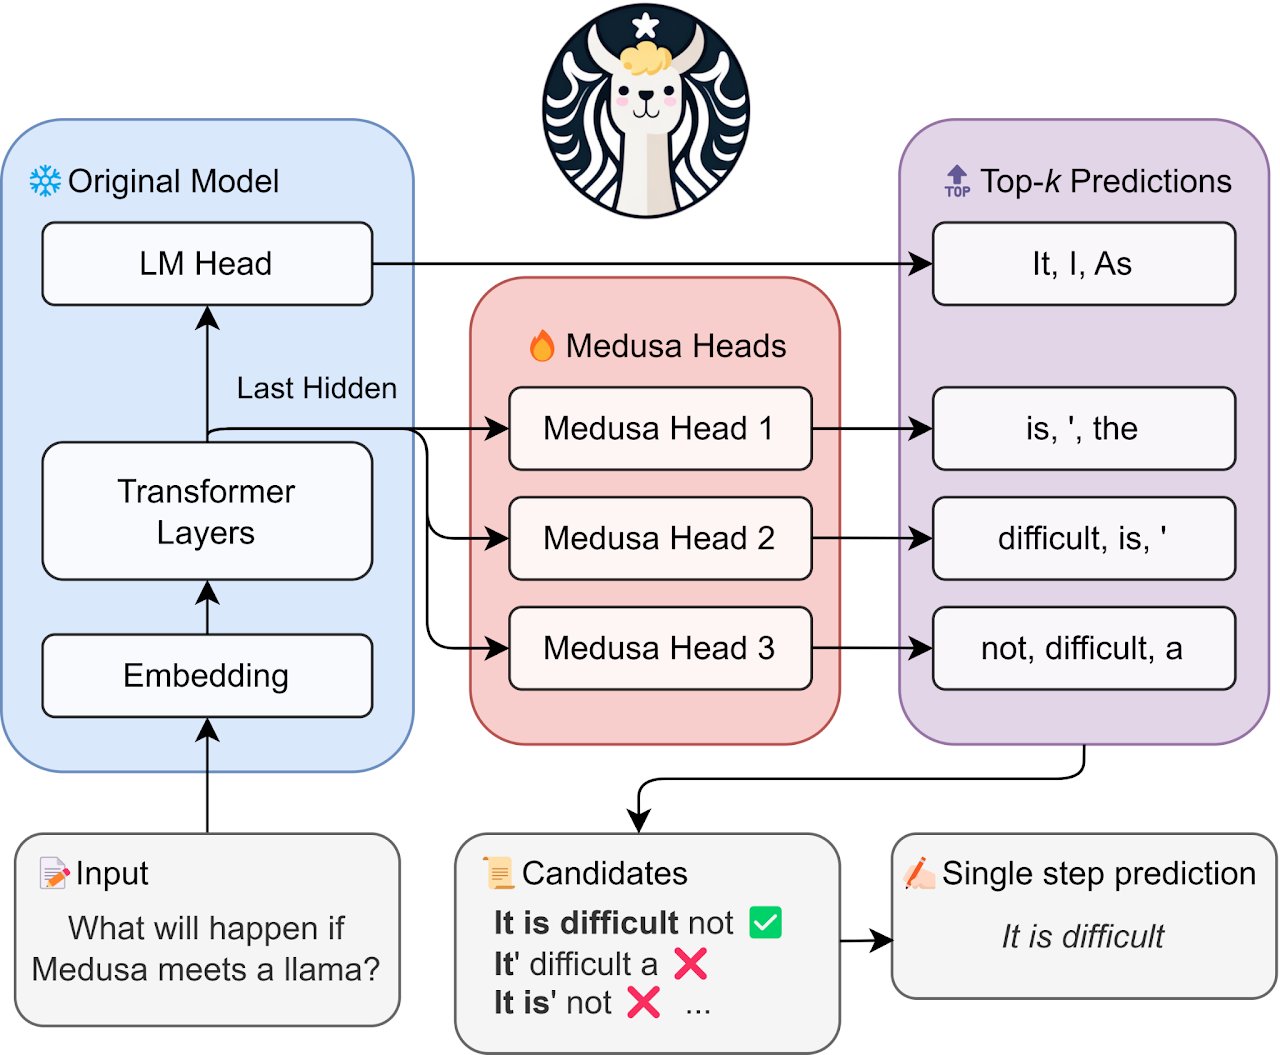
Accelerate LLM Inference with Speculative Decoding | Charles Xu