
Adapteval A Benchmark For Evaluating Large Language Models On Code

AdaptEval: A Benchmark for Evaluating Large Language Models on Code ...

(PDF) AdaptEval: A Benchmark for Evaluating Large Language Models on ...

[论文评述] AdaptEval: A Benchmark for Evaluating Large Language Models on ...

(PDF) ComplexCodeEval: A Benchmark for Evaluating Large Code Models on ...

[논문 리뷰] EngiBench: A Benchmark for Evaluating Large Language Models on ...

Dynamic Benchmark Construction for Evaluating Large Language Models on ...

(PDF) Evaluating Large Language Models for Code Generation: A ...

(PDF) A Survey on Evaluating Large Language Models in Code Generation Tasks

[论文评述] FeedbackEval: A Benchmark for Evaluating Large Language Models ...

Figure 4 from A Survey on Evaluating Large Language Models in Code ...
Advertisement Space (300x250)

CFDLLMBench: A Benchmark Suite for Evaluating Large Language Models in ...

AdaptEval: Evaluating Large Language Models on Domain Adaptation for ...
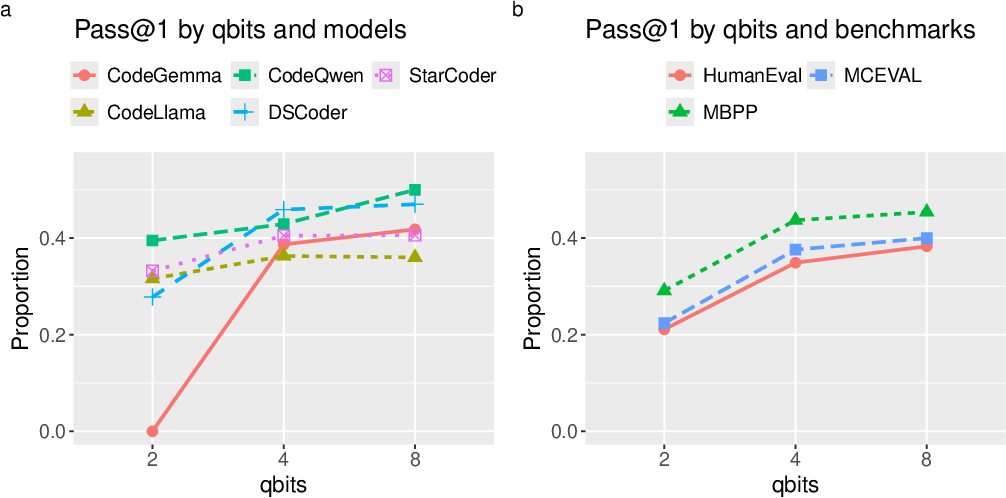
Figure 1 from Evaluating Quantized Large Language Models for Code ...

CodeMixBench: Evaluating Large Language Models on Code Generation with ...

Evaluating Large Language Models for Code Review | AI Research Paper ...
AdaptEval: Evaluating Large Language Models on Domain Adaptation for ...

VerilogEval: Evaluating Large Language Models for Verilog Code ...

AdaptEval: Evaluating Large Language Models on Domain Adaptation for ...

Grátis: Evaluating Large Language Models Trained on Code - Material ...

Paper page - CodeMixBench: Evaluating Large Language Models on Code ...
Advertisement Space (336x280)

Developing a Scalable Benchmark for Assessing Large Language Models in ...

Paper page - ComplexCodeEval: A Benchmark for Evaluating Large Code ...

[PDF] Evaluating Large Language Models Trained on Code | Semantic Scholar

Codex: Evaluating Large Language Models Trained on Code - YouTube

VHDL-Eval: A Framework for Evaluating Large Language Models in VHDL ...

Evaluating Large Language Models Trained on Code

[논문 리뷰] Evaluating Large Language Models on Spatial Tasks: A Multi-Task ...

Developing a Scalable Benchmark for Assessing Large Language Models in ...
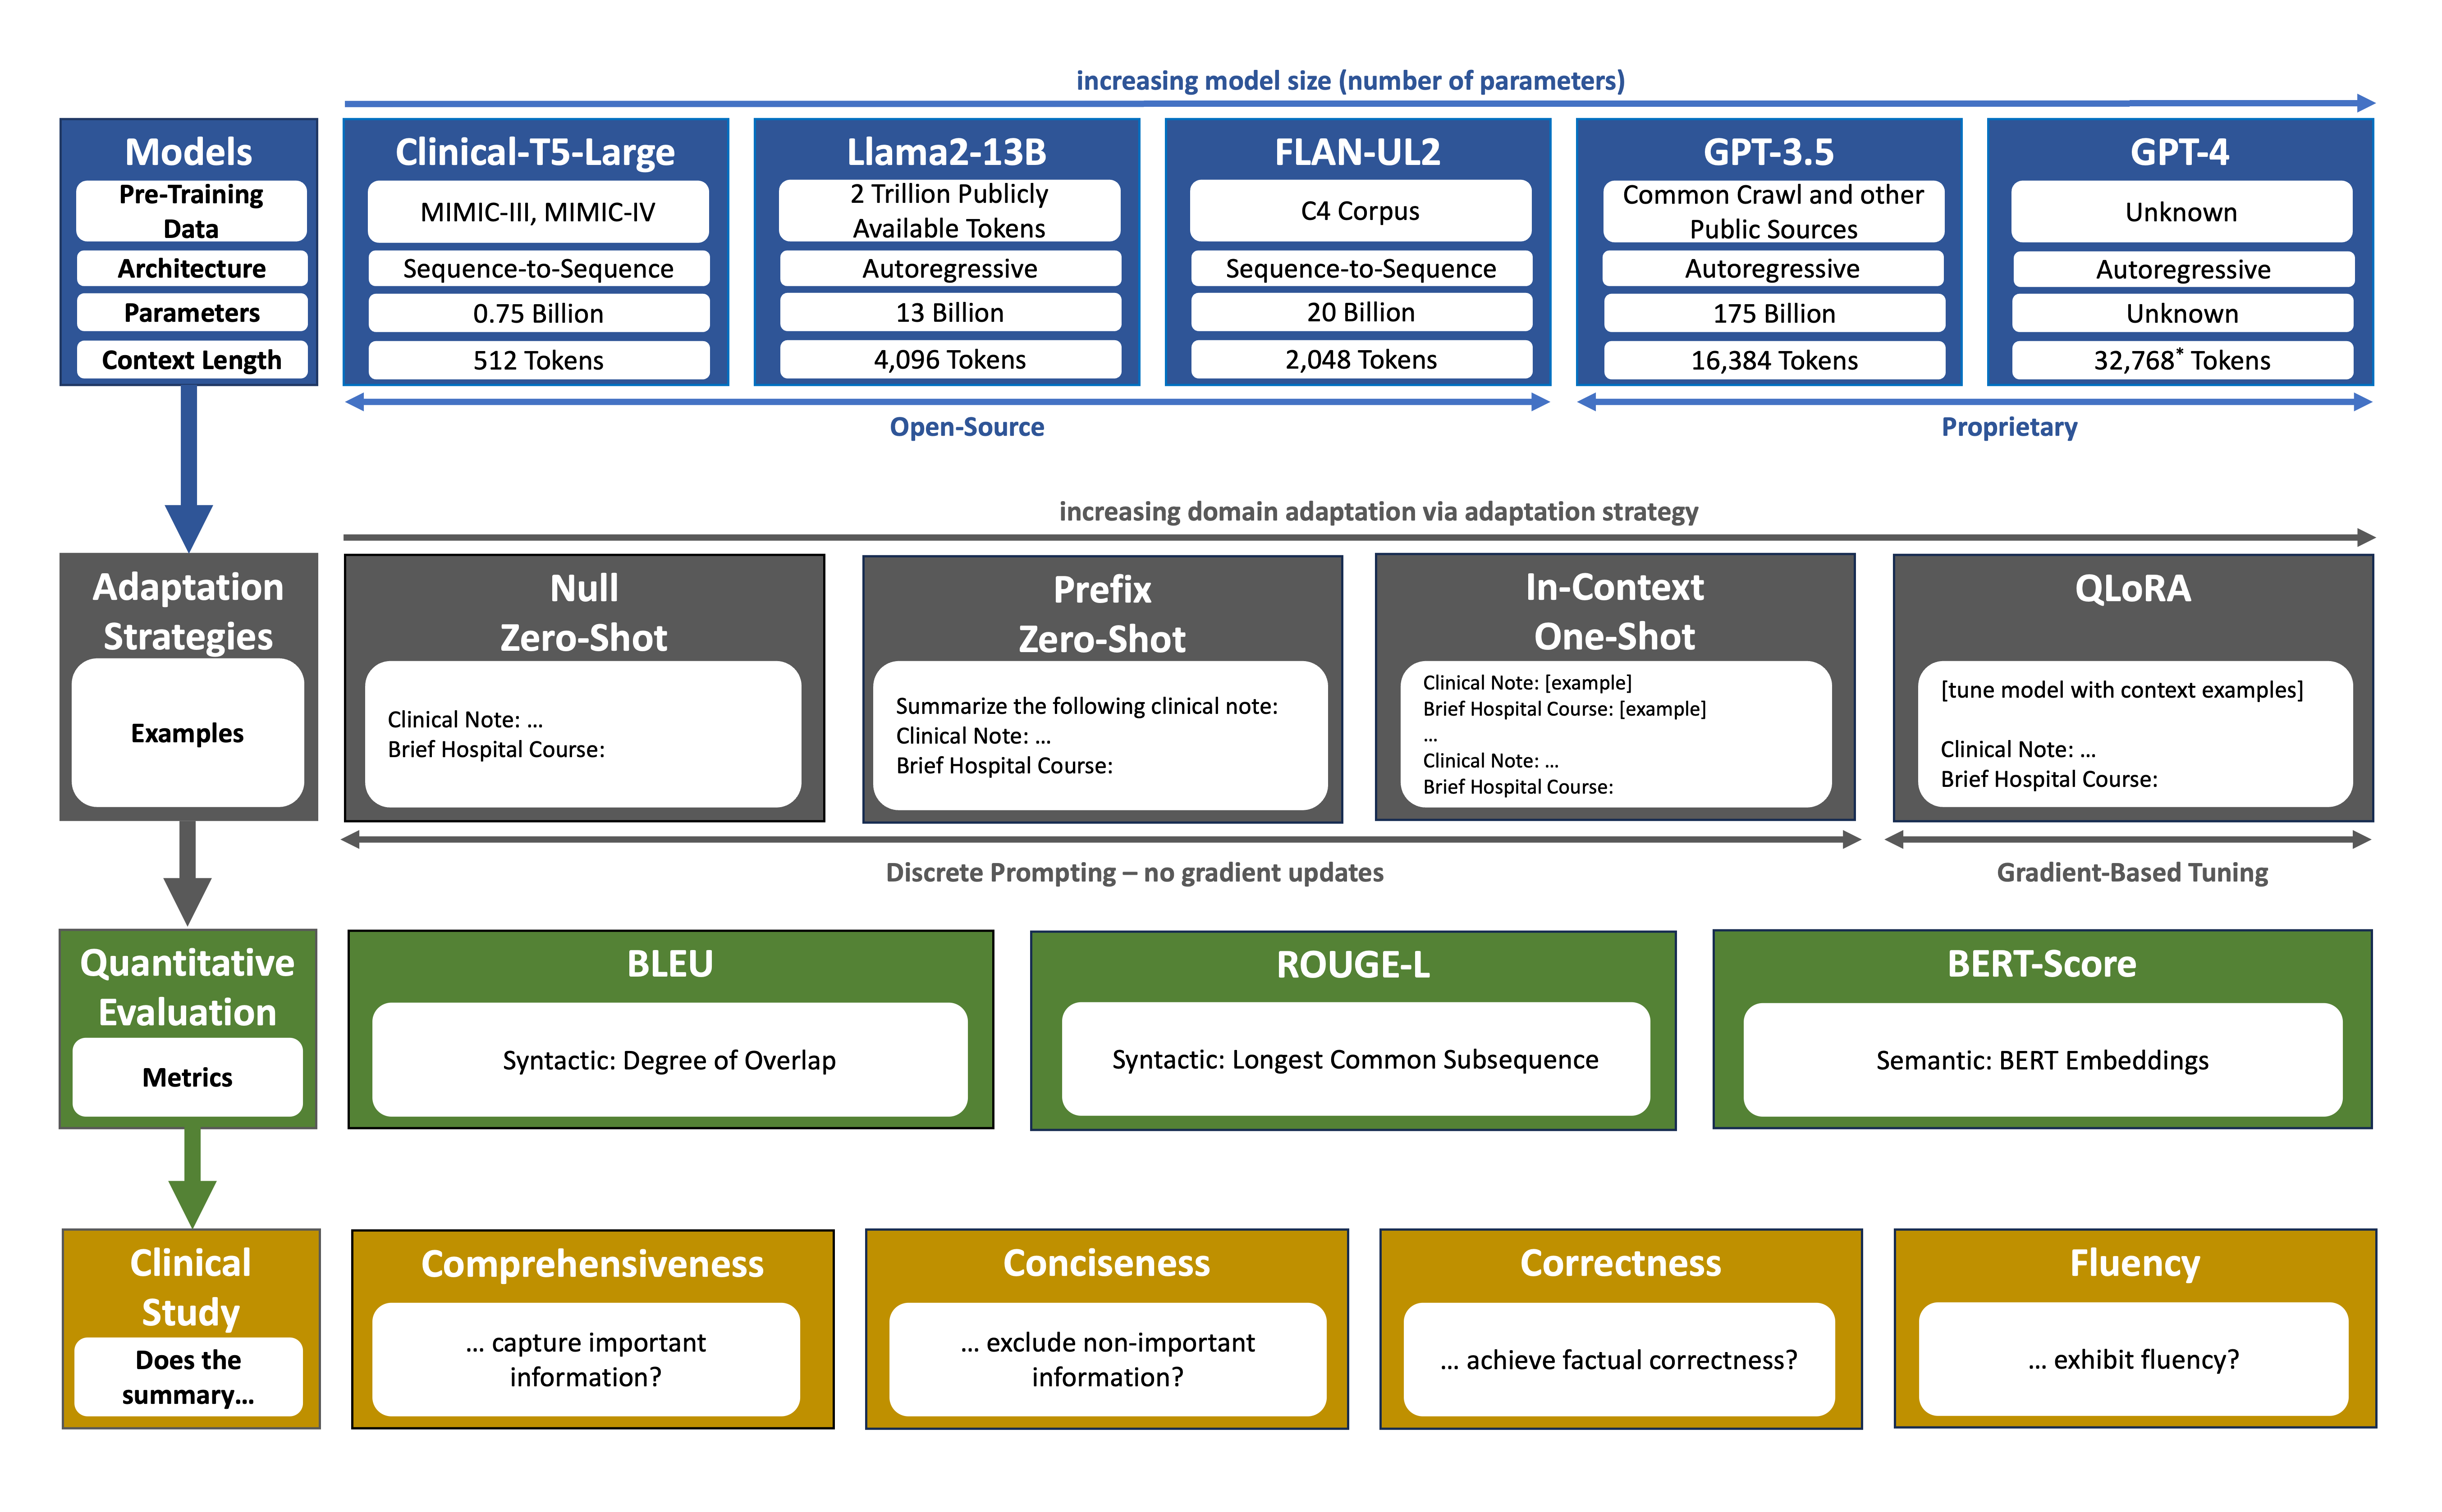
[2403.05720] A Benchmark of Domain-Adapted Large Language Models for ...
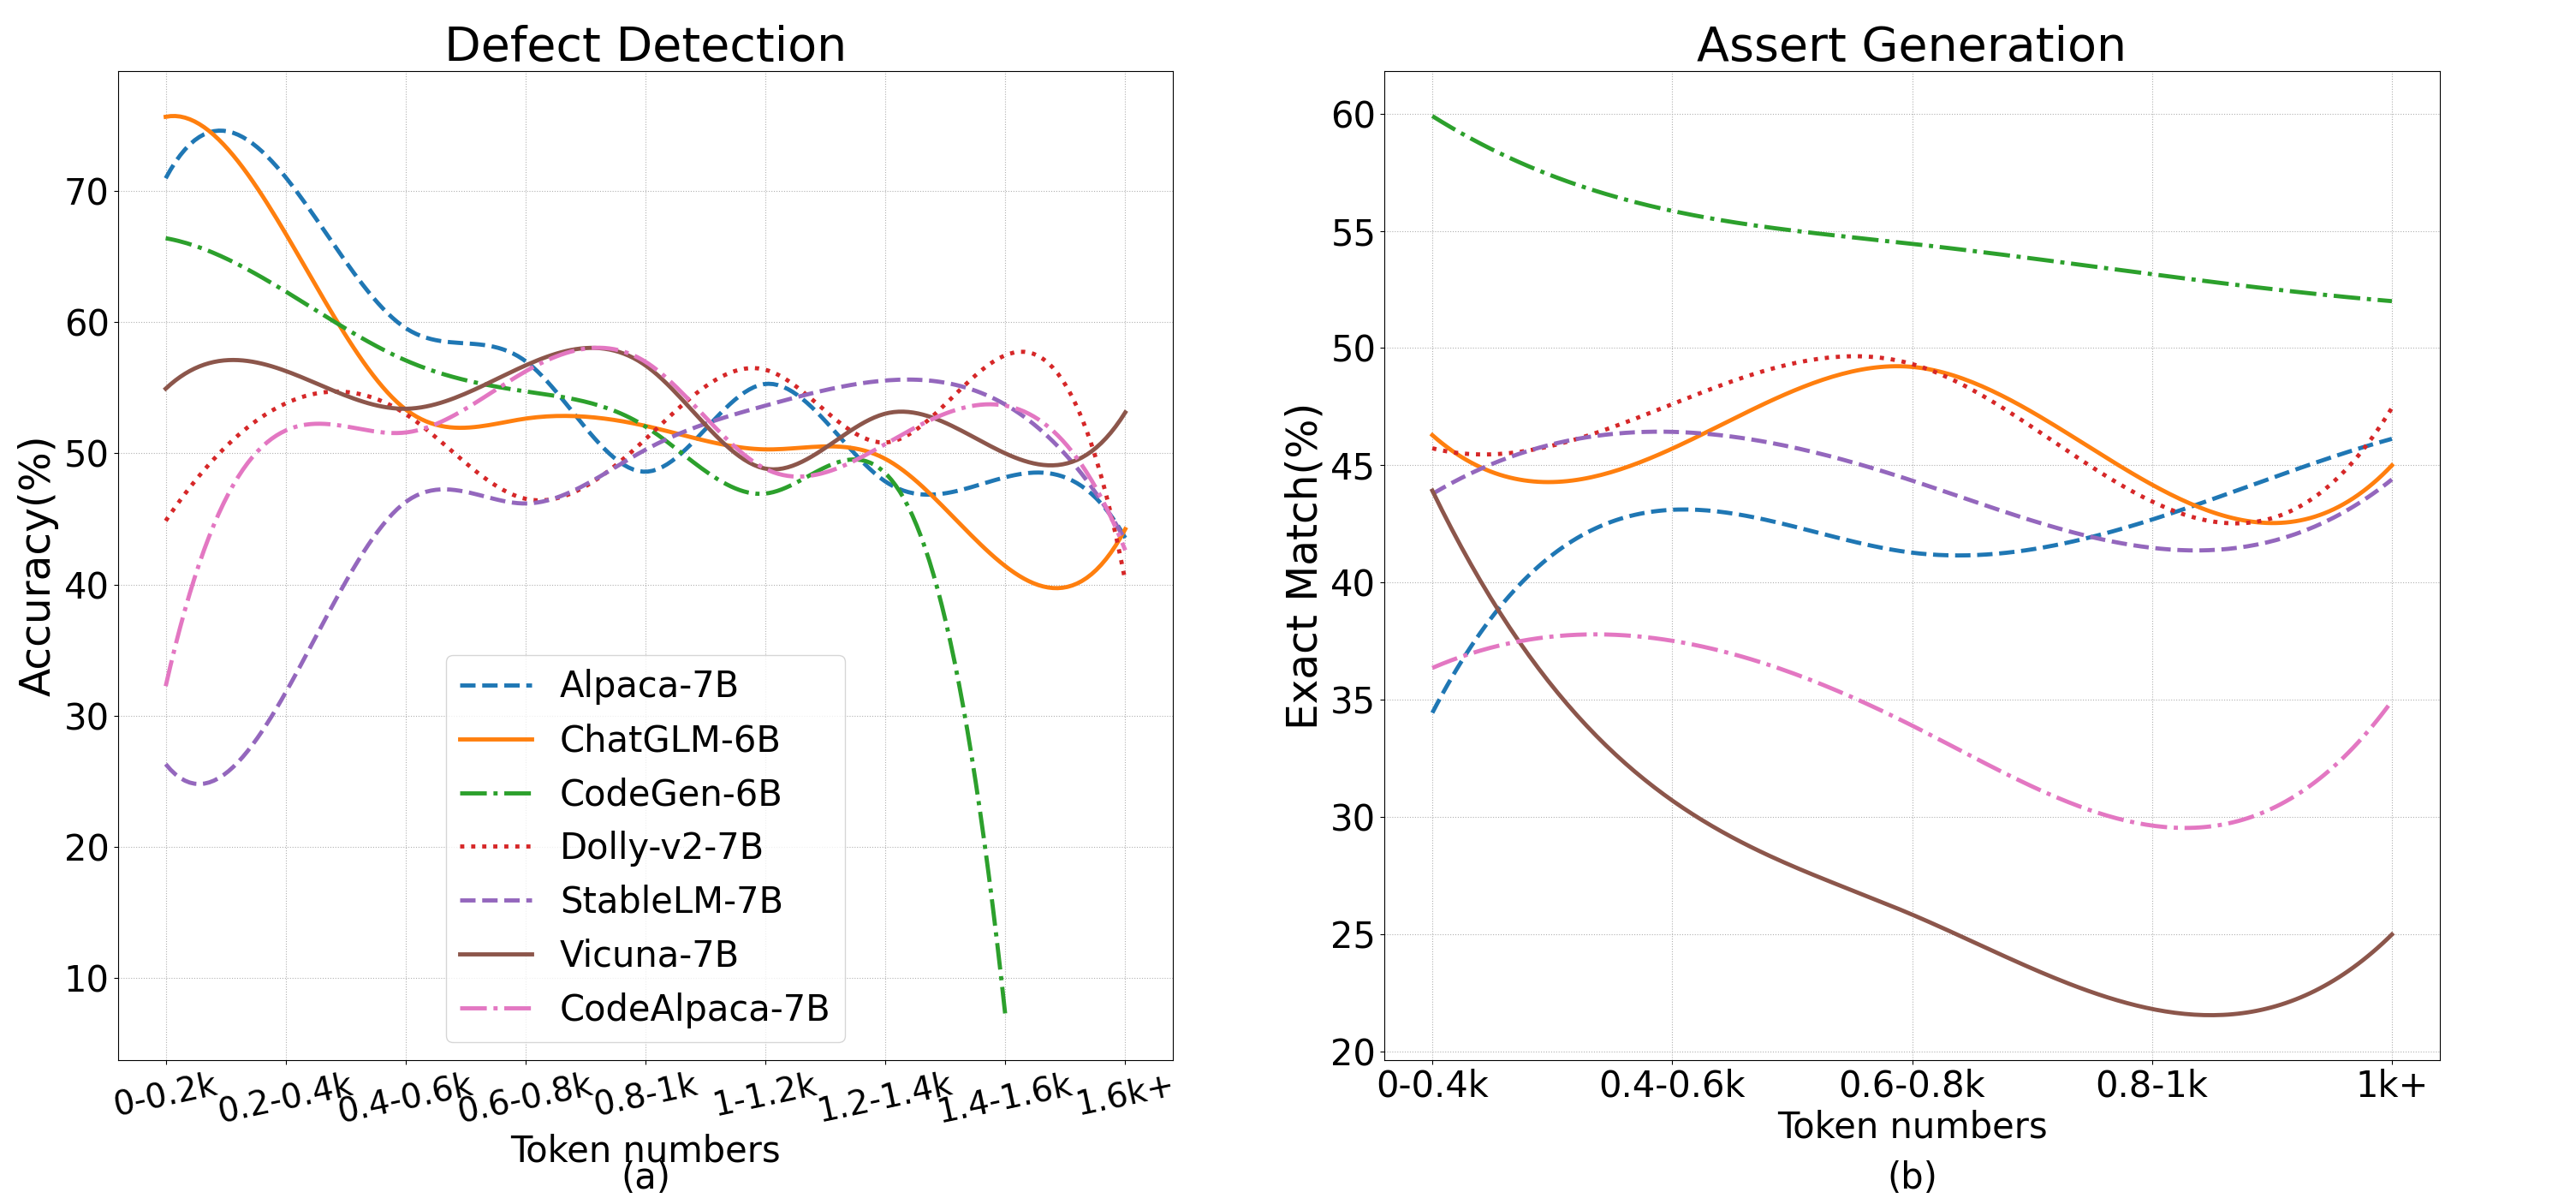
[2308.01240] Evaluating Instruction-Tuned Large Language Models on Code ...
Advertisement Space (336x280)
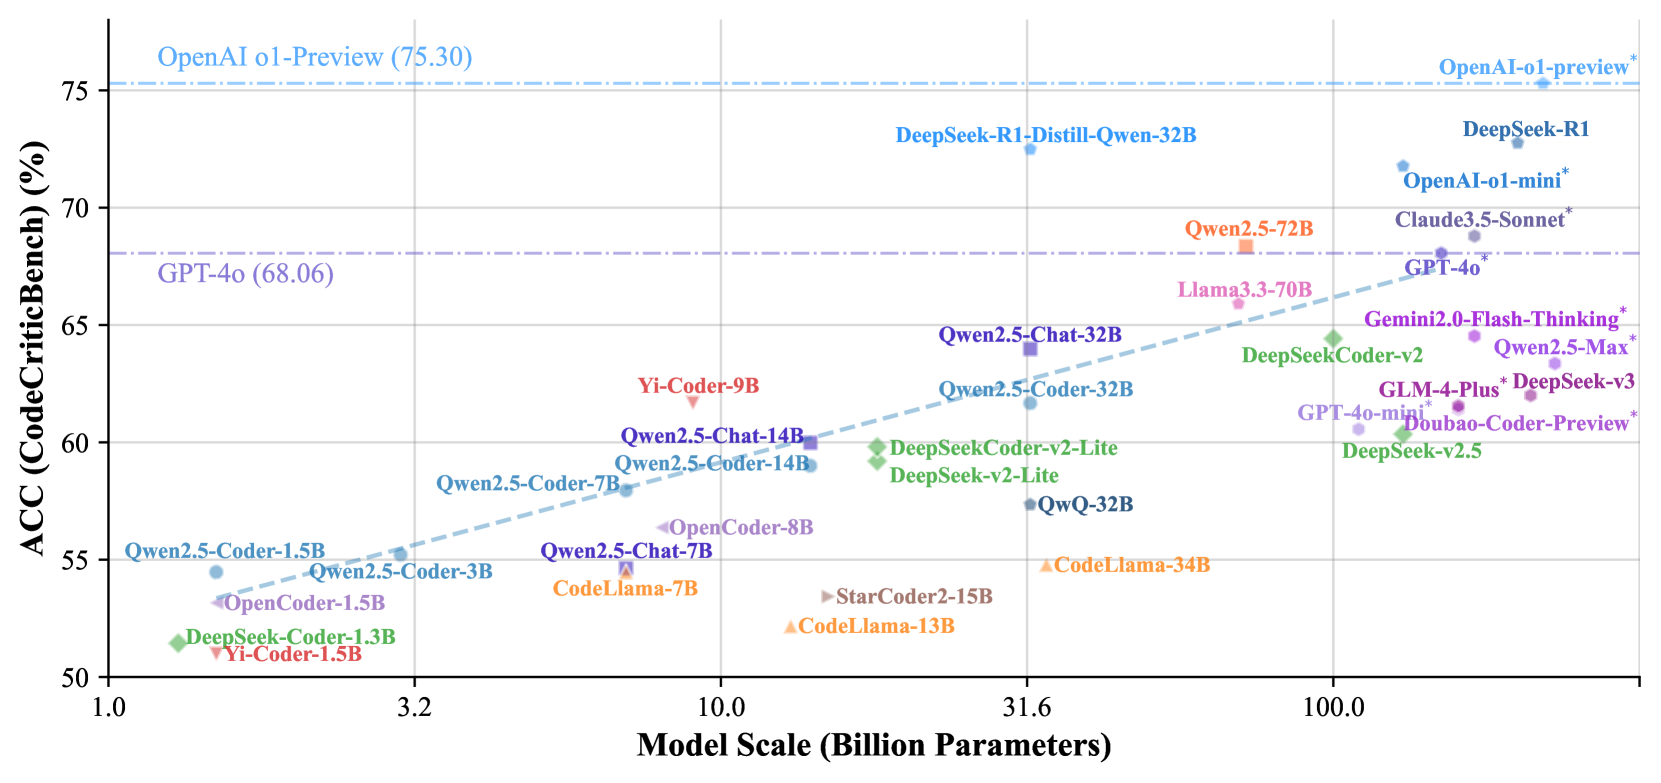
CodeCriticBench: A Holistic Code Critique Benchmark for Large Language ...

[논문 리뷰] Evaluating Large Language Models for Code Review

Figure 10 from Evaluating Large Language Models Trained on Code ...

Paper page - AdaptEval: Evaluating Large Language Models on Domain ...

DynaCode: A Dynamic Complexity-Aware Code Benchmark for Evaluating ...

(PDF) AdaptEval: Evaluating Large Language Models on Domain Adaptation ...