
Audio Generation With Diffusion Models Pdf Data Compression

Audio Generation With Diffusion Models | PDF | Data Compression ...
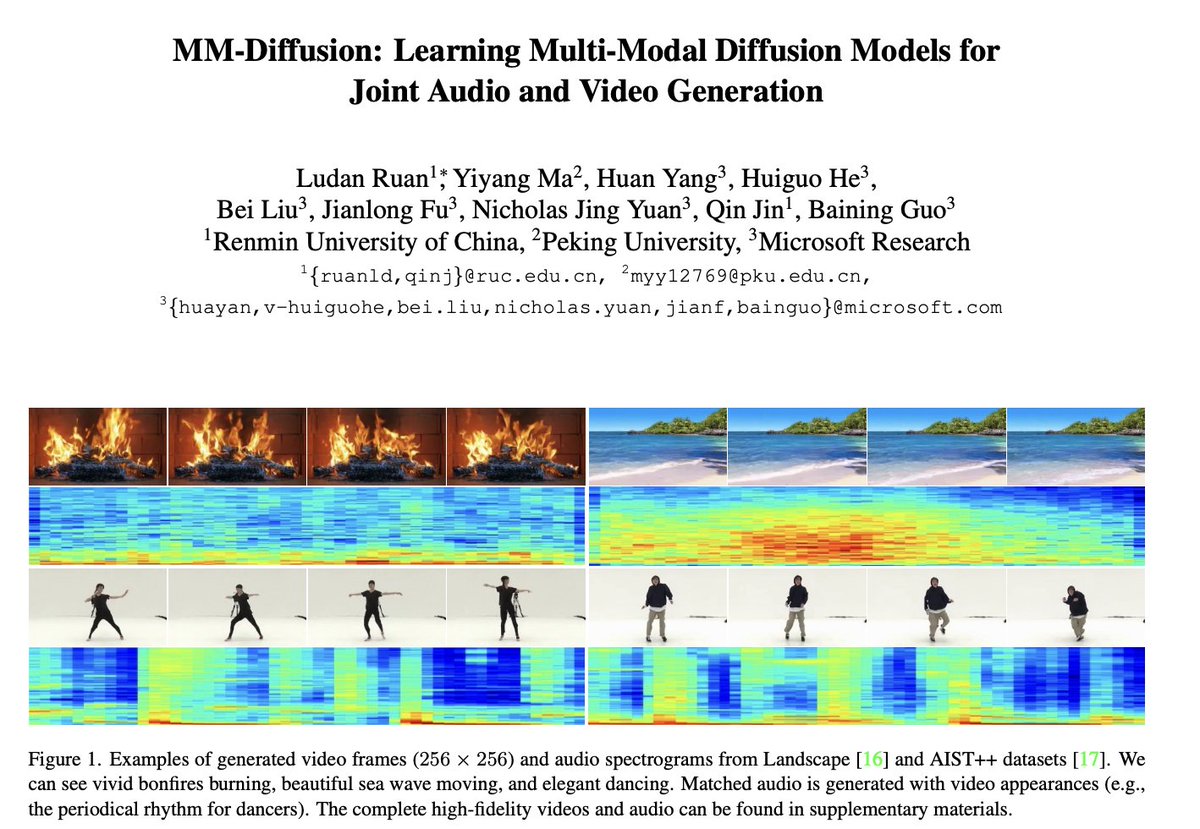
AUDIO GENERATION WITH DIFFUSION MODELS | AudioGenerationDiffusion
AUDIO GENERATION WITH DIFFUSION MODELS | AudioGenerationDiffusion
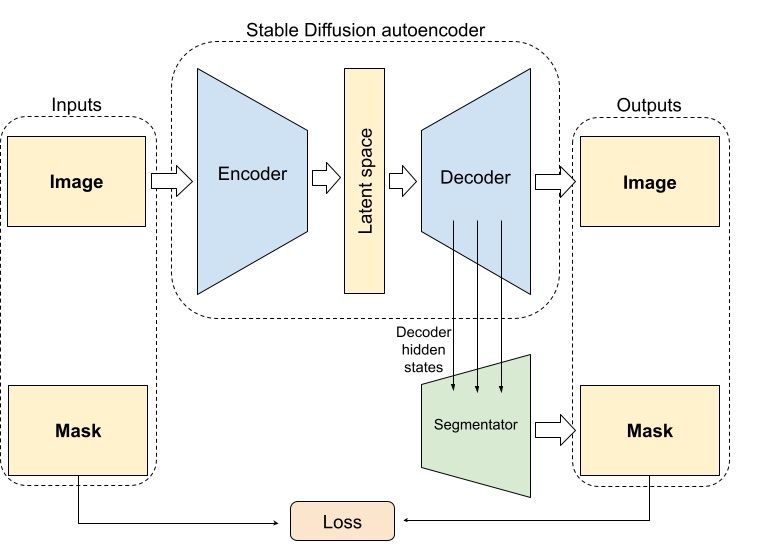
Data generation with diffusion models - part 2
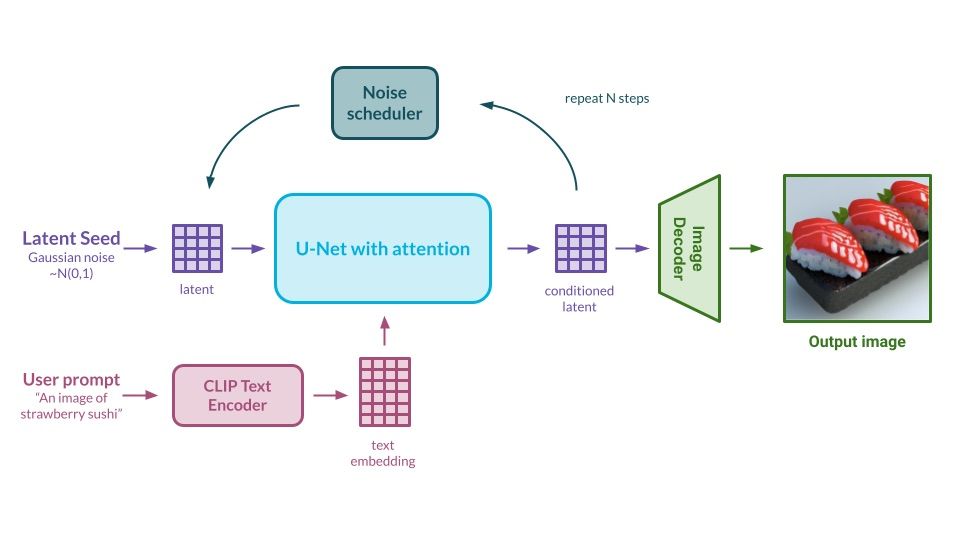
Data generation with diffusion models - part 2
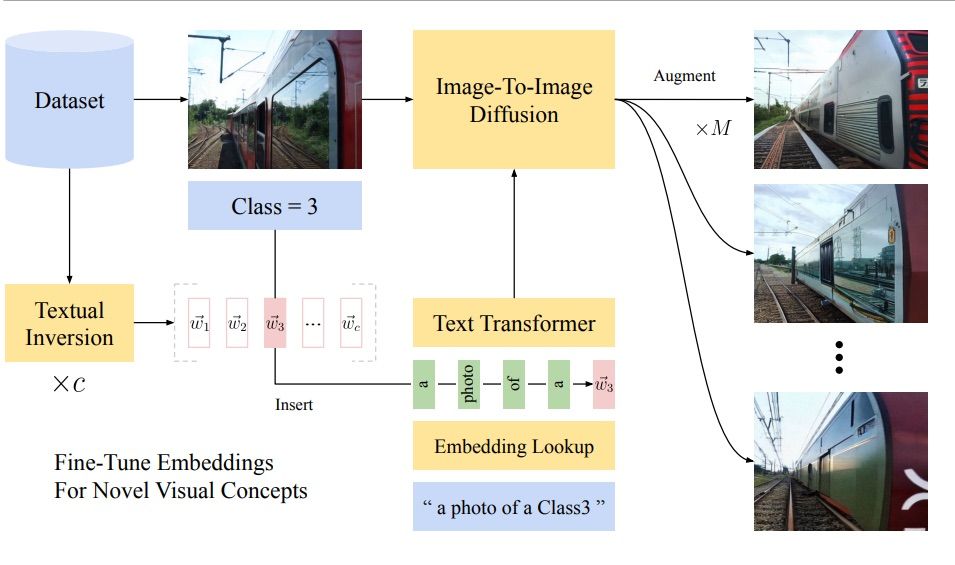
Data generation with diffusion models - part 1
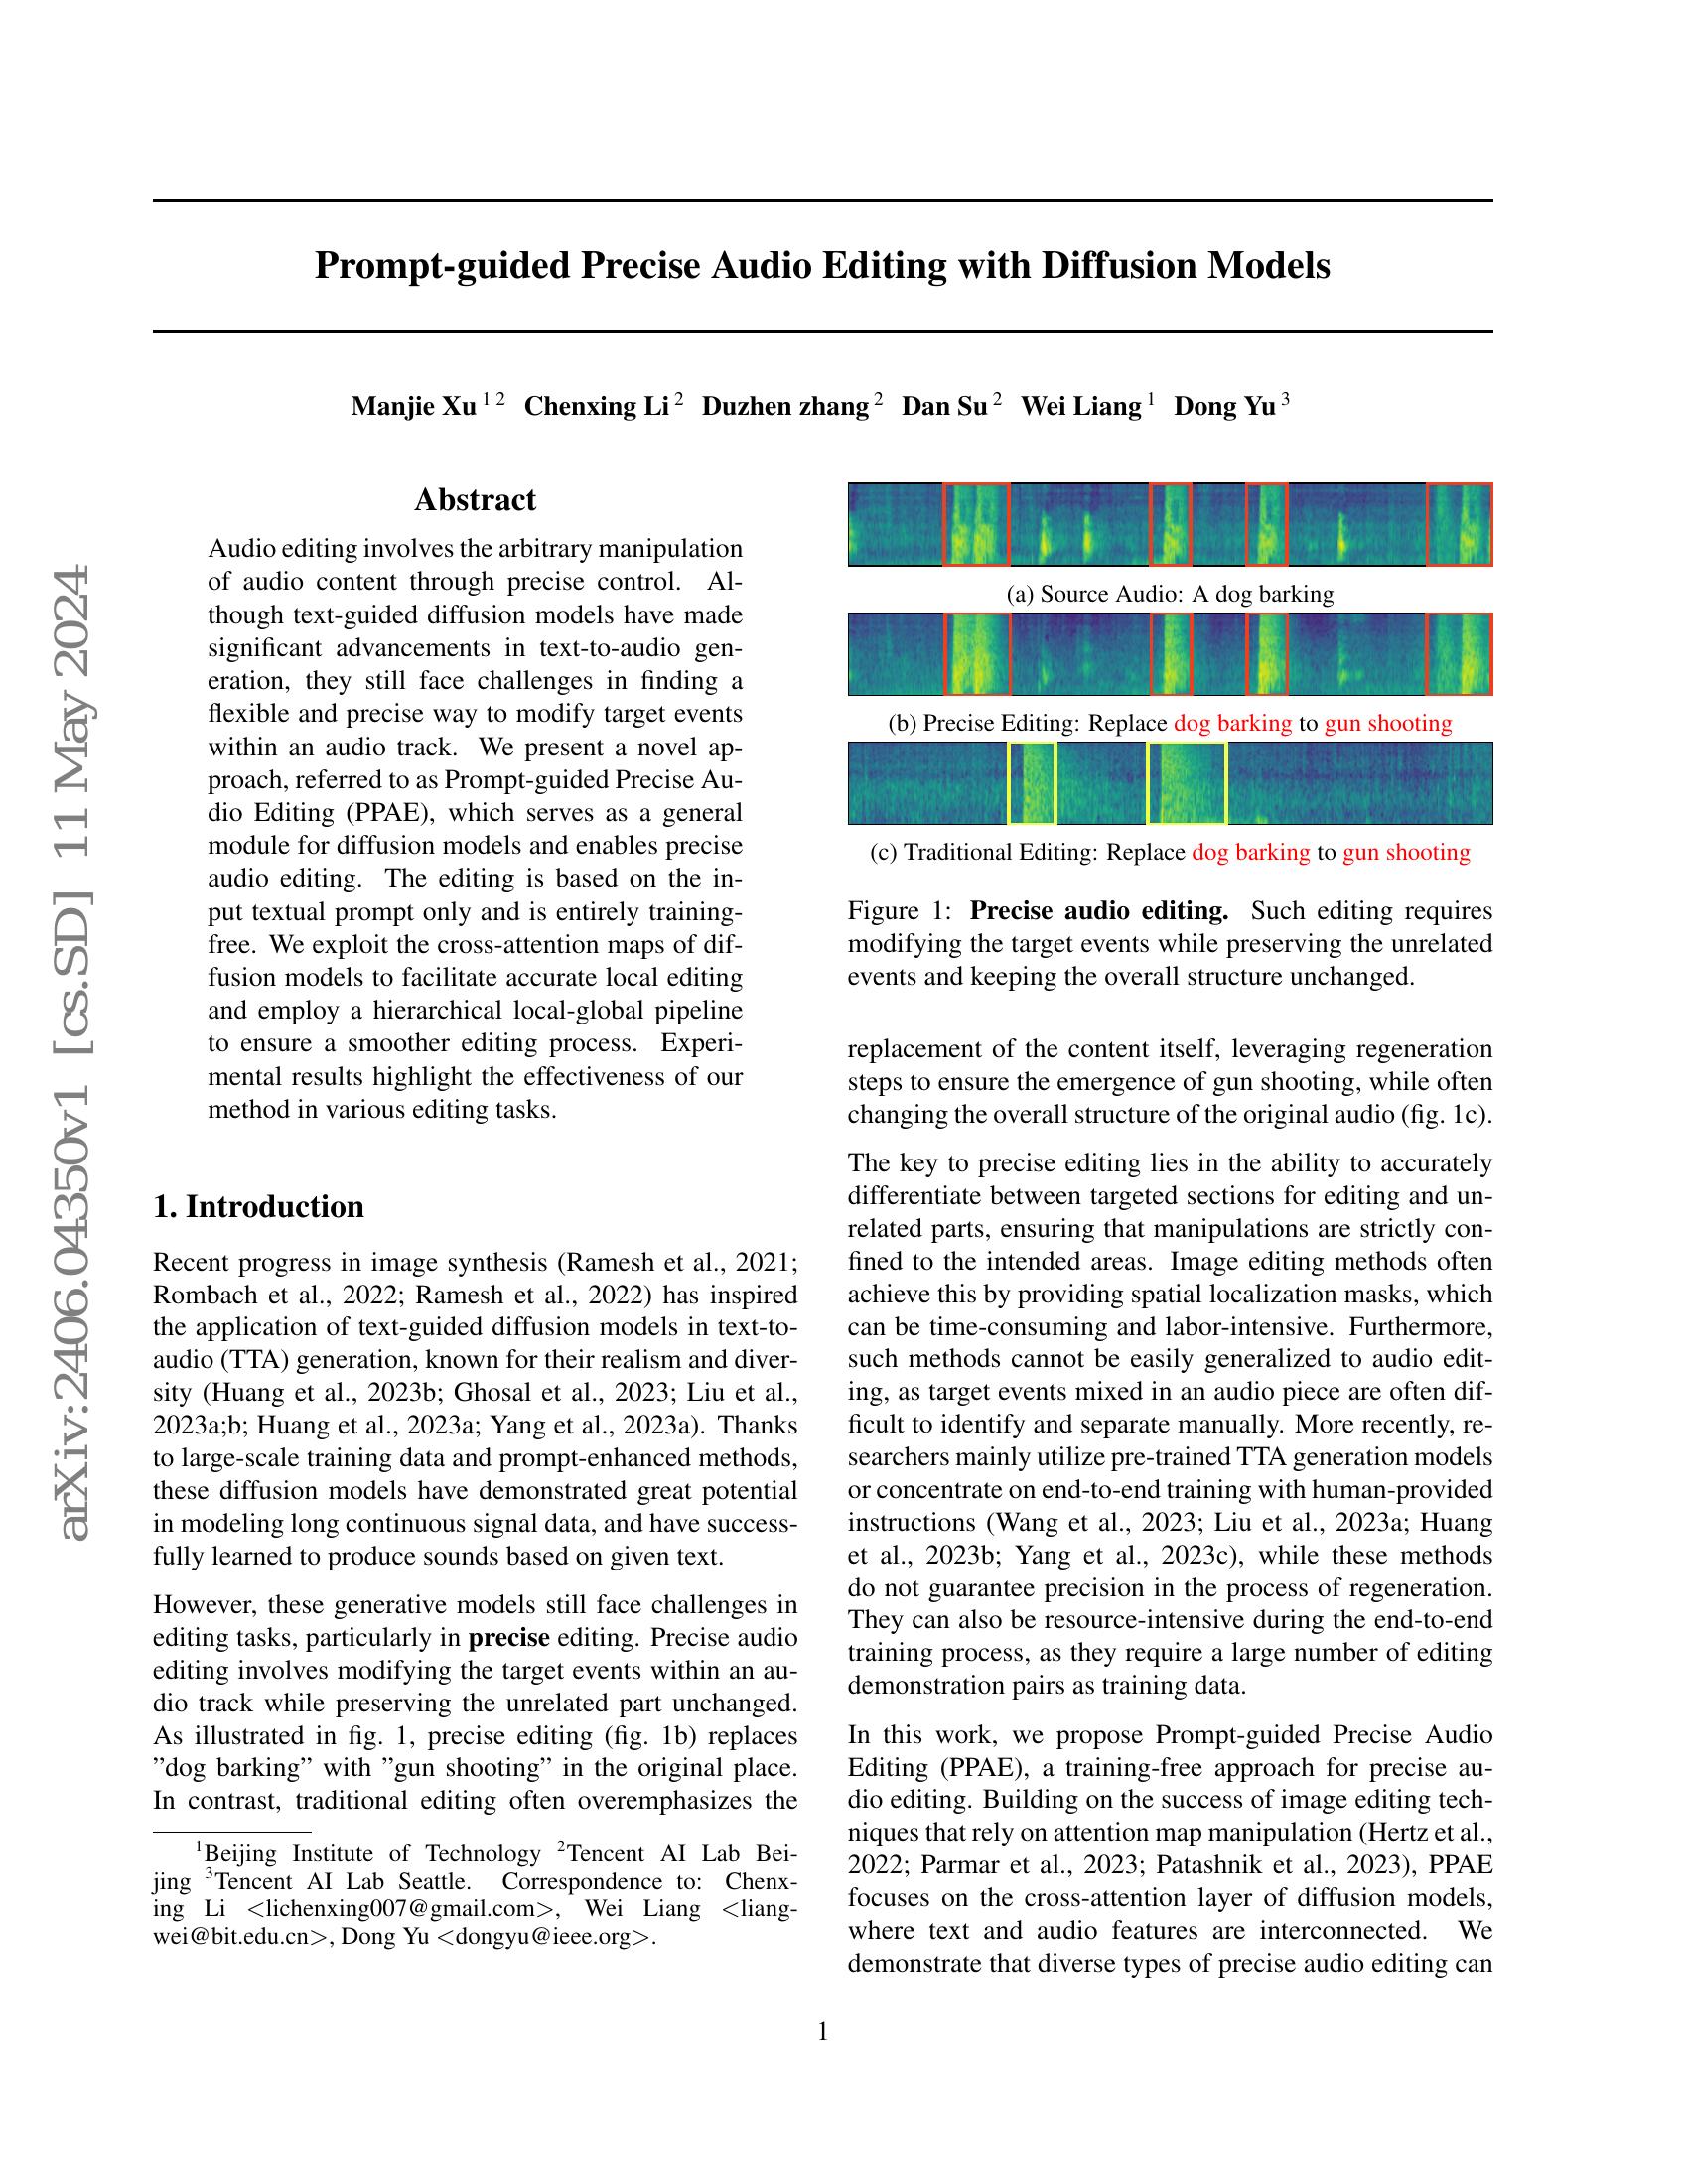
Prompt-guided Precise Audio Editing with Diffusion Models - 智源社区论文

(PDF) AudioLDM: Text-to-Audio Generation with Latent Diffusion Models

A Technical Guide to Diffusion Models for Audio Generation | audio ...

Diffusion Models For Audio Semantic Communication | PDF | Communication ...
Advertisement Space (300x250)

A Technical Guide to Diffusion Models for Audio Generation | audio ...

Latent Diffusion Models for Text-to-Audio Generation with Limited ...
Audio Generation with Multiple Conditional Diffusion Model | VIDEO ...

Audio Diffusion Models in Speech Synthesis | PDF | Speech Synthesis ...

Lossy Compression via Latent Diffusion | PDF | Data Compression | Codec

Autoregressive Diffusion Model | PDF | Data Compression | Probability ...

Text-to-Audio Generation with Latent Diffusion Models - a zman6969 ...
20 Nov 2025 - High Quality Audio Generation with Latent Diffusion ...
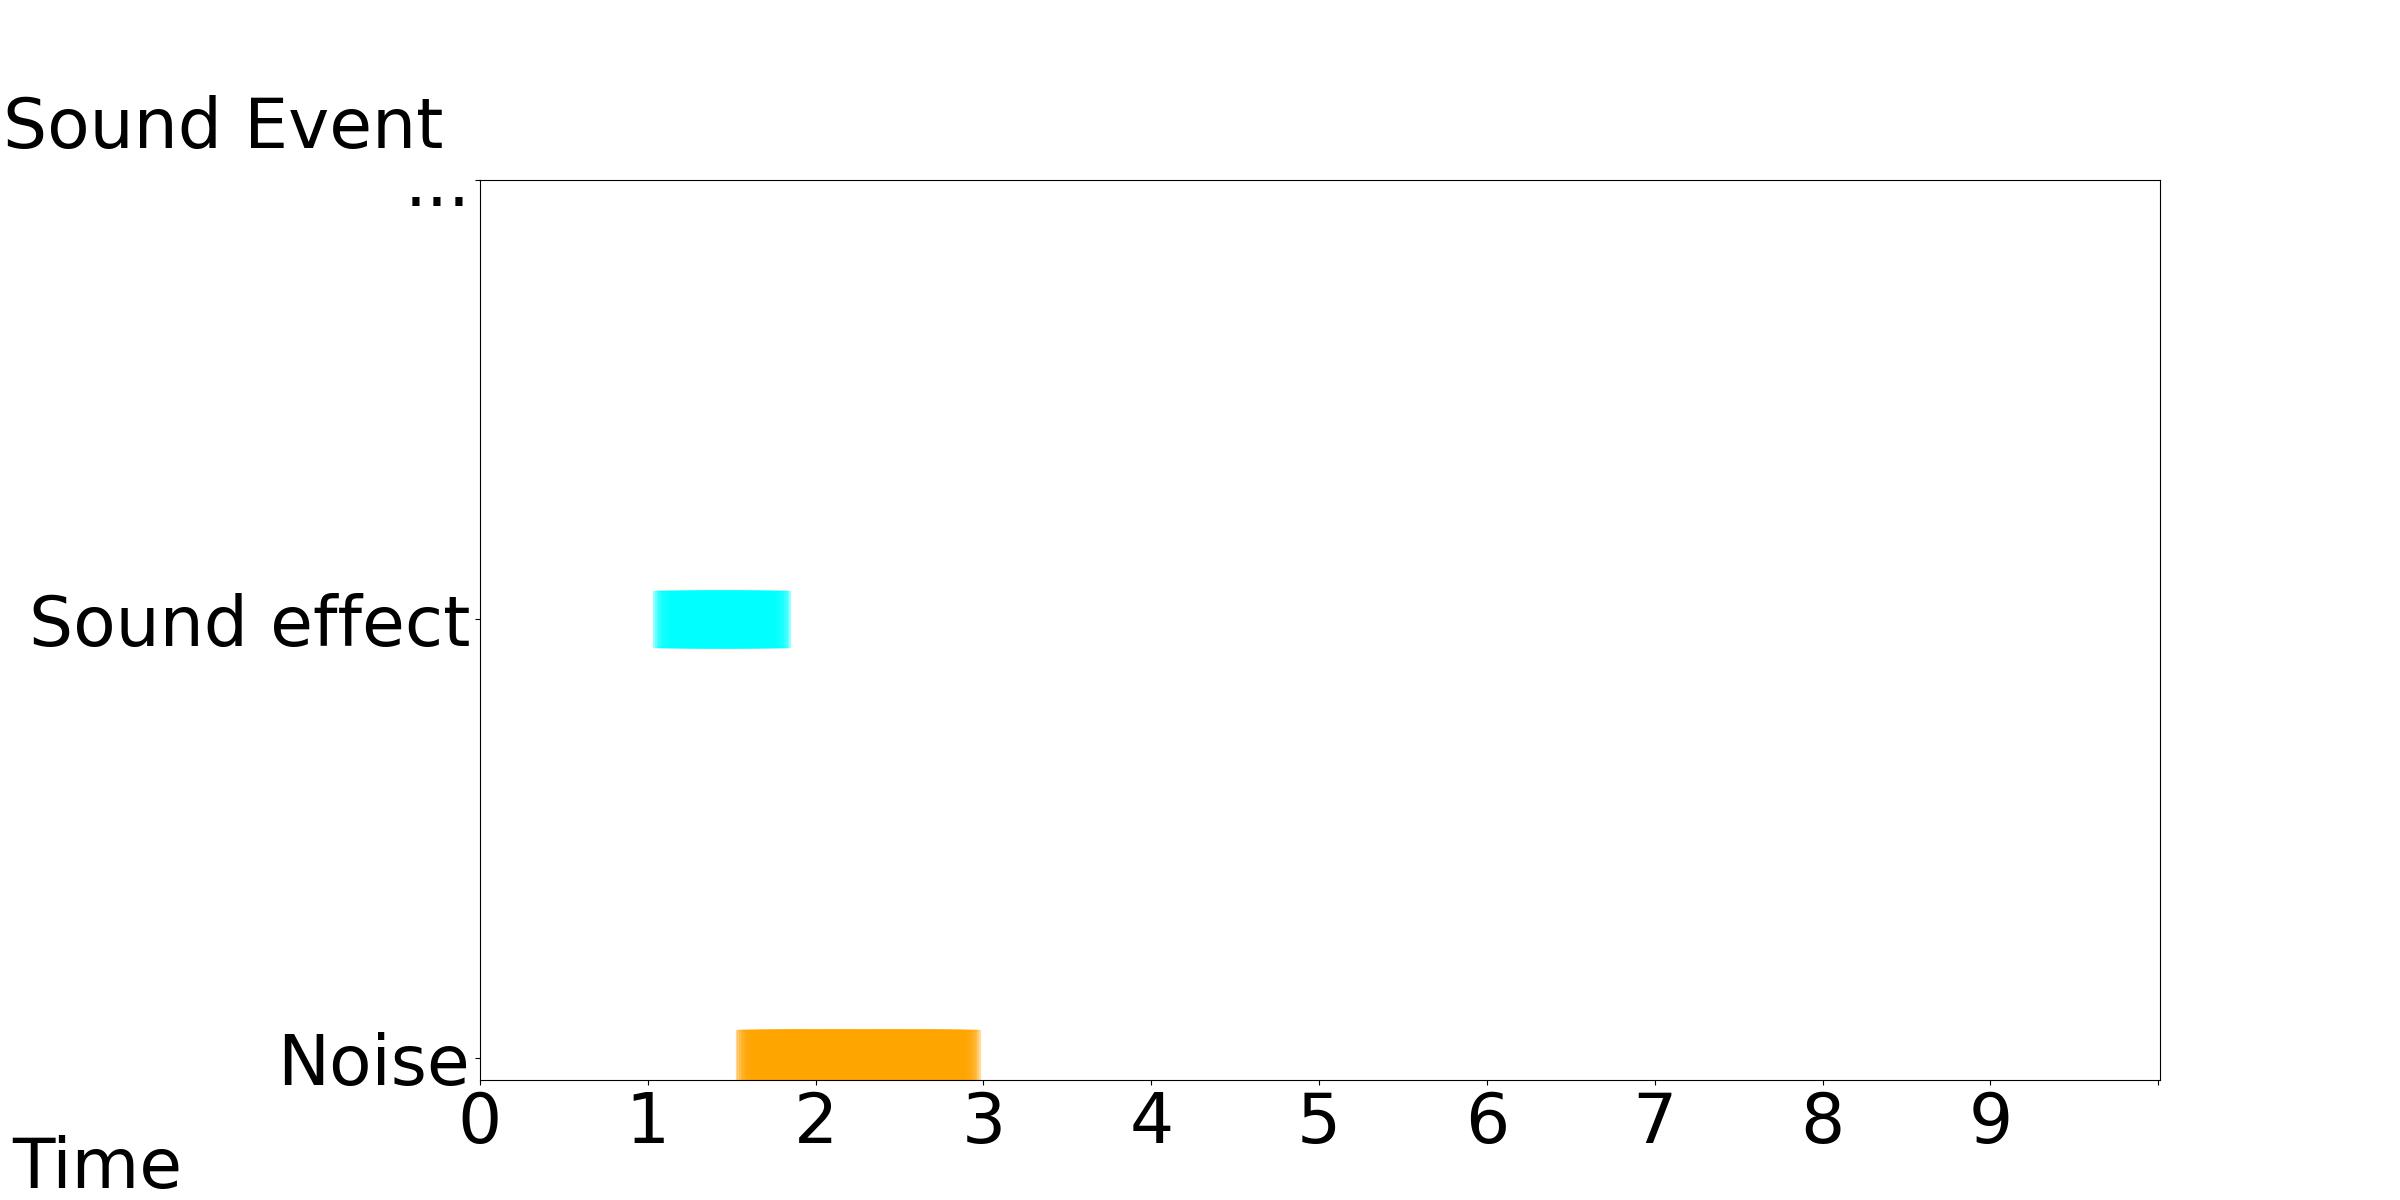
Audio Generation with Multiple Conditional Diffusion Model - Speech ...
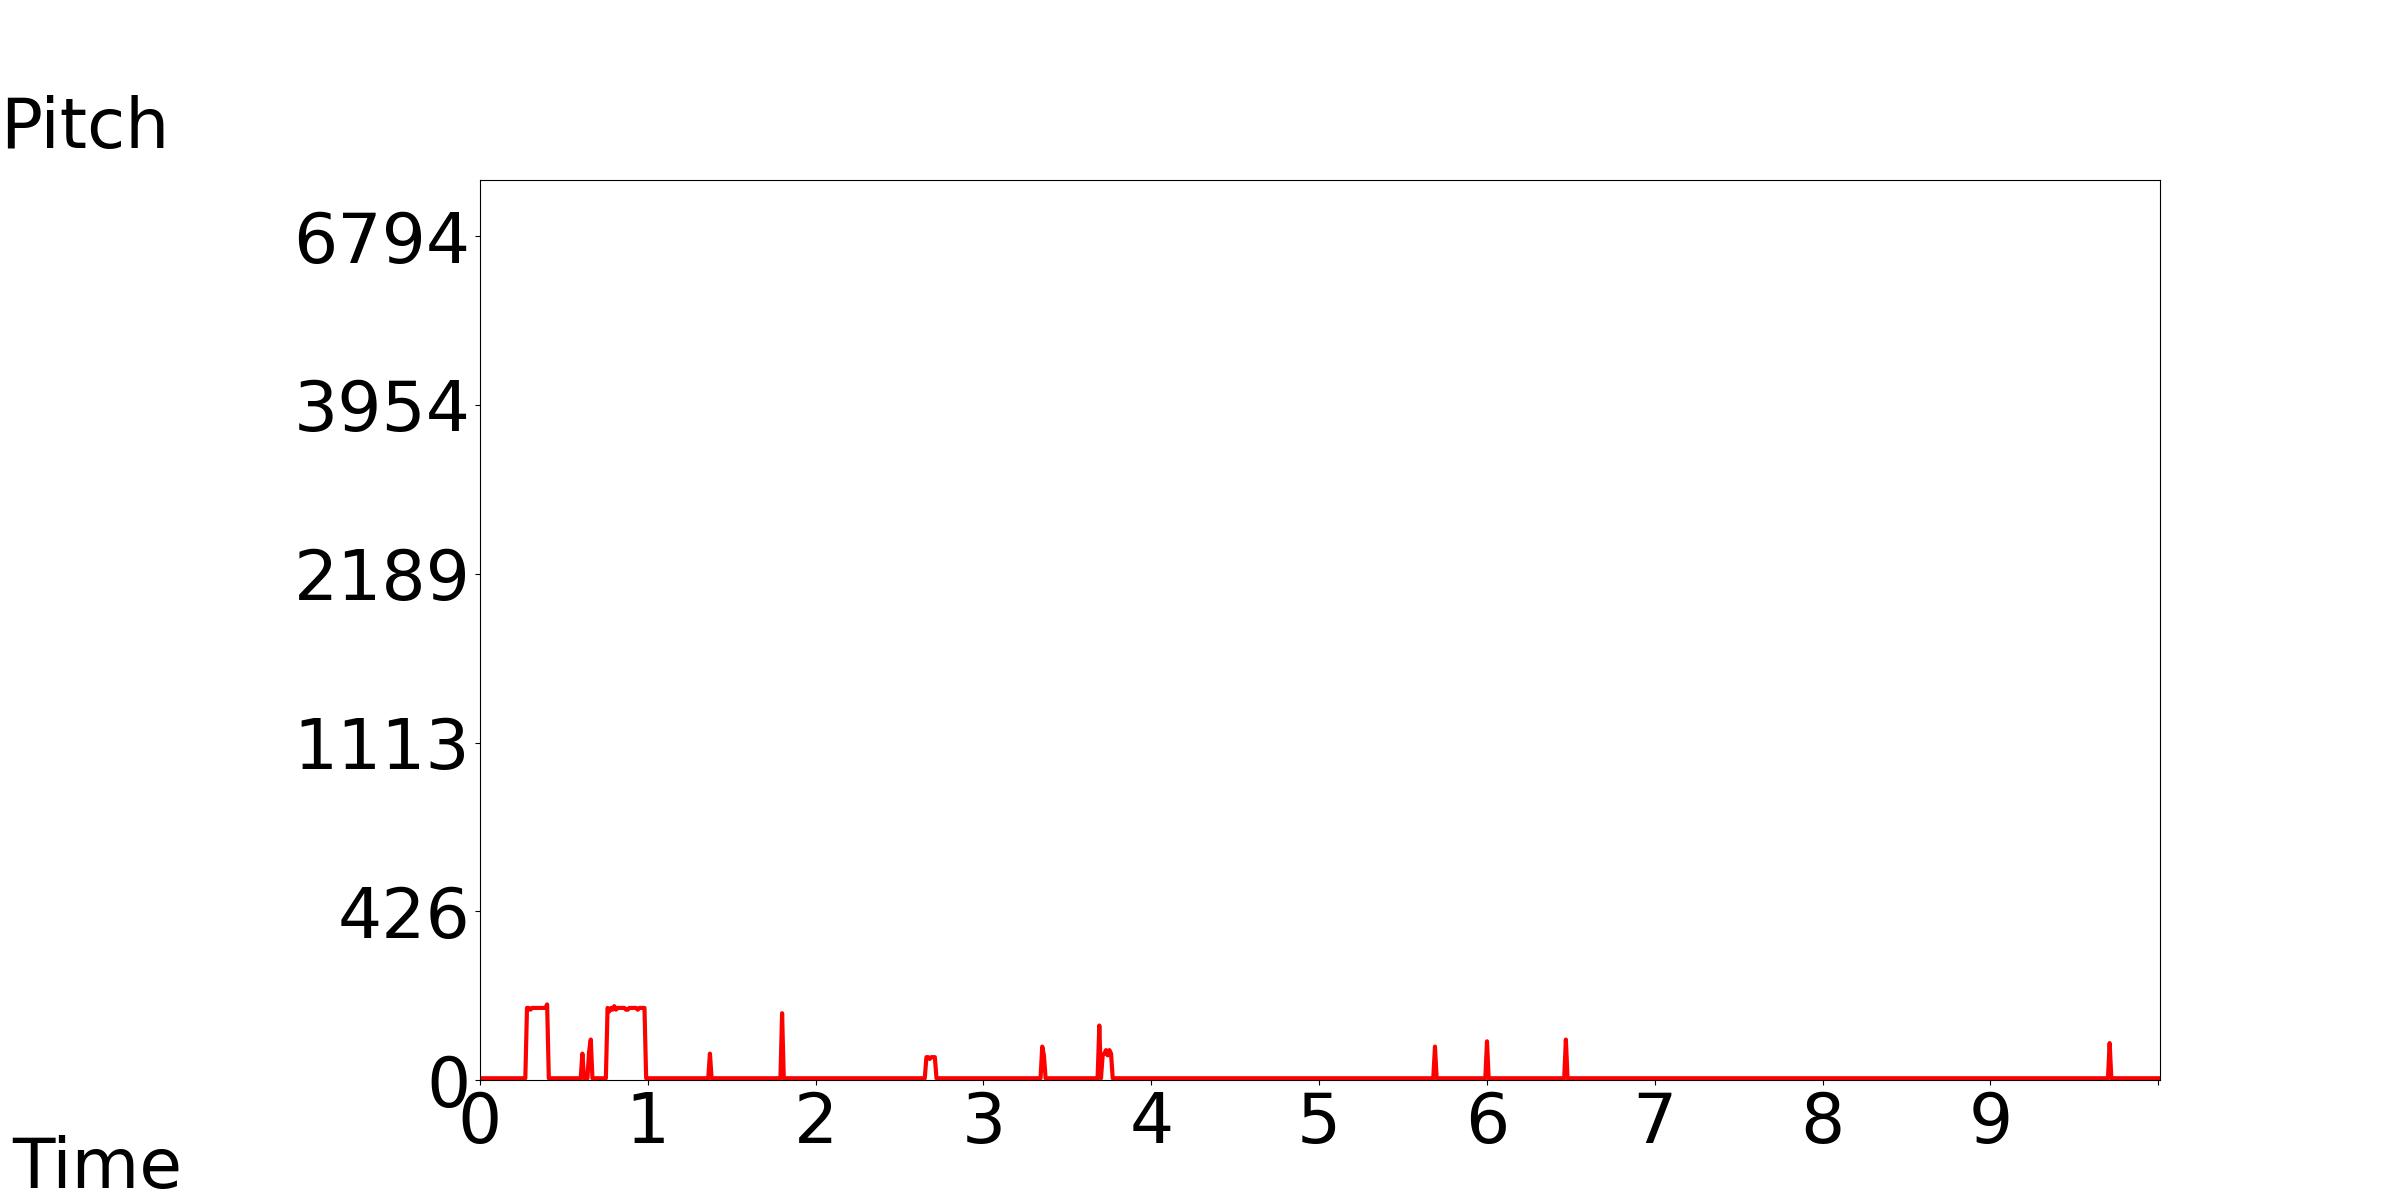
Audio Generation with Multiple Conditional Diffusion Model - Speech ...
Advertisement Space (336x280)
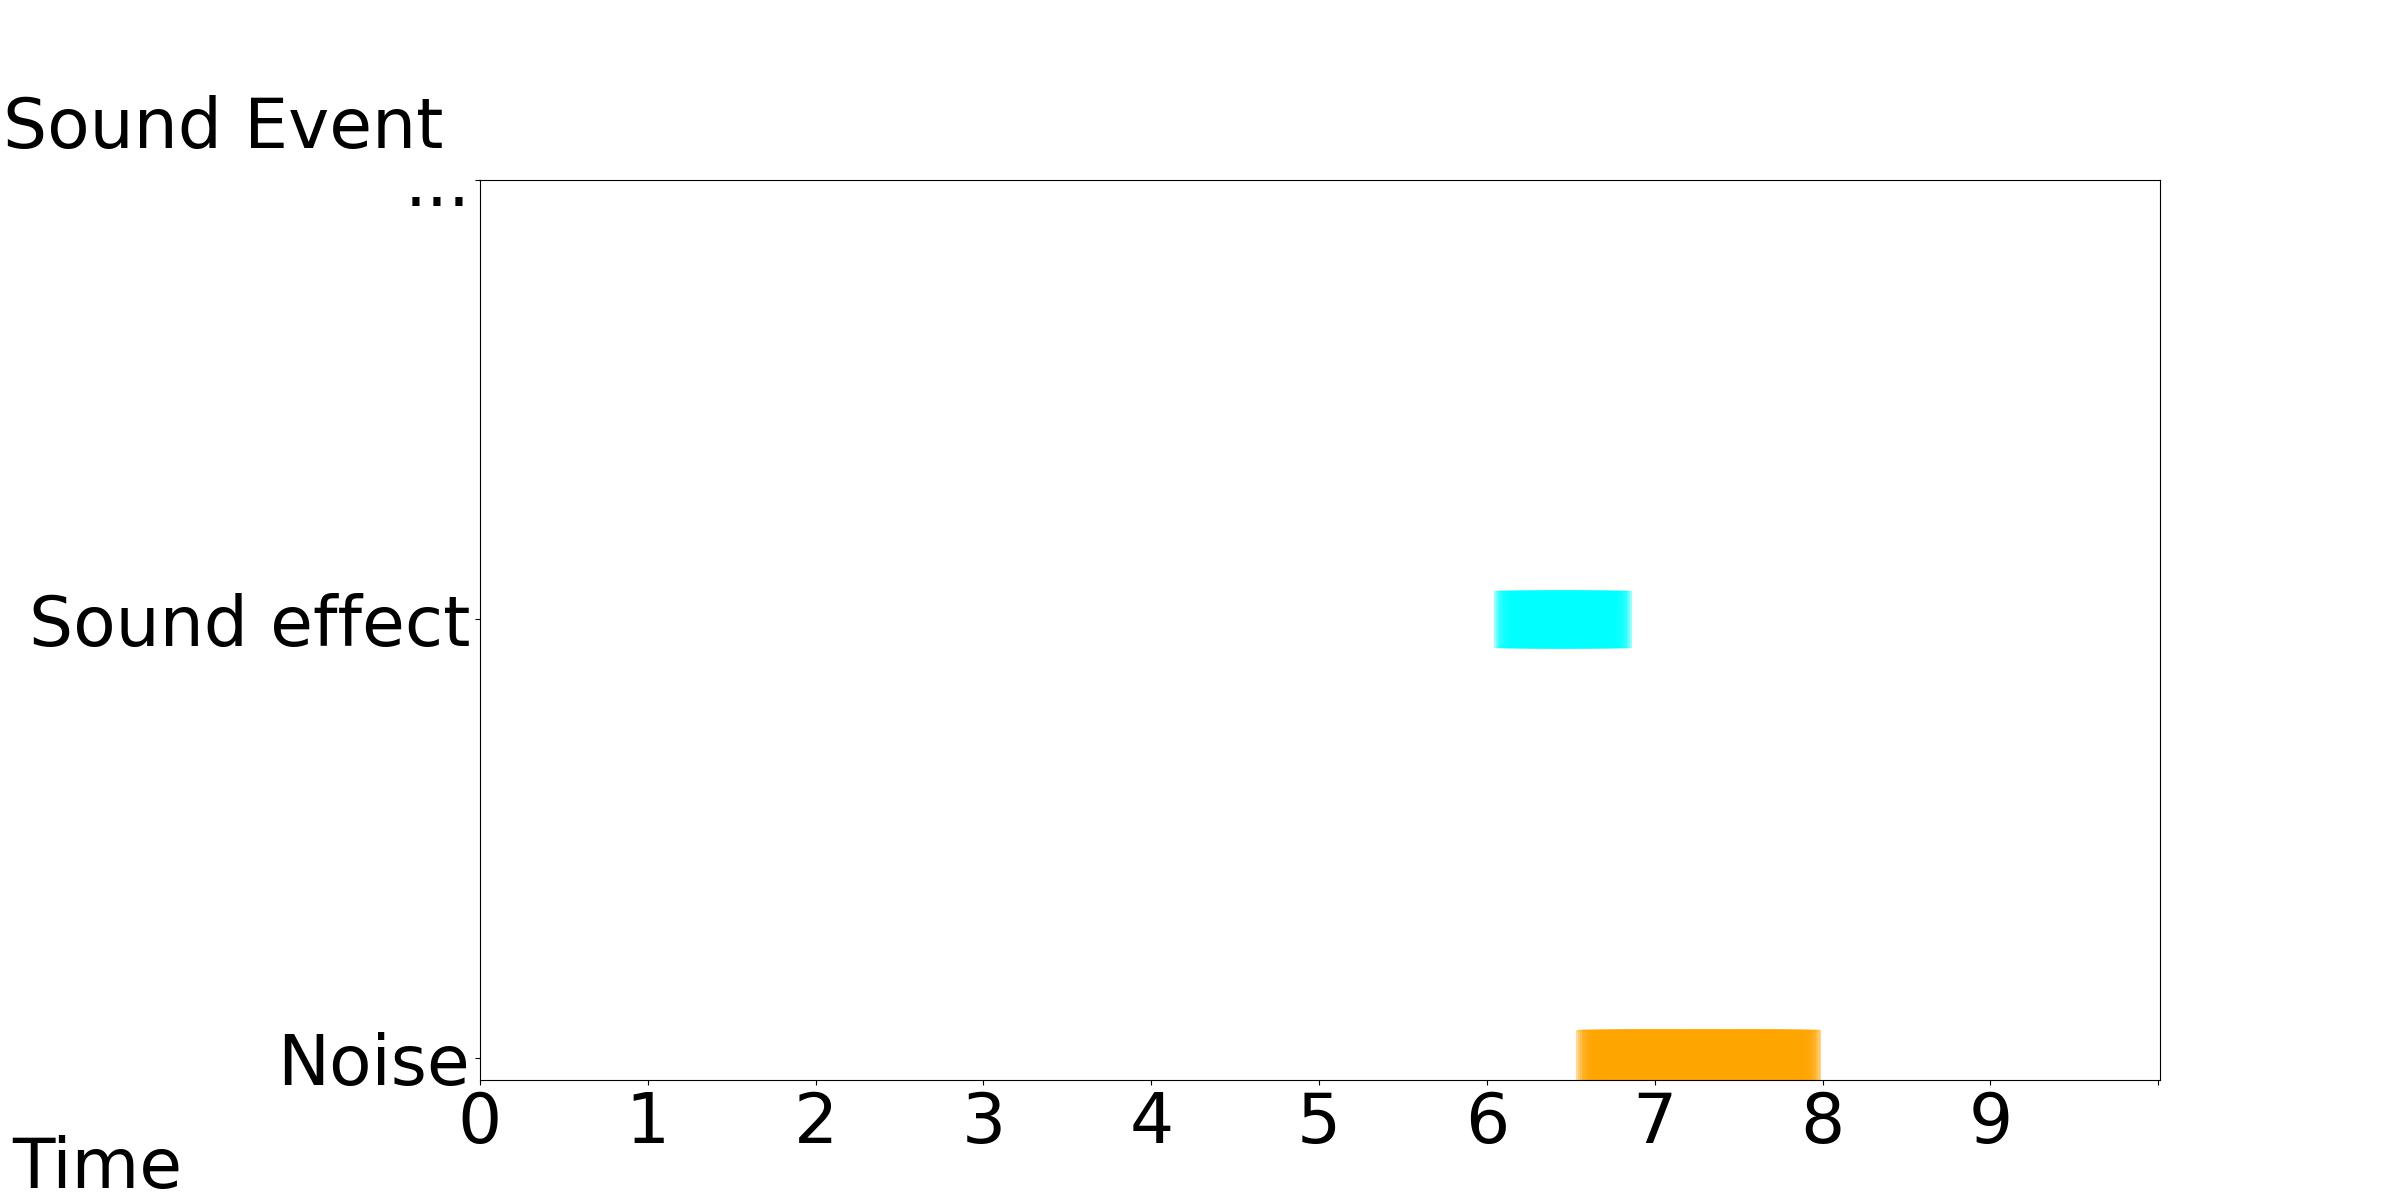
Audio Generation with Multiple Conditional Diffusion Model - Speech ...
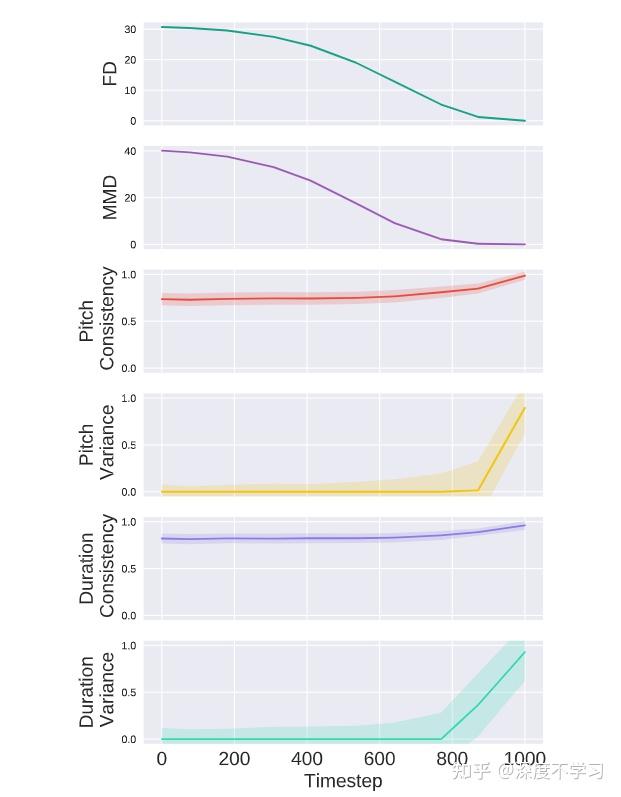
Symbolic Music Generation with Diffusion Models - 知乎
Audio Generation with Multiple Conditional Diffusion Model - Speech ...
Audio Generation with Multiple Conditional Diffusion Model - Speech ...
Audio Generation with Multiple Conditional Diffusion Model - Speech ...
Audio Generation with Multiple Conditional Diffusion Model - Speech ...

A Technical Guide to Diffusion Models for Audio Generation | audio ...

Meet AudioLDM: A Latent Diffusion Model For Audio Generation That ...
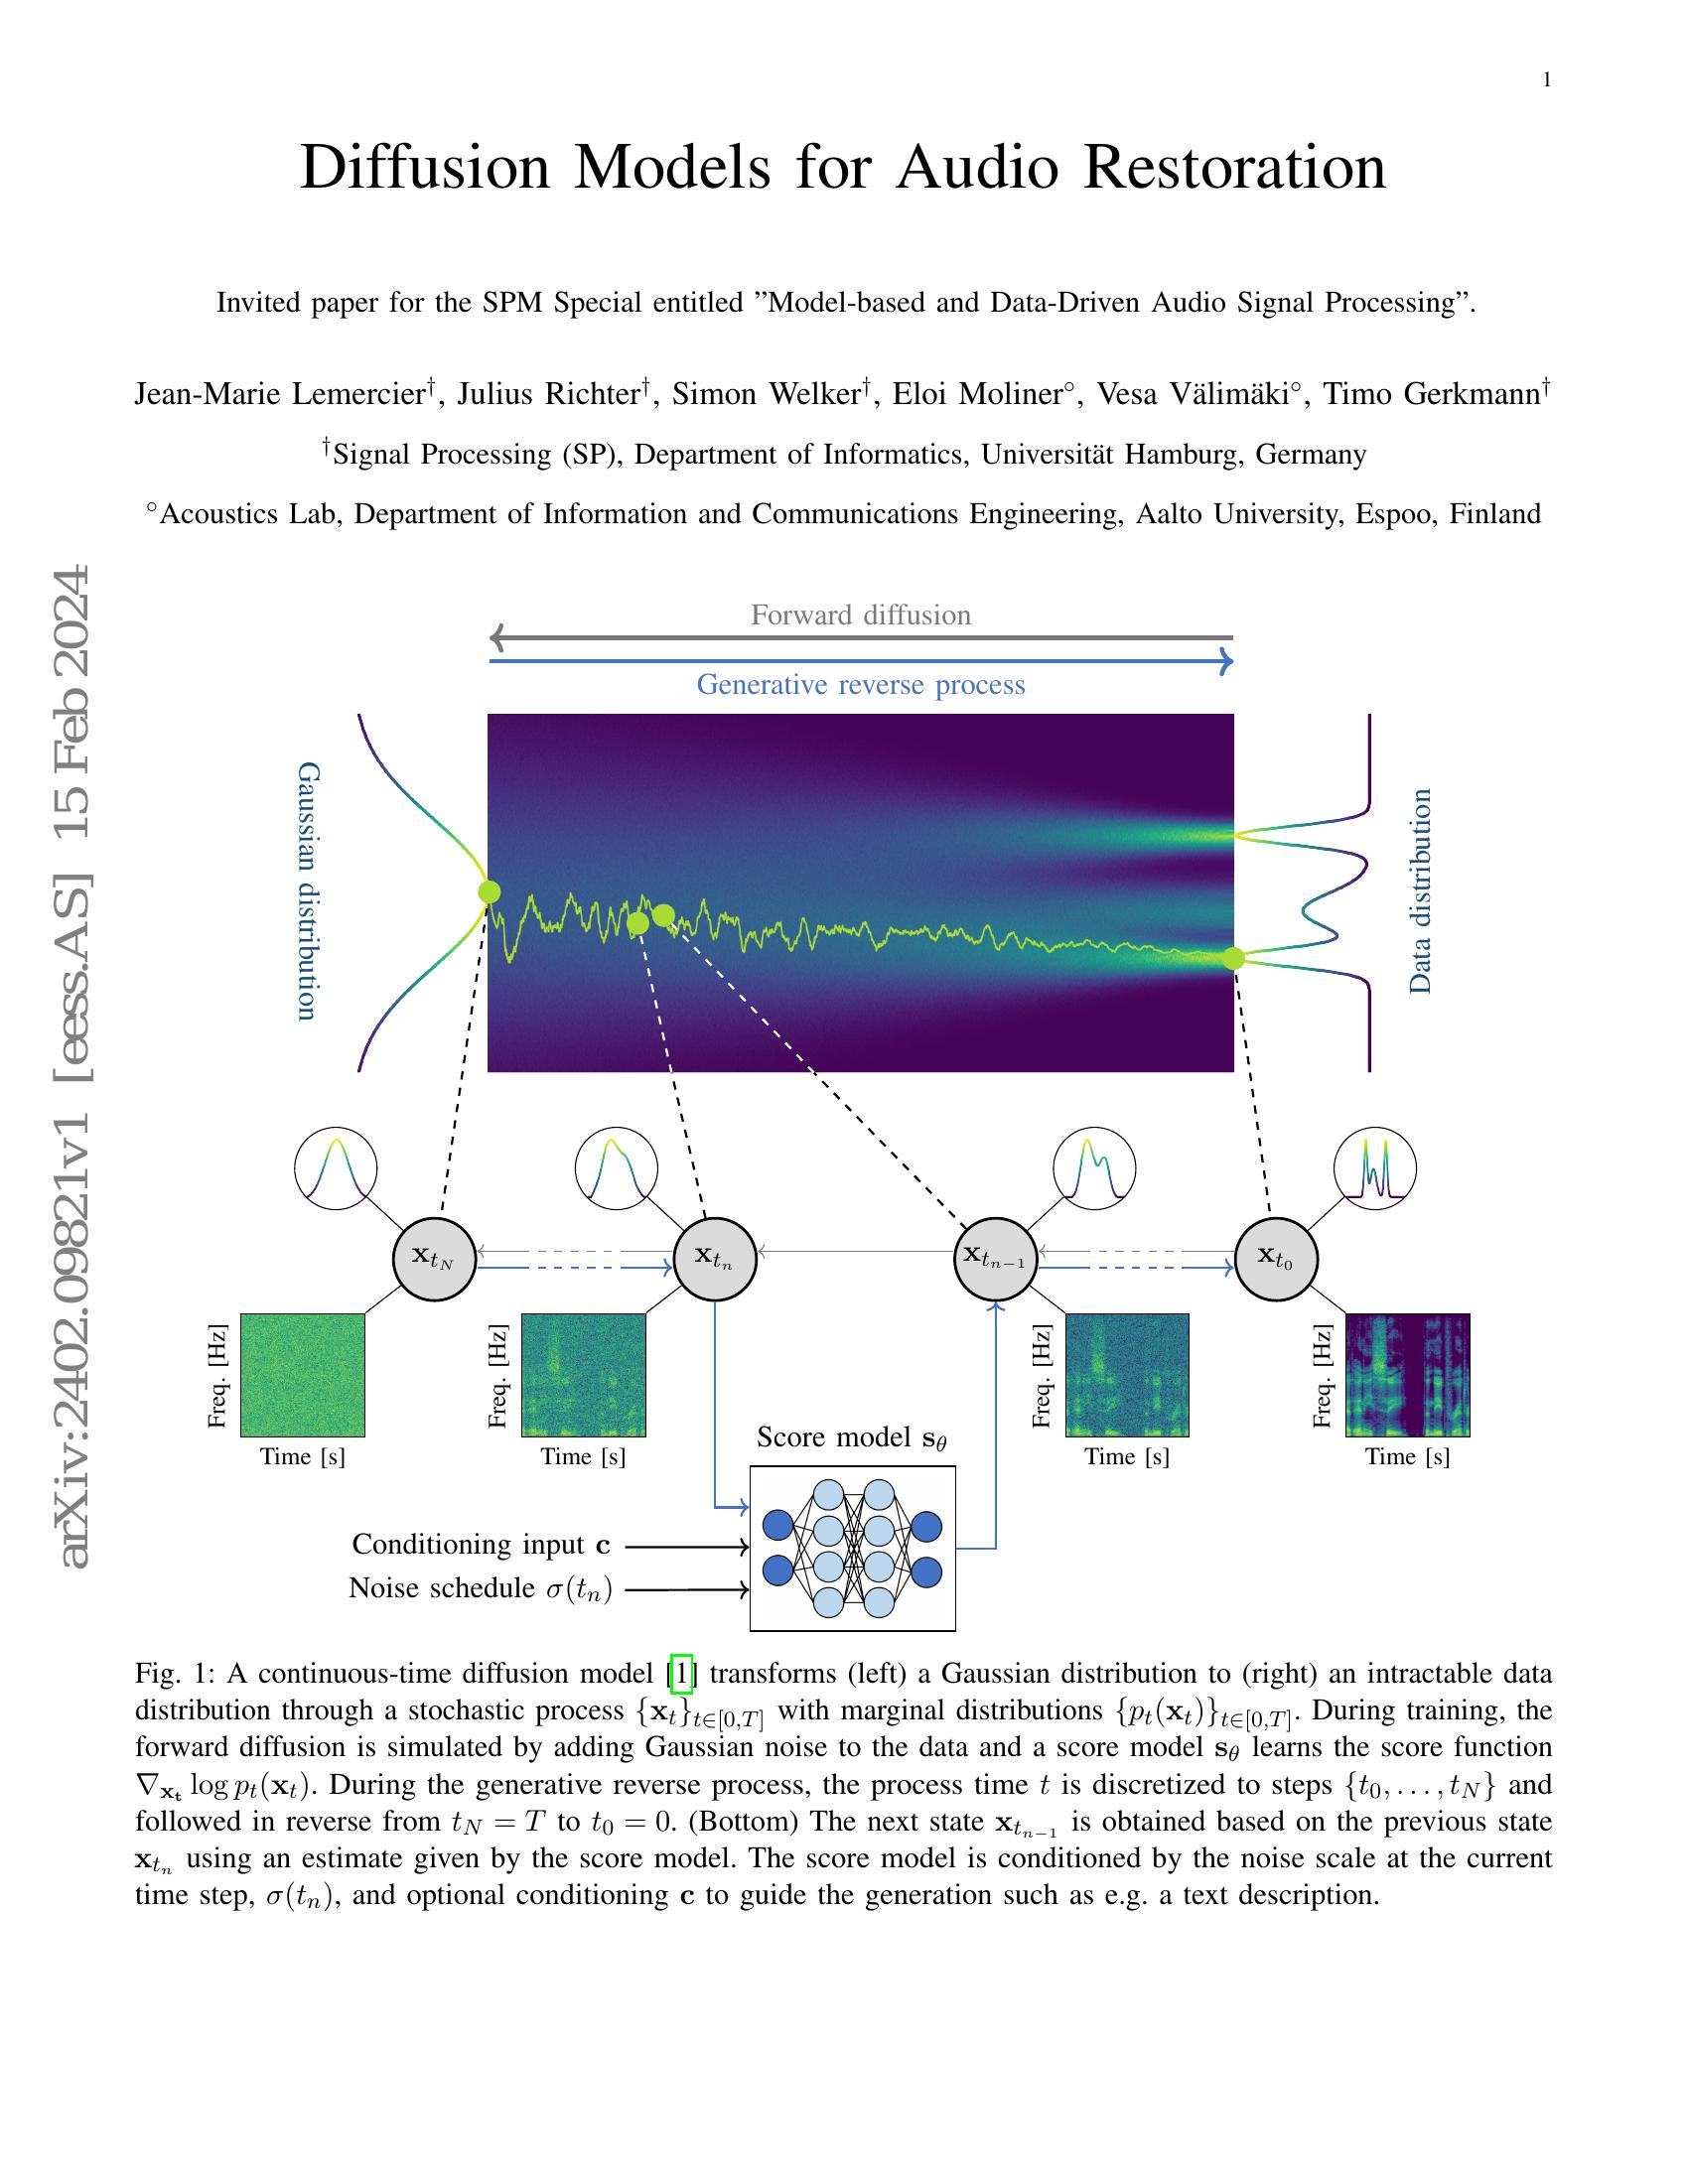
Diffusion Models for Audio Restoration - 智源社区论文

[论文评述] Diff-SAGe: End-to-End Spatial Audio Generation Using Diffusion ...
Advertisement Space (336x280)
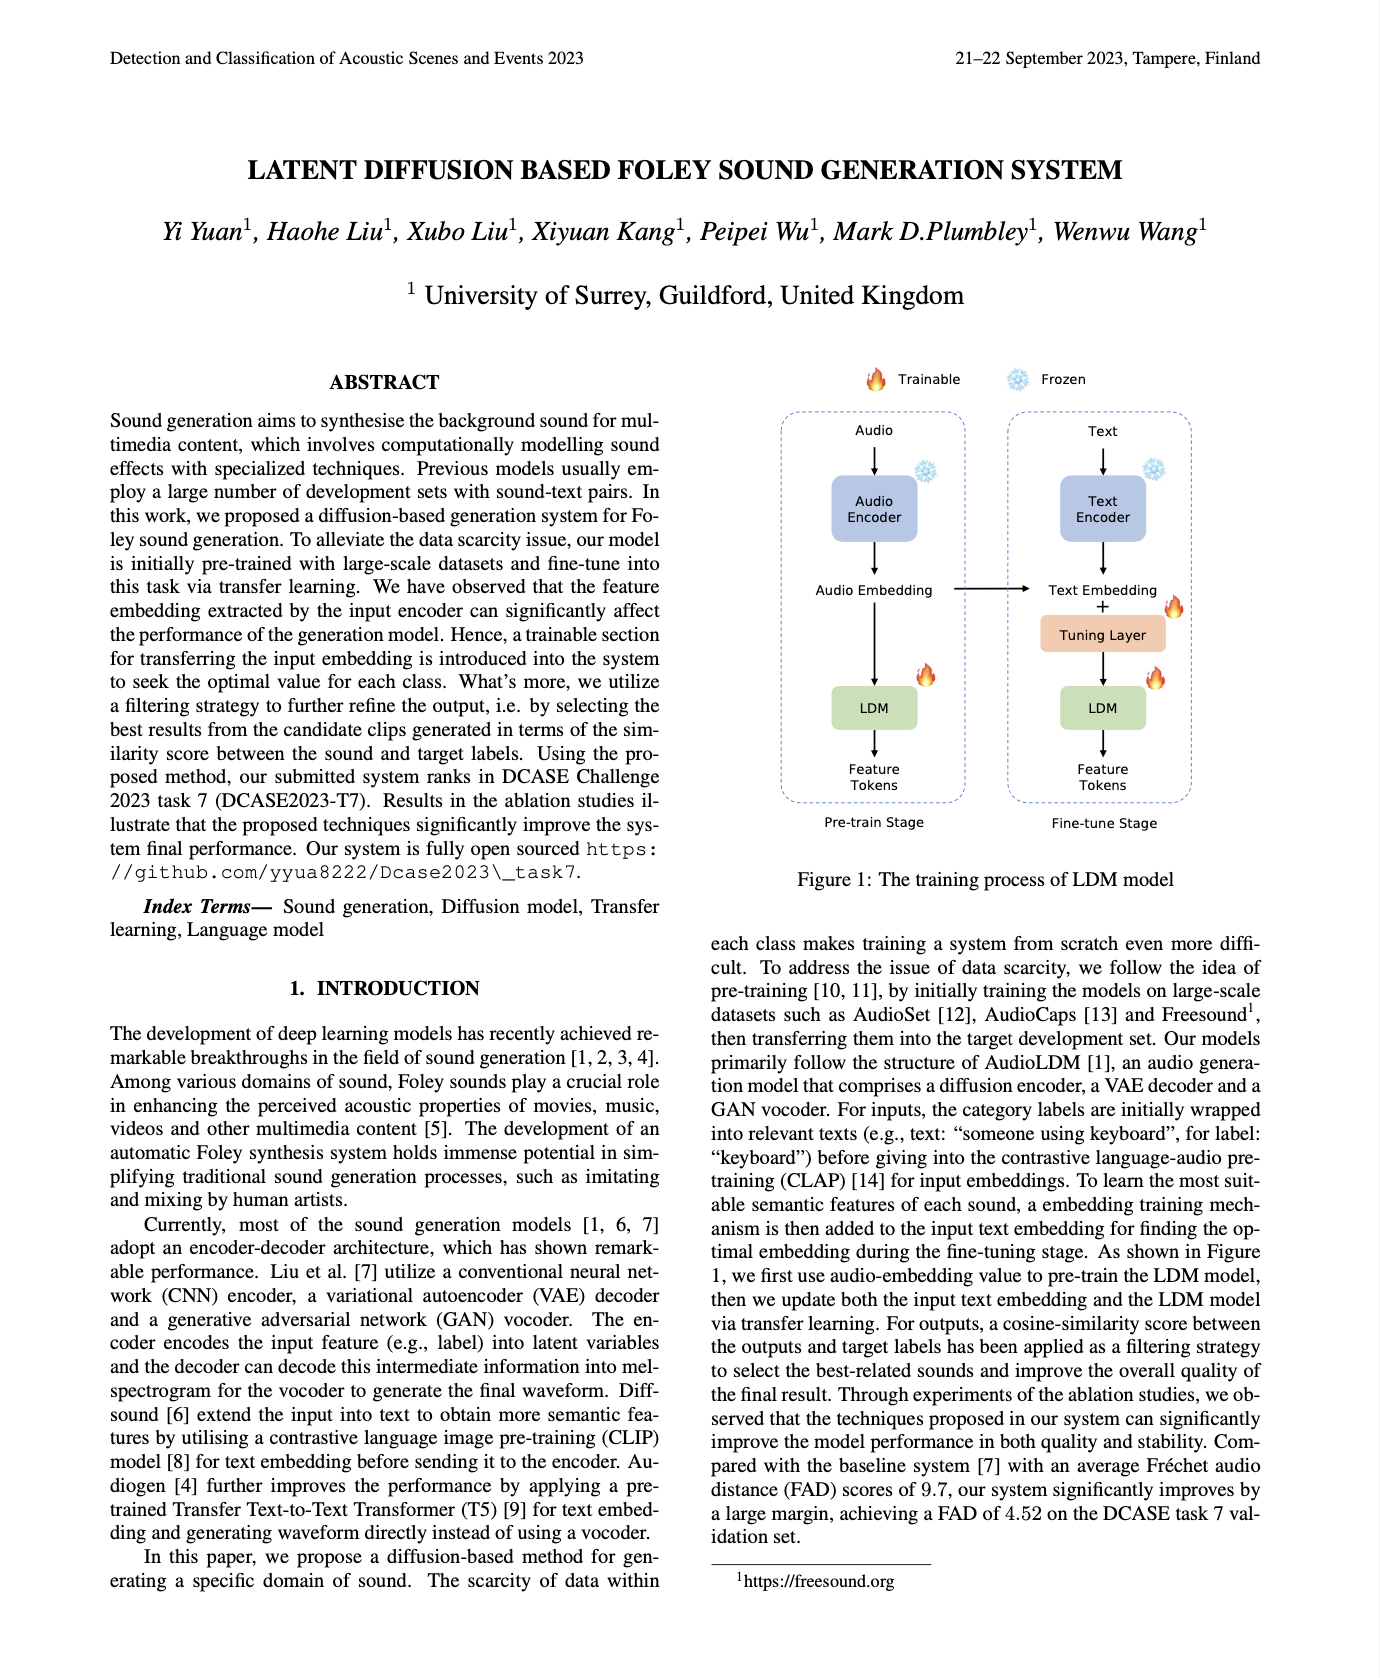
Text-driven Foley Sound Generation With Latent Diffusion Model
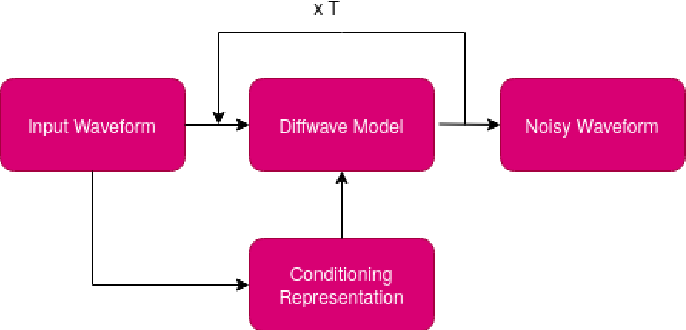
Figure 1 from Feature Conditioned Diffusion for Audio Generation ...

Network Bending of Diffusion Models for Audio-Visual Generation | AI ...
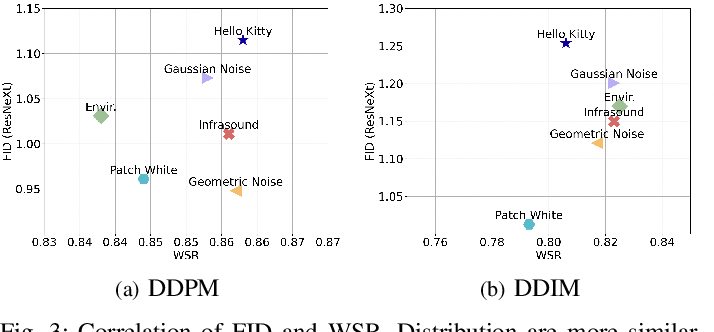
Figure 3 from Invisible Watermarking for Audio Generation Diffusion ...
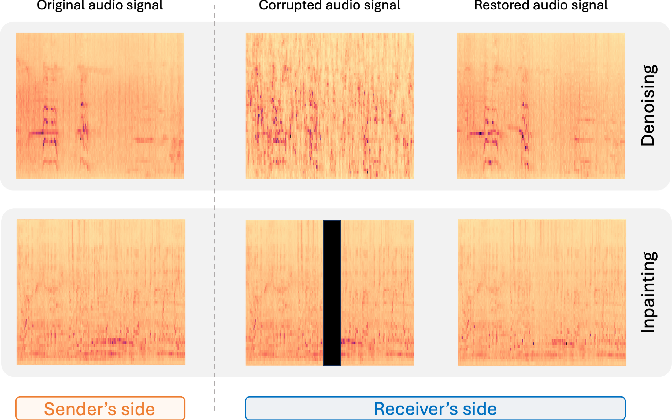
Figure 1 from Diffusion Models for Audio Semantic Communication ...

[2303.13336 ] A Survey on Audio Diffusion Models Text To Speech ...