
Autoregressive Diffusion Transformer For Text To Speech Synthesis

[논문 리뷰] Autoregressive Diffusion Transformer for Text-to-Speech Synthesis

Autoregressive Diffusion Transformer for Text-to-Speech Synthesis | AI ...

Review DiTAR: Diffusion Transformer Autoregressive Modeling for Speech ...

DiTAR: Diffusion Transformer Autoregressive Modeling for Speech ...

(PDF) DiTAR: Diffusion Transformer Autoregressive Modeling for Speech ...

Paper page - Autoregressive Diffusion Transformer for Text-to-Speech ...

Paper page - DiTAR: Diffusion Transformer Autoregressive Modeling for ...
[2204.11806] Parallel Synthesis for Autoregressive Speech Generation

[2303.13336 ] A Survey on Audio Diffusion Models Text To Speech ...
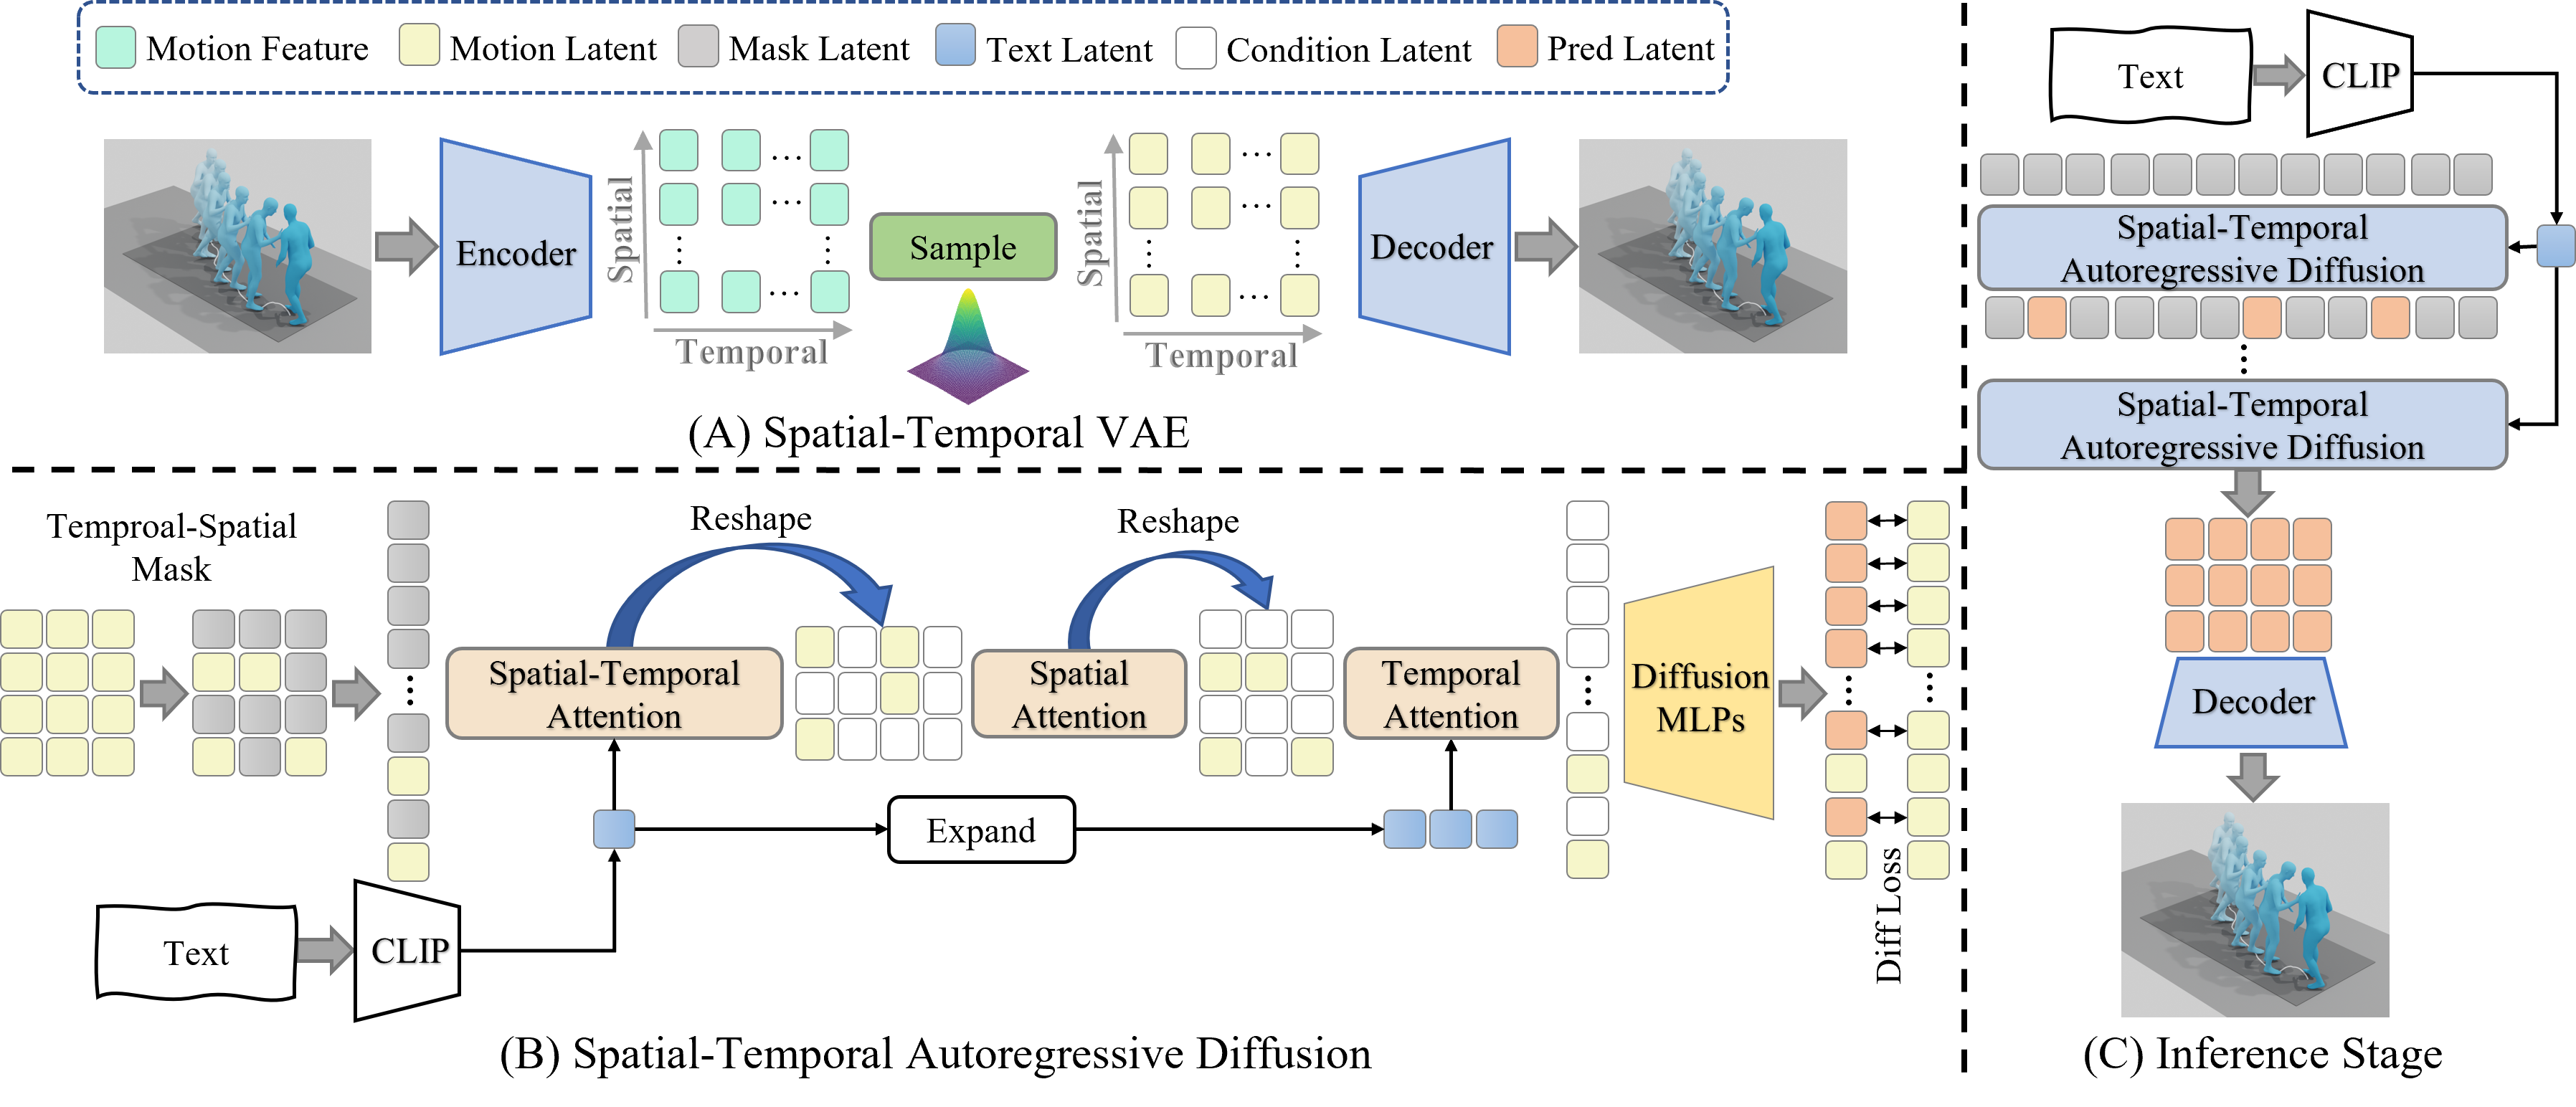
Spatiotemporally Decoupled Autoregressive Diffusion Model for Text ...
Advertisement Space (300x250)

Direct Preference Optimization for Speech Autoregressive Diffusion ...

Figure 1 from Autoregressive Speech Synthesis with Next-Distribution ...

U-Diffusion Vision Transformer for Text-to-Speech - Speech Research

Sample-Efficient Diffusion for Text-To-Speech Synthesis | AI Research ...

VoiceDiT: Dual-Condition Diffusion Transformer for Environment-Aware ...

Paper page - Marrying Autoregressive Transformer and Diffusion with ...

[Literature Review] Accelerating Autoregressive Speech Synthesis ...

[论文评述] MADFormer: Mixed Autoregressive and Diffusion Transformers for ...

Diffusion vs. Autoregressive Language Models: A Text Embedding ...

Diff-TTS: Efficient TTS via Diffusion | PDF | Speech Synthesis ...
Advertisement Space (336x280)
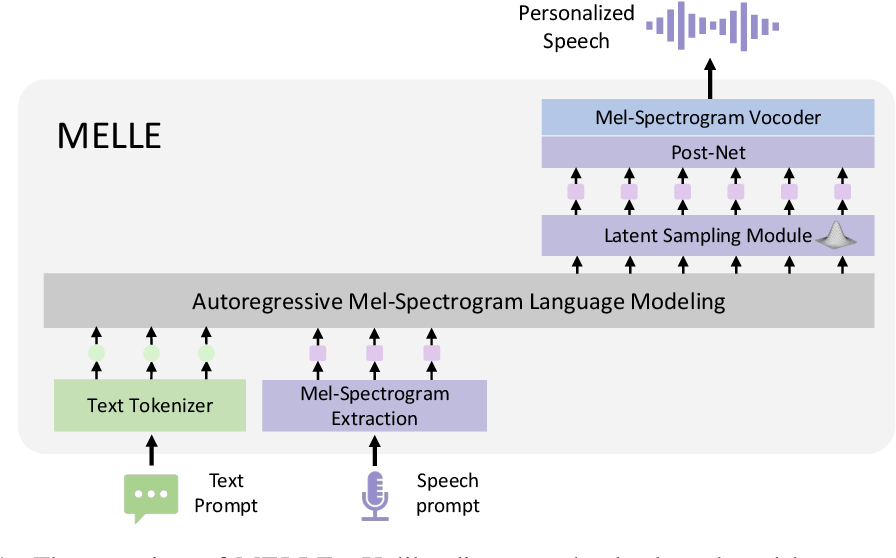
Figure 1 from Autoregressive Speech Synthesis without Vector ...

DiTAR Diffusion Transformer Autoregressive Modeling | PDF | Algorithms ...

[논문 리뷰] Diffusion vs. Autoregressive Language Models: A Text Embedding ...

Sparse Alignment Enhanced Latent Diffusion Transformer for Zero-Shot ...
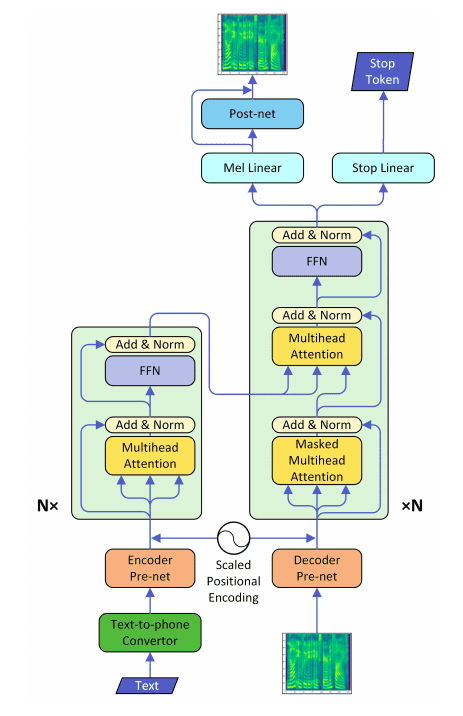
Speech synthesis: A review of the best text to speech architectures ...

Sample-Efficient Diffusion for Text-To-Speech Synthesis
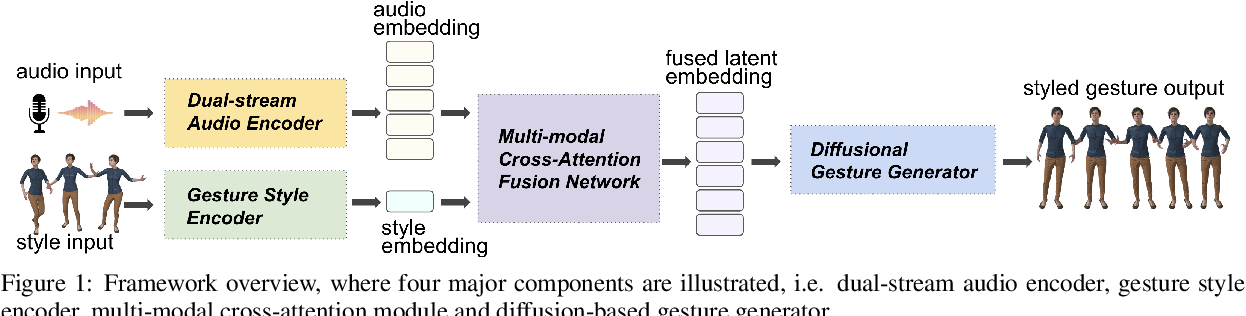
Figure 1 from Diffusion Transformer Framework for Speech-Driven ...
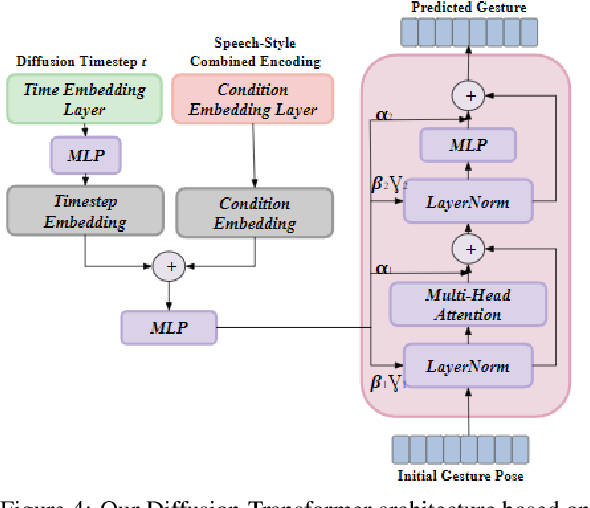
Figure 4 from Diffusion Transformer Framework for Speech-Driven ...
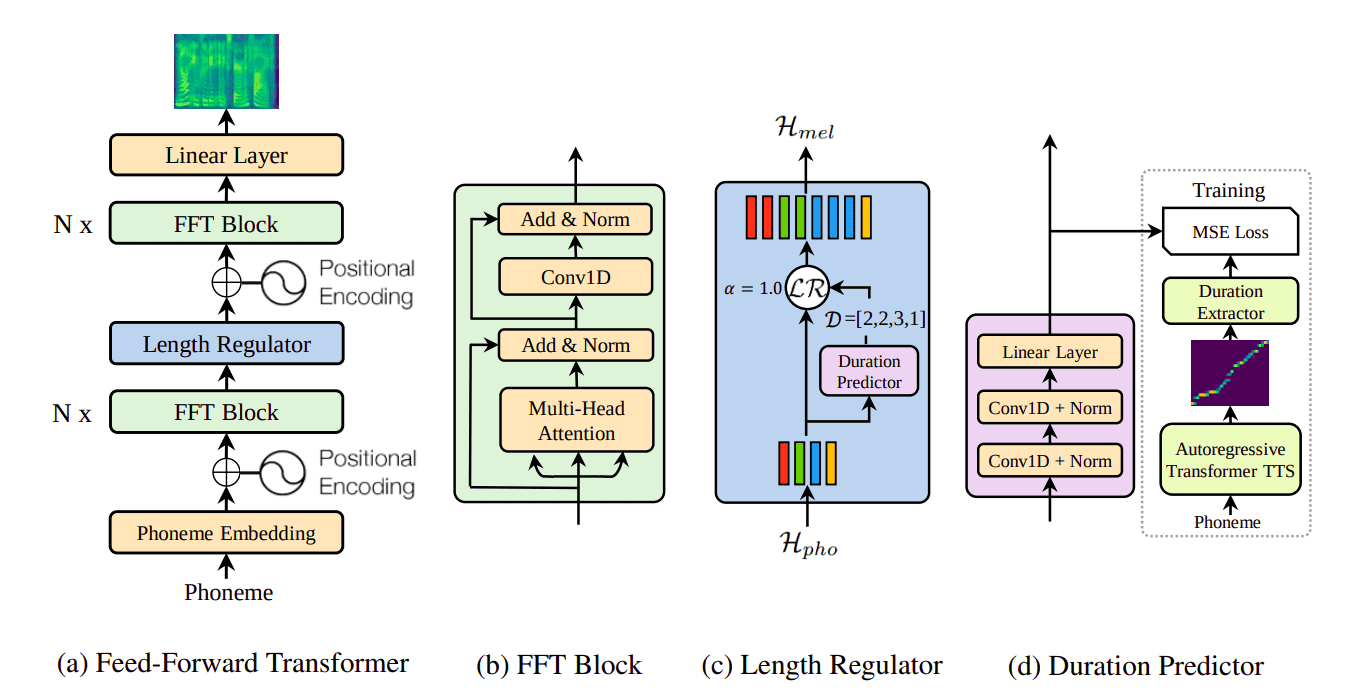
Speech synthesis: A review of the best text to speech architectures ...

DART: Denoising Autoregressive Transformer for Scalable Text-to-Image ...
Advertisement Space (336x280)

Auto-Regressive Diffusion Models for Text Generation: A Deep Dive | by ...

A REVIEW ON Latent Diffusion Models for High-Resolution Image Synthesis ...

[논문 리뷰] DiSTAR: Diffusion over a Scalable Token Autoregressive ...

ViT-TTS: Visual Text-to-Speech with Scalable Diffusion Transformer
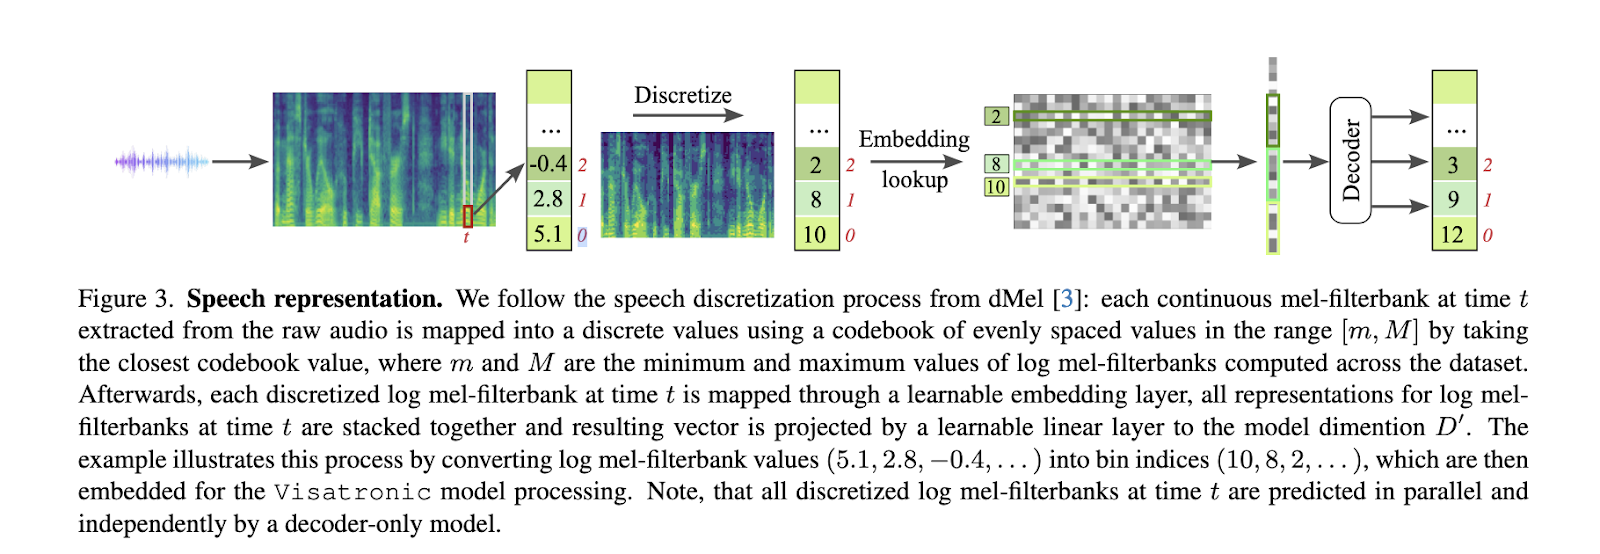
Visatronic: A Unified Multimodal Transformer for Video-Text-to-Speech ...

MixDiff-TTS: Mixture Alignment and Diffusion Model for Text-to-Speech