
Benchmarking Large Language Models With Integer Sequence Generation

Benchmarking Large Language Models with Integer Sequence Generation ...

[PDF] Benchmarking Large Language Models with Integer Sequence ...
Benchmarking Large Language Models with a Unified Performance Ranking ...
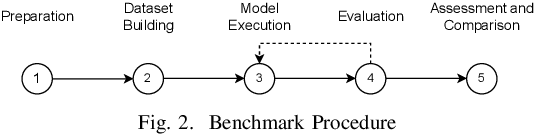
Figure 2 from Benchmarking Large Language Models for Code Generation ...
Benchmarking Large Language Models with a Unified Performance Ranking ...
Benchmarking Large Language Models on Controllable Generation under ...
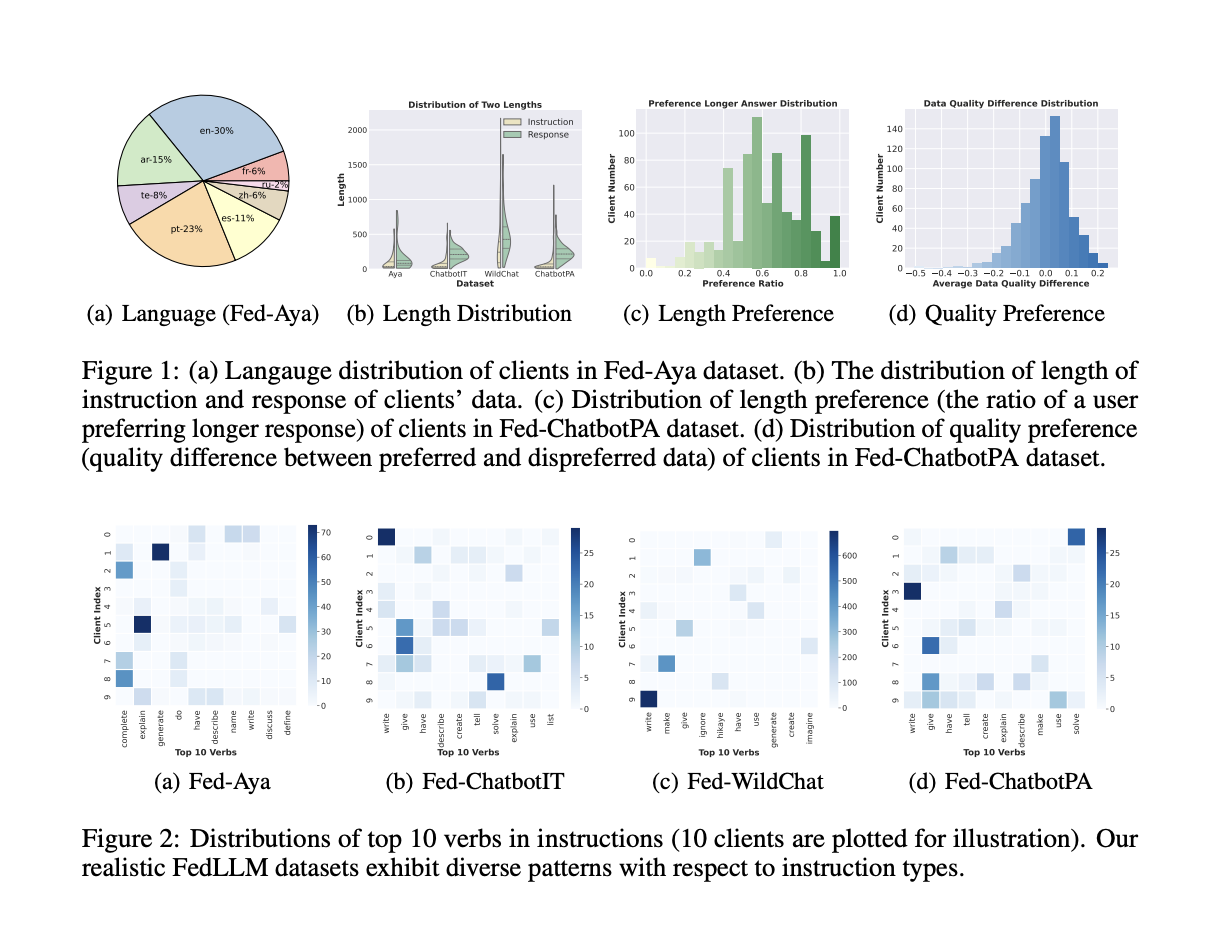
Benchmarking Federated Learning for Large Language Models with FedLLM ...

IdeaBench: Benchmarking Large Language Models for Research Idea Generation

STOP! Benchmarking Large Language Models with Sensitivity Testing on ...
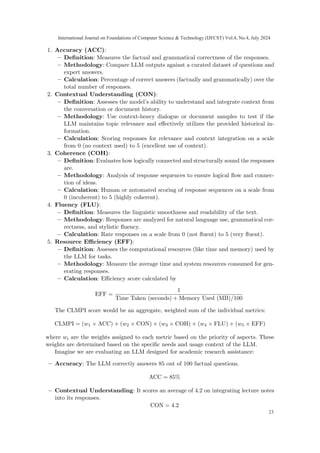
Benchmarking Large Language Models with a Unified Performance Ranking ...
Advertisement Space (300x250)
Benchmarking Large Language Models in Retrieval-Augmented Generation ...
Benchmarking Large Language Models in Retrieval-Augmented Generation ...
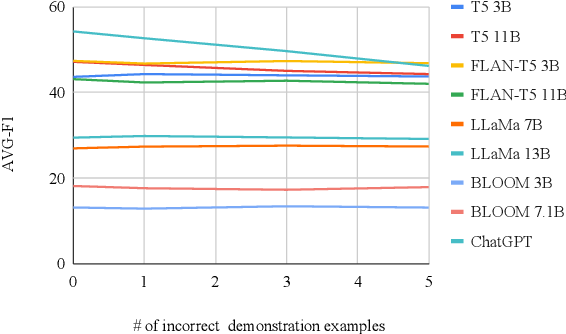
Figure 6 from Benchmarking Large Language Models with Augmented ...

Benchmarking Large Language Models on Controllable Generation under ...

Figure 1 from Risk Aware Benchmarking of Large Language Models ...

Can Large Language Models Keep Up? Benchmarking Online Adaptation to ...

Benchmarking Large Language Models for Math Reasoning Tasks | AI ...

(PDF) Benchmarking Large Language Models for Data Pipeline Code ...

IdeaBench: Benchmarking Large Language Models for Research Idea ...
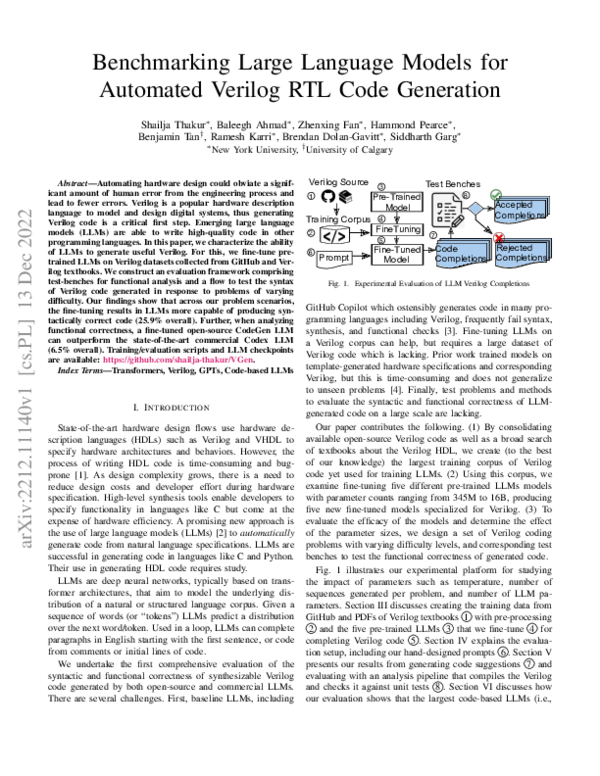
(PDF) Benchmarking Large Language Models for Automated Verilog RTL Code ...
Advertisement Space (336x280)

(PDF) Benchmarking 24 Large Language Models for Automated Multiple ...

ProBench: Benchmarking Large Language Models in Competitive Programming ...
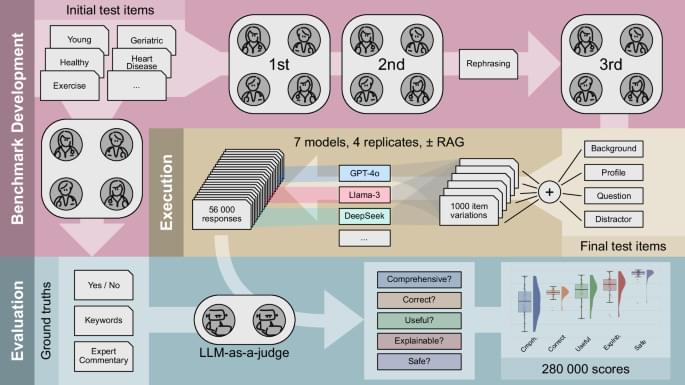
Benchmarking large language models for personalized, biomarker-based ...

[논문 리뷰] MELABenchv1: Benchmarking Large Language Models against Smaller ...

(PDF) Benchmarking Evidence-Augmented Large Language Models for Fact ...
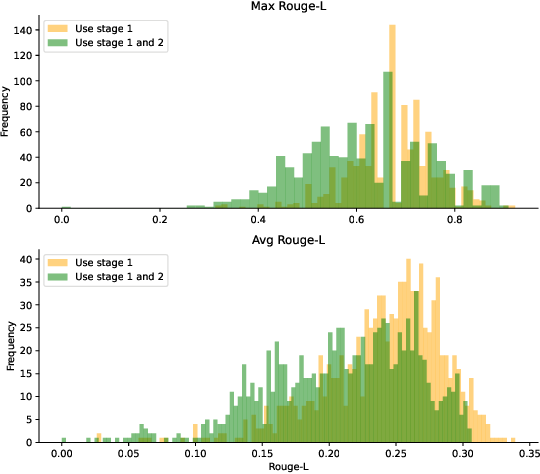
Figure 10 from Benchmarking Large Language Models on Controllable ...

Figure 6 from Benchmarking Large Language Models for Automated Verilog ...

(PDF) Benchmarking Causal Study to Interpret Large Language Models for ...
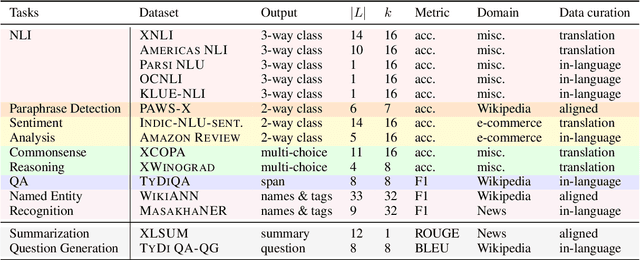
BUFFET: Benchmarking Large Language Models for Few-shot Cross-lingual ...

Benchmarking DNA large language models on quadruplexes - Computational ...
Advertisement Space (336x280)

Paper page - Benchmarking Benchmark Leakage in Large Language Models

Paper page - Benchmarking Large Language Models in Retrieval-Augmented ...

Paper page - IndicMMLU-Pro: Benchmarking Indic Large Language Models on ...

(PDF) Benchmarking Large Language Models for Replication of Guideline ...

Table 1 from BUFFET: Benchmarking Large Language Models for Few-shot ...

Paper page - Measuring and Benchmarking Large Language Models ...