
Benchmarking Visual State Tracking In Multimodal Video Understanding

Benchmarking Visual State Tracking in Multimodal Video Understanding ...

Benchmarking Visual State Tracking in Multimodal Video Understanding ...
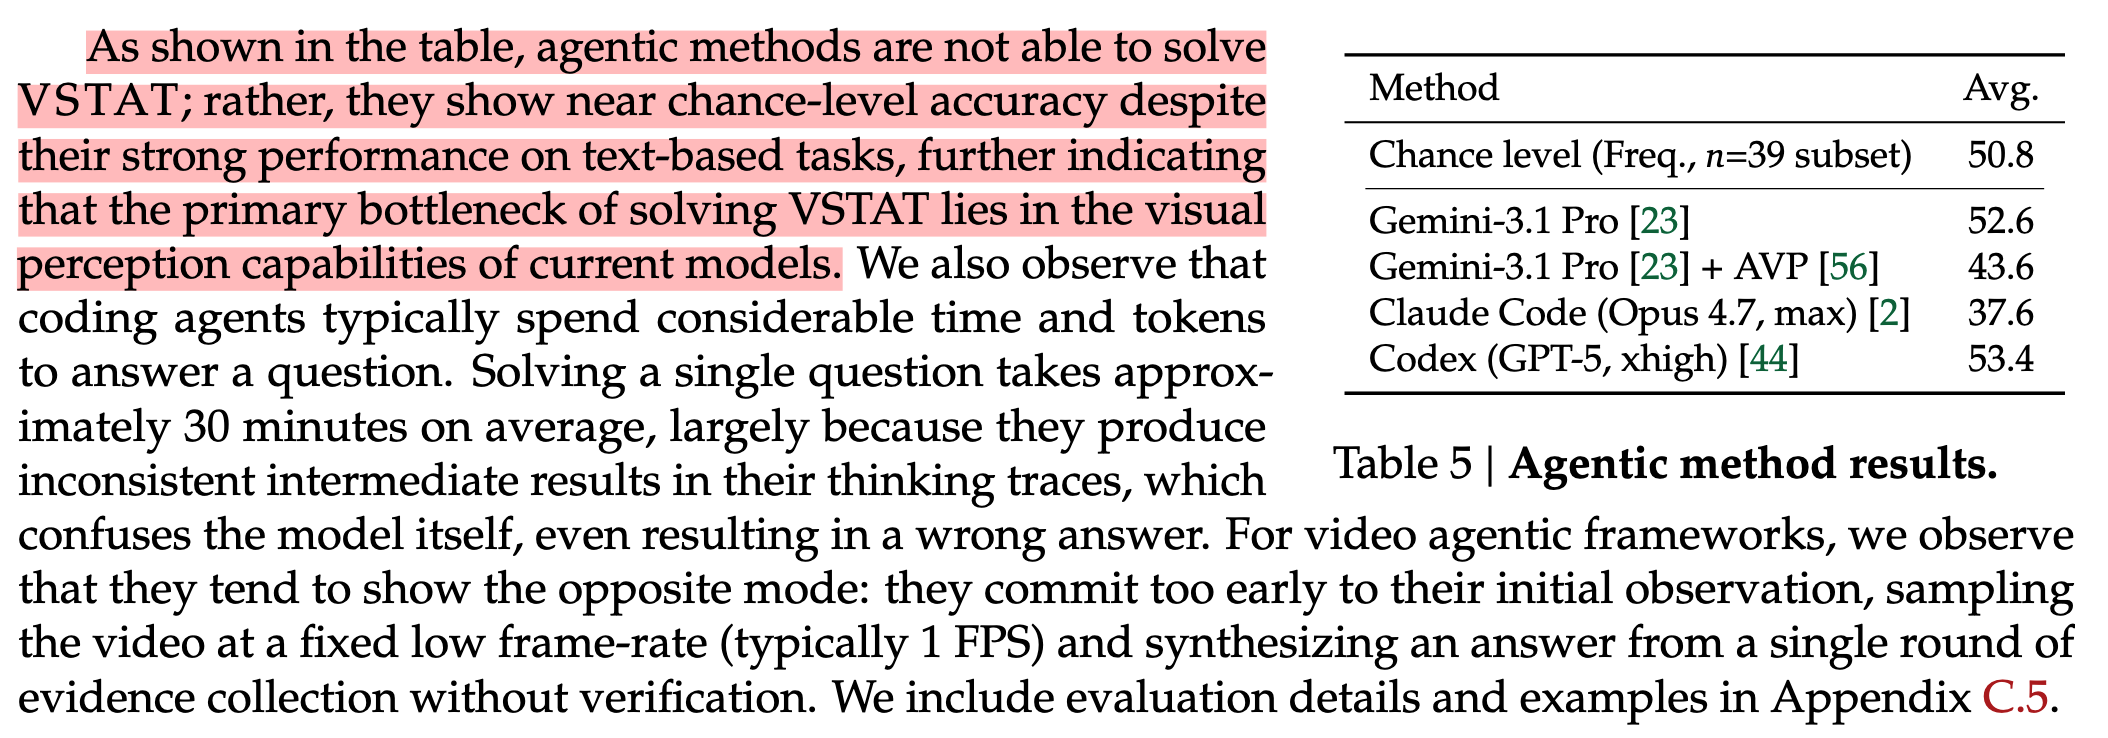
论文阅读笔记:VSTAT: Benchmarking Visual State Tracking in Multimodal Video ...

VisFactor: Benchmarking Fundamental Visual Cognition in Multimodal ...

Figure 2 from Multimodal Dialogue State Tracking | Semantic Scholar

Towards General Multimodal Visual Tracking | AI Research Paper Details

NeurIPS MFCL Vision: Benchmarking Tool Use in Multimodal Large Language ...

[论文评述] LogicVista: Multimodal LLM Logical Reasoning Benchmark in Visual ...

Benchmarking Multimodal Mathematical Reasoning with Explicit Visual ...

(PDF) Towards General Multimodal Visual Tracking
Advertisement Space (300x250)

Lightweight Multimodal Adapter for Visual Object Tracking

Figure 1 from Scaling the Long Video Understanding of Multimodal Large ...

Benchmarking Multimodal Mathematical Reasoning with Explicit Visual ...
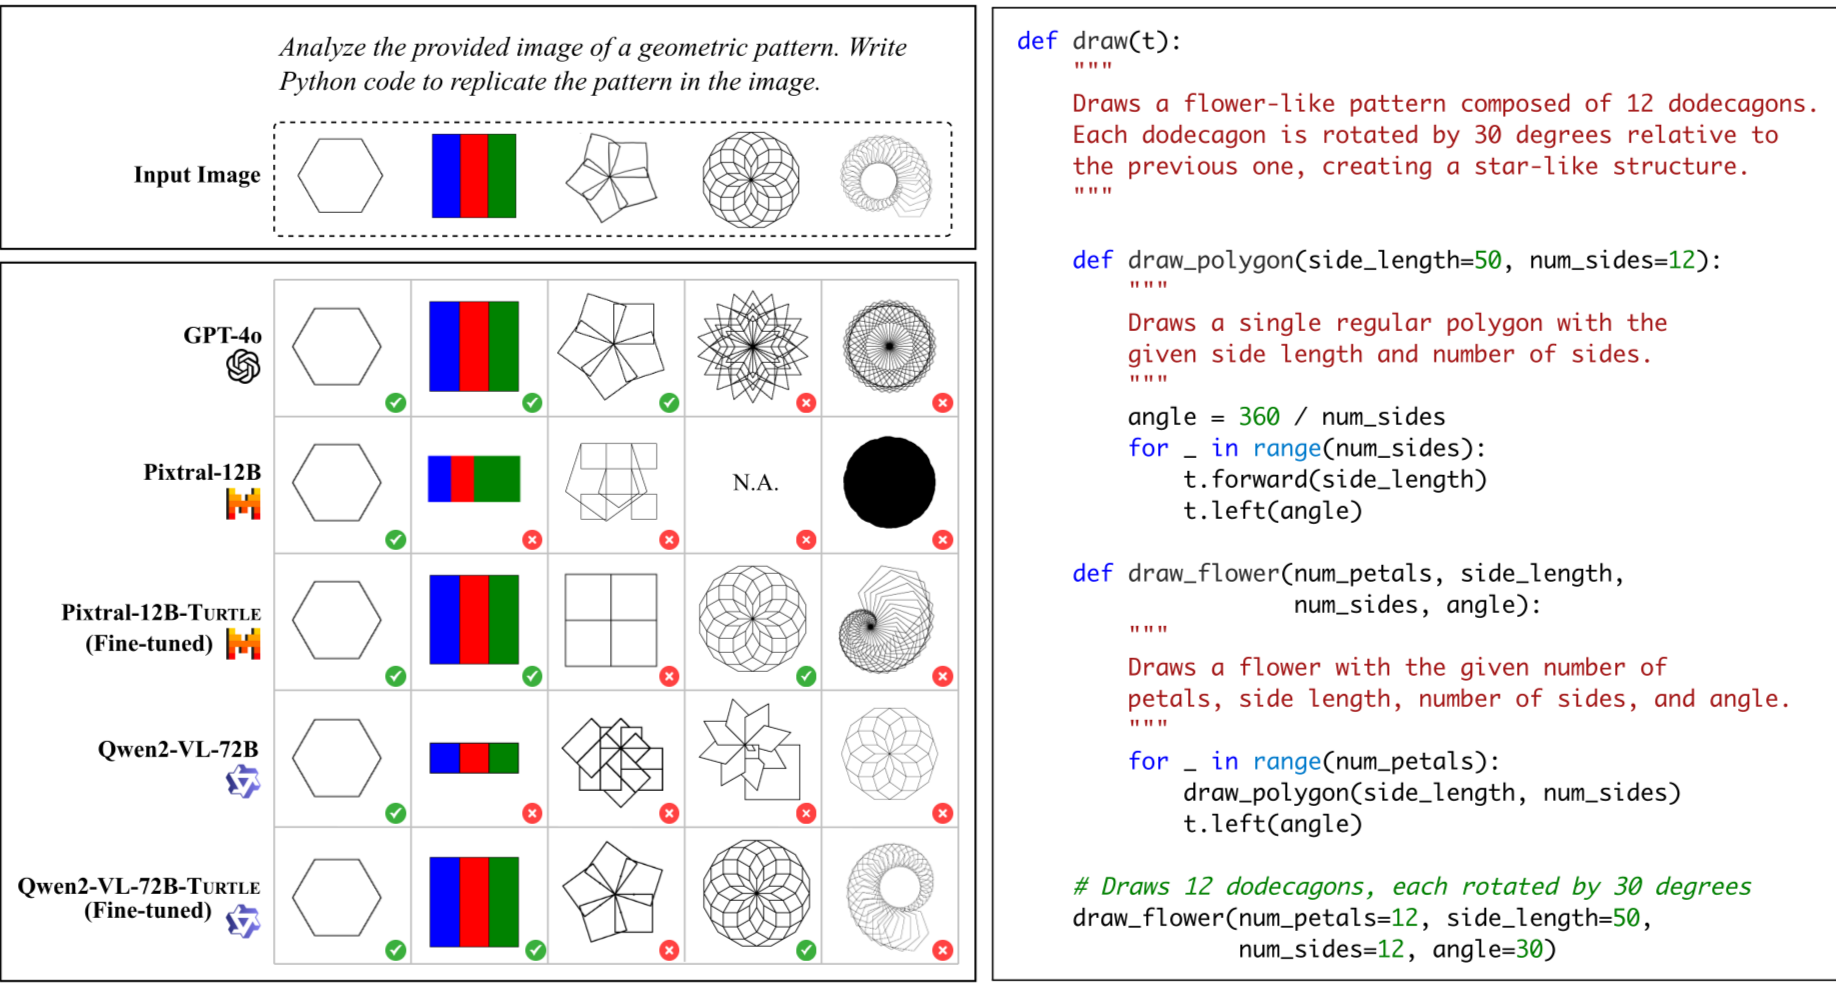
[논문 리뷰] TurtleAI: Benchmarking Multimodal Models for Visual Programming ...

FinRAGBench-V: A Benchmark for Multimodal RAG with Visual Citation in ...

Benchmarking Multimodal Mathematical Reasoning with Explicit Visual ...

[논문 리뷰] Enhancing Visual Dialog State Tracking through Iterative Object ...

MambaEVT: Event Stream based Visual Object Tracking using State Space ...

(PDF) TrackingMamba: Visual State Space Model for Object Tracking

Benchmarking Multimodal Mathematical Reasoning with Explicit Visual ...
Advertisement Space (336x280)

[论文评述] VisFactor: Benchmarking Fundamental Visual Cognition in ...

Benchmarking Multi-Image Understanding in Vision and Language Models ...

Paper page - CameraBench: Benchmarking Visual Reasoning in MLLMs via ...

Figure 2 from Multimodal Dialogue State Tracking | Semantic Scholar
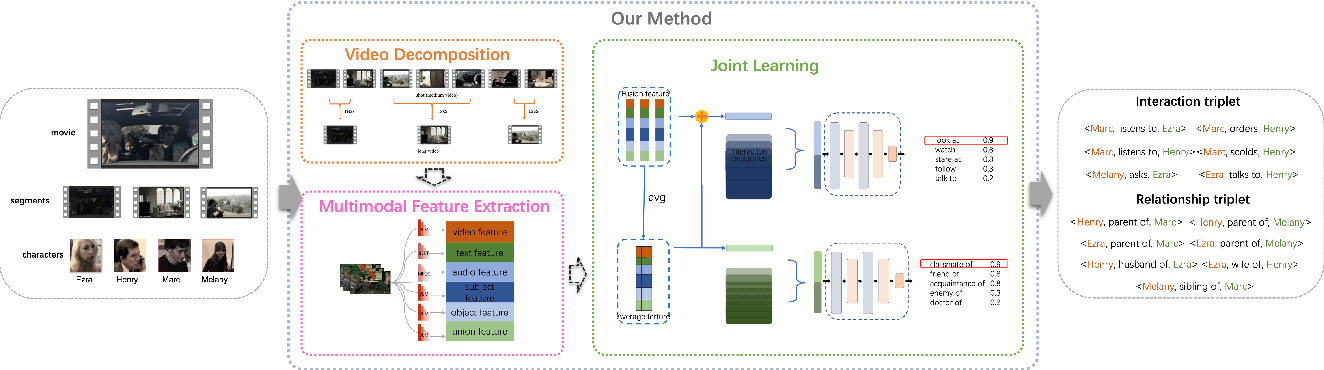
Figure 2 from Multimodal Analysis for Deep Video Understanding with ...

A Multimodal Video Understanding Agent Based on Video-Audio Multi-Task ...

RAVENEA: A Benchmark for Multimodal Retrieval-Augmented Visual Culture ...
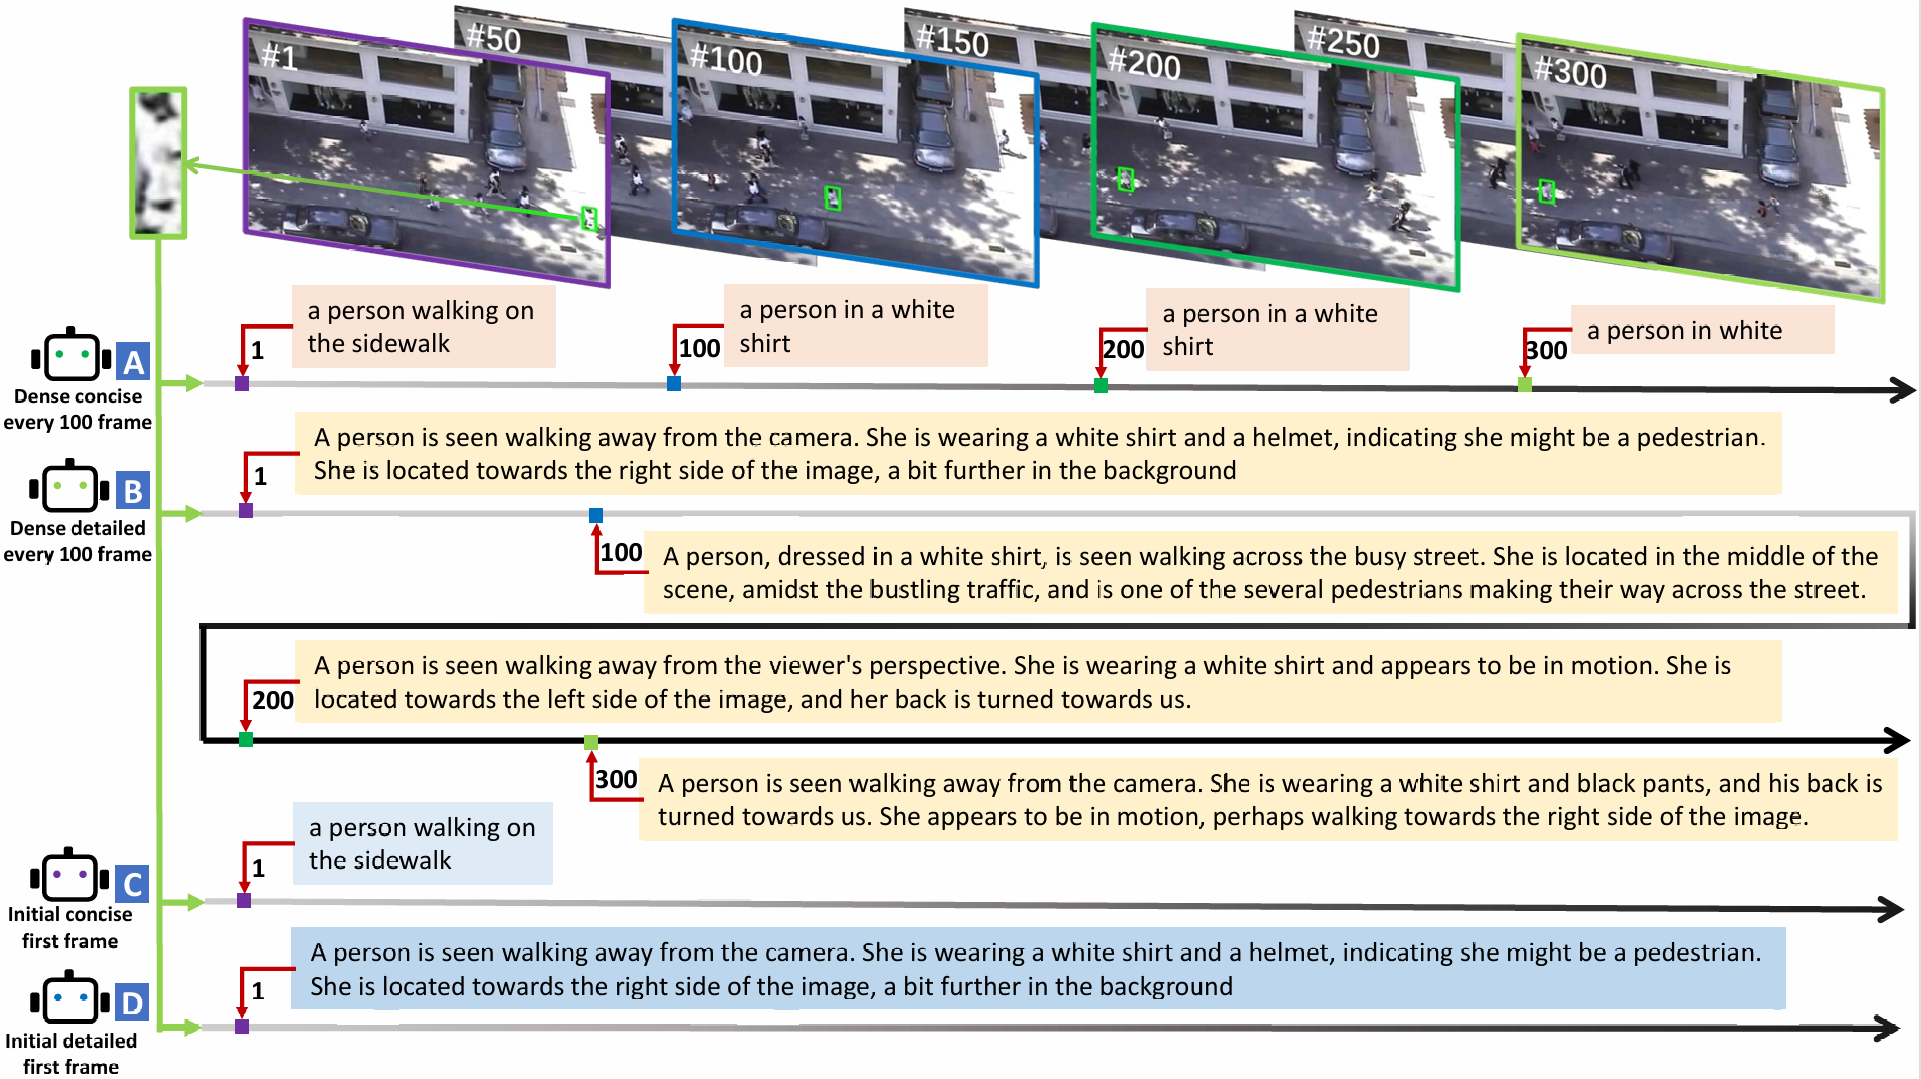
VideoCube: A general benchmark for visual tracking intelligence evaluation
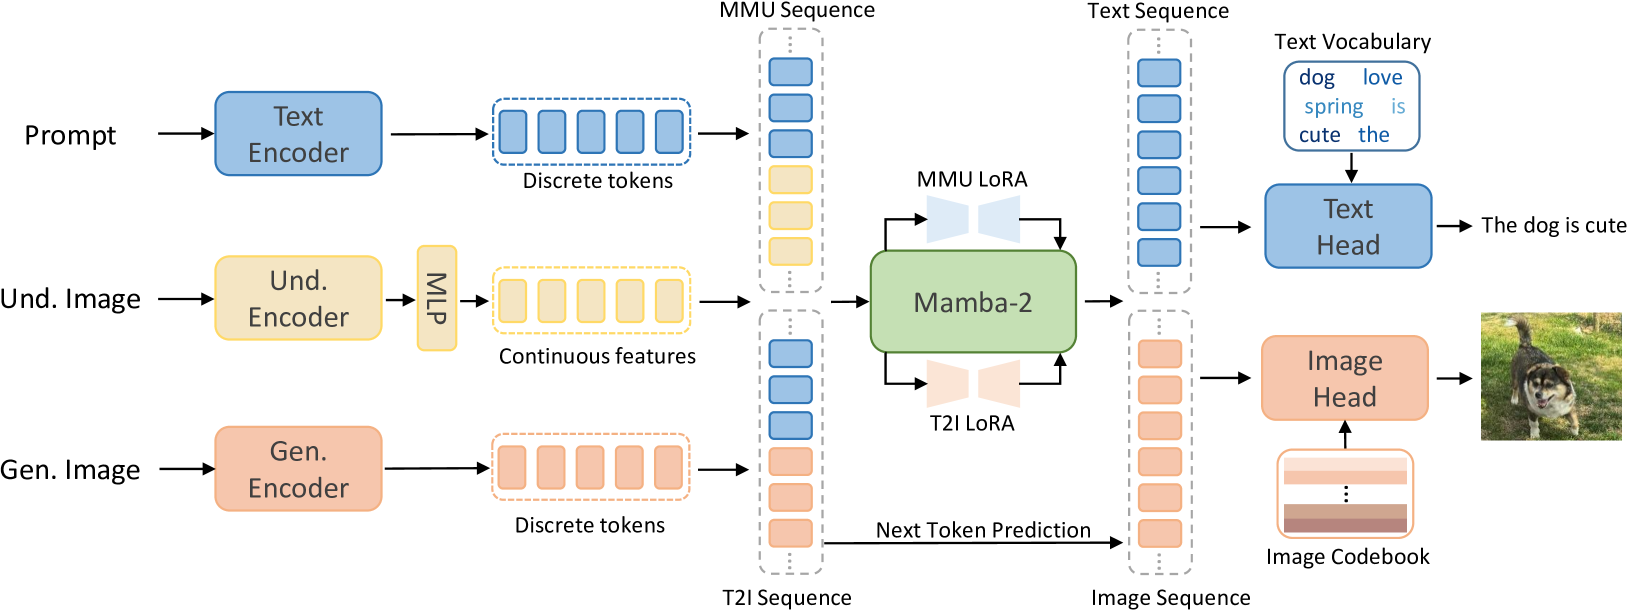
OmniMamba: Efficient and Unified Multimodal Understanding and ...

[논문 리뷰] How Far Are Video Models from True Multimodal Reasoning?
Advertisement Space (336x280)

VideoMathQA: Benchmarking Mathematical Reasoning via Multimodal ...

[2412.15691] Exploiting Multimodal Spatial-temporal Patterns for Video ...

Figure 1 from Adaptive Perception for Unified Visual Multimodal Object ...
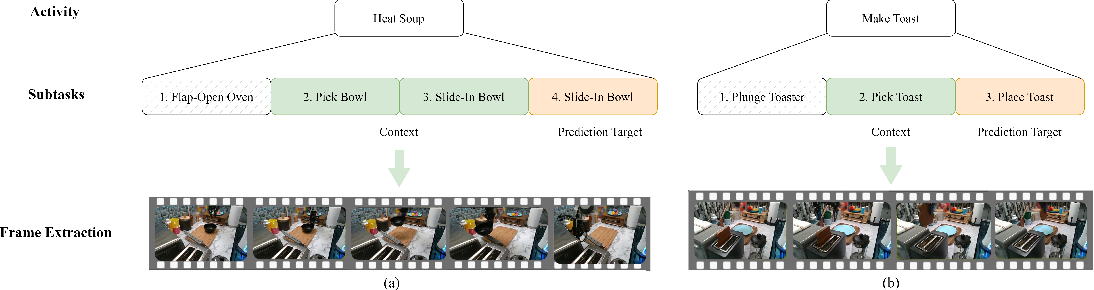
Figure 1 from Benchmarking Sequential Visual Input Reasoning and ...
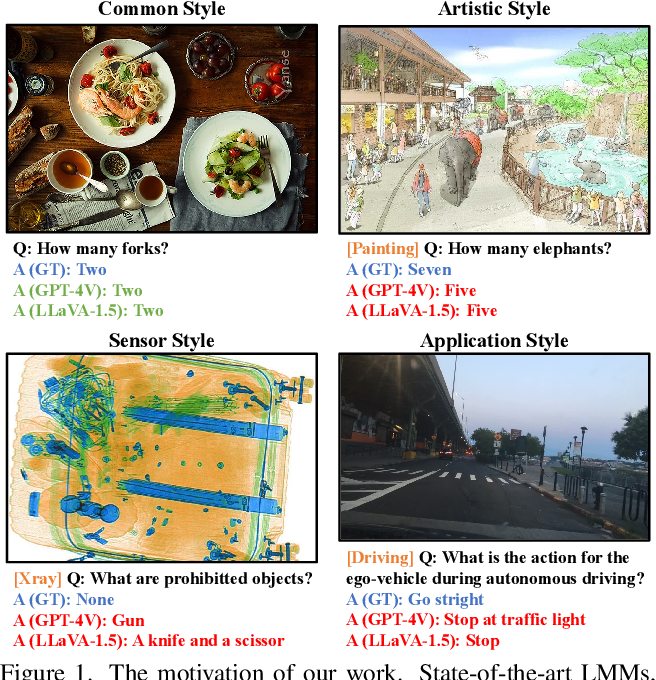
Figure 1 from BenchLMM: Benchmarking Cross-style Visual Capability of ...

NeurIPS Illusory VQA: Benchmarking and Enhancing Multimodal Models on ...