
Bio Inspired Modality Fusion For Active Speaker Detection

Bio-Inspired Modality Fusion for Active Speaker Detection - VisTeam

Bio-Inspired Modality Fusion for Active Speaker Detection
Bio-Inspired Modality Fusion for Active Speaker Detection | DeepAI
Bio-Inspired Modality Fusion for Active Speaker Detection

Bio-Inspired Modality Fusion for Active Speaker Detection
Bio-Inspired Modality Fusion for Active Speaker Detection

(PDF) Efficient Audiovisual Fusion for Active Speaker Detection

GateFusion: Hierarchical Gated Cross-Modal Fusion for Active Speaker ...
[2303.04439] A Light Weight Model for Active Speaker Detection

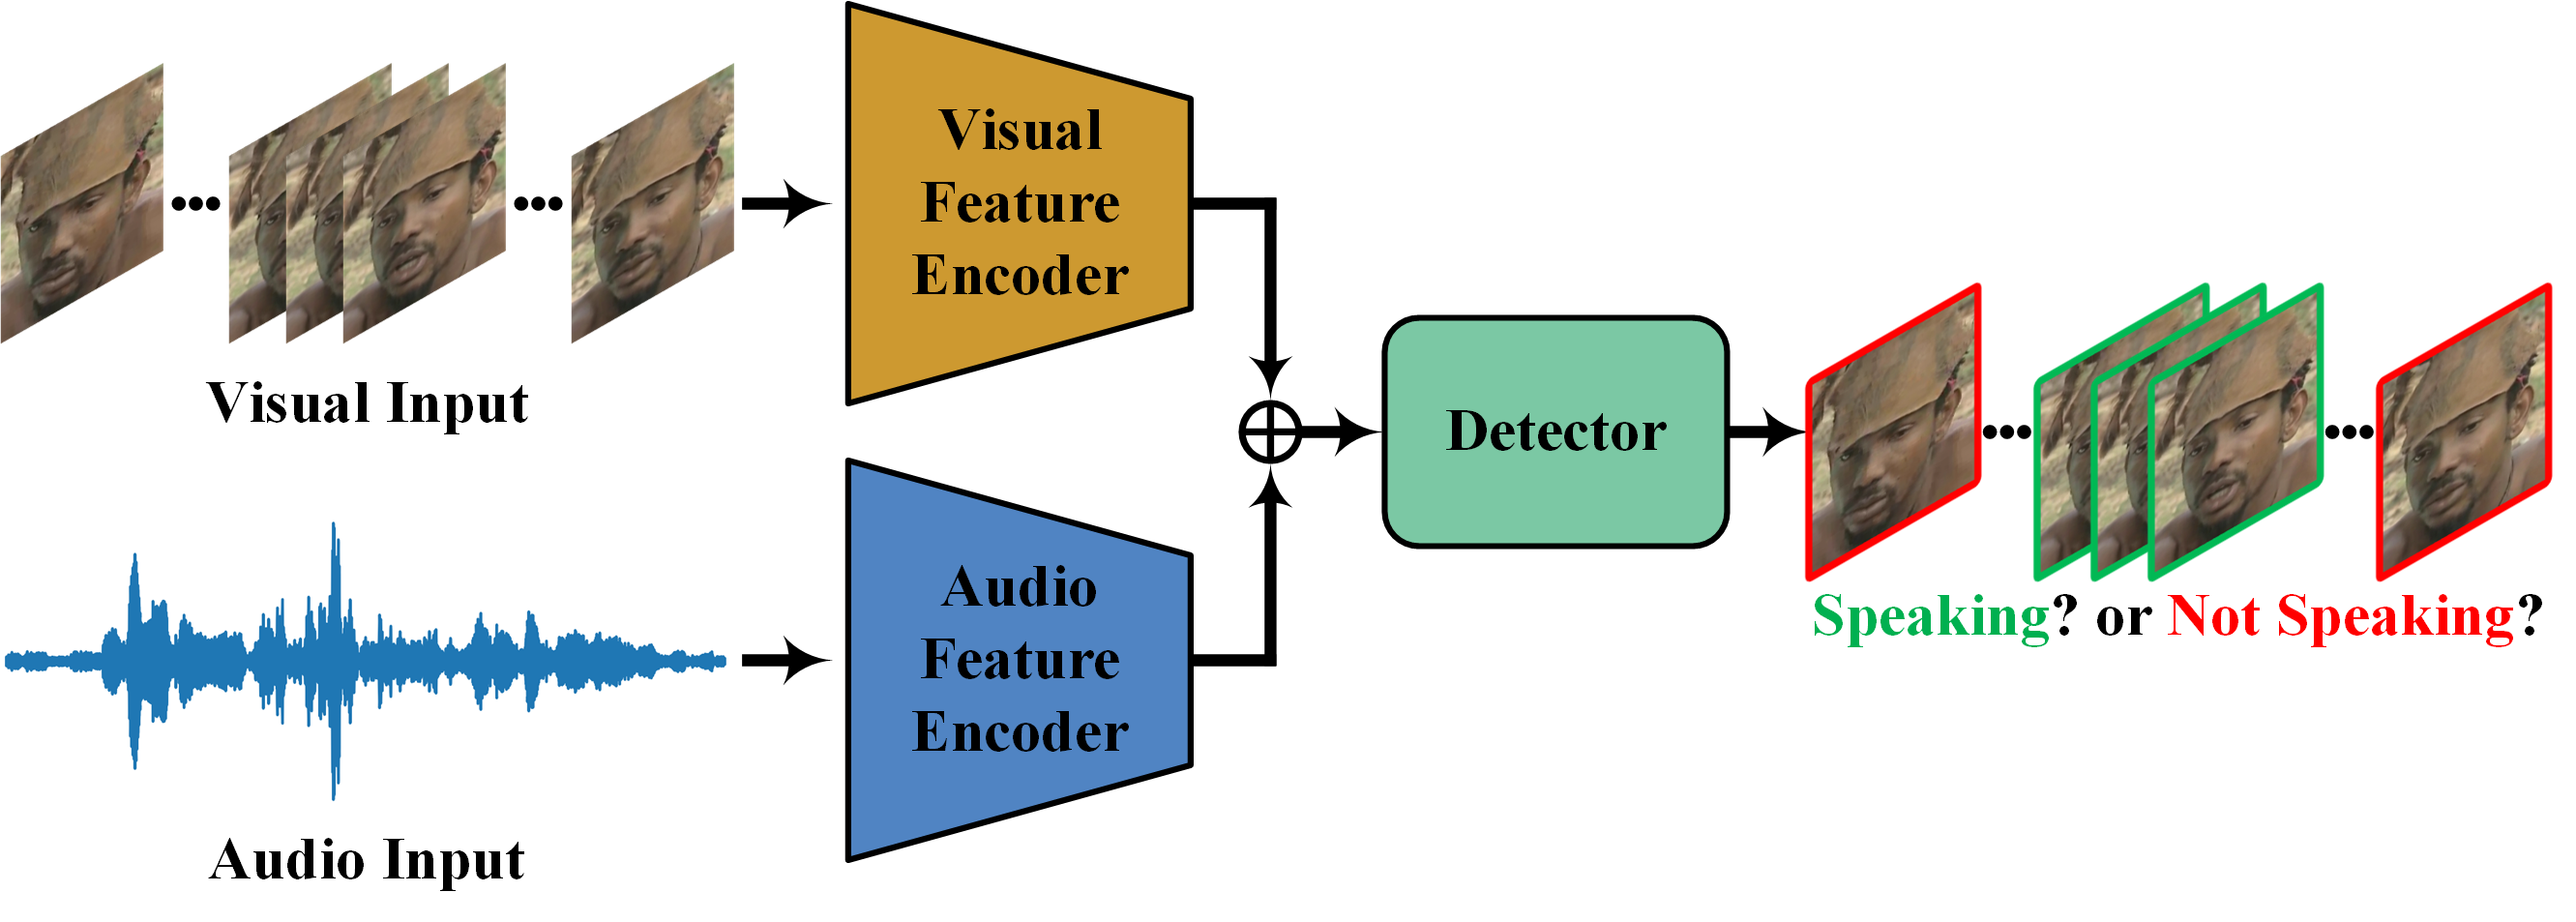
The proposed system architecture for active speaker detection ...
Advertisement Space (300x250)

Active speaker detection – CCMI: Center for Computational Media ...

Paper page - A Light Weight Model for Active Speaker Detection

(PDF) Audio Inputs for Active Speaker Detection and Localization via ...

GateFusion: Hierarchical Gated Cross-Modal Fusion for Active Speaker ...

Figure 4 from Enhancing Real-World Active Speaker Detection with Multi ...

[논문 리뷰] GateFusion: Hierarchical Gated Cross-Modal Fusion for Active ...

Figure 1 from Target Active Speaker Detection with Audio-visual Cues ...

Look&Listen: Multi-Modal Correlation Learning for Active Speaker ...

Robust Active Speaker Detection in Noisy Environments: Paper and Code
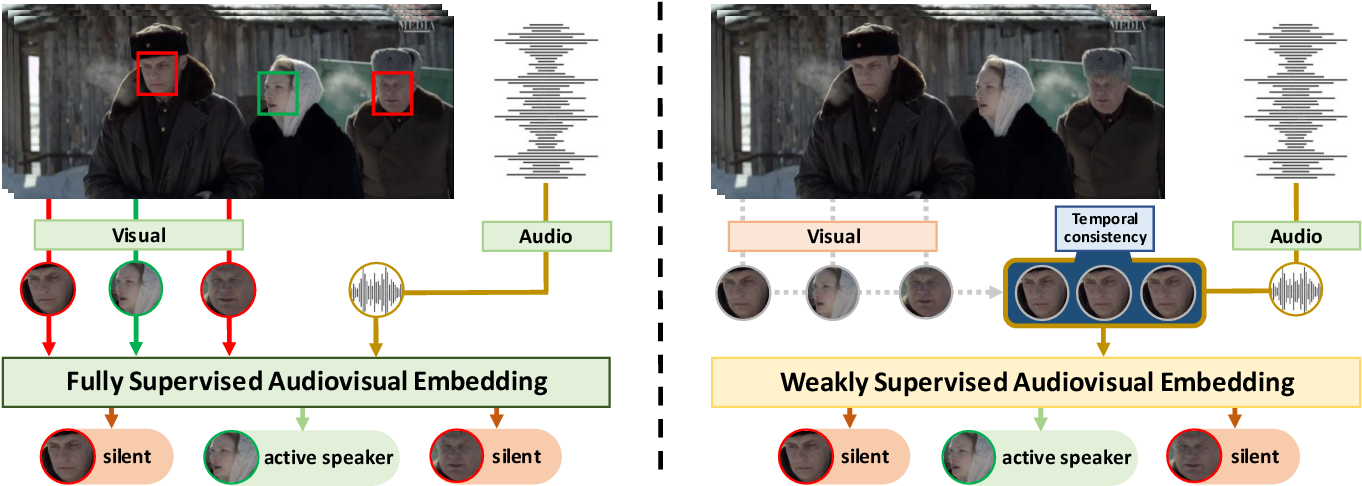
Figure 1 from End-to-End Active Speaker Detection | Semantic Scholar
Advertisement Space (336x280)
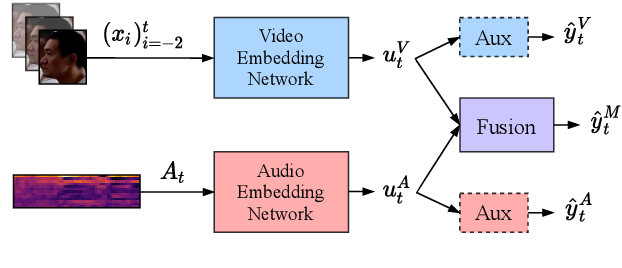
Figure 2 from Active Speaker Detection as a Multi-Objective ...

Block diagram of the proposed modality fusion system for open-set ...
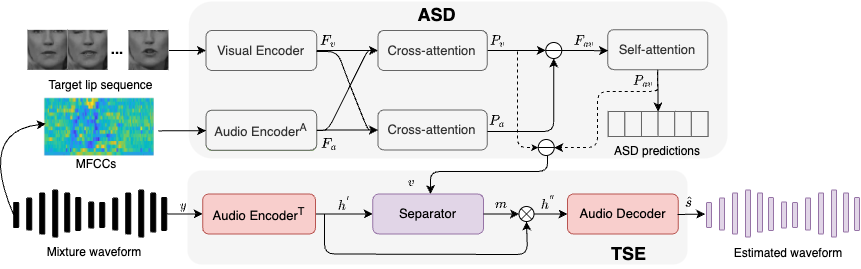
Audio-Visual Active Speaker Extraction for Sparsely Overlapped Multi ...

Figure 2 from Enhancing Real-World Active Speaker Detection With Multi ...

Look&Listen: Multi-Modal Correlation Learning for Active Speaker ...

Figure 1 from A Two-Stage Attention Based Modality Fusion Framework for ...

Figure 1 from Robust Active Speaker Detection in Noisy Environments ...

(PDF) Active Speaker Detection Using Audio, Visual, and Depth ...

(PDF) Modeling Long-Term Multimodal Representations for Active Speaker ...
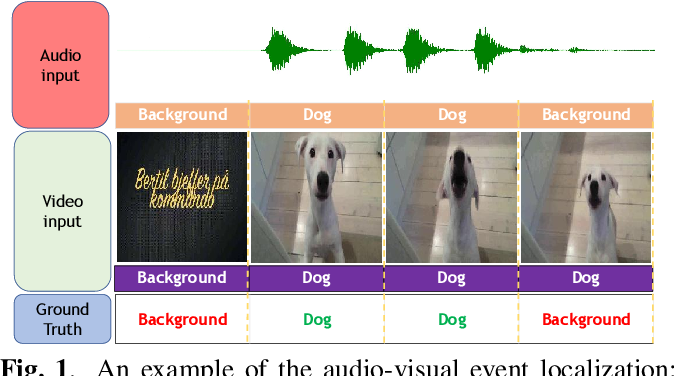
Figure 1 from Bi-Directional Modality Fusion Network For Audio-Visual ...
Advertisement Space (336x280)
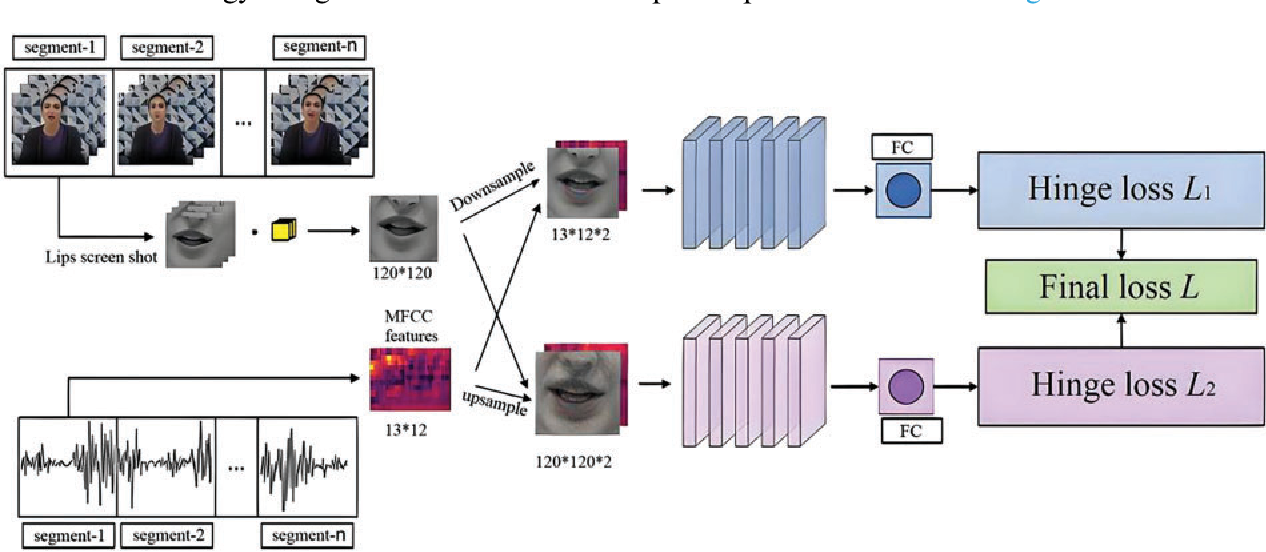
Figure 1 from Lip-Audio Modality Fusion for Deep Forgery Video ...

(PDF) Bi-Directional Modality Fusion Network For Audio-Visual Event ...

(PDF) Comparative Analysis of Modality Fusion Approaches for Audio ...

Block diagram of the proposed modality fusion system for open-set ...

Figure 2 from End-to-End Active Speaker Detection | Semantic Scholar

End-to-End Active Speaker Detection | DeepAI