
Bug Qwen2 Vl 72b Inference On Multiple Gpus Issue 9363 Vllm
[Bug]: Qwen2-VL-72B Inference on Multiple-GPUs · Issue #9363 · vllm ...

Deploy Qwen 2.5 VL 72B Instruct with vLLM in one click on Koyeb's high ...
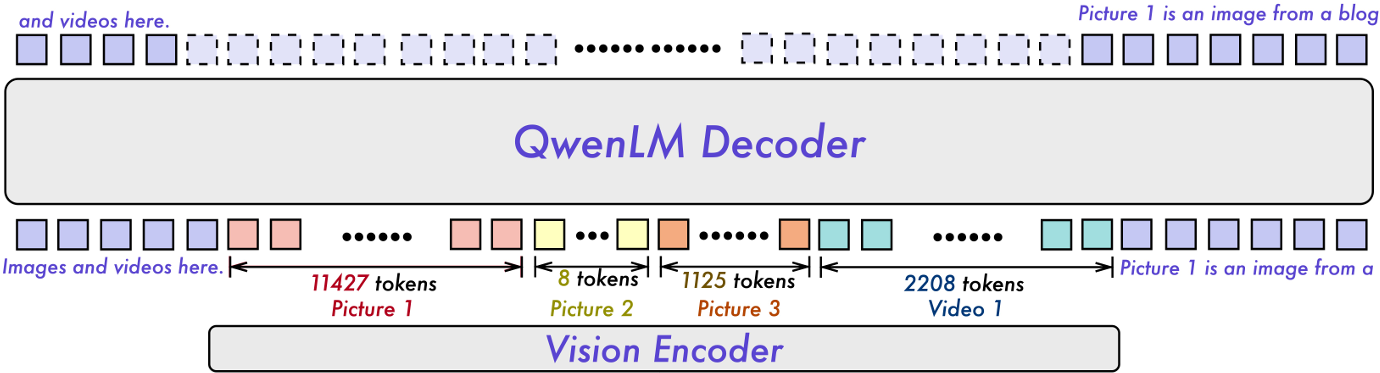
Qwen2 VL - Inference and Fine-Tuning for Understanding Charts
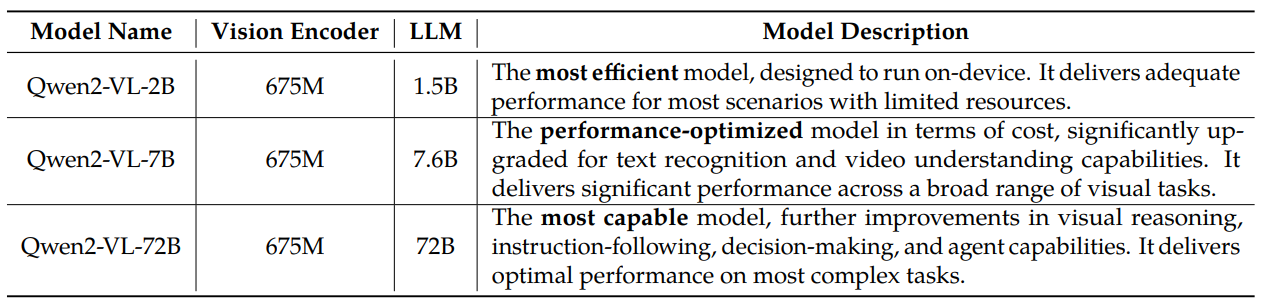
Qwen2 VL - Inference and Fine-Tuning for Understanding Charts
[Bug]: Qwen2-VL-72B-Instruct Inference failure · Issue #115 · vllm ...

Qwen2 VL - Inference and Fine-Tuning for Understanding Charts
[Bug]: Qwen2.5-32B-GPTQ-Int4 inference `!!!!!` · Issue #10656 · vllm ...

Qwen 2 VL 72B AI In-Depth Test: Answering Multiple Questions with ...

Qwen 2 VL 72B AI In-Depth Test: Answering Multiple Questions with ...

Qwen2 VL - Inference and Fine-Tuning for Understanding Charts
Advertisement Space (300x250)
[Bug]: multi-GPU inference (tensor_parallel_size=2) fails on Intel GPUs ...

Qwen2 VL 72B Instruct API | Segmind

72B Parameters, Zero Quantization, One GPU: Benchmarking Qwen2-VL on ...
[Usage]:910B2 部署qwen2.5-vl-72B,效果比GPU部署效果差很多 · Issue #482 · vllm ...
Qwen2.5 VL 72B Instruct
[Bug]: Errors Encountered While Running Qwen2.5-VL-72B-AWQ Inference on ...
[Bug]: The speed of loading the qwen2 72b model, glm-4-9b-chat-1m model ...

Qwen/Qwen2.5-VL-72B-Instruct · Inference problems for all Qwen2.5 VL ...
[Bug]: Nonsense output for Qwen2.5 72B after upgrading to latest vllm 0 ...
[Bug]: Qwen/Qwen2-72B-Instruct 128k server down · Issue #5496 · vllm ...
Advertisement Space (336x280)
Error using vllm with Qwen2.5-VL-72B-Instruct-AWQ · Issue #831 · QwenLM ...

72B Parameters, Zero Quantization, One GPU: Benchmarking Qwen2-VL on ...
[Bug]: v0.8.4rc2运行qwen-vl-72B-instruct会导致机器重启 · Issue #622 · vllm ...
[Bug]: Issue Running Qwen2.5-VL-7B-Instruct with vLLM Due to ...
[Bug]: qwen2.5-vl-72b oom in 4 A100 in 0.8.3 · Issue #16570 · vllm ...
[Bug]: 910B3 显卡 qwen2.5vl 72B 发送请求超时失败 · Issue #2891 · vllm-project ...
LLaVA-onevision-qwen2-7b-ov and Qwen2-VL-7B-Instruct can't inference on ...
[Bug]: Qwen2.5 VL failed · Issue #382 · vllm-project/vllm-ascend · GitHub
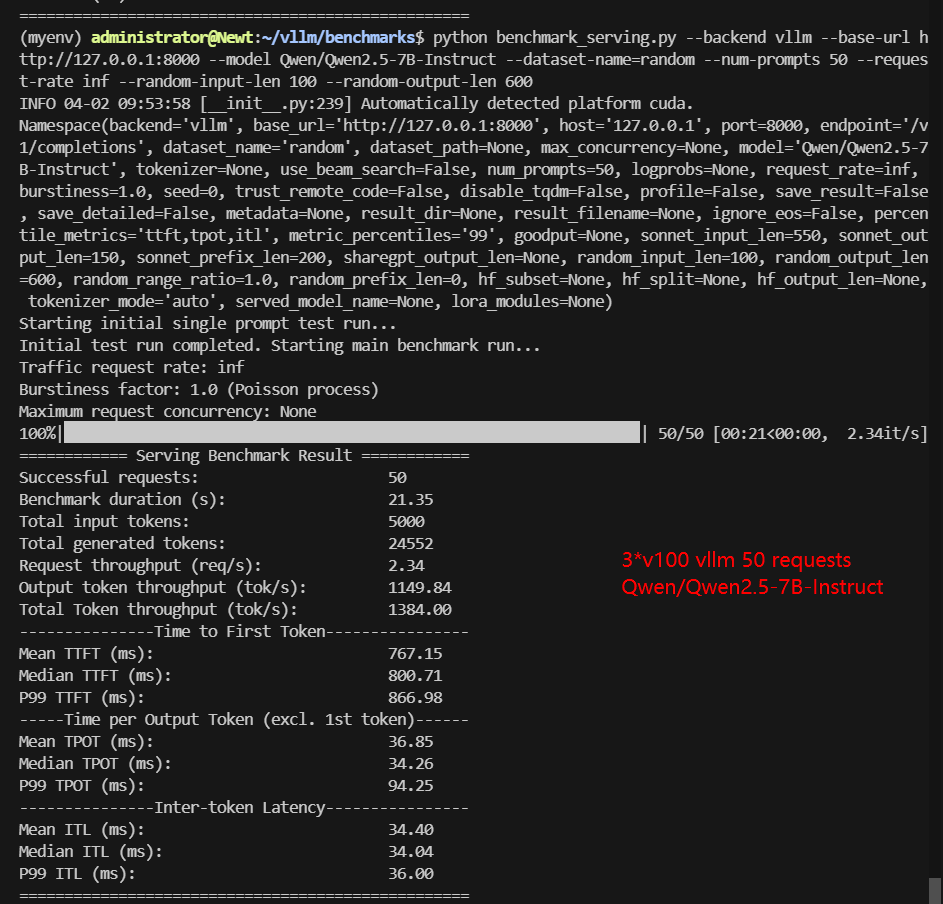
3×V100 vLLM Benchmark: Multi-GPU Inference Performance Optimization

72B Parameters, Zero Quantization, One GPU: Benchmarking Qwen2-VL on ...
Advertisement Space (336x280)
[Bug]: Incoherent Offline Inference Single Video with Qwen2-VL · Issue ...

vLLM CPU和GPU模式署和推理 Qwen2 等大语言模型详细教程_vllm qwen-CSDN博客
Multi-GPU inference and Specify which GPUs to be used during inference ...
Qwen 2 VL 72B Performance - Latency & Token Trajectory | AI Stats
使用最新的 vllm 镜像推理qwen2-72B-AWQ 报错 · Issue #285 · xusenlinzy/api-for-open ...
[Bug]: qwen2.5-vl inference truncated · Issue #16763 · vllm-project ...