
Creating A New Benchmark Task Riverbench

Creating a new benchmark task - RiverBench
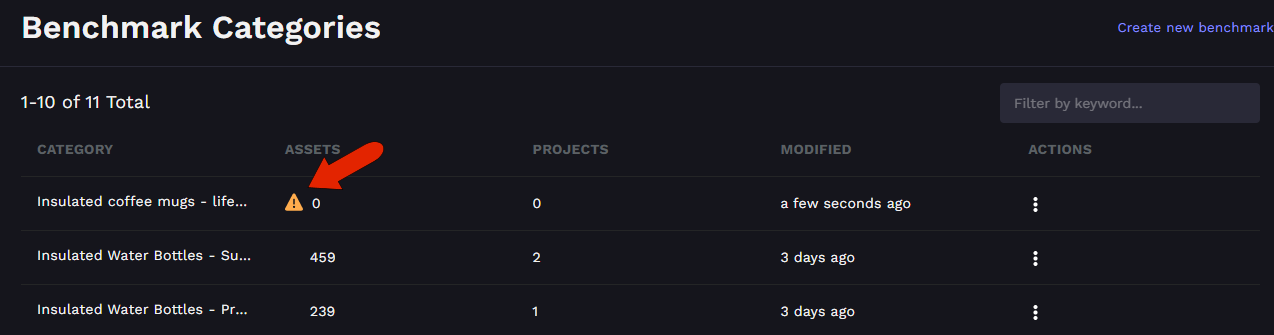
Creating a New Benchmark - Vizit Knowledge Base

Creating a new dataset - RiverBench
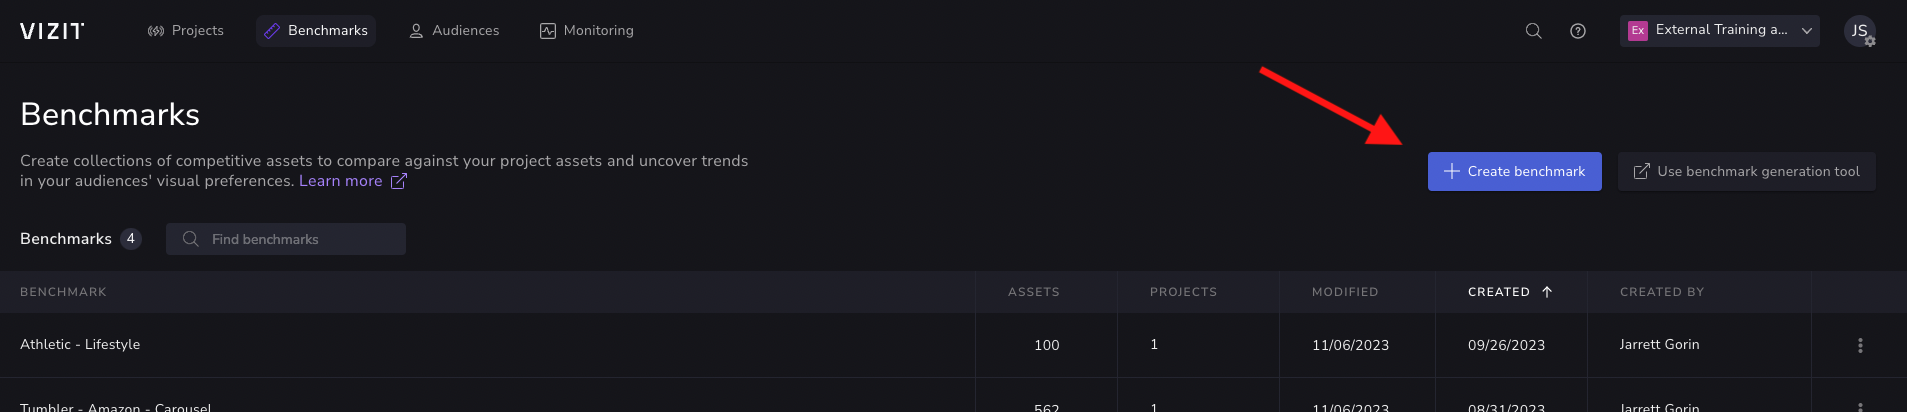
Creating a New Benchmark - Vizit Knowledge Base
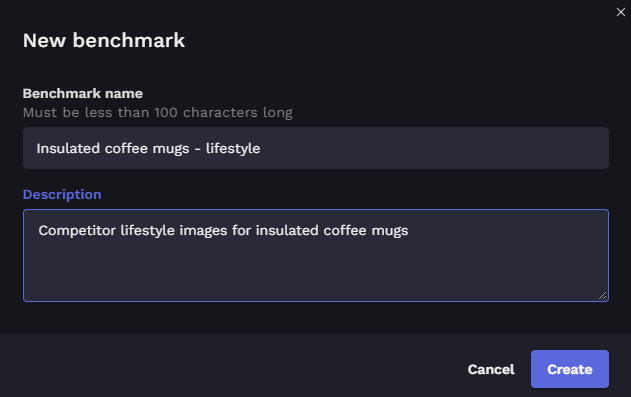
Creating a New Benchmark - Vizit Knowledge Base
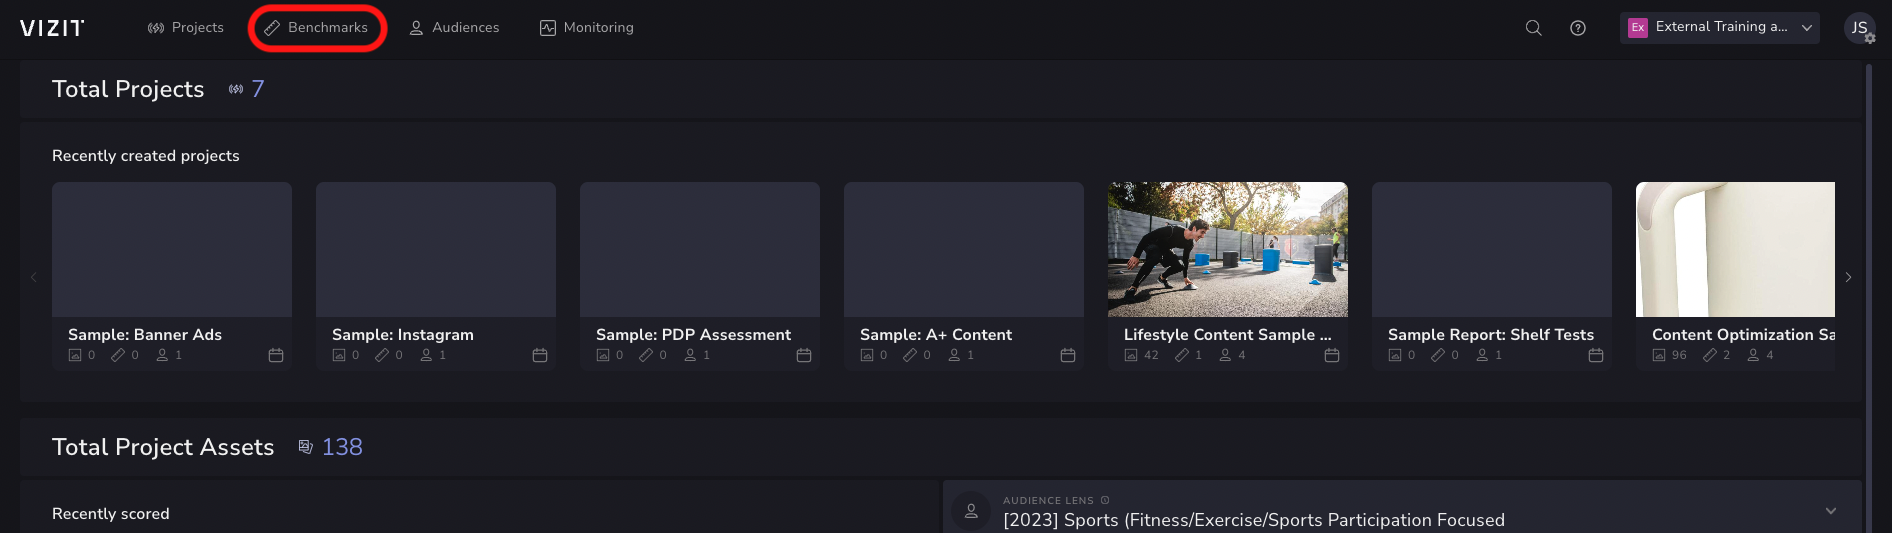
Creating a New Benchmark - Vizit Knowledge Base
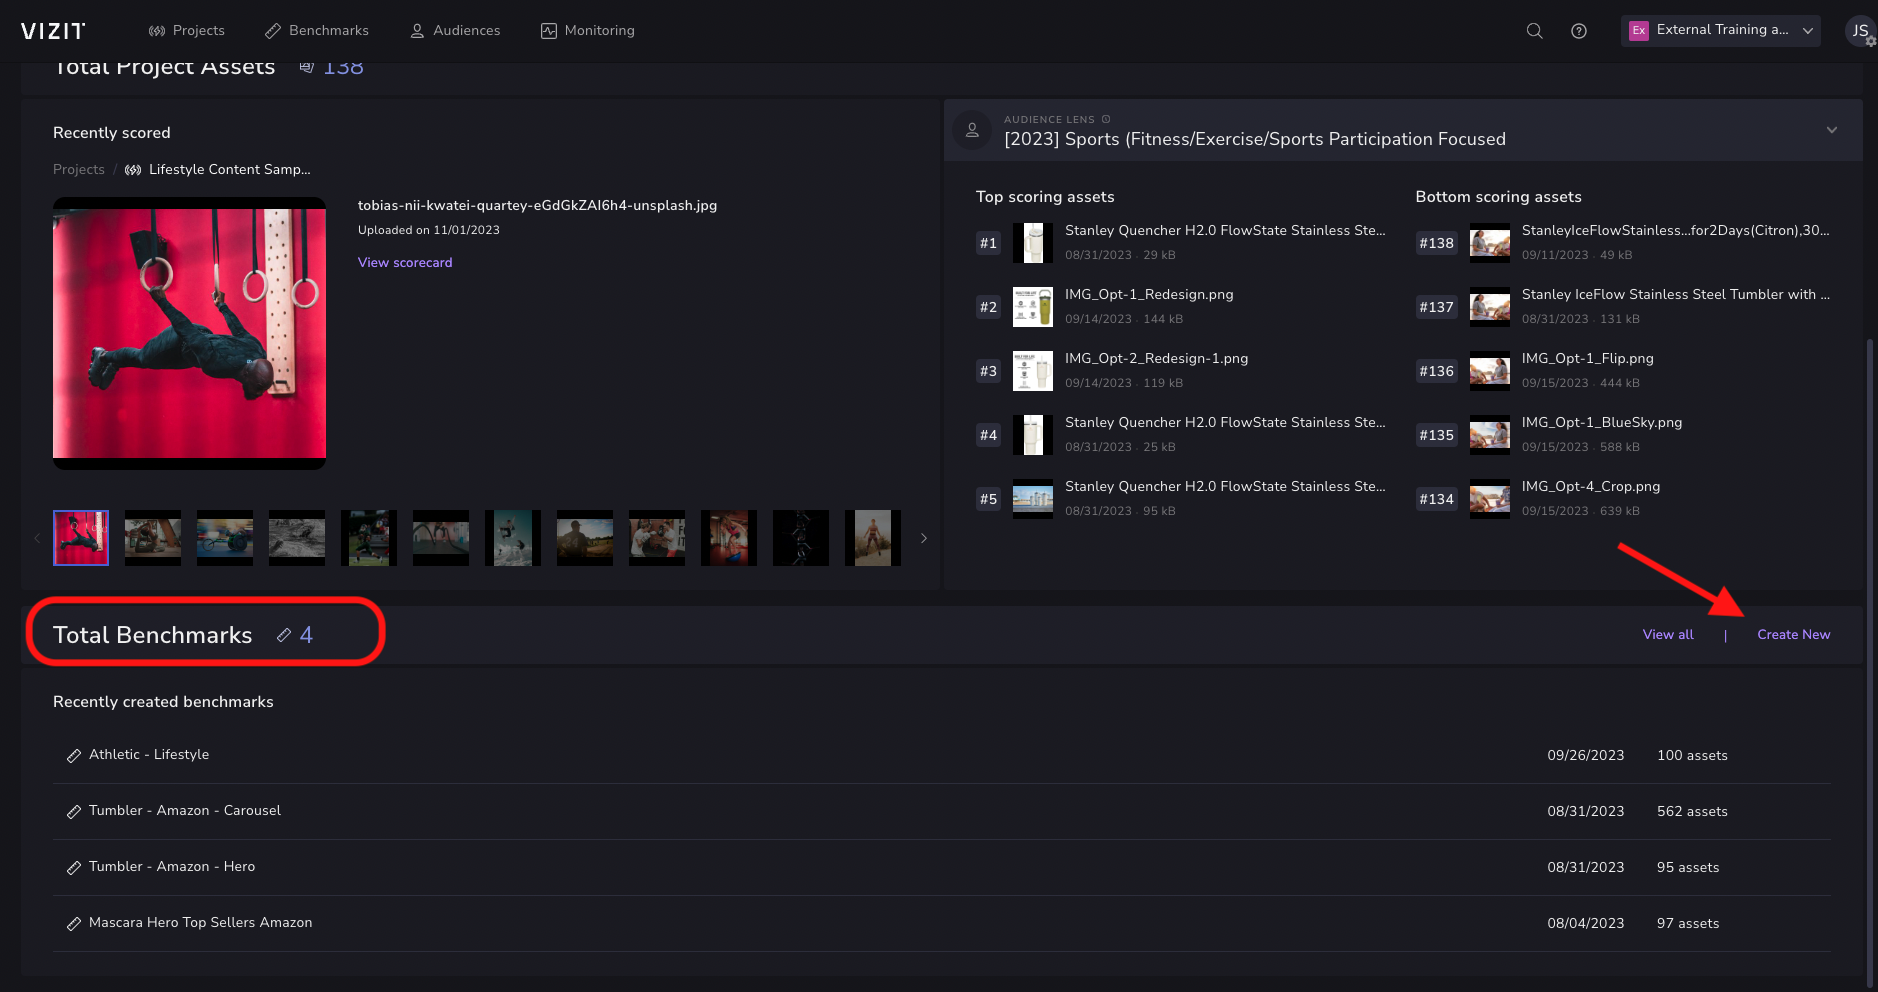
Creating a New Benchmark - Vizit Knowledge Base
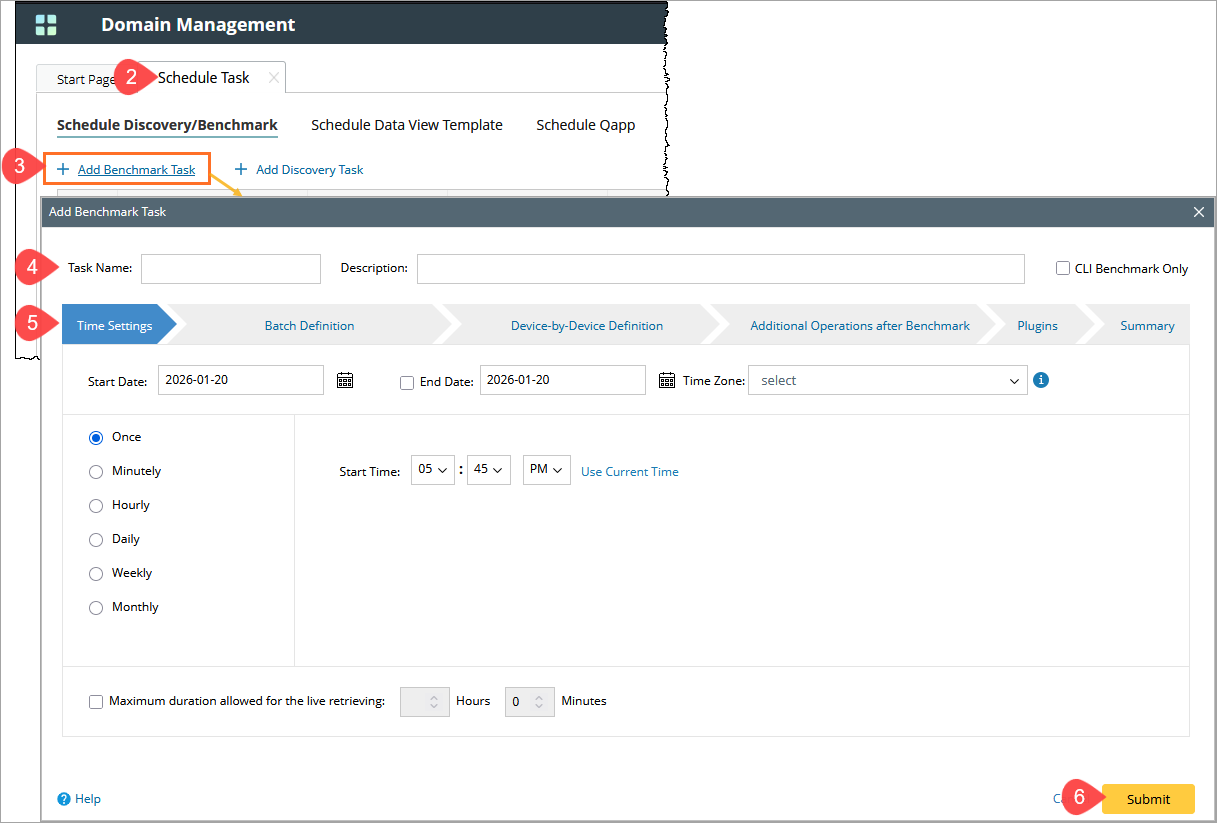
Create a Benchmark Task

New Benchmark Task 41ed3 | Kaggle
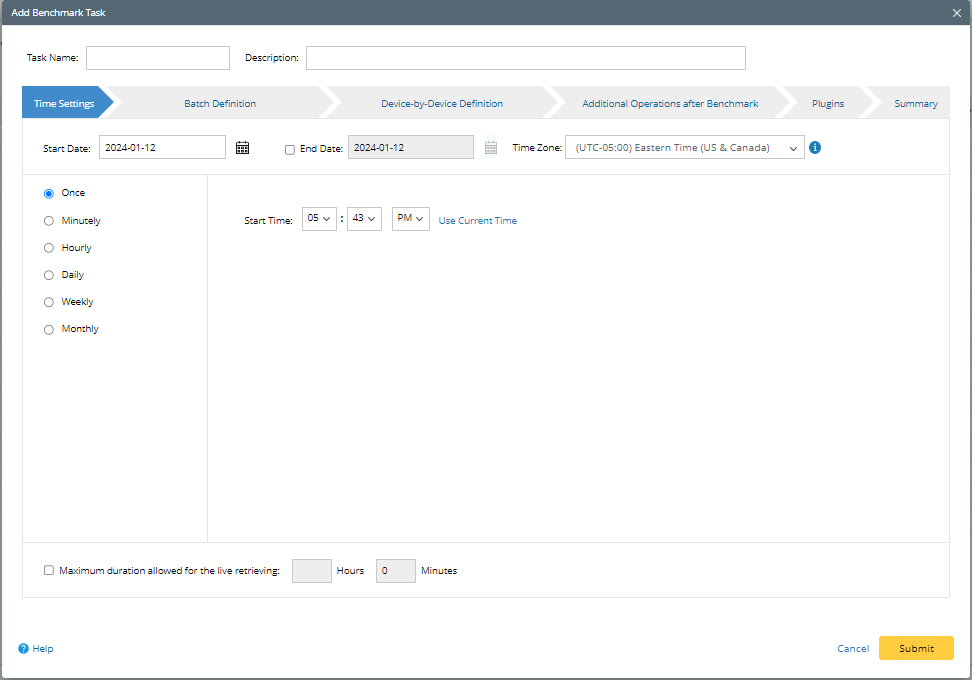
Create a Benchmark Task
Advertisement Space (300x250)

Create a Benchmark Task

MCPAgentBench: A Real-world Task Benchmark for Evaluating LLM Agent MCP ...

SafeAgentBench: A Benchmark for Safe Task Planning of Embodied LLM ...
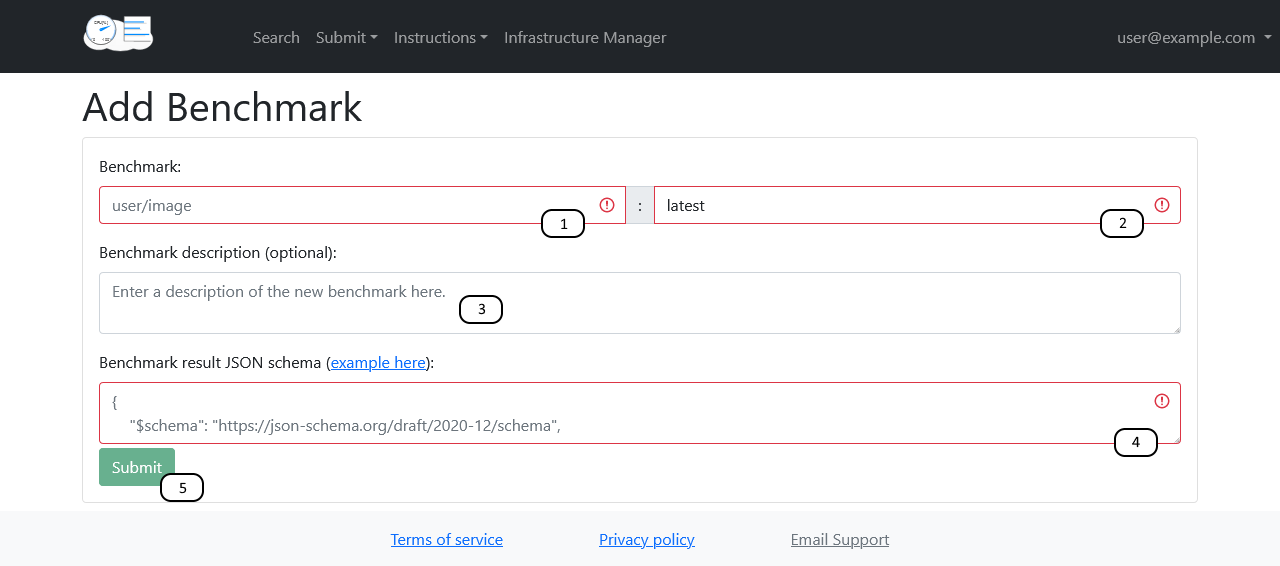
Adding a new benchmark — eosc-perf documentation

Reporting benchmark results - RiverBench
Creating New Tasks | embeddings-benchmark/mteb | DeepWiki

TimeMachine-bench: A Benchmark for Evaluating Model Capabilities in ...

BuilderBench -- A benchmark for generalist agents | AI Research Paper ...

XCR-Bench: A Multi-Task Benchmark for Evaluating Cultural Reasoning in ...
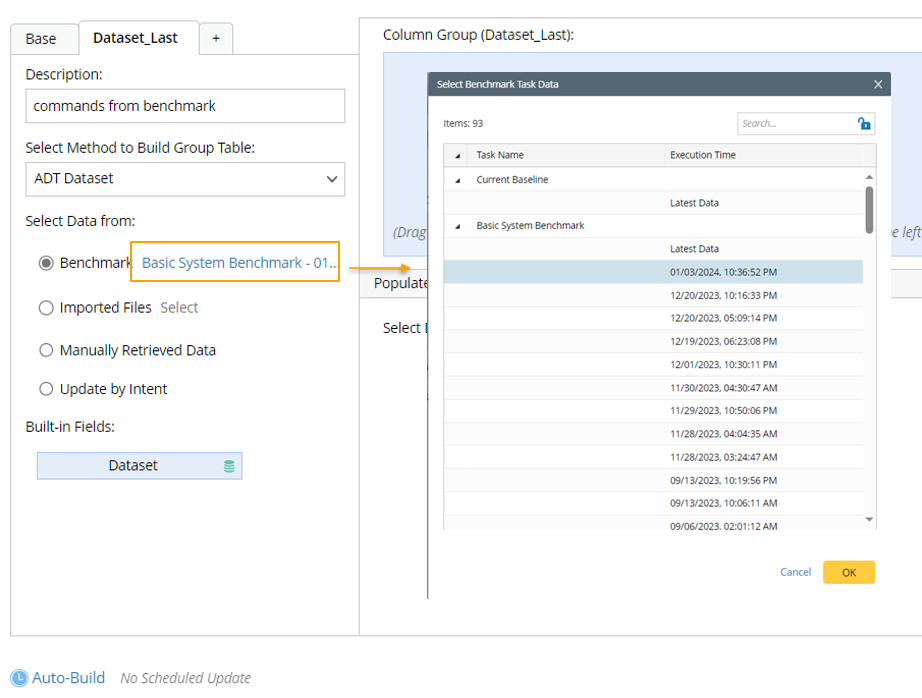
Create Dataset by Benchmark Task
Advertisement Space (336x280)
New Benchmark

MU-Bench: A Multitask Multimodal Benchmark for Machine Unlearning | AI ...
GitHub - Ilerii/terminal-bench-template: A benchmark for LLMs on ...
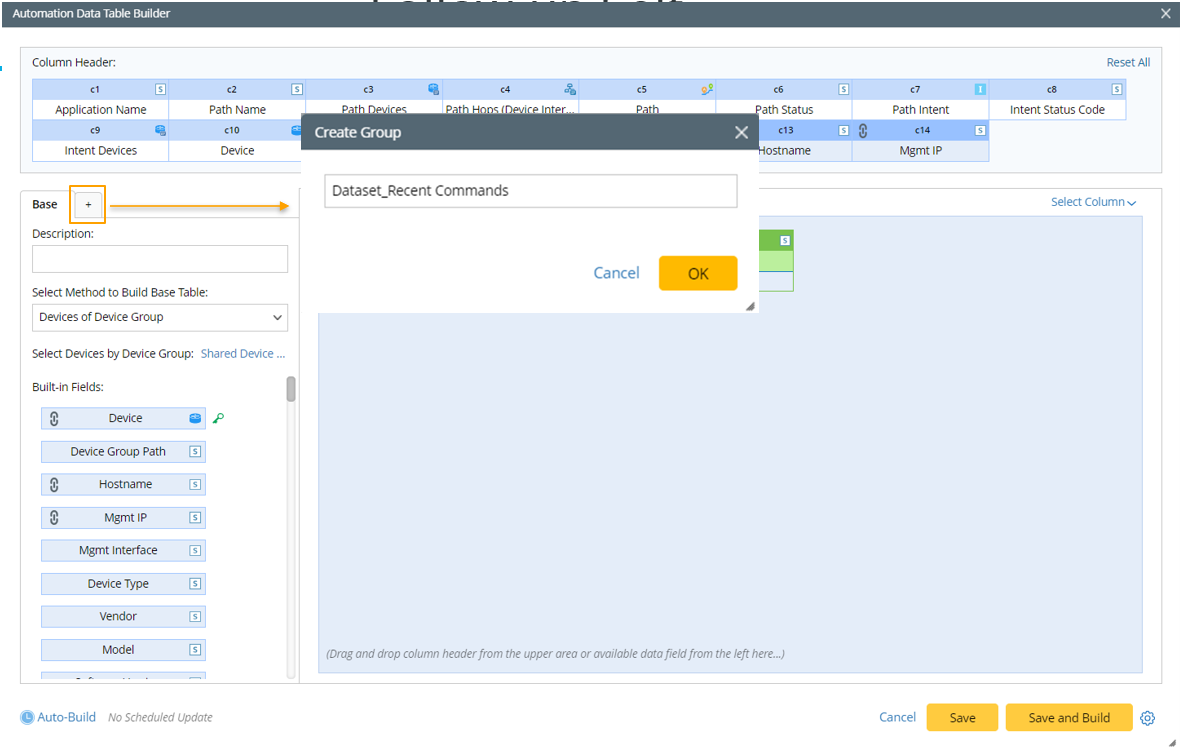
Create Dataset by Benchmark Task

RealBench: A Repo-Level Code Generation Benchmark Aligned with Real ...

I2EBench: A Comprehensive Benchmark for Instruction-based Image Editing ...
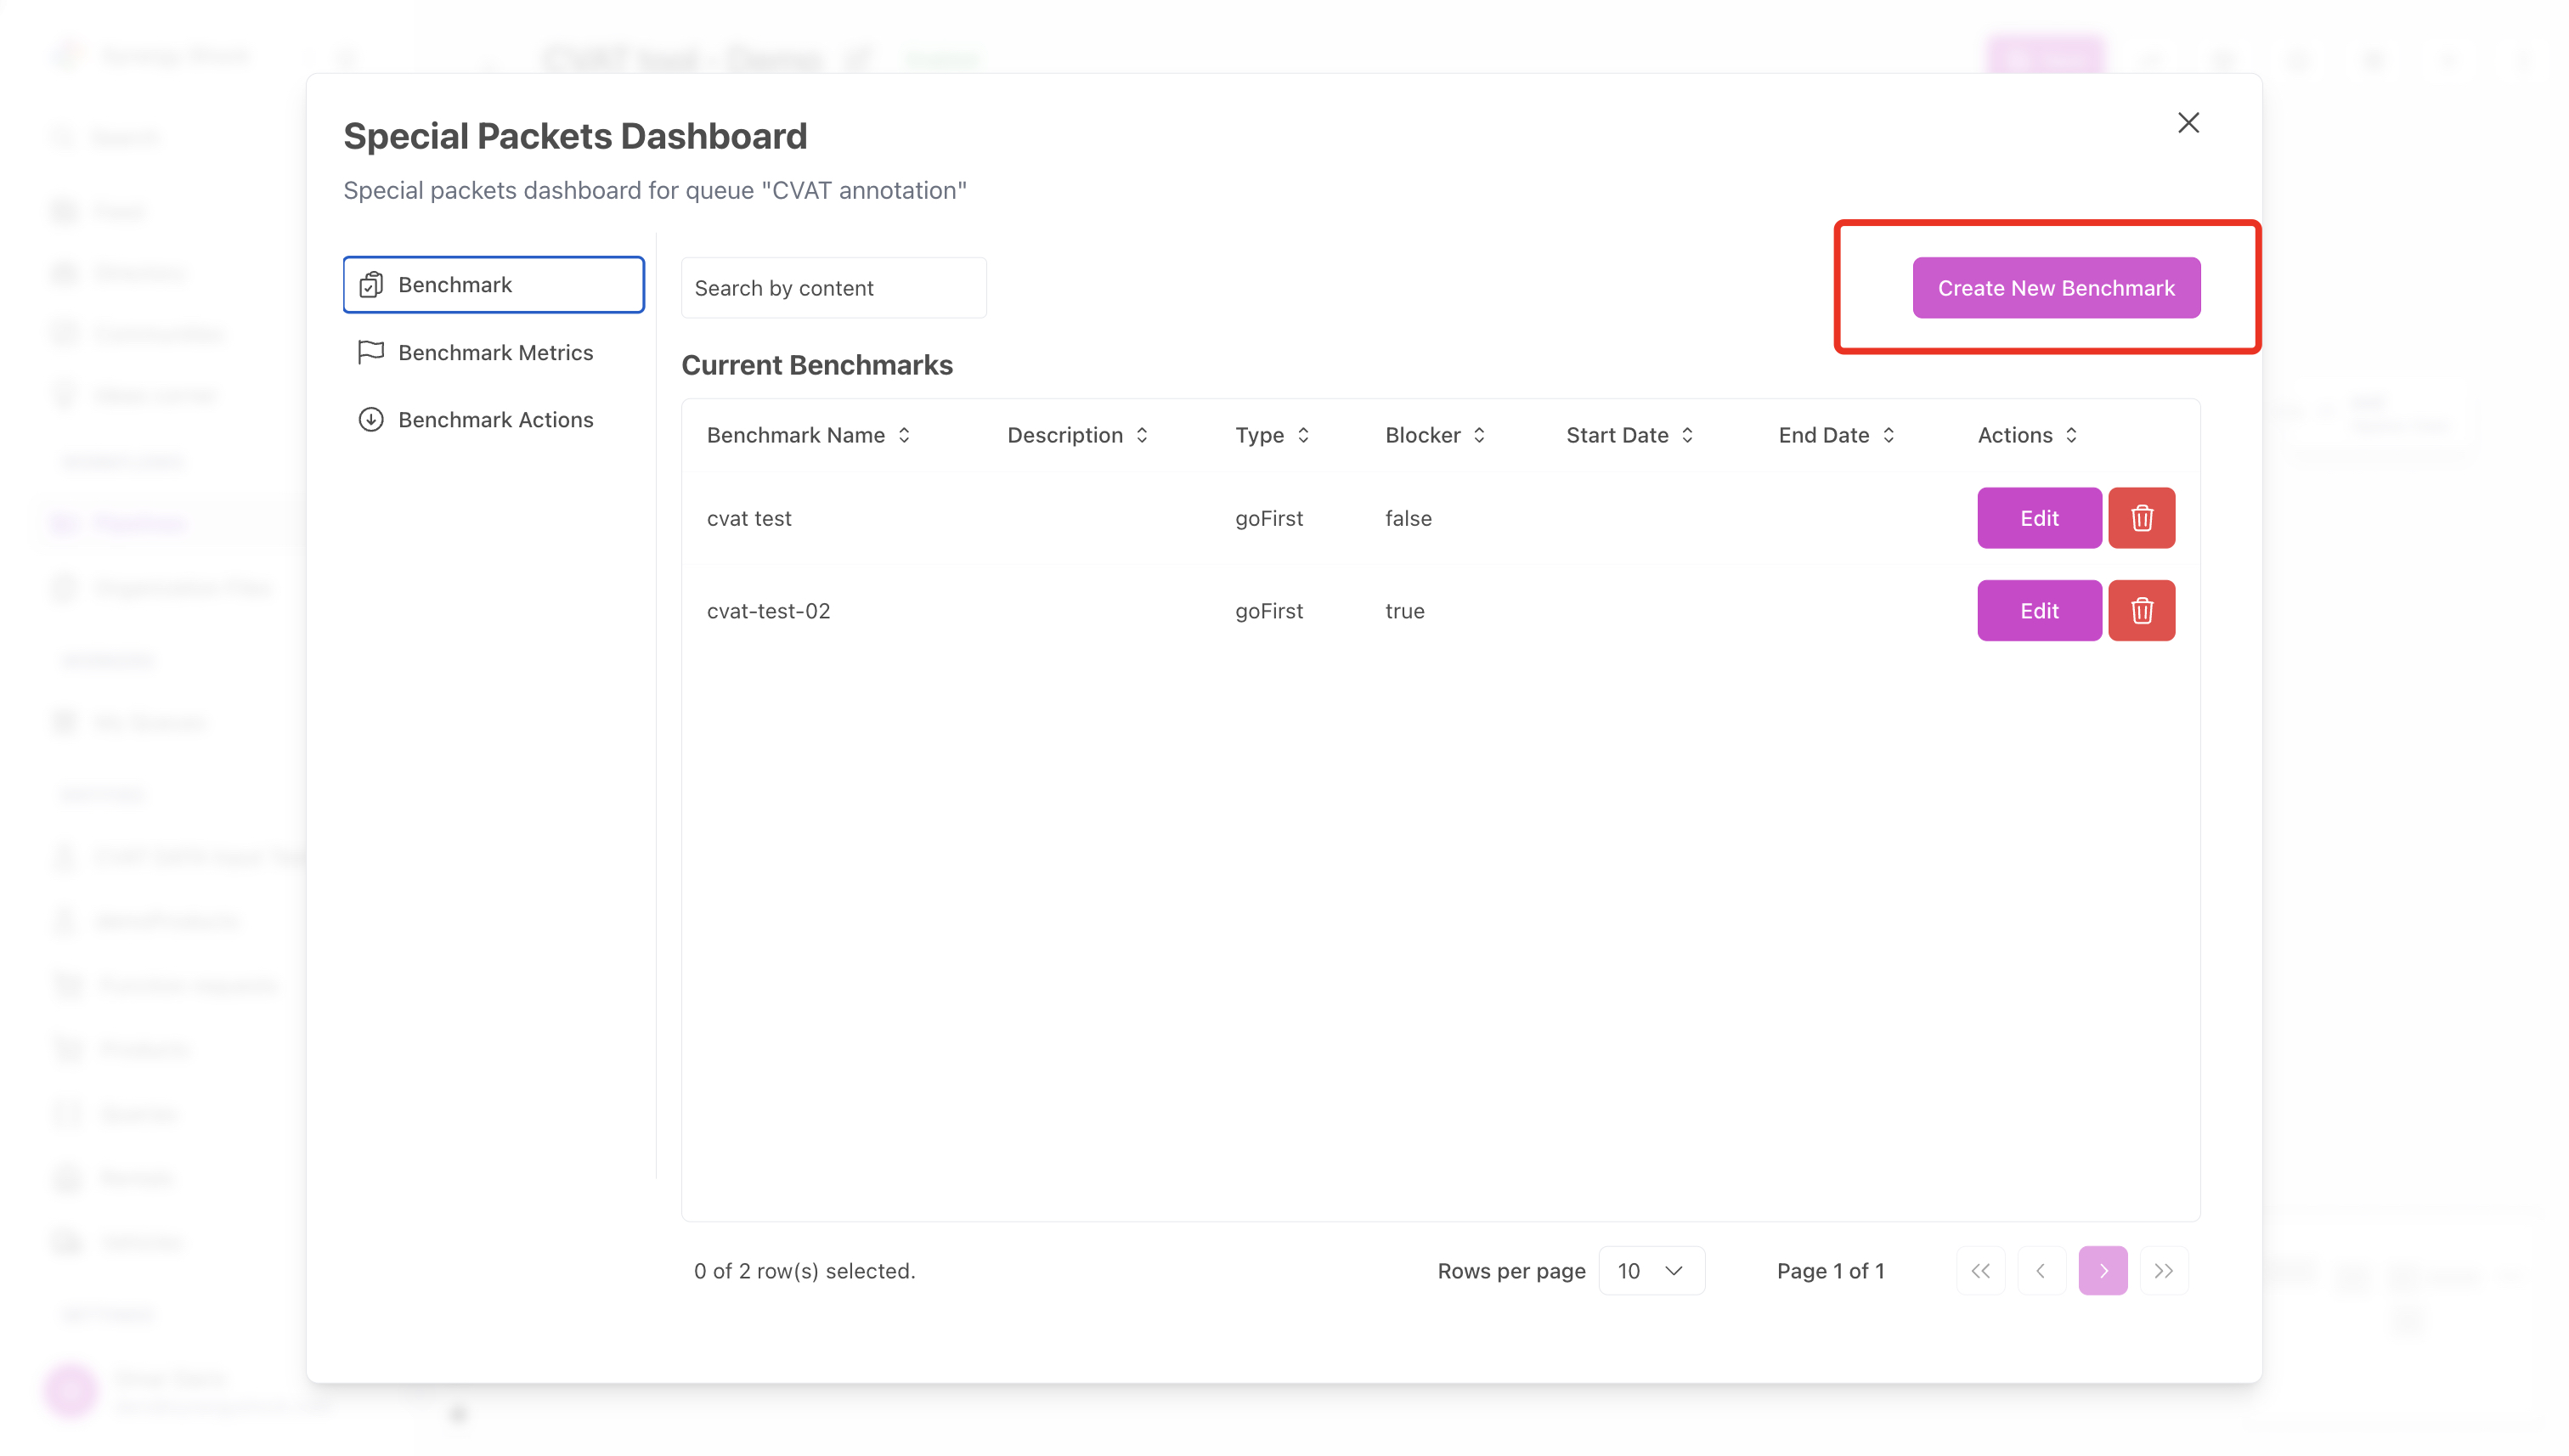
How to create a CVAT benchmark
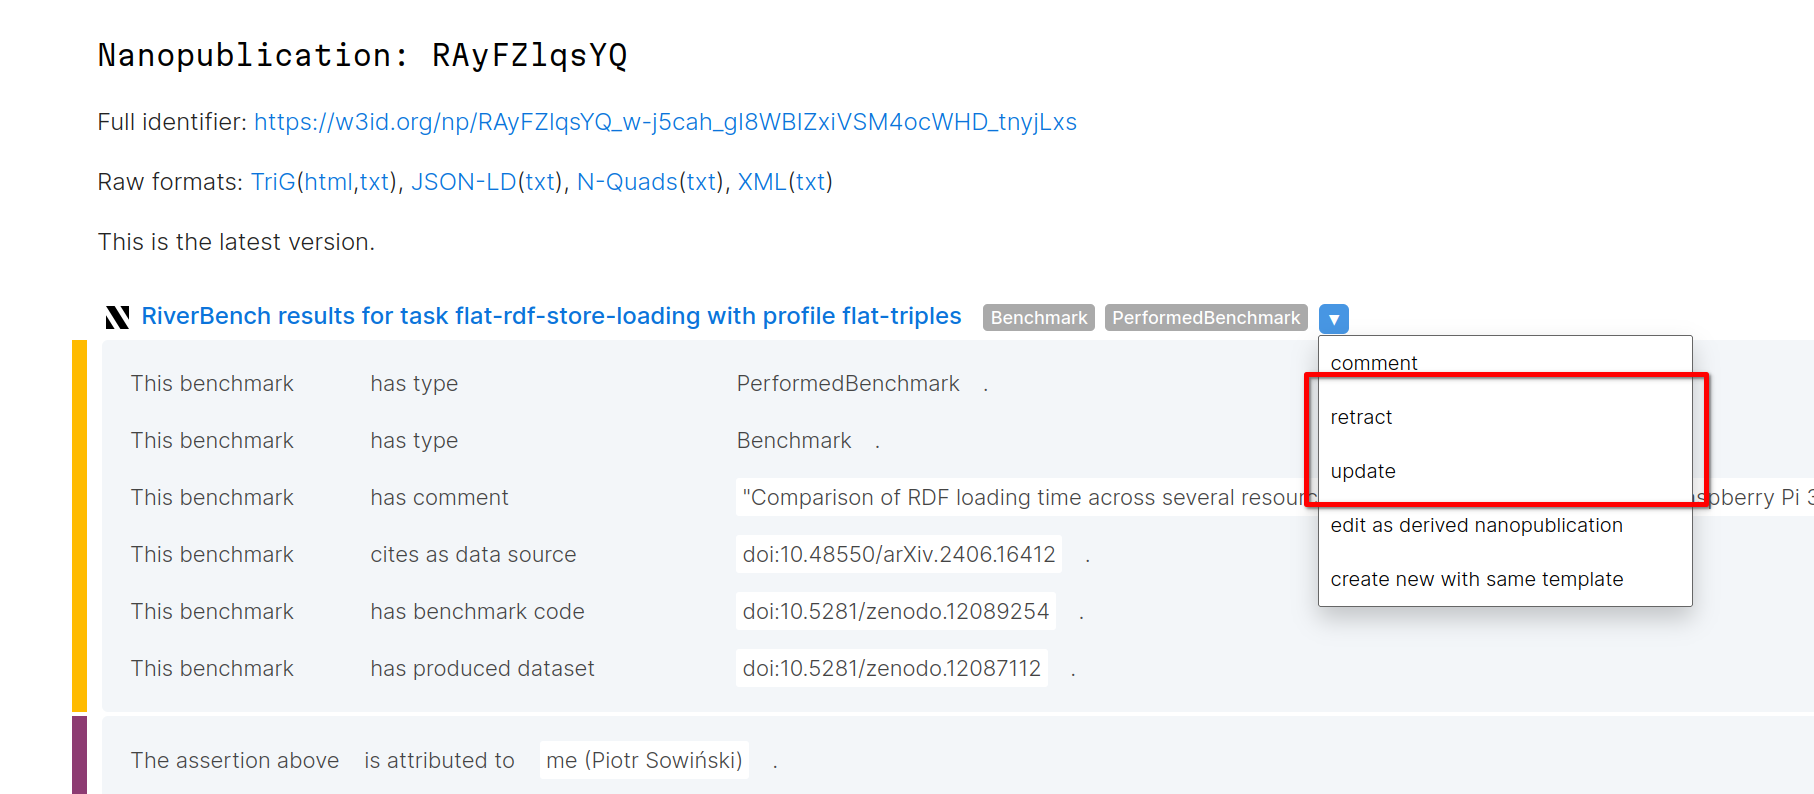
Reporting benchmark results - RiverBench

RIVER: A Real-Time Interaction Benchmark for Video LLMs

UR-Bench: A Benchmark for Multi-Hop Reasoning over Ultra-High ...
Advertisement Space (336x280)
New Benchmark
GitHub - ISO-Bench/ISO-Bench: A benchmark framework for evaluating AI ...

(PDF) RVTBench: A Benchmark for Visual Reasoning Tasks

TOBench: A Task-Oriented Omni-Modal Benchmark for Real-World Tool-Using ...
New Benchmark

Mem2ActBench: A Benchmark for Evaluating Long-Term Memory Utilization ...