
Cvpr Poster Glid Pre Training A Generalist Encoder Decoder Vision Model
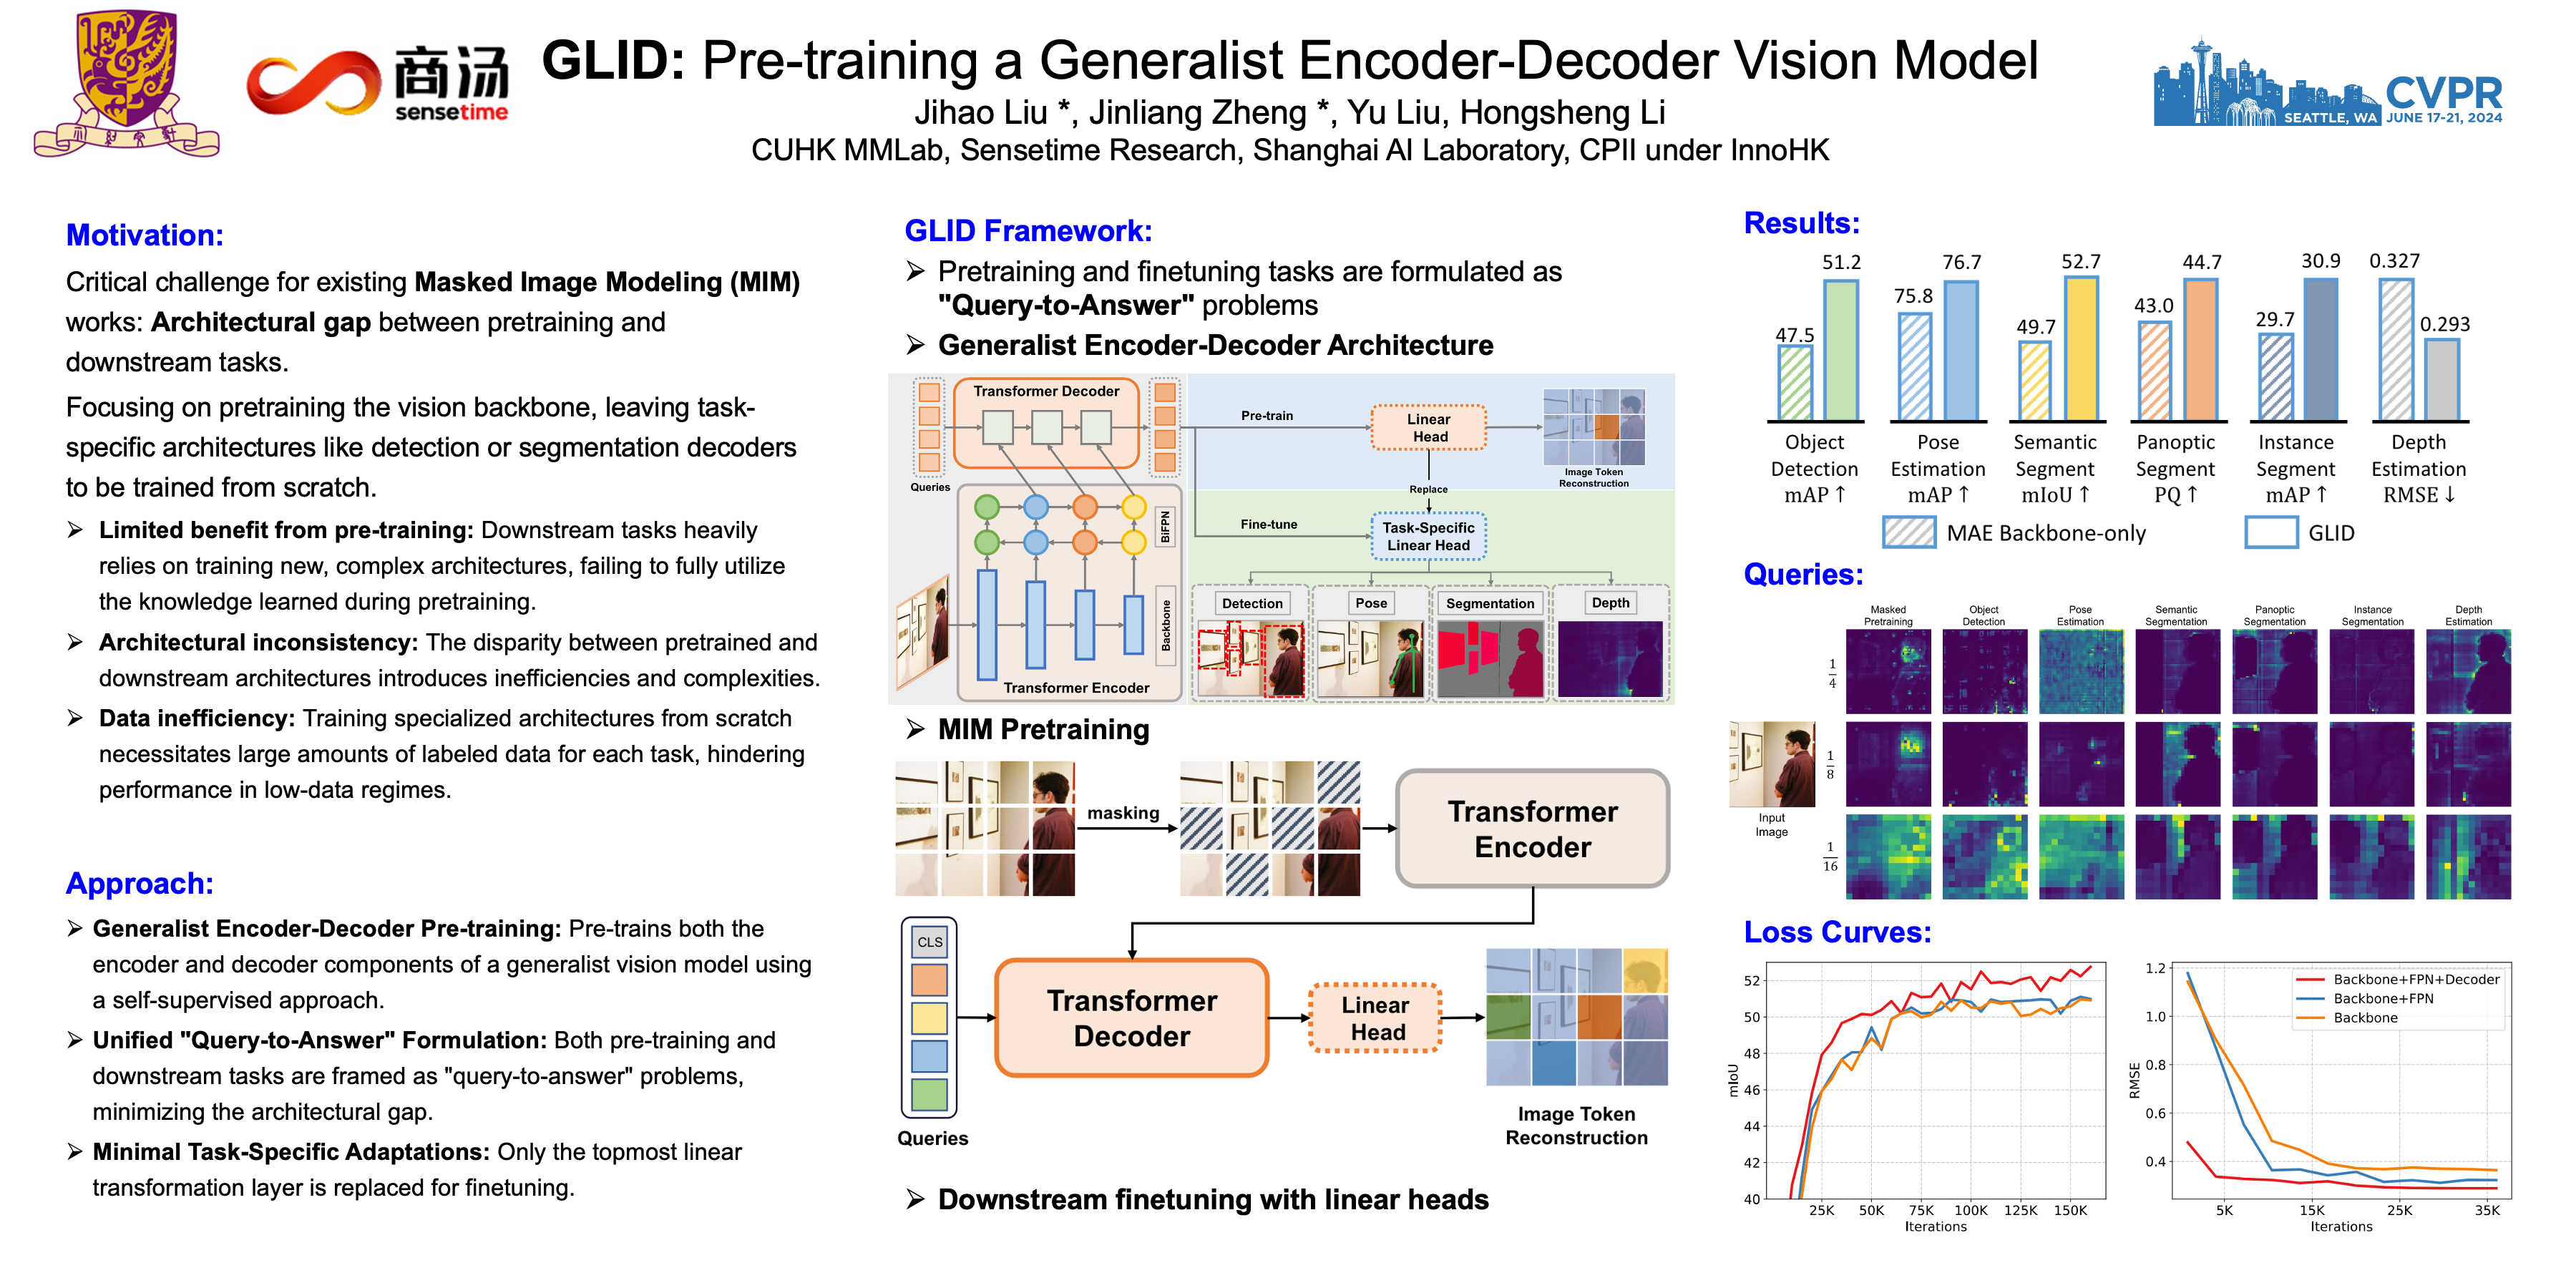
CVPR Poster GLID: Pre-training a Generalist Encoder-Decoder Vision Model
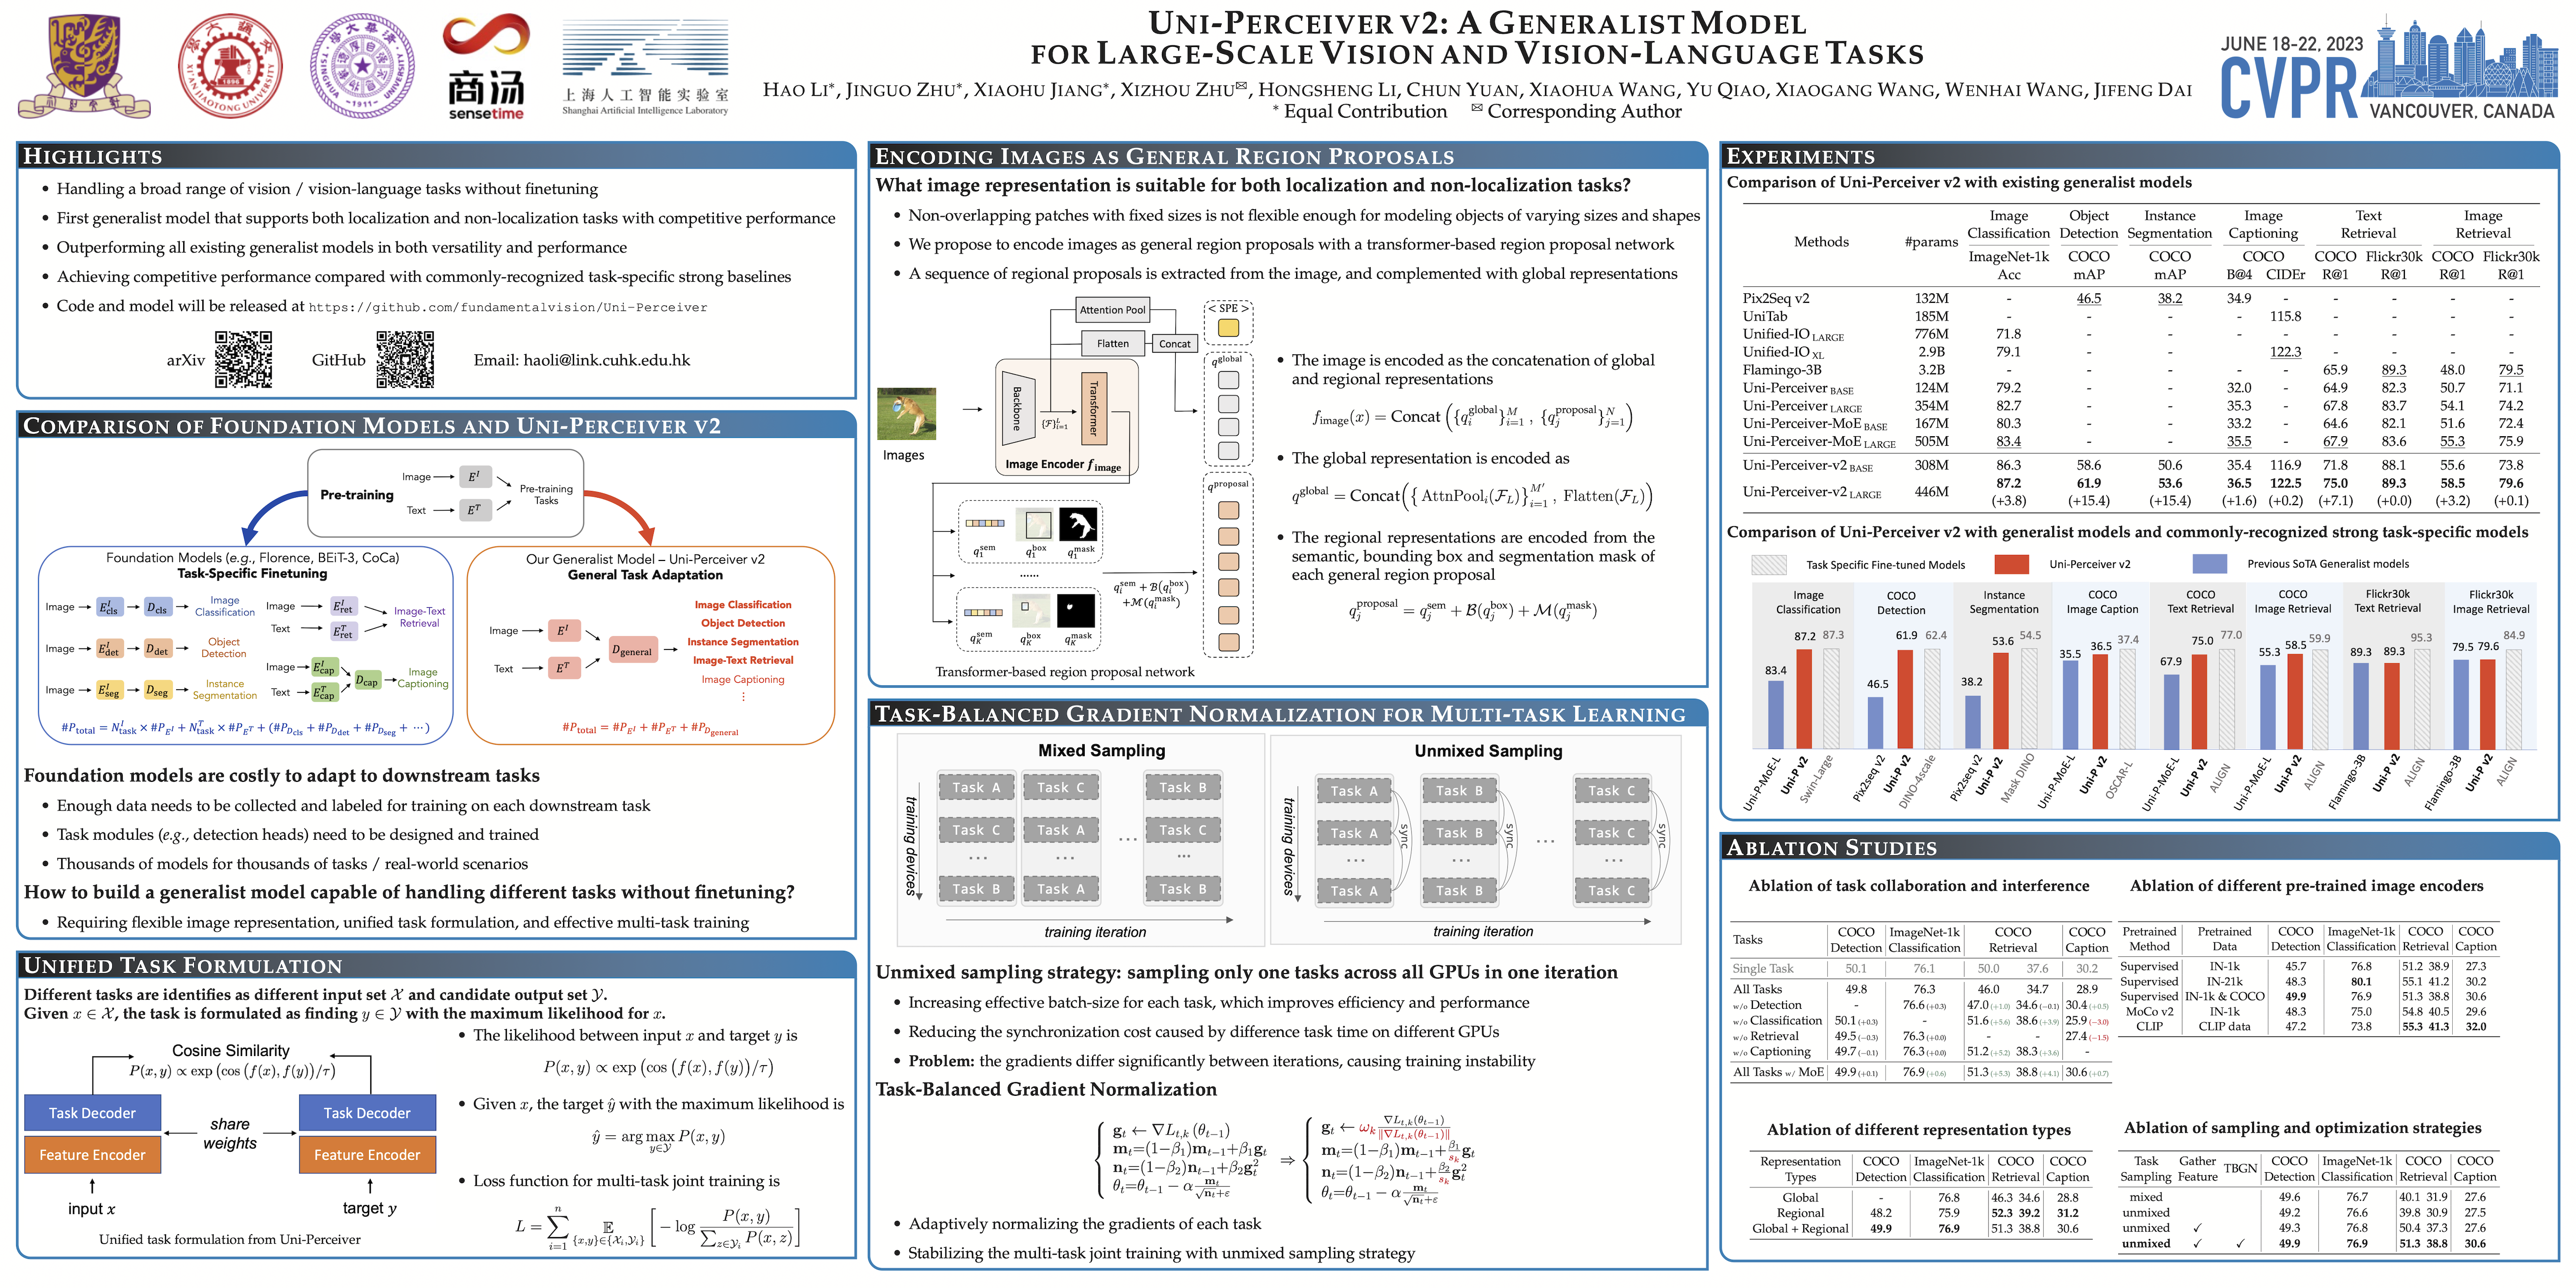
CVPR Poster Uni-Perceiver v2: A Generalist Model for Large-Scale Vision ...
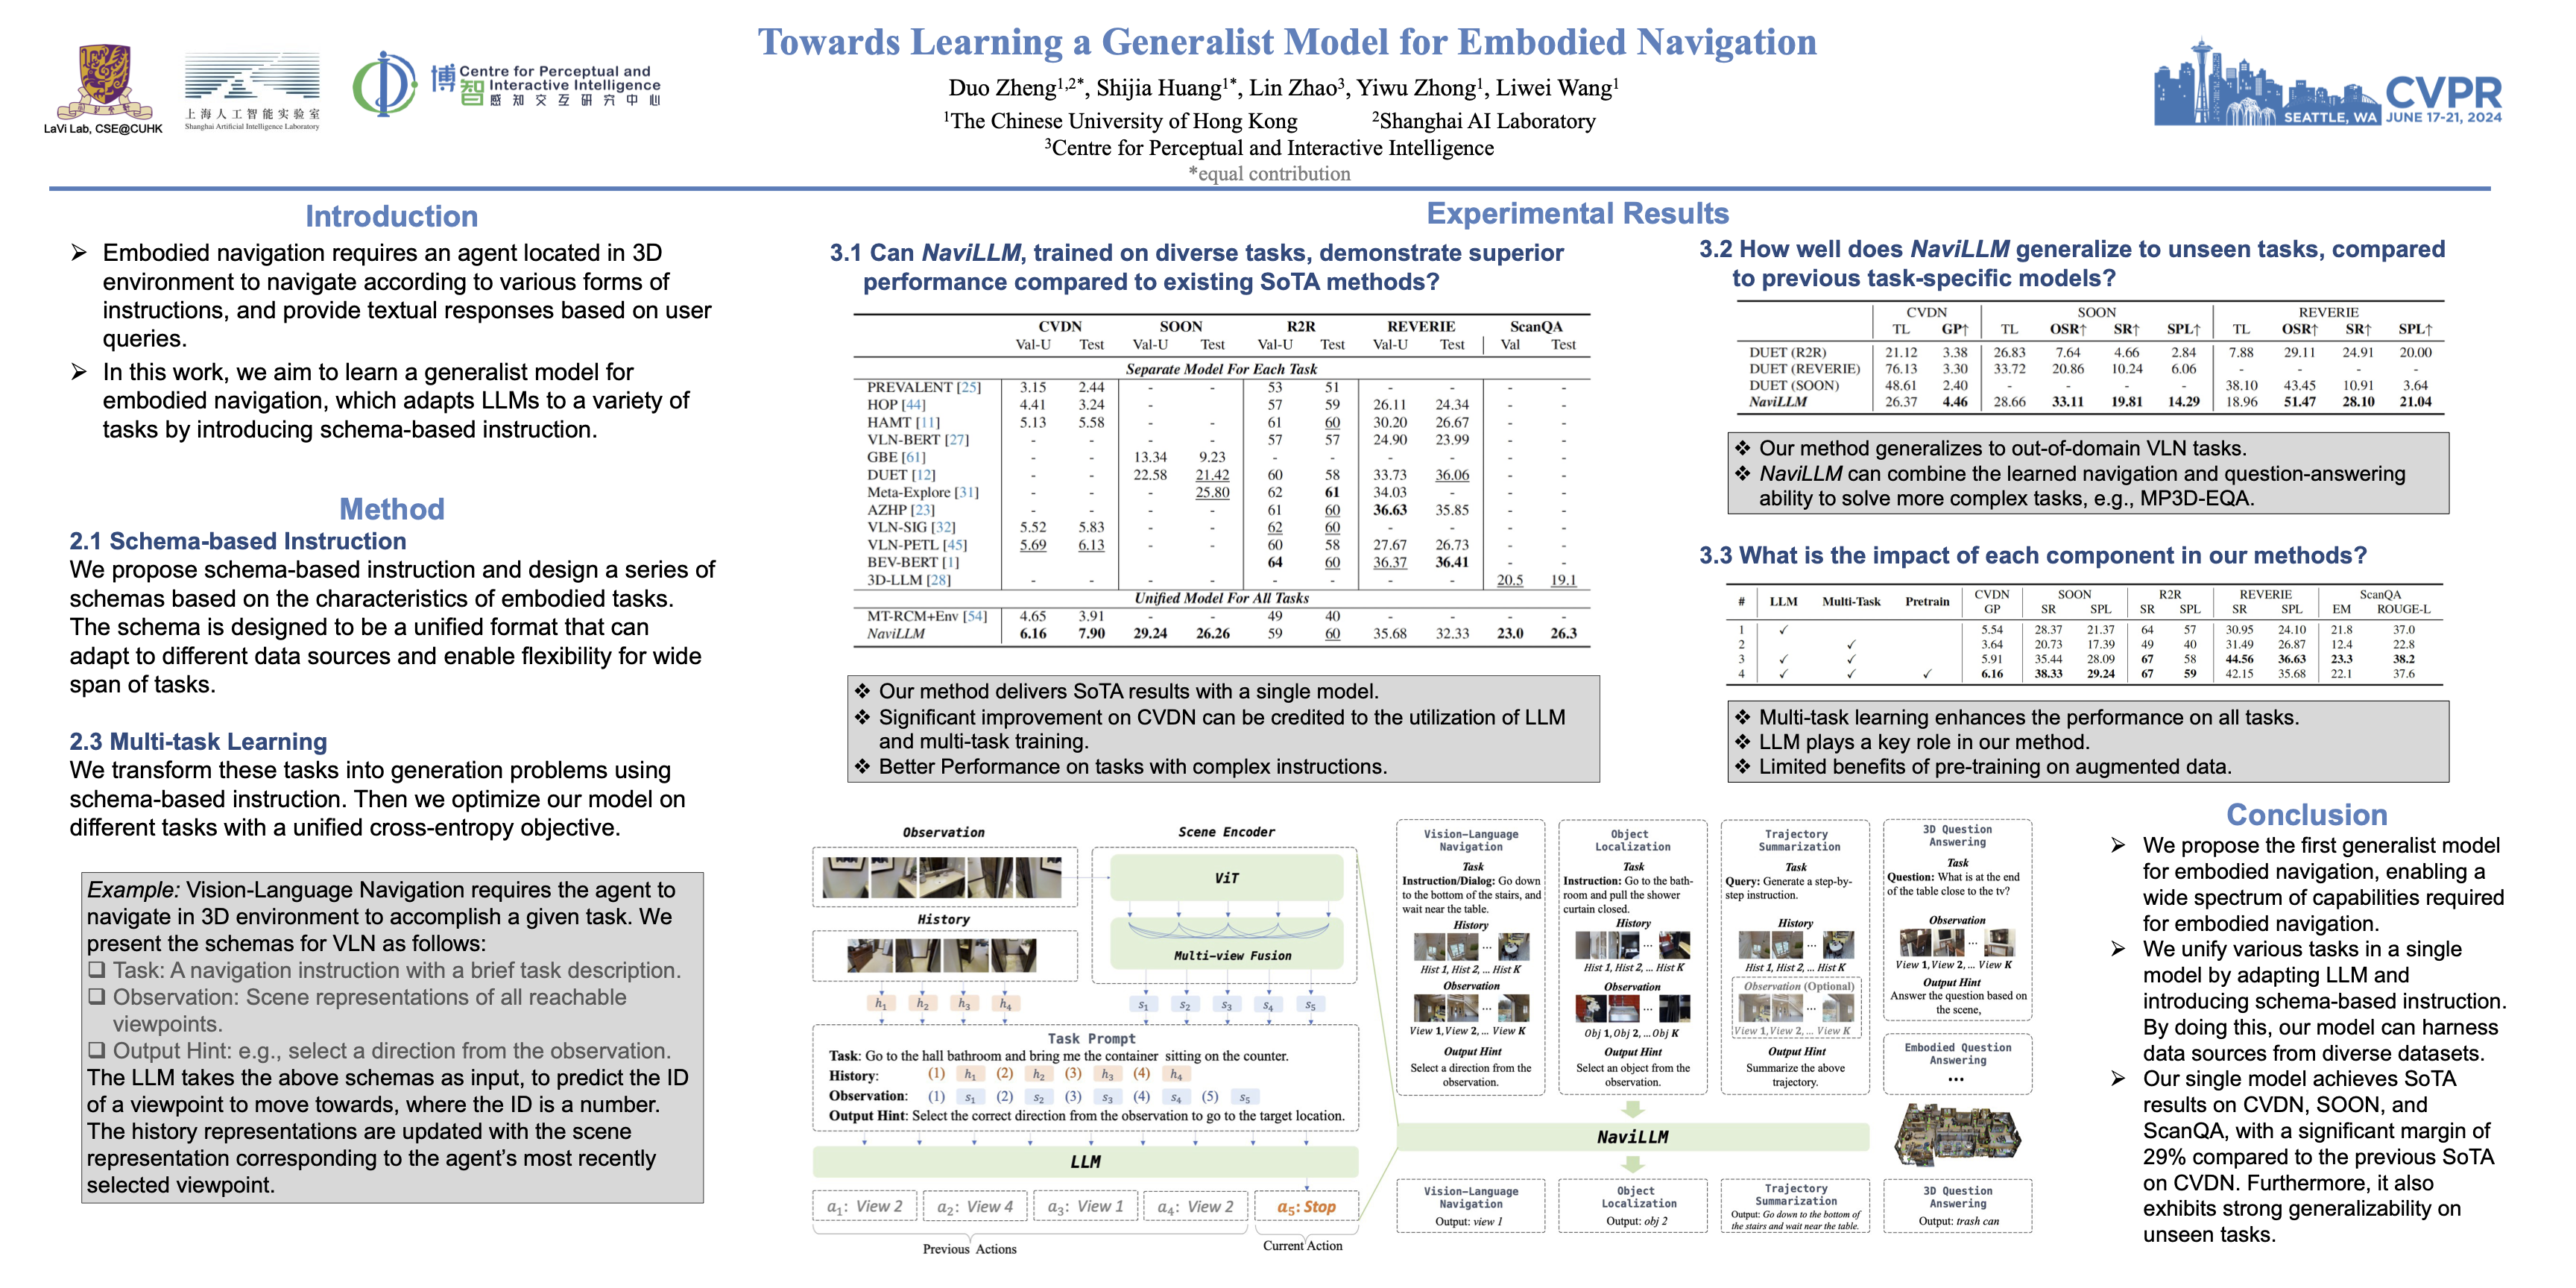
CVPR Poster Towards Learning a Generalist Model for Embodied Navigation
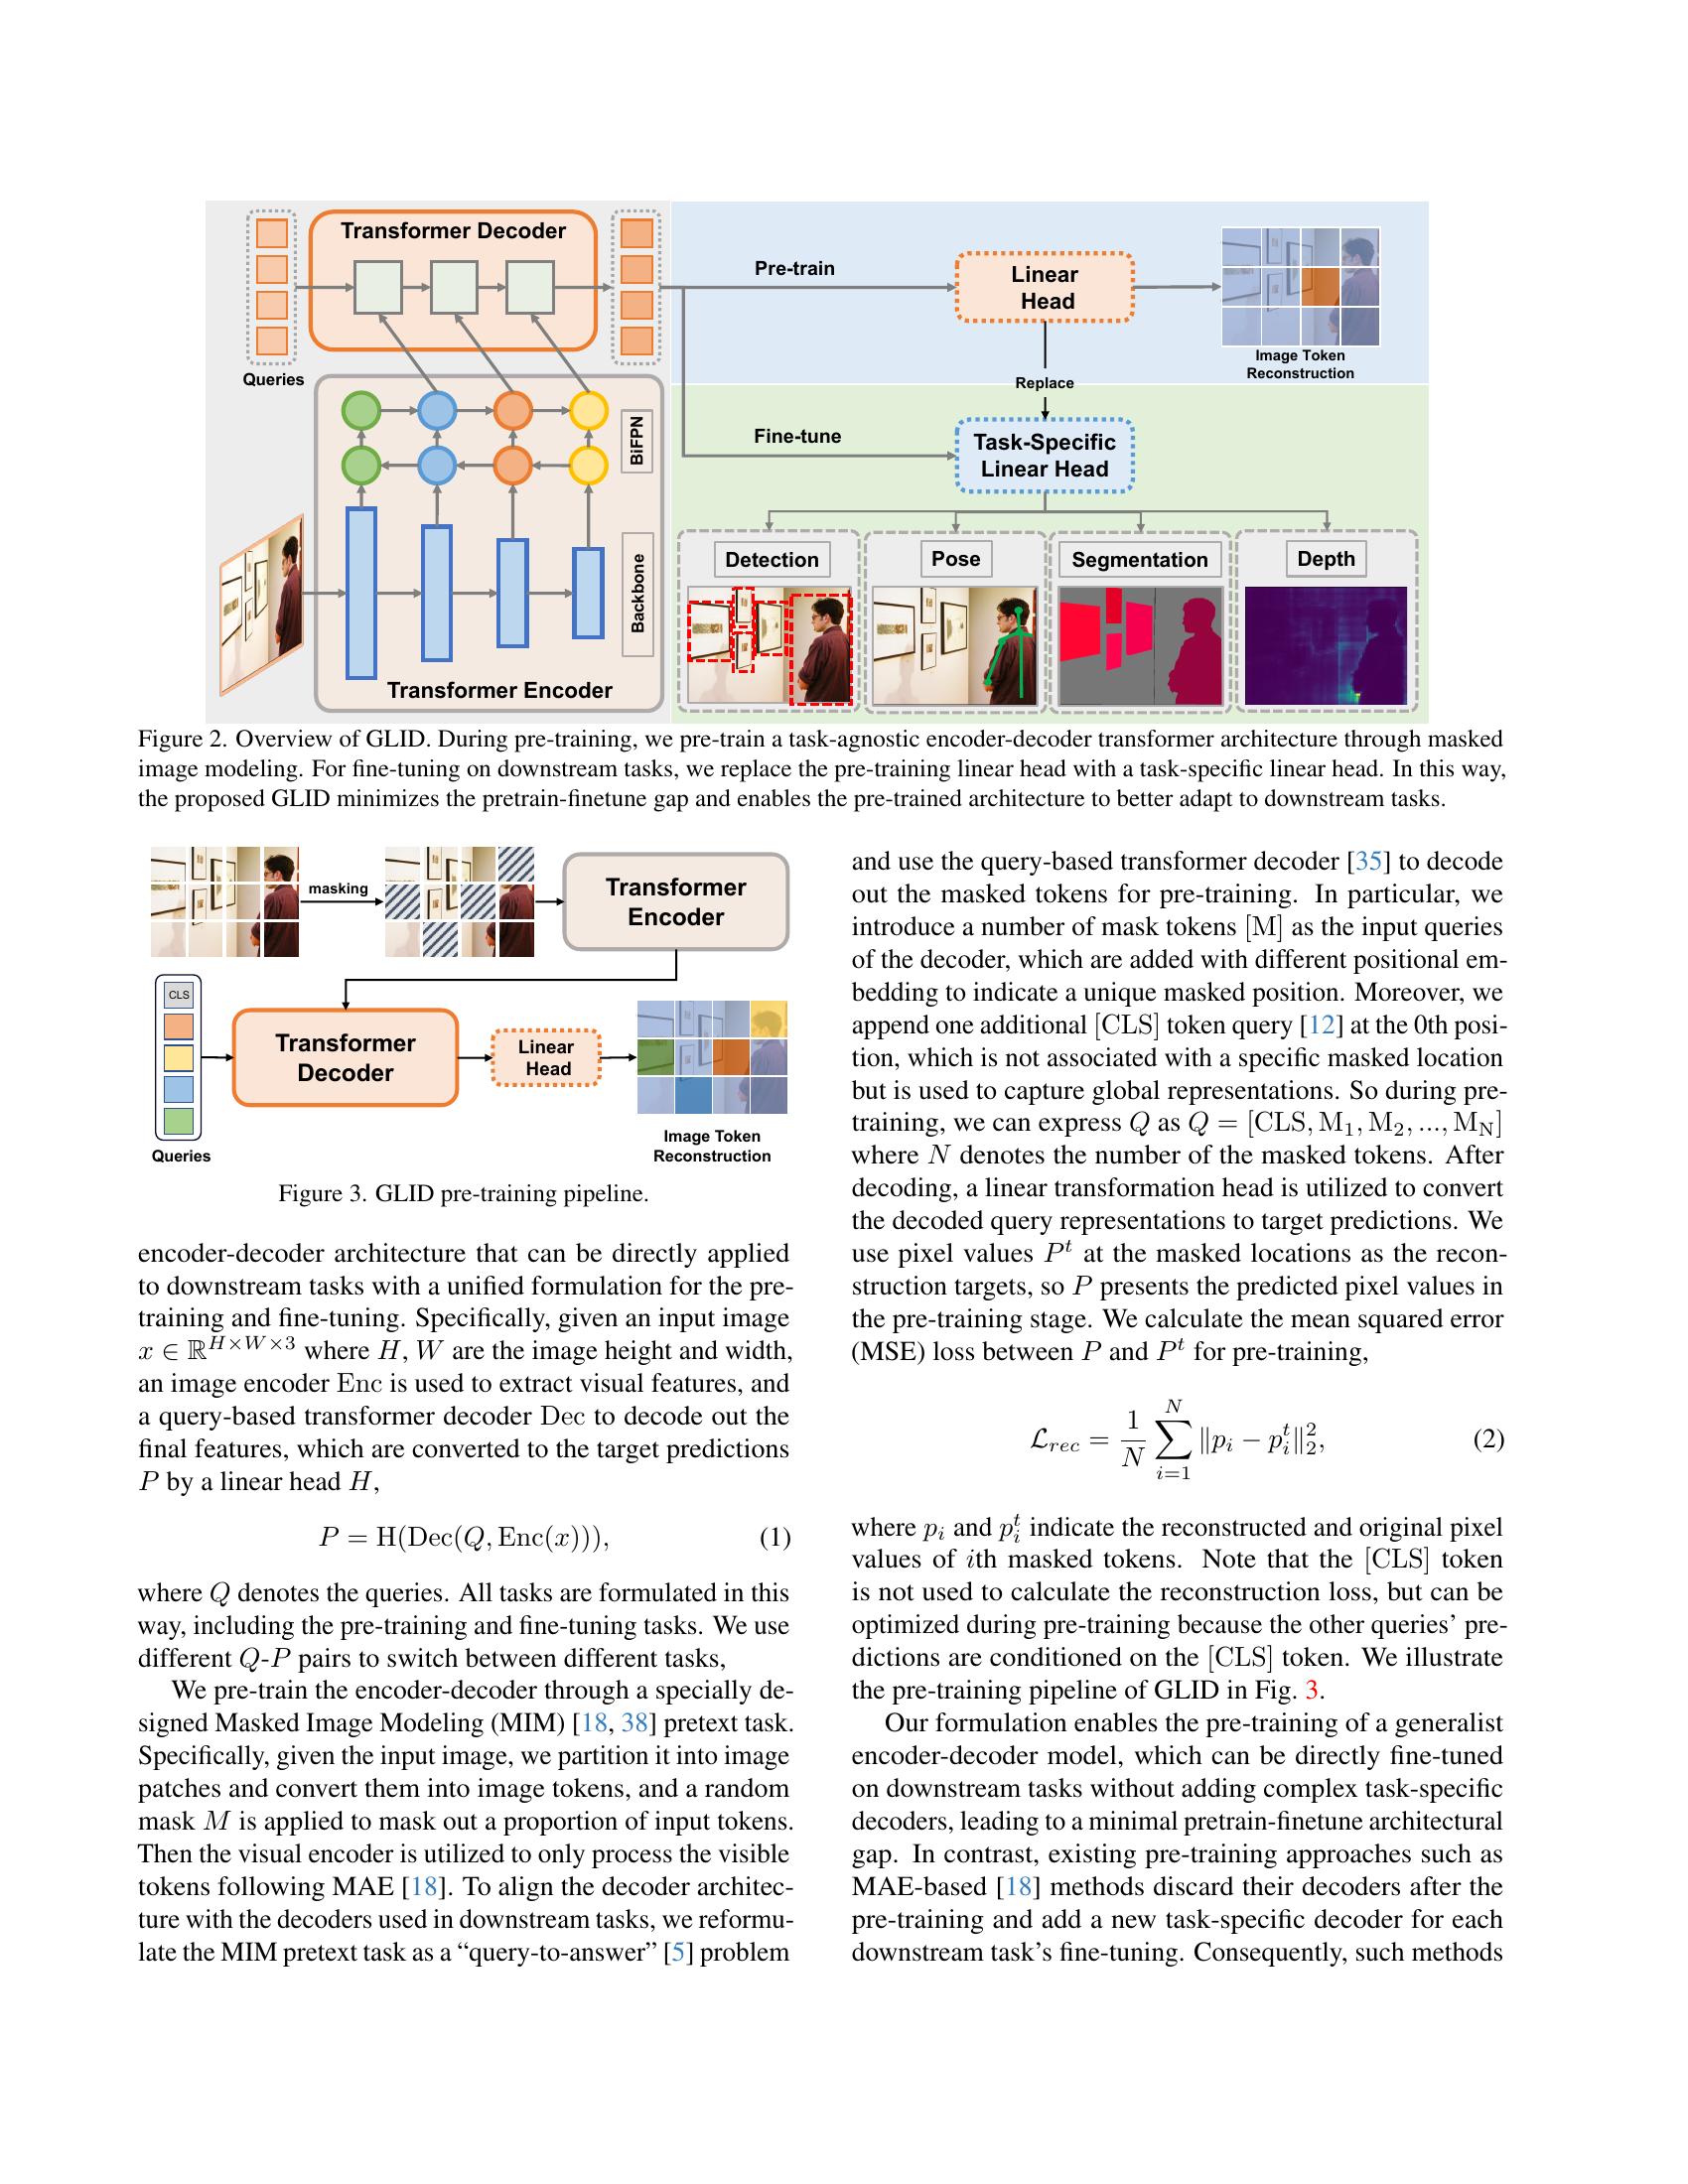
GLID: Pre-training a Generalist Encoder-Decoder Vision Model - 智源社区论文

GLID: Pre-training a Generalist Encoder-Decoder Vision Model | AI ...
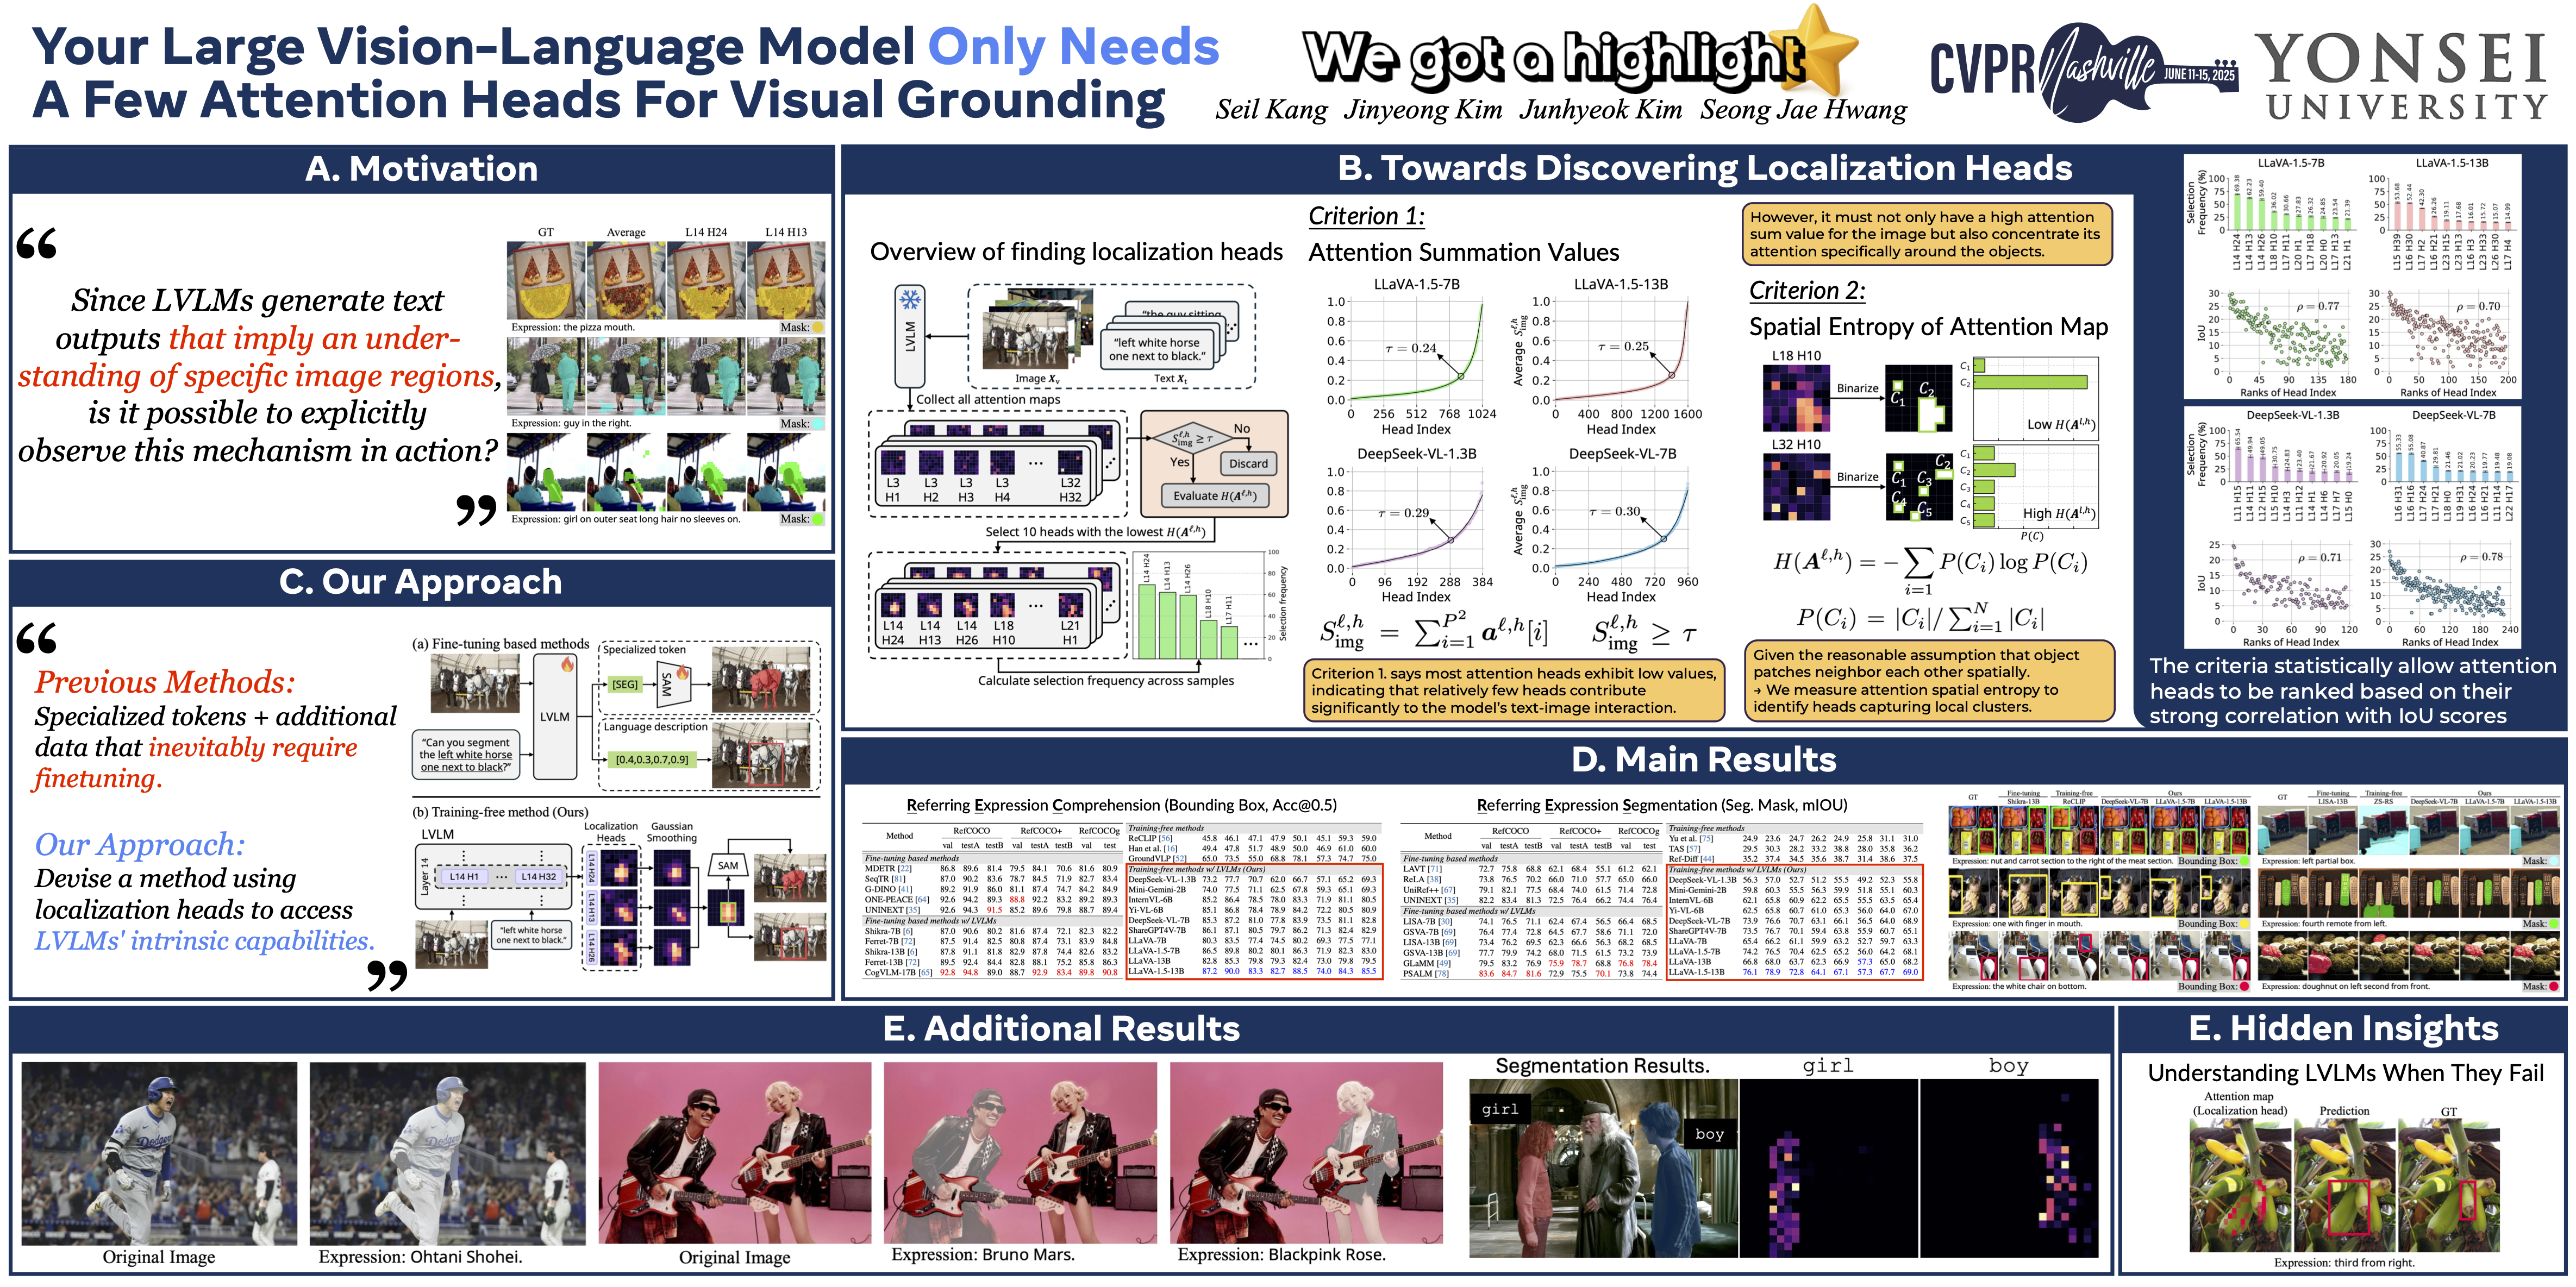
CVPR Poster Your Large Vision-Language Model Only Needs A Few Attention ...

[논문 리뷰] GLID: Pre-training a Generalist Encoder-Decoder Vision Model
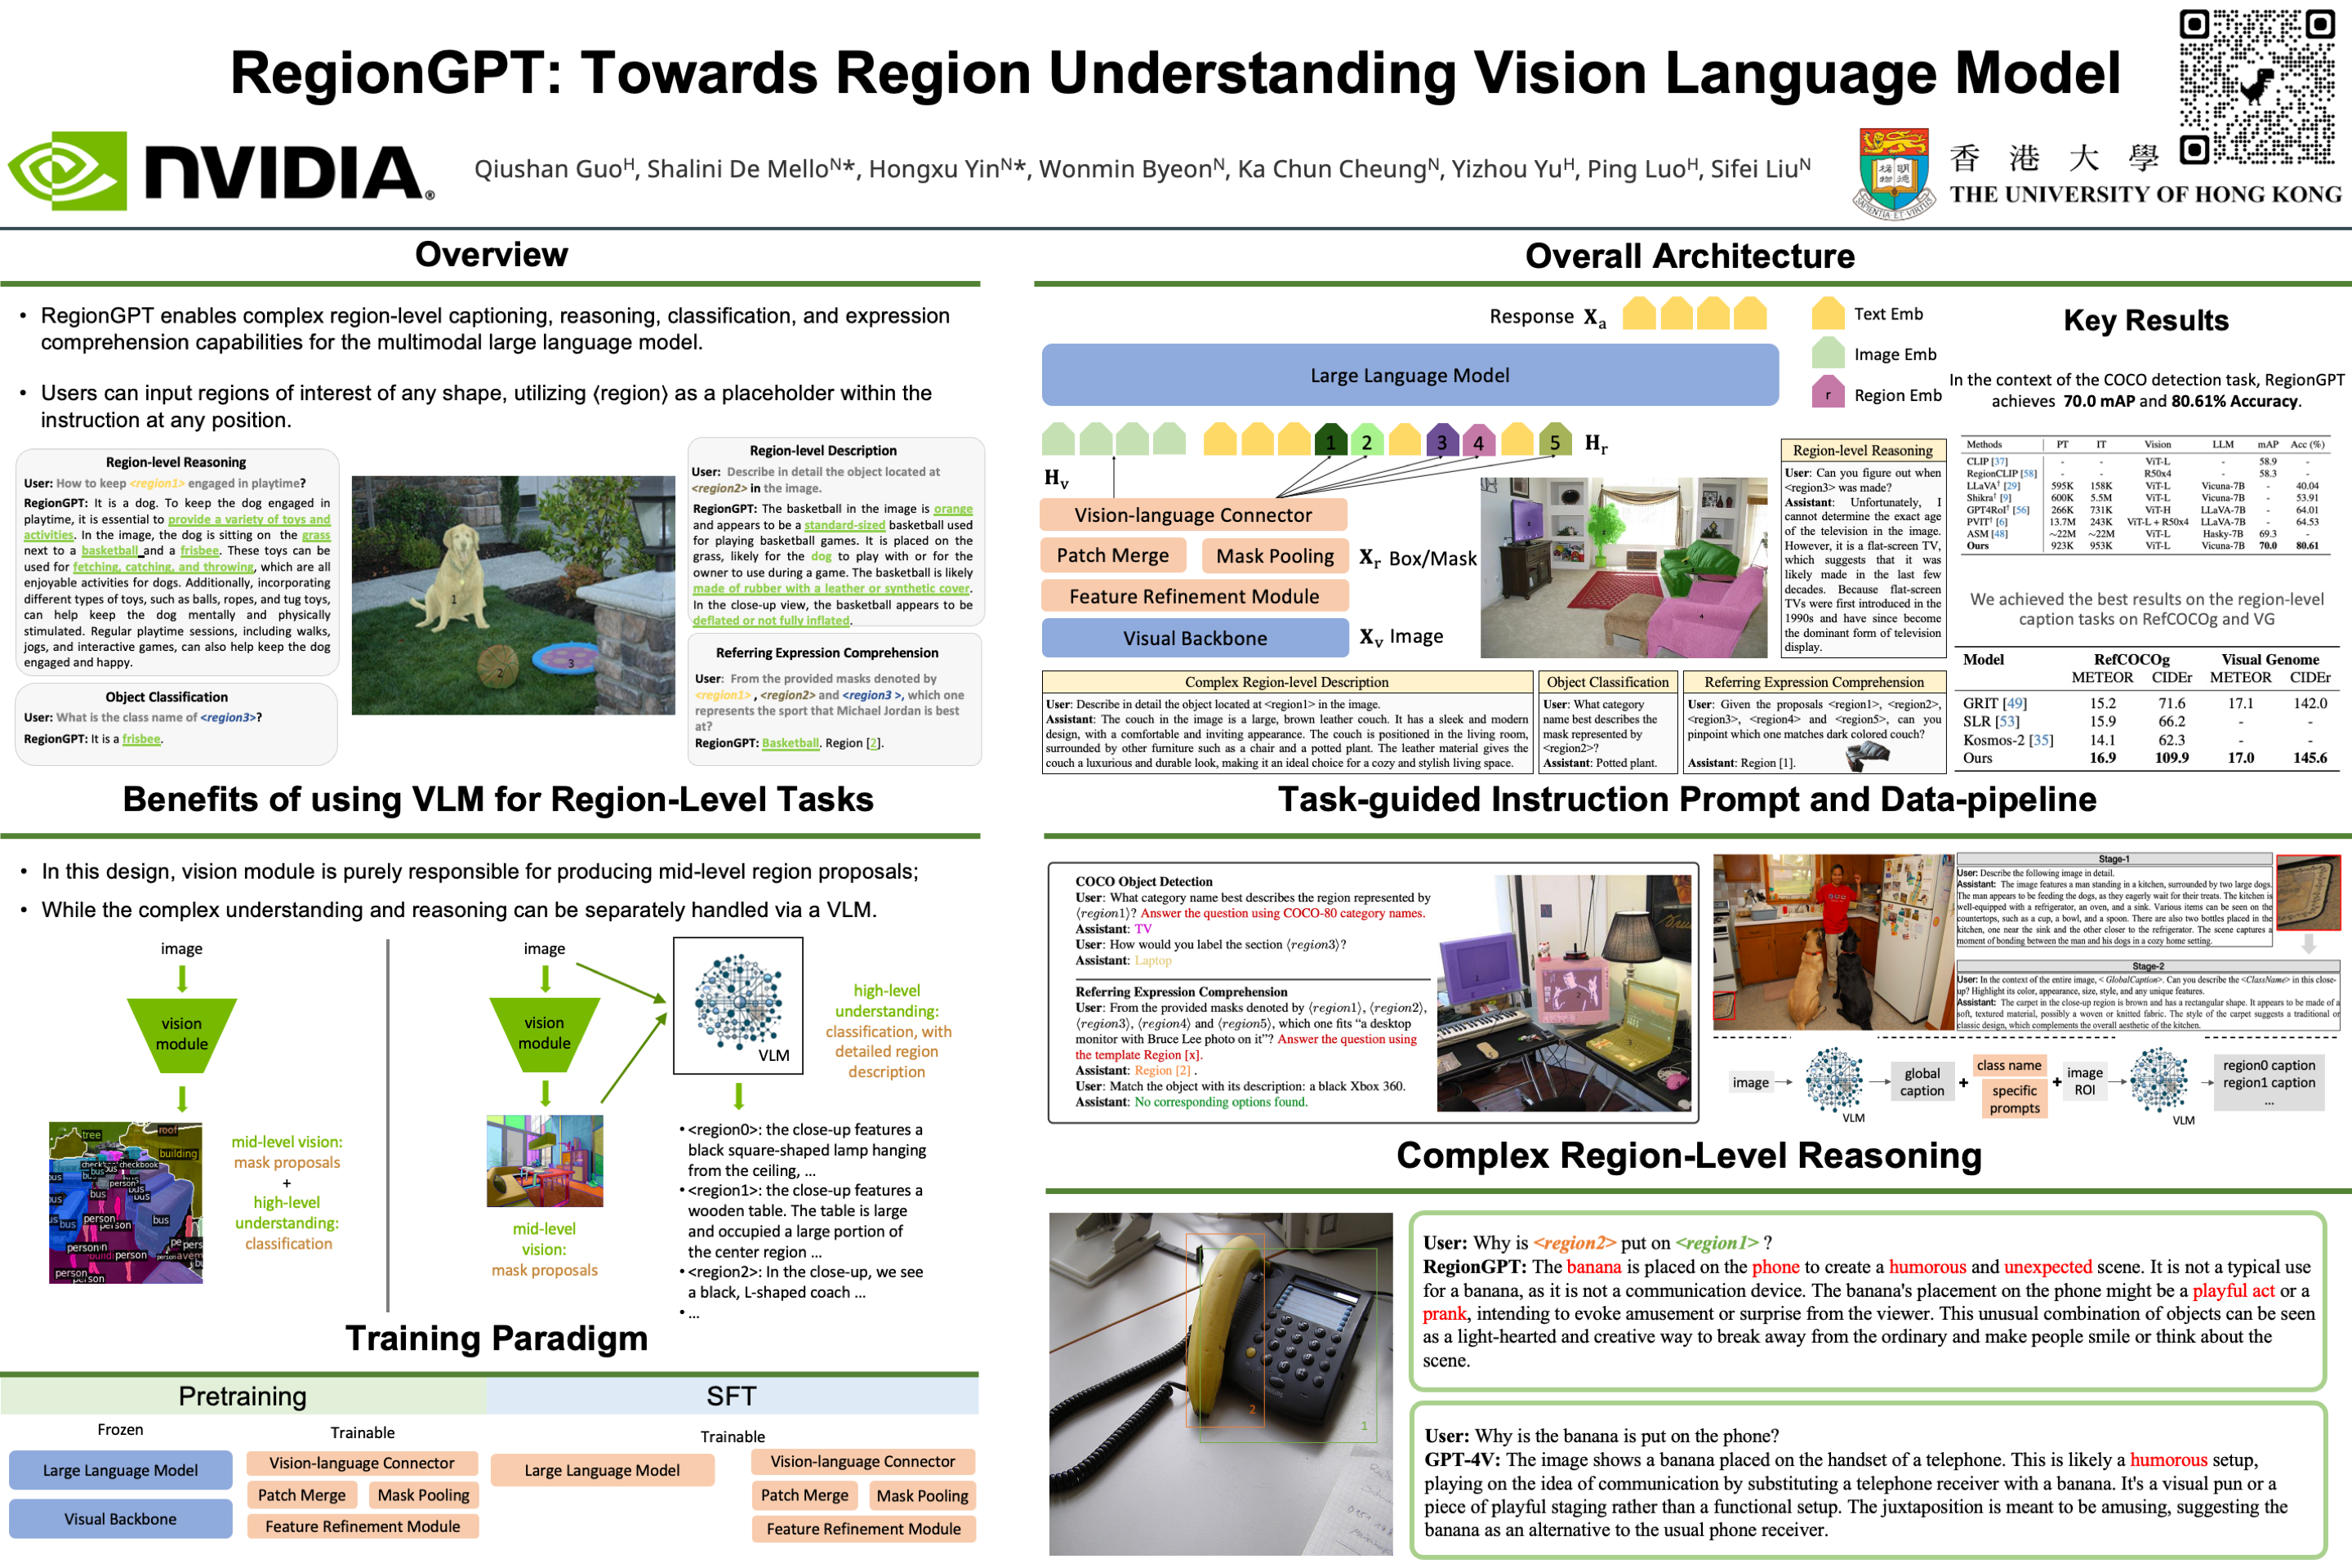
CVPR Poster RegionGPT: Towards Region Understanding Vision Language Model
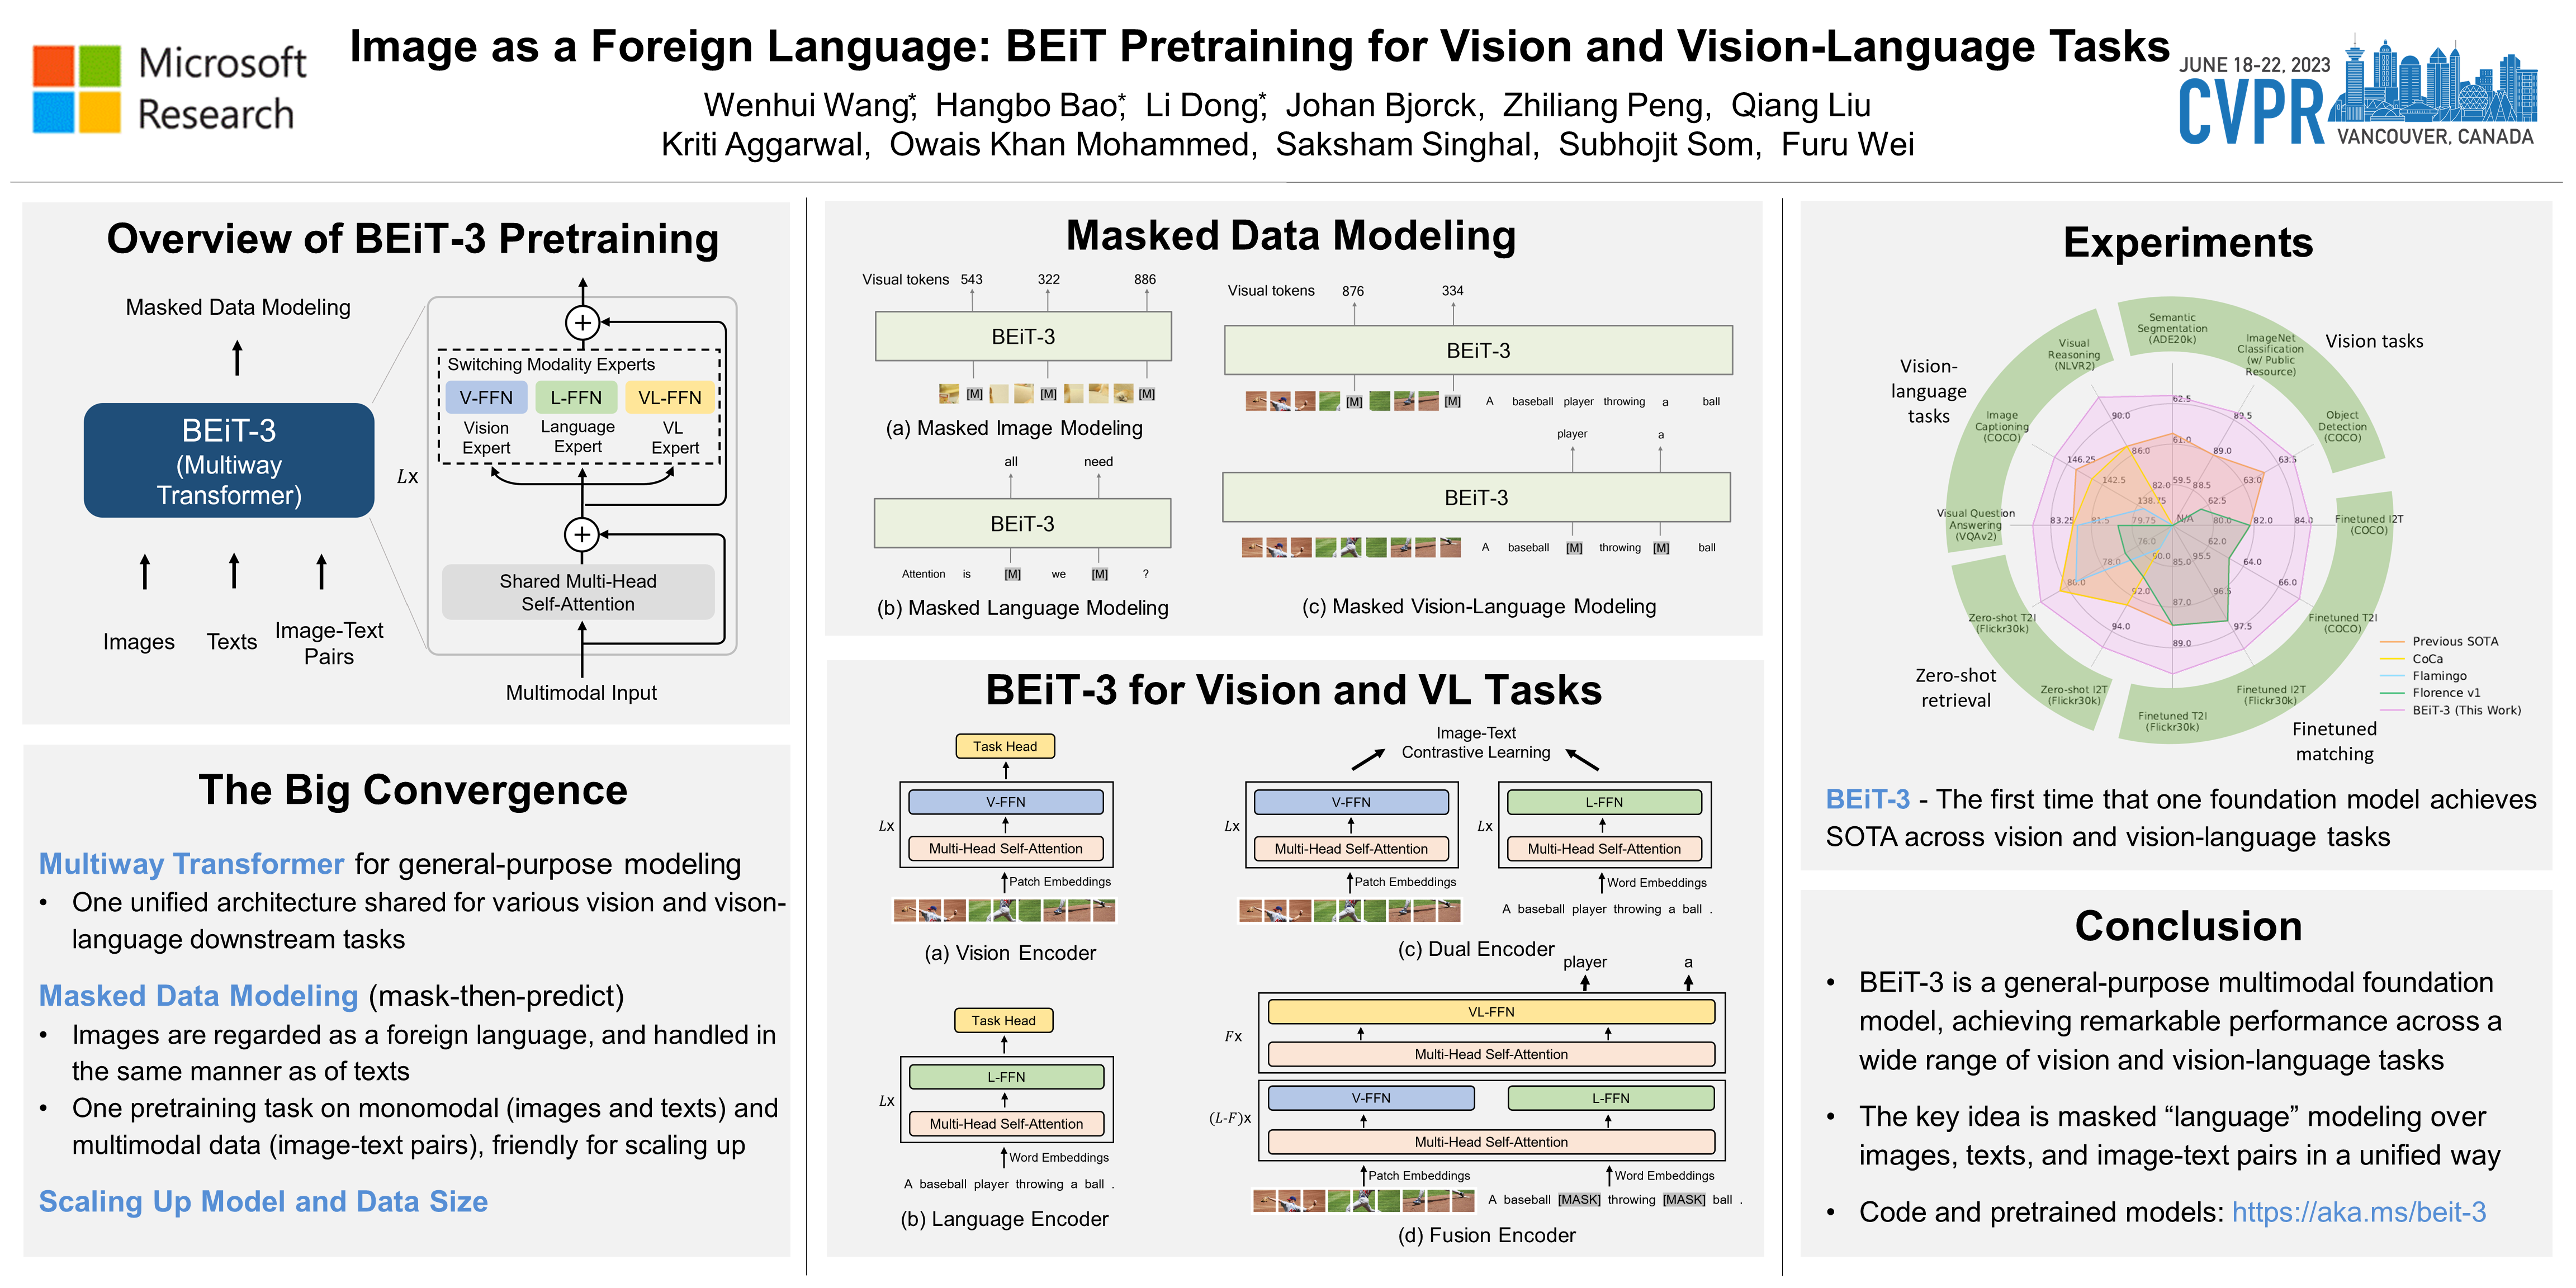
CVPR Poster Image as a Foreign Language: BEiT Pretraining for Vision ...
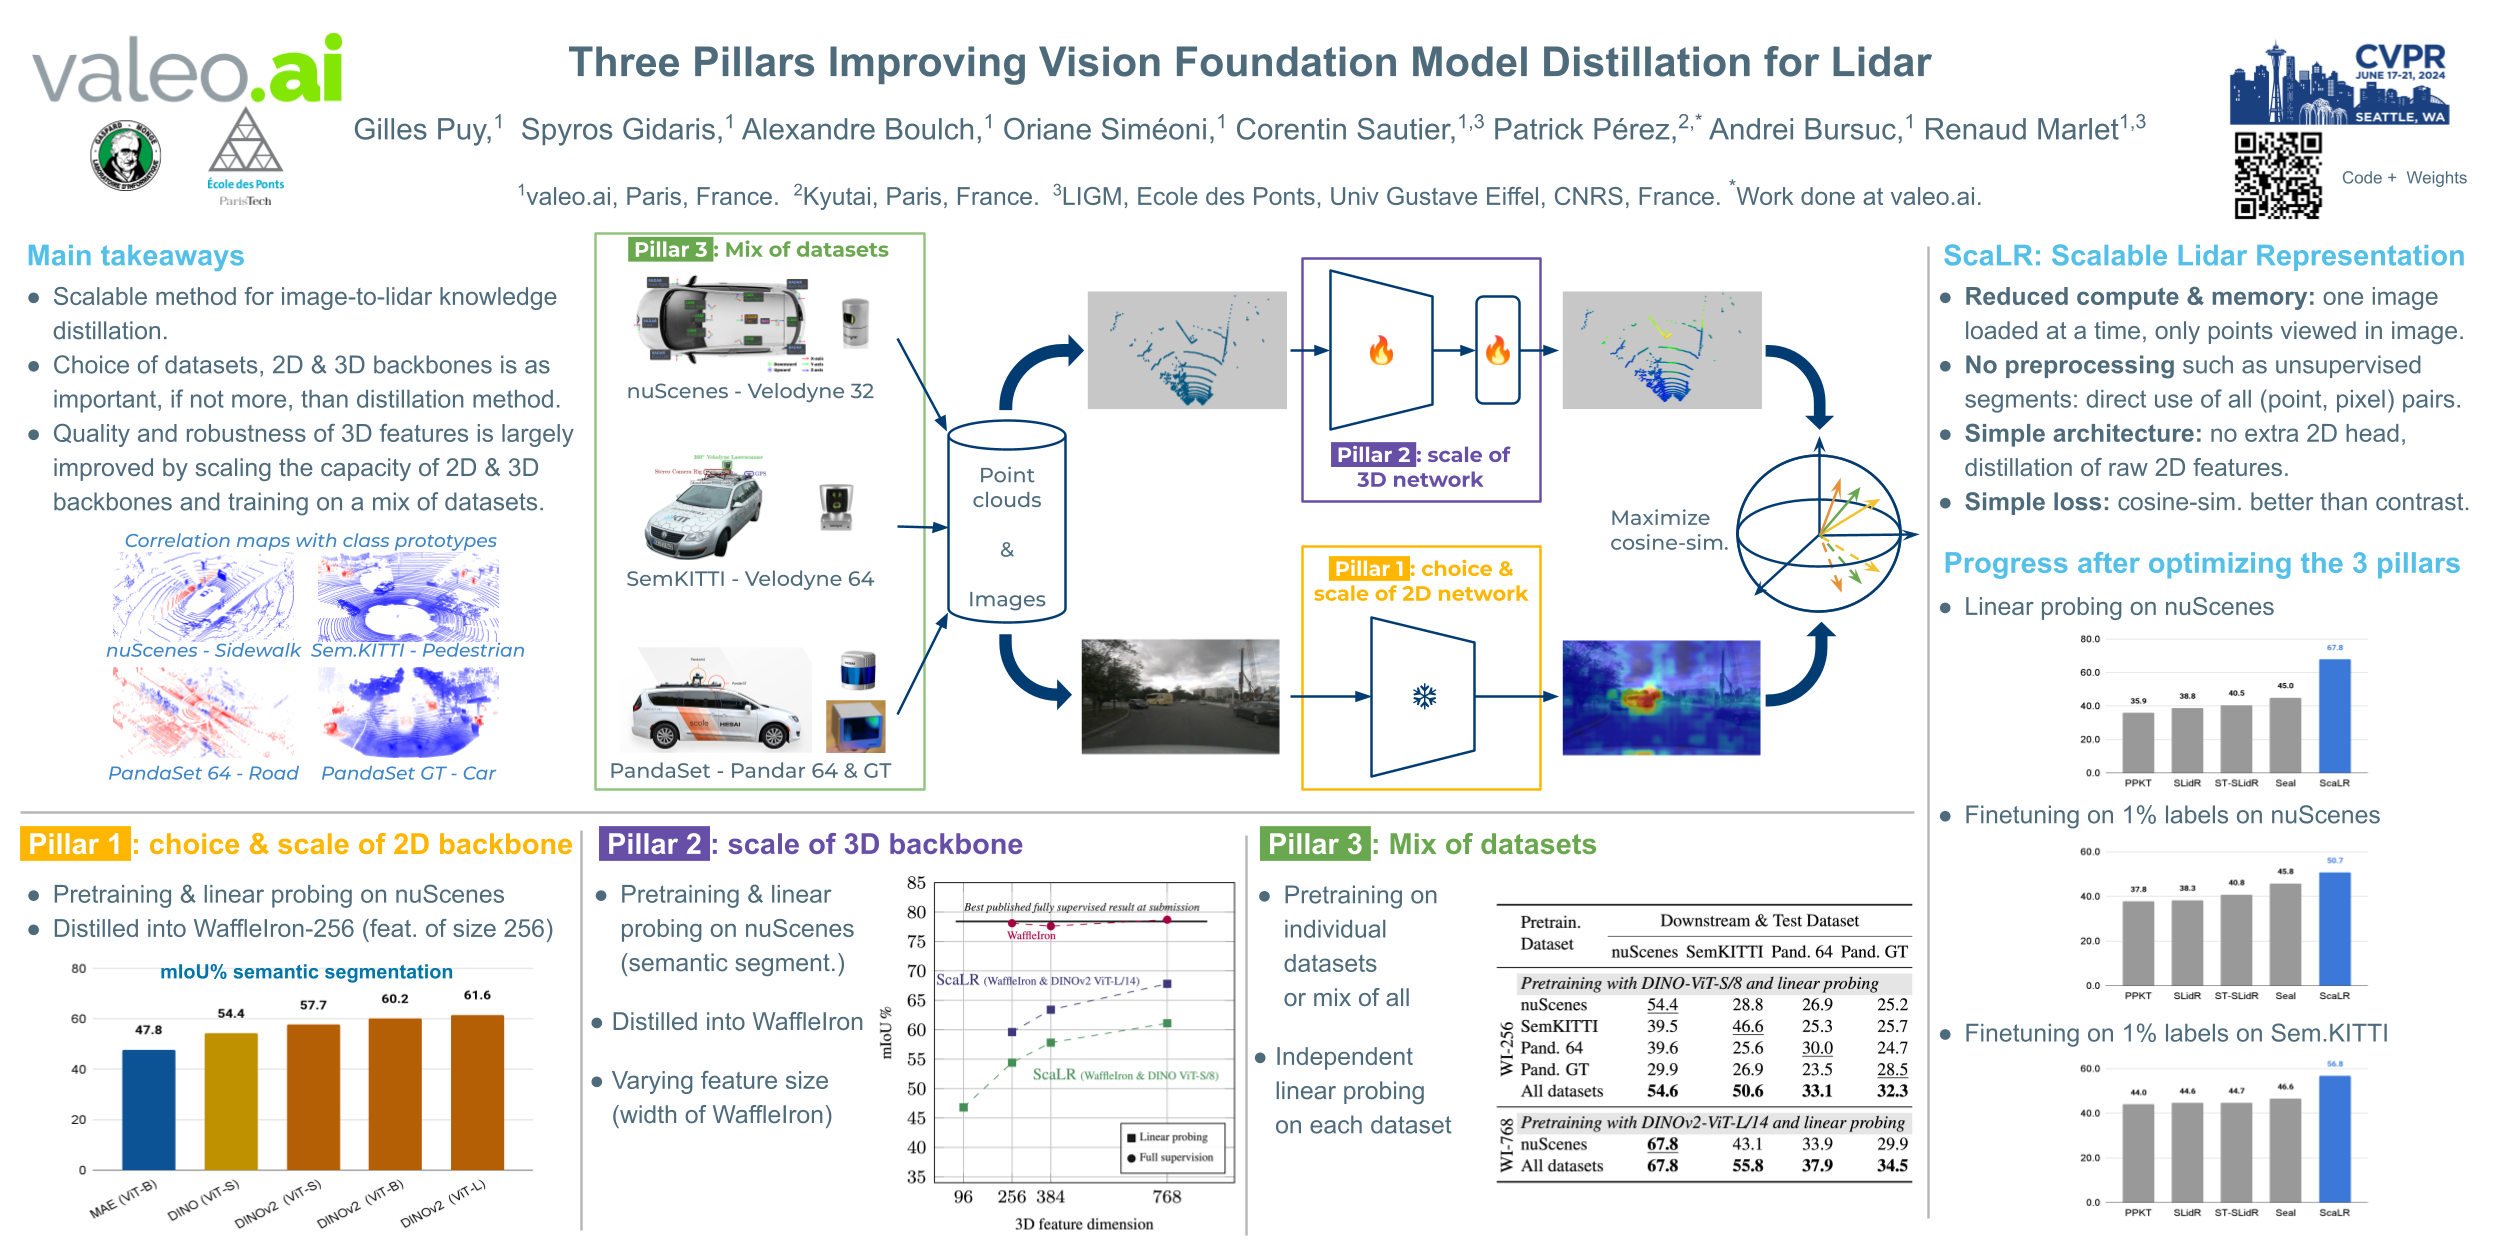
CVPR Poster Three Pillars Improving Vision Foundation Model ...
Advertisement Space (300x250)
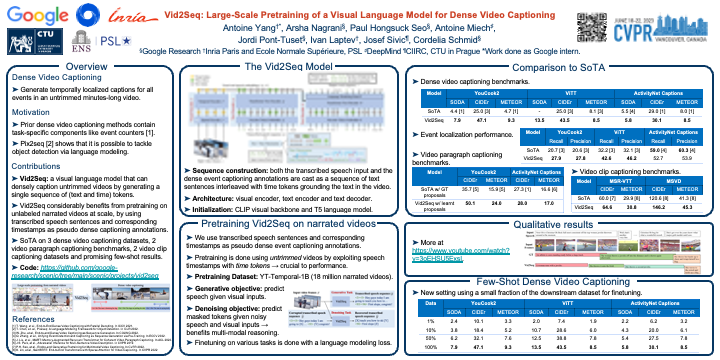
CVPR Poster Vid2Seq: Large-Scale Pretraining of a Visual Language Model ...
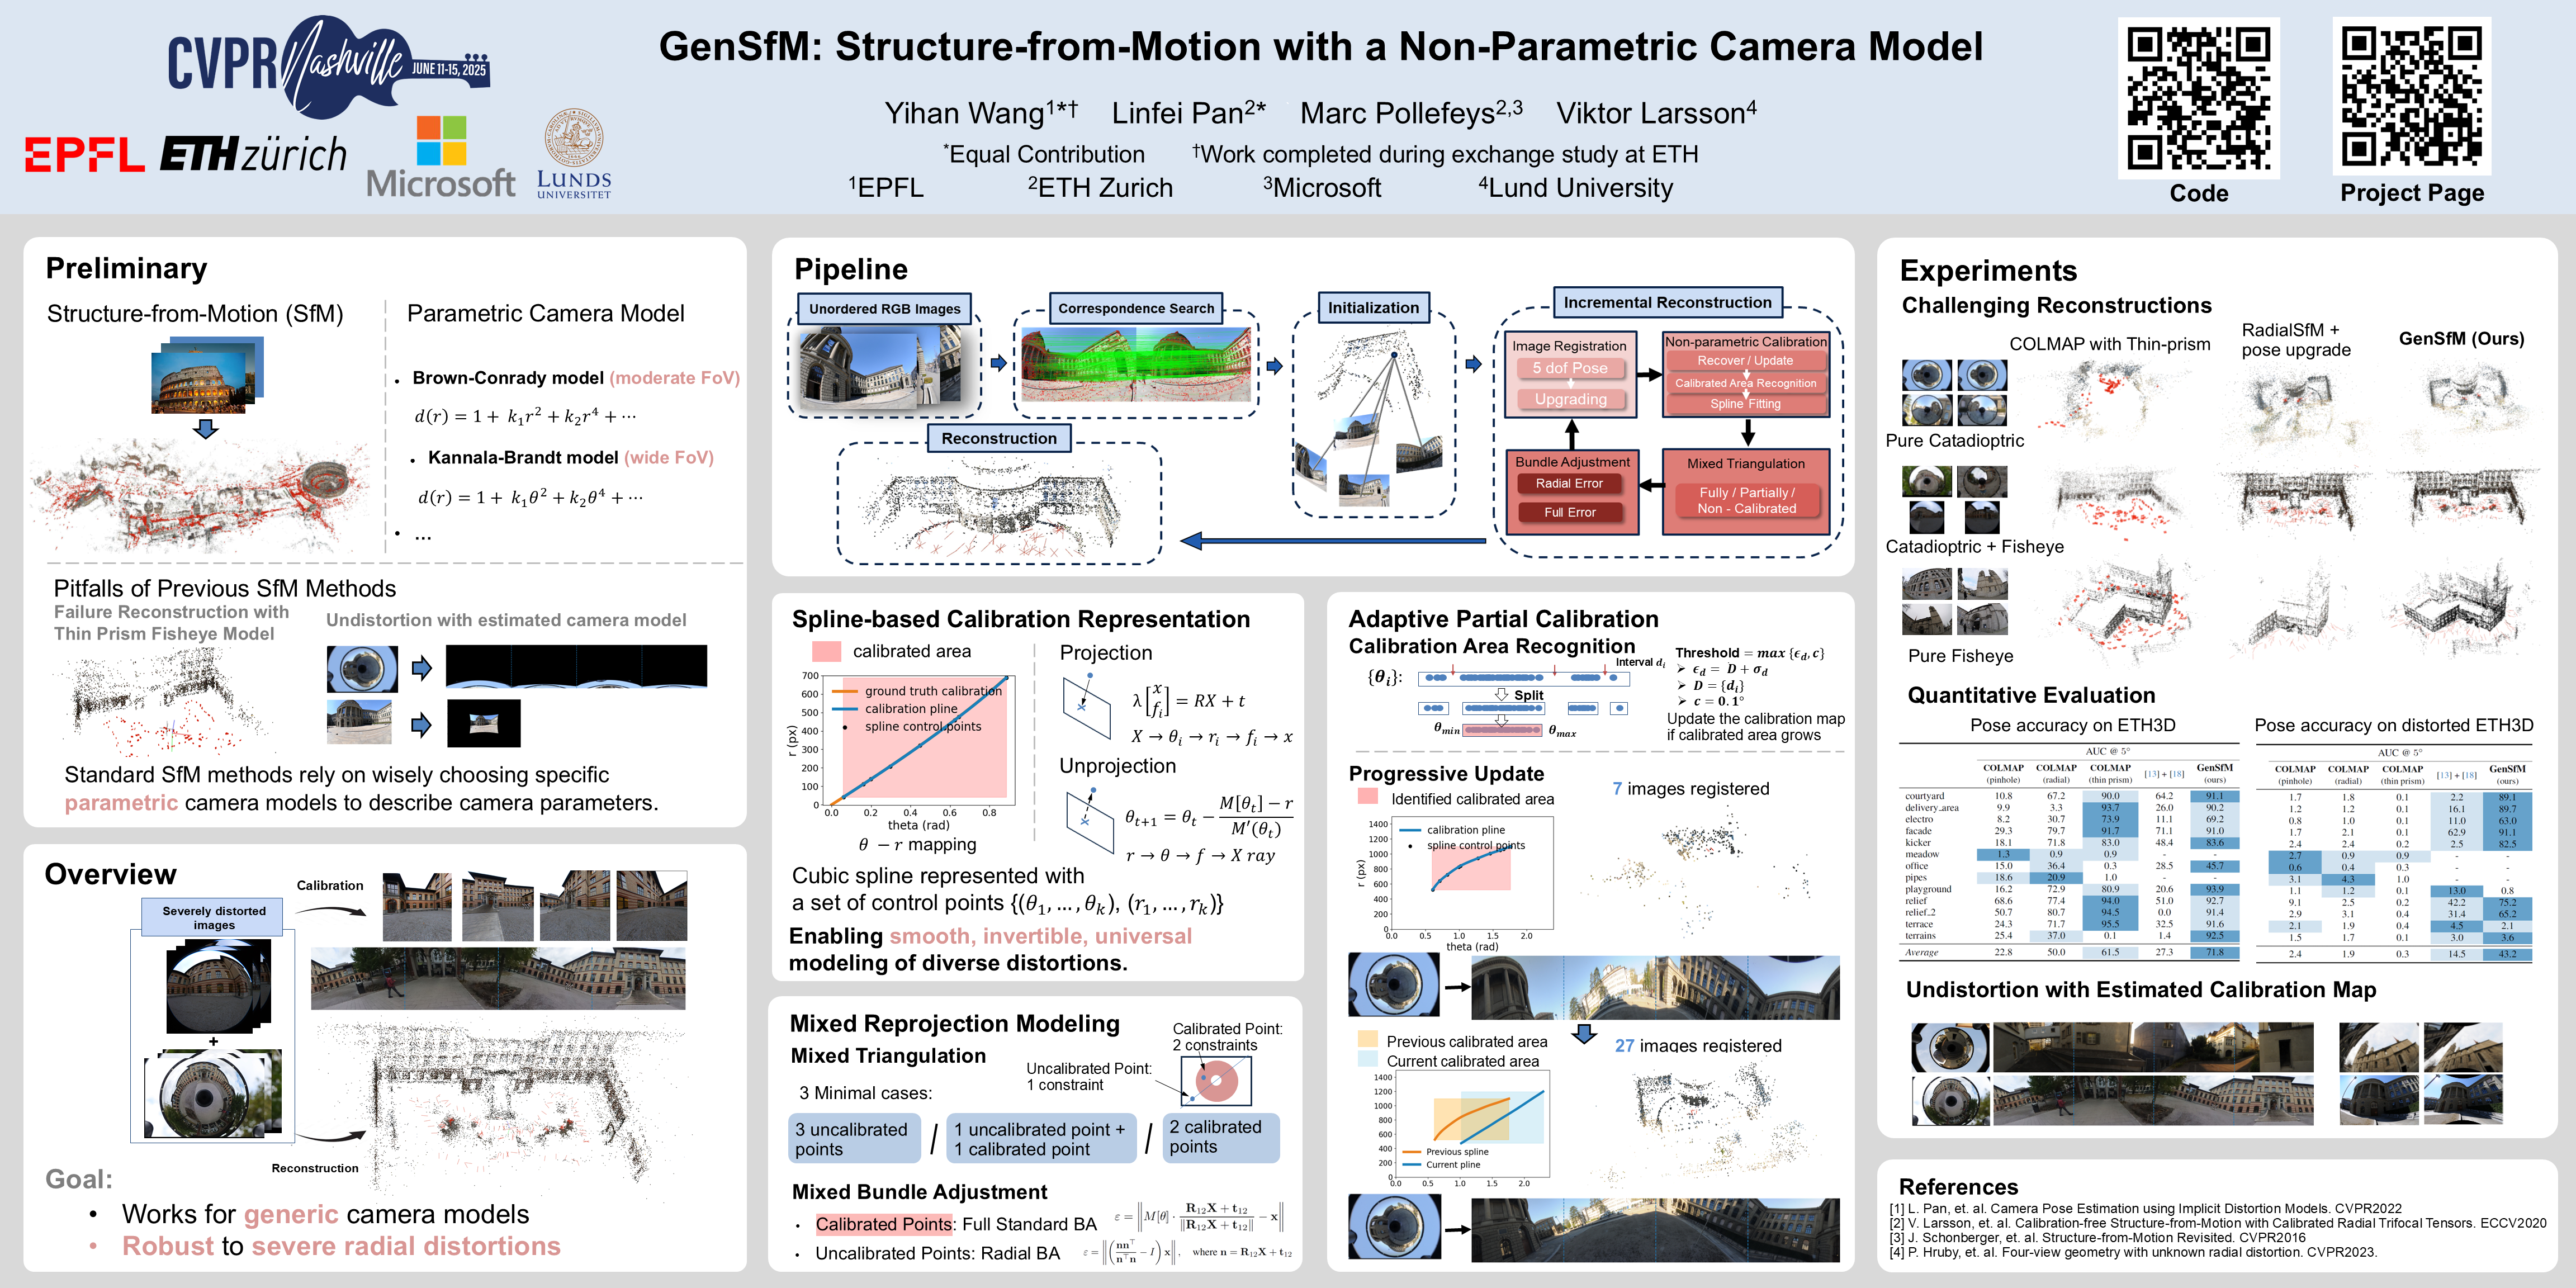
CVPR Poster Structure-from-Motion with a Non-Parametric Camera Model
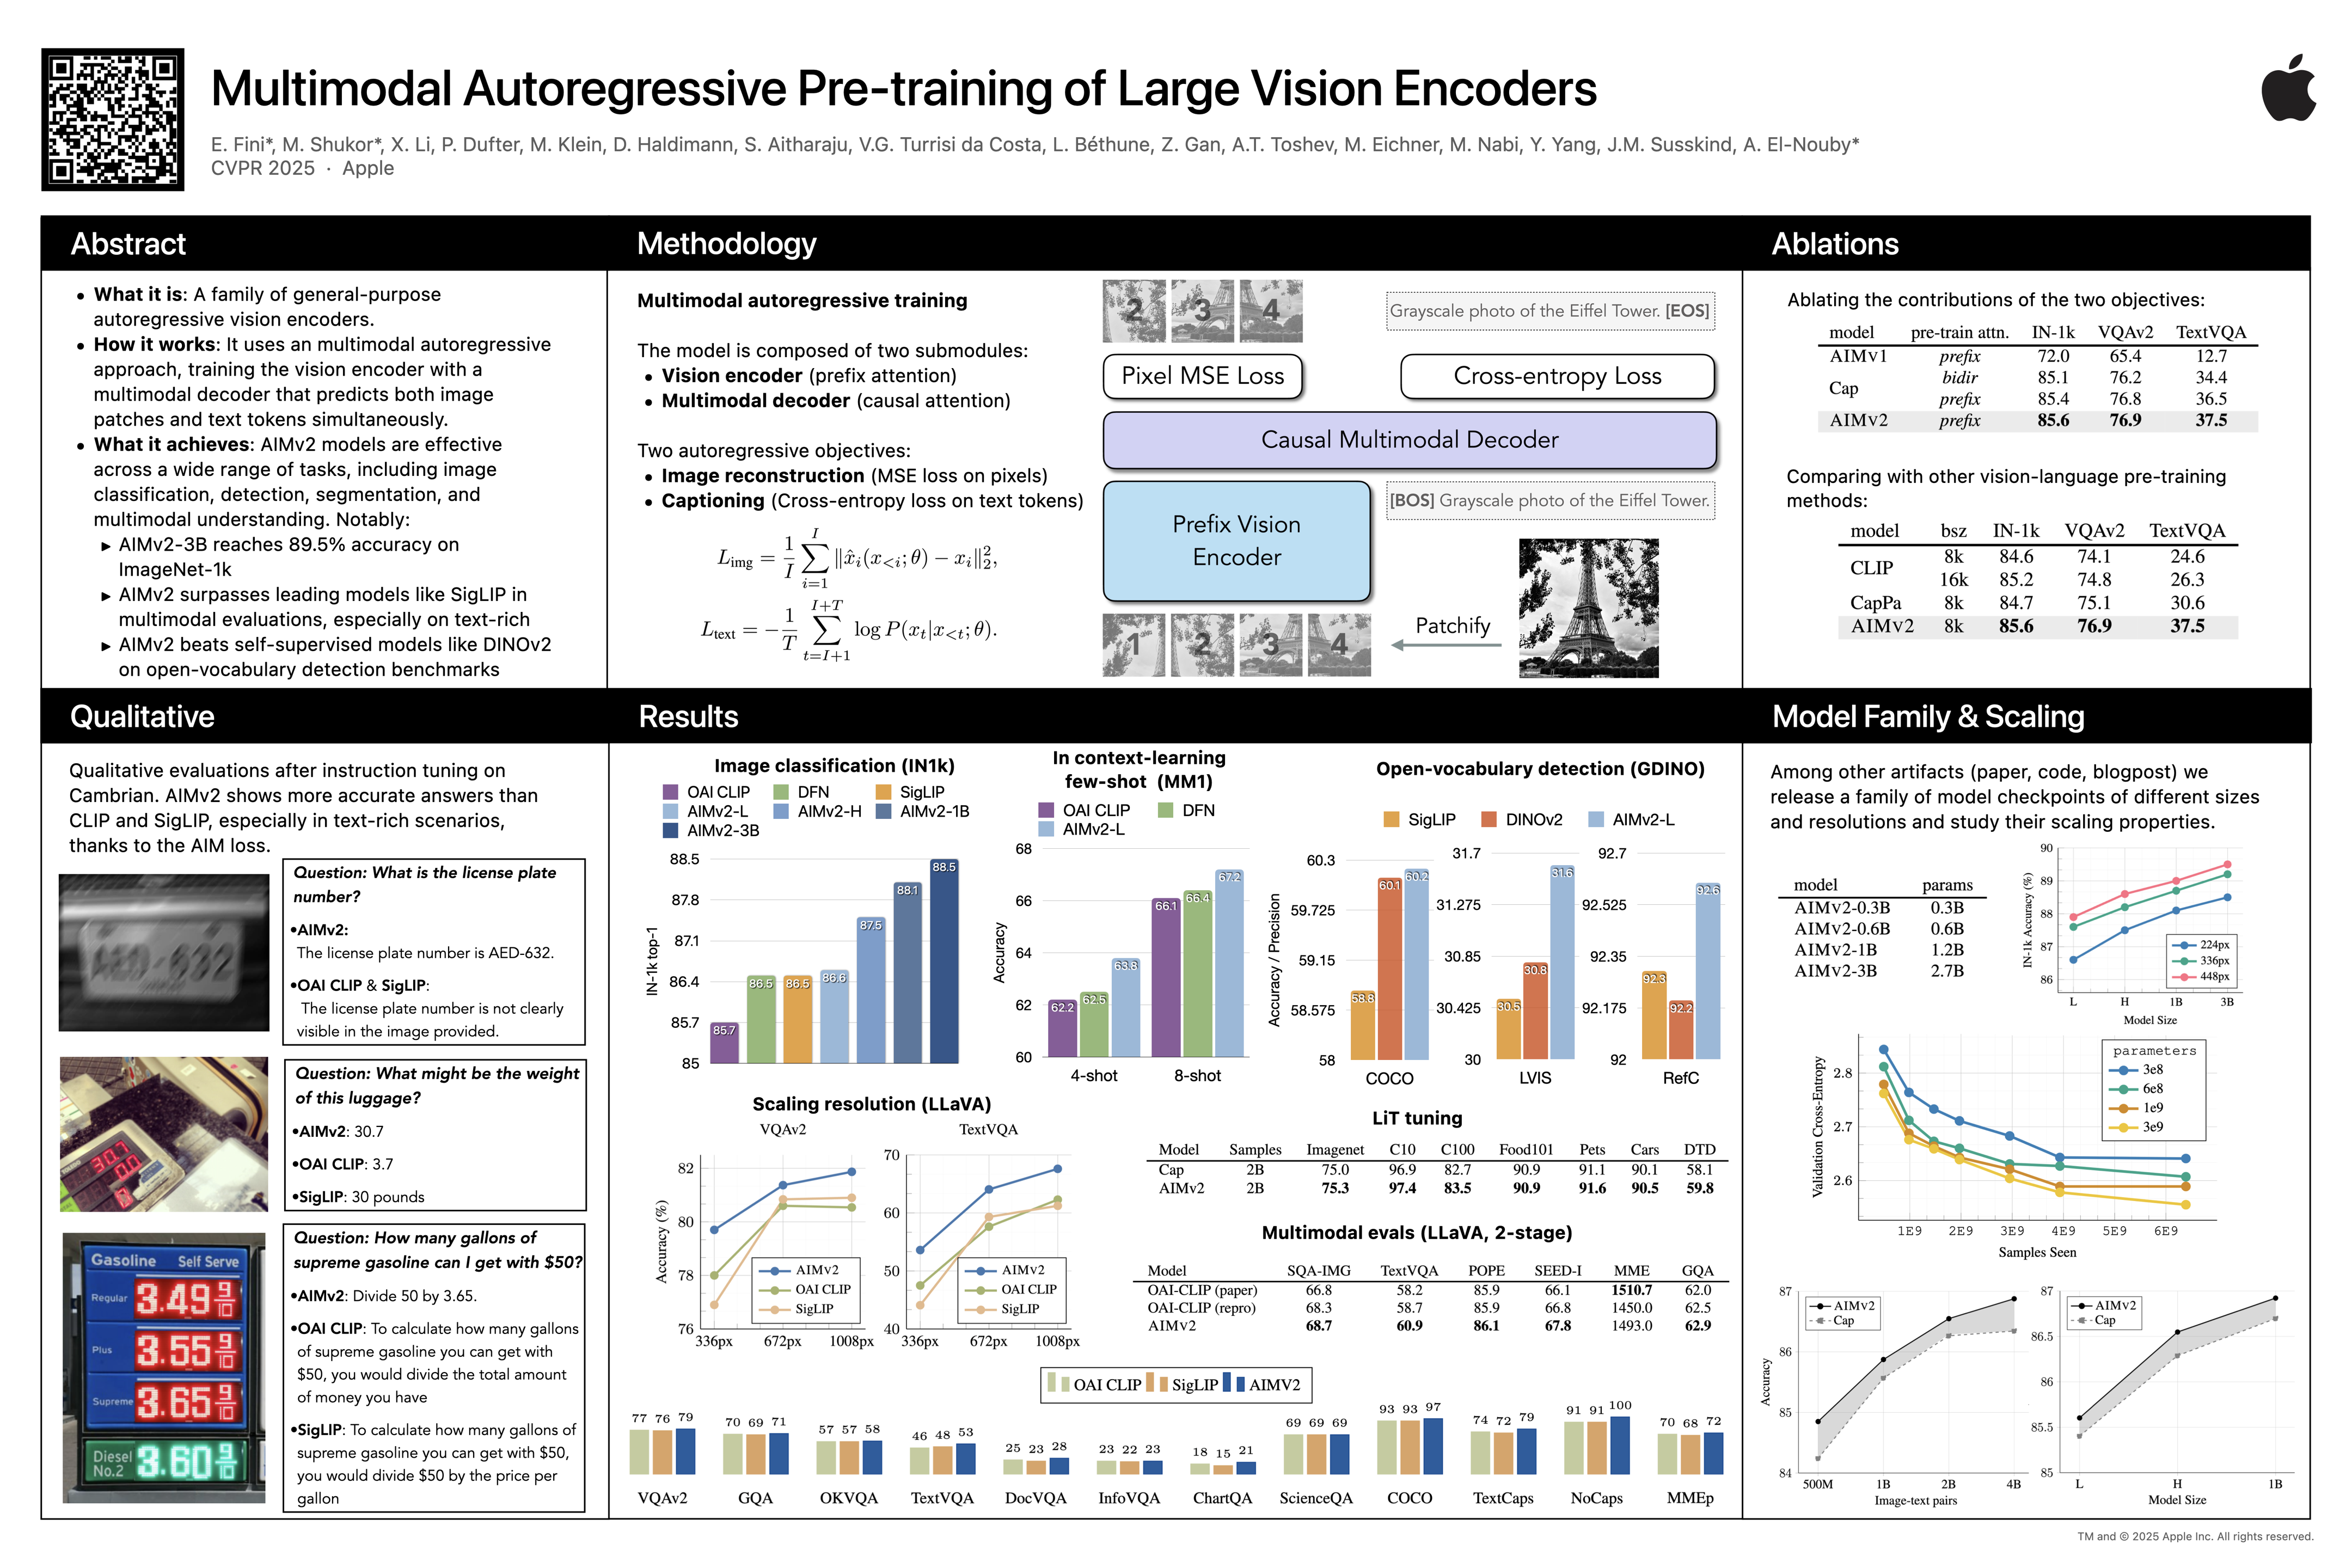
CVPR Poster Multimodal Autoregressive Pre-training of Large Vision Encoders
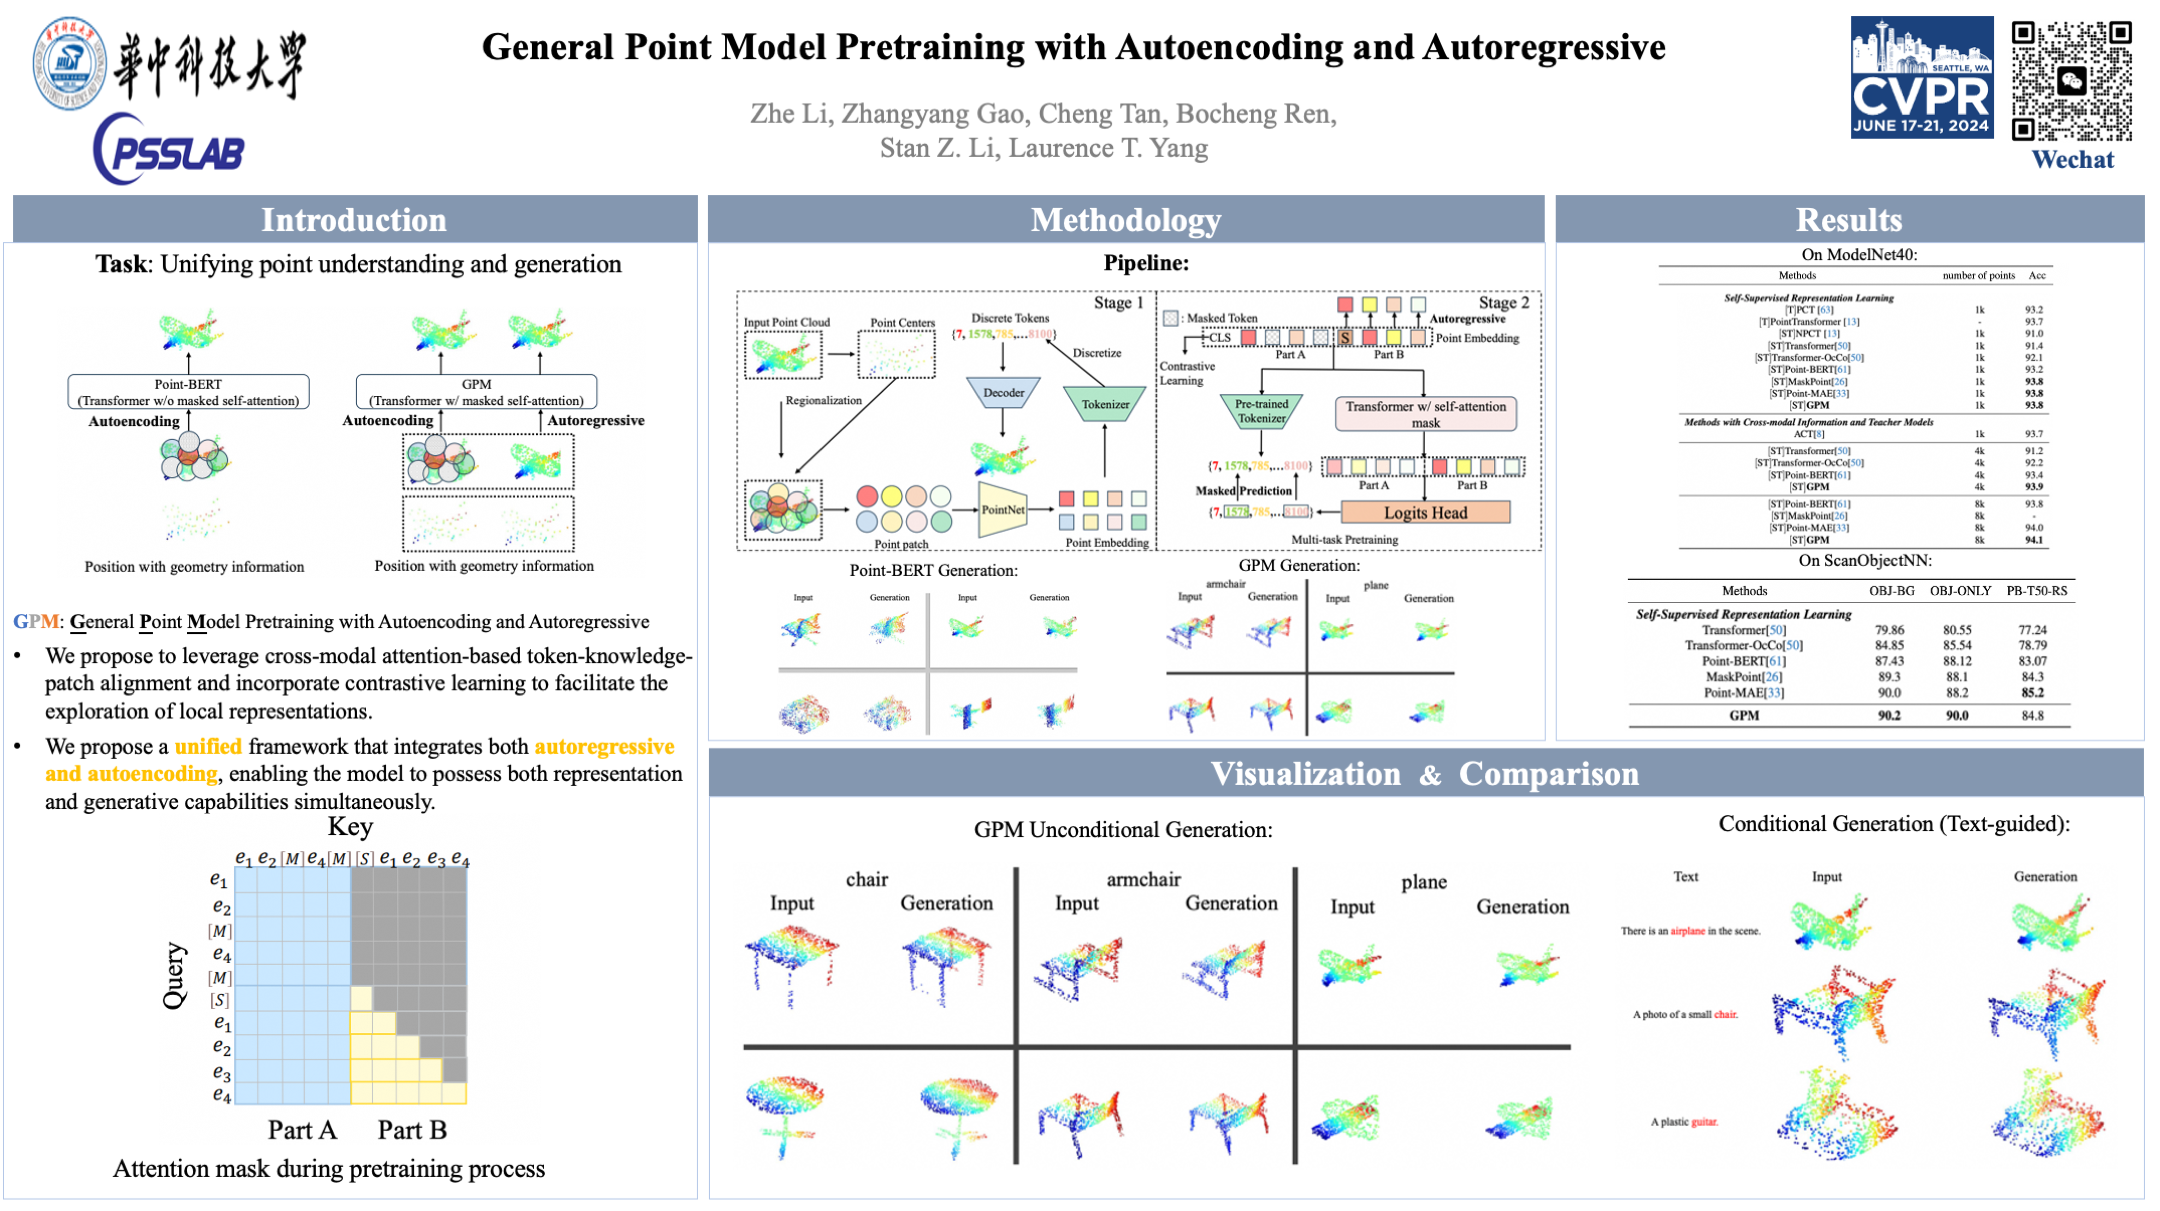
CVPR Poster General Point Model Pretraining with Autoencoding and ...
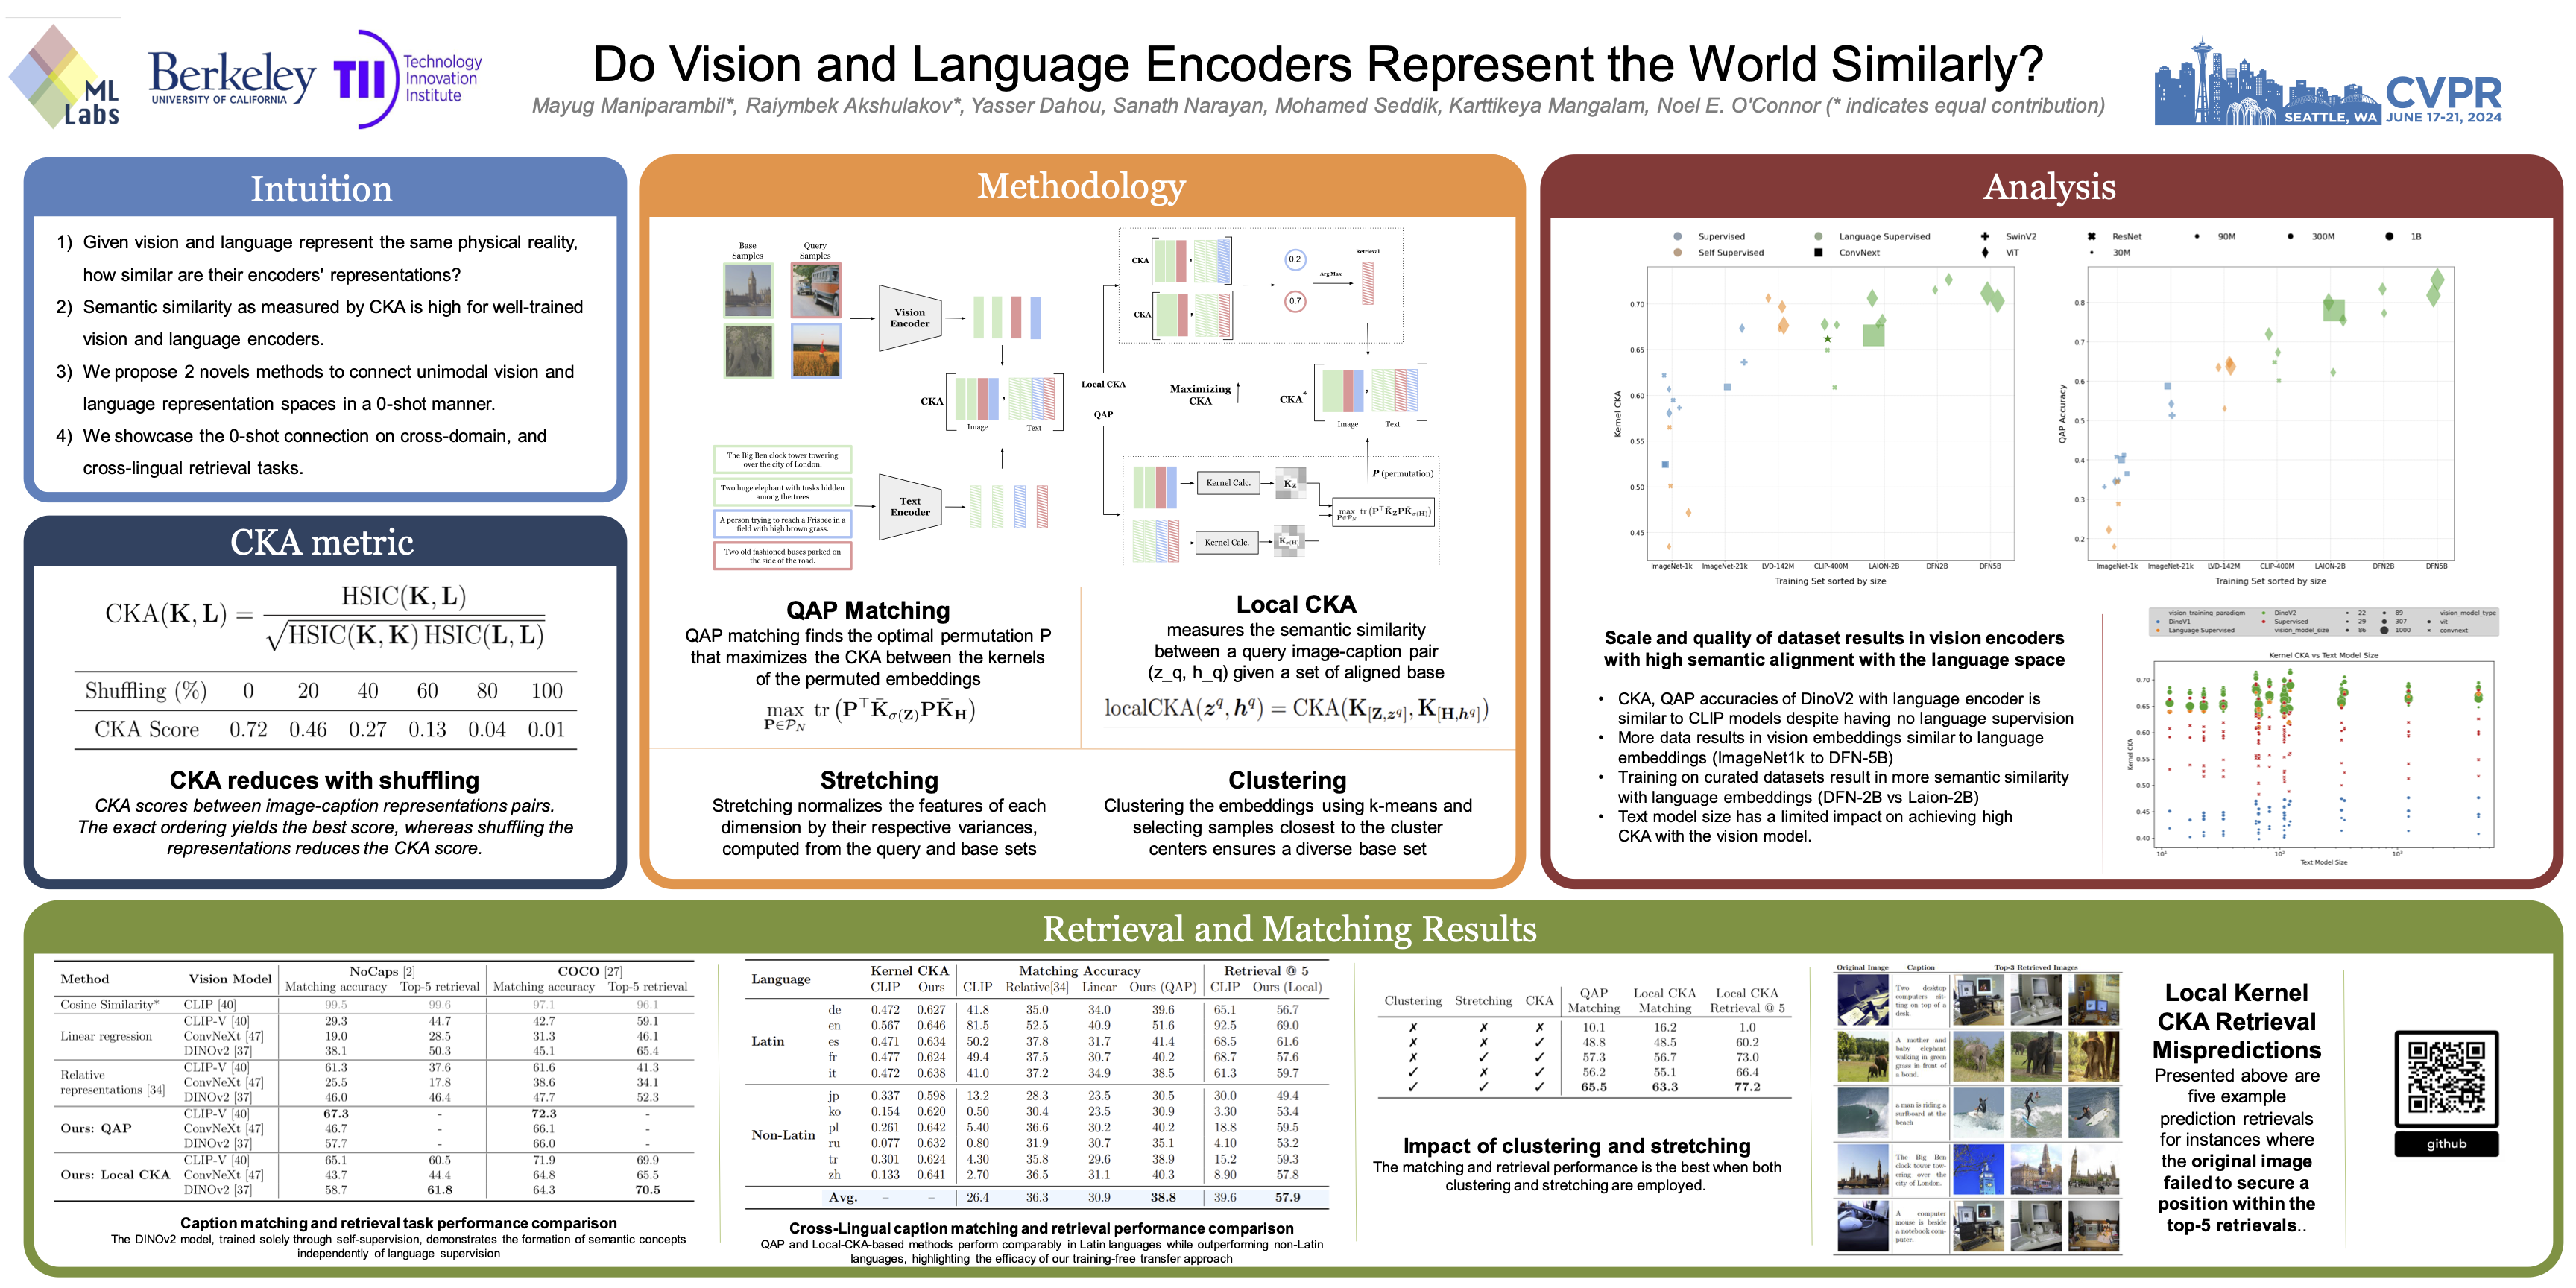
CVPR Poster Do Vision and Language Encoders Represent the World Similarly?

CVPR Poster VisionPAD: A Vision-Centric Pre-training Paradigm for ...
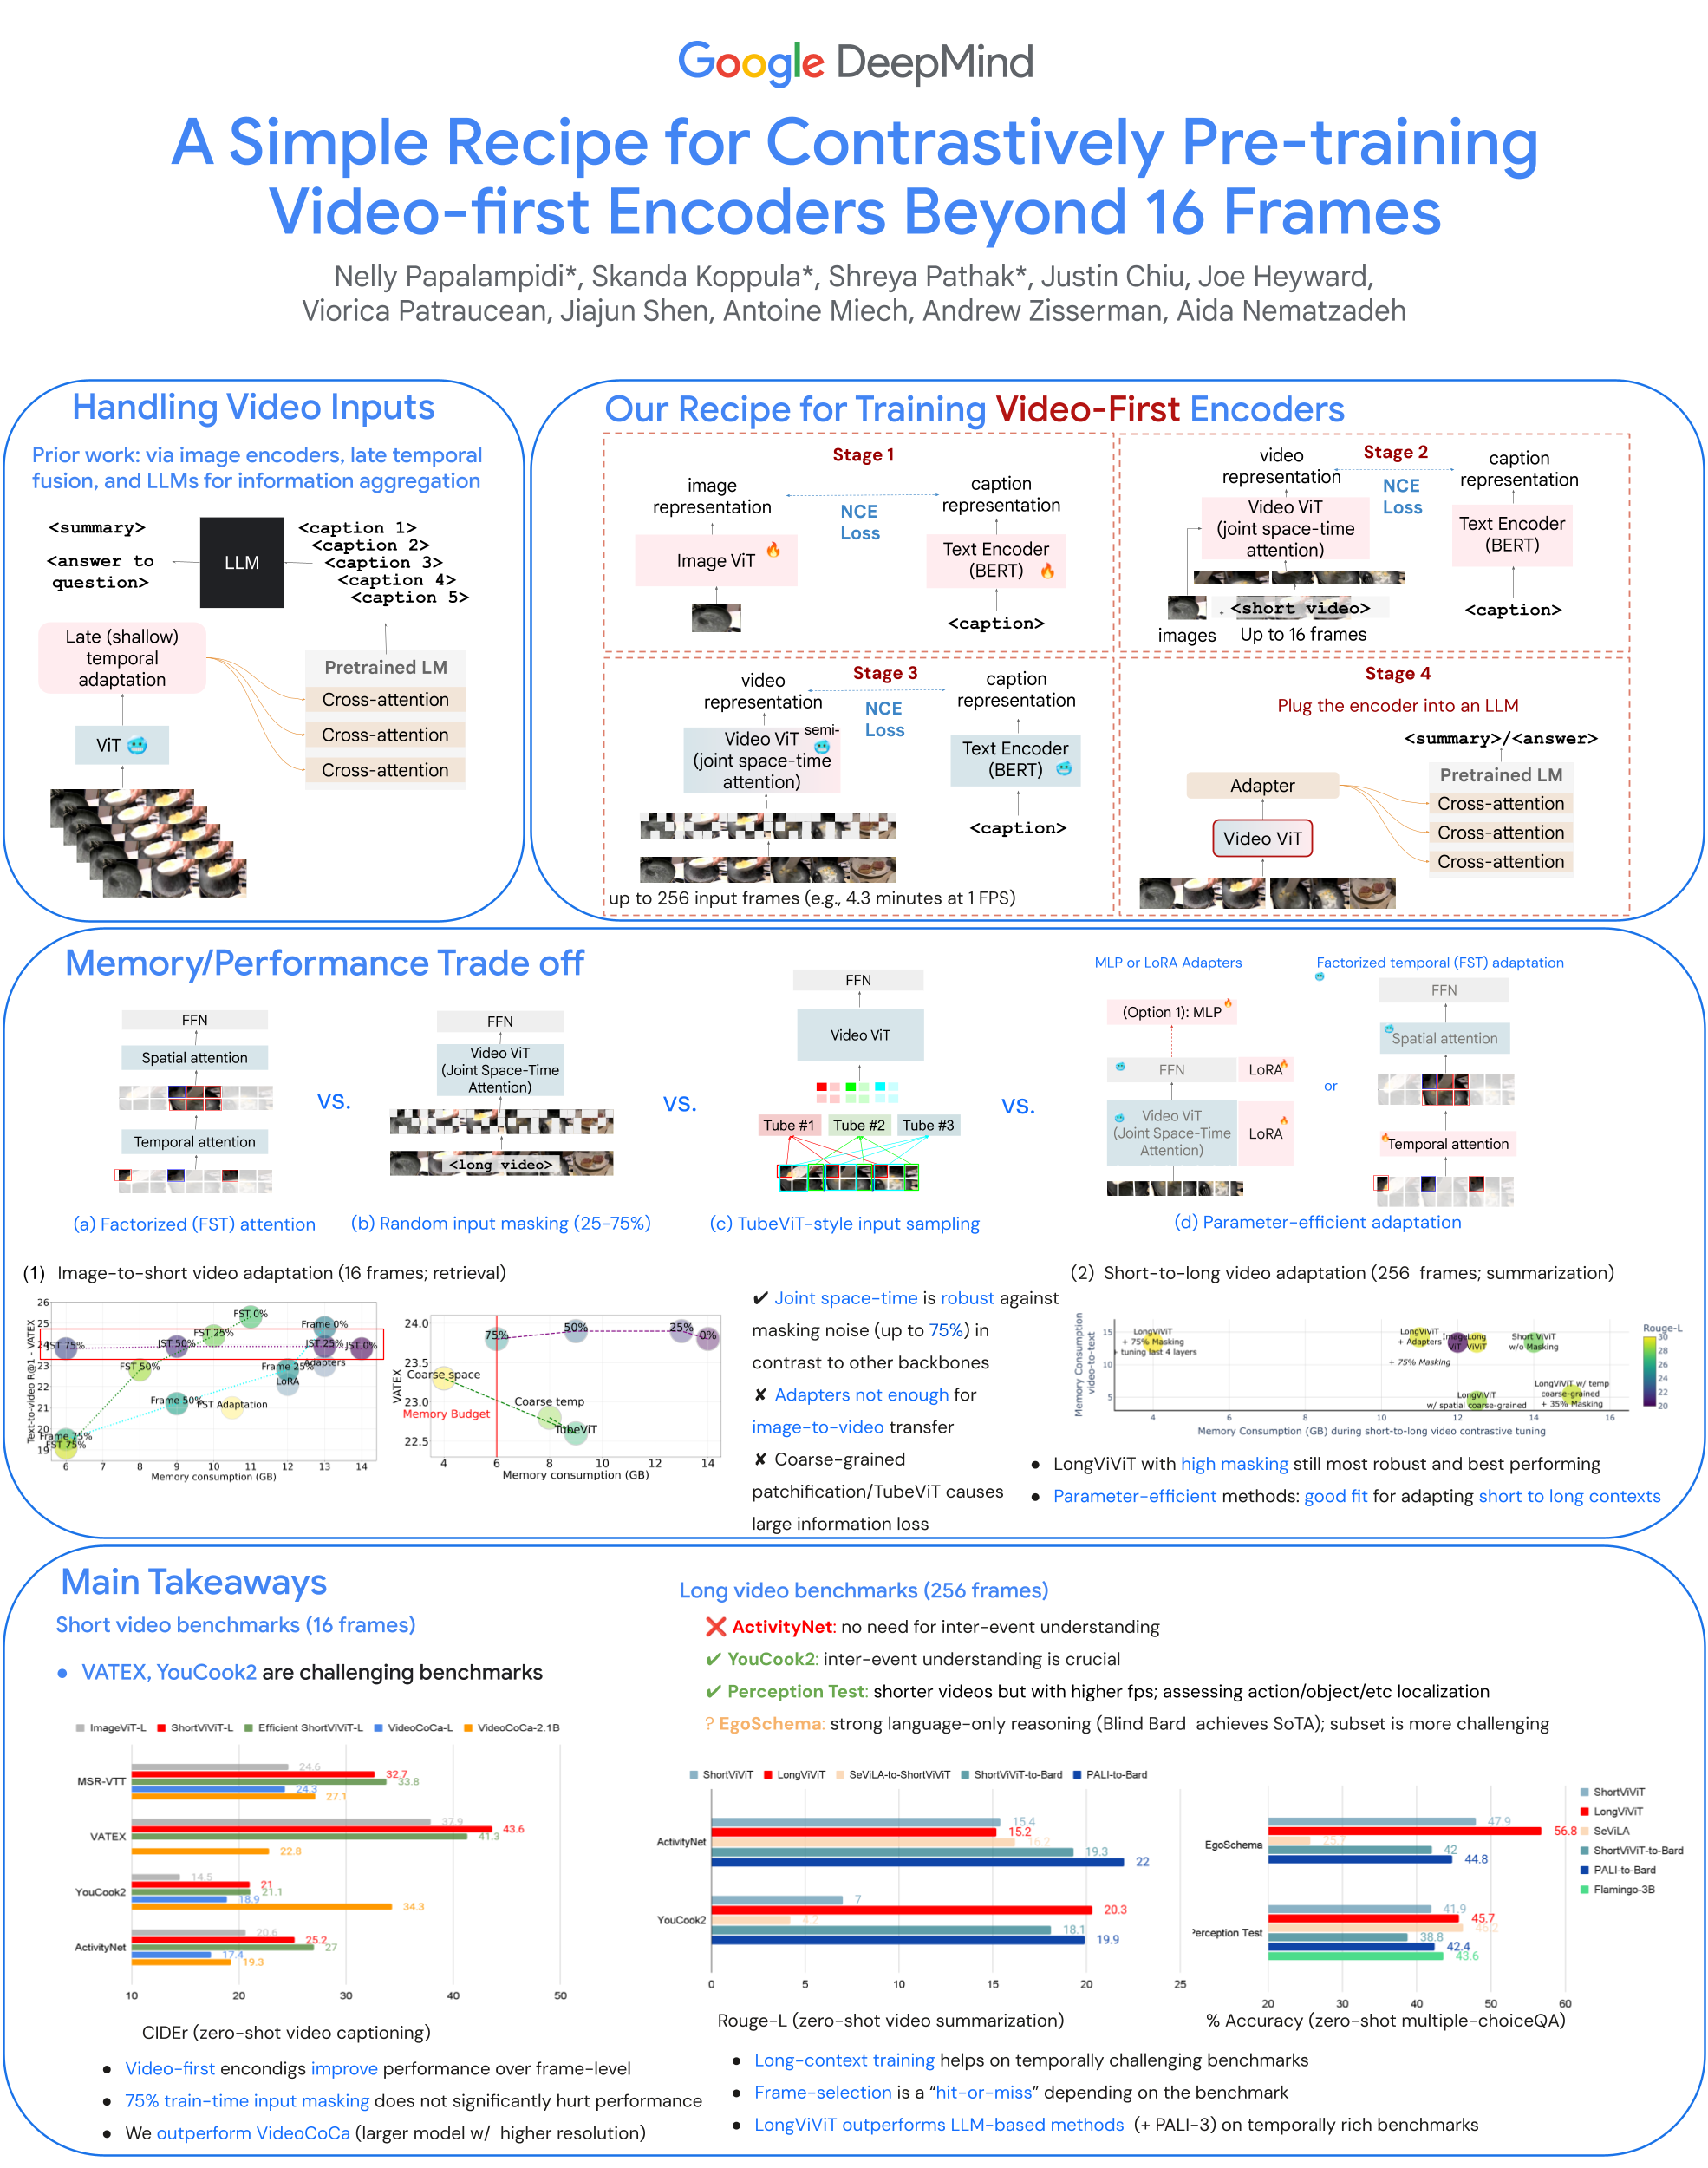
CVPR Poster A Simple Recipe for Contrastively Pre-training Video-First ...
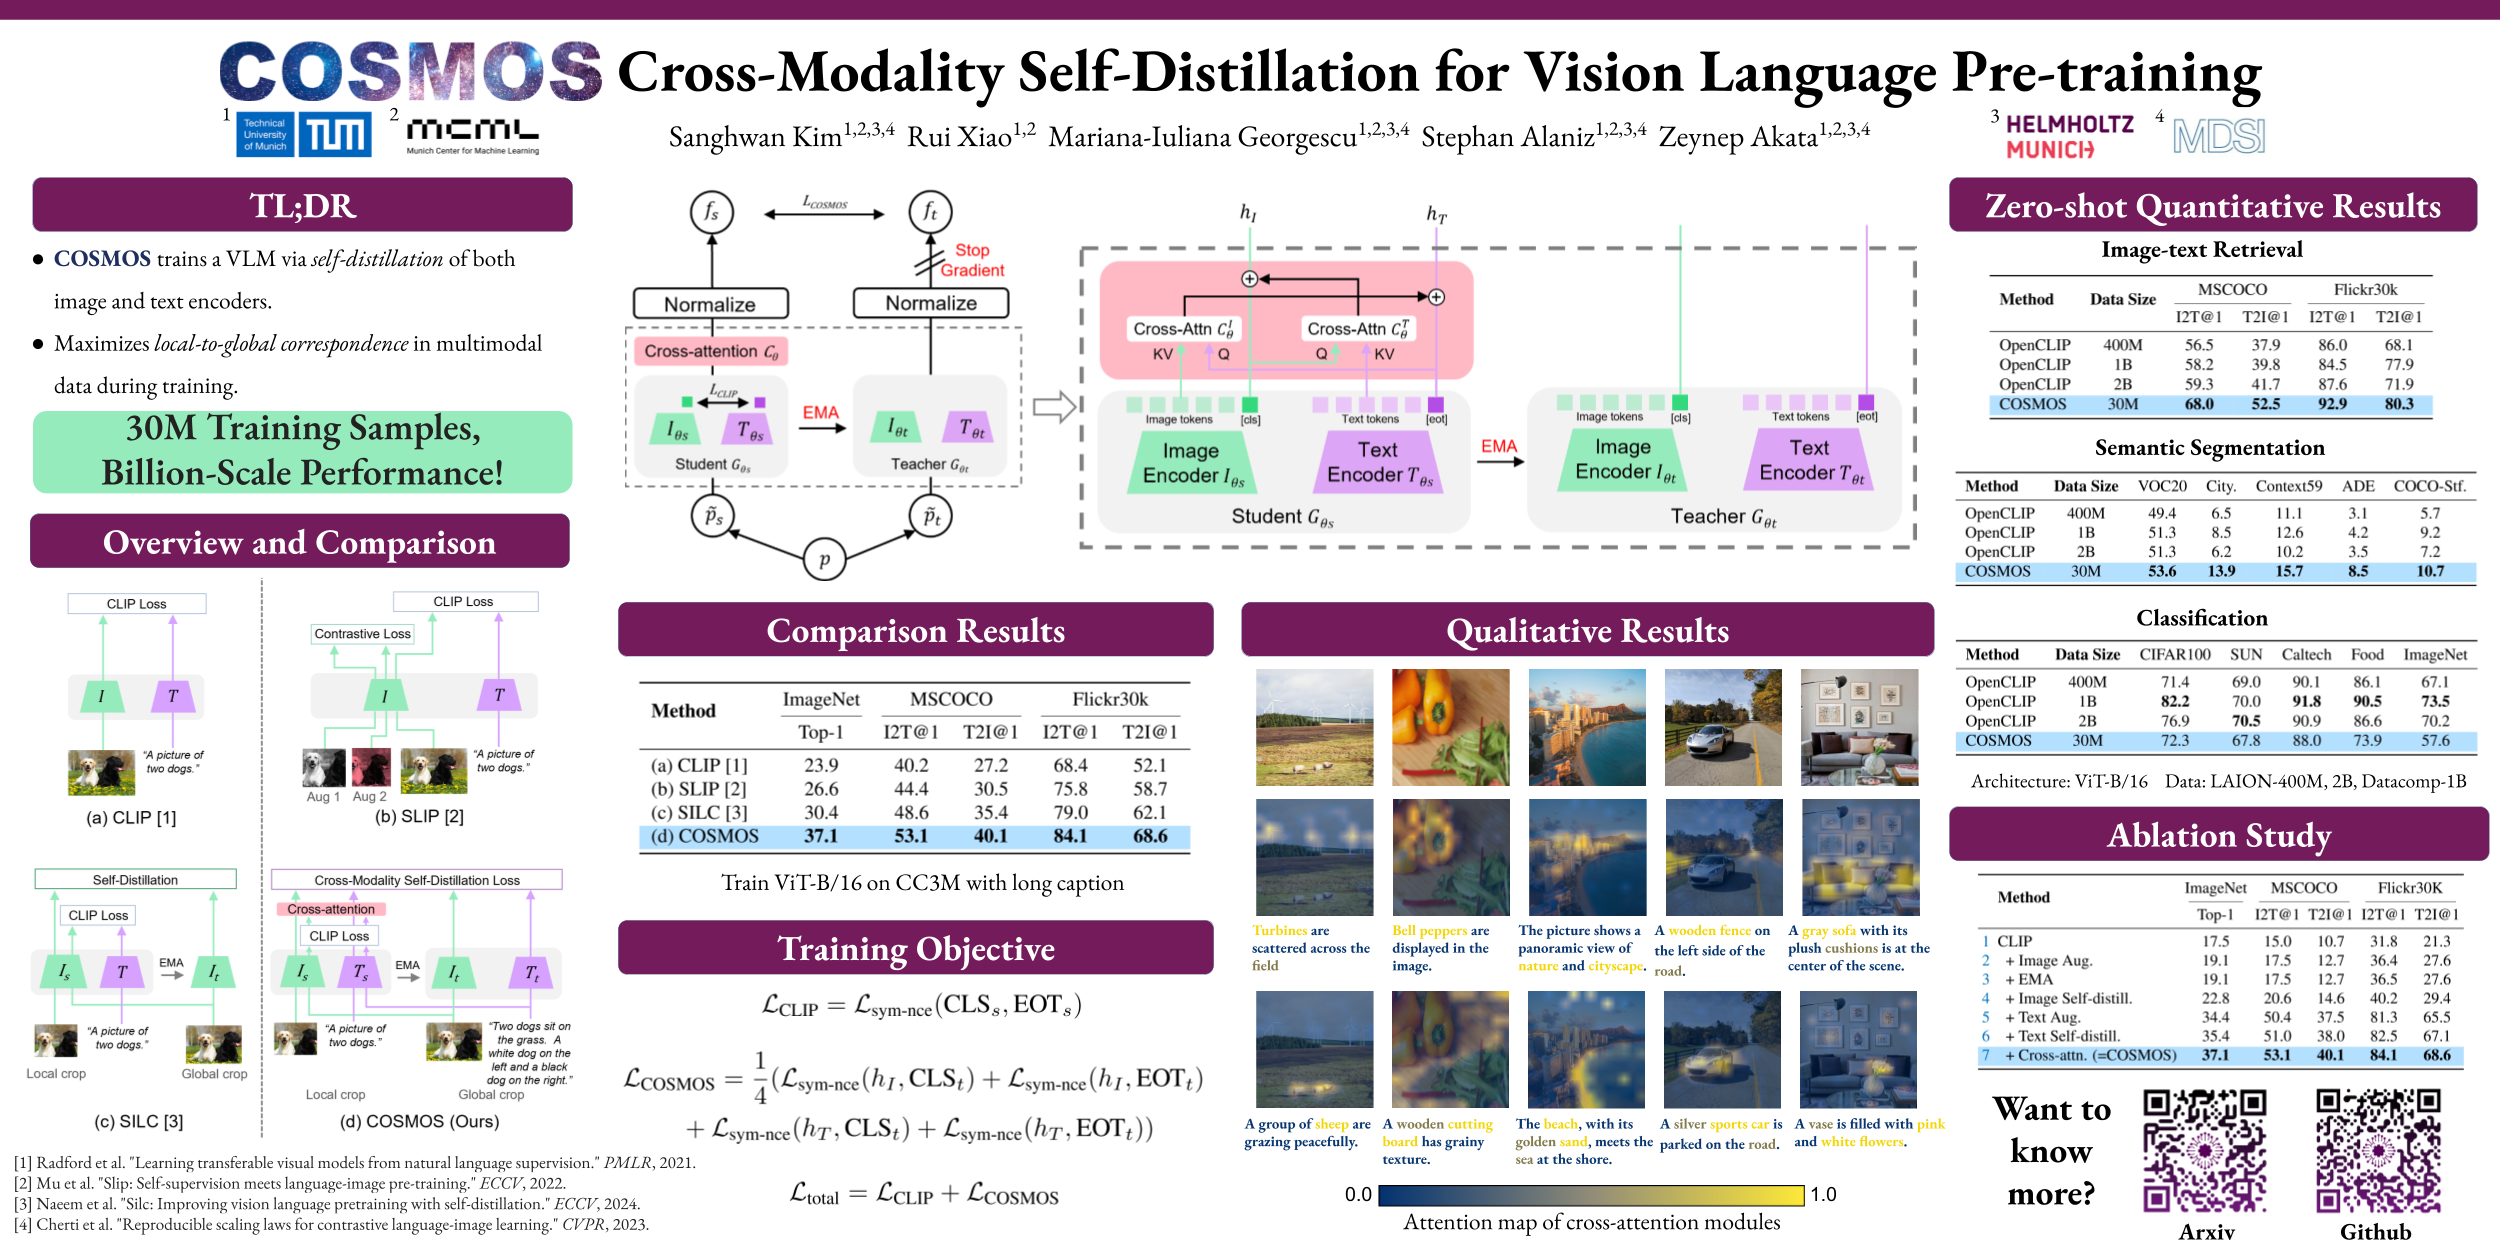
CVPR Poster COSMOS: Cross-Modality Self-Distillation for Vision ...

CVPR Poster Stealthy Backdoor Attack in Self-Supervised Learning Vision ...
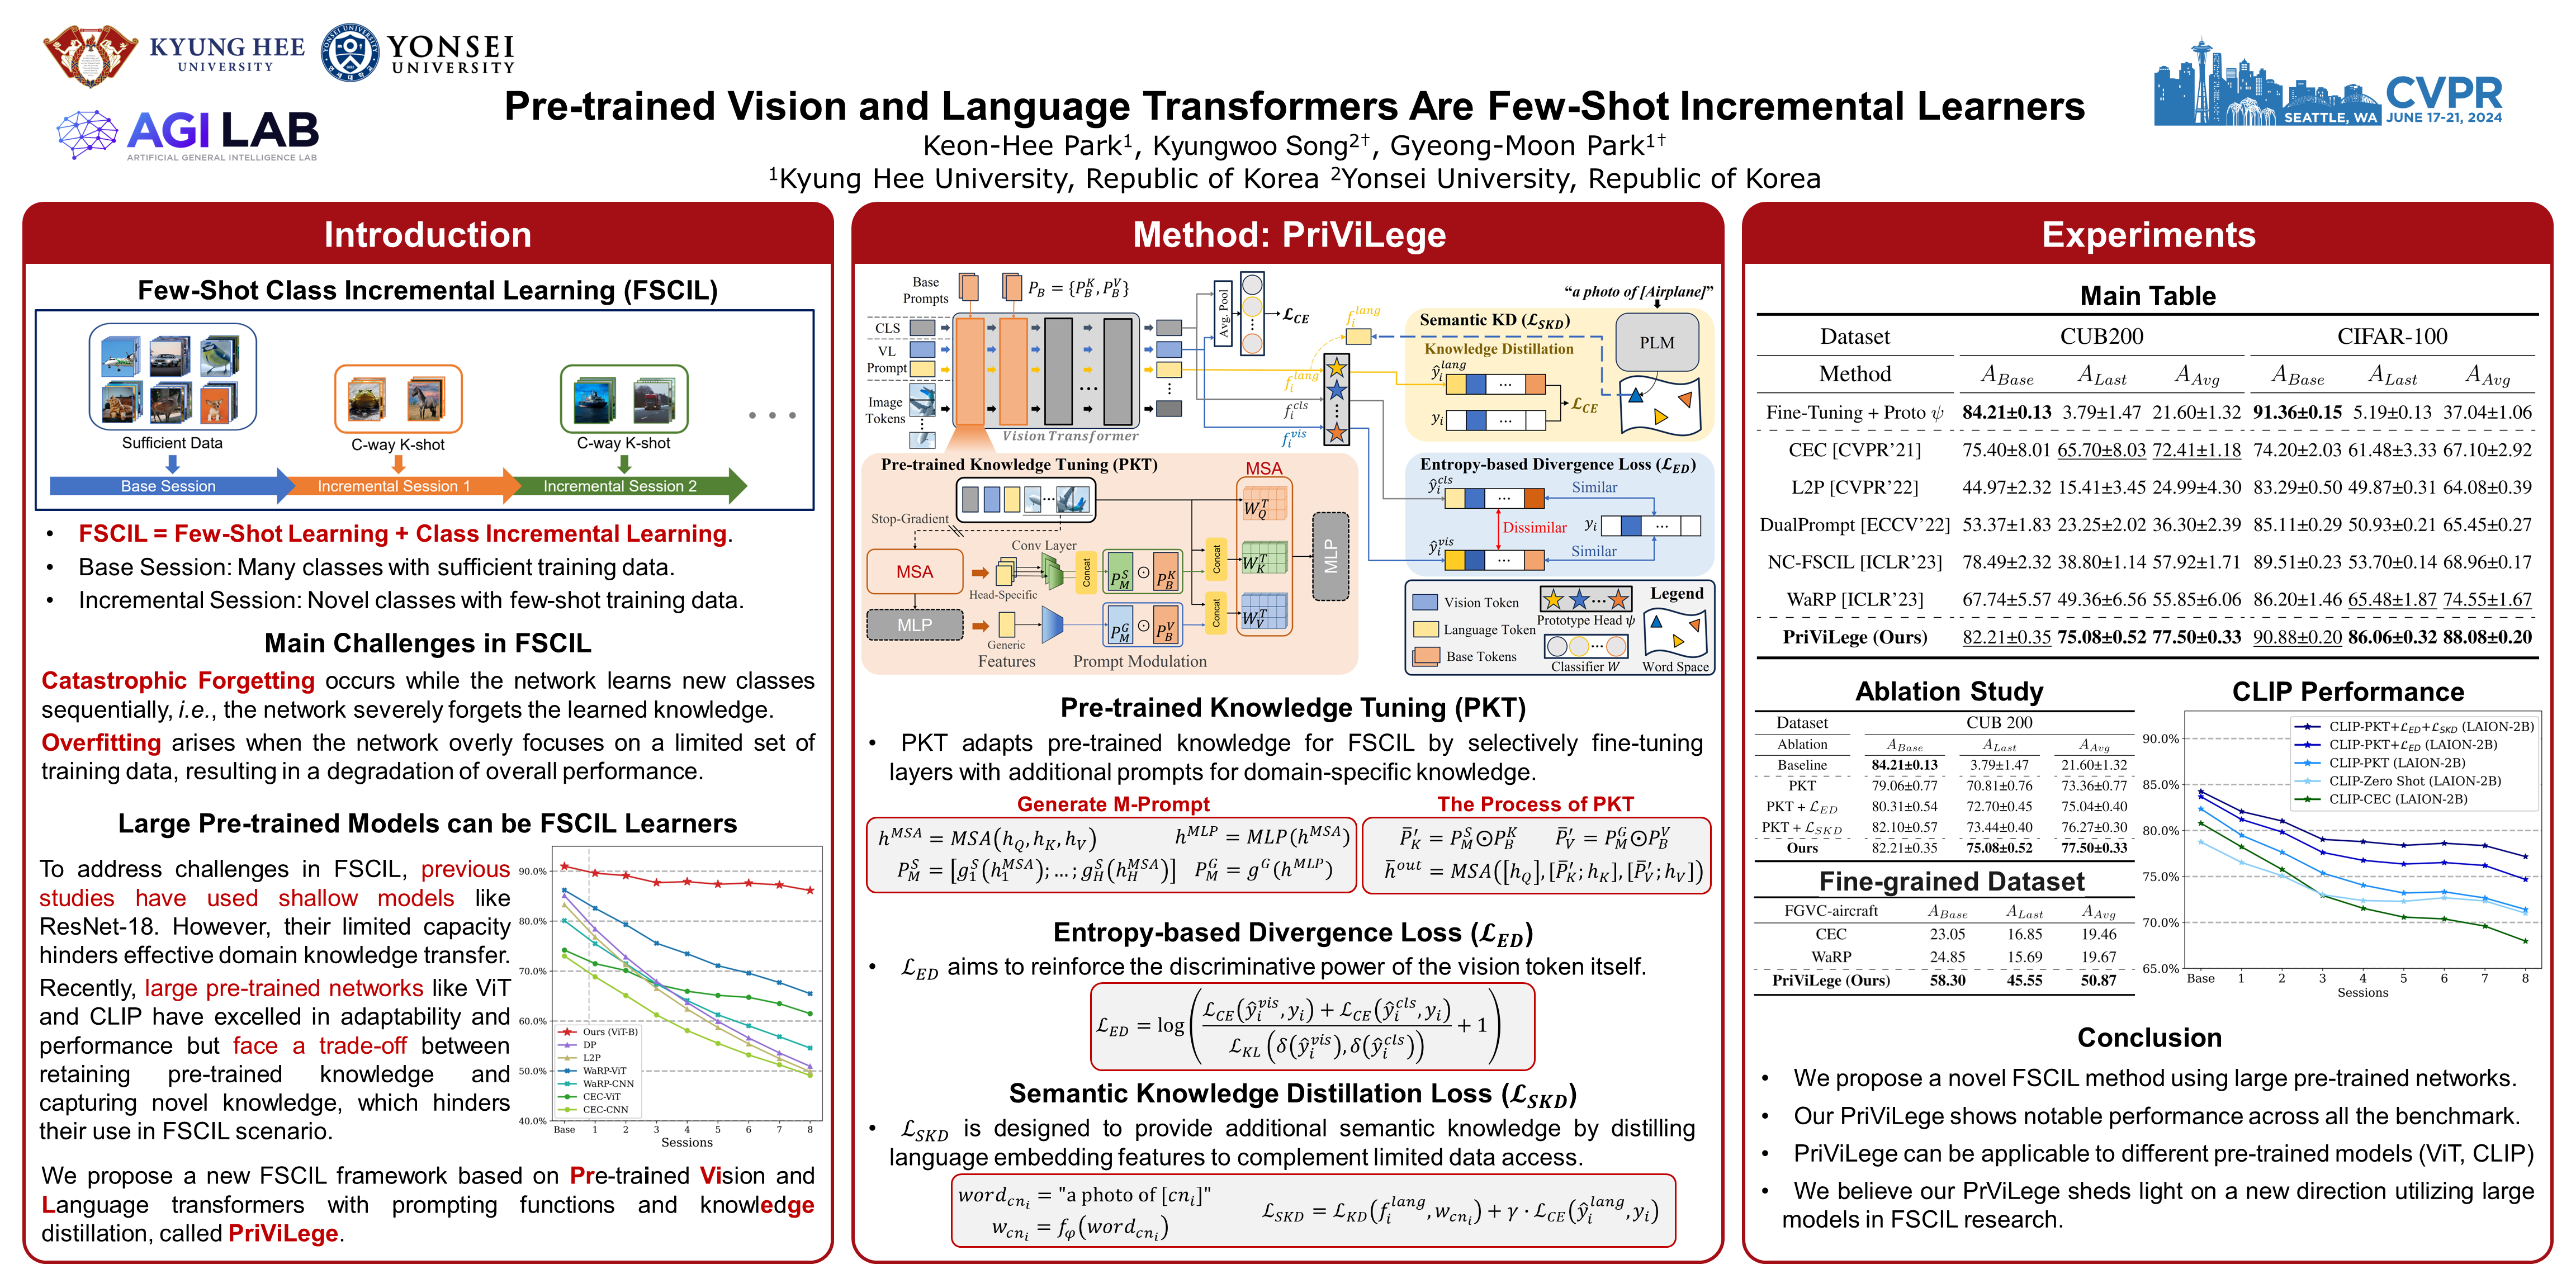
CVPR Poster Pre-trained Vision and Language Transformers Are Few-Shot ...
Advertisement Space (336x280)
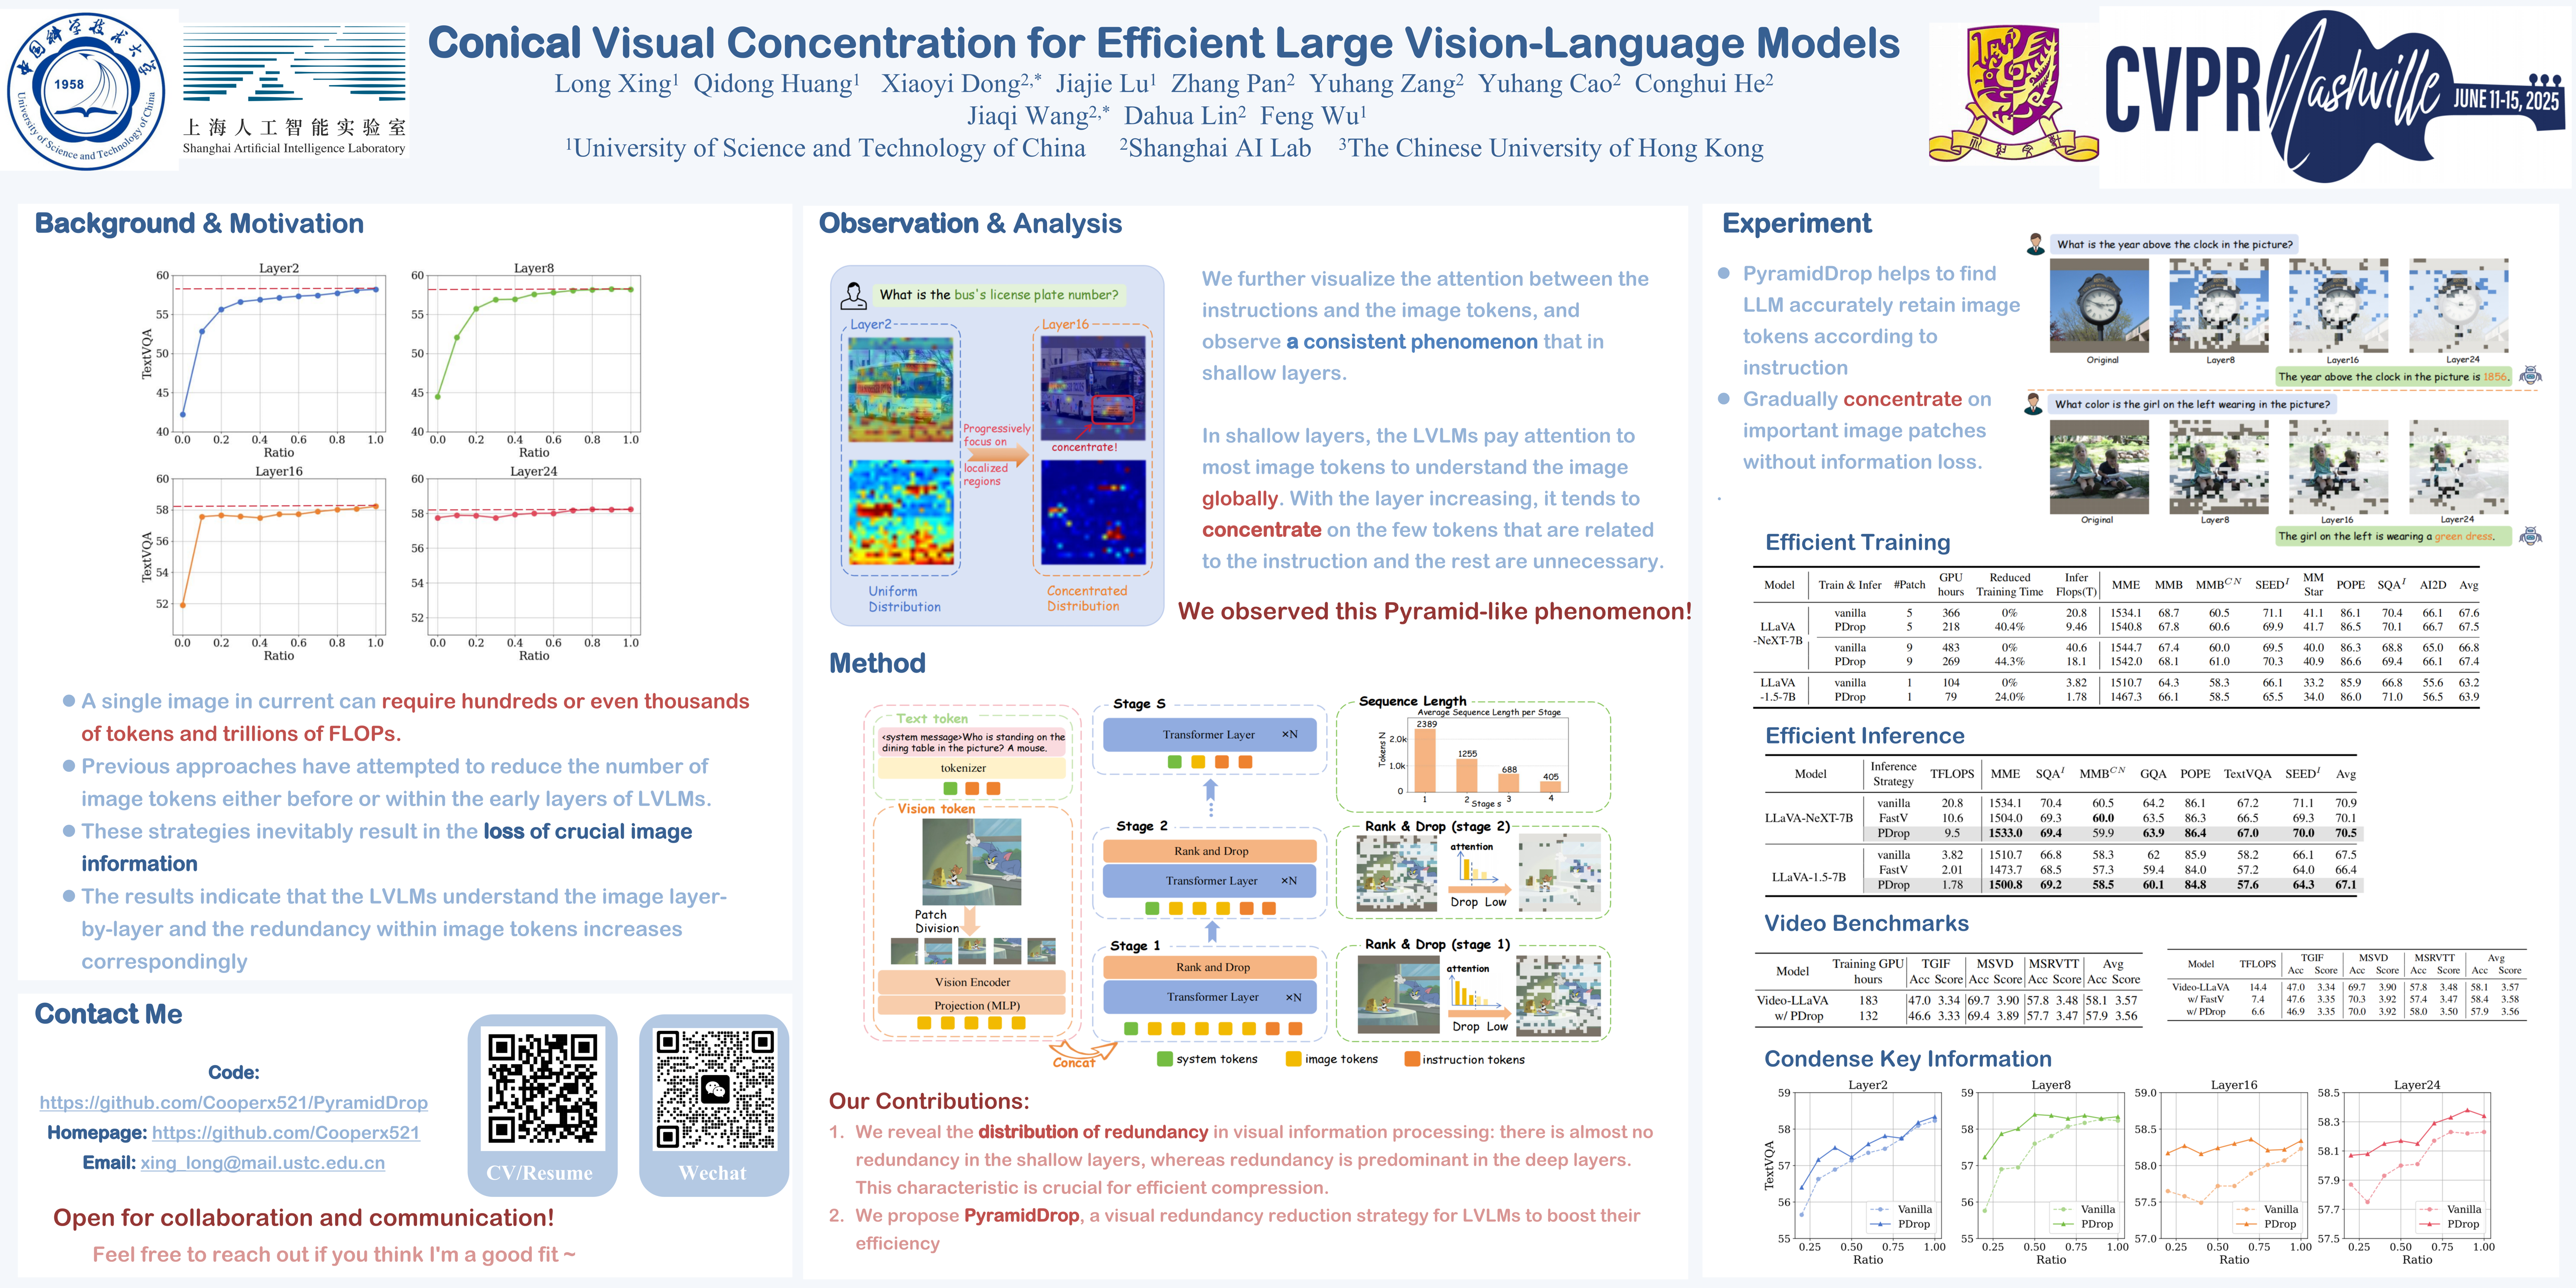
CVPR Poster Conical Visual Concentration for Efficient Large Vision ...

Figure 4 from GLID: Pre-training a Generalist Encoder-Decoder Vision ...
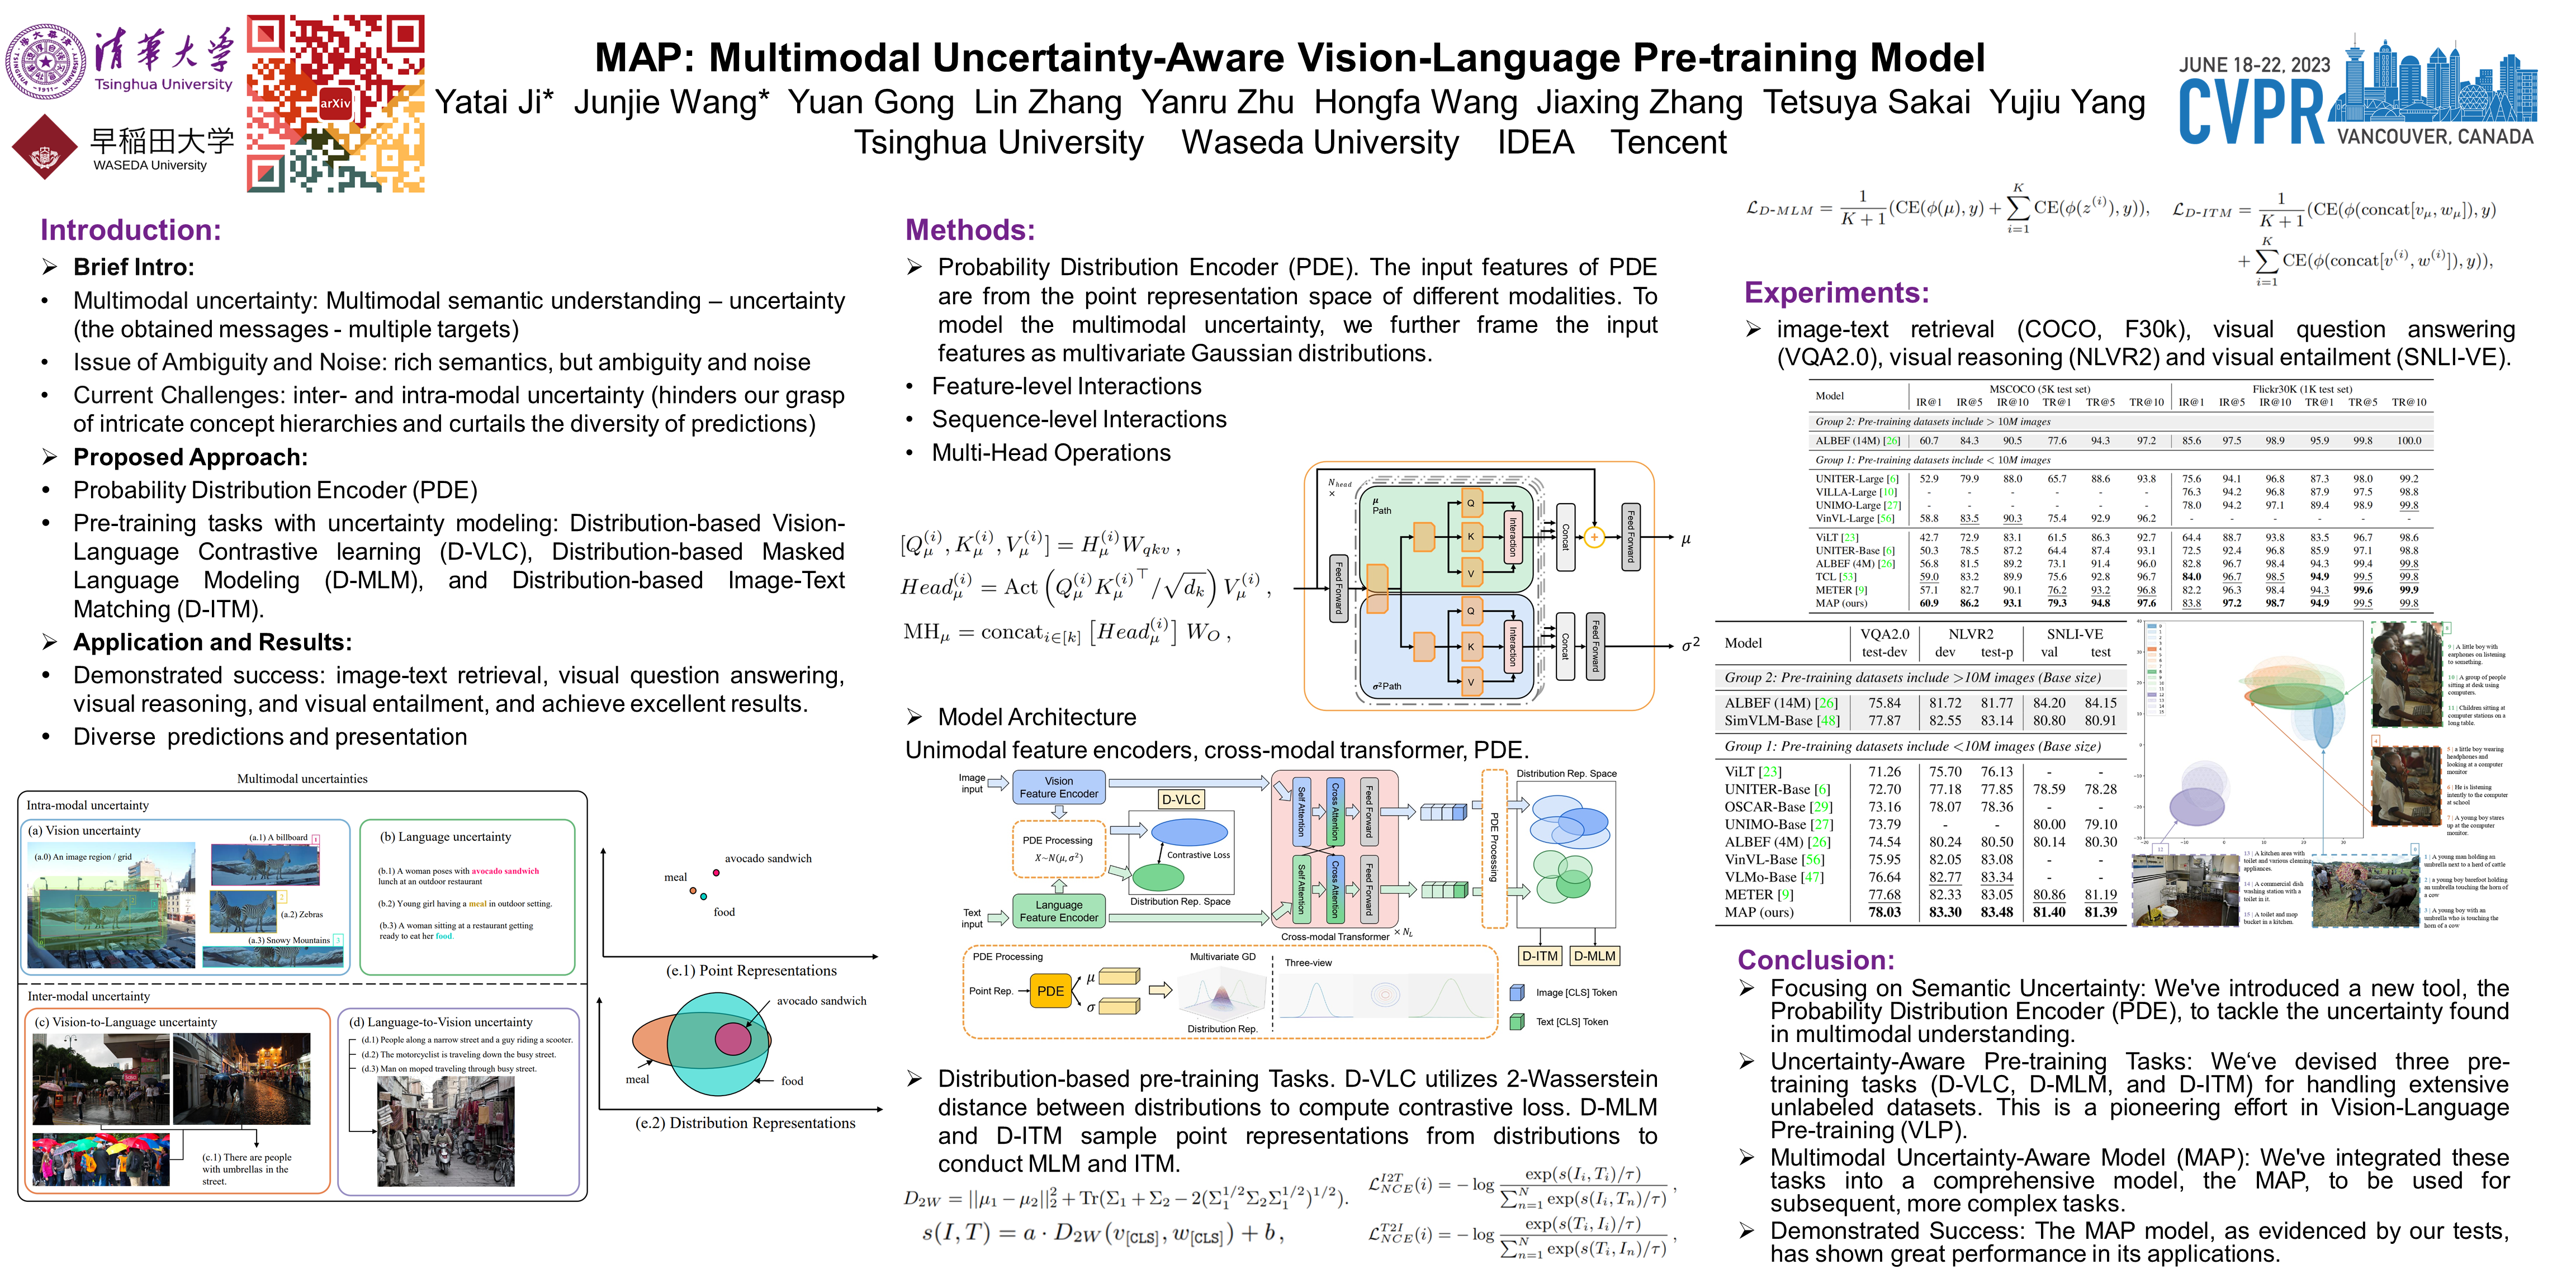
CVPR Poster MAP: Multimodal Uncertainty-Aware Vision-Language Pre ...

CVPR Poster Lifelong Knowledge Editing for Vision Language Models with ...

CVPR Poster Towards Training-free Anomaly Detection with Vision and ...
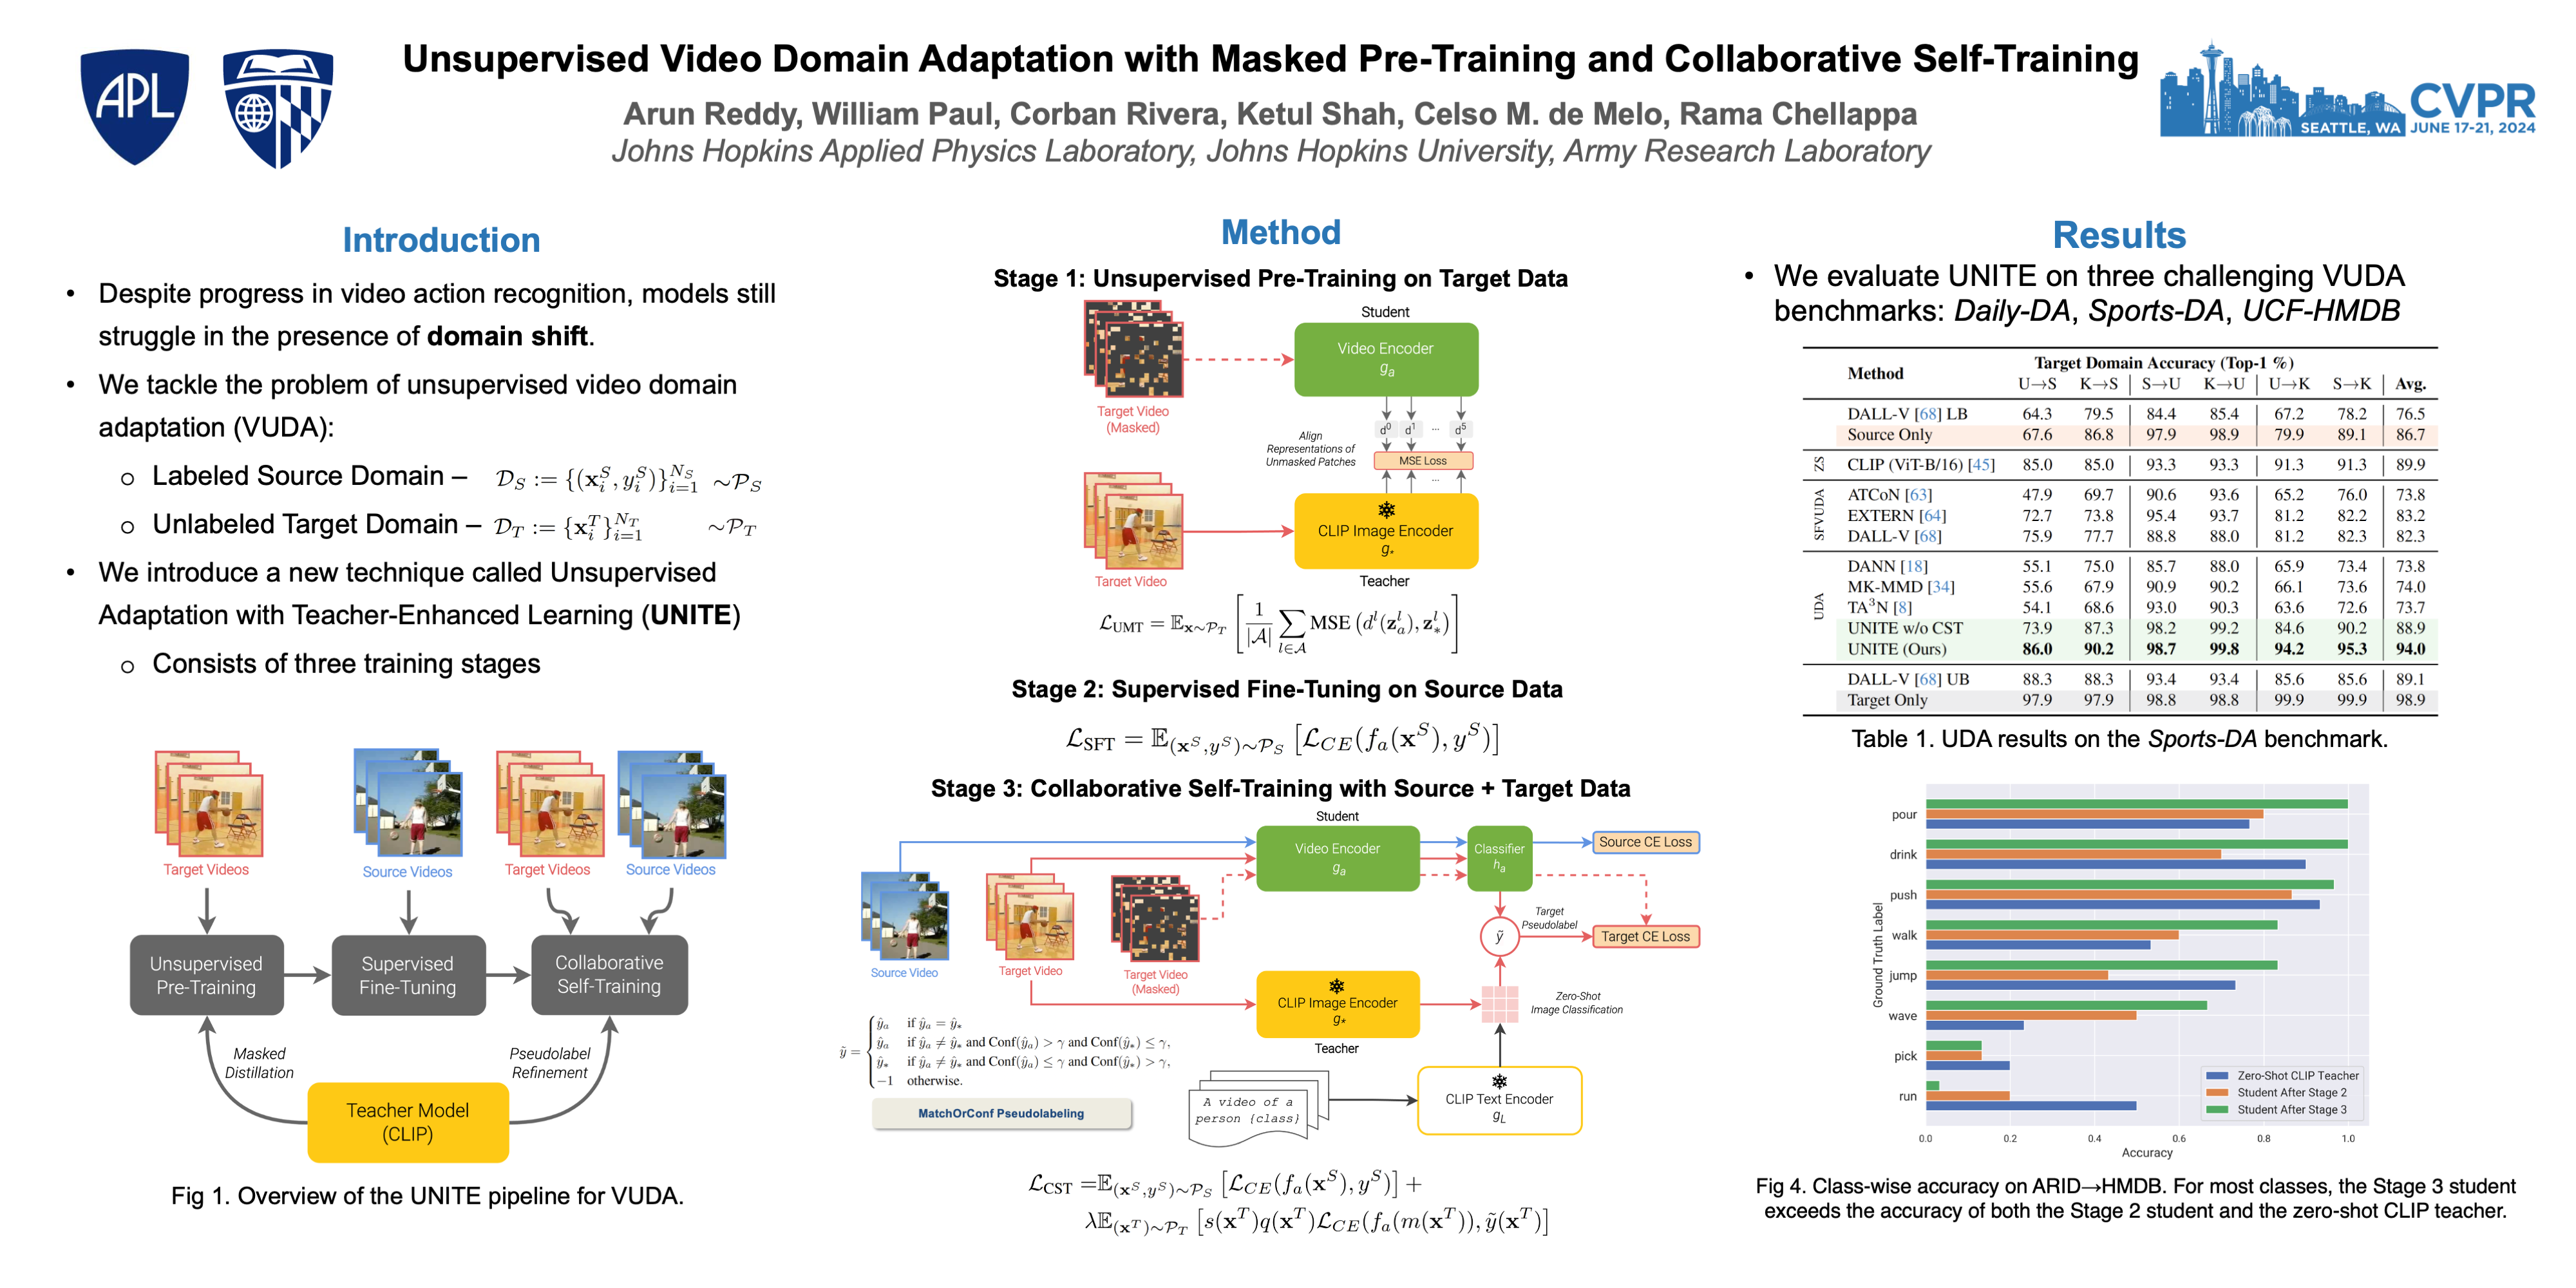
CVPR Poster Unsupervised Video Domain Adaptation with Masked Pre ...
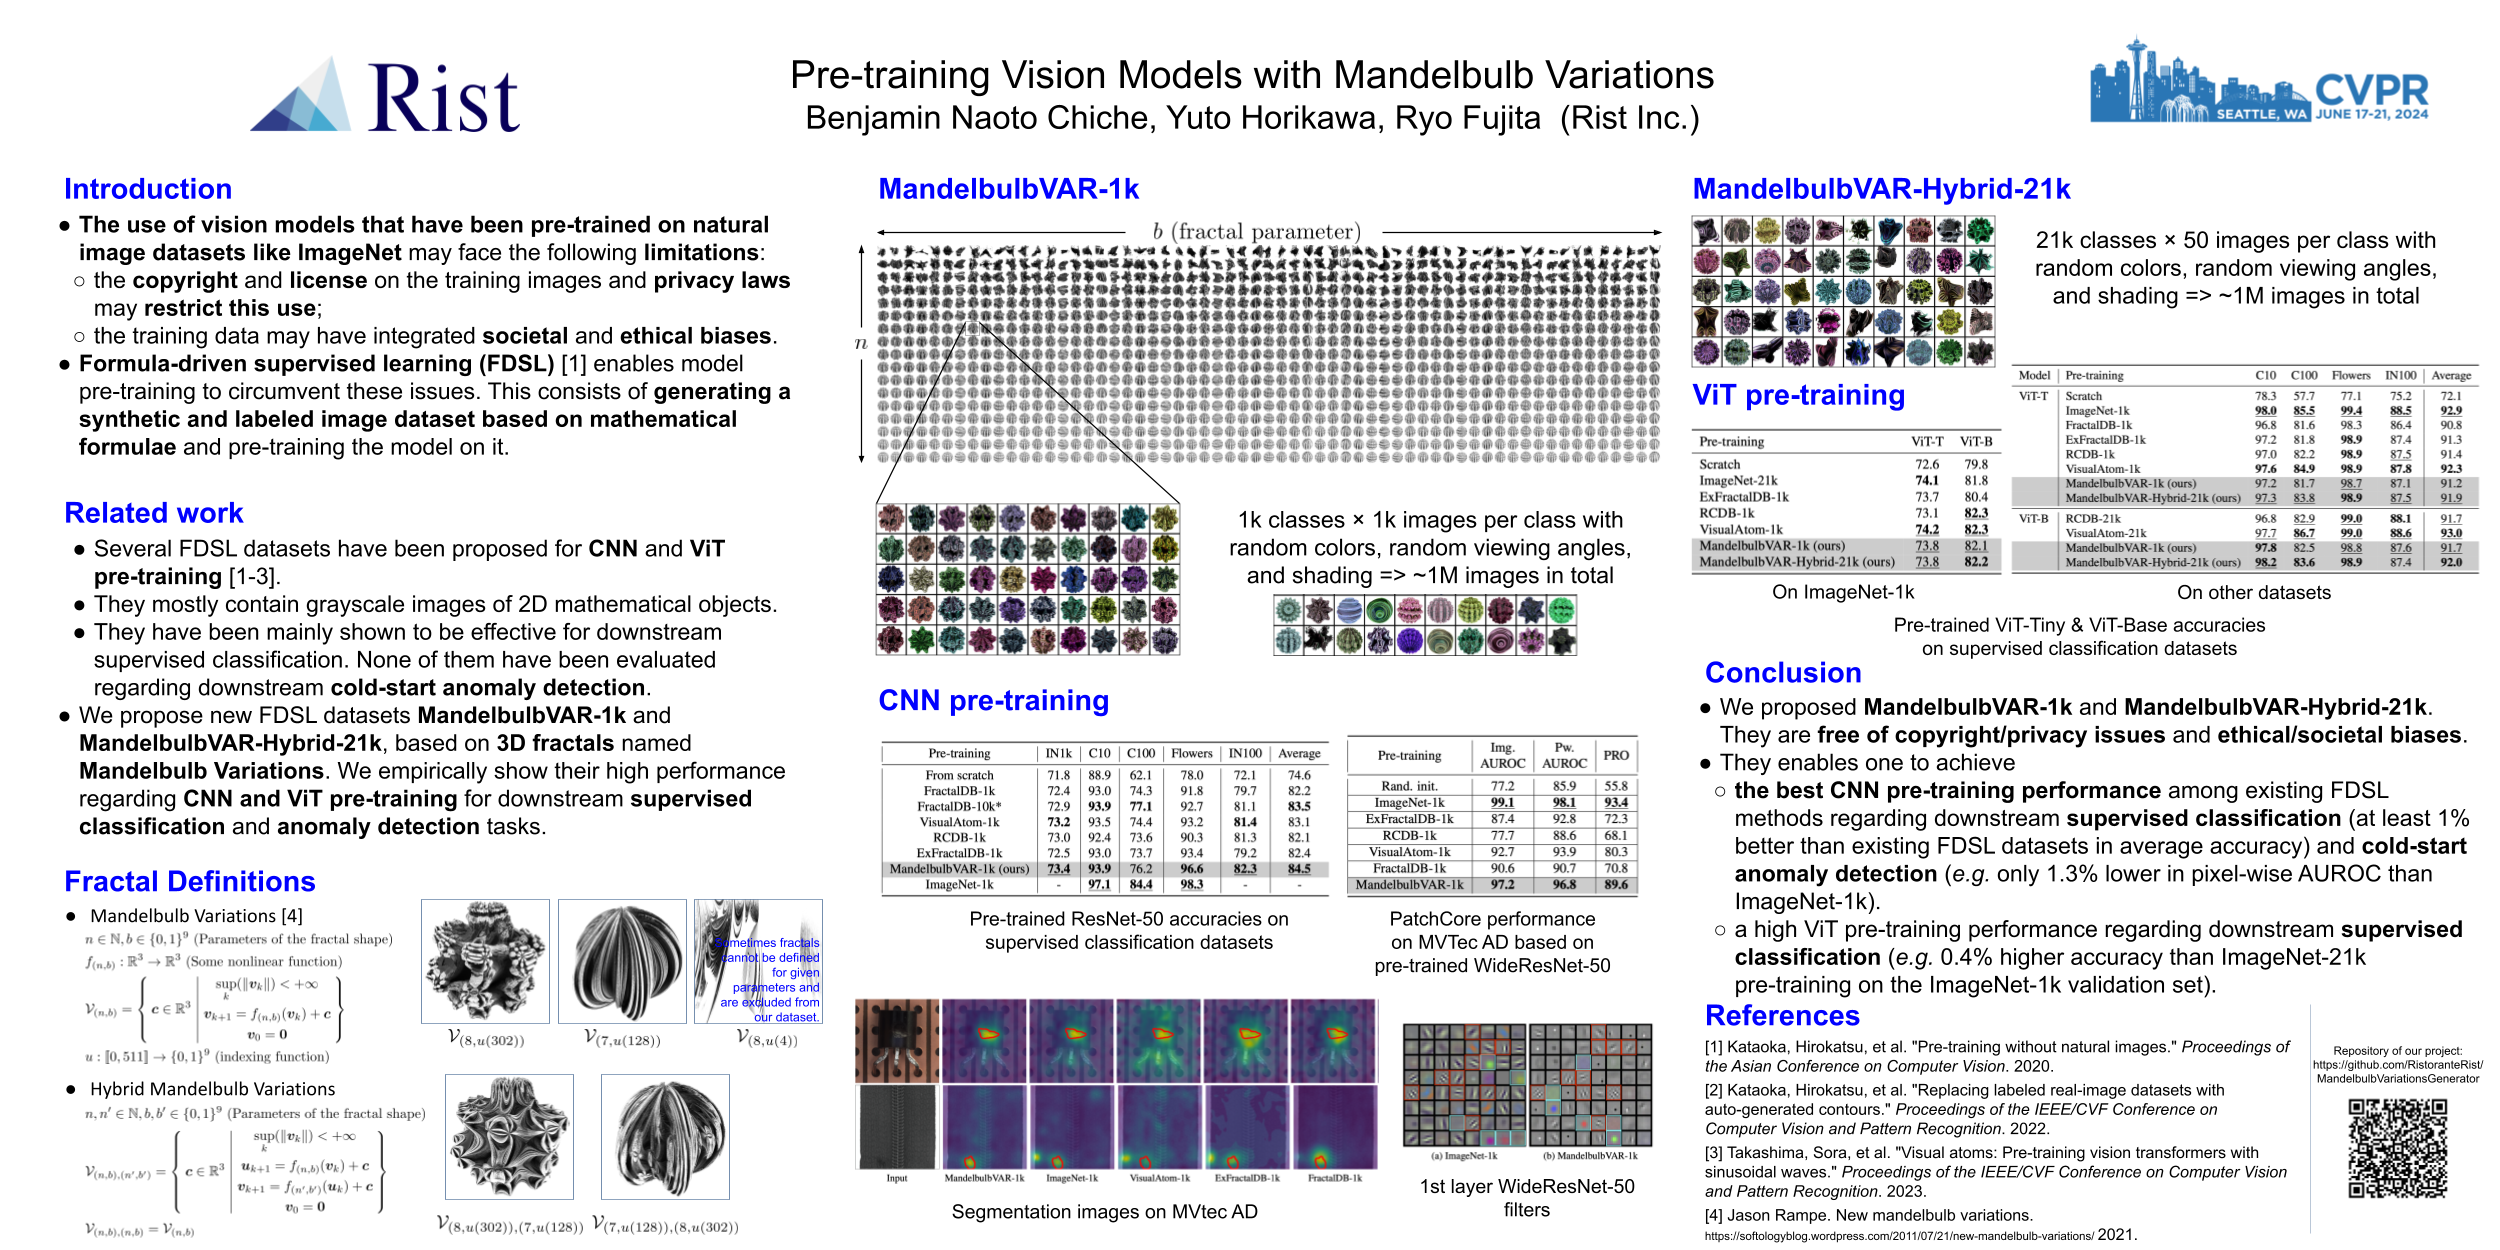
CVPR Poster Pre-training Vision Models with Mandelbulb Variations

Table 1 from GLID: Pre-training a Generalist Encoder-Decoder Vision ...
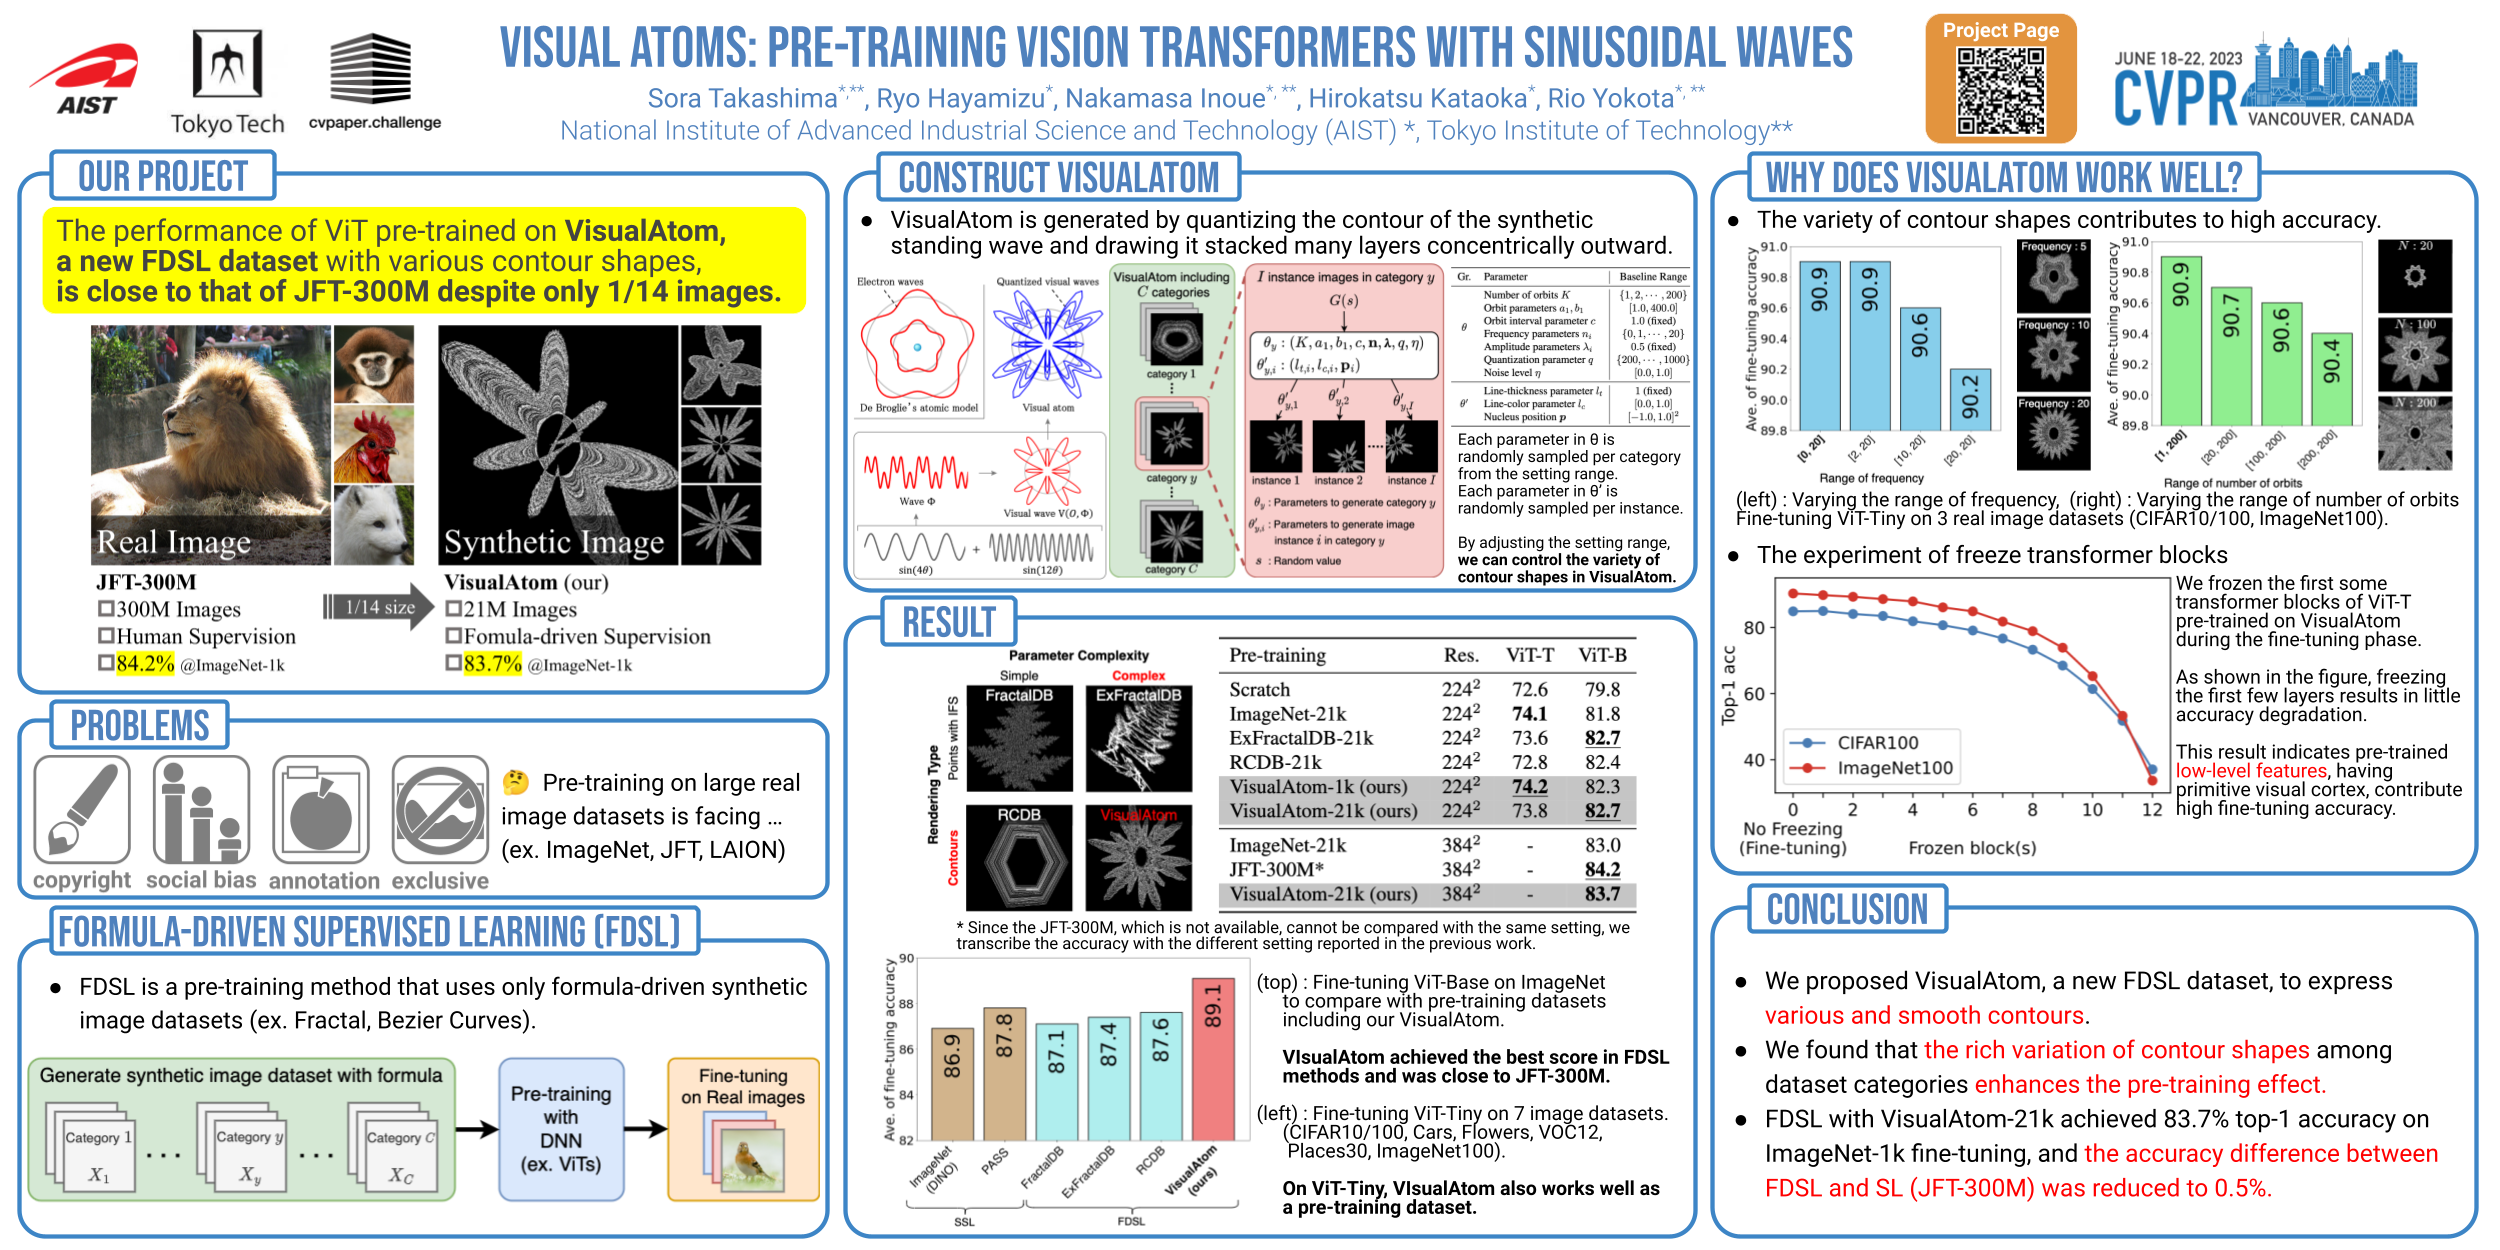
CVPR Poster Visual Atoms: Pre-Training Vision Transformers With ...

CVPR Poster Correlational Image Modeling for Self-Supervised Visual Pre ...
Advertisement Space (336x280)

CVPR Poster Filter Images First, Generate Instructions Later: Pre ...
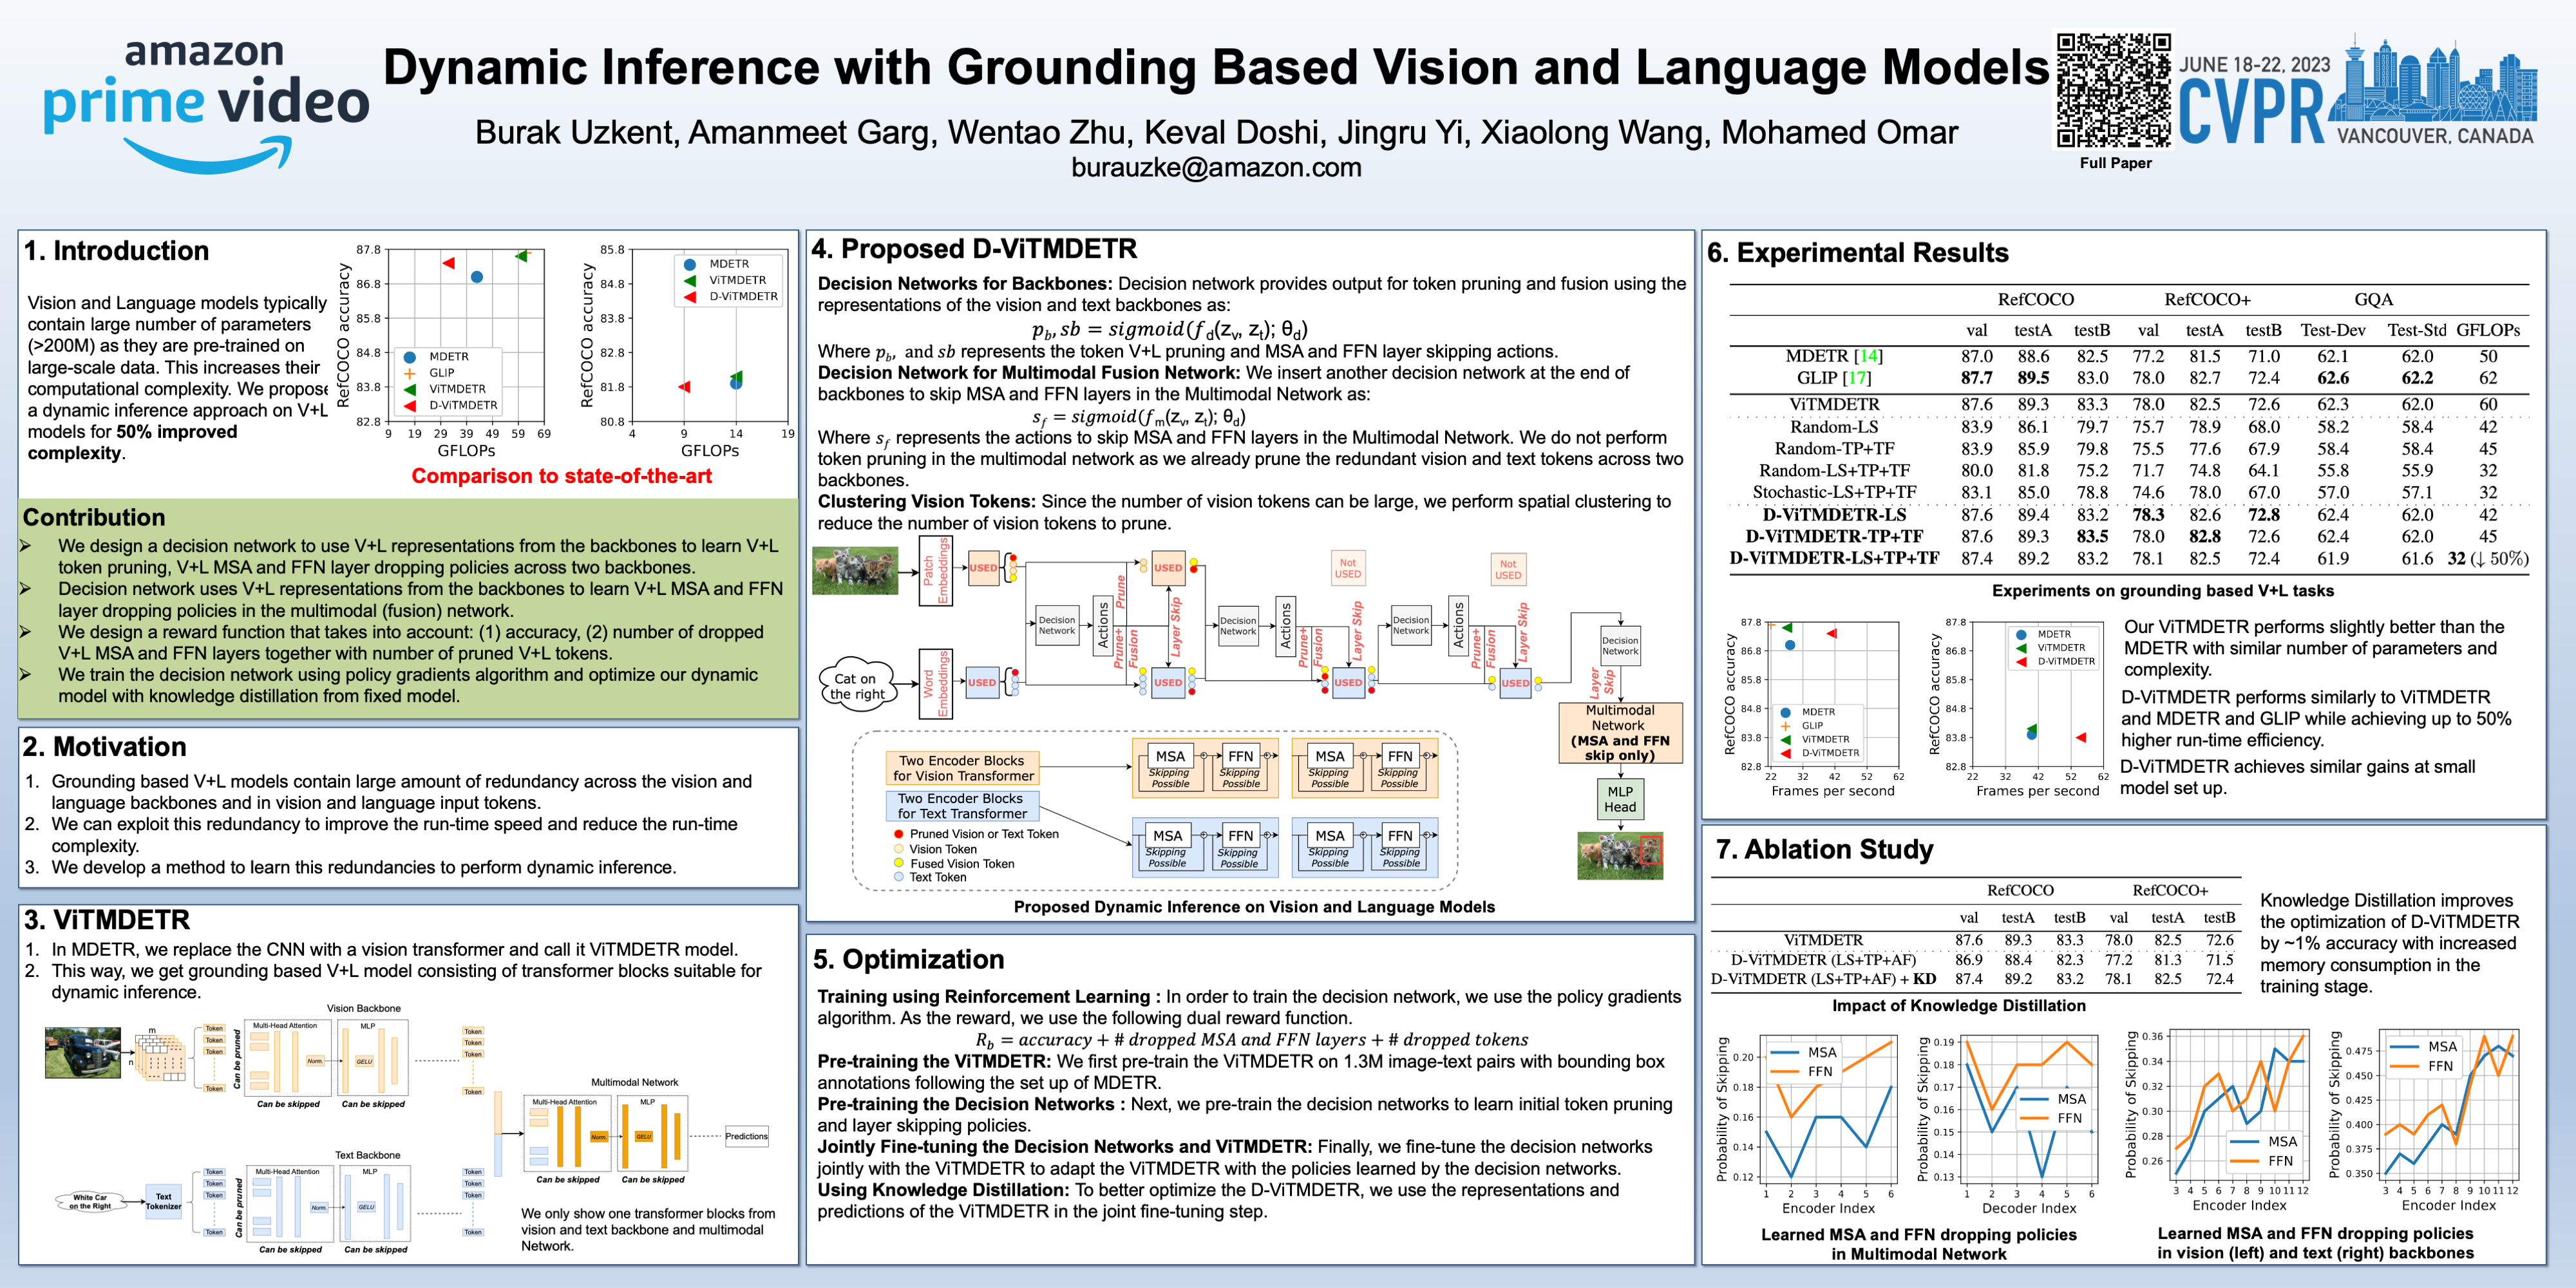
CVPR Poster Dynamic Inference With Grounding Based Vision and Language ...
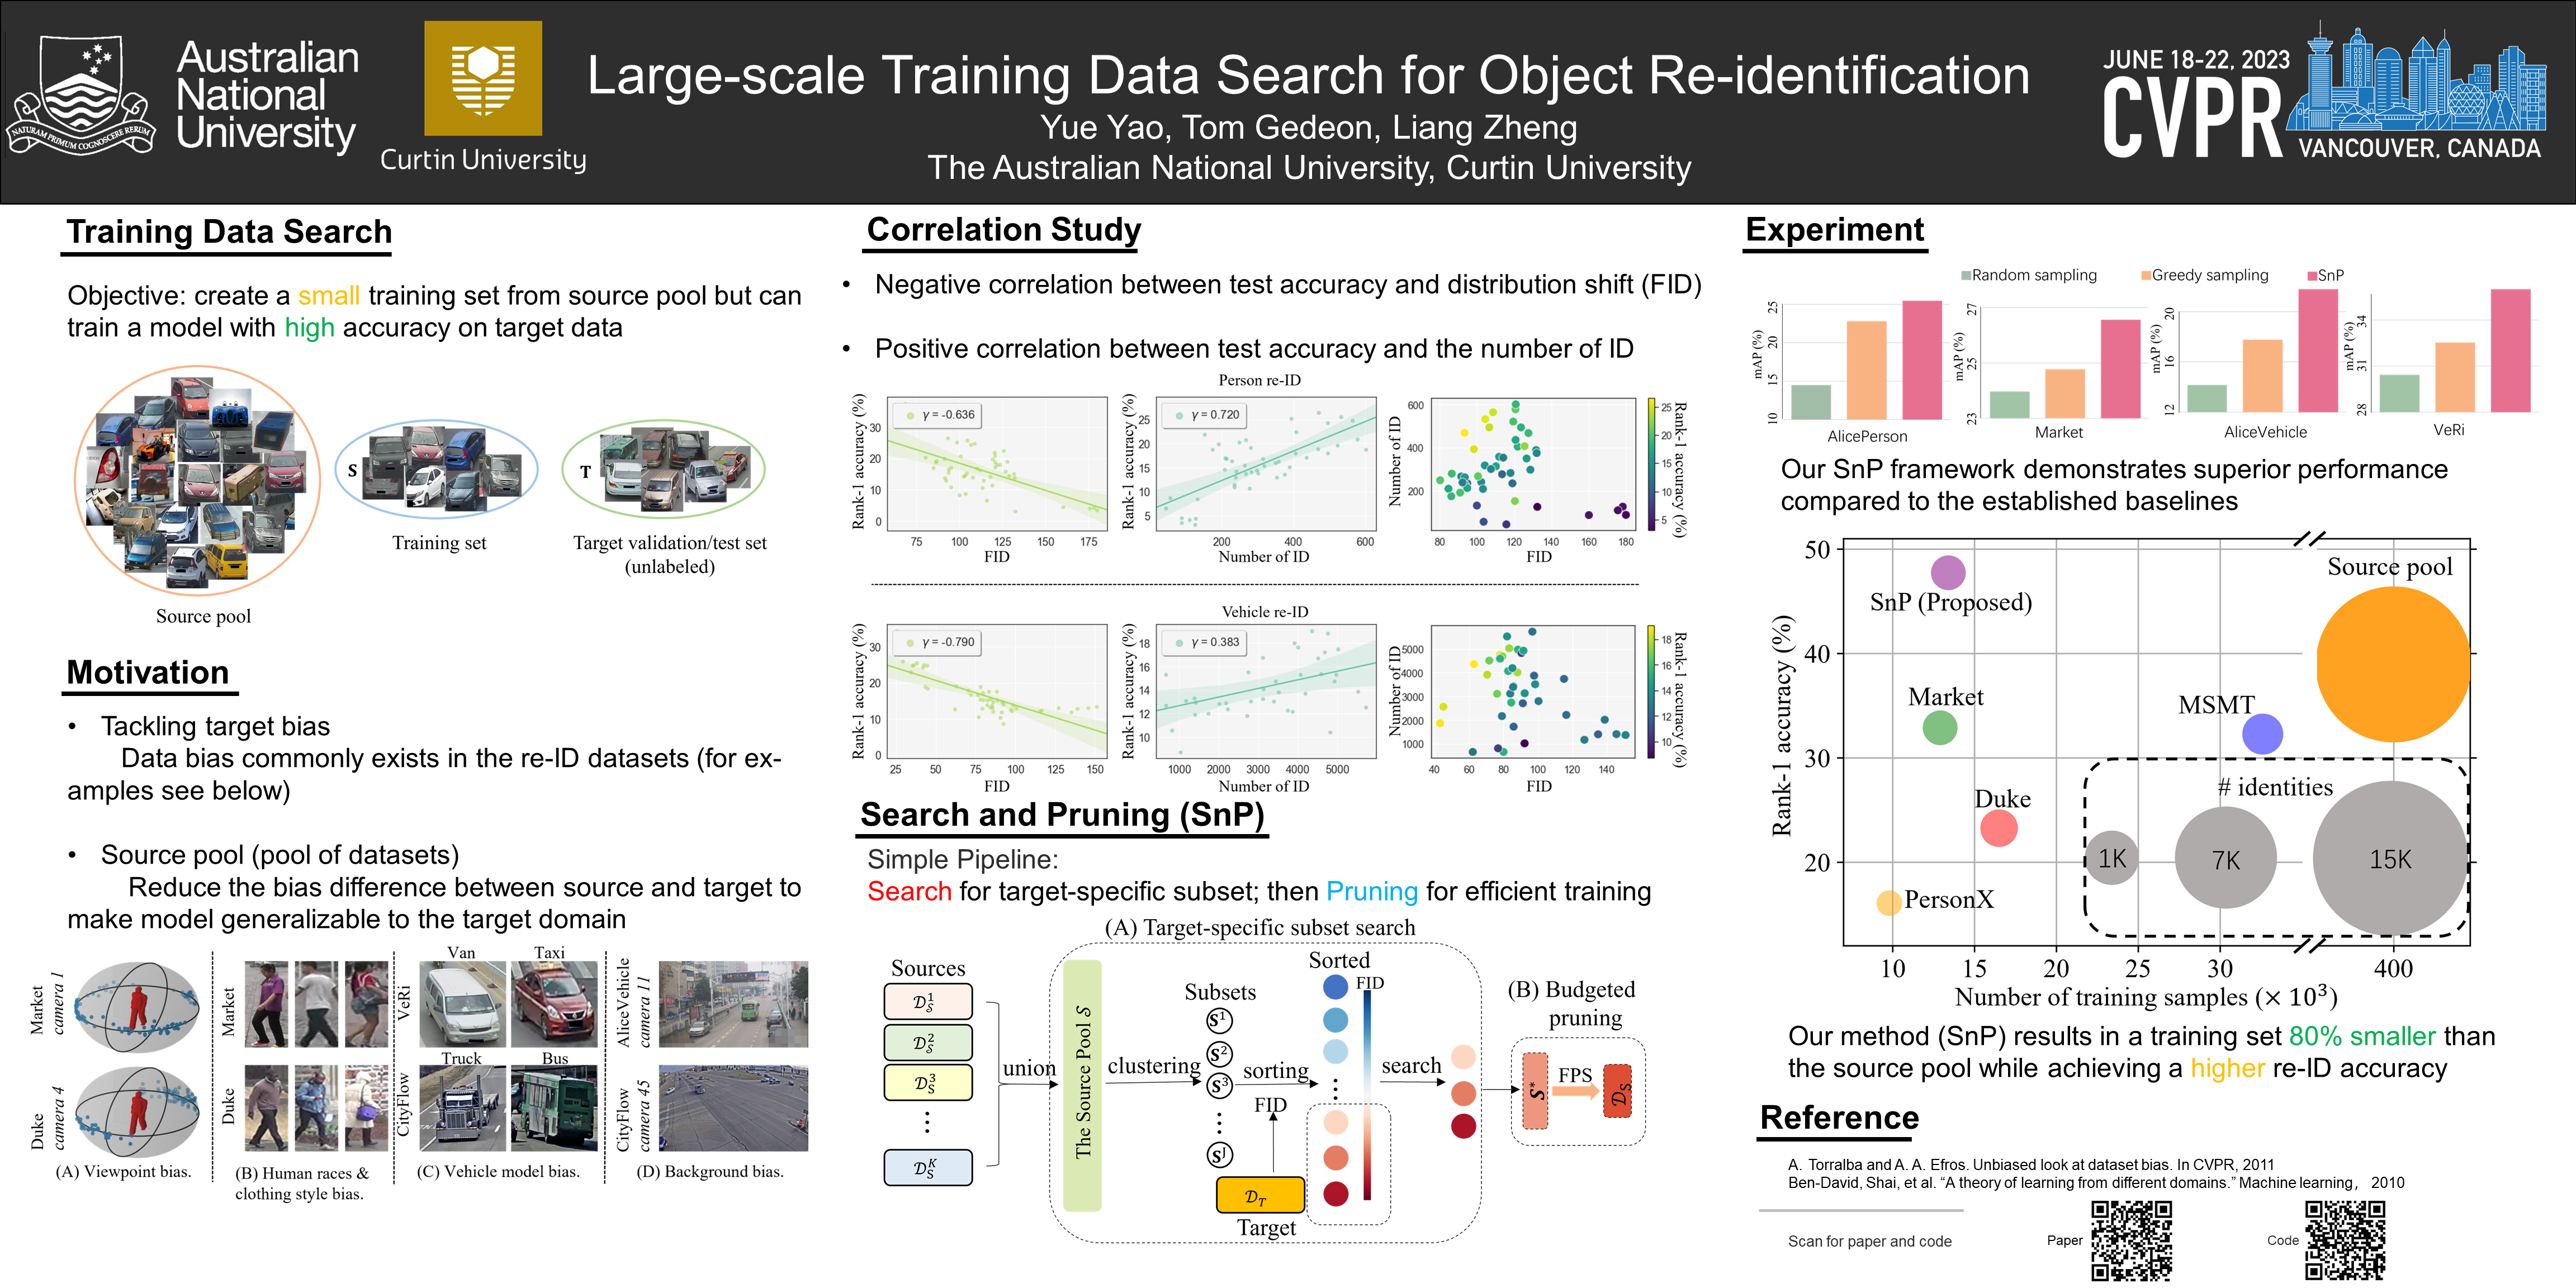
CVPR Poster Large-Scale Training Data Search for Object Re-Identification
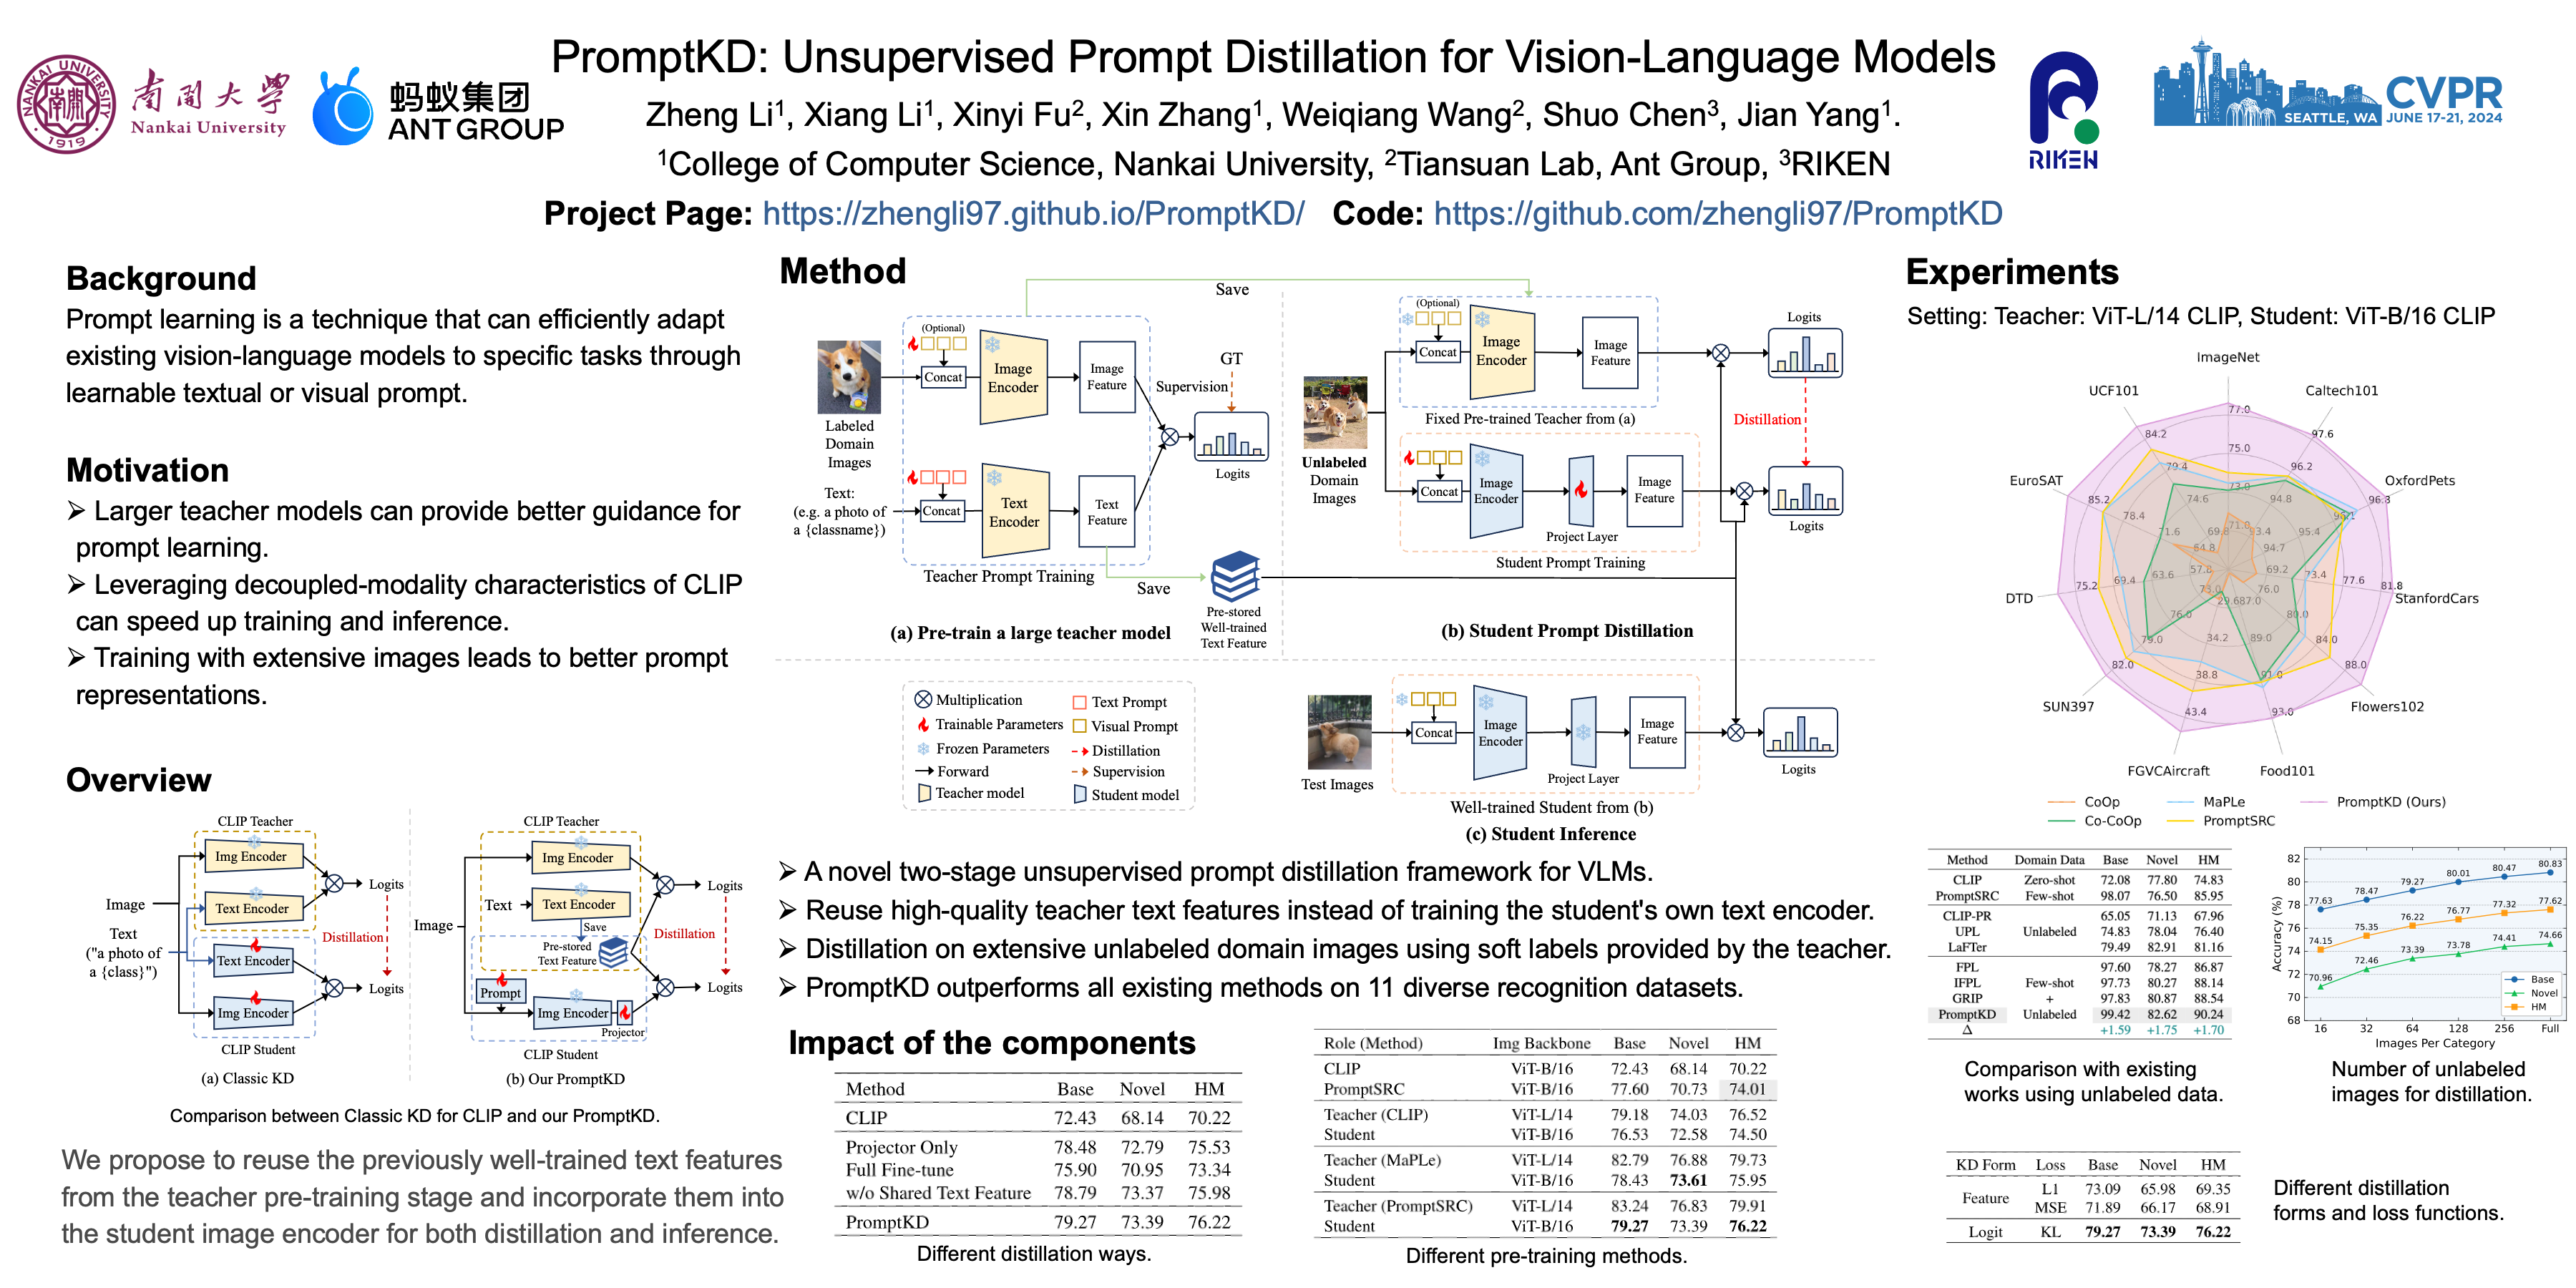
CVPR Poster PromptKD: Unsupervised Prompt Distillation for Vision ...
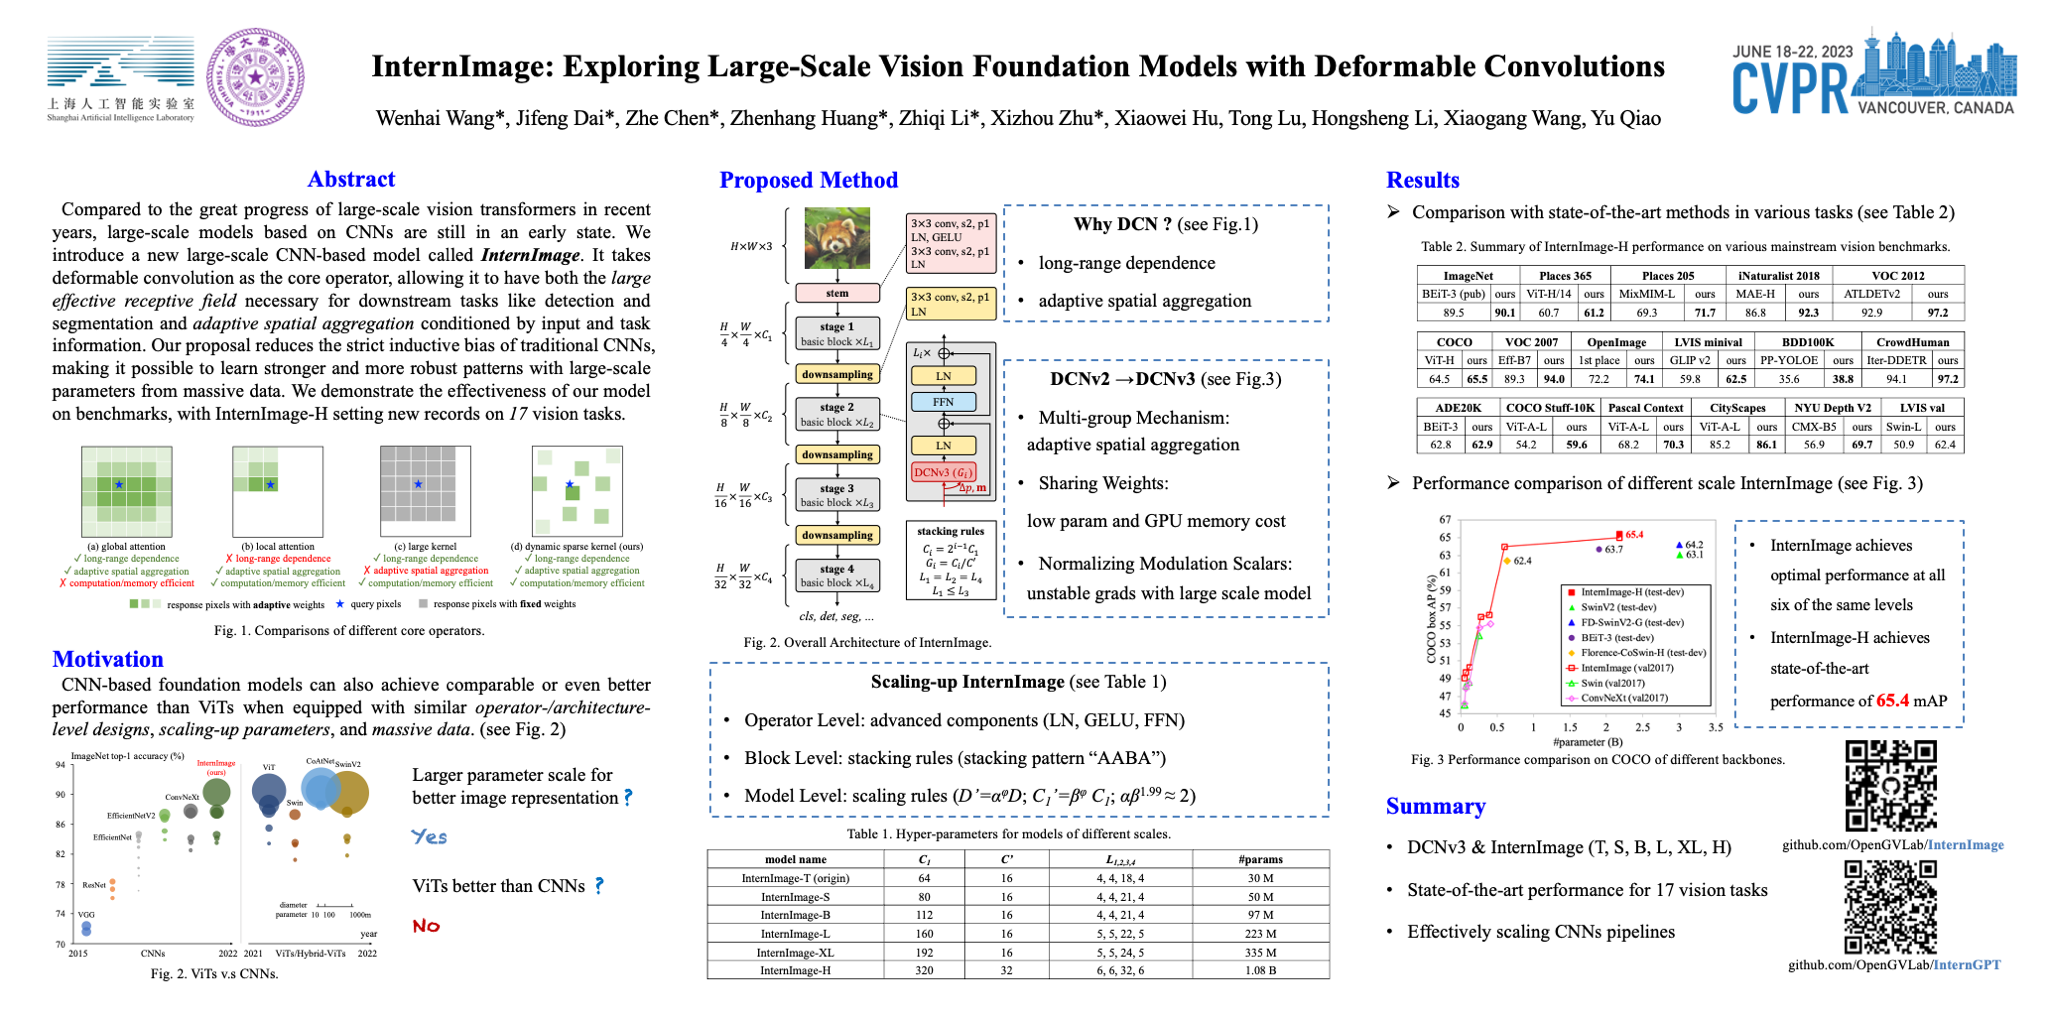
CVPR Poster InternImage: Exploring Large-Scale Vision Foundation Models ...
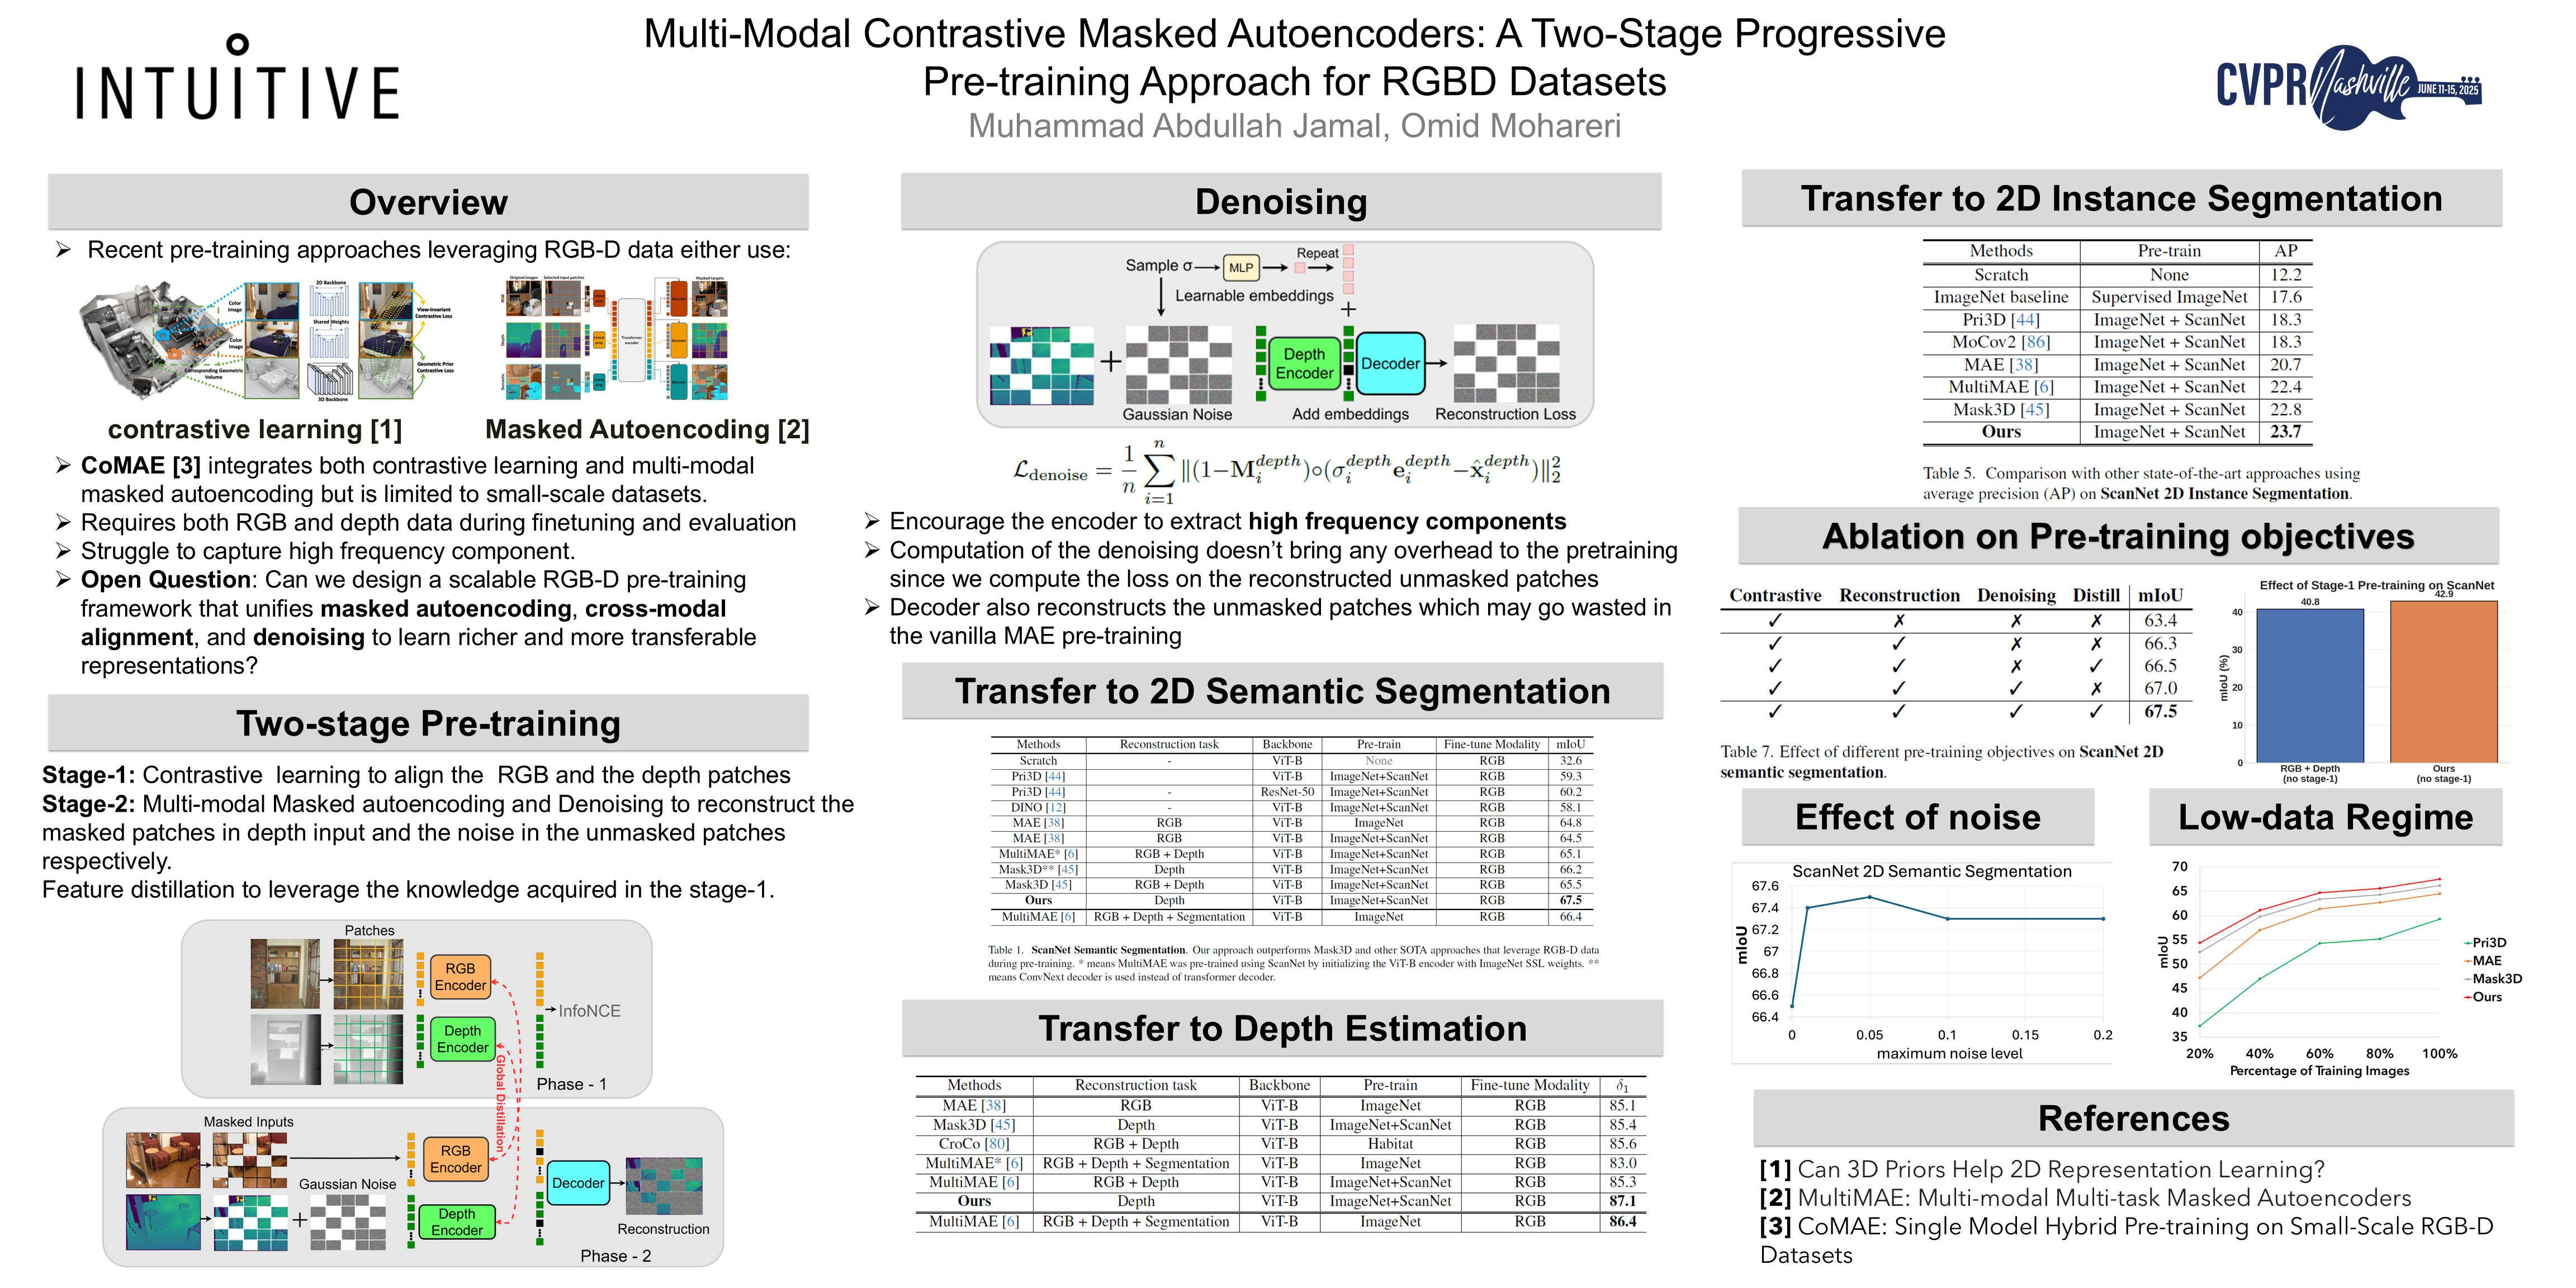
CVPR Poster Multi-Modal Contrastive Masked Autoencoders: A Two-Stage ...