
Distilling Tiny Embeddings

🥃 Distilling Tiny Embeddings
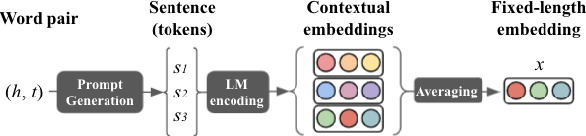
Figure 1 from Distilling Relation Embeddings from Pretrained Language ...

(PDF) Distilling Semantic Concept Embeddings from Contrastively Fine ...

Distilling Semantic Concept Embeddings from Contrastively Fine-Tuned ...

a) HNeRV uses ConvNeXt blocks to encode frames as tiny embeddings ...
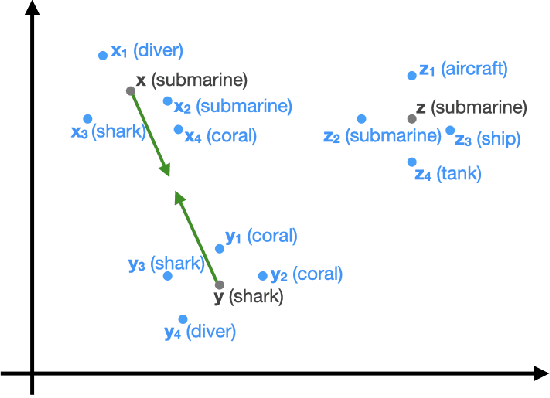
Distilling Semantic Concept Embeddings from Contrastively Fine-Tuned ...

(PDF) DICE: Distilling Classifier-Free Guidance into Text Embeddings

Distilling Knowledge into Tiny LLMs - DEV Community
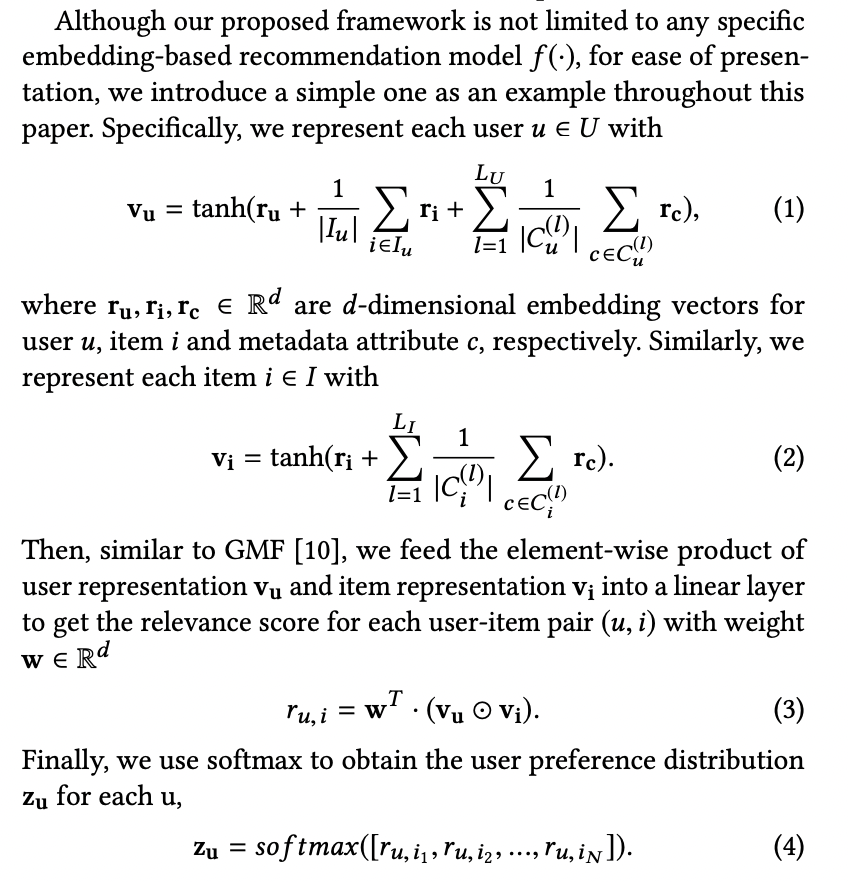
Distilling Structured Knowledge into Embeddings for Explainable and ...
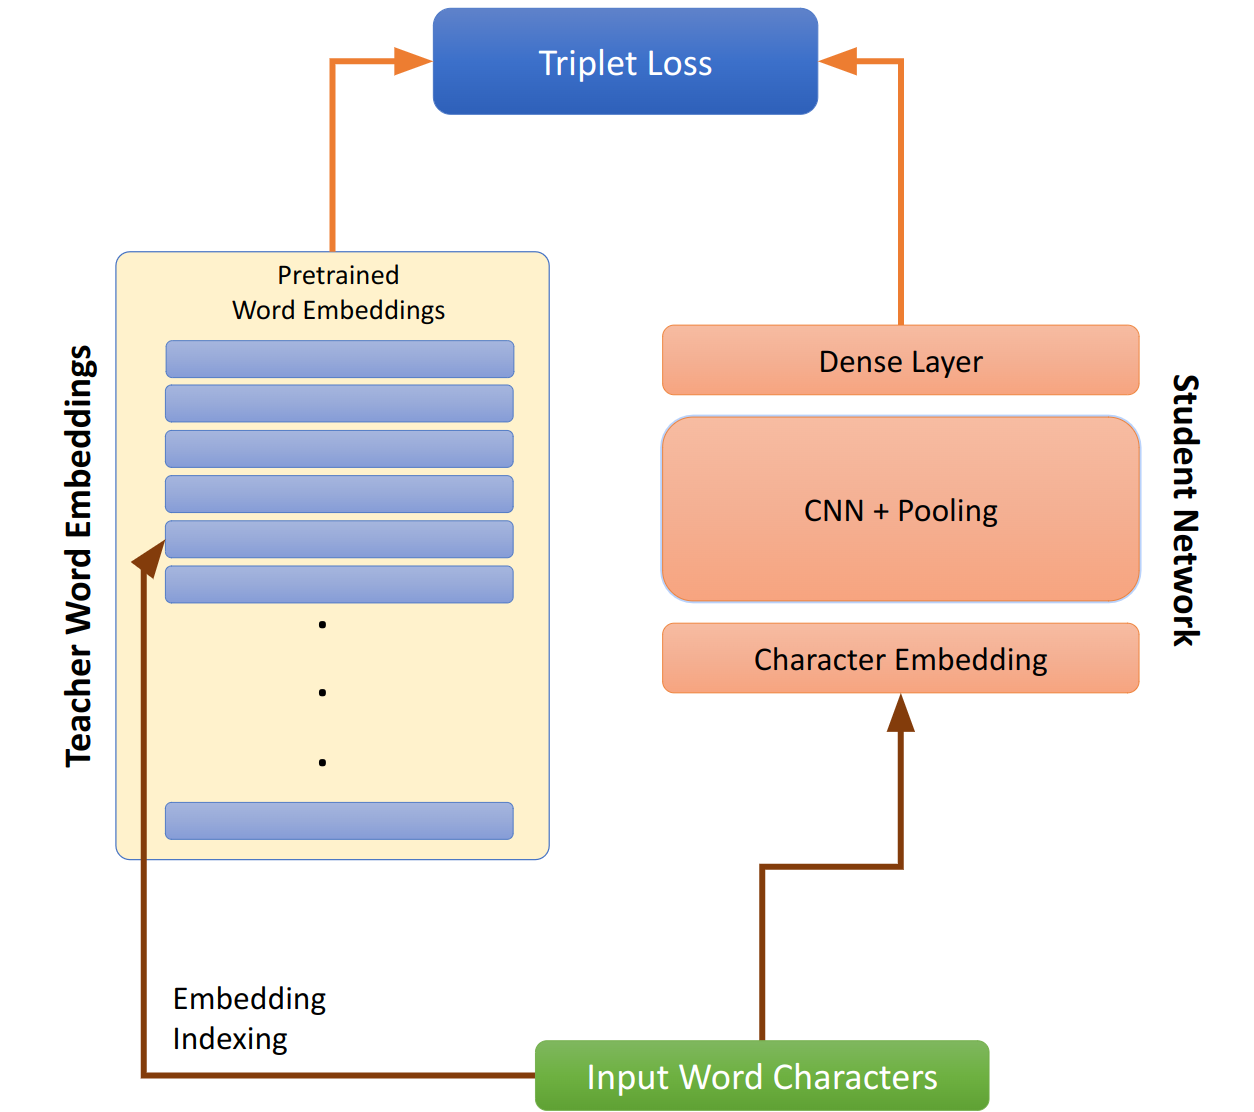
Distilling Word Embeddings via Contrastive Learning | Amanuel Mersha
Advertisement Space (300x250)

Distilling Knowledge into Tiny LLMs

Distilling Semantic Concept Embeddings from Contrastively Fine-Tuned ...

(PDF) Distilling Relation Embeddings from Pre-trained Language Models

Distilling Relation Embeddings from Pre-trained Language Models | Underline
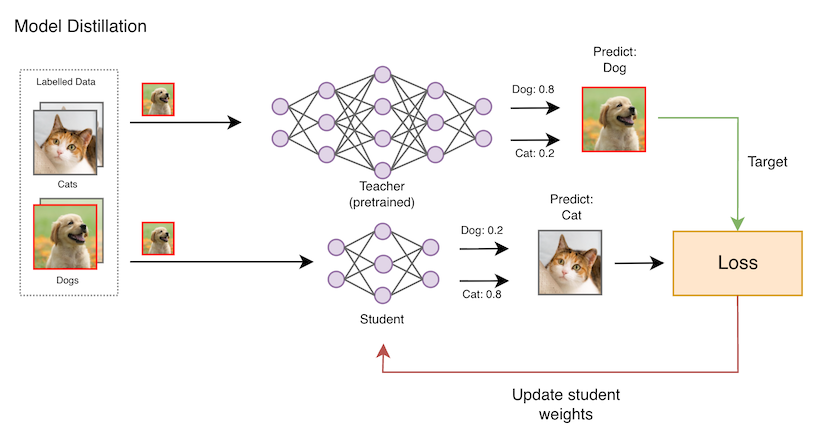
Tiny Language Models | Tristan Penman · Hacker at

Papers Explained 05: Tiny BERT. Knowledge Distillation aims to transfer ...

mxbai-edge-colbert-v0: tiny long context multi-vector embedding models ...

Tiny Distillation Results | Download Scientific Diagram

Figure 1 from Wasserstein Topology Transfer for Joint Distilling ...
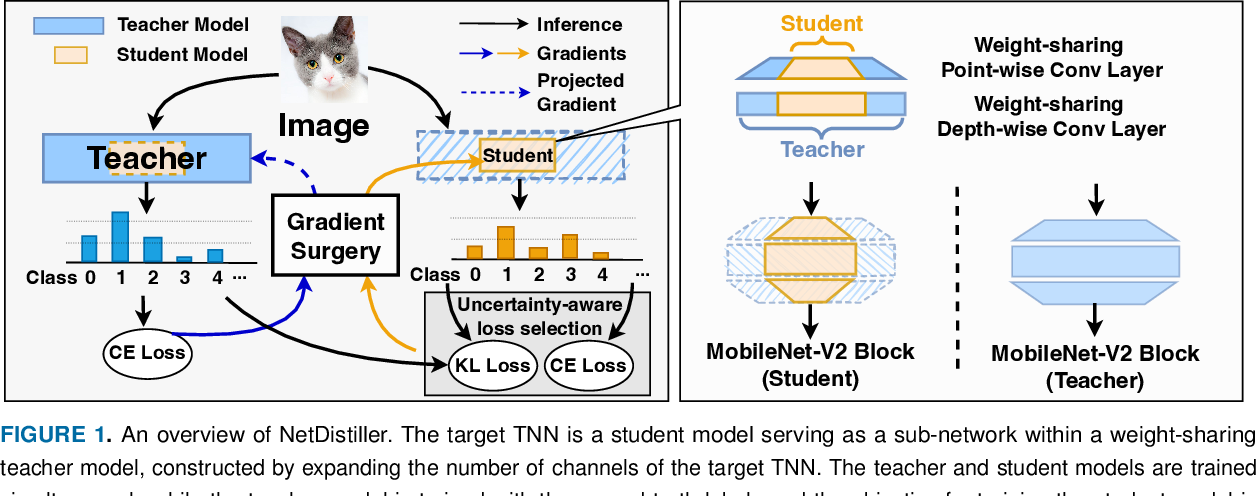
Figure 1 from NetDistiller: Empowering Tiny Deep Learning via In Situ ...
Advertisement Space (336x280)

Distilling Word Embeddings: An Encoding Approach

Training, Distilling, and Embedding Tiny Models in Video Games

Mini Models, New Tricks : Distilling 13B and 4B Models into 135M and ...

Figure 4 from Semi-supervised Knowledge Distillation for Tiny Defect ...

Tiny Distillation Results | Download Scientific Diagram
Feature embedding t-SNE visualization of the penultimate layer for Tiny ...

Figure 1 from Cooperative Knowledge-Distillation-Based Tiny DNN for UAV ...

Multi-Sense Embeddings for Language Models and Knowledge Distillation ...

[논문 리뷰] TinyThinker: Distilling Reasoning through Coarse-to-Fine ...
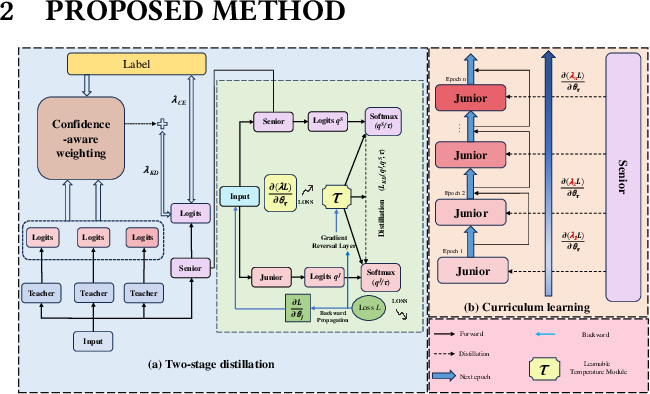
Figure 1 from Distilling Knowledge Based on Curriculum Learning for ...
Advertisement Space (336x280)
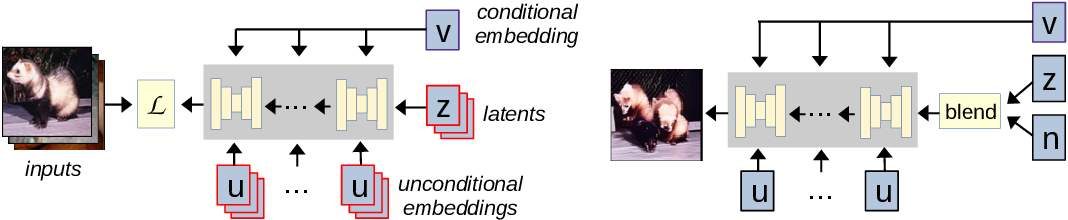
Figure 1 from Tiny models from tiny data: Textual and null-text ...

Figure 1 from Wasserstein Topology Transfer for Joint Distilling ...

Embedding the Teacher: Distilling vLLM Preferences for Scalable Image ...

[논문 리뷰] Multi-Sense Embeddings for Language Models and Knowledge ...
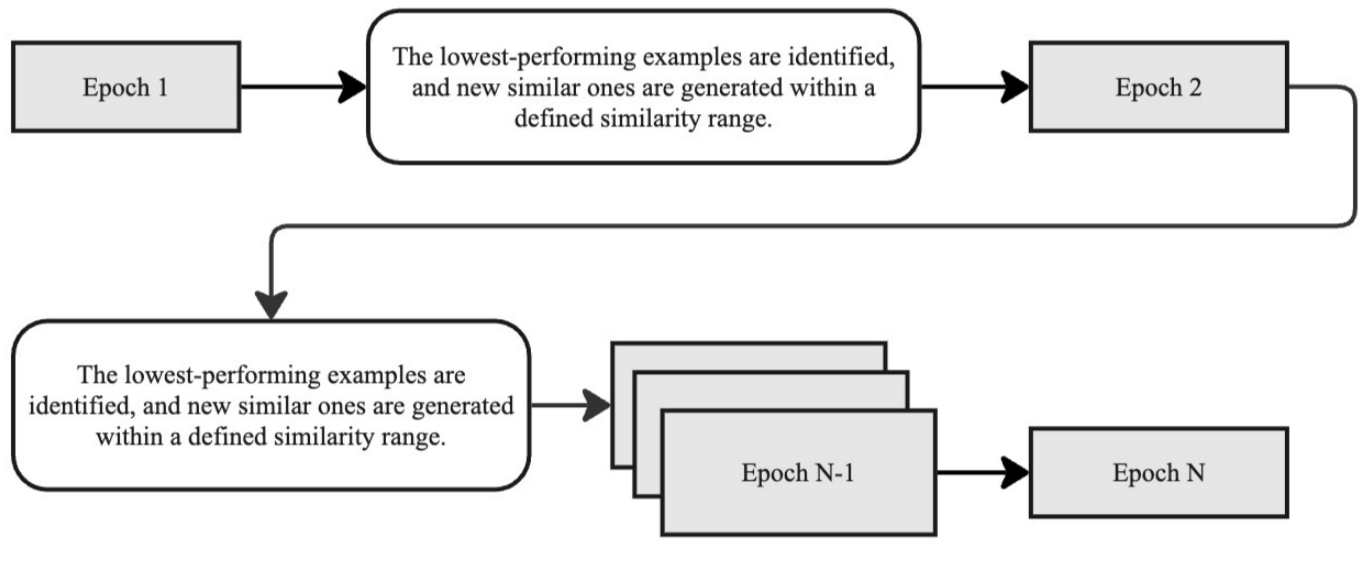
[논문 리뷰] Synthetic Adaptive Guided Embeddings (SAGE): A Novel Knowledge ...
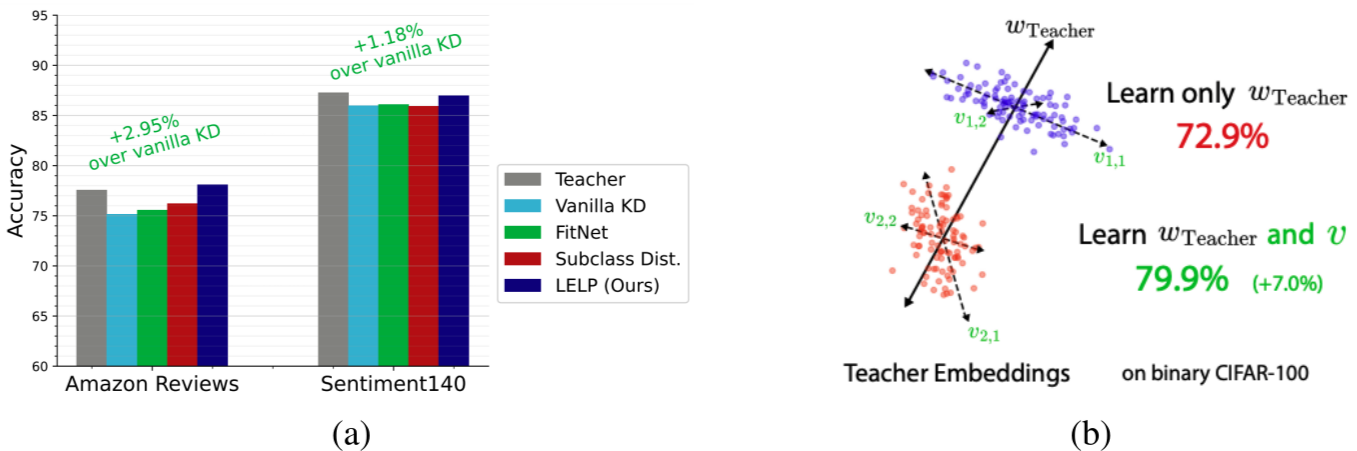
[논문 리뷰] Linear Projections of Teacher Embeddings for Few-Class Distillation