
Does Vllm Support Kv Cache Between Multi Turn Conversation Issue
Does vllm support KV-cache between multi-turn conversation · Issue ...
[Performance]: KV Cache Size Comparison vLLM vs SGLang · Issue #21348 ...
[Bug]: vllm serve kv cache does not seem to persist properly across ...

混合 KV Cache 管理器 - vLLM - vLLM 文件
[Installation]: vLLM KV Cache Initialization Error Despite Sufficient ...
vLLM stops all processing when CPU KV cache is used, has to be shut ...
GitHub - QuasarRevival/vLLM-with-KV-Cache-Sparsity: vLLM with KV cache ...

混合 KV Cache 管理器 - vLLM - vLLM 文件
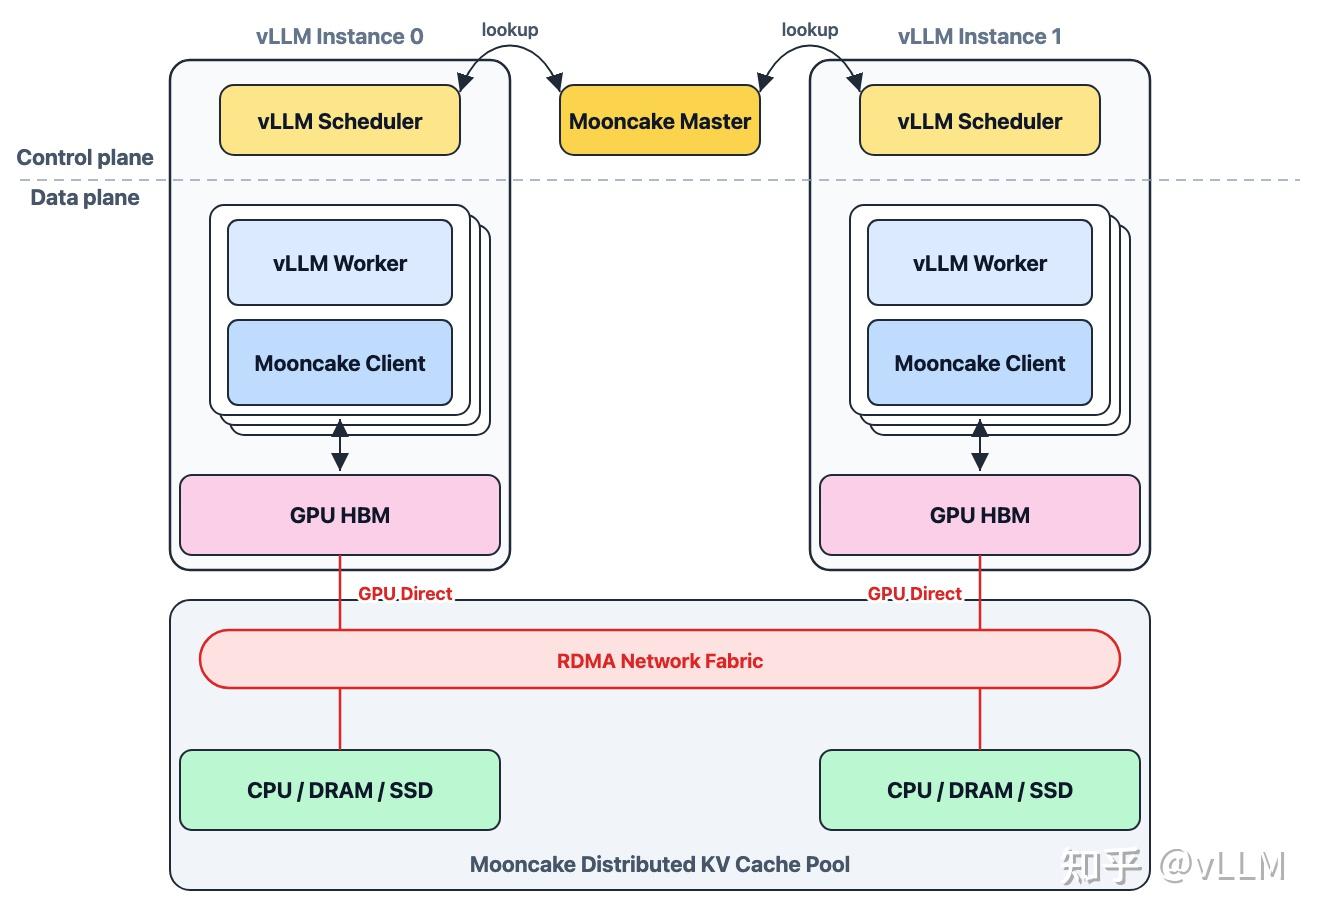
vLLM × Mooncake:用分布式 KV Cache Pool 服务大规模 Agentic 推理 - 知乎
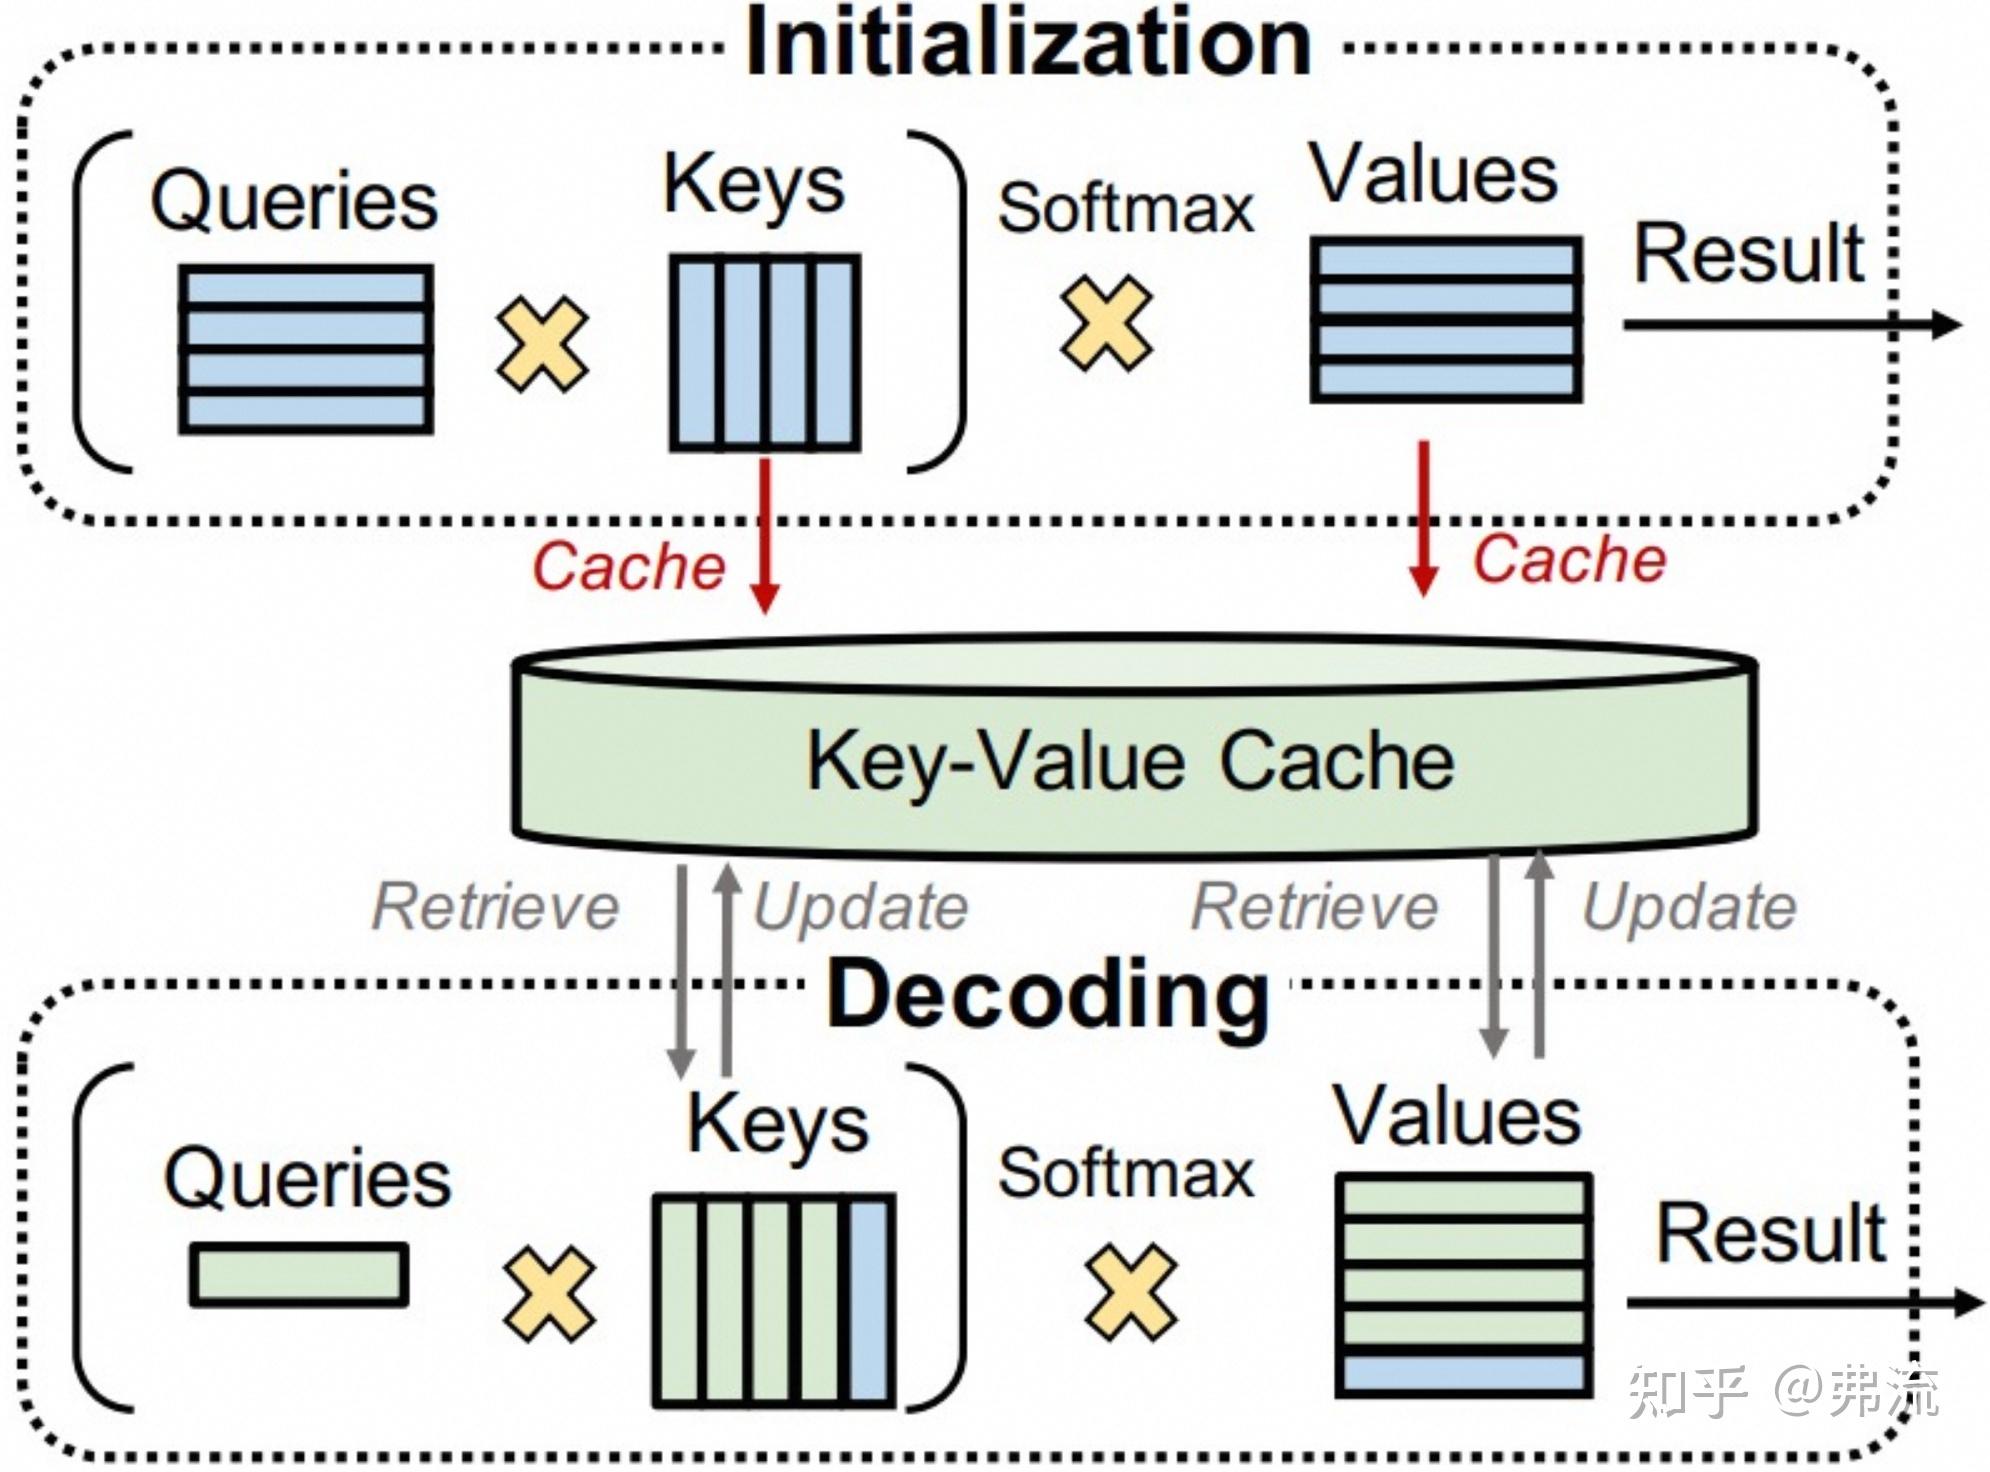
vLLM V1 源码解读(二):PagedAttention——用操作系统的思想管 GPU 的 KV Cache - 知乎
Advertisement Space (300x250)

vLLM KV Cache 实现要点 | LIAO JIAYI Blog

Scaling Multi-Turn LLM Inference with KV Cache Storage Offload and Dell ...
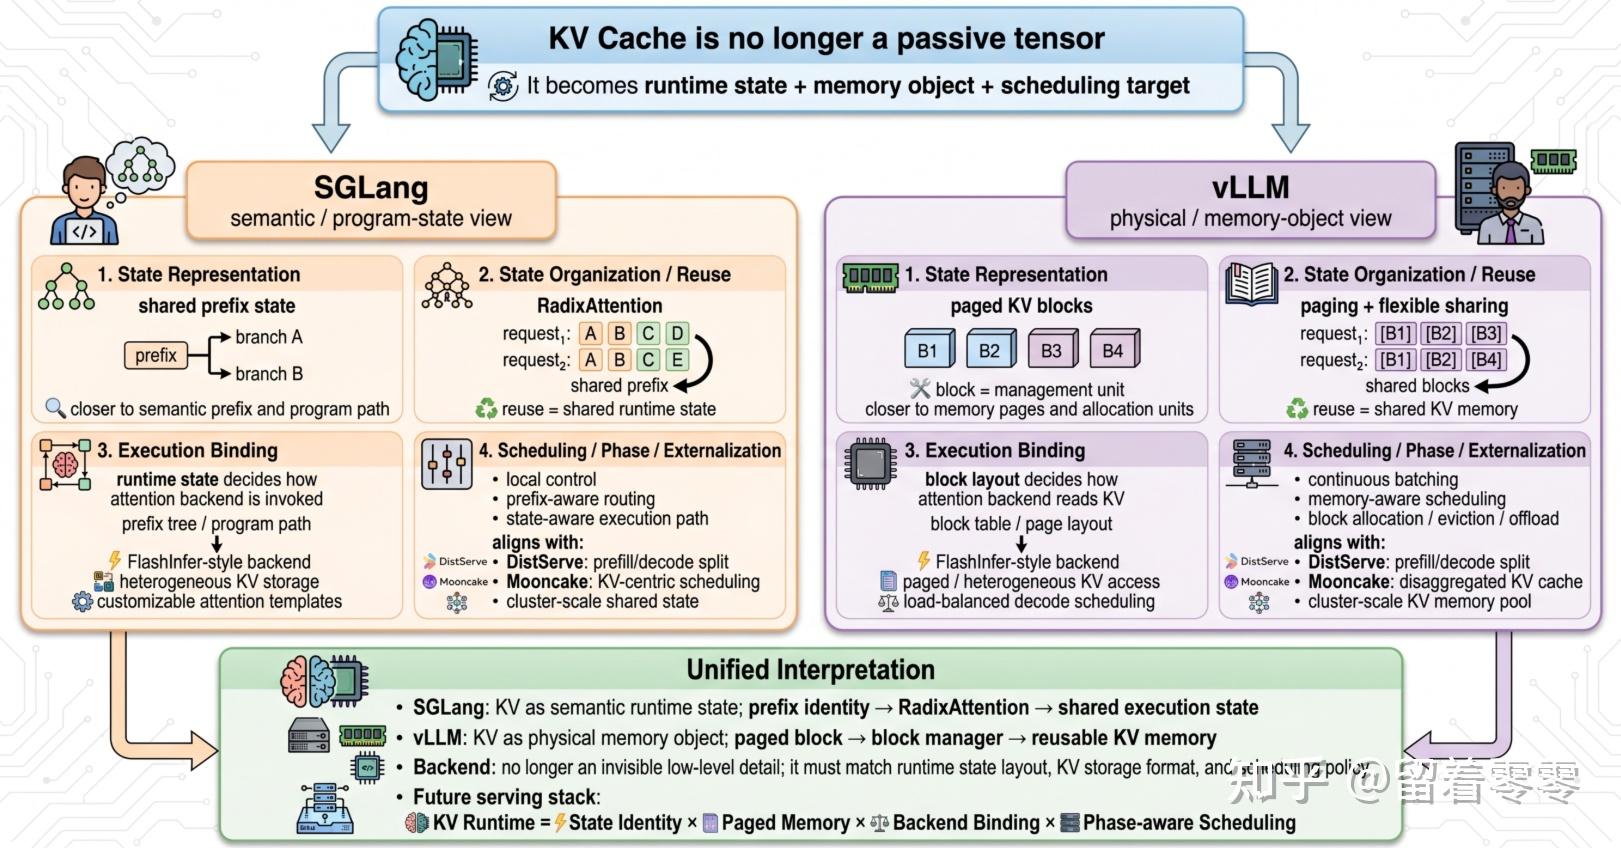
图示理解KV Cache System,统一视角理解 SGLang 与 vLLM 的系统范式 - 知乎
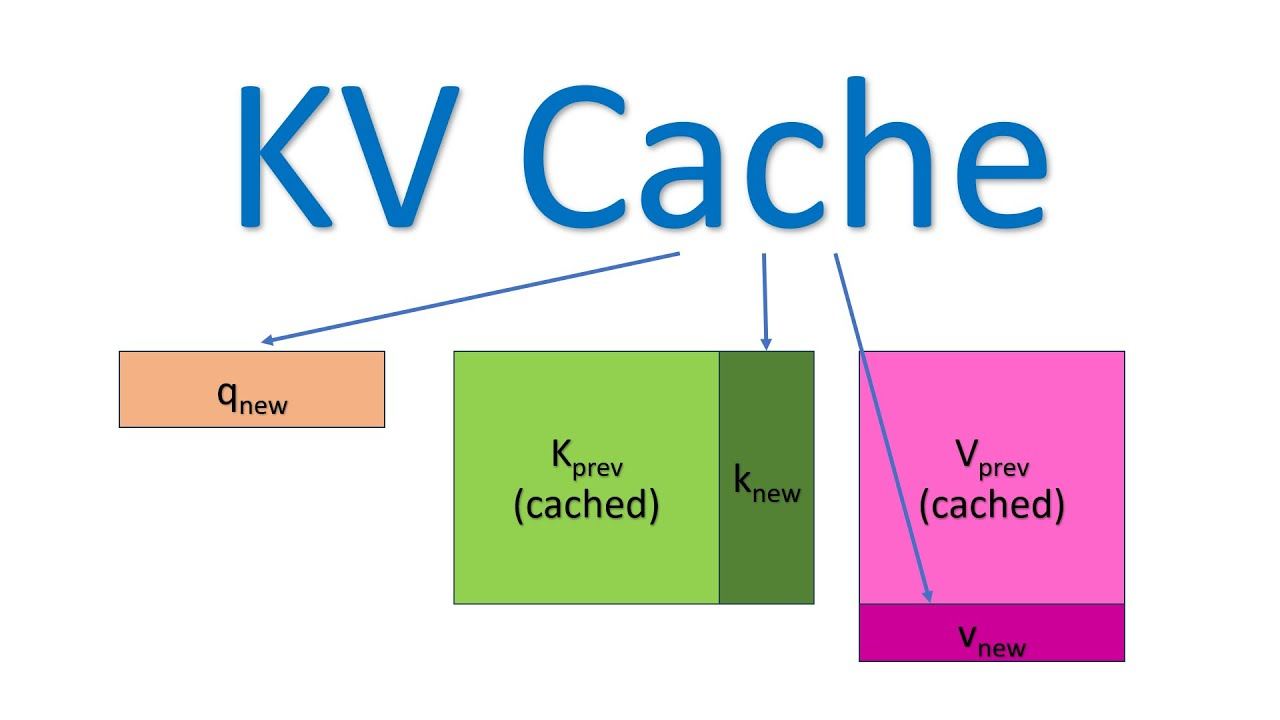
KV Cache 详解:新手也能理解的 LLM 推理加速技巧-CSDN博客

Global Multi-Level KV Cache - xLLM

[vLLM vs TensorRT-LLM] #8. KV Cache Quantization - SqueezeBits ...
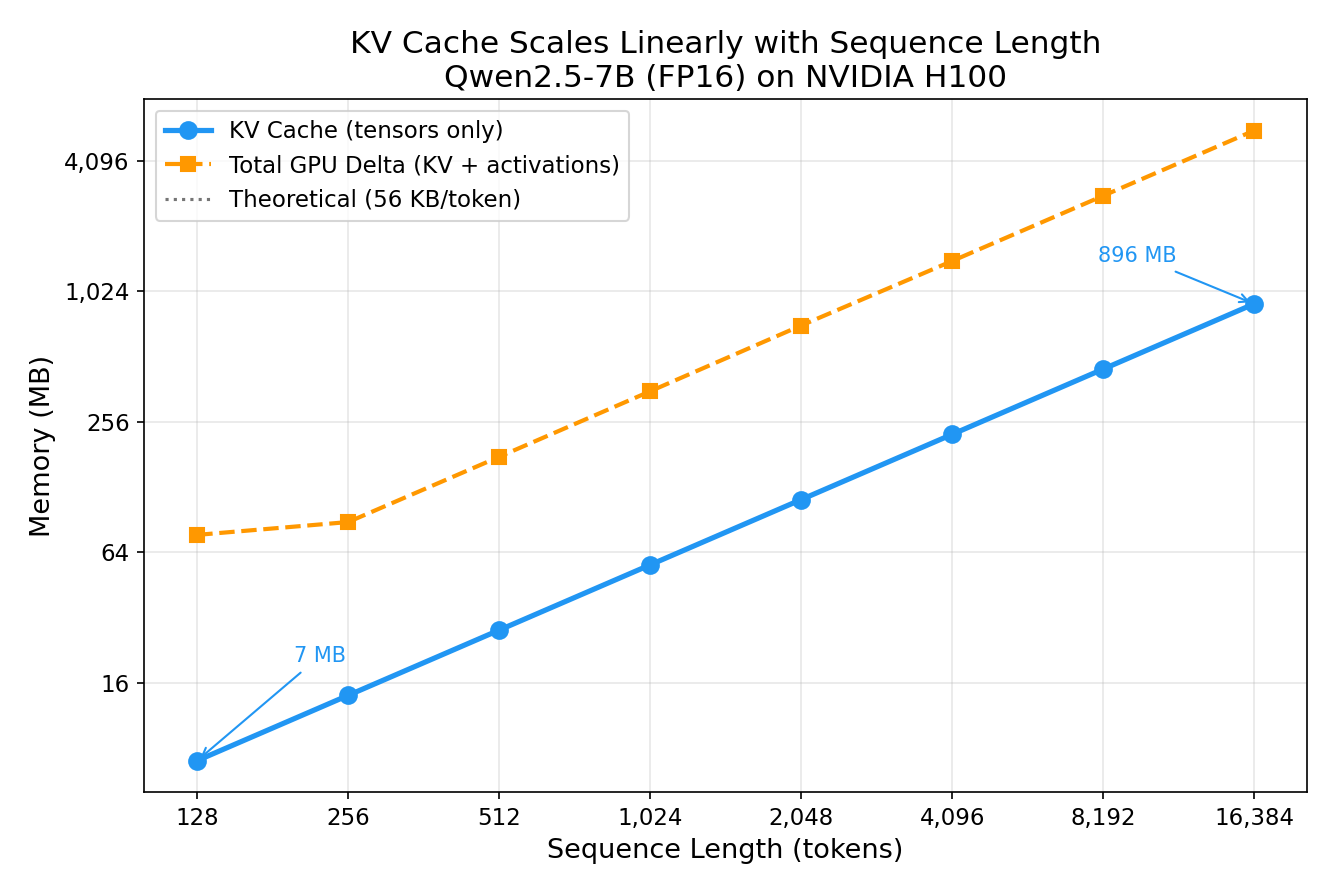
Understanding KV Cache in LLM Inference - Jingchao’s Website

高效推理的核心:vLLM V1 KV cache 管理机制剖析 - 知乎
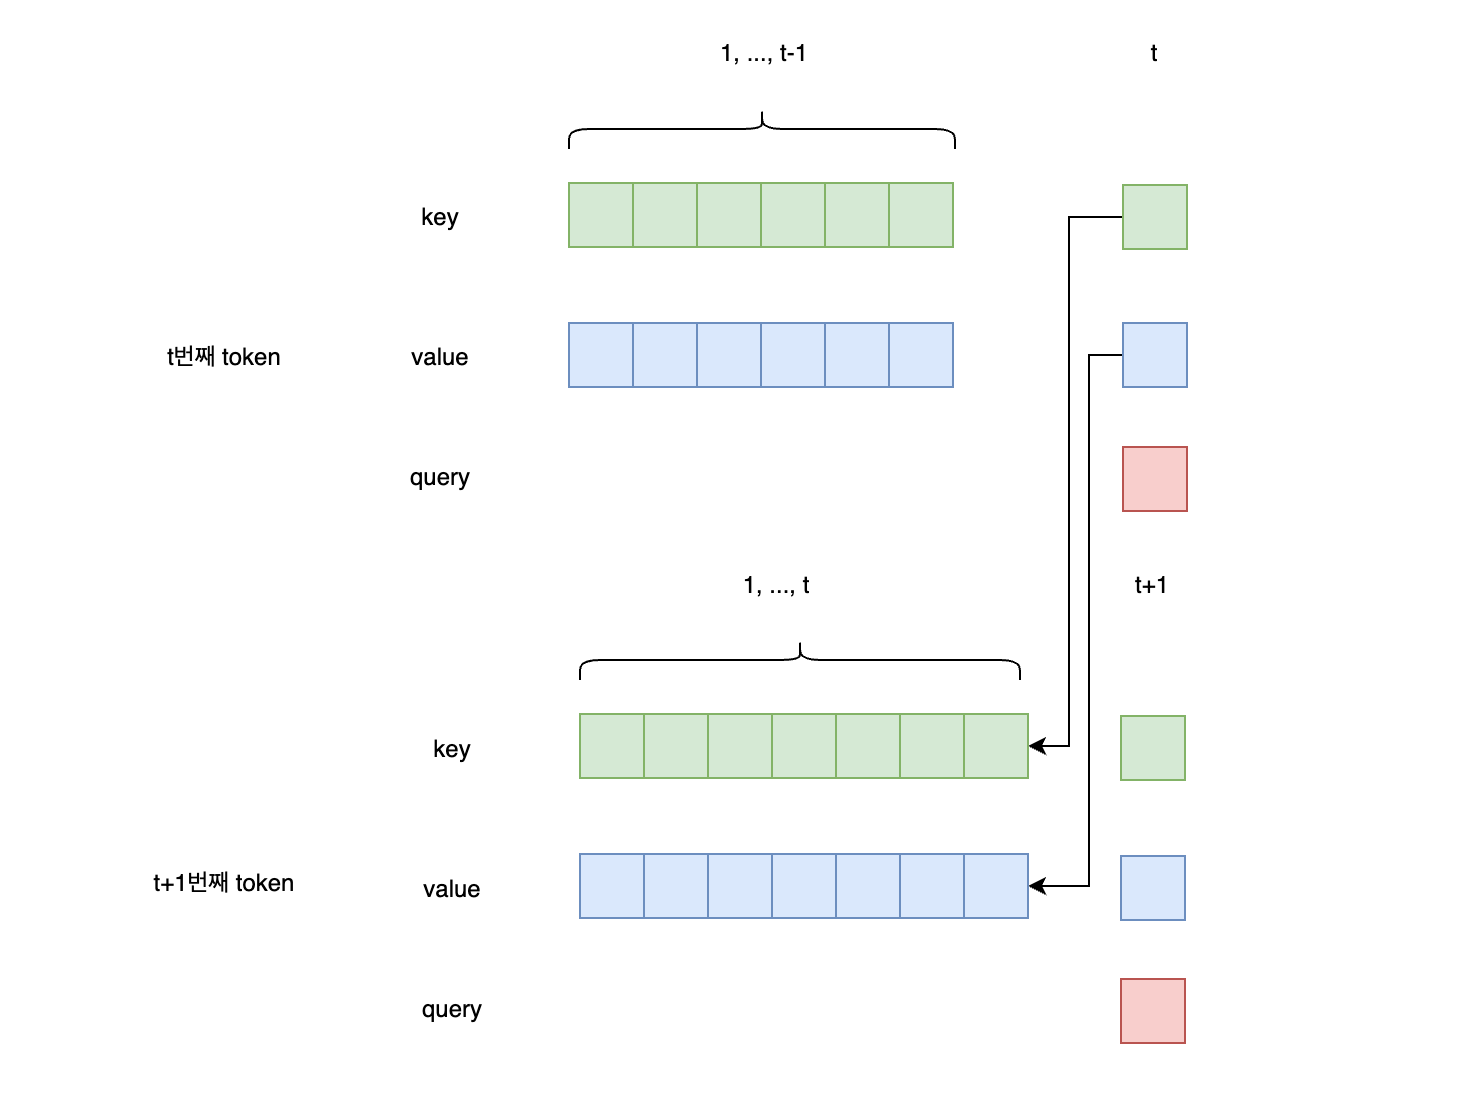
LLM 서빙과 KV Cache, vLLM
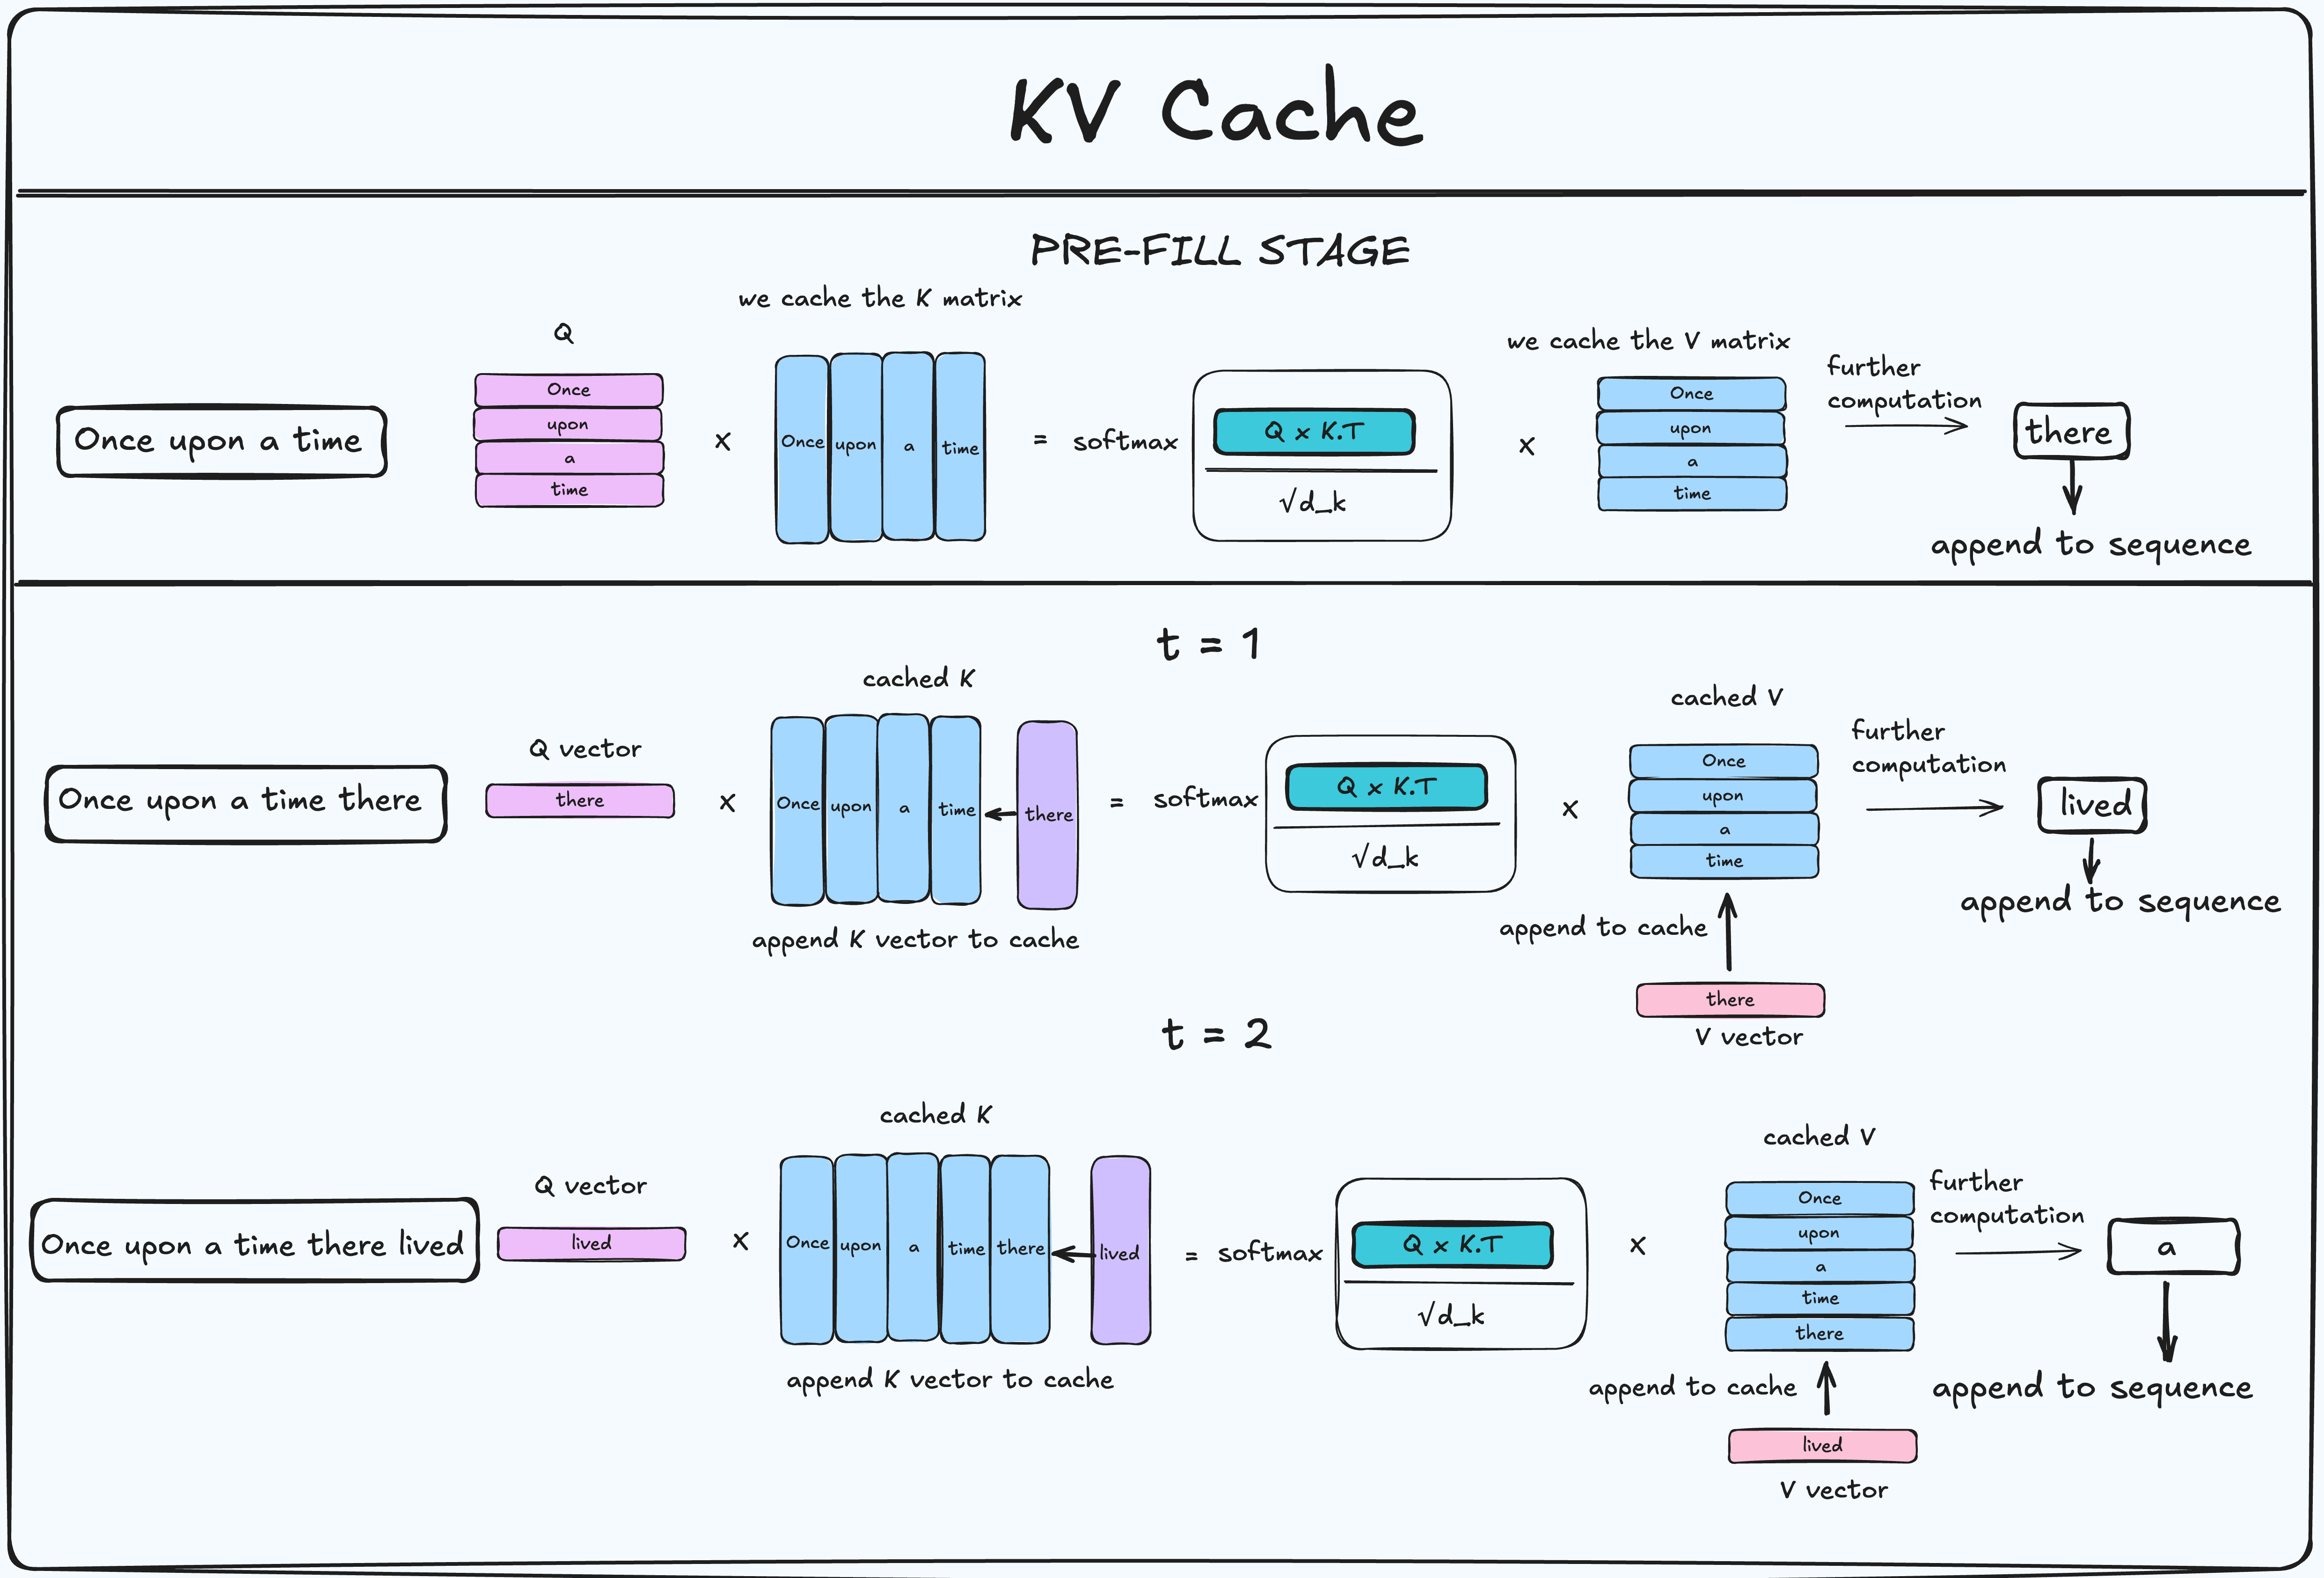
KV Cache From First Principles
Advertisement Space (336x280)

[vLLM vs TensorRT-LLM] #8. KV Cache Quantization - SqueezeBits

How to Reduce KV Cache Bottlenecks with NVIDIA Dynamo | NVIDIA ...
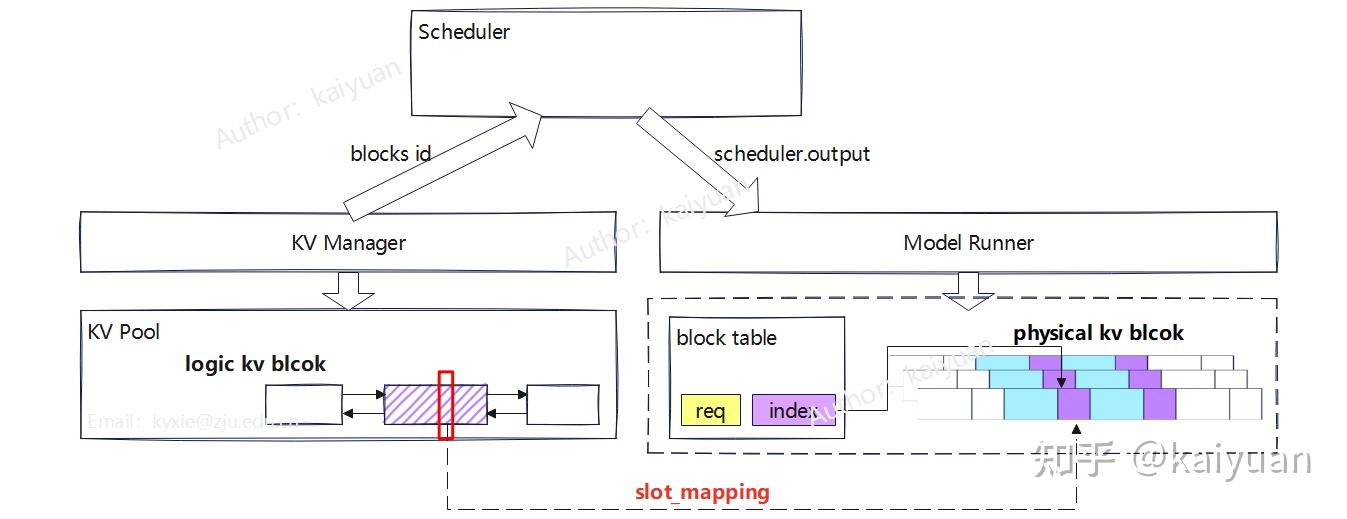
高效推理的核心:vLLM V1 KV cache 管理机制剖析 - 知乎
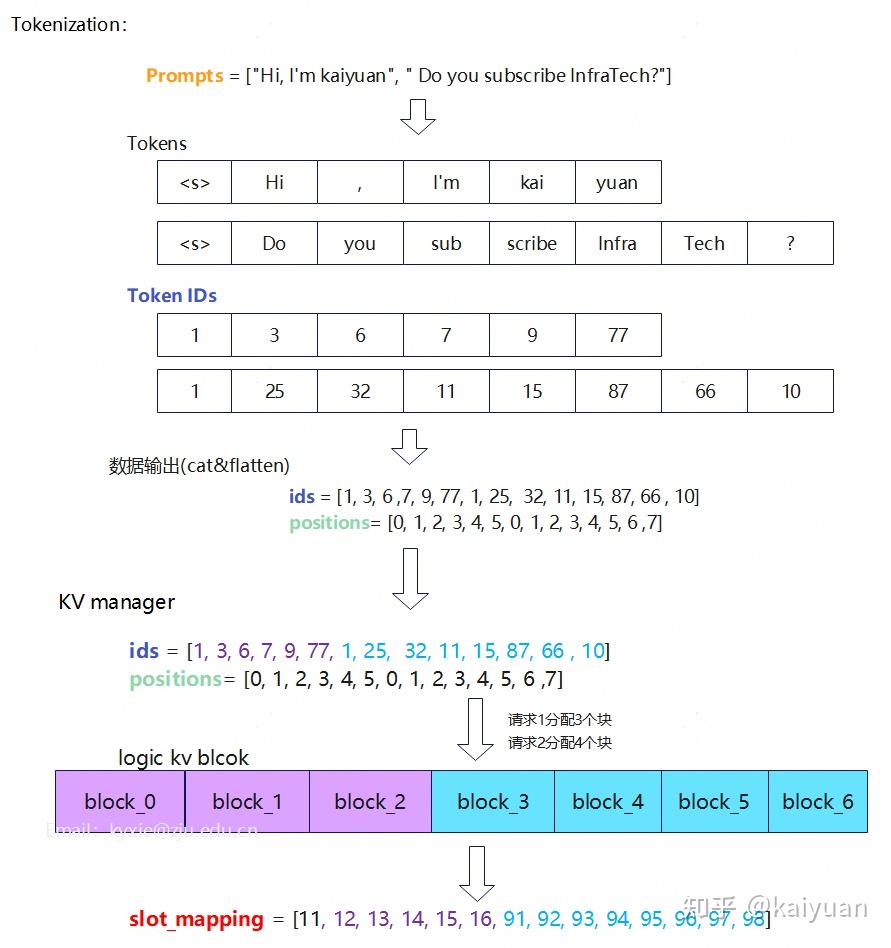
高效推理的核心:vLLM V1 KV cache 管理机制剖析 - 知乎
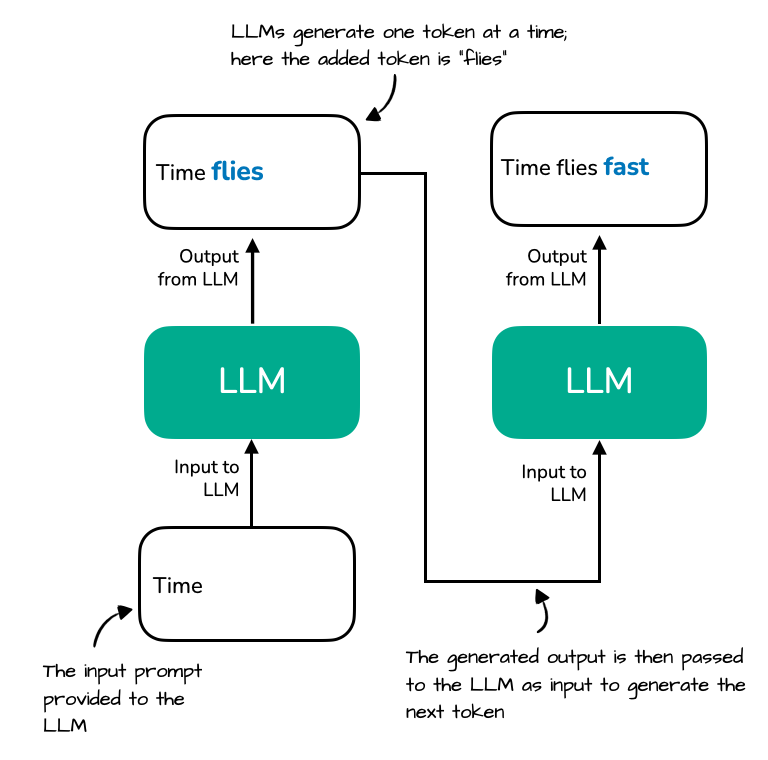
Understanding and Coding the KV Cache in LLMs from Scratch

图示理解KV Cache System,统一视角理解 SGLang 与 vLLM 的系统范式 - 知乎
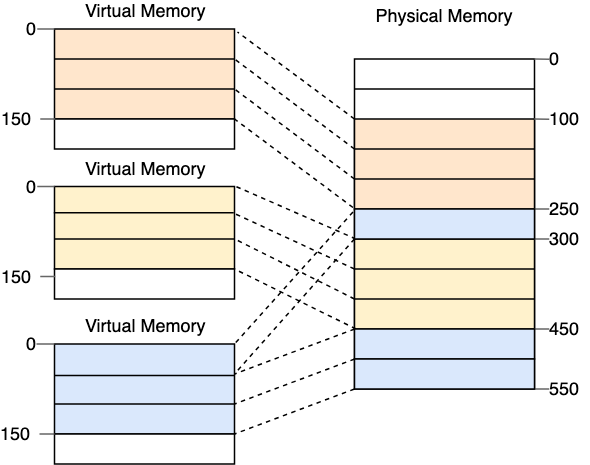
LLM 서빙과 KV Cache, vLLM

Caching Strategies for VLM Inference: vLLM APC vs LangChain Cache | by ...

KV Cache Management and Prefix Caching | vllm-project/vllm | DeepWiki

LLM inference engines performance testing: SGLang VS. vLLM | by ...
Advertisement Space (336x280)

vLLM Throughput Guide - PagedAttention and Batching Tips (2026)

vLLM 源码学习 | SongXJ's Blog
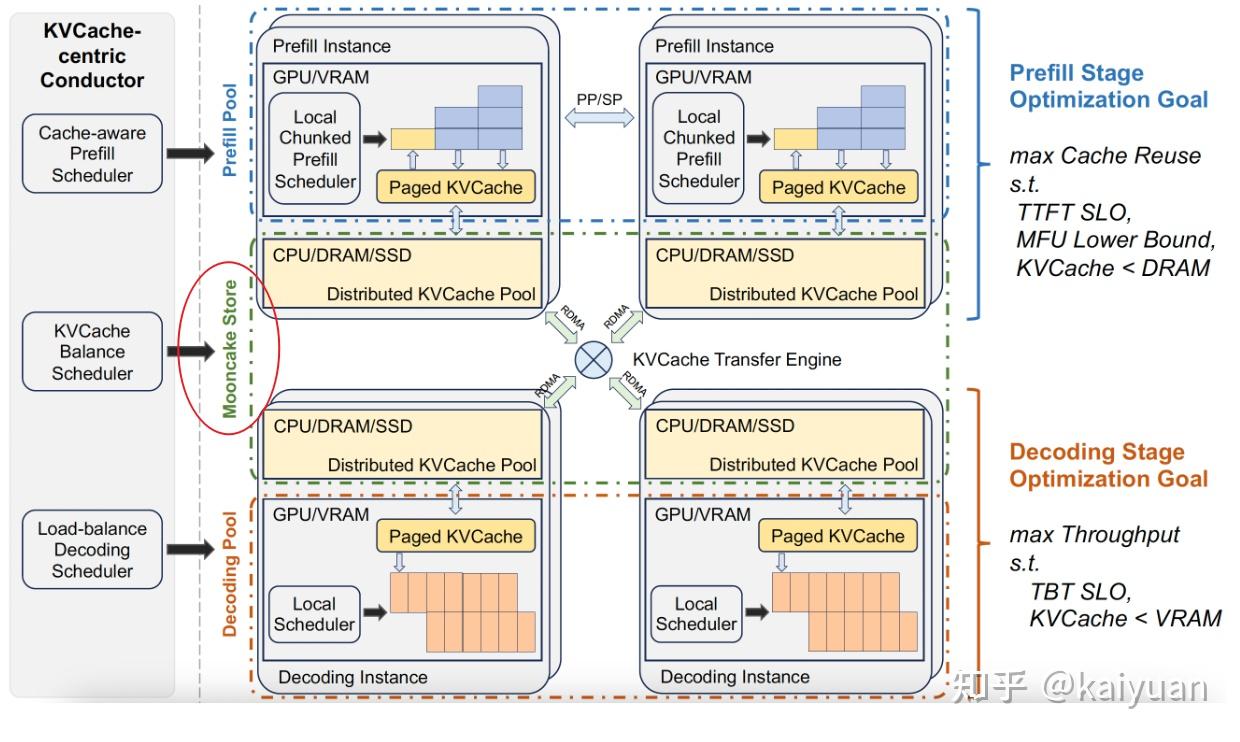
vLLM PD分离KV cache传递机制详解与演进分析 - 知乎

CacheTTL: Efficient and Robust Multi-Turn LLM Agent Scheduling with KV ...
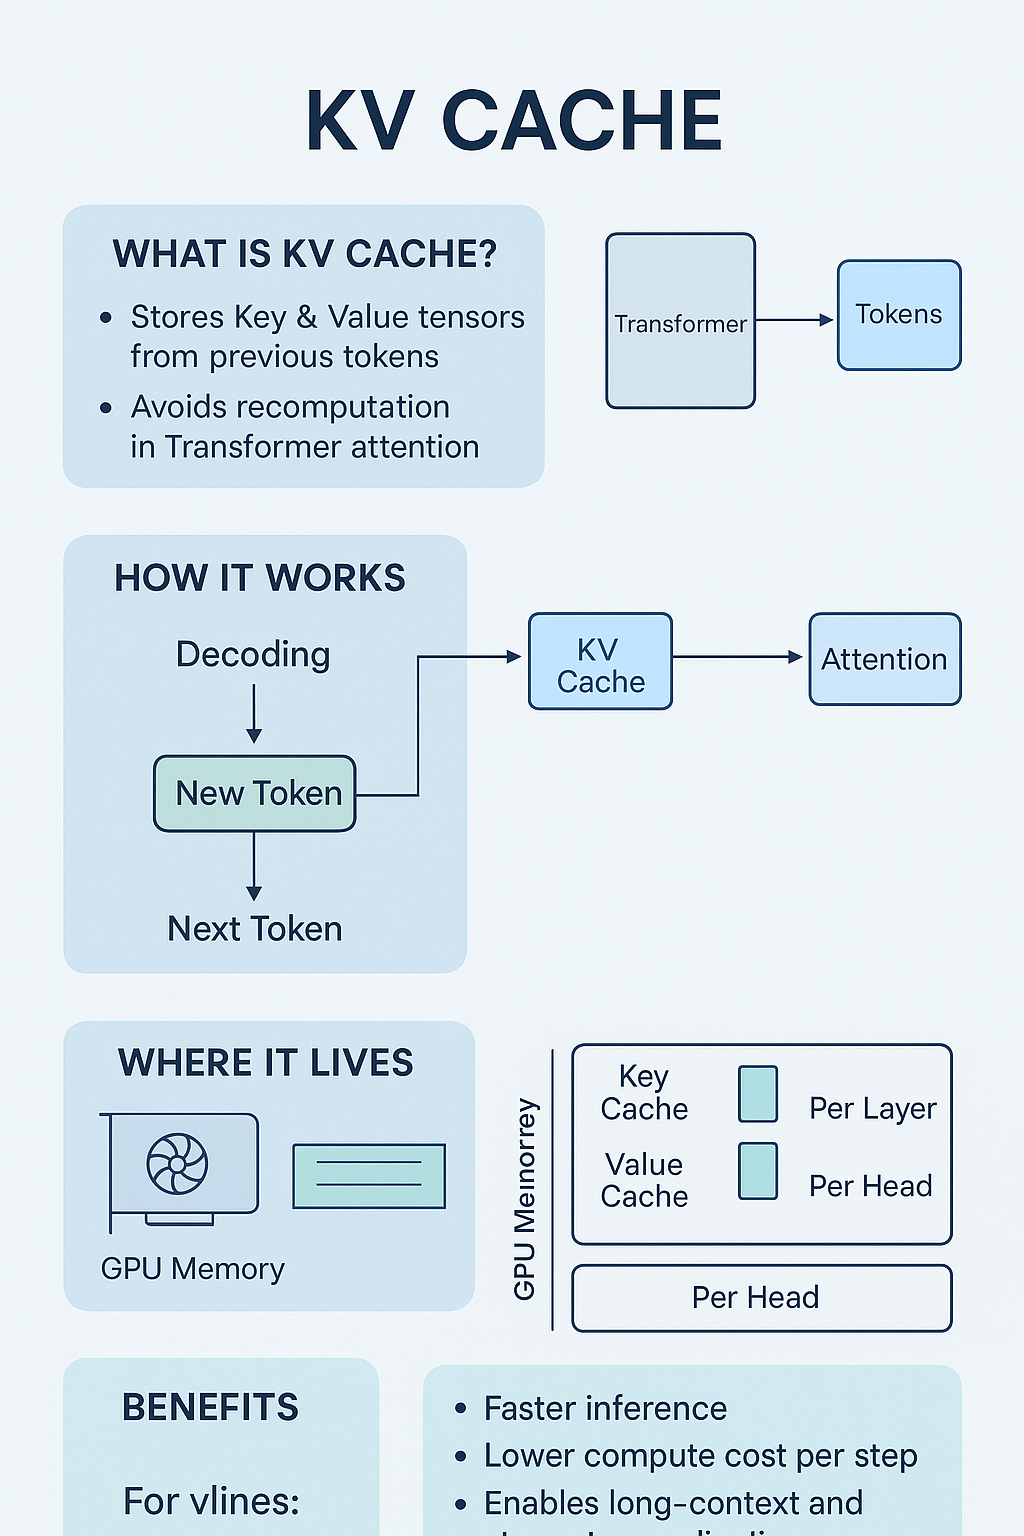
【LLMs篇】19:vLLM推理中的KV Cache技术全解析_vllm kv cache-CSDN博客

深入vLLM V1内核:KV cache 管理机制详细剖析_kvcache slot-CSDN博客