
Dynamic Knowledge Distillation For Pre Trained Language Models

(PDF) Dynamic Knowledge Distillation for Pre-trained Language Models

Dynamic Knowledge Distillation for Pre-trained Language Models - ACL ...
Dynamic Knowledge Distillation for Pre-trained Language Models | Underline
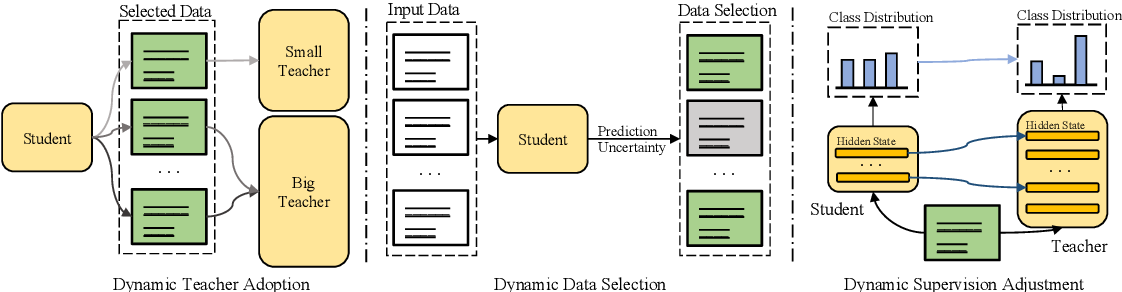
Figure 1 from Dynamic Knowledge Distillation for Pre-trained Language ...
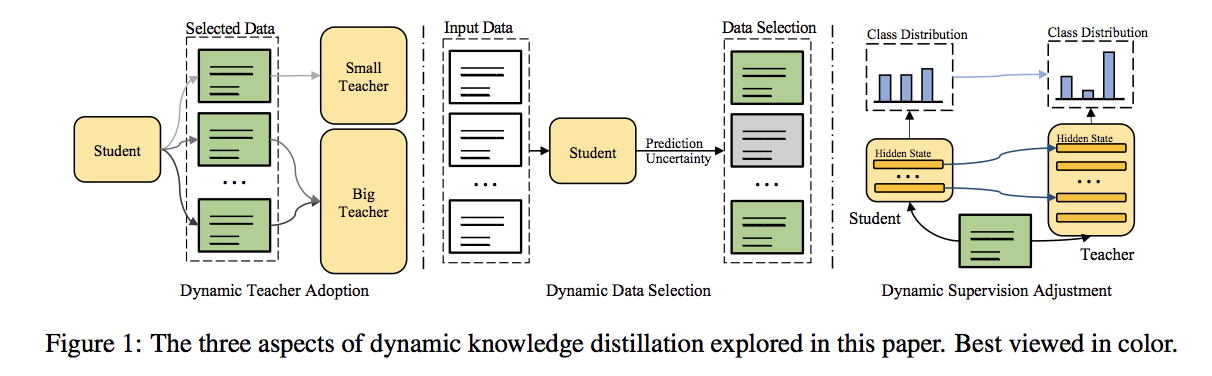
【简读】Dynamic Knowledge Distillation for Pre-trained Language Models - 知乎

Memorization Dynamics in Knowledge Distillation for Language Models ...
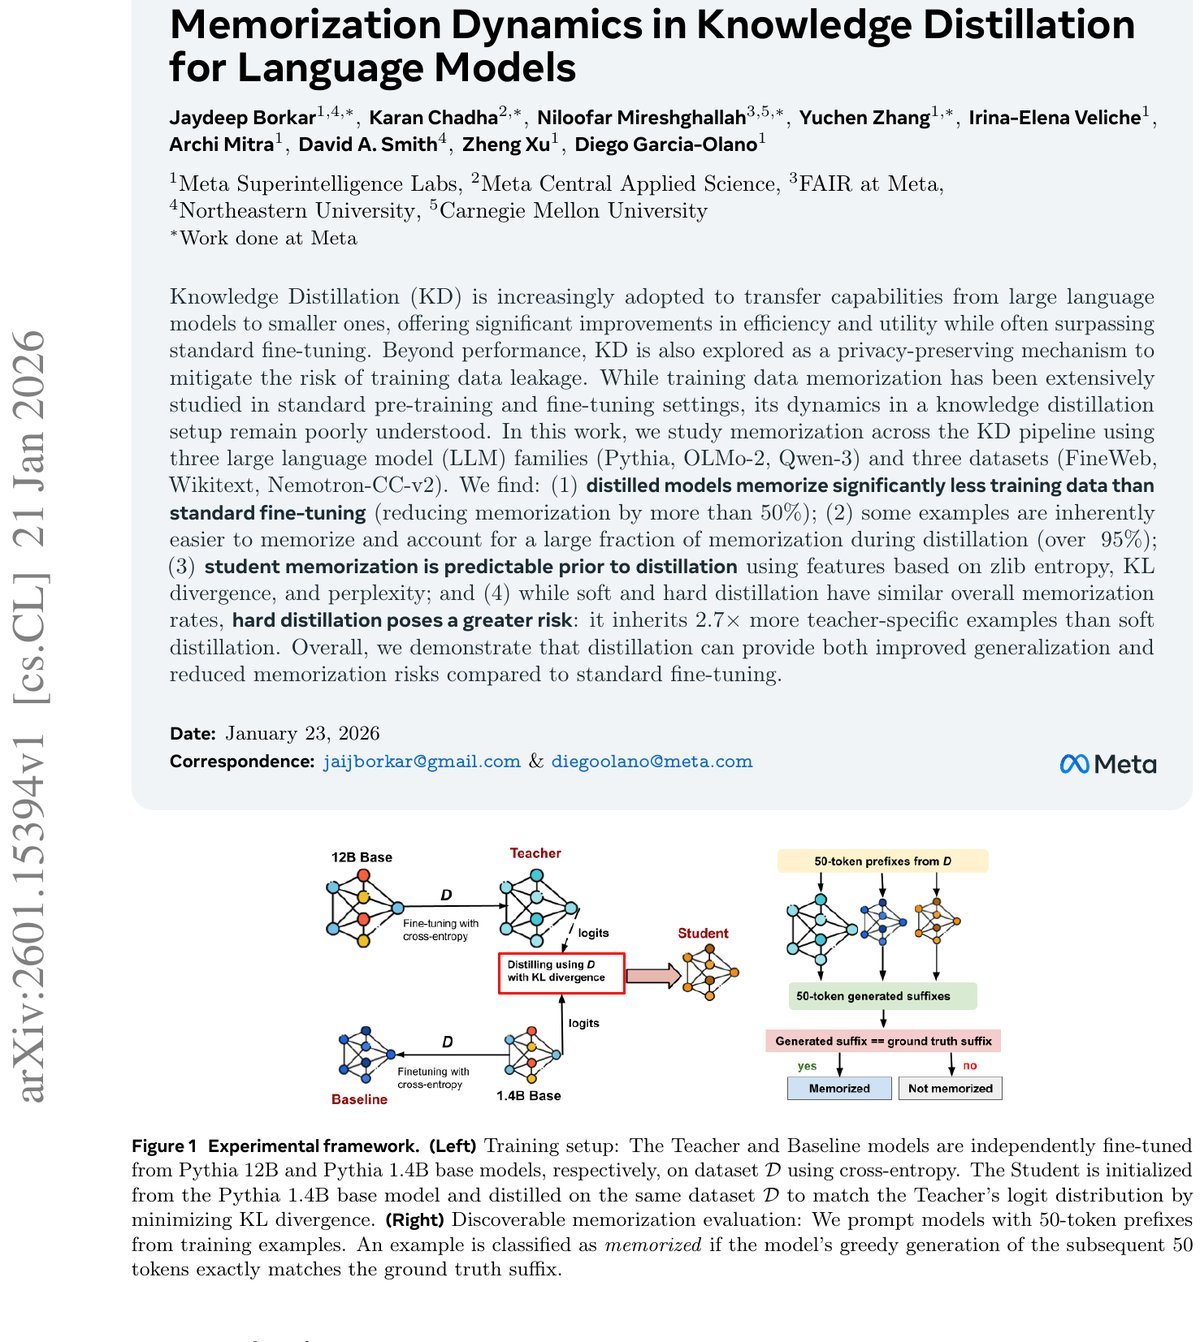
Memorization Dynamics in Knowledge Distillation for Language Models ...

[논문 리뷰] Memorization Dynamics in Knowledge Distillation for Language Models

MiniPLM: Knowledge Distillation for Pre-Training Language Models | AI ...

(PDF) MiniPLM: Knowledge Distillation for Pre-Training Language Models
Advertisement Space (300x250)
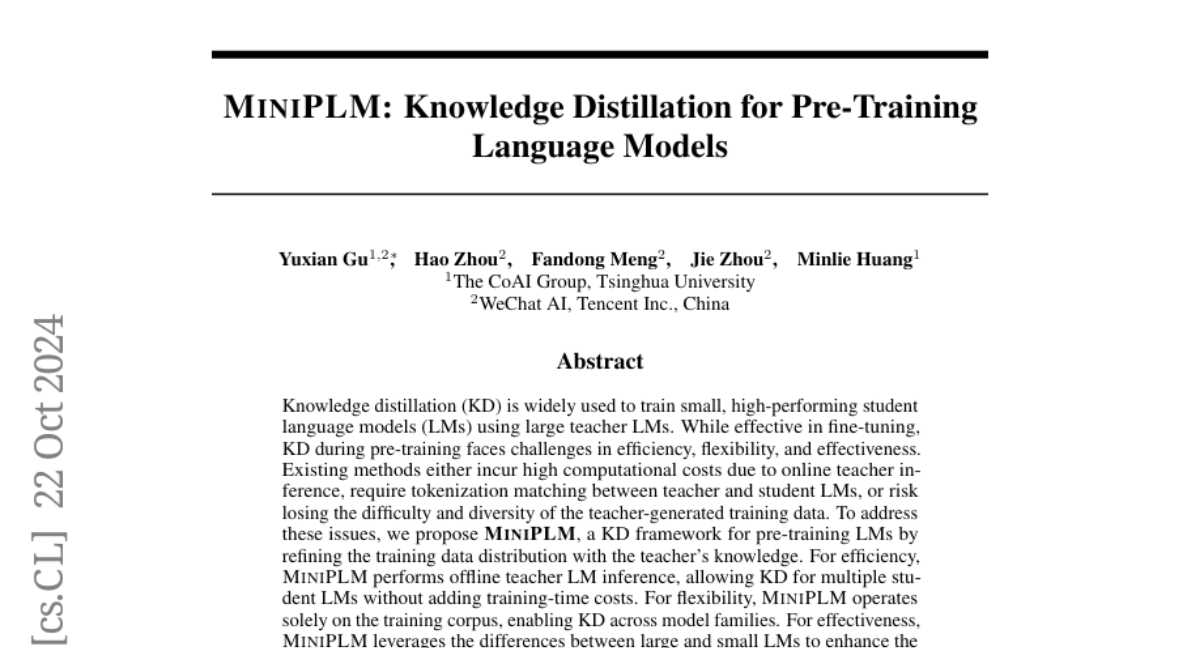
MiniPLM: Knowledge Distillation for Pre-Training Language Models - AI ...
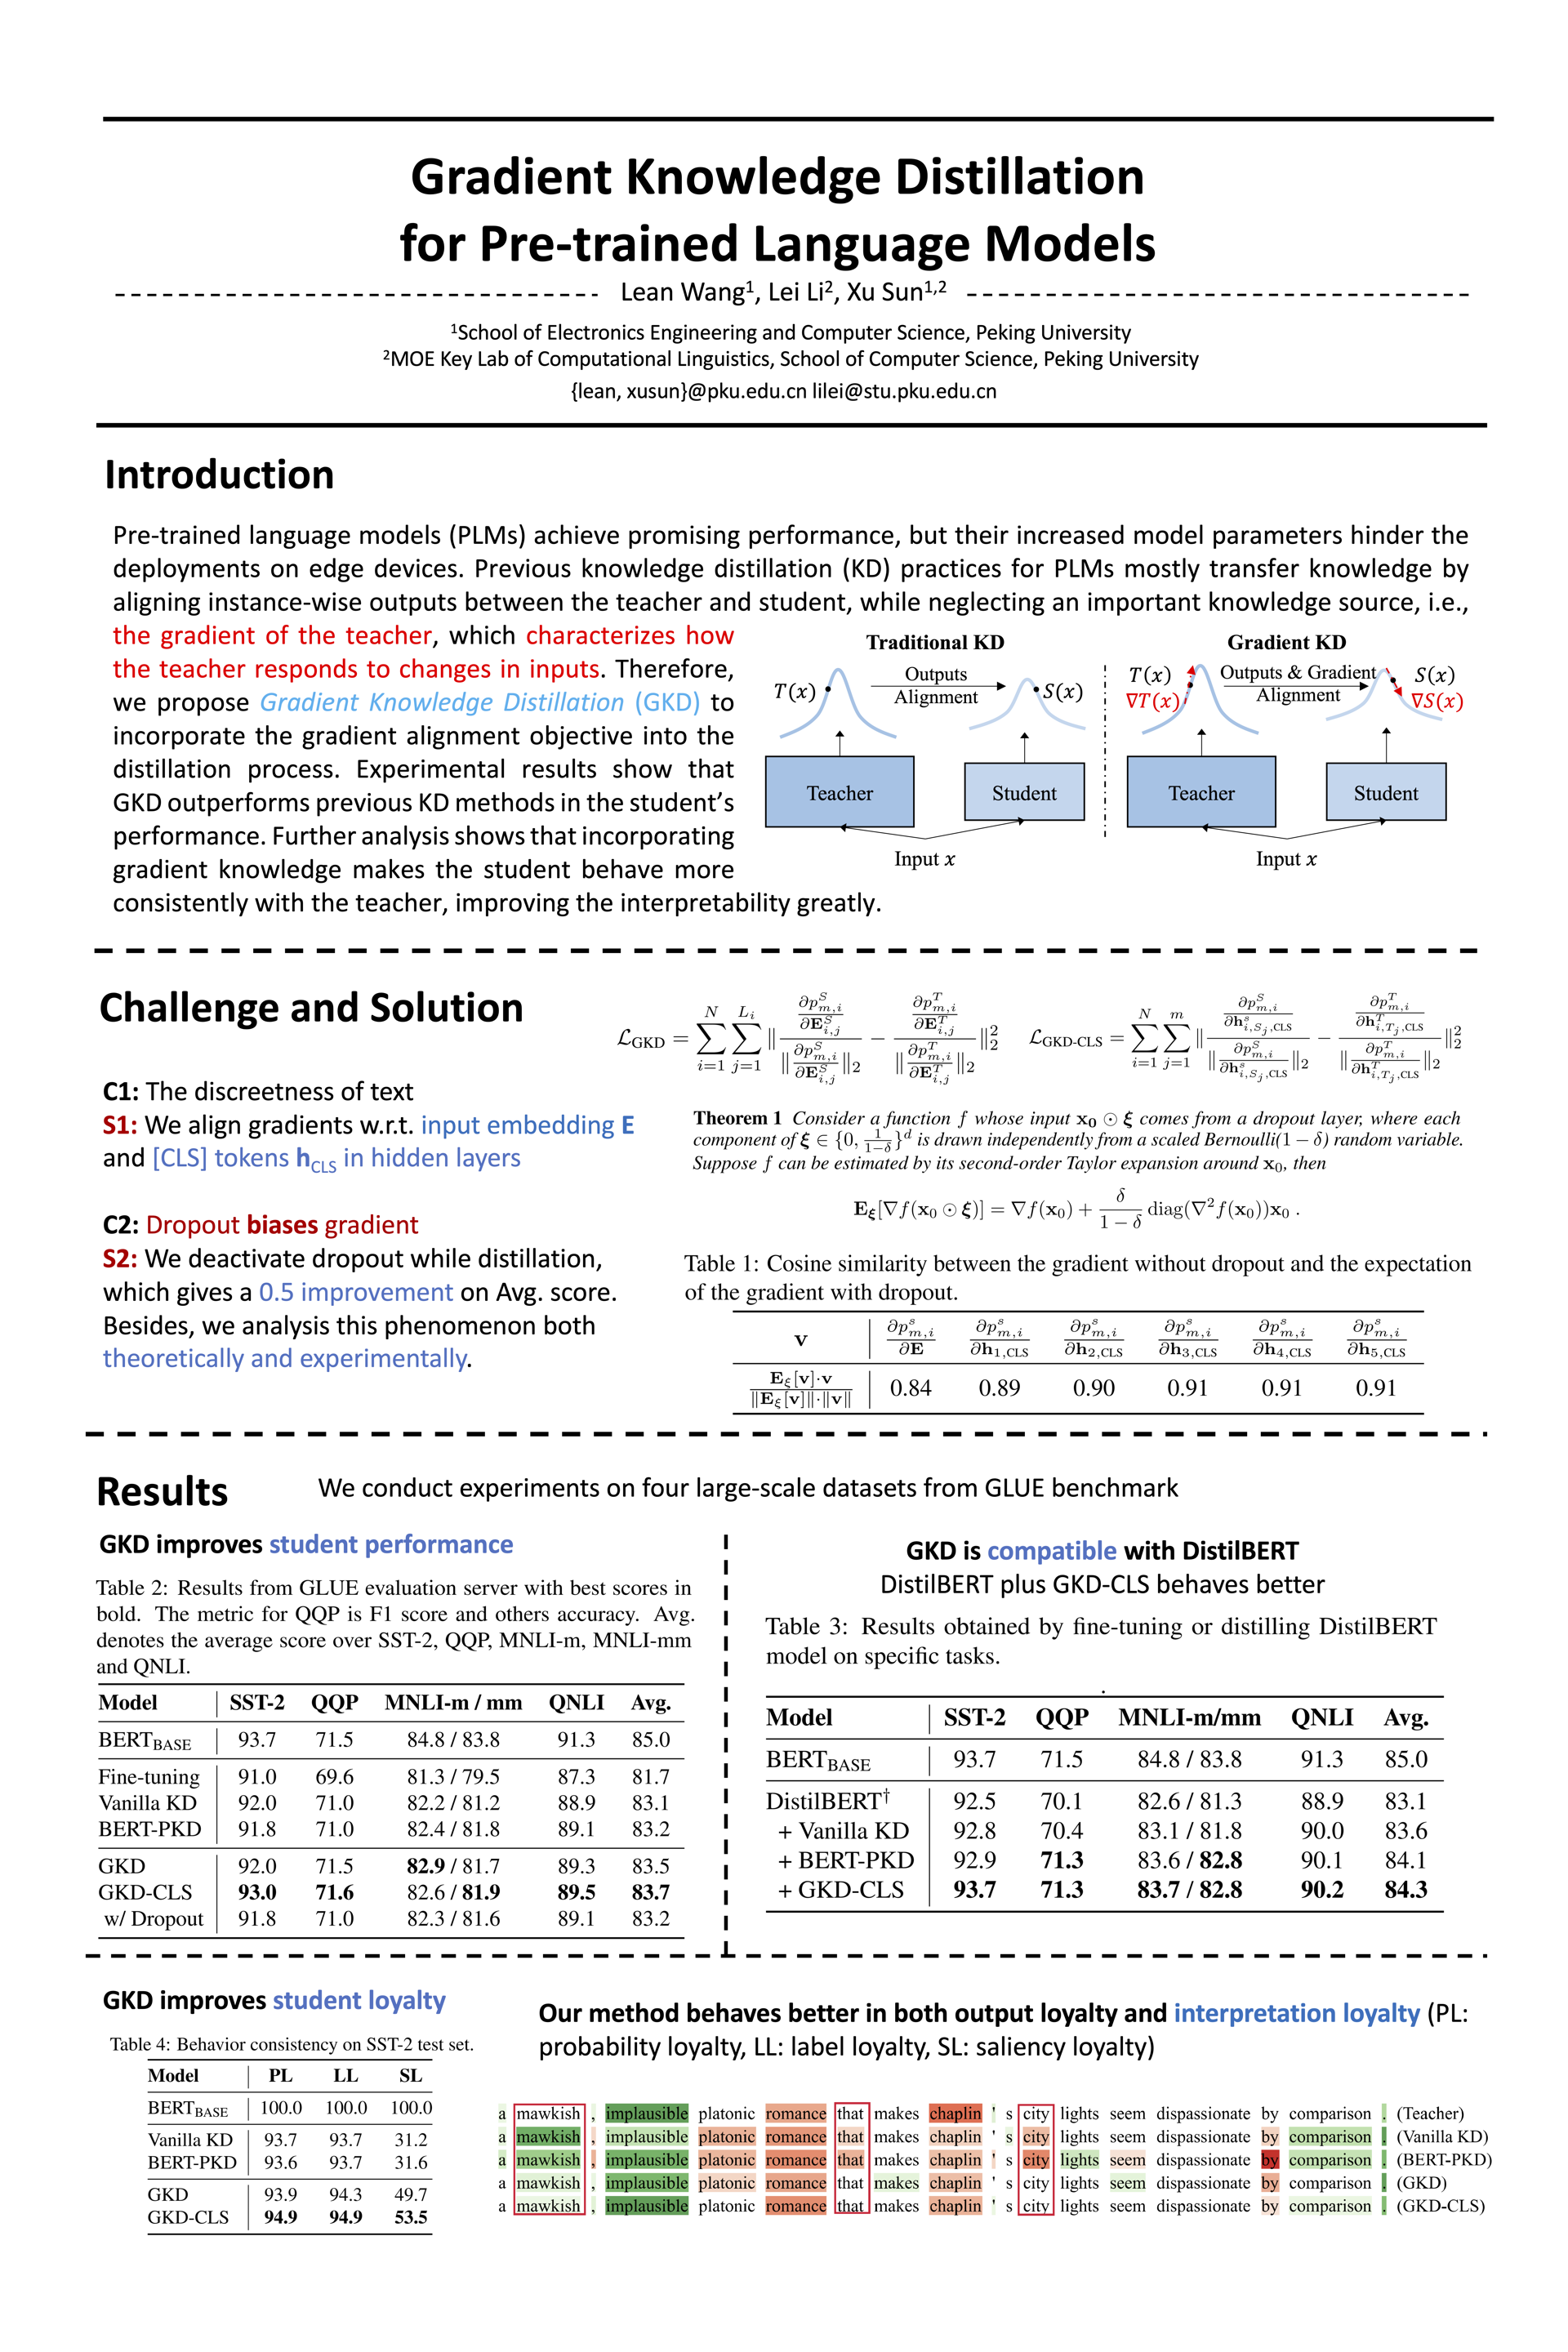
NeurIPS Gradient Knowledge Distillation for Pre-trained Language Models

(PDF) Improved Knowledge Distillation for Pre-trained Language Models ...

(PDF) Gradient Knowledge Distillation for Pre-trained Language Models

Improved Knowledge Distillation for Pre-trained Language Models via ...

[論文レビュー] MiniPLM: Knowledge Distillation for Pre-Training Language Models
Improved Knowledge Distillation for Pre-trained Language Models via ...

Revisiting Knowledge Distillation for Autoregressive Language Models ...

Improved Knowledge Distillation for Pre-trained Language Models via ...
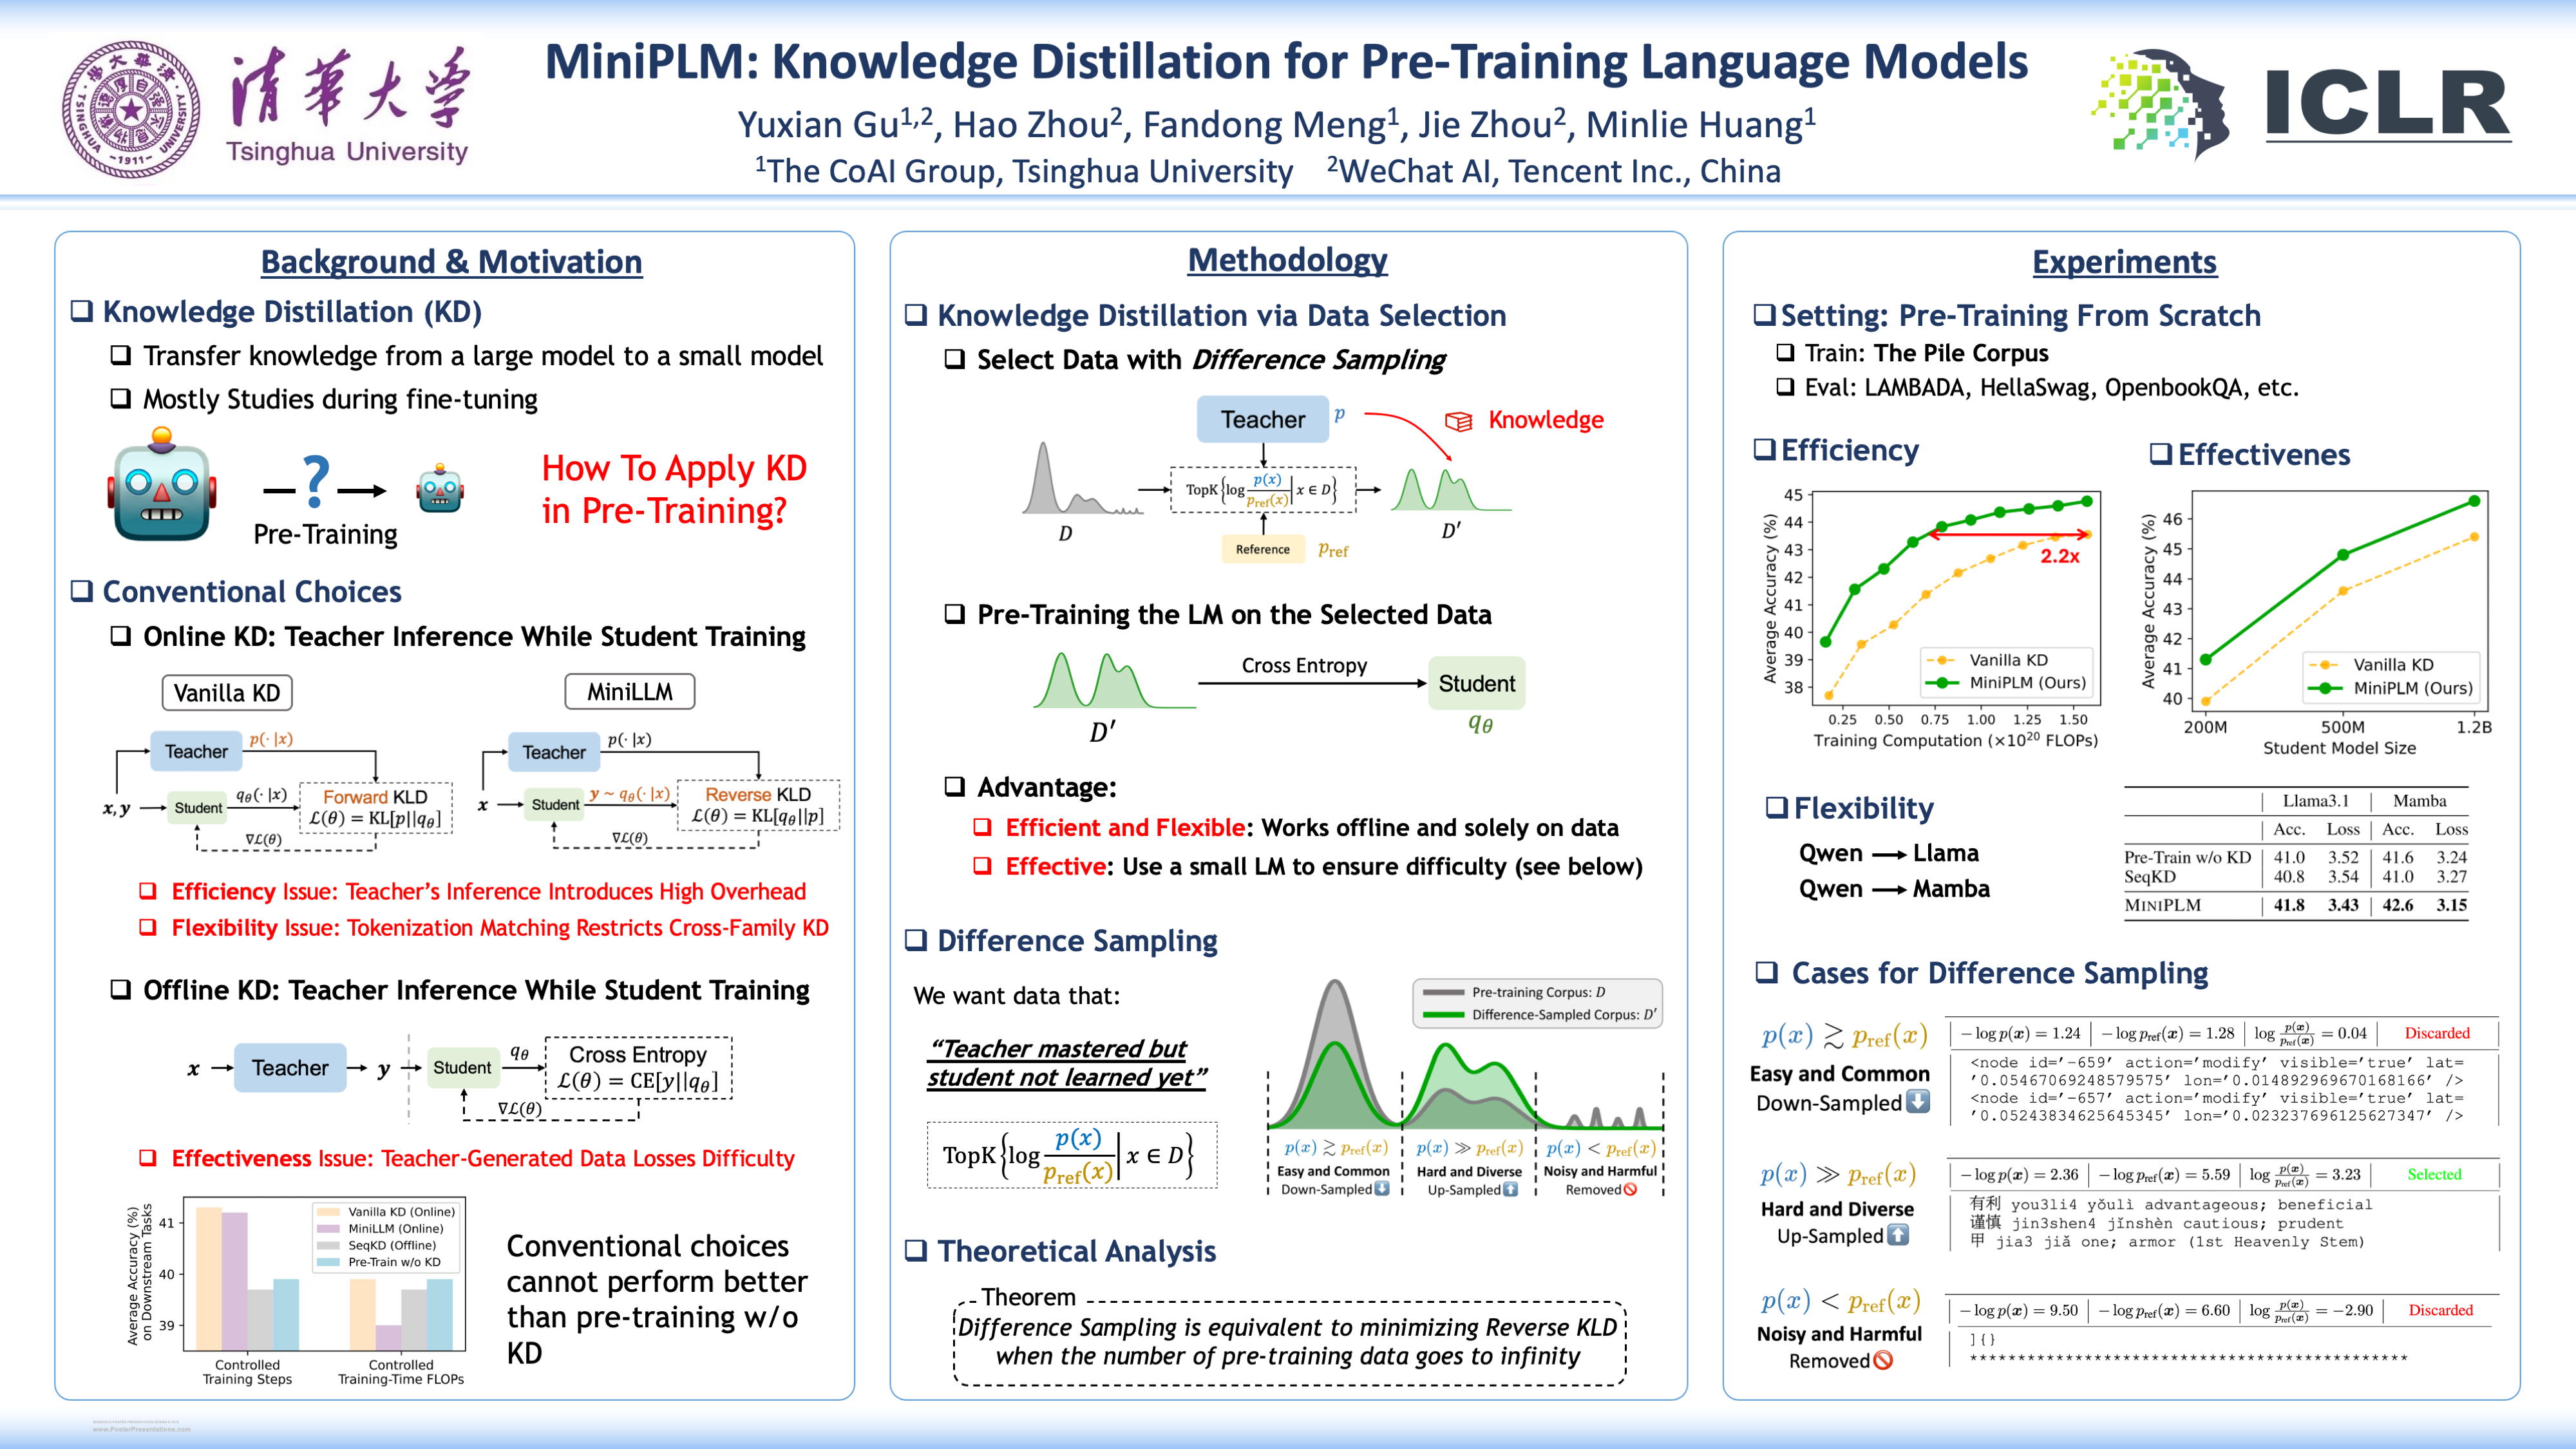
ICLR Poster MiniPLM: Knowledge Distillation for Pre-training Language ...
Advertisement Space (336x280)

Multi-Aspect Knowledge Distillation for Language Model with Low-rank ...

Figure 1 from Improved Knowledge Distillation for Pre-trained Language ...

GKD: A General Knowledge Distillation Framework for Large-scale Pre ...
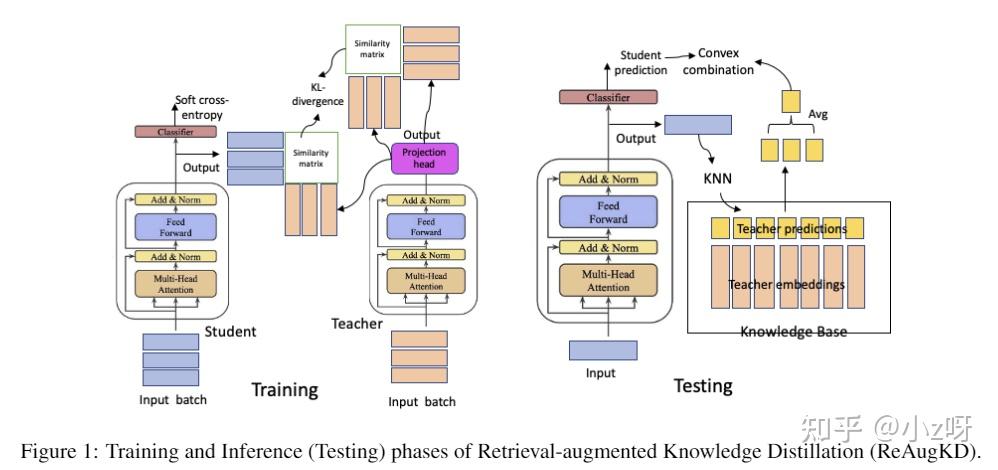
【43论文泛读】ReAugKD: Retrieval-Augmented Knowledge Distillation For Pre ...
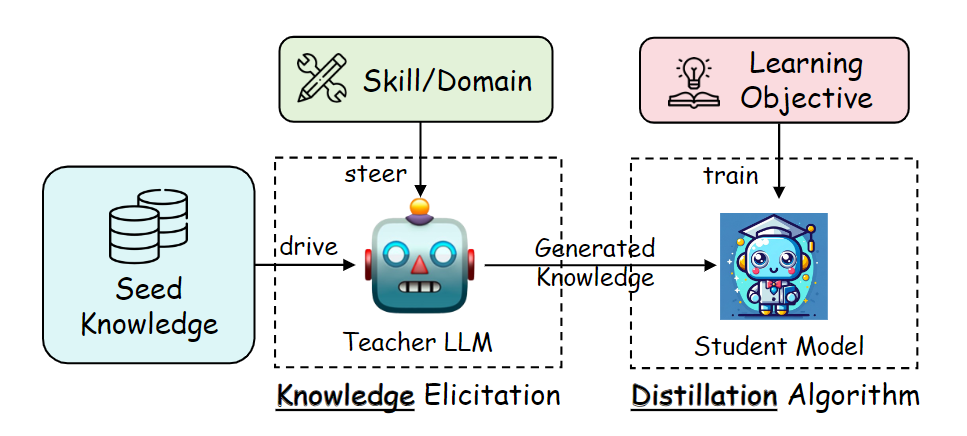
Knowledge Distillation for Large Language Models: A Deep Dive - Zilliz ...
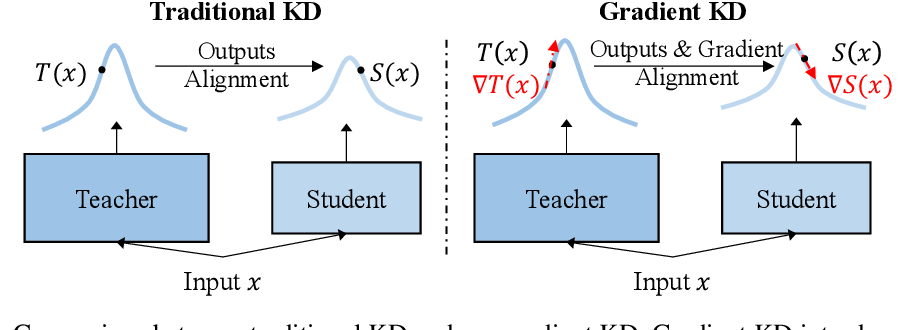
Figure 1 from Gradient Knowledge Distillation for Pre-trained Language ...

MLKD-BERT: Multi-level Knowledge Distillation for Pre-trained Language ...
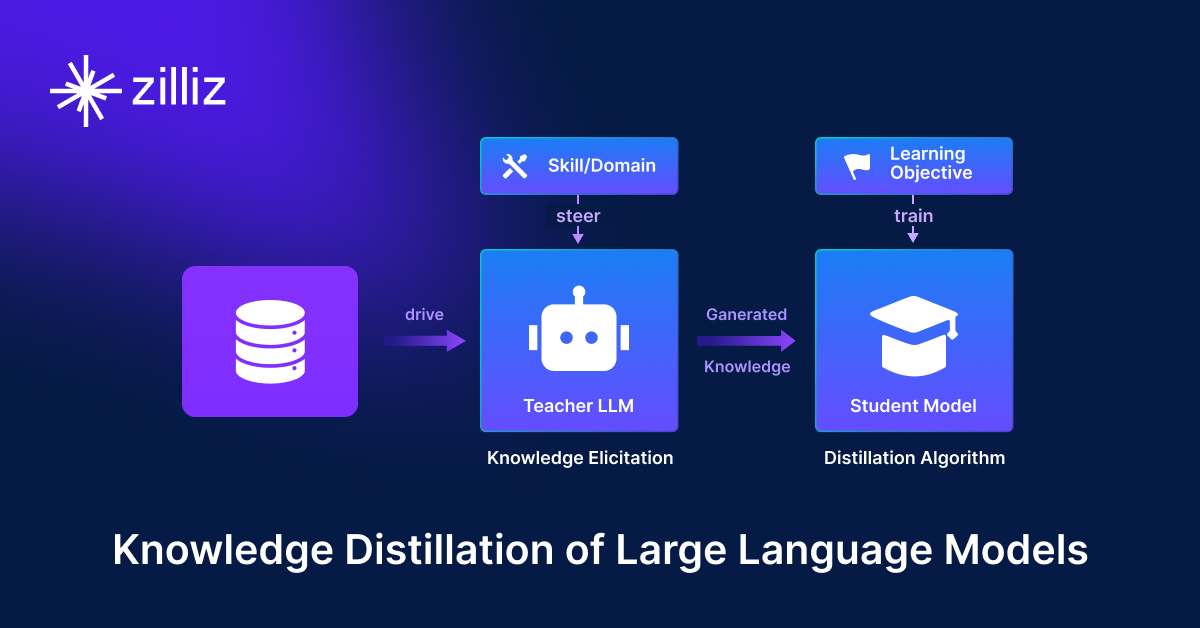
Knowledge Distillation for Large Language Models: A Deep Dive - Zilliz ...

Lean Wang, Lei Li, Xu Sun · Gradient Knowledge Distillation for Pre ...
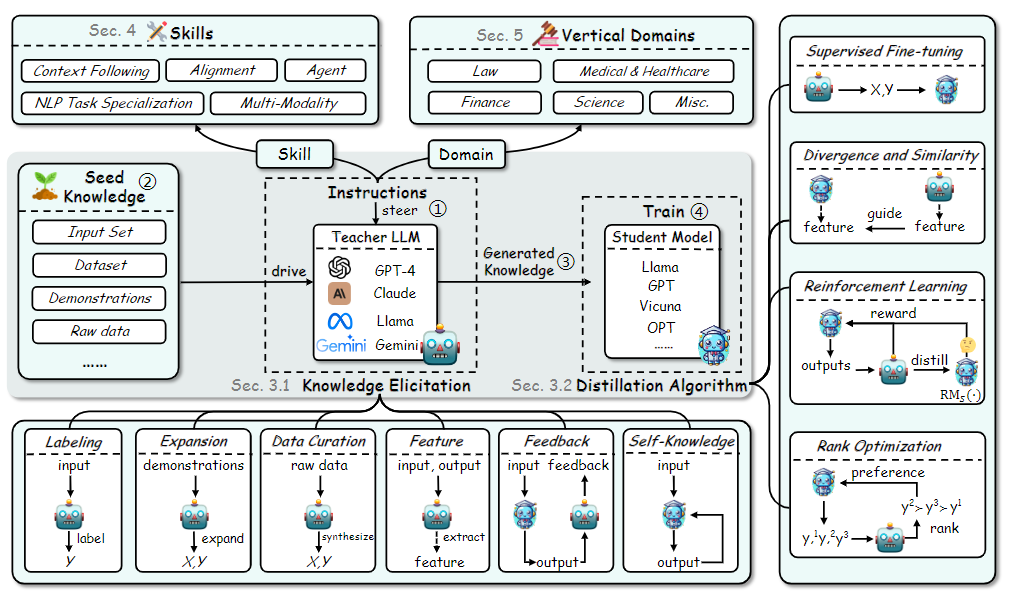
Knowledge Distillation for Large Language Models: A Deep Dive - Zilliz ...
Advertisement Space (336x280)
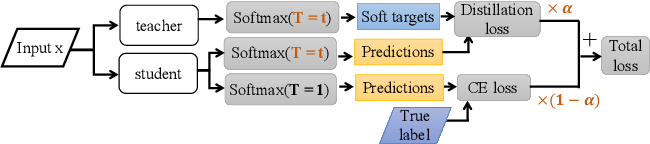
Figure 1 from Practical Insights into Knowledge Distillation for Pre ...

Evolving Knowledge Distillation with Large Language Models and Active ...

Knowledge Distillation in Large Language Models

MLKD-BERT: Multi-level Knowledge Distillation for Pre-trained Language ...

Figure 1 from Domain Knowledge Transferring for Pre-trained Language ...

Figure 2 from Domain Knowledge Transferring for Pre-trained Language ...