
Edit Efficient Diffusion Transformers With Linear Compressed Attention

EDiT: Efficient Diffusion Transformers with Linear Compressed Attention ...

EDiT: Efficient Diffusion Transformers with Linear Compressed Attention

(PDF) EDiT: Efficient Diffusion Transformers with Linear Compressed ...
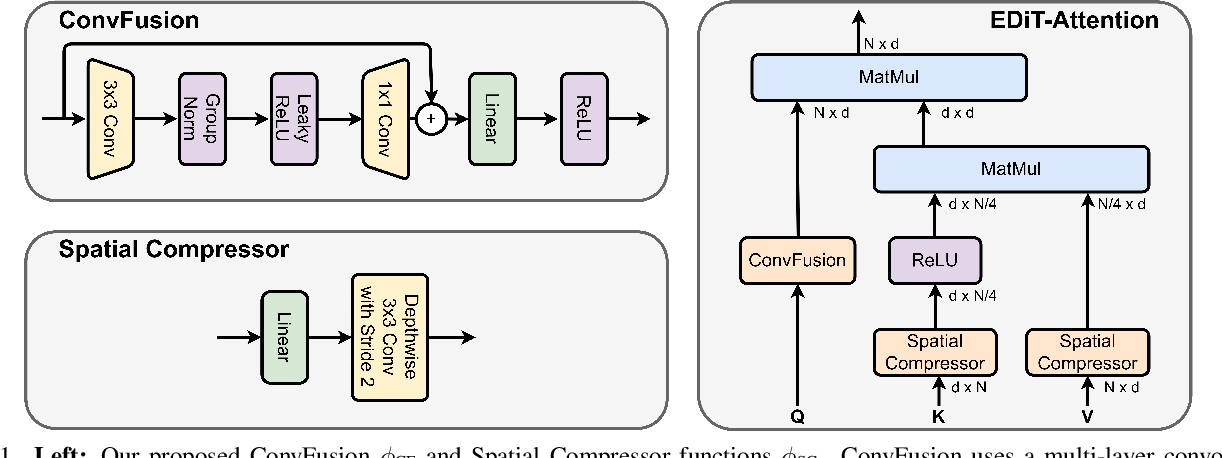
Figure 1 from Edit: Efficient Diffusion Transformers with Linear ...
Diffuser: Efficient Transformers with Multi-hop Attention Diffusion for ...

Efficient-vDiT: Efficient Video Diffusion Transformers With Attention ...

🚀 New Paper at ICCV 2025: “EDiT: Efficient Diffusion Transformers with ...

DiG: Scalable and Efficient Diffusion Models with Gated Linear ...
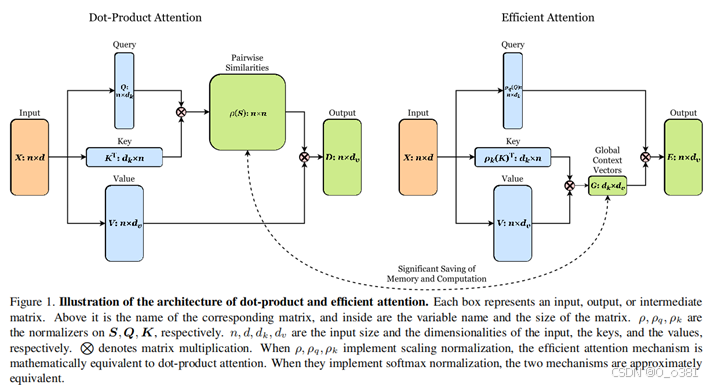
Efficient Attention: Attention with Linear Complexities(高效注意力)-CSDN博客
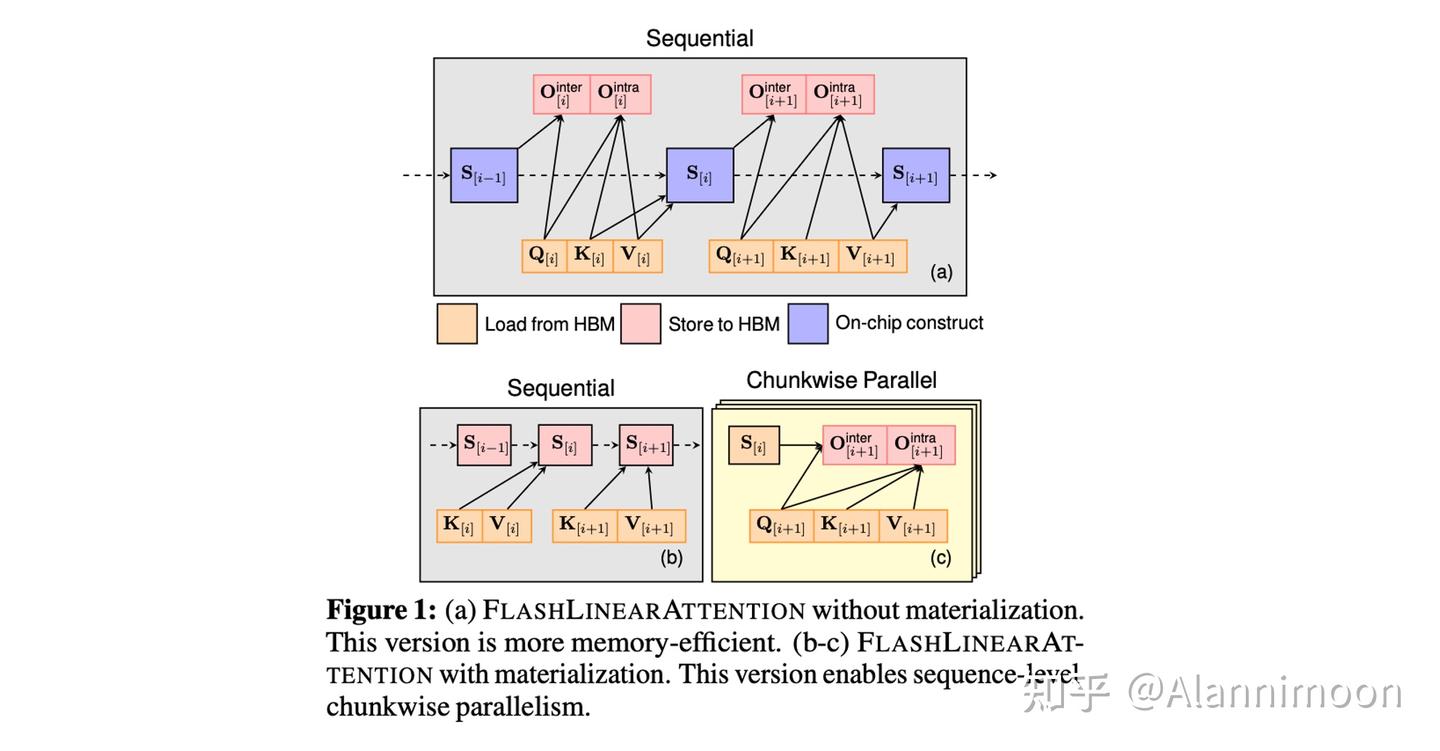
Gated Linear Attention Transformers with Hardware-Efficient Training 论文 ...
Advertisement Space (300x250)
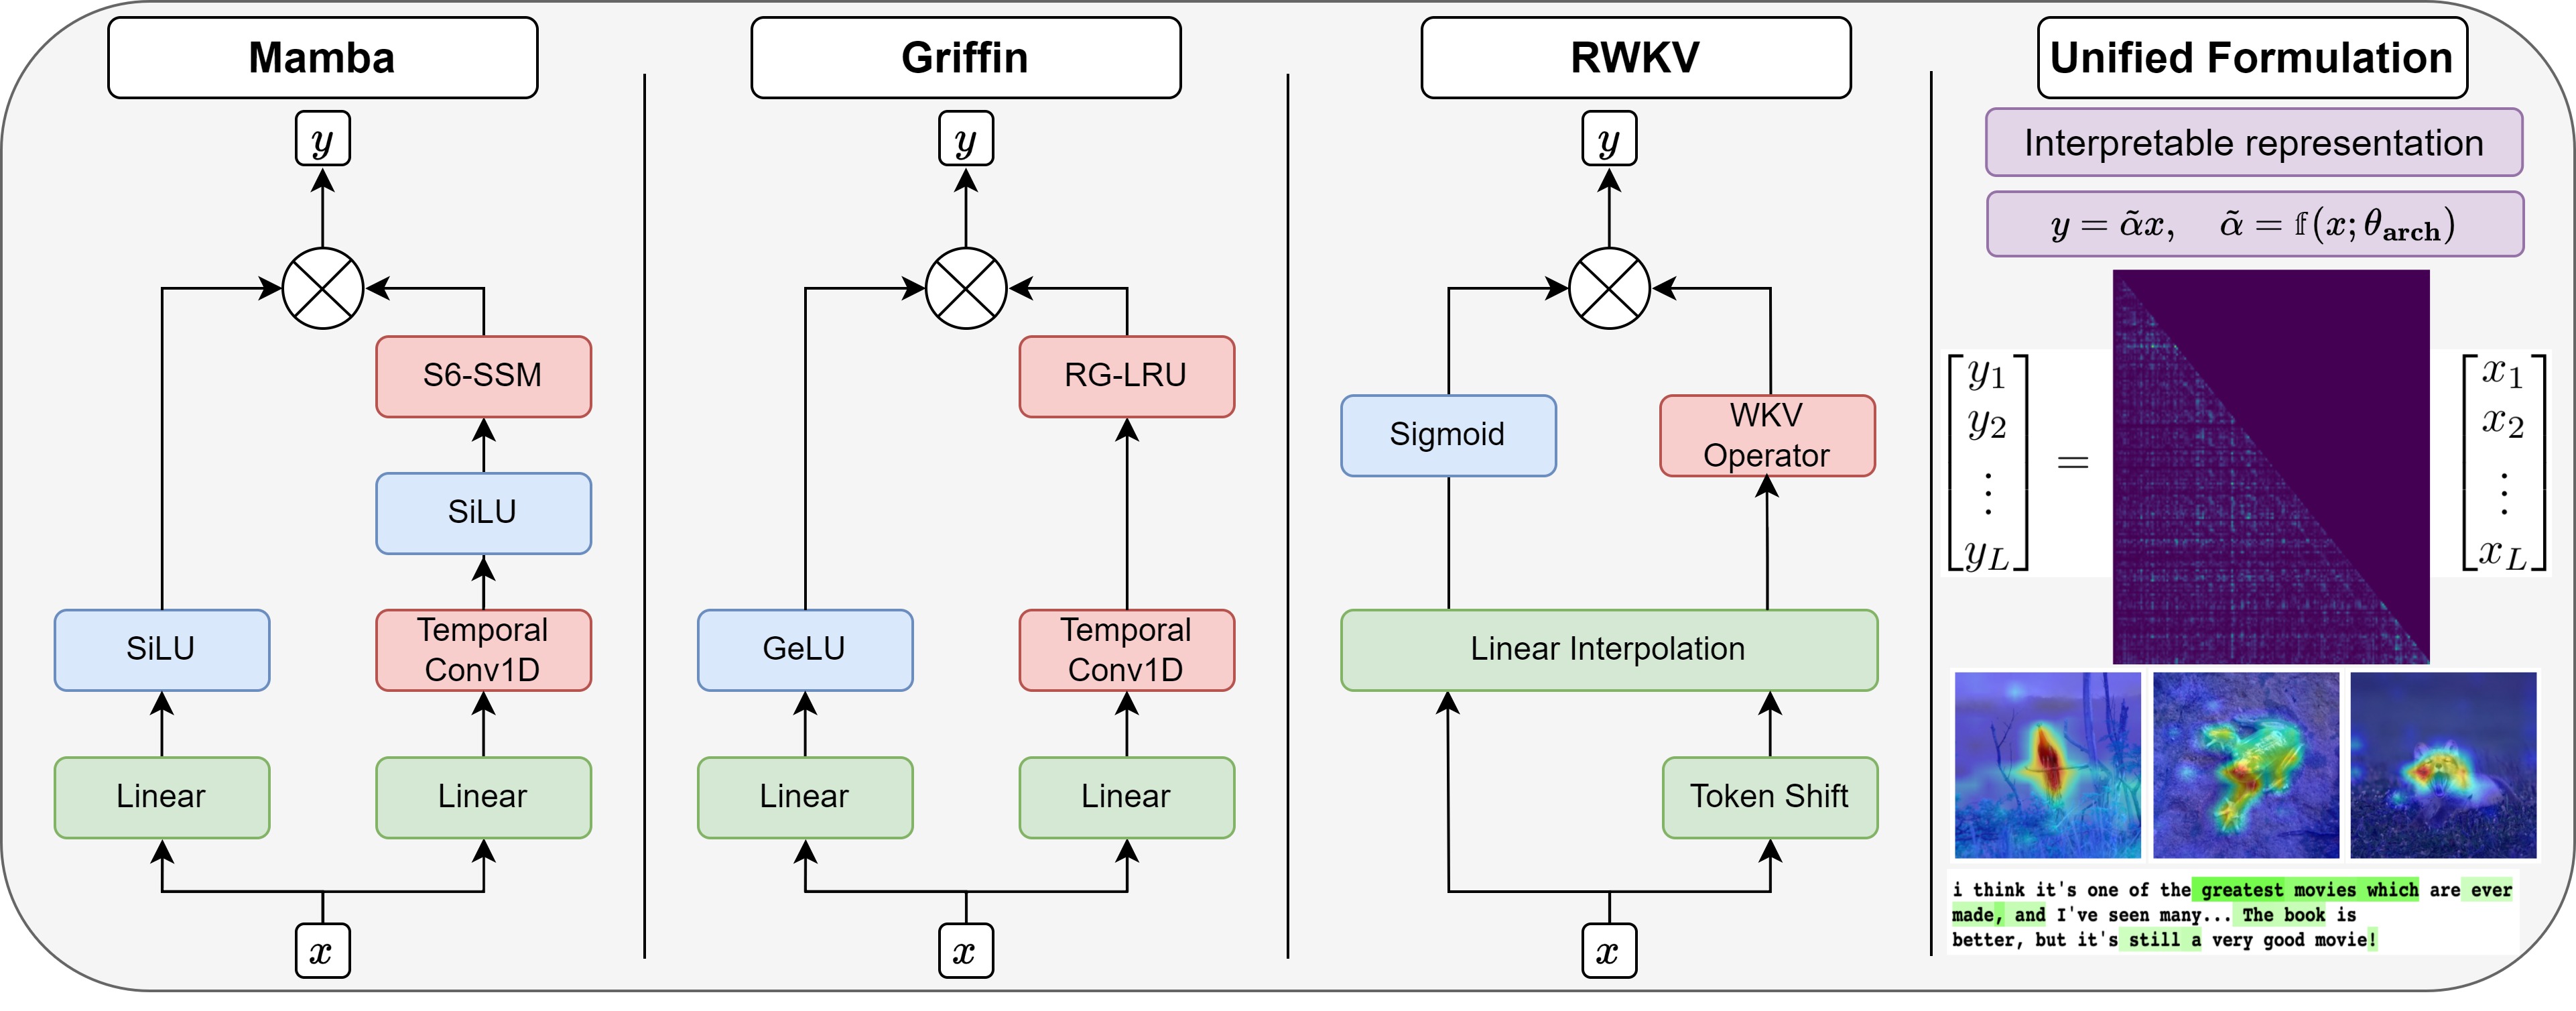
Gated Linear Attention Transformers with Hardware-Efficient Training ...

(PDF) Diffuser: Efficient Transformers with Multi-hop Attention ...
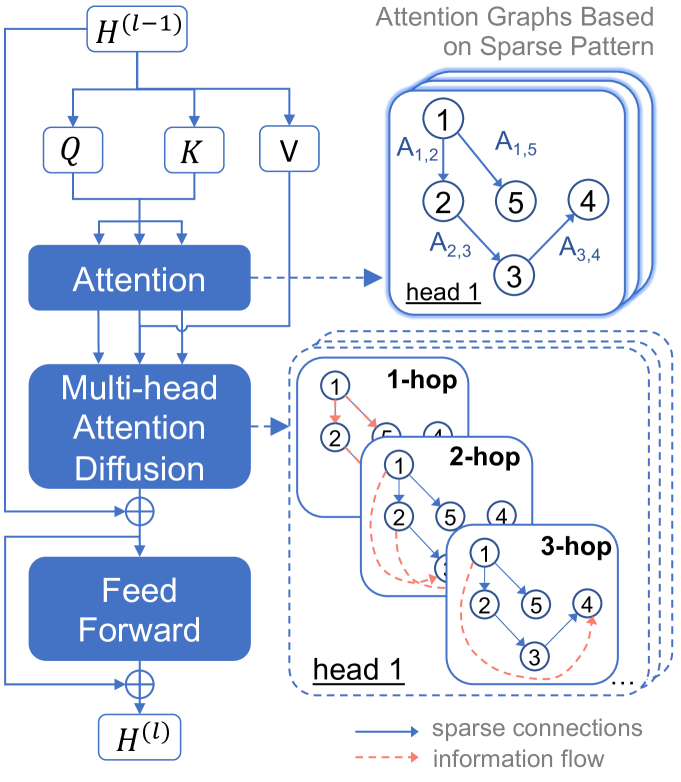
[2210.11794] Diffuser: Efficient Transformers with Multi-hop Attention ...
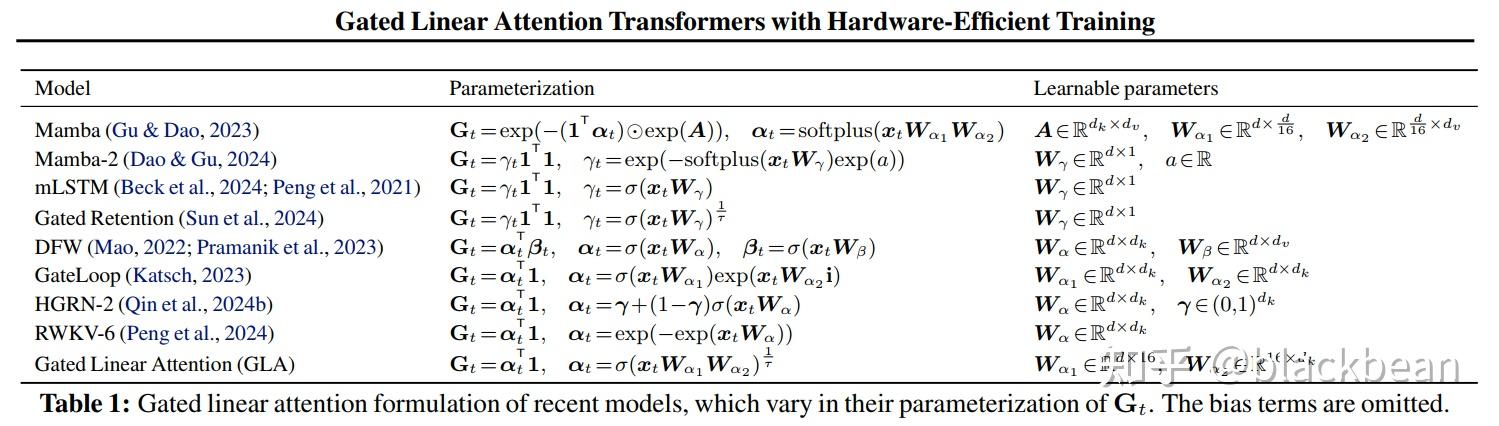
linear attention 系列文章(三) Gated Linear Attention Transformers with ...
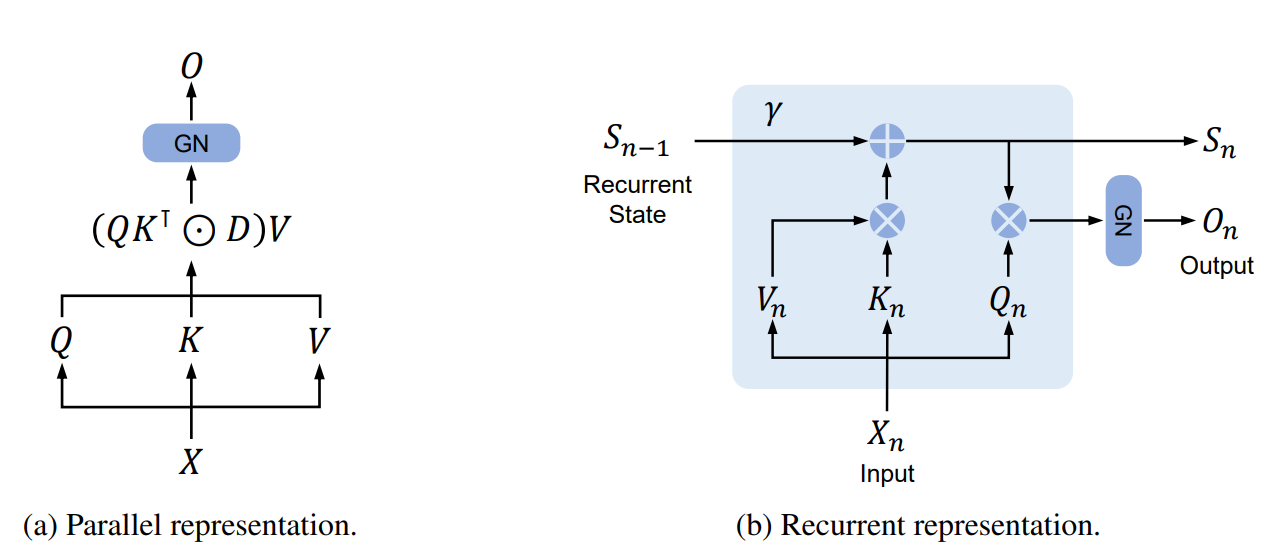
Gated Linear Attention Transformers with Hardware-Efficient Training - 知乎
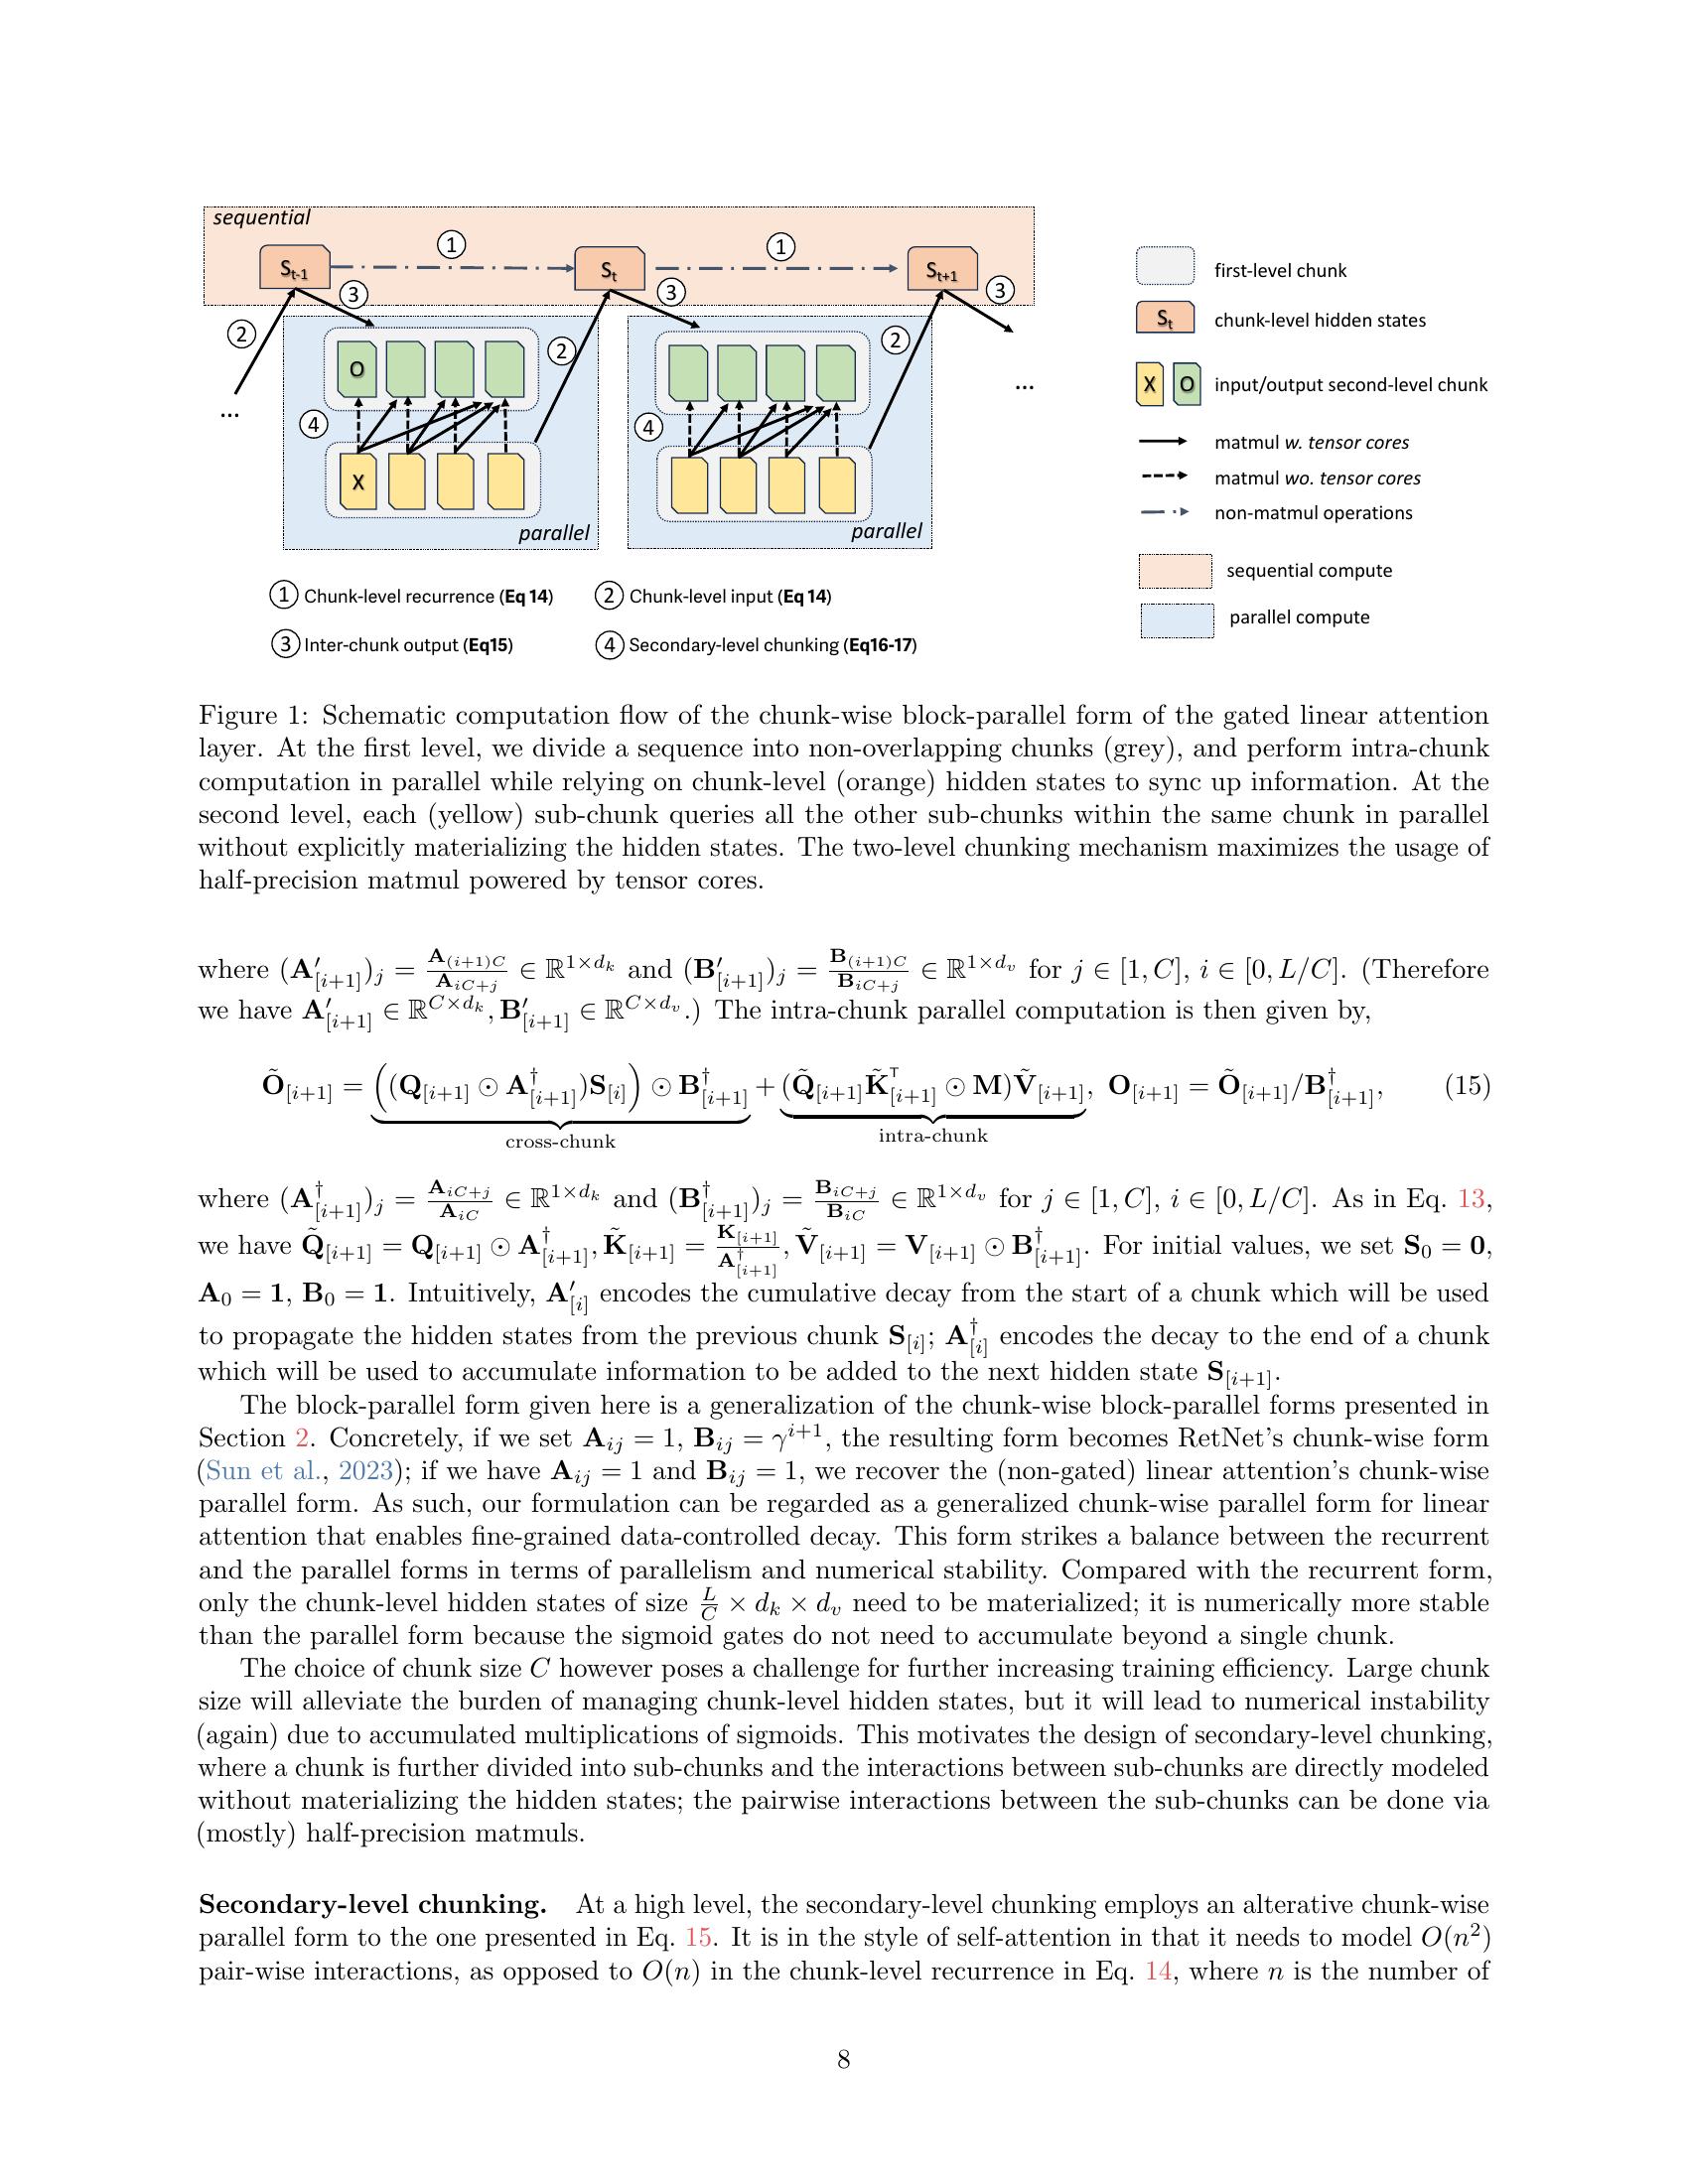
Gated Linear Attention Transformers with Hardware-Efficient Training ...

Paper page - SLAB: Efficient Transformers with Simplified Linear ...

[논문 리뷰] DiTPainter: Efficient Video Inpainting with Diffusion Transformers
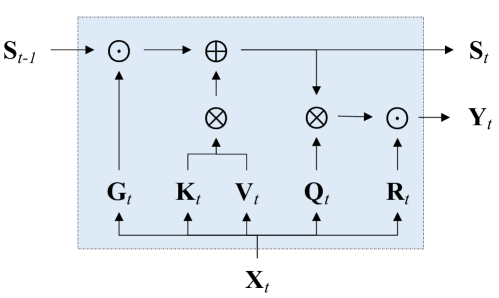
Gated Linear Attention Transformers with Hardware-Efficient Training ...
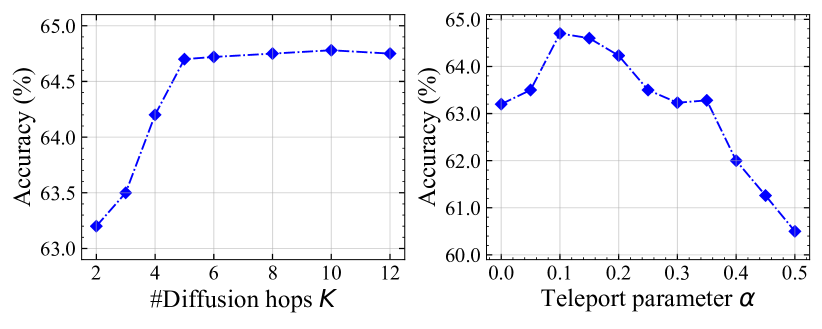
[2210.11794] Diffuser: Efficient Transformers with Multi-hop Attention ...
Advertisement Space (336x280)

ELFATT: Efficient Linear Fast Attention for Vision Transformers | AI ...

[2210.11794] Diffuser: Efficient Transformers with Multi-hop Attention ...
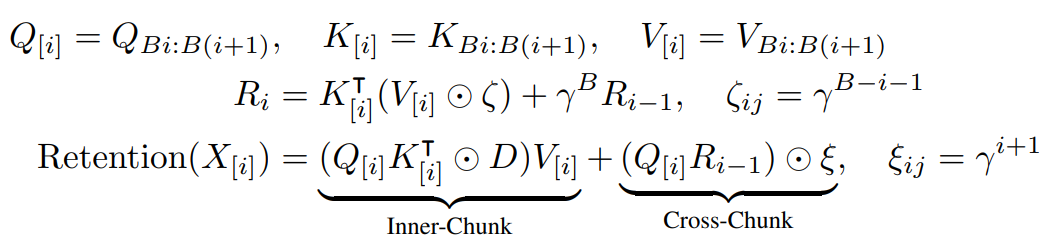
Gated Linear Attention Transformers with Hardware-Efficient Training - 知乎

Paper page - Gated Linear Attention Transformers with Hardware ...
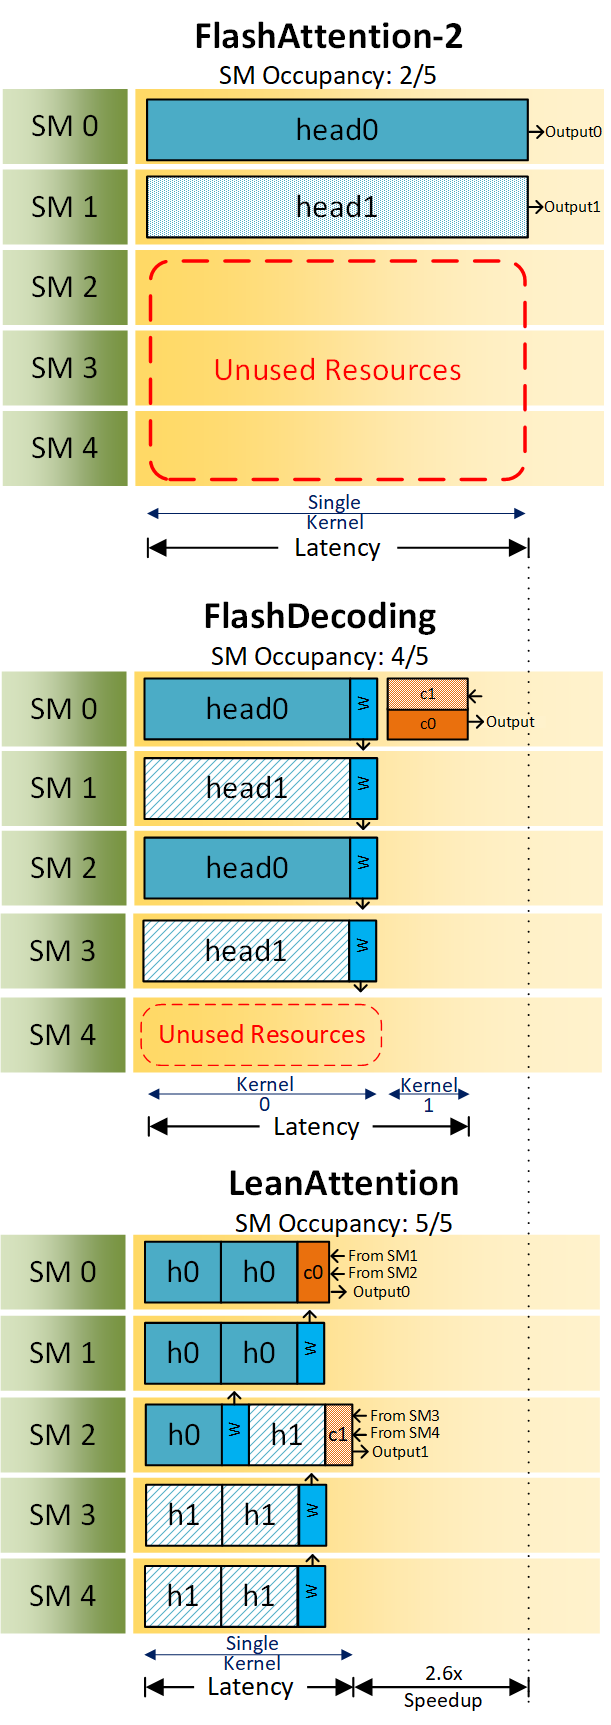
Gated Linear Attention Transformers with Hardware-Efficient Training ...

SALAD: Achieve High-Sparsity Attention via Efficient Linear Attention ...

ECCV Poster Efficient Diffusion Transformer with Step-wise Dynamic ...

SALAD: Achieve High-Sparsity Attention via Efficient Linear Attention ...

Transformers on Edge Devices? Monash U’s Energy-Saving Attention With ...

FrameDiT: Diffusion Transformer with Frame-Level Matrix Attention for ...
Advertisement Space (336x280)

Paper page - Efficient Diffusion Transformer with Step-wise Dynamic ...
Understanding The Attention Mechanism in Transformers with Code | by ...

SANA-Video: Efficient Block Linear Diffusion Transformer for AI Video ...

SALAD: Achieve High-Sparsity Attention via Efficient Linear Attention ...

Efficient Diffusion Transformer Policies with Mixture of Expert ...
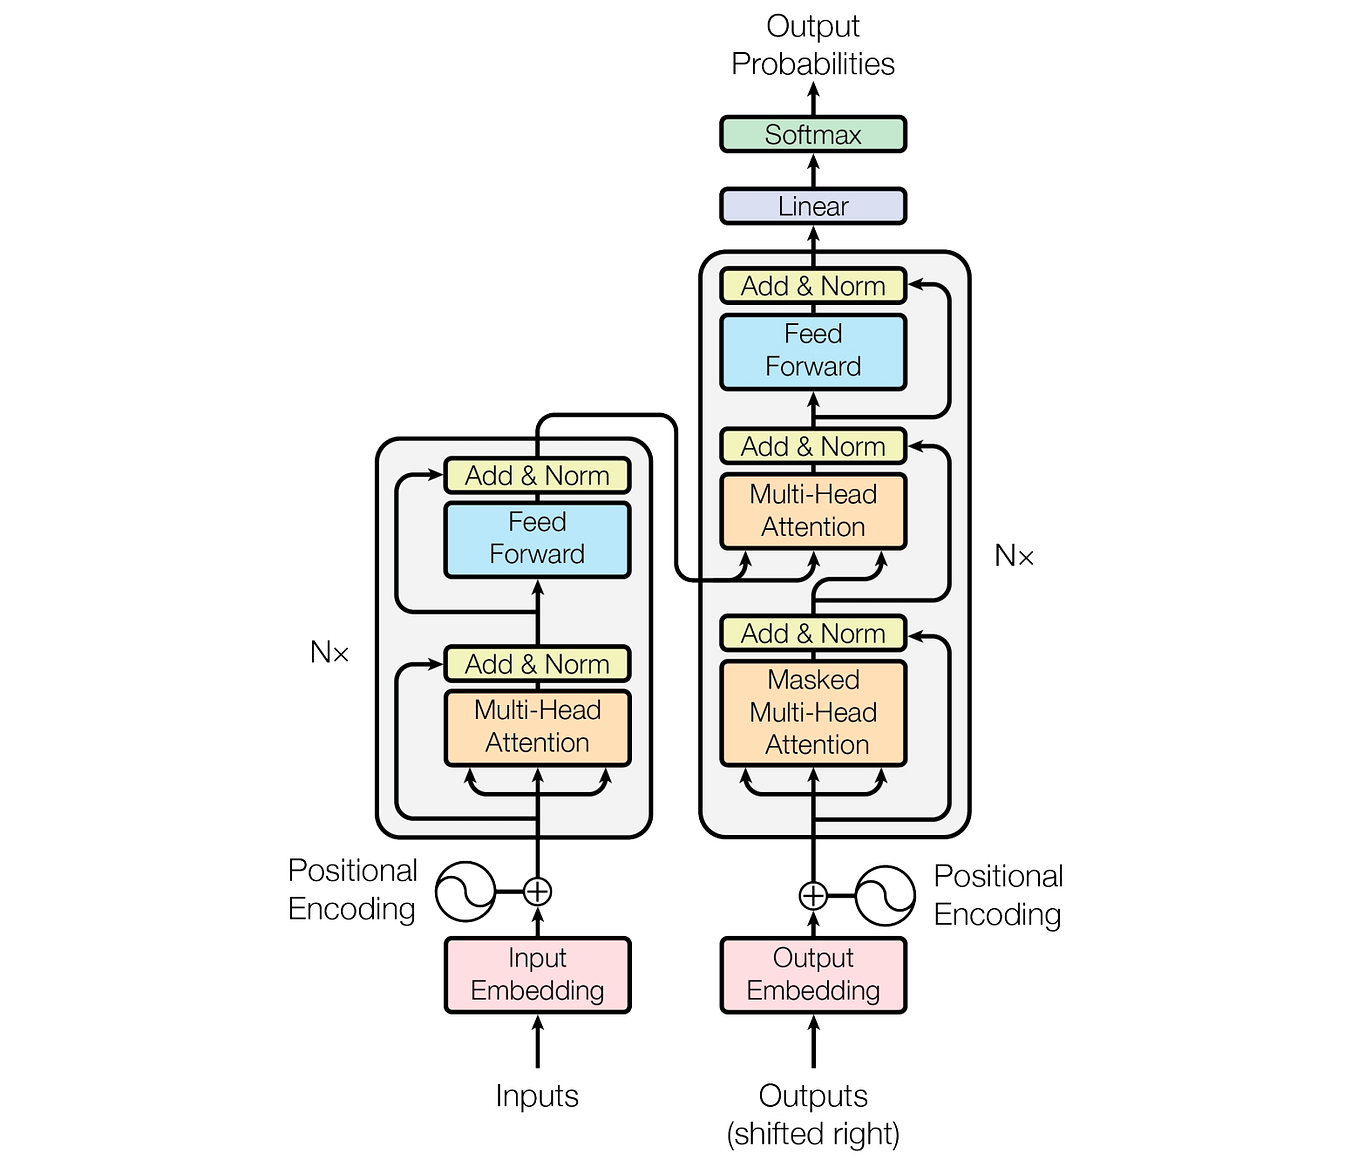
Understanding The Attention Mechanism in Transformers with Code | by ...