
Efficient Gather And Scatter Matrix Multiplication Kernel With Triton
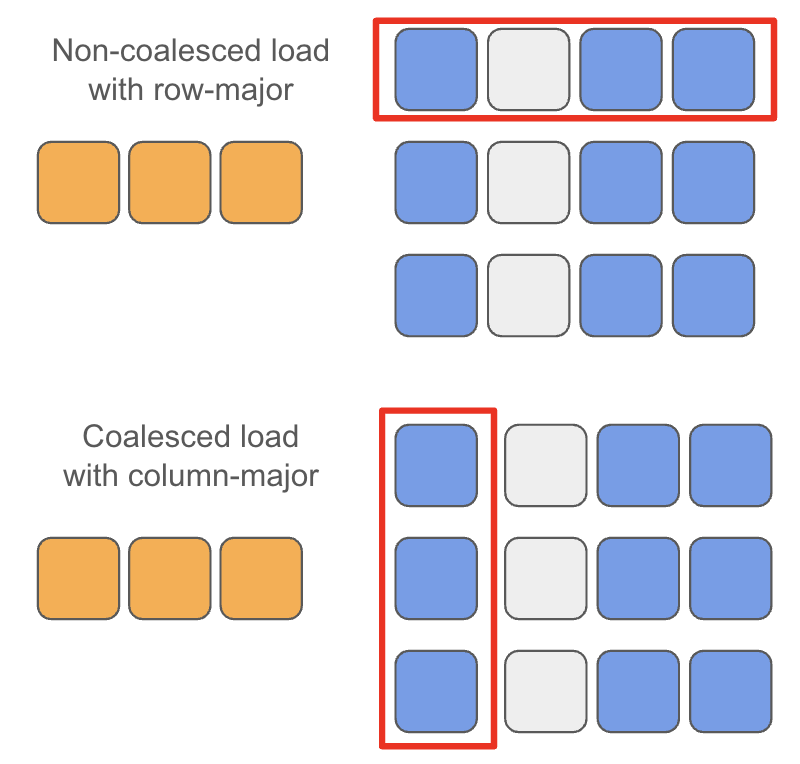
Efficient Gather-and-scatter Matrix Multiplication Kernel with Triton ...
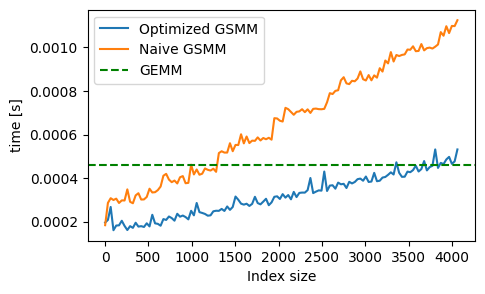
Efficient Gather-and-scatter Matrix Multiplication Kernel with Triton ...
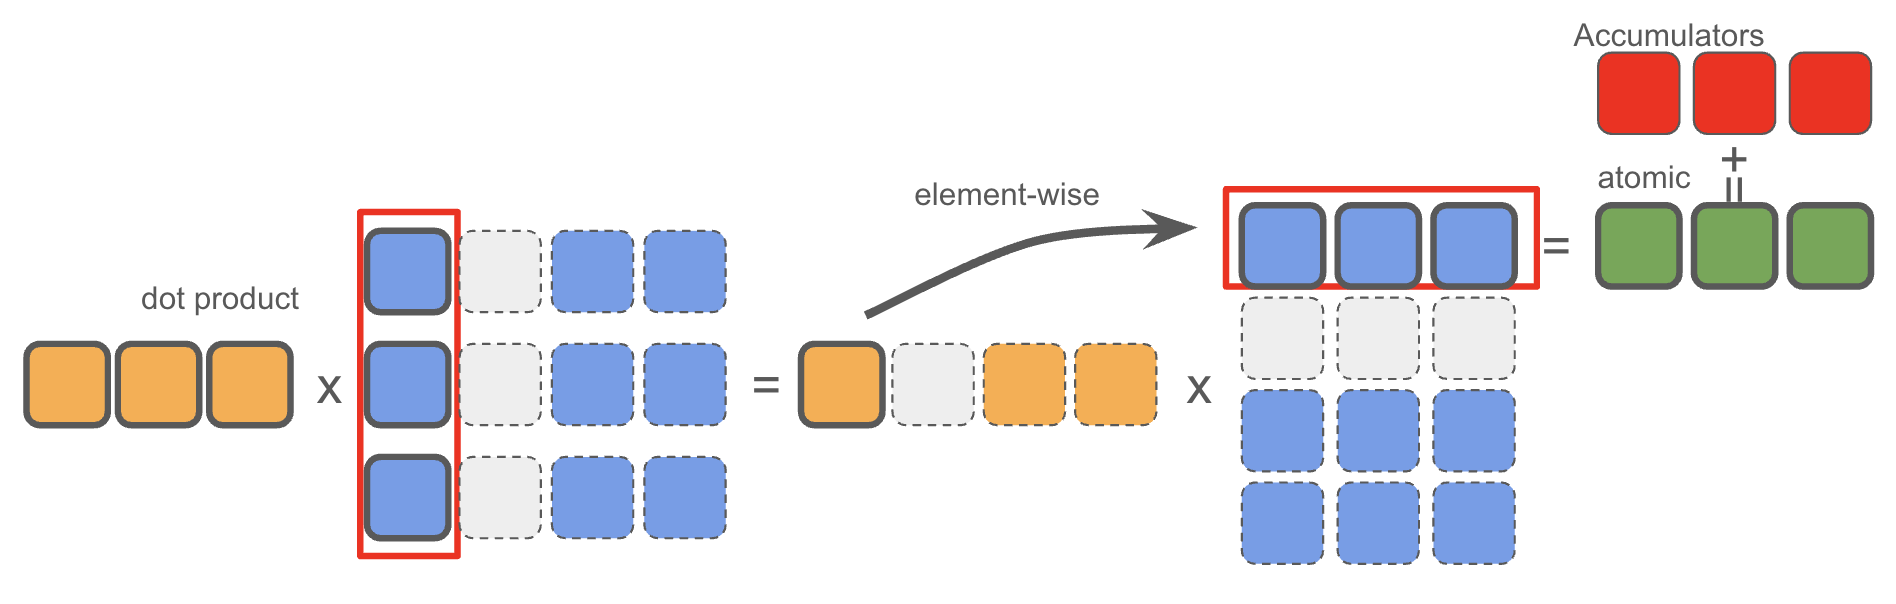
Efficient Gather-and-scatter Feed-forward Network Kernel with Triton ...
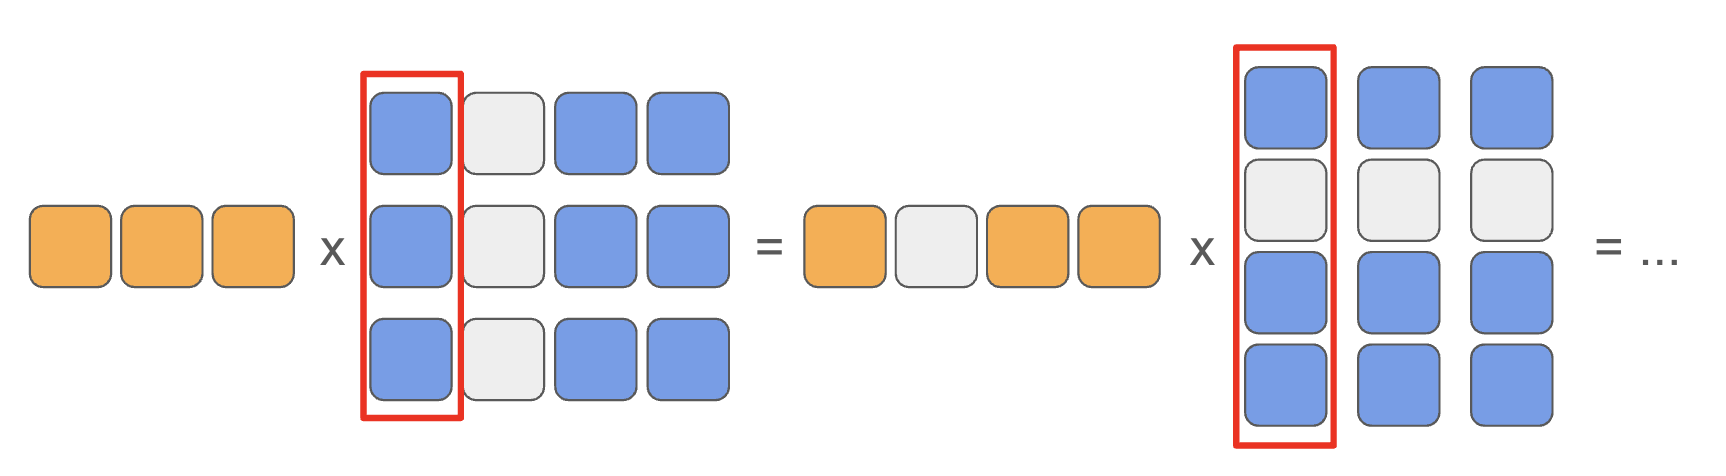
Efficient Gather-and-scatter Feed-forward Network Kernel with Triton ...
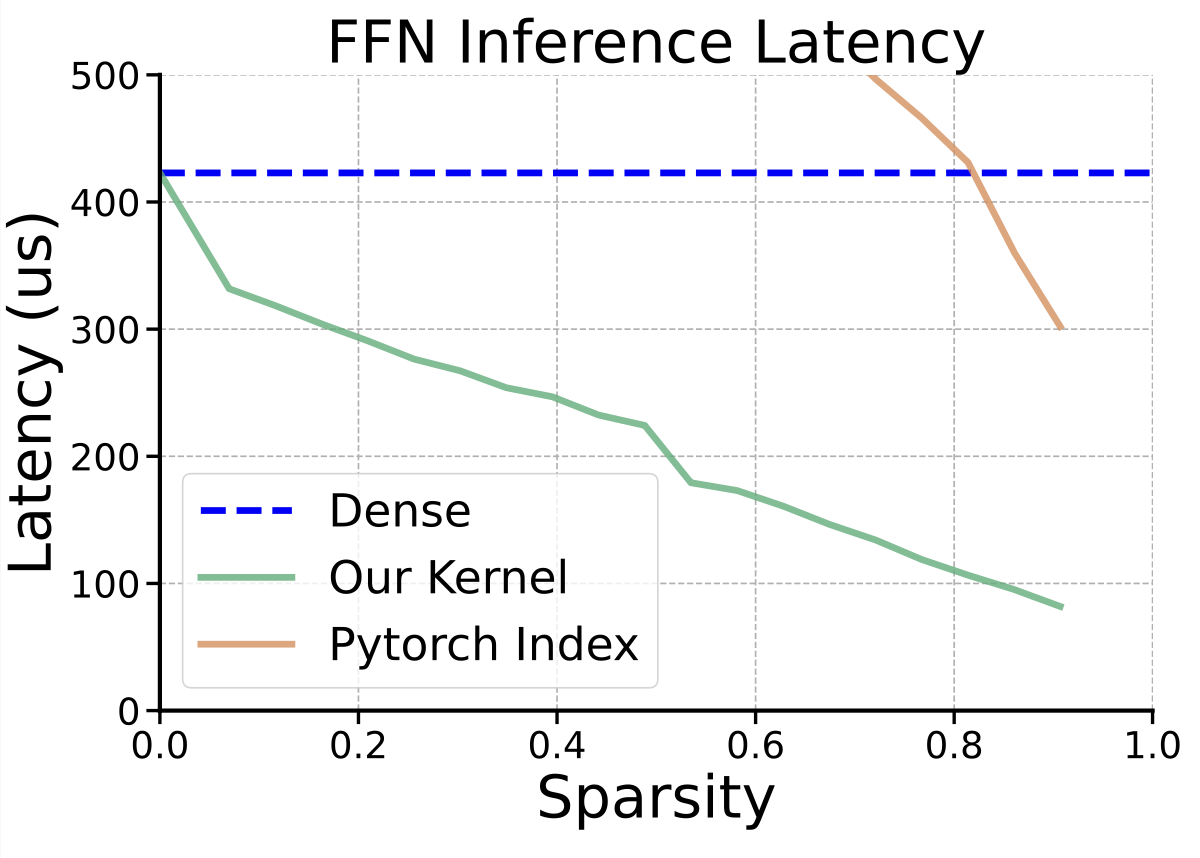
Efficient Gather-and-scatter Feed-forward Network Kernel with Triton ...
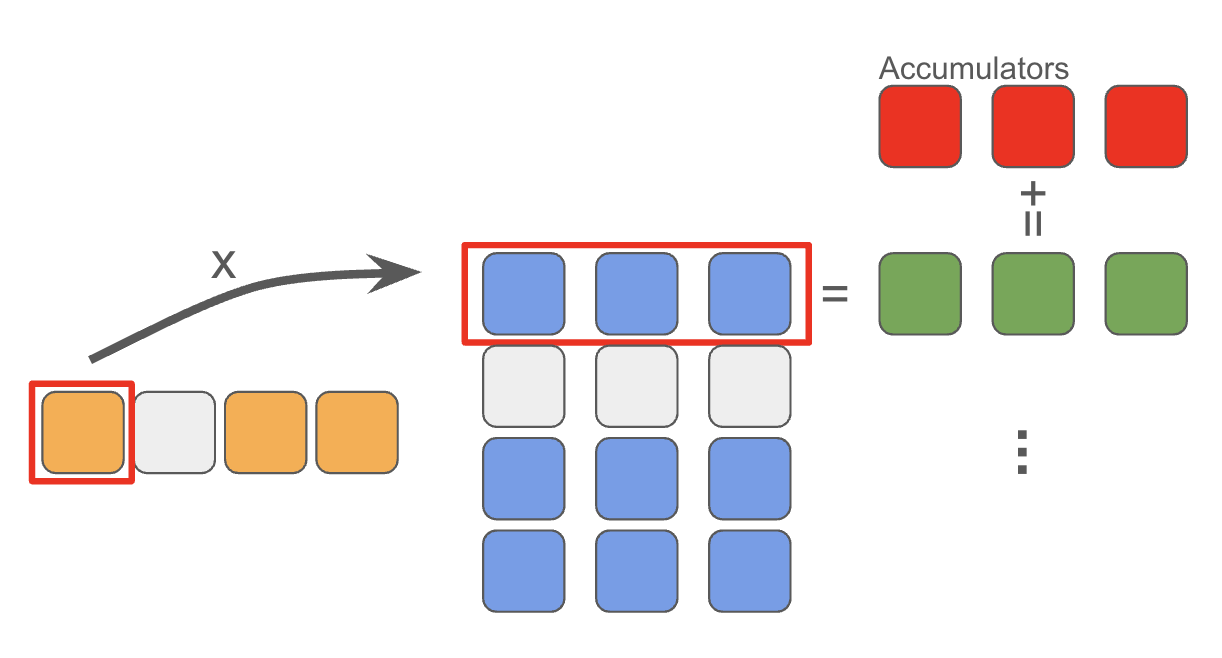
Efficient Gather-and-scatter Feed-forward Network Kernel with Triton ...

Learning Triton One Kernel at a Time: Matrix Multiplication ...

(PDF) Micro-Kernels for Portable and Efficient Matrix Multiplication in ...

Micro-kernels for portable and efficient matrix multiplication in deep ...
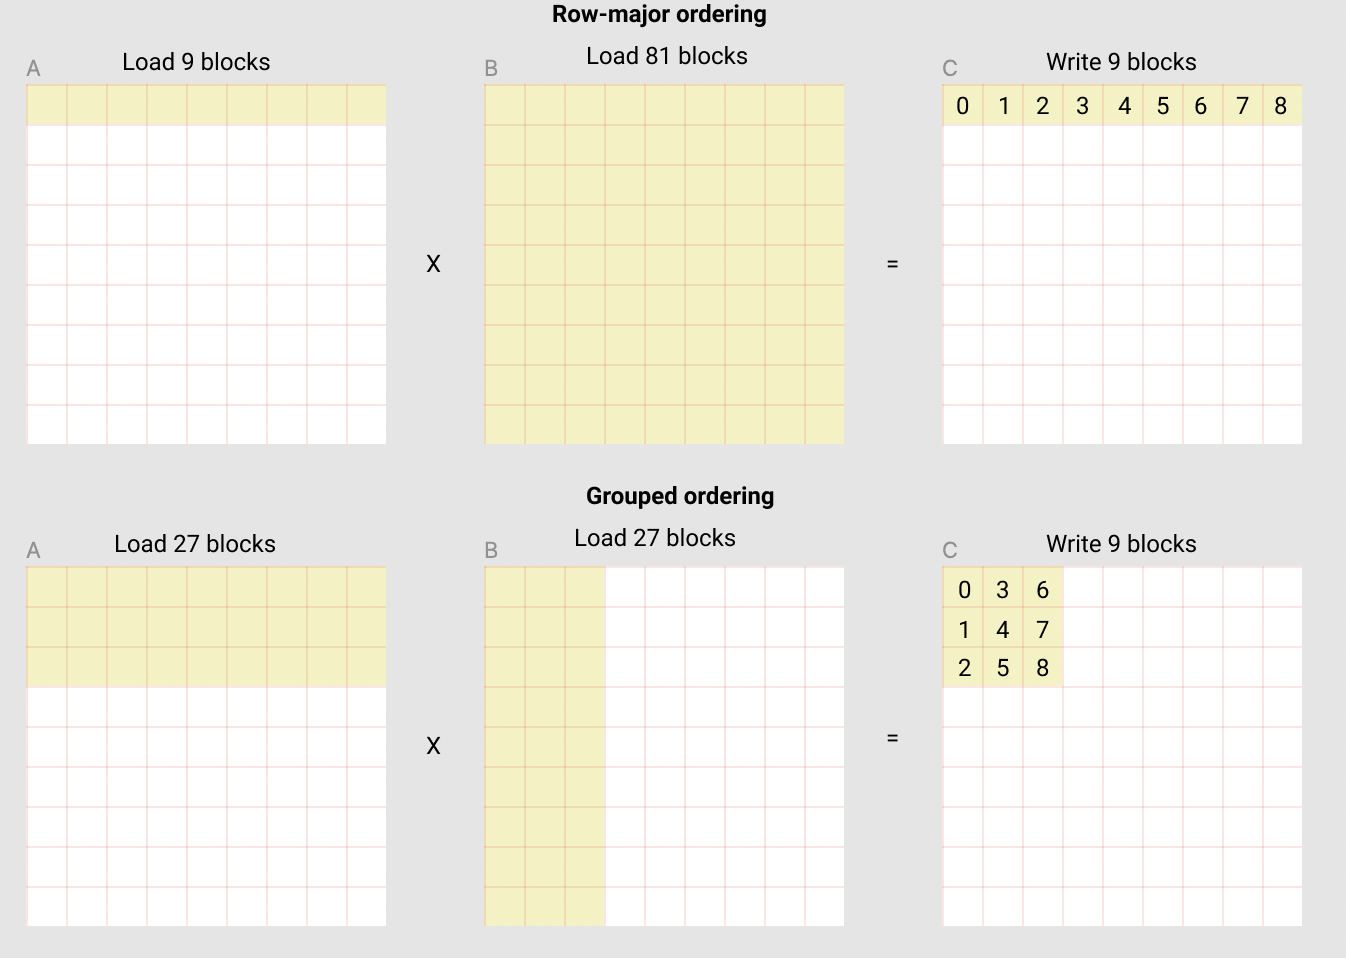
Matrix Multiplication — Triton documentation
Advertisement Space (300x250)
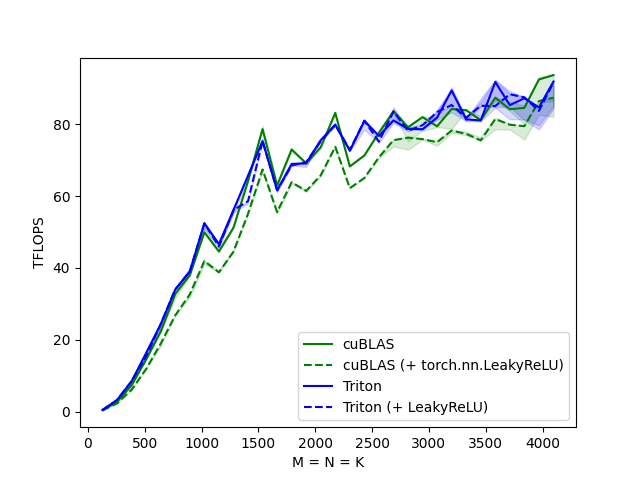
Matrix Multiplication — Triton documentation
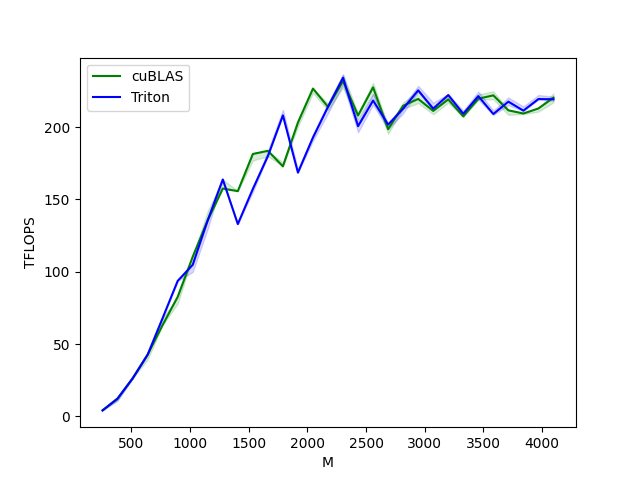
Matrix Multiplication — Triton documentation

Tiled Matrix Multiplication in Triton - part 1 - YouTube

Triton Grouped Matrix Multiplication (Almost CUDA Performance!) | A ...
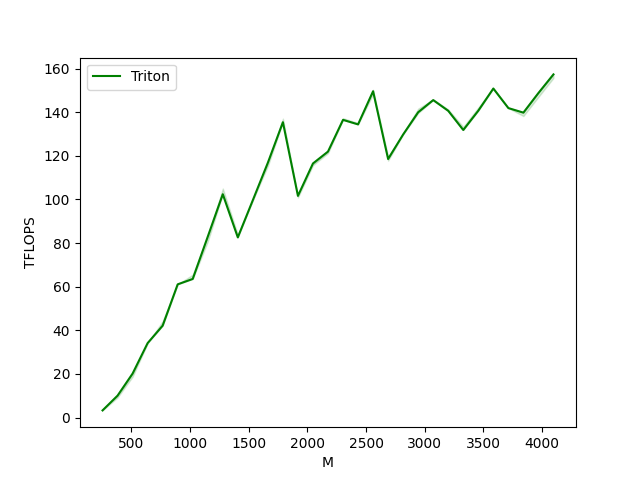
Matrix Multiplication — Triton documentation
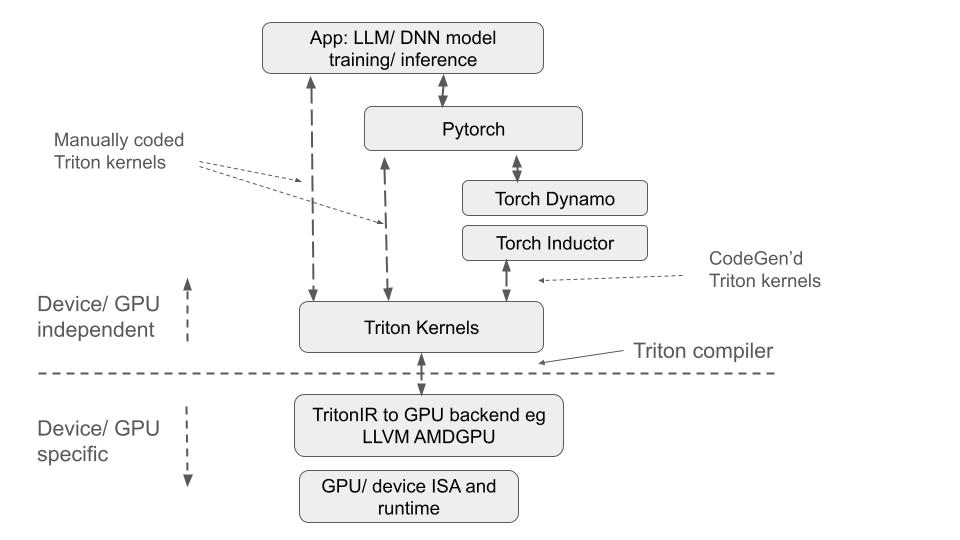
Democratizing AI Accelerators and GPU Kernel Programming using Triton ...

Scatter plot matrix (SPLOM) with kernel-density estimator (KDE). For a ...

A Low-Power General Matrix Multiplication Accelerator with Sparse ...
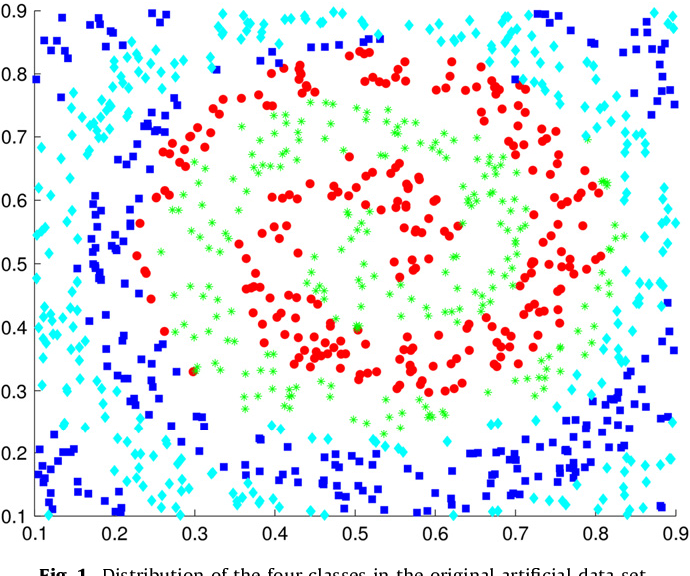
Figure 1 from Cohort-based kernel visualisation with scatter matrices ...

Sparton: Fast and Memory-Efficient Triton Kernel for Learned Sparse ...
Advertisement Space (336x280)

A Low-Power General Matrix Multiplication Accelerator with Sparse ...

Execution time for the task with matrix multiplication kernels ...

A Low-Power General Matrix Multiplication Accelerator with Sparse ...
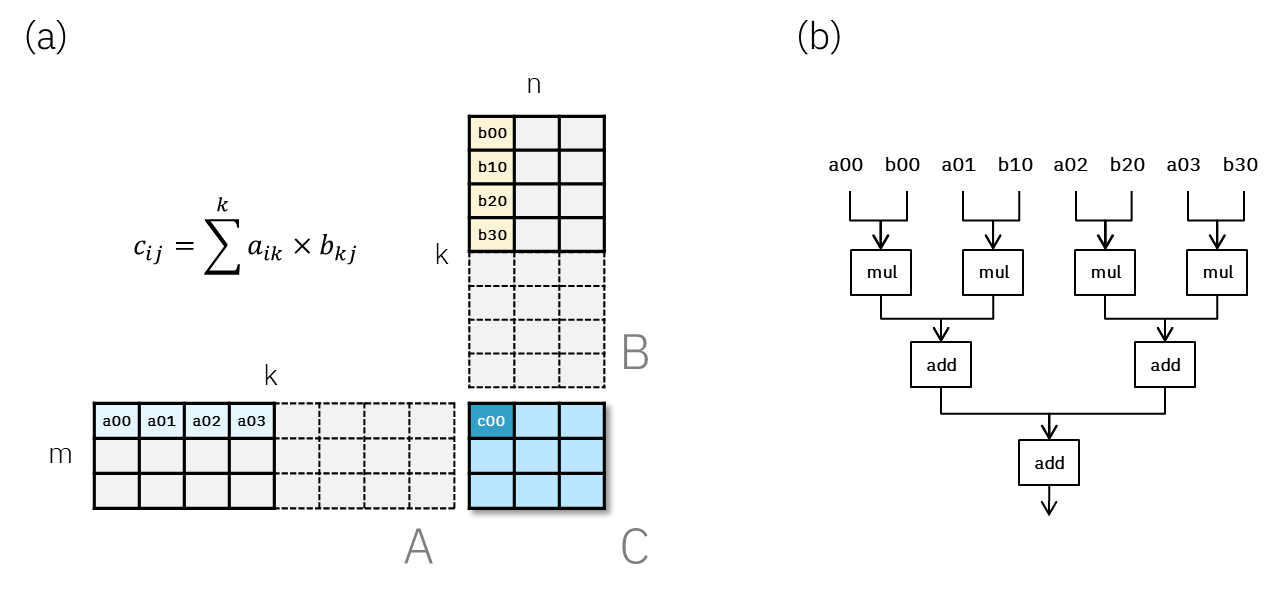
Some Matrix Multiplication Engines Are Not As Accurate As We Thought ...

🚀 CUDA Programming Series: Matrix Multiplication on the GPU | by Shyam ...
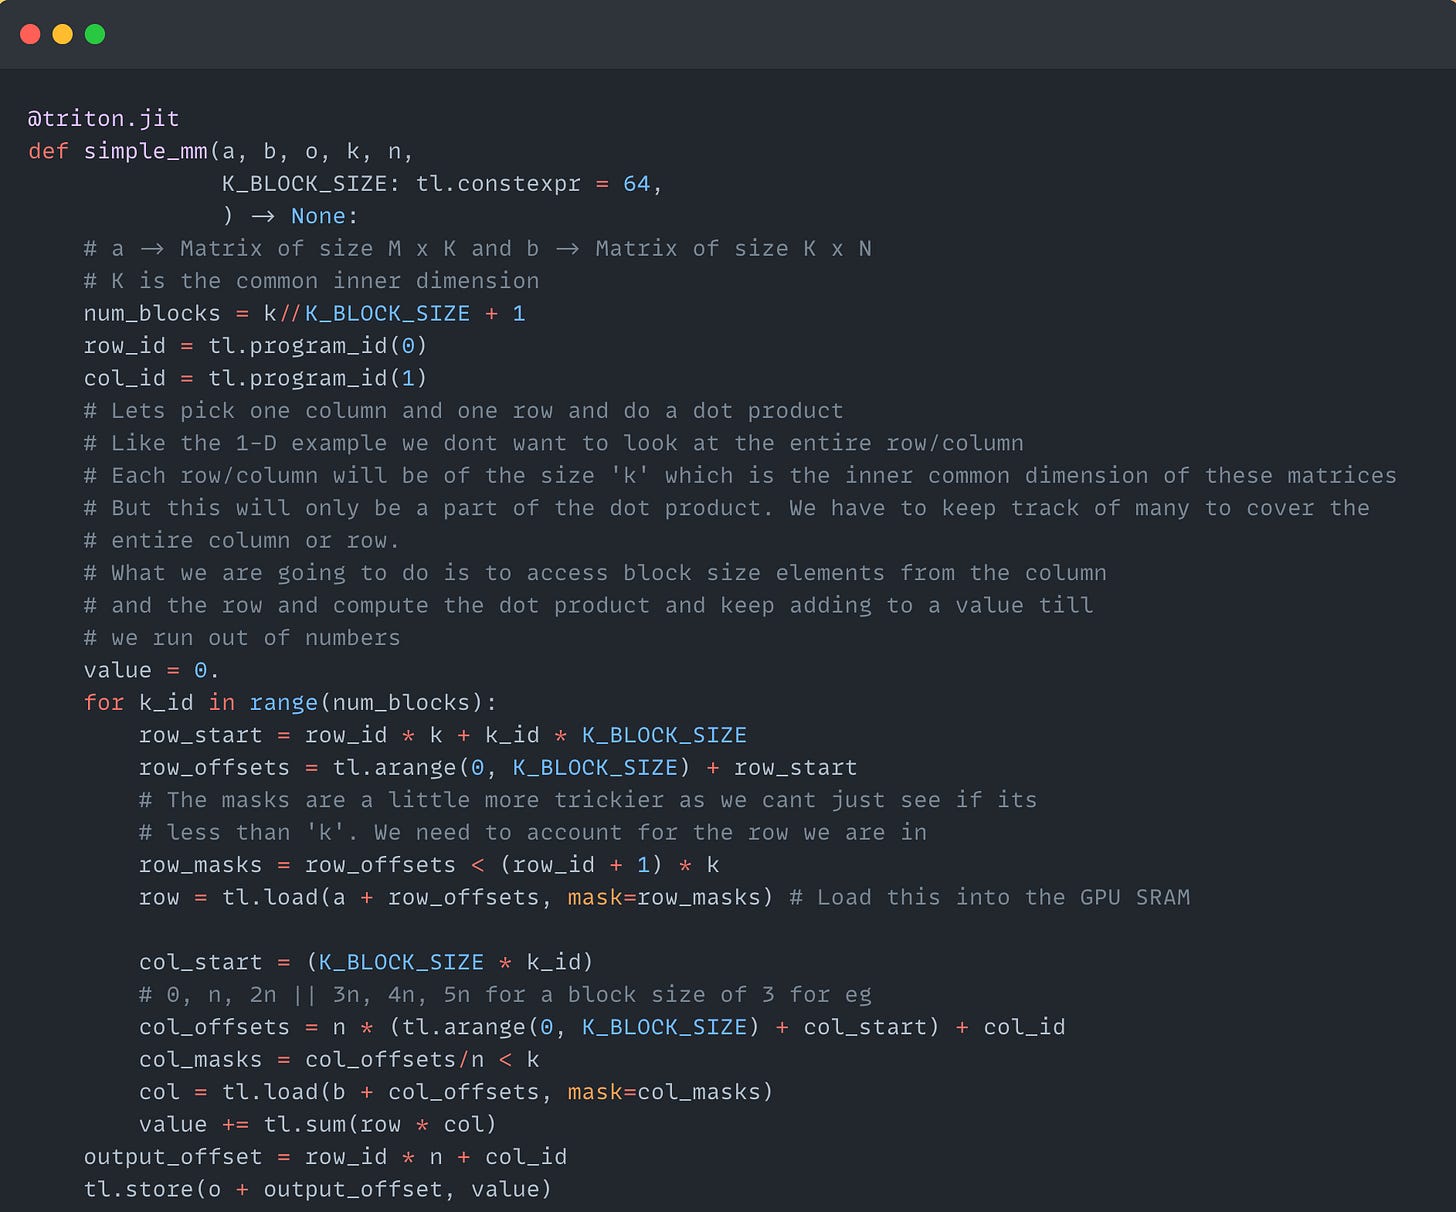
Simplifying CUDA kernels with OpenAI's Triton

Figure 1 from A scalable sparse matrix-vector multiplication kernel for ...
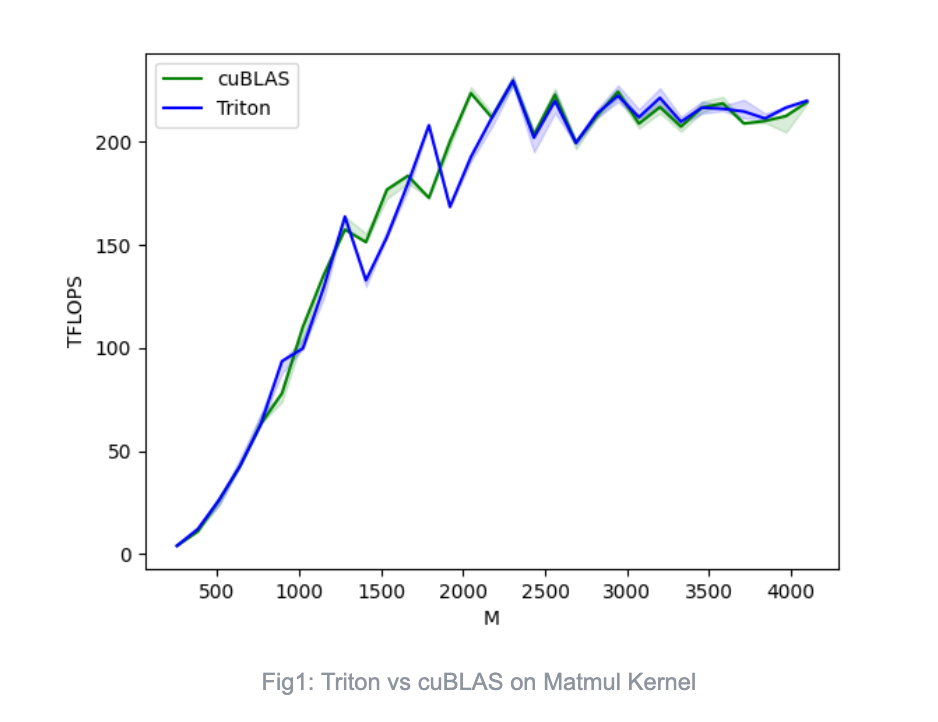
Triton kernel performance on RISC-V CPU - RISC-V International
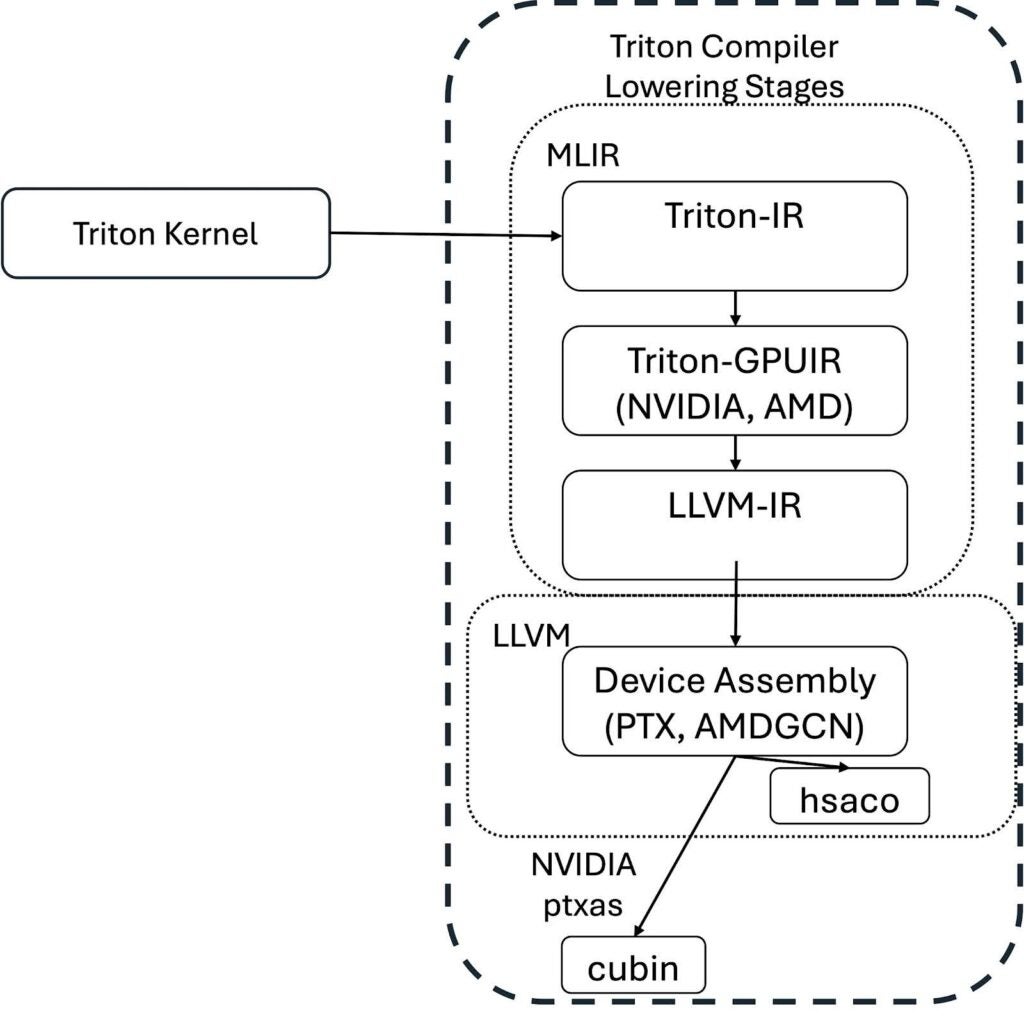
Triton Kernel Compilation Stages – PyTorch

AutoTriton: Automatic Triton Programming with Reinforcement Learning in ...
Advertisement Space (336x280)

论文笔记 - 《Implementing block-sparse matrix multiplication kernels using ...

(PDF) A scalable sparse matrix-vector multiplication kernel for energy ...
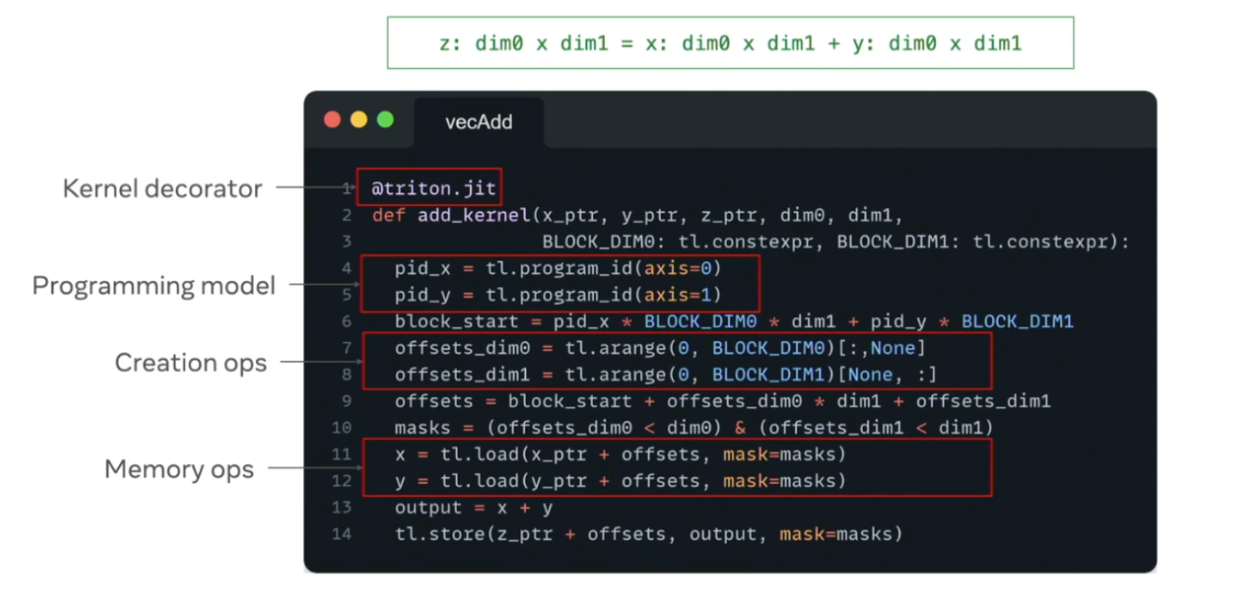
Programming AI Accelerators with Triton | DigitalOcean
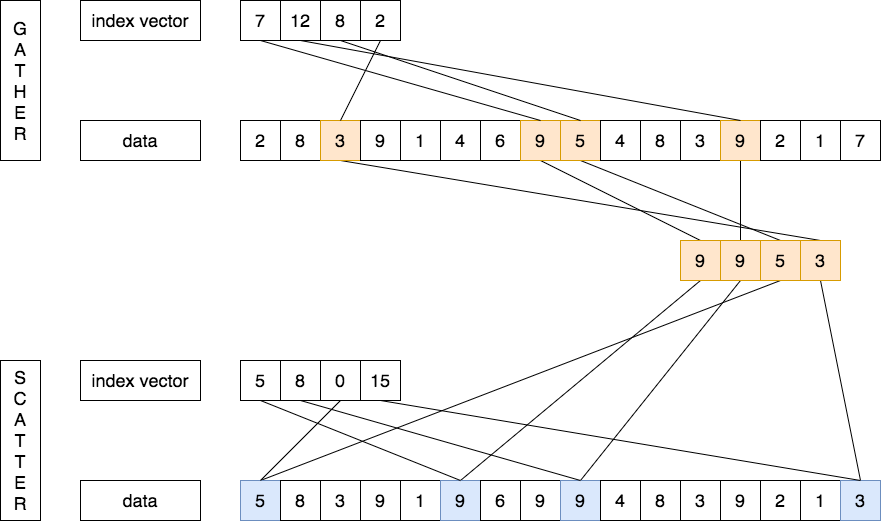
Vector Optimization - Gather Scatter - The Beard Sage

Simplifying CUDA kernels with OpenAI's Triton

Evaluation of computational and energy performance in matrix ...