
End To End Generative Pre Training For Multimodal Video Captioning R
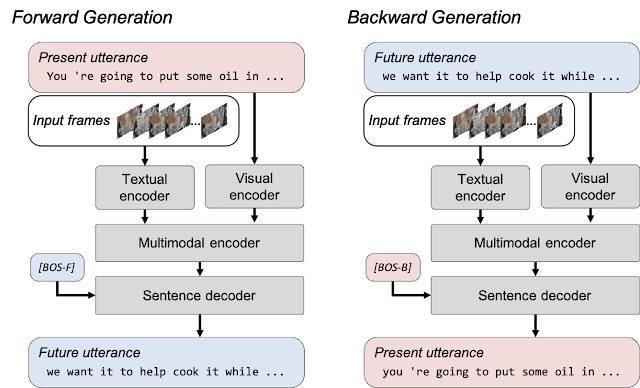
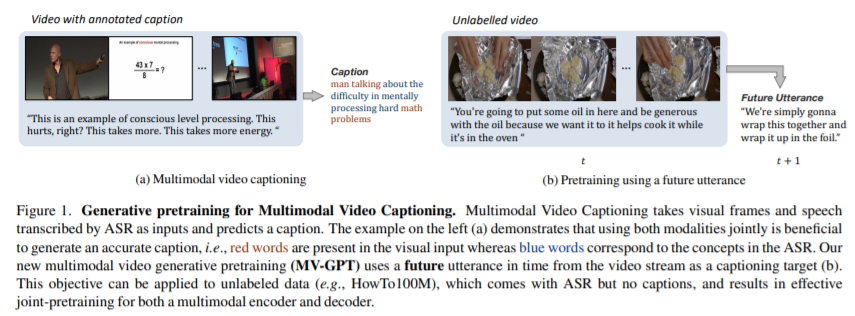
End-to-end Generative Pre-training for Multimodal Video Captioning
谷歌 | End-to-end Generative Pretraining for Multimodal Video Captioning ...
End-to-end Generative Pretraining for Multimodal Video Captioning 论文笔记 ...
[CVPR 2022] End-to-end Generative Pretraining for Multimodal Video ...
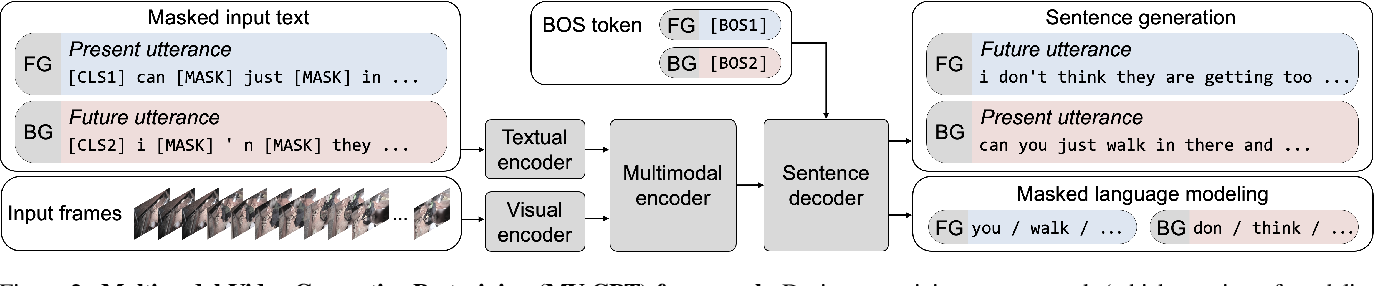
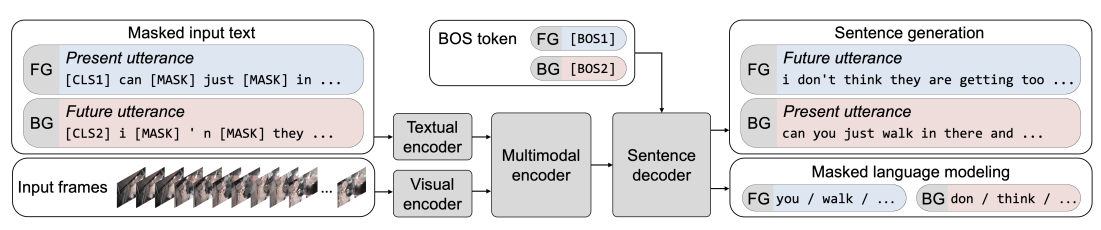
Figure 2 from End-to-end Generative Pretraining for Multimodal Video ...

[Journal club] End-to-End Generative Pretraining for Multimodal Video ...
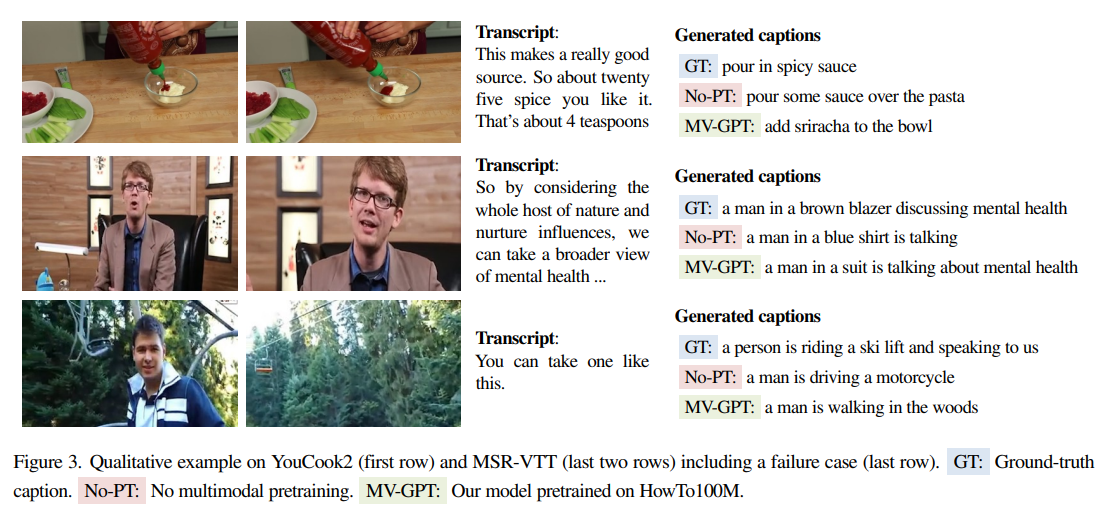
[CVPR 2022] End-to-end Generative Pretraining for Multimodal Video ...
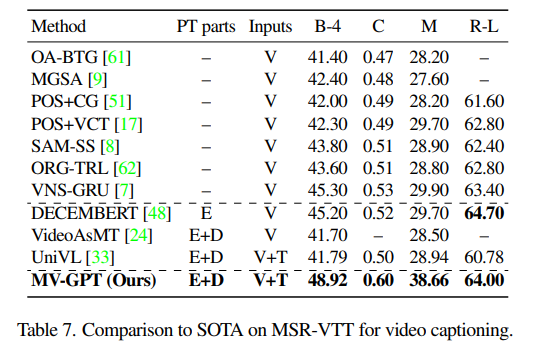
[CVPR 2022] End-to-end Generative Pretraining for Multimodal Video ...
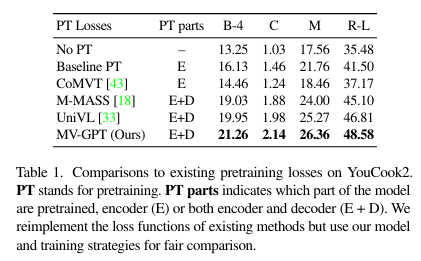
[CVPR 2022] End-to-end Generative Pretraining for Multimodal Video ...
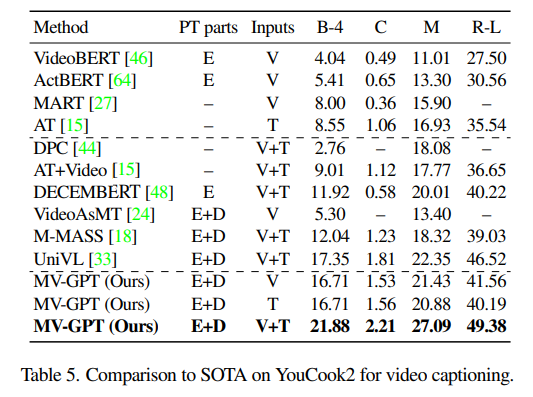
[CVPR 2022] End-to-end Generative Pretraining for Multimodal Video ...
Advertisement Space (300x250)
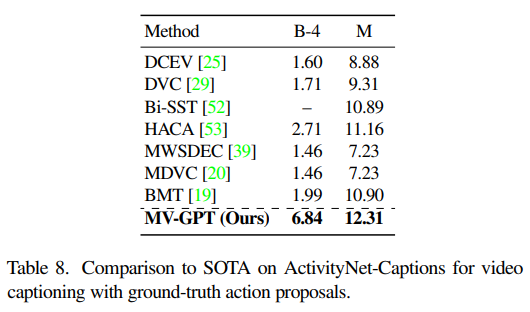
[CVPR 2022] End-to-end Generative Pretraining for Multimodal Video ...
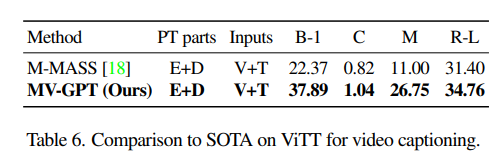
[CVPR 2022] End-to-end Generative Pretraining for Multimodal Video ...

[2201.08264] End-to-end Generative Pretraining for Multimodal Video ...
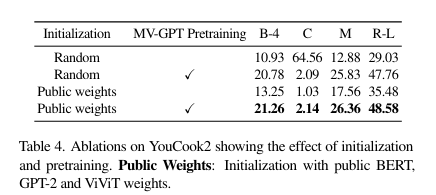
[CVPR 2022] End-to-end Generative Pretraining for Multimodal Video ...

Multimodal Feature Learning for Video Captioning - Lee - 2018 ...

Multimodal Pretraining for Dense Video Captioning - ACL Anthology

Multi-Task Video Captioning with a Stepwise Multimodal Encoder

Figure 1 from A Multimodal Framework for Video Caption Generation ...

Figure 2 from Enhancing Ocean Scene Video Captioning with Multimodal ...

Multimodal Video Captioning Framework | PDF | Attention | Deep Learning
Advertisement Space (336x280)

Multi-Task Video Captioning with a Stepwise Multimodal Encoder

Figure 1 from Enhancing Ocean Scene Video Captioning with Multimodal ...

Figure 1 from Enhancing Ocean Scene Video Captioning with Multimodal ...

Multimodal-enhanced hierarchical attention network for video captioning ...

Enhancing Ocean Scene Video Captioning With Multimodal Pre-Training and ...

(PDF) Leveraging Pre-trained 3D-CNNs for Video Captioning

Figure 3 from A Review of Deep Learning for Video Captioning | Semantic ...

Figure 1 from End-to-End Video Captioning | Semantic Scholar

Video Captioning 总结与展望 - 知乎

Video Captioning 总结与展望 - 知乎
Advertisement Space (336x280)
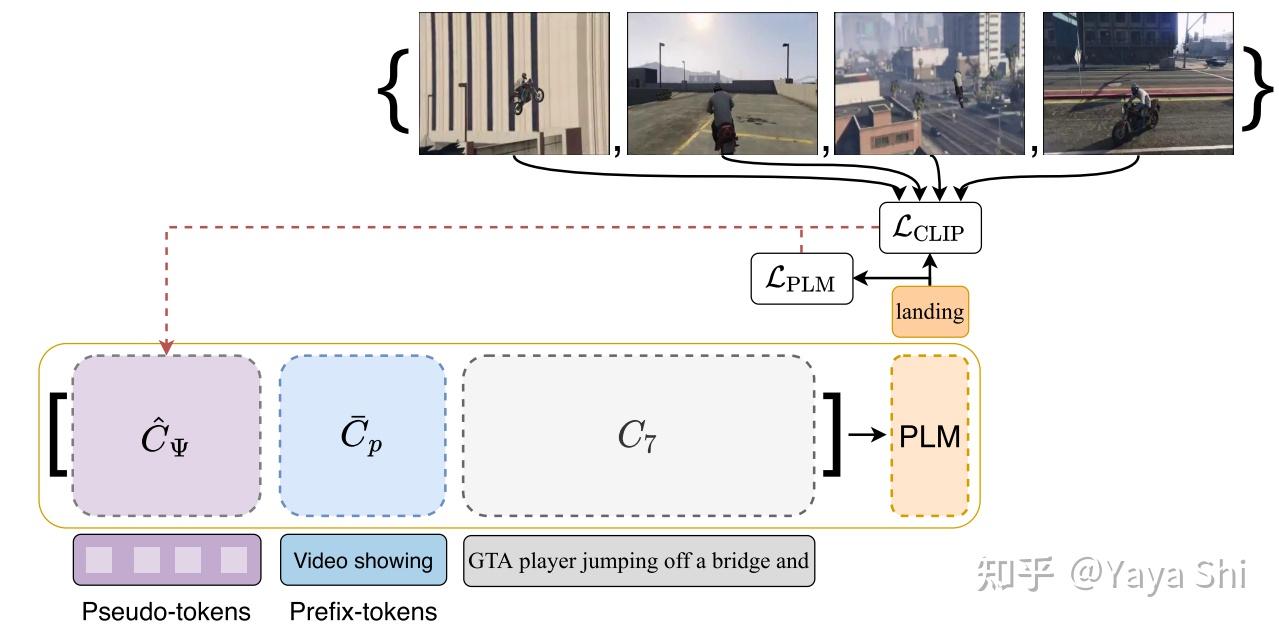
Video Captioning 总结与展望 - 知乎

Video Captioning 总结与展望 - 知乎

Video Captioning 总结与展望 - 知乎

论文阅读—— Multimodal Foundation Models:From Specialists to General-Purpose ...

Deep Learning for Multimodal Systems

[1909.11059] Unified Vision-Language Pre-Training for Image Captioning ...