
End To End Generative Pretraining For Multimodal Video Captioning
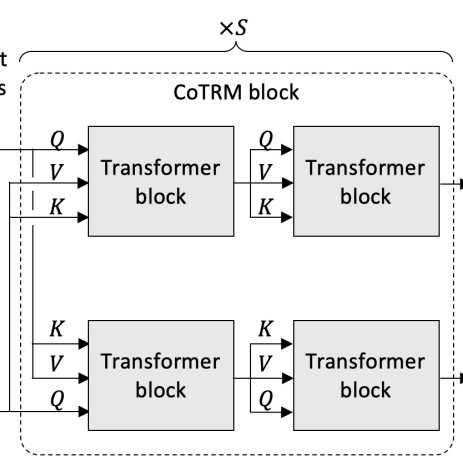
End-to-end Generative Pretraining for Multimodal Video Captioning 论文笔记 ...
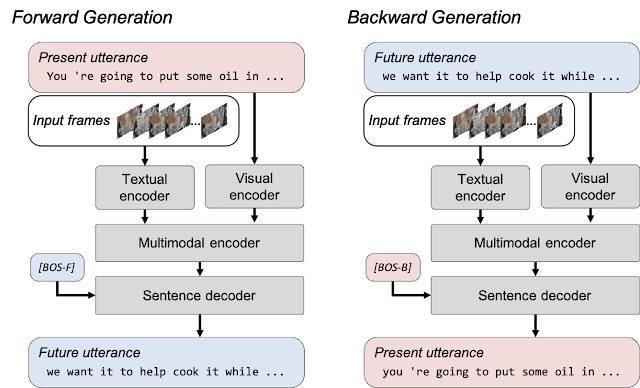
End-to-end Generative Pre-training for Multimodal Video Captioning

[2201.08264] End-to-end Generative Pretraining for Multimodal Video ...
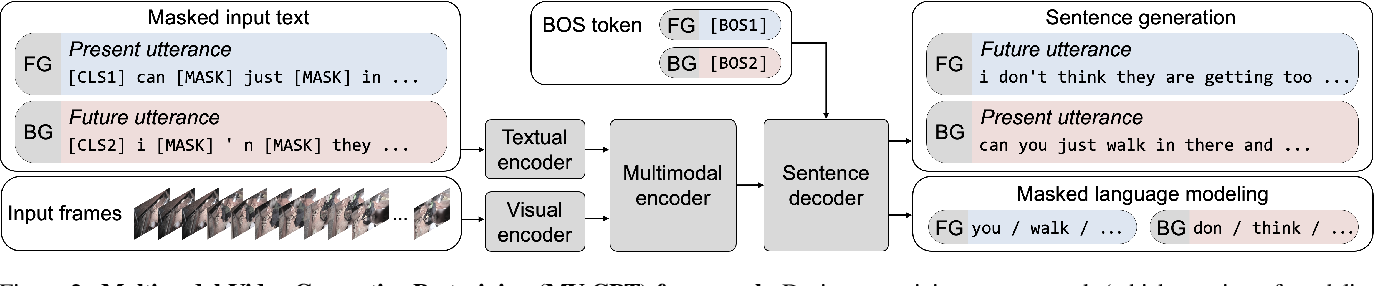
Figure 2 from End-to-end Generative Pretraining for Multimodal Video ...

[Journal club] End-to-End Generative Pretraining for Multimodal Video ...
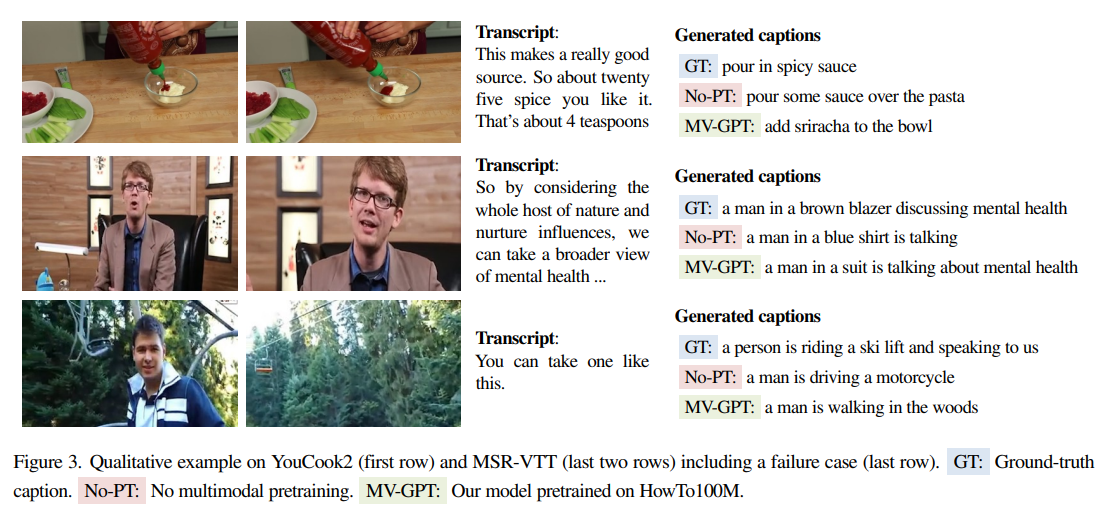
[CVPR 2022] End-to-end Generative Pretraining for Multimodal Video ...

[2201.08264] End-to-end Generative Pretraining for Multimodal Video ...

[2201.08264] End-to-end Generative Pretraining for Multimodal Video ...

[2201.08264] End-to-end Generative Pretraining for Multimodal Video ...
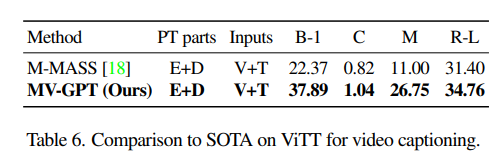
[CVPR 2022] End-to-end Generative Pretraining for Multimodal Video ...
Advertisement Space (300x250)
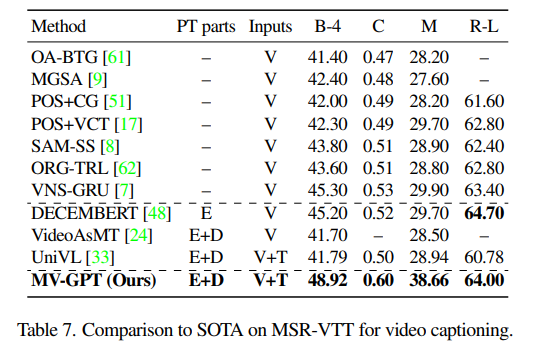
[CVPR 2022] End-to-end Generative Pretraining for Multimodal Video ...
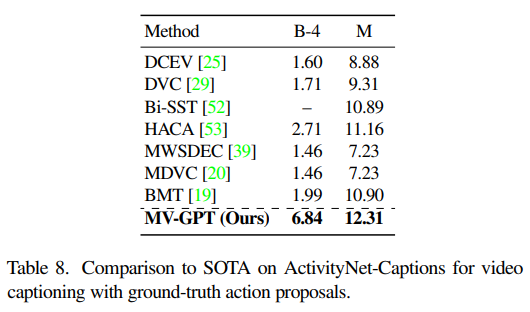
[CVPR 2022] End-to-end Generative Pretraining for Multimodal Video ...
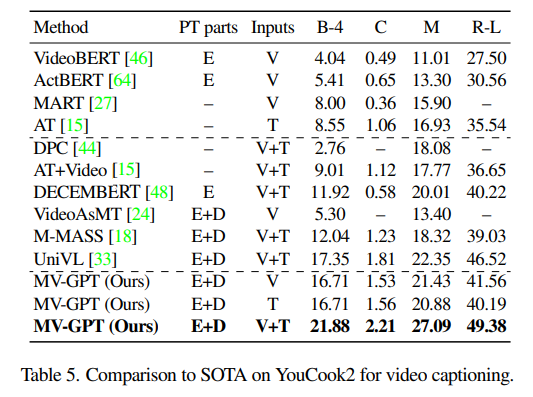
[CVPR 2022] End-to-end Generative Pretraining for Multimodal Video ...
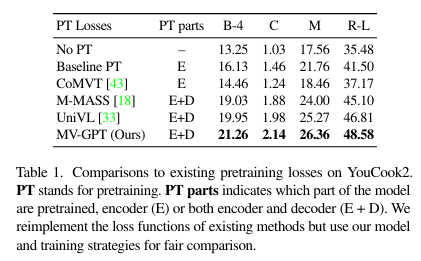
[CVPR 2022] End-to-end Generative Pretraining for Multimodal Video ...

Paper page - Multimodal Pretraining for Dense Video Captioning

Table 1 from End-to-end Generative Pretraining for Multimodal Video ...
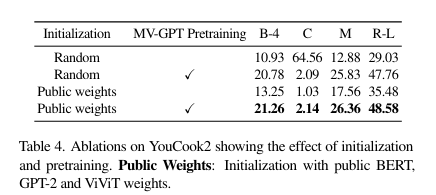
[CVPR 2022] End-to-end Generative Pretraining for Multimodal Video ...

Multimodal Pretraining for Dense Video Captioning - ACL Anthology

Multimodal Feature Learning for Video Captioning - Lee - 2018 ...
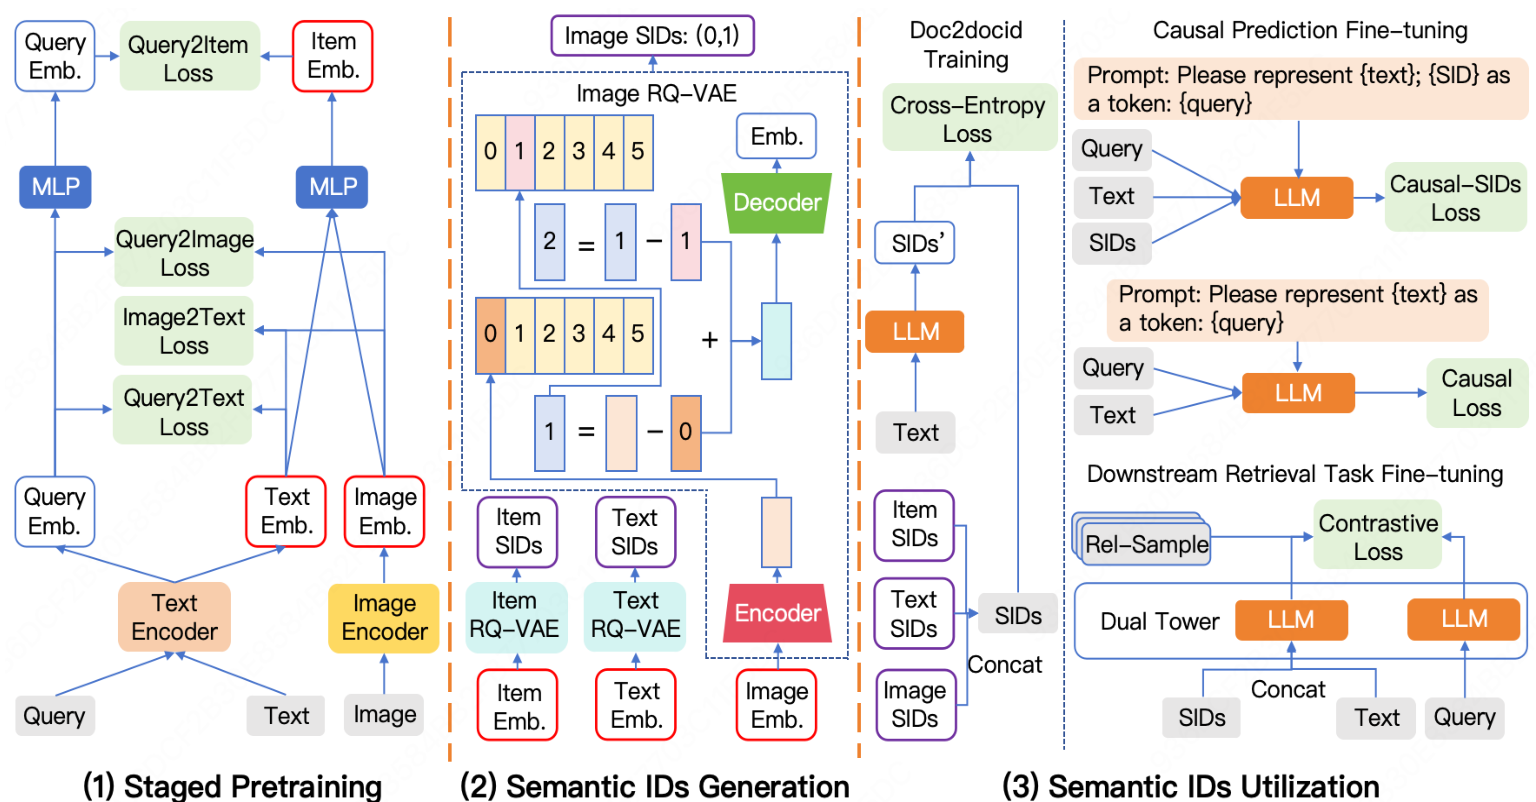
Multimodal Generative Retrieval Model with Staged Pretraining for Food ...
Advertisement Space (336x280)

Figure 1 from A Multimodal Framework for Video Caption Generation ...

Multi-Task Video Captioning with a Stepwise Multimodal Encoder

Introduction to Multimodal Generative Models-Model Architecture Key ...

Multimodal Video Captioning Framework | PDF | Attention | Deep Learning

Multi-Task Video Captioning with a Stepwise Multimodal Encoder

Figure 2 from Enhancing Ocean Scene Video Captioning with Multimodal ...

Multimodal Pretraining and Generation for Recommendation: A Tutorial ...
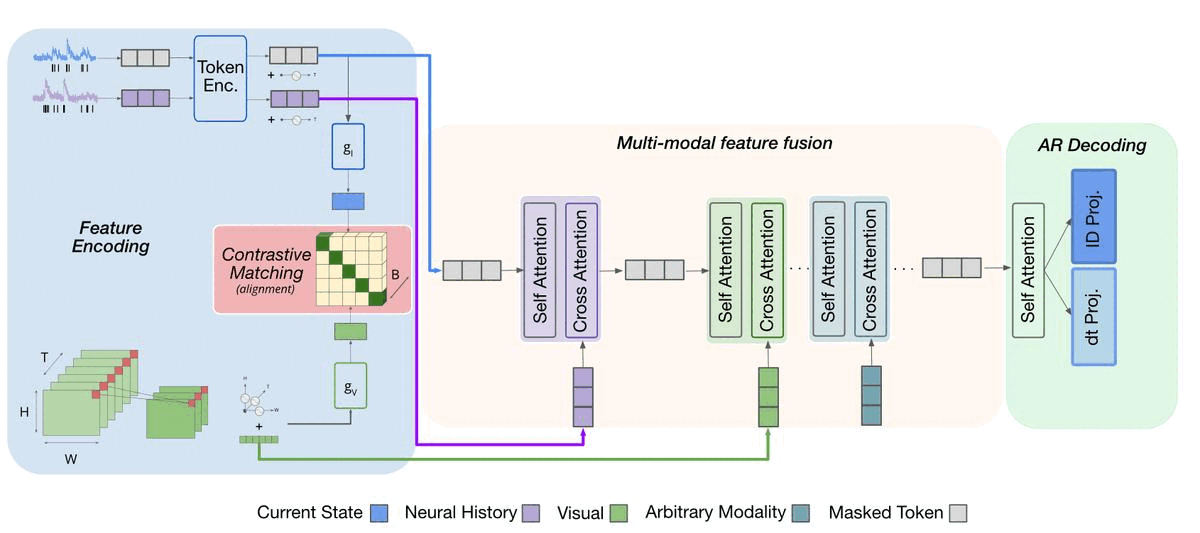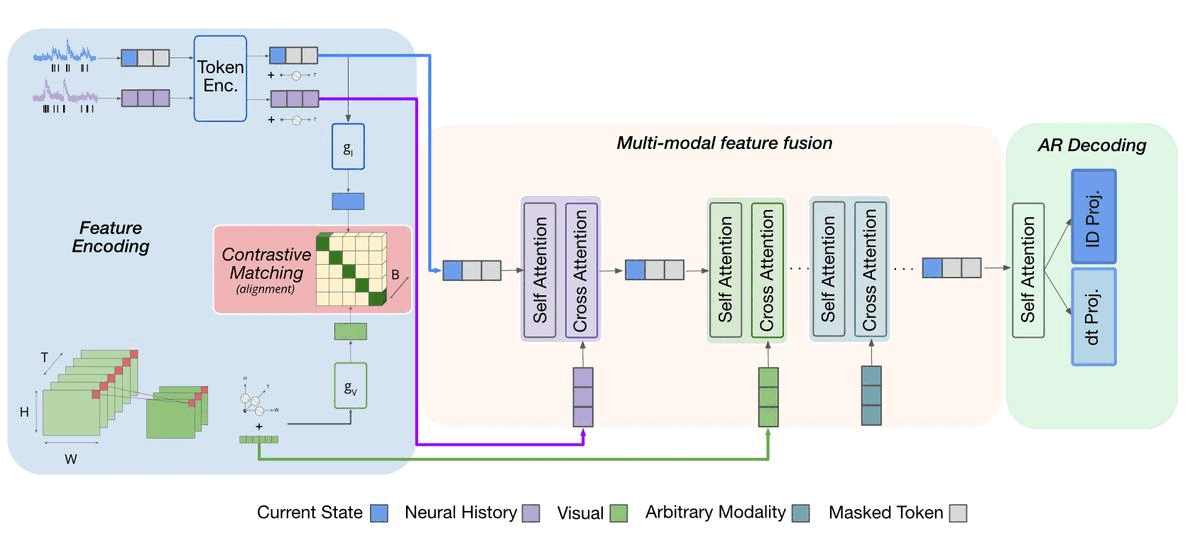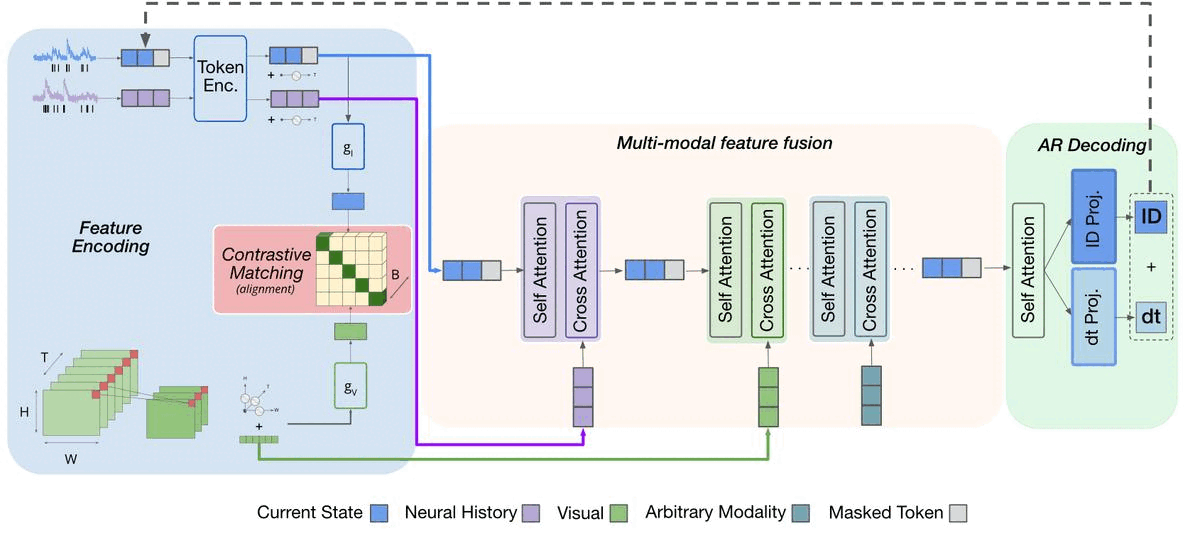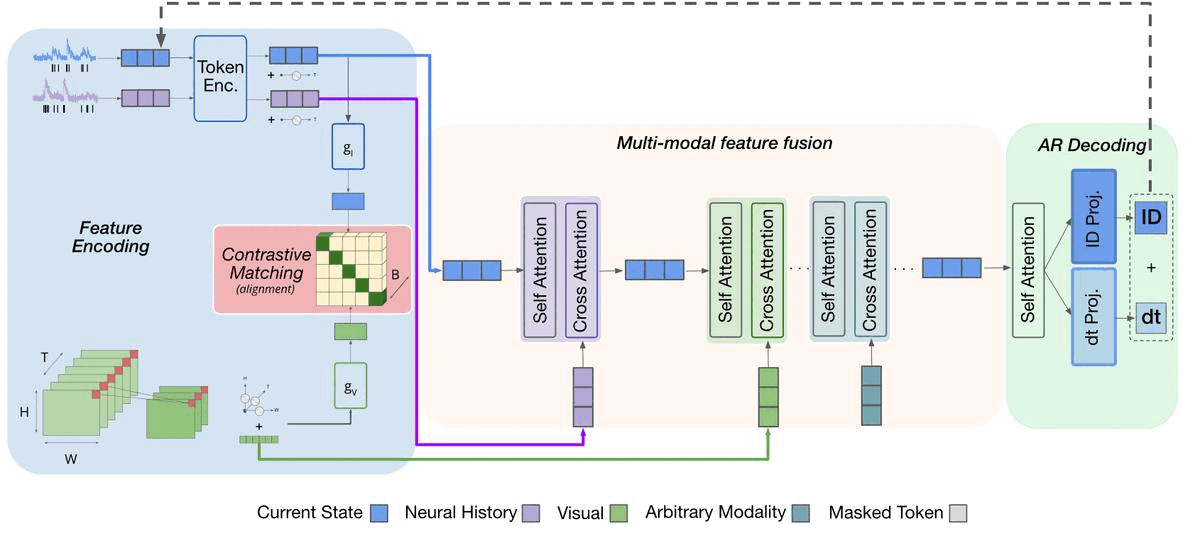
"Neuroformer: Multimodal, Multitask Generative Pretraining for Brain Data"
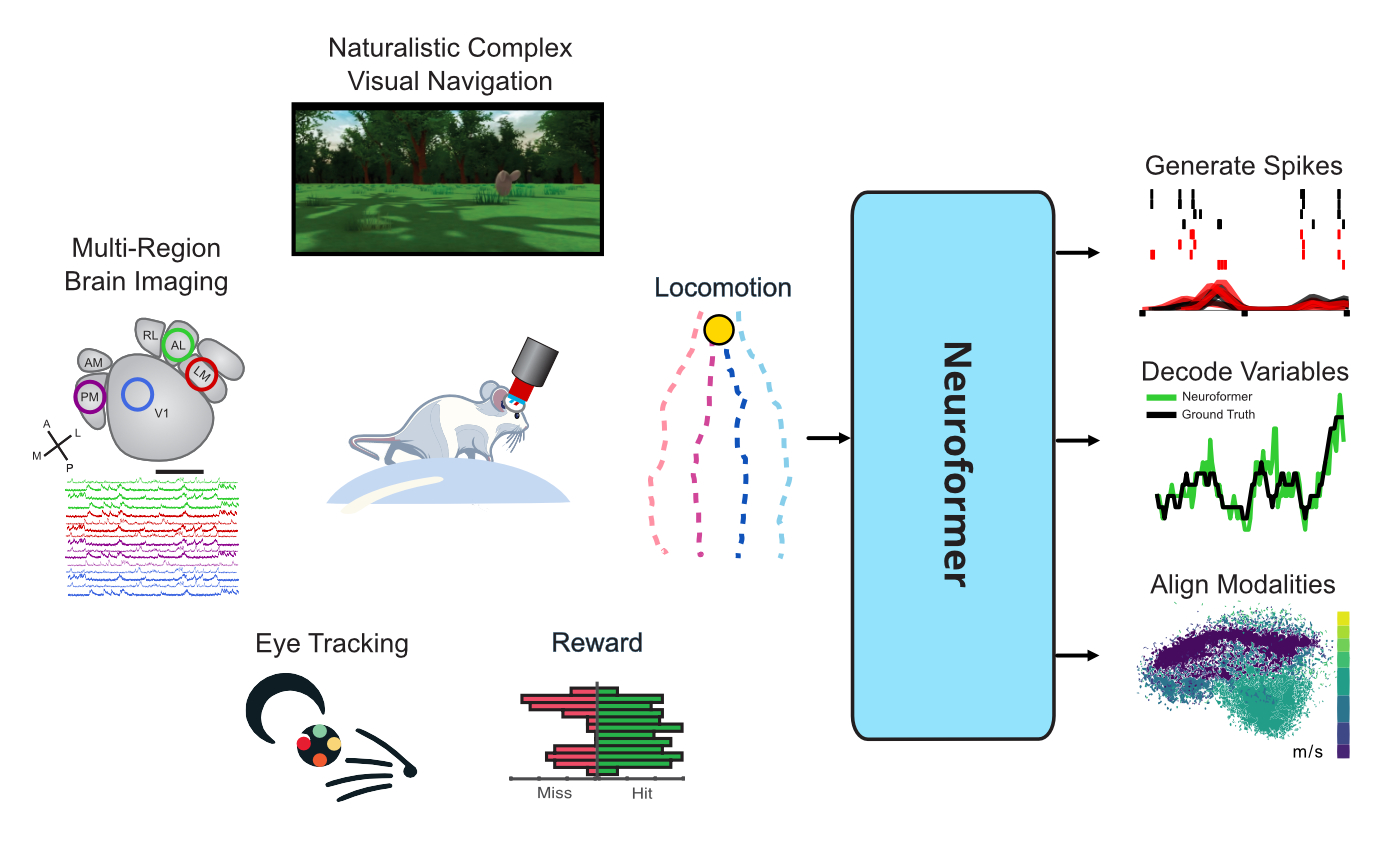
"Neuroformer: Multimodal, Multitask Generative Pretraining for Brain Data"

Adaptively Building a Video-language Model for Video Captioning and ...
Advertisement Space (336x280)

Figure 2 from End-to-End Multimodal Representation Learning for Video ...

[논문 리뷰] Enhancing Multimodal LLM for Detailed and Accurate Video ...

Privileged Contrastive Pretraining for Multimodal Affect Modelling ...
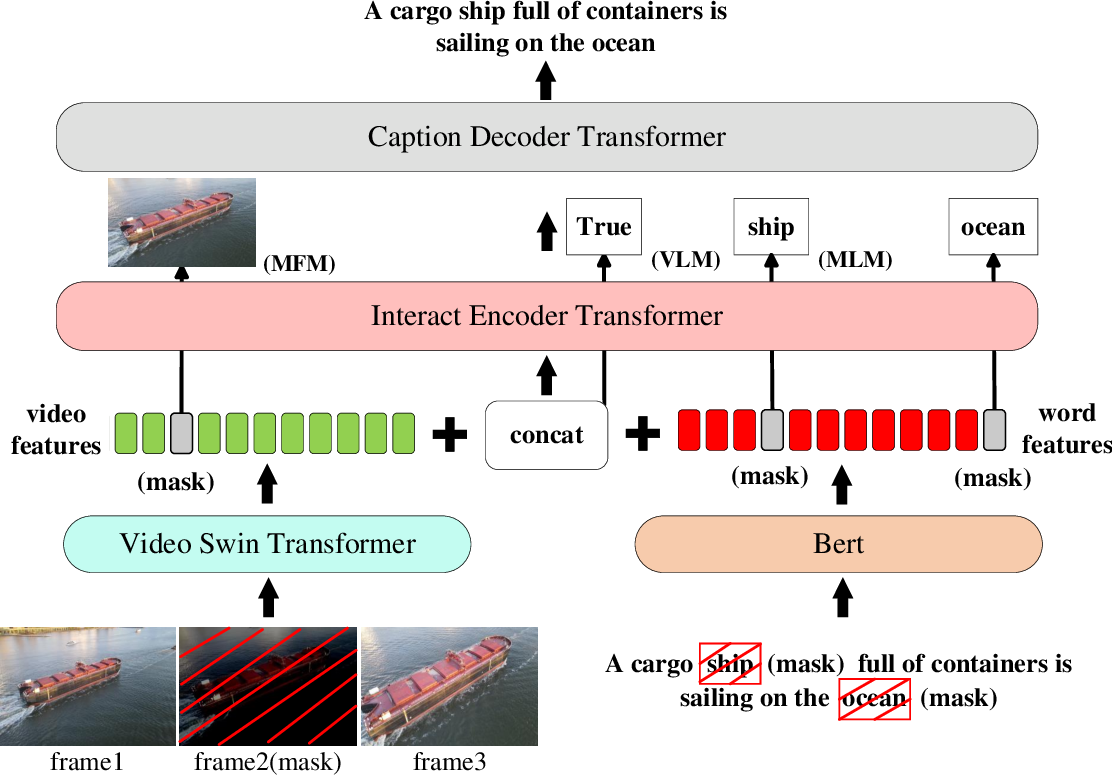
Figure 1 from Enhancing Ocean Scene Video Captioning with Multimodal ...

Figure 1 from Enhancing Ocean Scene Video Captioning with Multimodal ...

An end-to-end transformer model for dense video captioning [222]. The ...