
Examples Of Vision Dialogue Navigation Using Our Proposed Cross Modal
Examples of vision dialogue navigation using our proposed Cross-modal ...

Interpretation of our our proposed cross-modal attention-guided visual ...

Interpretation of our our proposed cross-modal attention-guided visual ...

Interpretation of our our proposed cross-modal attention-guided visual ...

The overview of our proposed model. | Download Scientific Diagram

[CVPR2022|跨模态检索]ViSTA: Vision and Scene Text Aggregation for Cross ...

[2203.05137] Cross-modal Map Learning for Vision and Language Navigation

[2203.05137] Cross-modal Map Learning for Vision and Language Navigation

Improving Speech Emotion Recognition Through Cross Modal Attention ...

Cross modal attention. These visualizations follow the same format as ...
Advertisement Space (300x250)

Improving Cross-Modal Alignment in Vision Language Navigation via ...

[2203.05137] Cross-modal Map Learning for Vision and Language Navigation

Improving Cross-Modal Alignment in Vision Language Navigation via ...

[2203.05137] Cross-modal Map Learning for Vision and Language Navigation

Frontiers | A Modular Vision Language Navigation and Manipulation ...

Cross-modal Map Learning for Vision and Language Navigation | DeepAI

Learning Visuomotor Policies for Aerial Navigation Using Cross-Modal ...

Vision-Dialog Navigation by Exploring Cross-Modal Memory

Cross-Modal Alignment Learning of Vision-Language Conceptual Systems
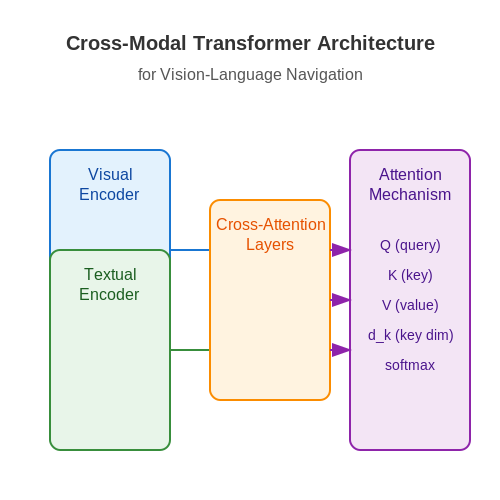
Vision-Language Navigation Tasks | AI Tutorial | Next Electronics
Advertisement Space (336x280)

Vision-Language Navigation Tasks | AI Tutorial | Next Electronics

Examples for retrieving cross-modal adaptive relations reasoning ...

Vision-Dialog Navigation by Exploring Cross-Modal Memory

Figure 2 from Cross-Modal Concept Learning and Inference for Vision ...

Figure 1 from Vision-Dialog Navigation by Exploring Cross-Modal Memory ...

CoNav: Collaborative Cross-Modal Reasoning for Embodied Navigation

Vision-Dialog Navigation by Exploring Cross-Modal Memory - YouTube
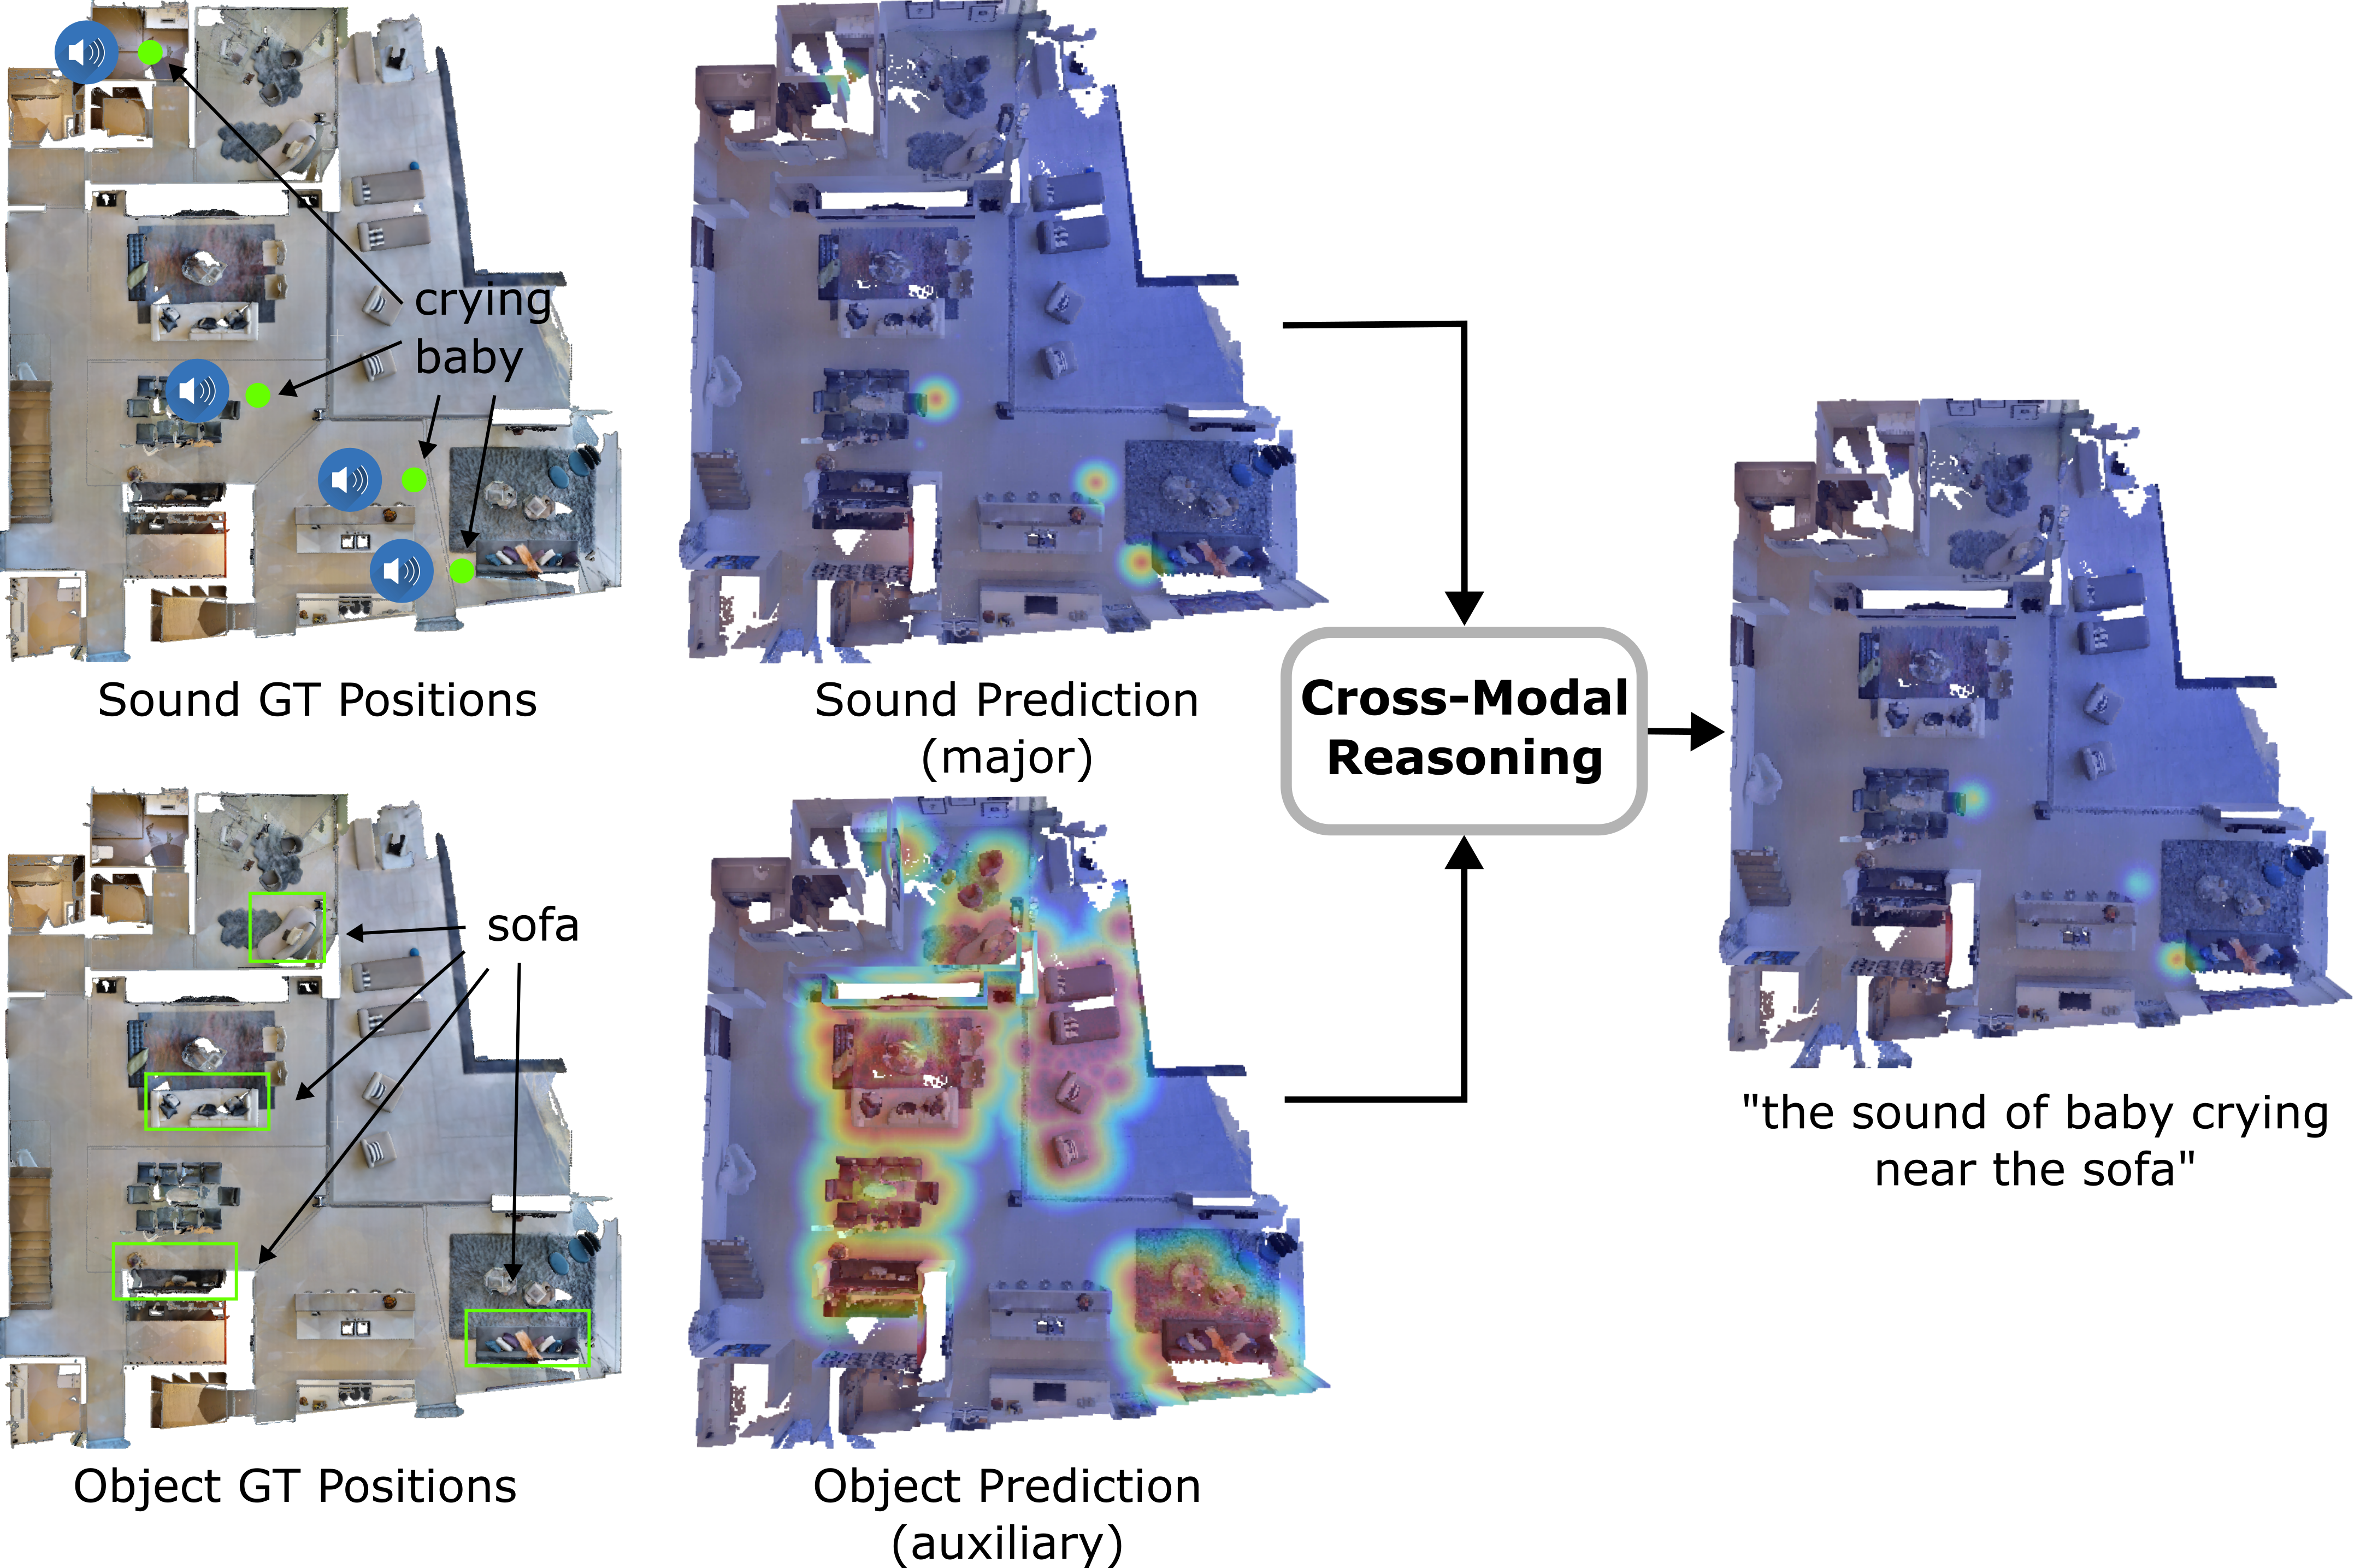
Multimodal Spatial Language Maps for Robot Navigation and Manipulation
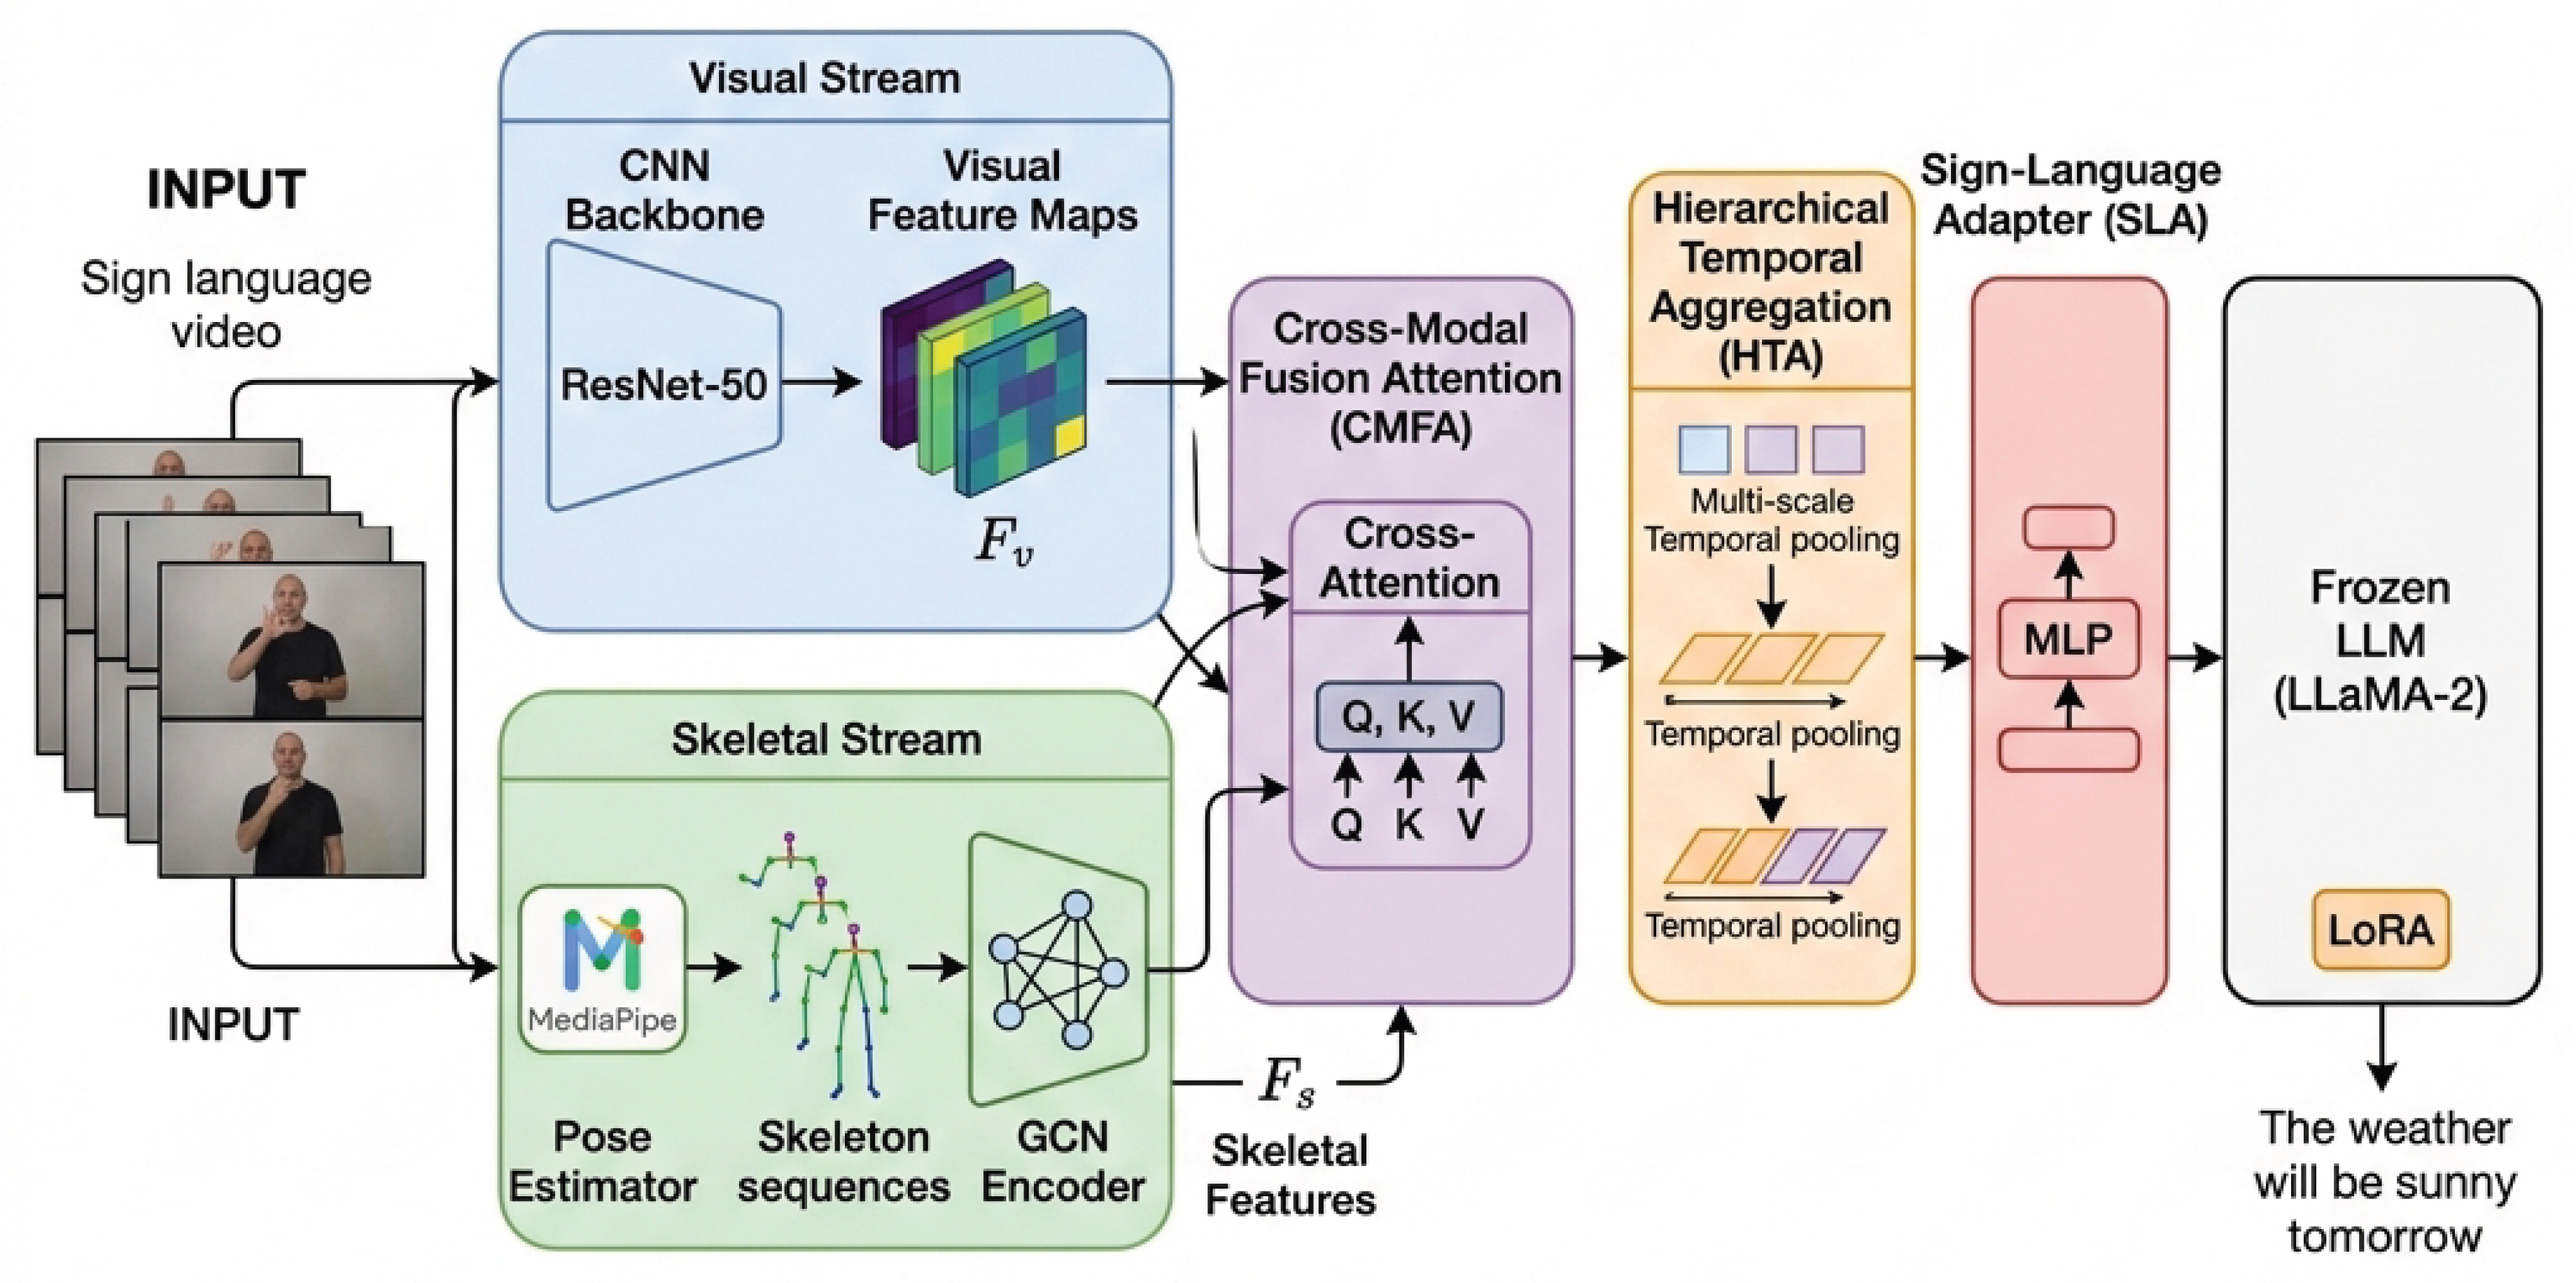
SignFuse: A Proposed Dual-Stream Cross-Modal Framework for Gloss-Free ...

Figure 1 from Vision-and-Language or Vision-for-Language? On Cross ...
Advertisement Space (336x280)

Semantic Modeling Of Textual Relationships In Cross-Modal – NNKJW
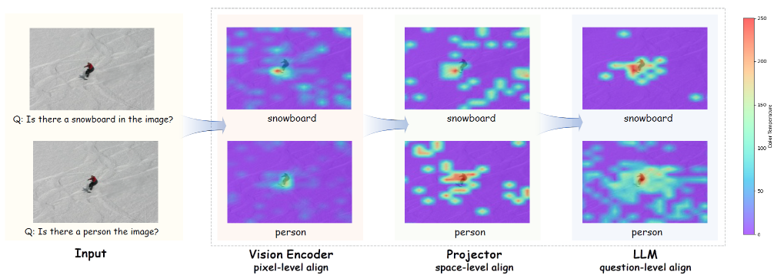
FUSION: Fully Integration of Vision-Language Representations for Deep ...

(PDF) Vision-Dialog Navigation by Exploring Cross-modal Memory
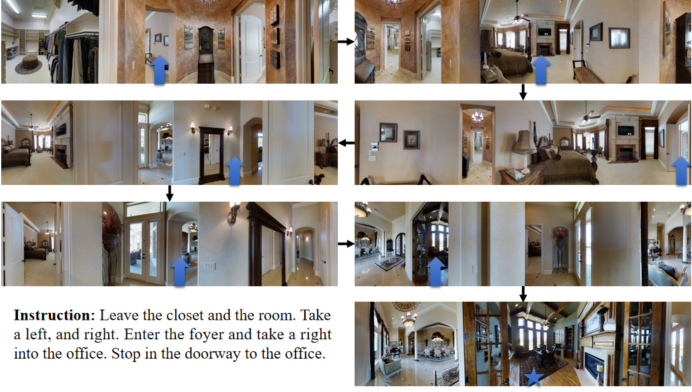
Figure 1 from Vision-and-Language Navigation Based on Cross-Modal ...

Vision-Dialog Navigation by Exploring Cross-Modal Memory

Illustration of the key point to the success of cross-modal image-text ...