
Exploring Extreme Quantization In Spiking Language Models

Exploring Extreme Quantization in Spiking Language Models | AI Research ...

Exploring Extreme Quantization in Spiking Language Models

Exploring Extreme Quantization in Spiking Language Models
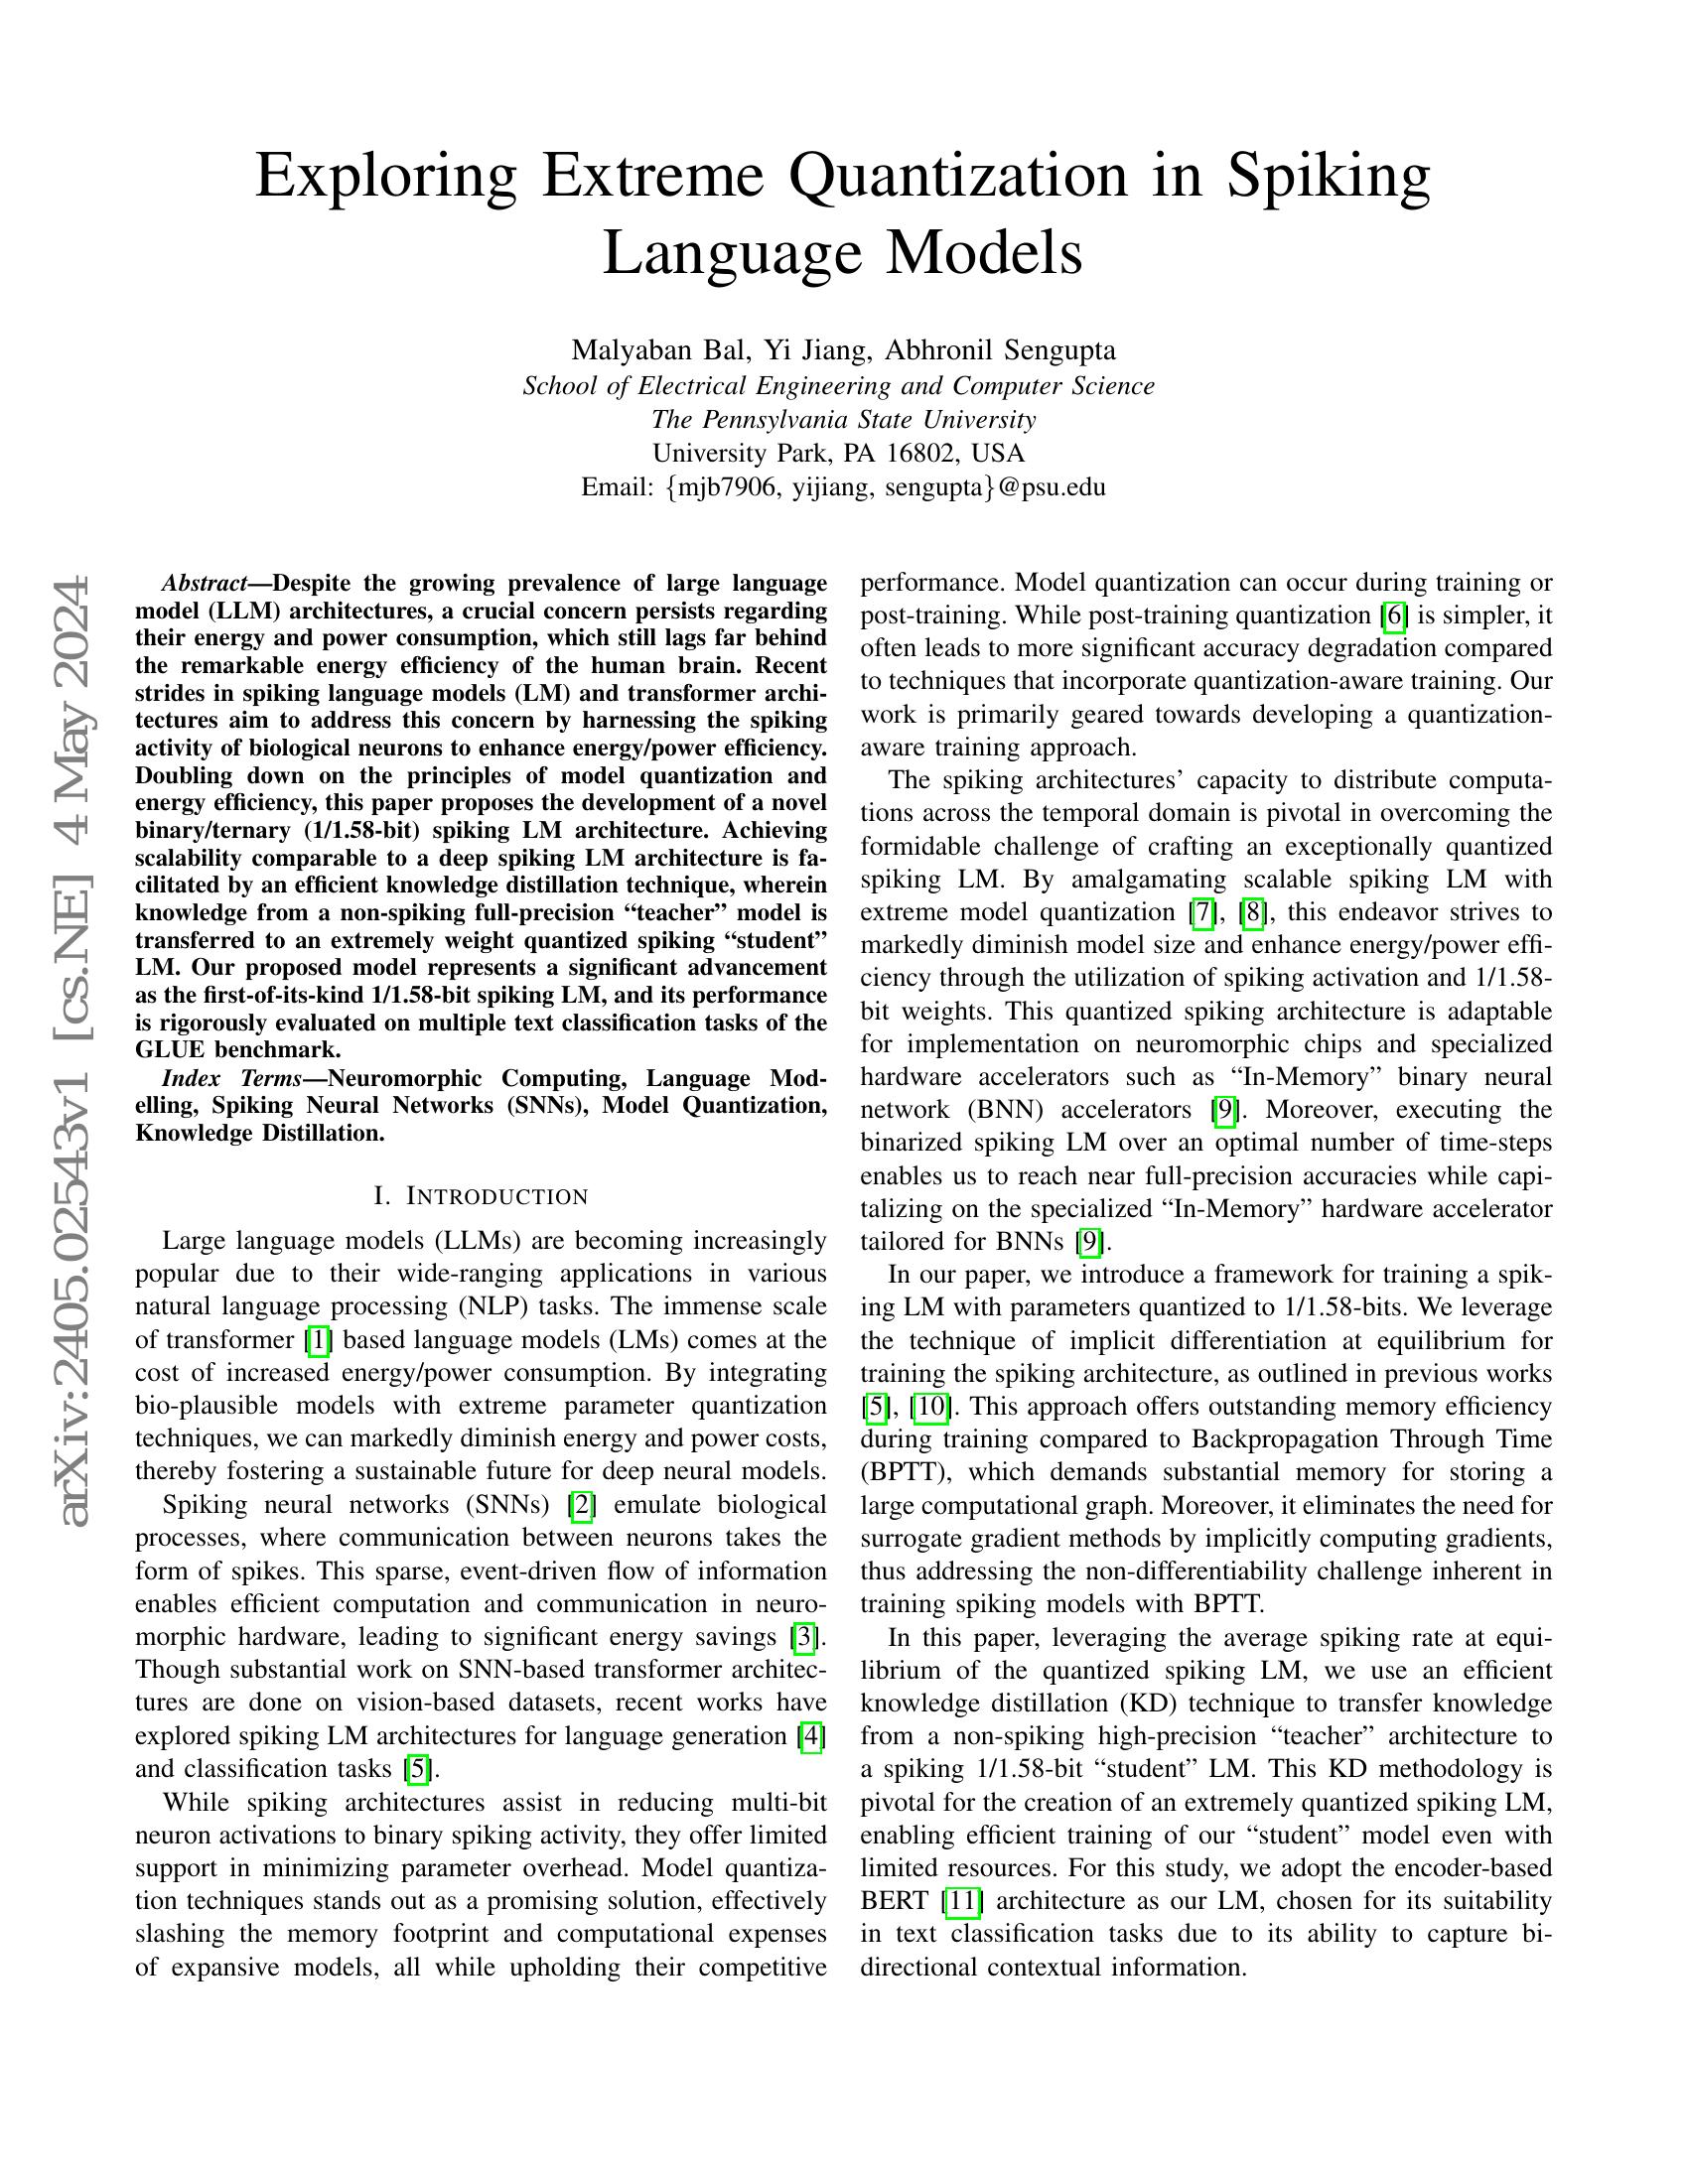
Exploring Extreme Quantization in Spiking Language Models - 智源社区论文

Exploring Extreme Quantization in Spiking Language Models

Exploring Quantization Techniques for Large-Scale Language Models ...

Extreme Compression of Large Language Models via Additive Quantization ...
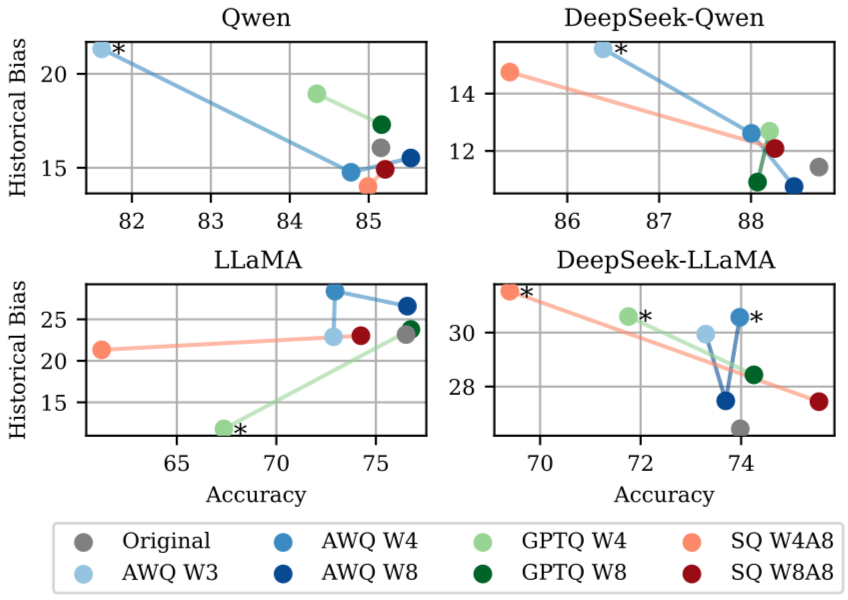
[論文レビュー] How Quantization Shapes Bias in Large Language Models

Exploring Quantization Techniques for Large-Scale Language Models ...

[논문 리뷰] Scaling Laws for Mixed quantization in Large Language Models
Advertisement Space (300x250)
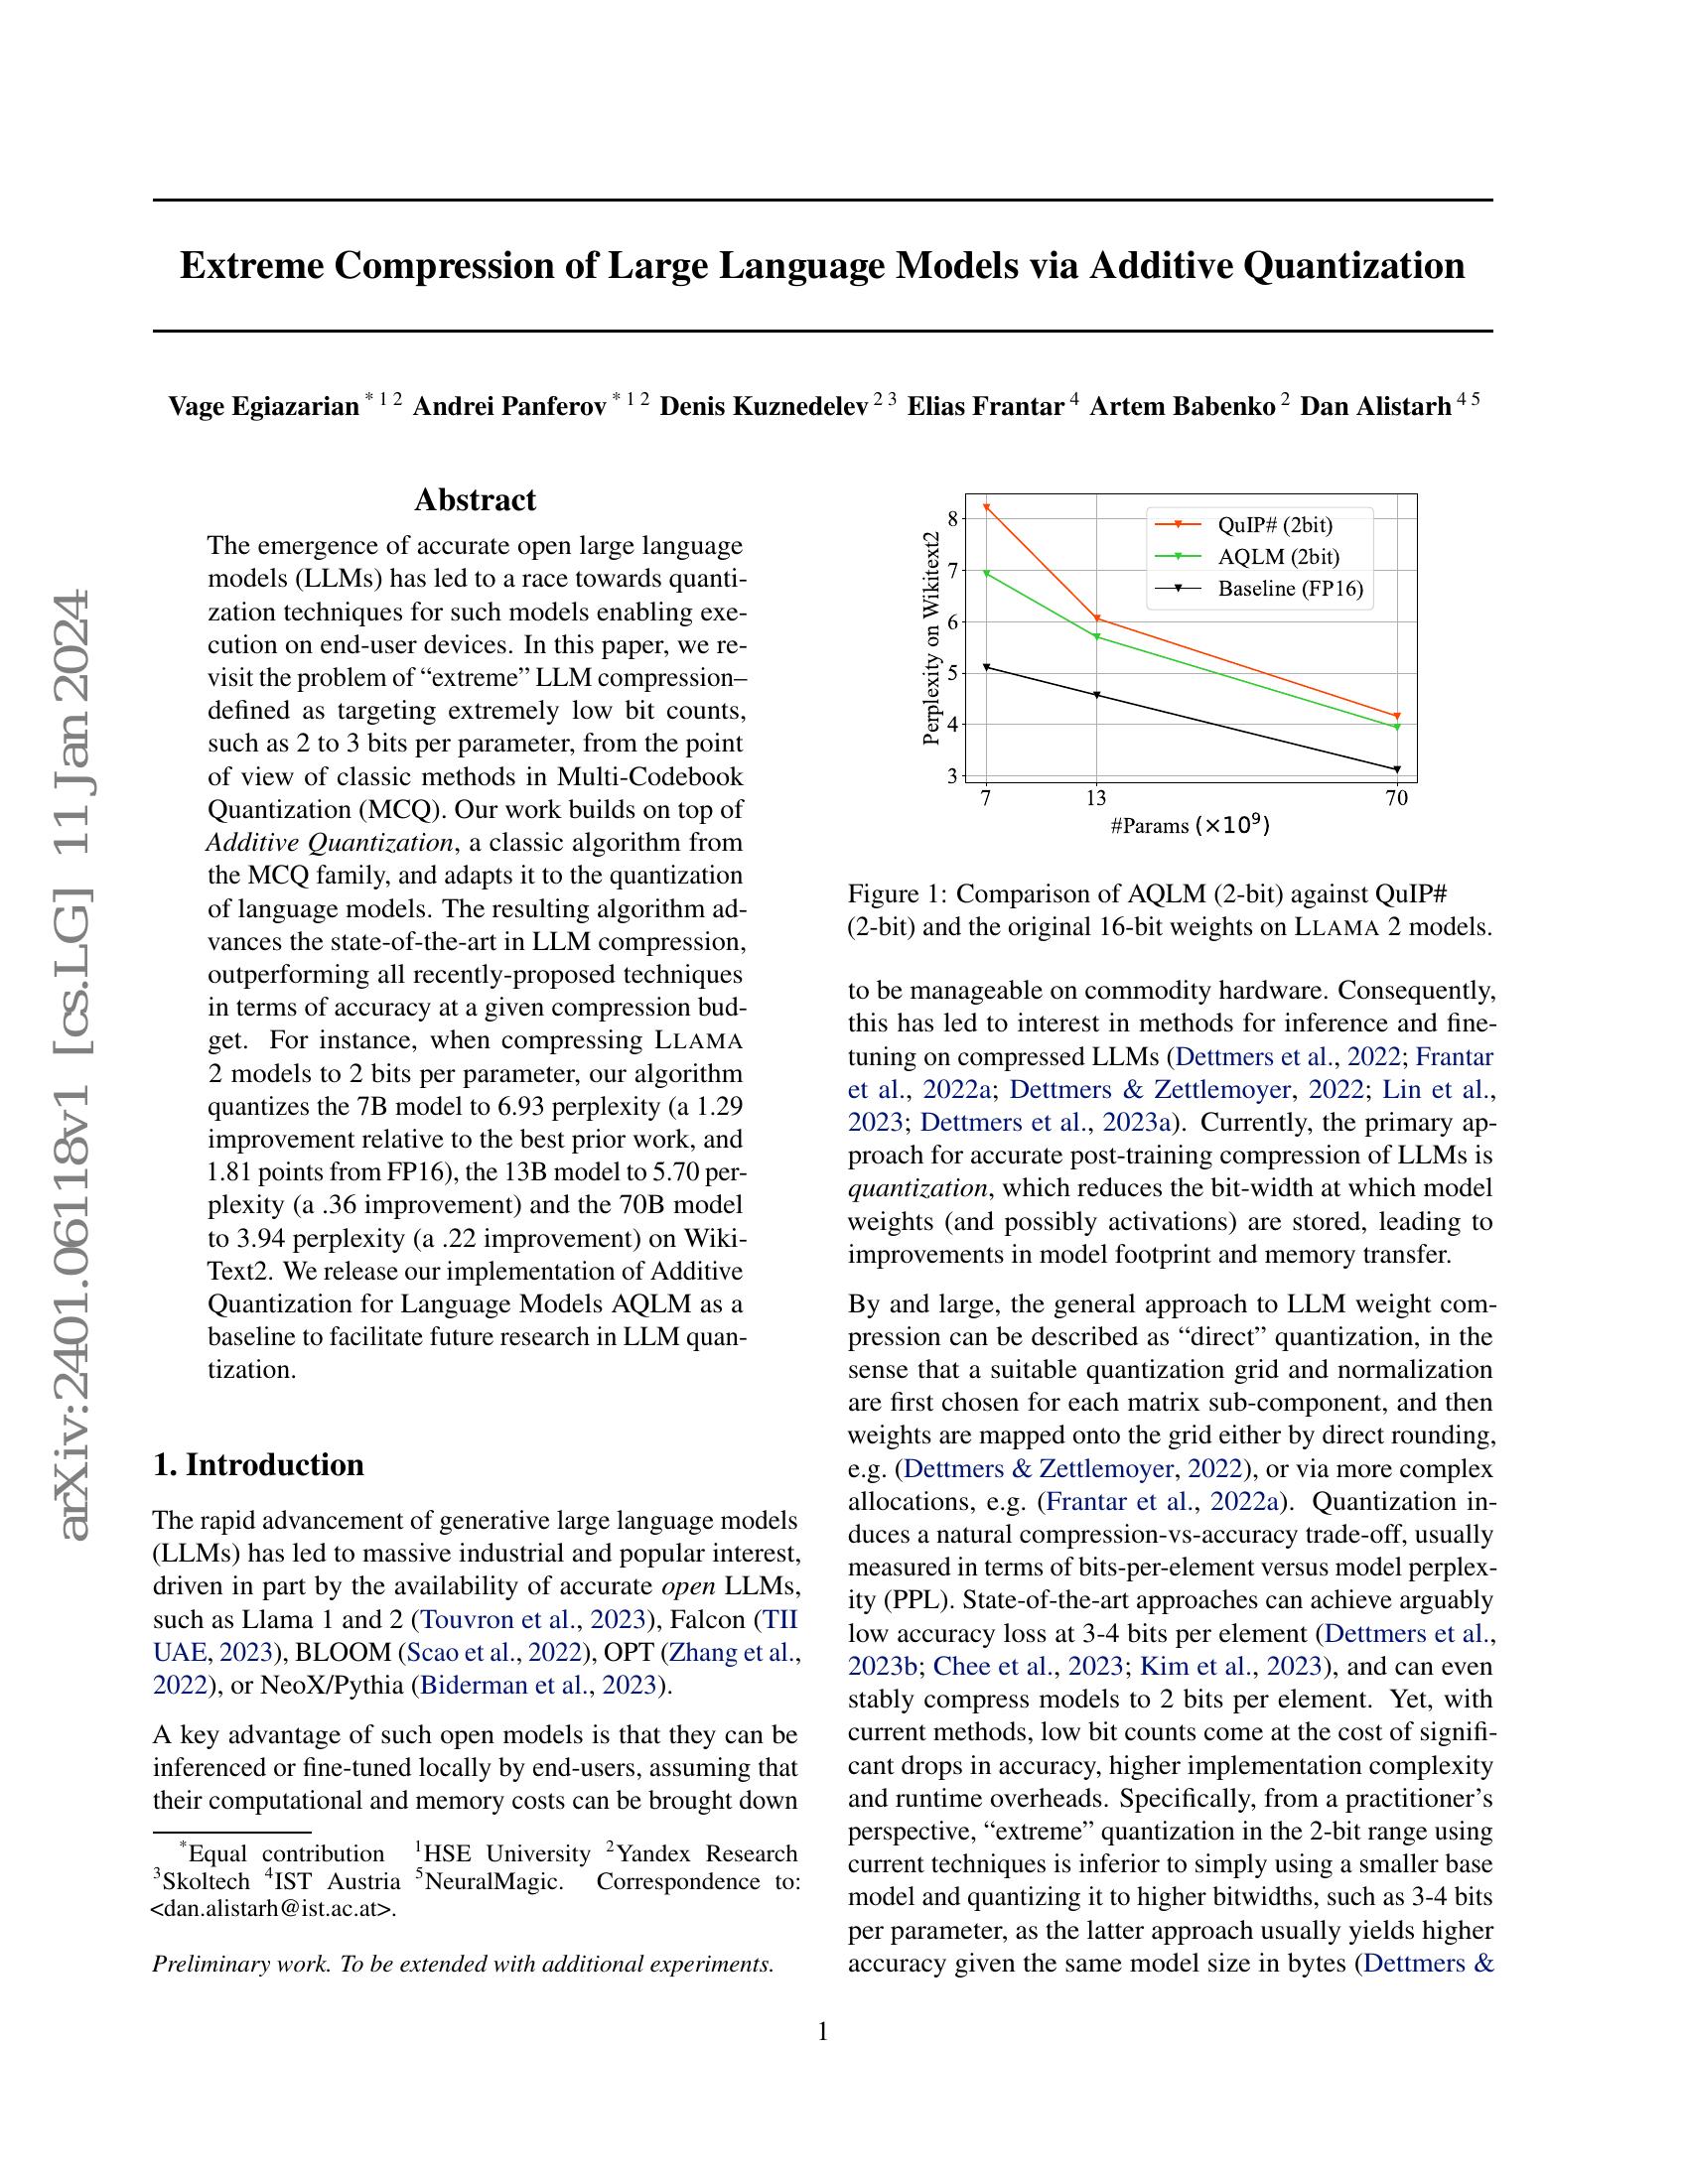
Extreme Compression of Large Language Models via Additive Quantization ...

Understanding Quantization in Large Language Models | Bavalpreet Singh

SpikeLLM: Scaling up Spiking Neural Network to Large Language Models ...
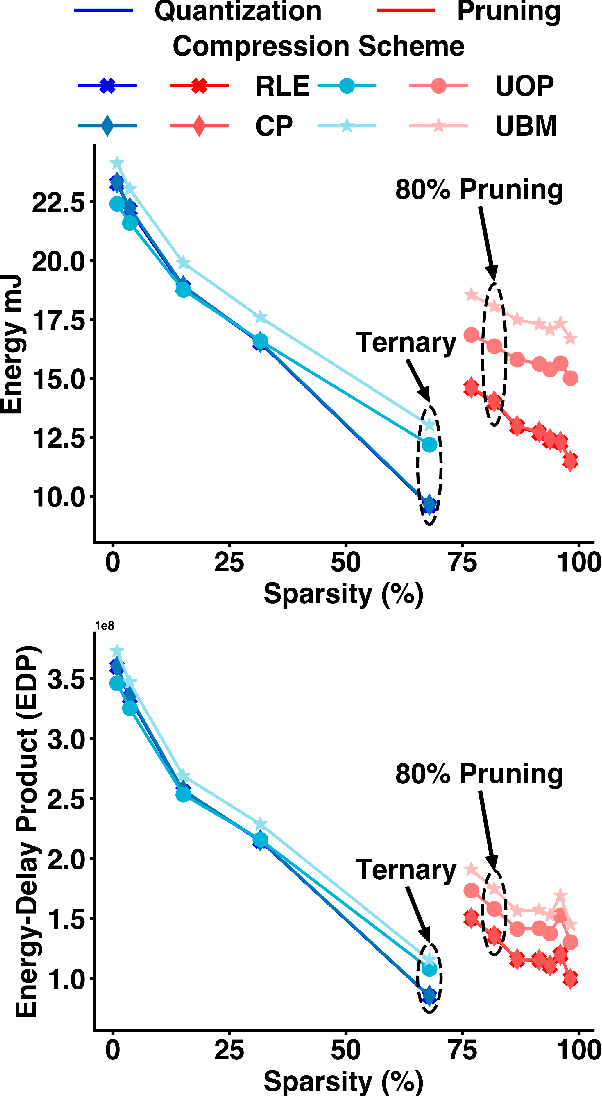
The Hardware Impact of Quantization and Pruning for Weights in Spiking ...

PB-LLM: a cutting-edge technique for extreme low-bit quantization in ...

Paper page - Extreme Compression of Large Language Models via Additive ...
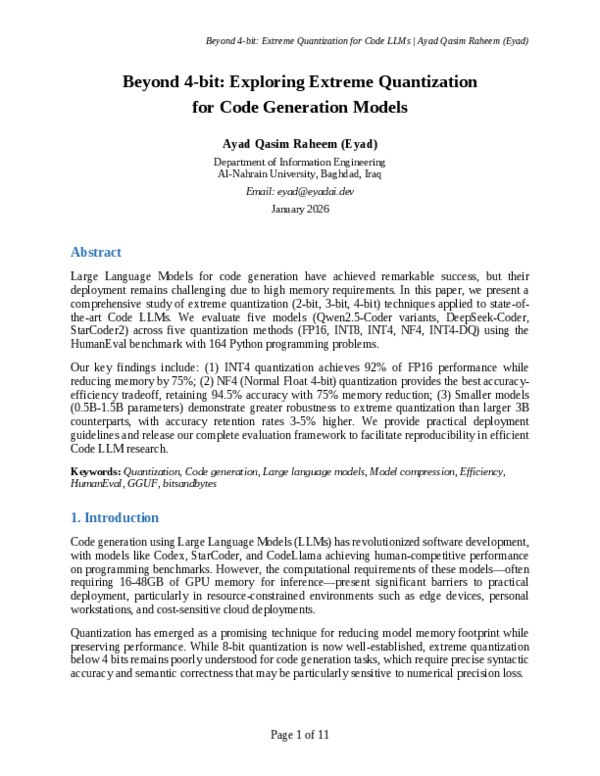
(PDF) Beyond 4-bit: Exploring Extreme Quantization for Code Generation ...

(PDF) FBQuant: FeedBack Quantization for Large Language Models
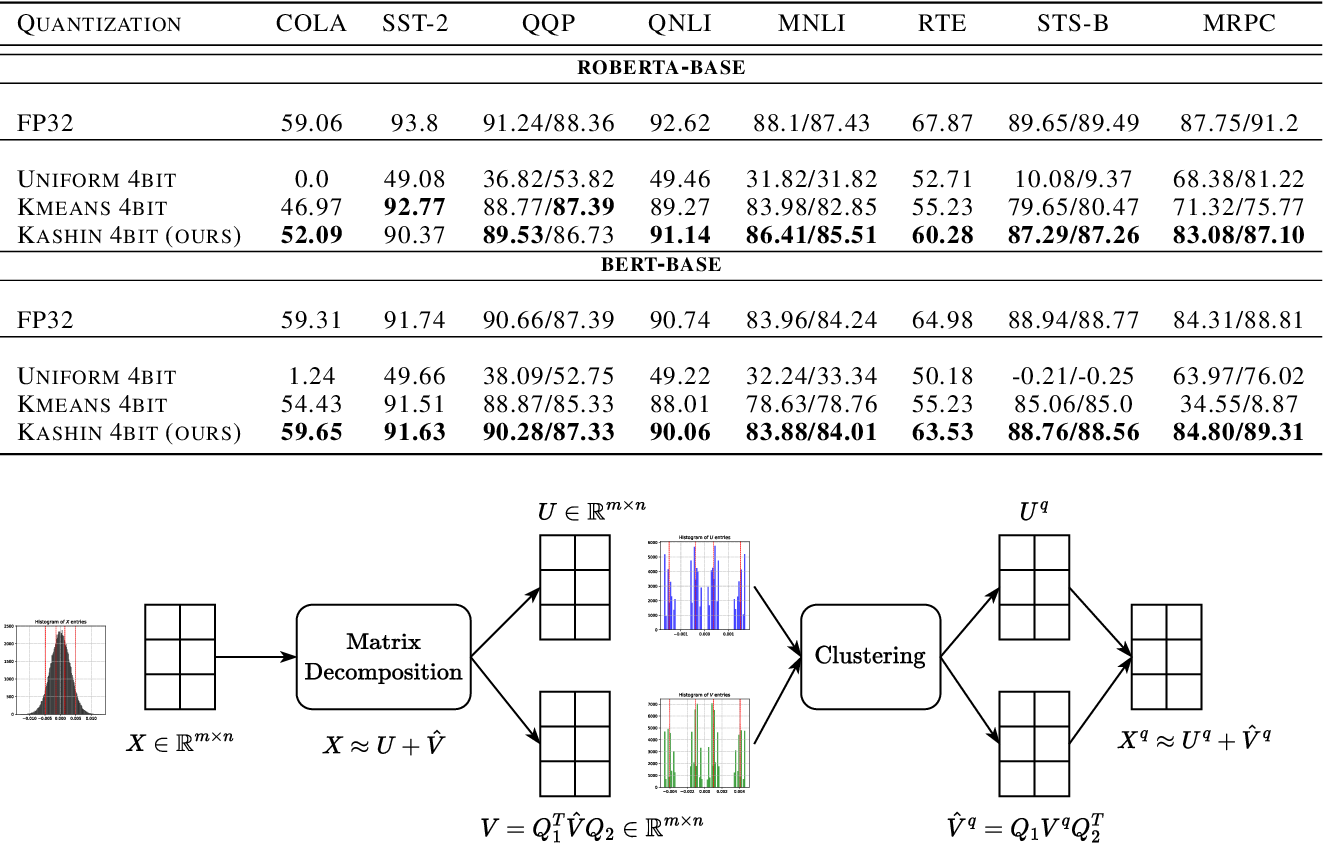
Figure 8 from Quantization of Large Language Models with an ...

(PDF) Quantization in Spiking Neural Networks
Advertisement Space (336x280)

Quantisation in speech and language models - EthicAI
Microscaling Quantization for Large Language Models — AI Post Transformers

Enhancing Ultra-Low-Bit Quantization of Large Language Models Through ...
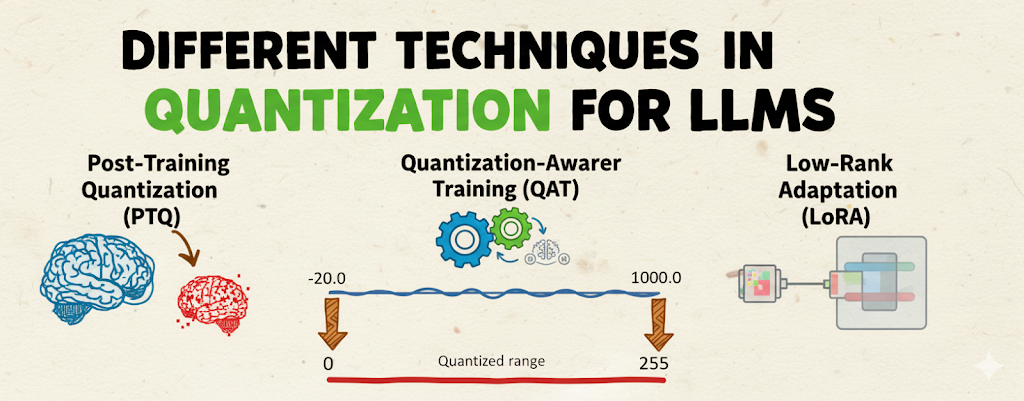
Deep Drive in Quantization Techniques for a Language Model (Part-1 ...

Quantization in Large Language Models(LLMs)
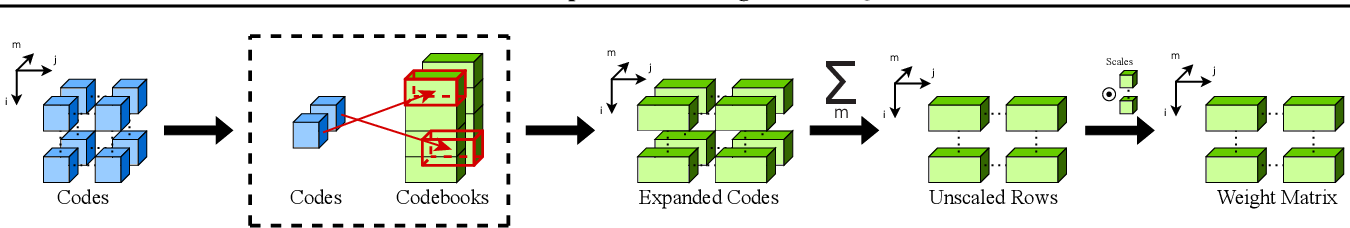
Figure 3 from Extreme Compression of Large Language Models via Additive ...

Large Language Models Inference Engines based on Spiking Neural ...
Quantization Principles for Large Language Models

Outlier Suppression+: Accurate quantization of large language models by ...

Paper page - QuIP: 2-Bit Quantization of Large Language Models With ...
Advertisement Space (336x280)
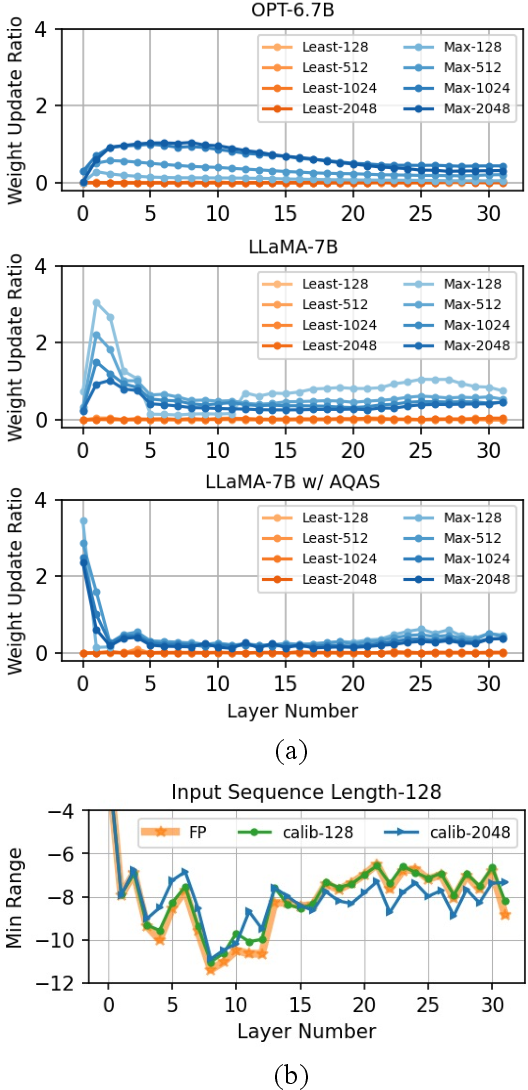
Figure 3 from Enhancing Computation Efficiency in Large Language Models ...

Enable 3.5 times faster vision language models with quantization | Red ...
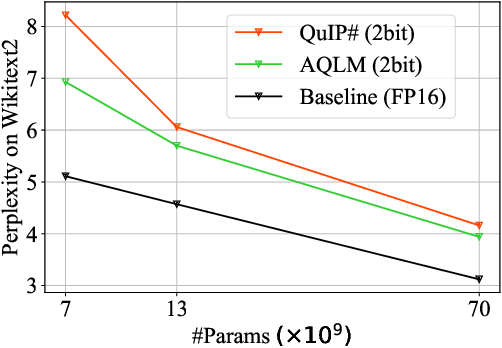
Figure 1 from Extreme Compression of Large Language Models via Additive ...
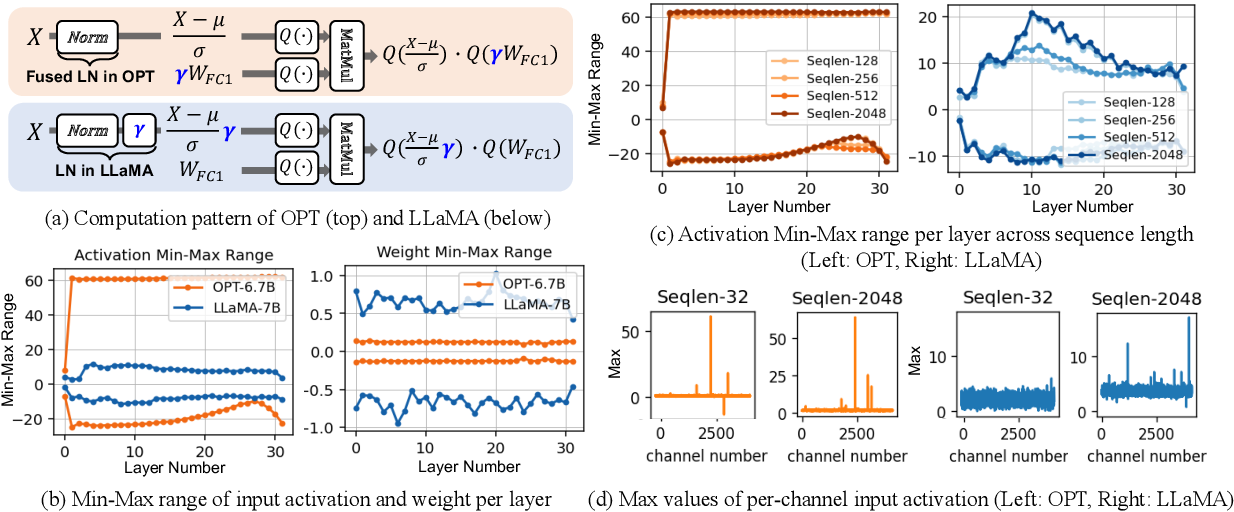
Figure 1 from Enhancing Computation Efficiency in Large Language Models ...
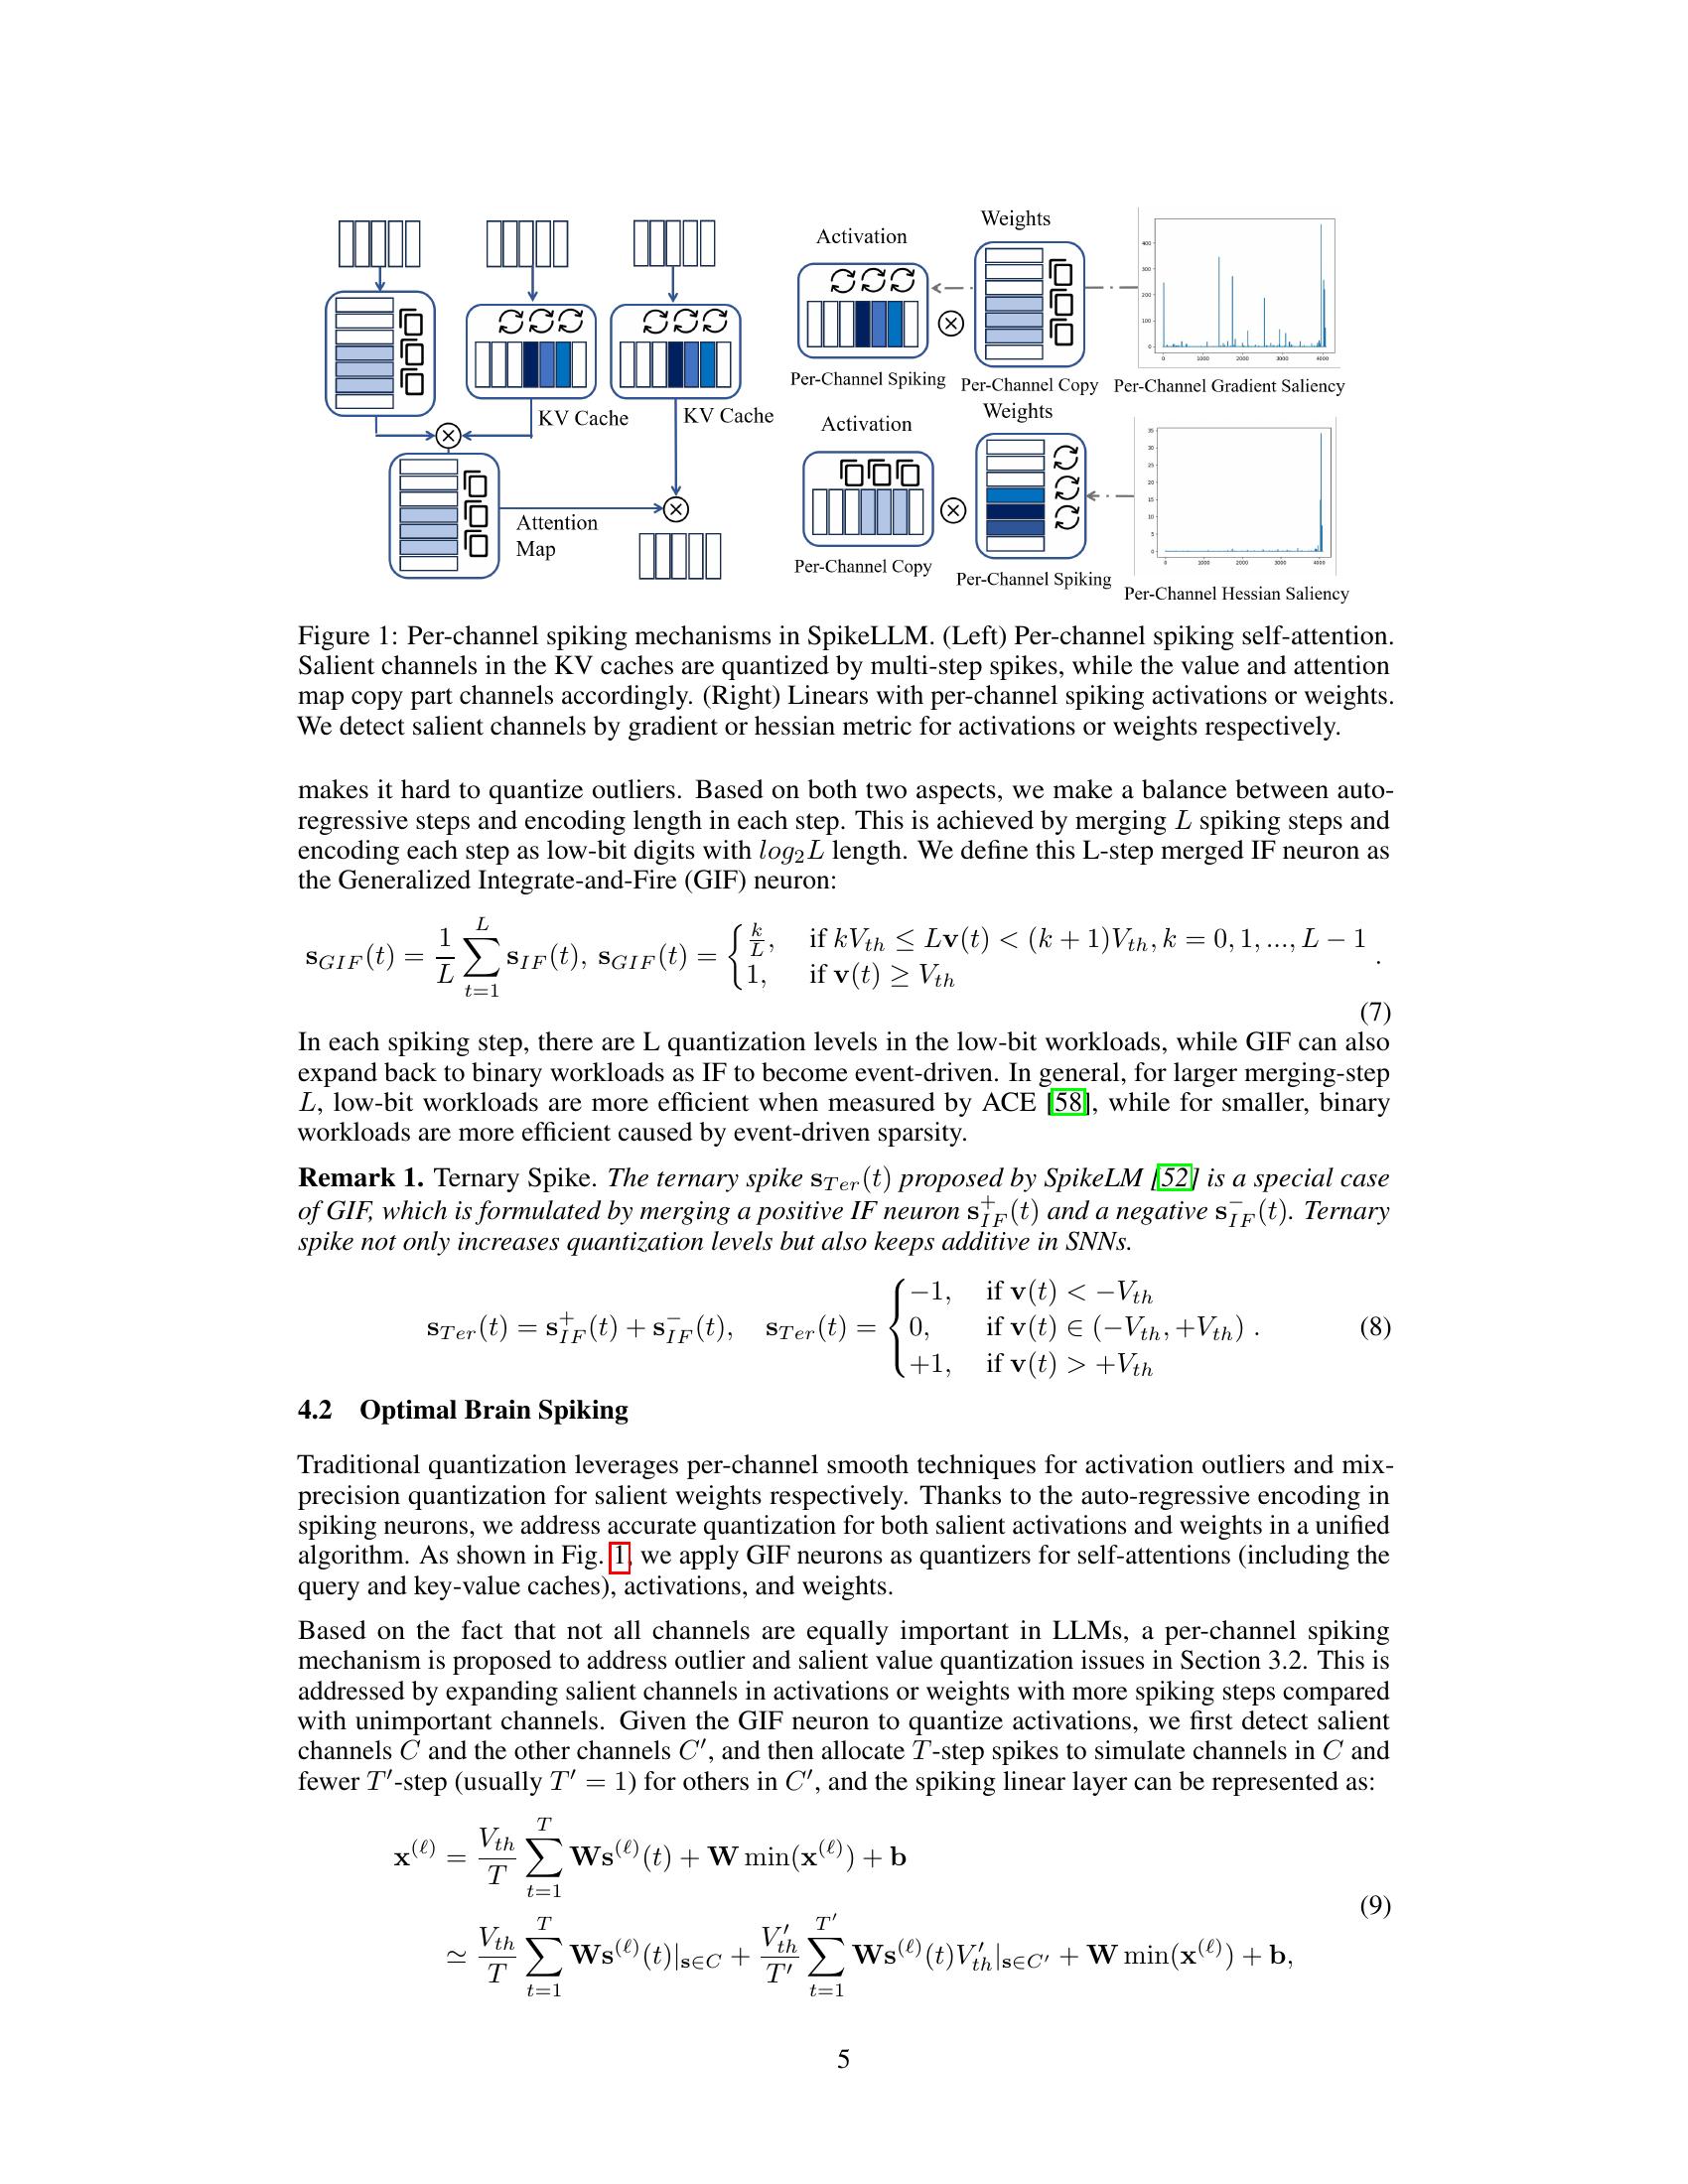
SpikeLLM: Scaling up Spiking Neural Network to Large Language Models ...
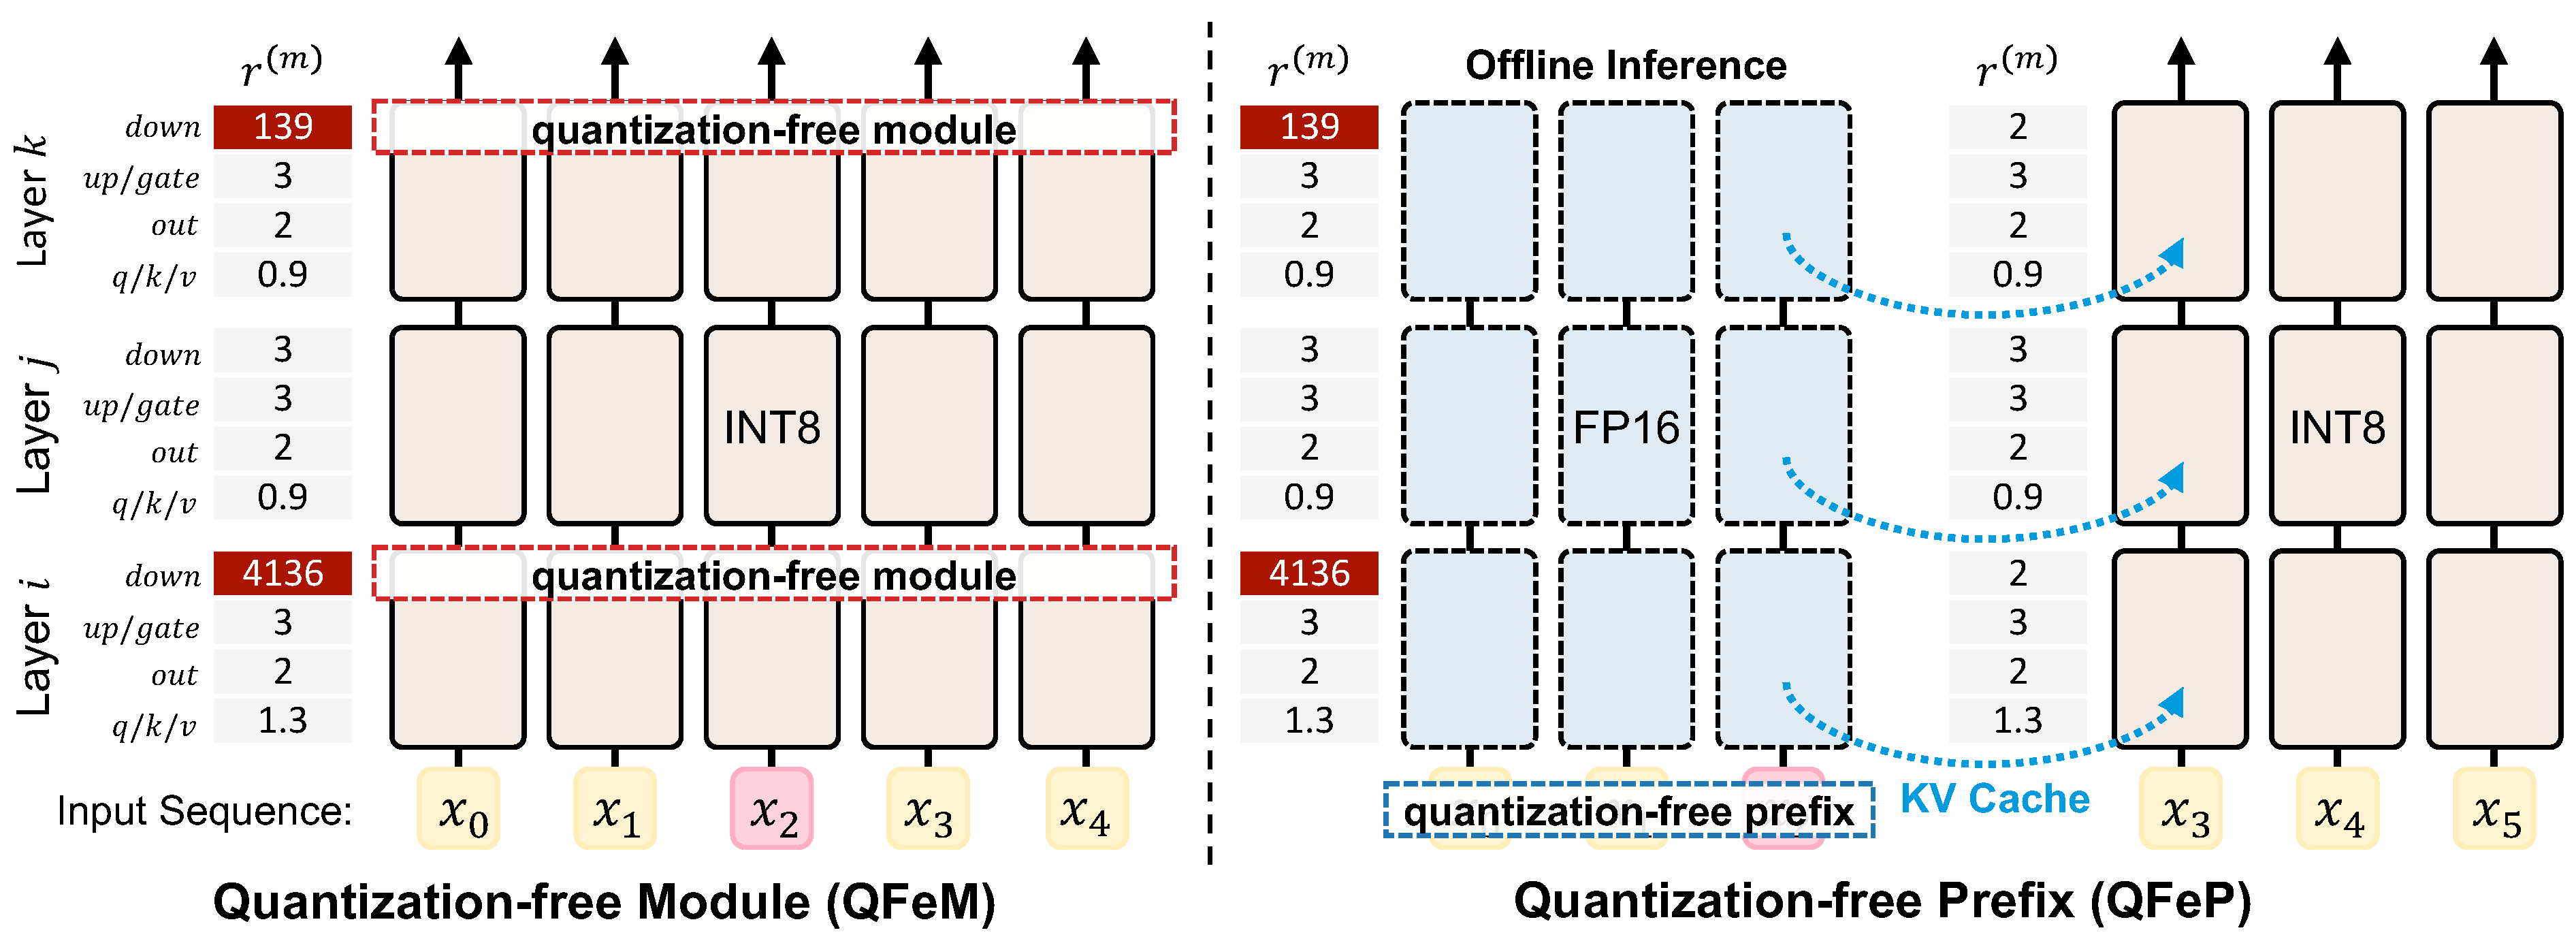
Mitigating Quantization Errors Due to Activation Spikes in Gated Linear ...