
Figure 1 From A Dual Alignment Scheme For Improved Speech To Singing
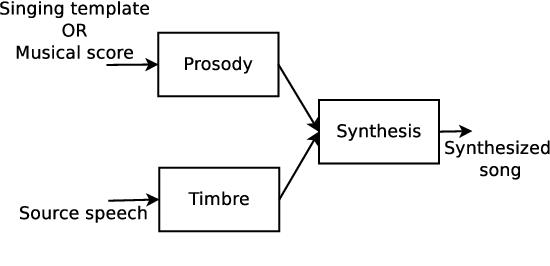
Figure 1 from A dual alignment scheme for improved speech-to-singing ...
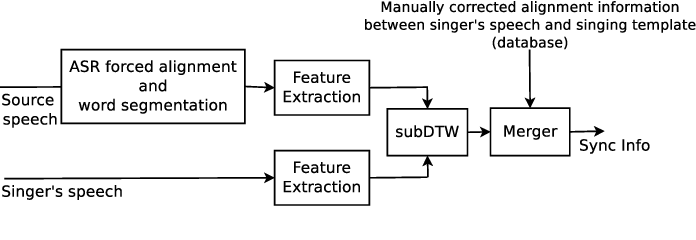
Figure 1 from A dual alignment scheme for improved speech-to-singing ...
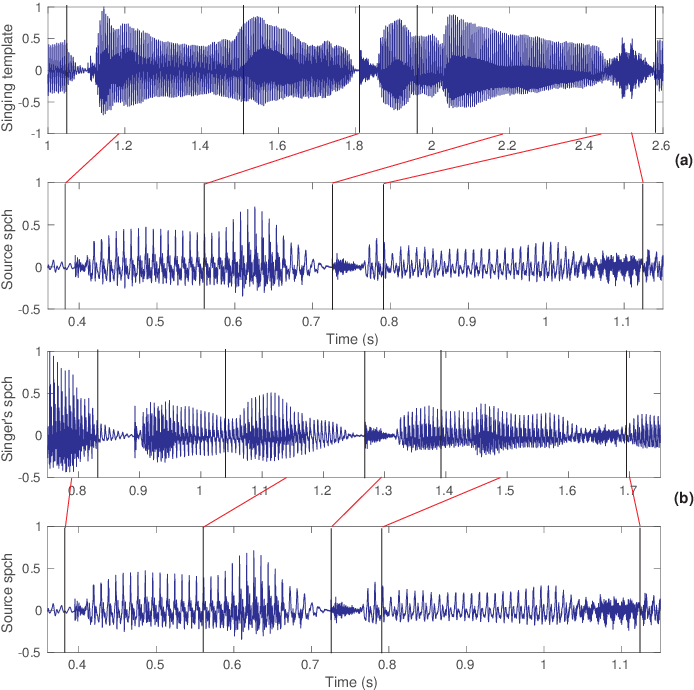
Figure 1 from A dual alignment scheme for improved speech-to-singing ...
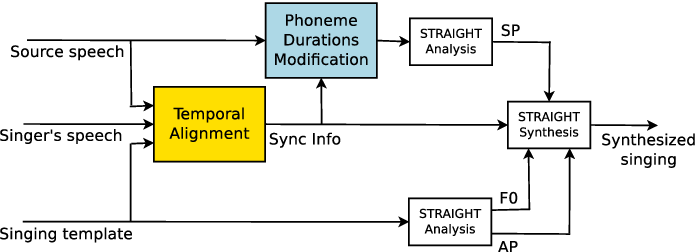
Figure 3 from A dual alignment scheme for improved speech-to-singing ...
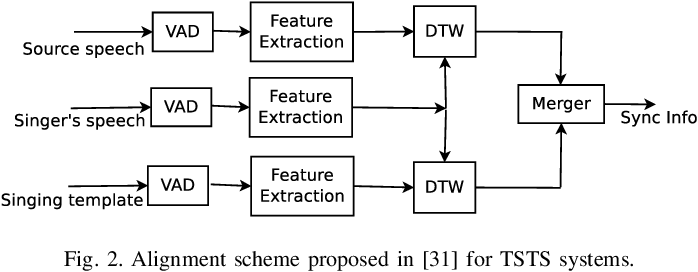
Figure 2 from A dual alignment scheme for improved speech-to-singing ...
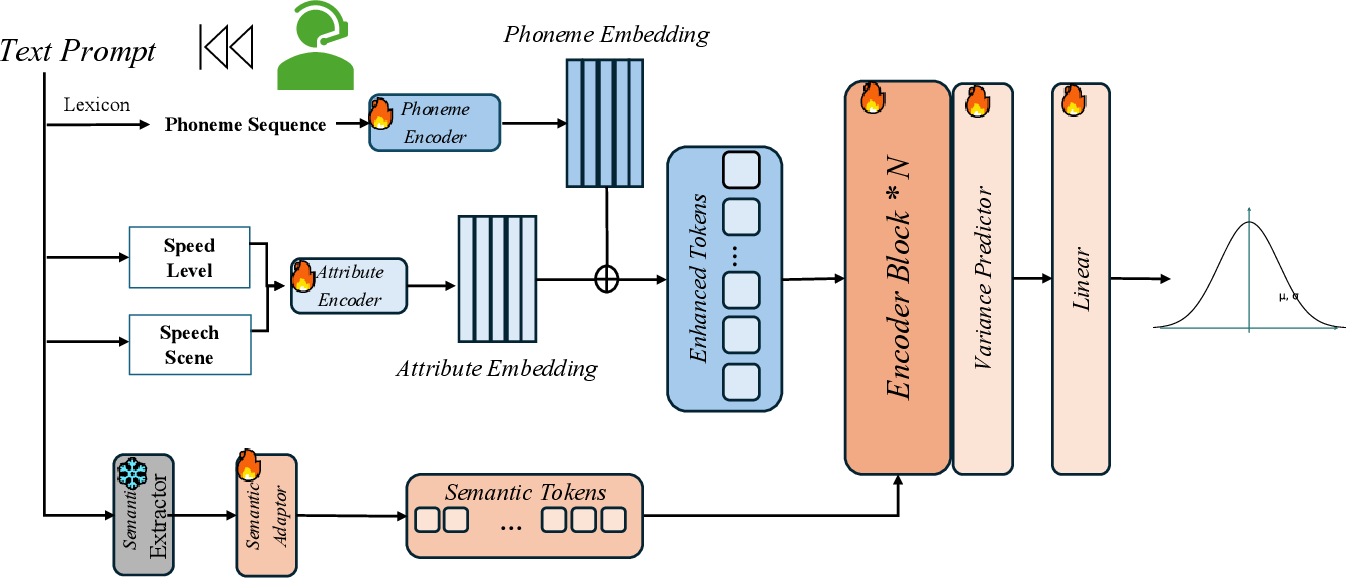
Figure 1 from Adaptive Duration Model for Text Speech Alignment ...
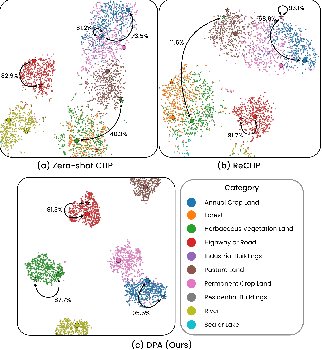
Figure 1 from DPA: Dual Prototypes Alignment for Unsupervised ...

Figure 1 from Dual Adversarial Alignment for Realistic Support-Query ...

Figure 1 from Dual Adaptive Representation Alignment for Cross-Domain ...

Figure 1 from Cross-Modal Cross-Domain Dual Alignment Network for RGB ...
Advertisement Space (300x250)

Figure 1 from Reference-Based Speech Enhancement via Feature Alignment ...

Figure 1 from Aligning Speech to Languages to Enhance Code-Switching ...

Figure 1 from An emotion speech sequence alignment algorithm based on ...

Figure 1 from Cross-Modal Global Interaction and Local Alignment for ...

TADA — Text-Acoustic Dual Alignment for Speech - a Hugging Face Space ...

Figure 1 from Streaming Audio-Visual Speech Recognition with Alignment ...
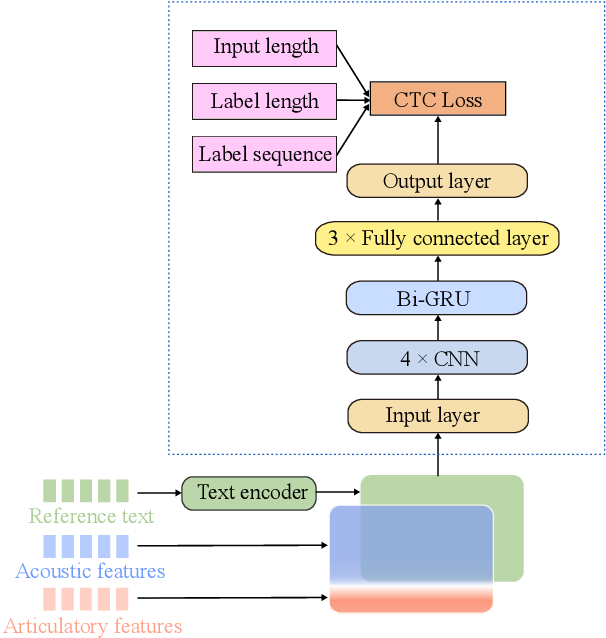
Figure 1 from An Alignment Method Leveraging Articulatory Features for ...
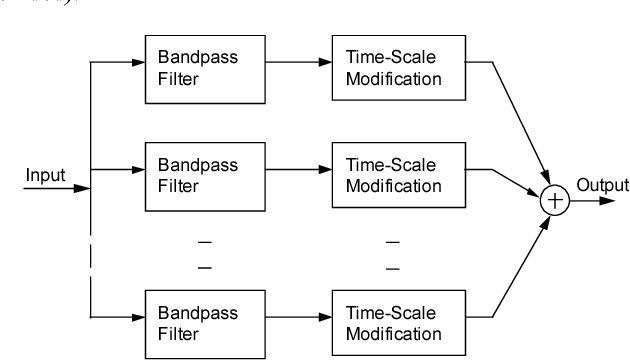
Figure 1 from High Auality Time-scale Modification of Speech using a ...
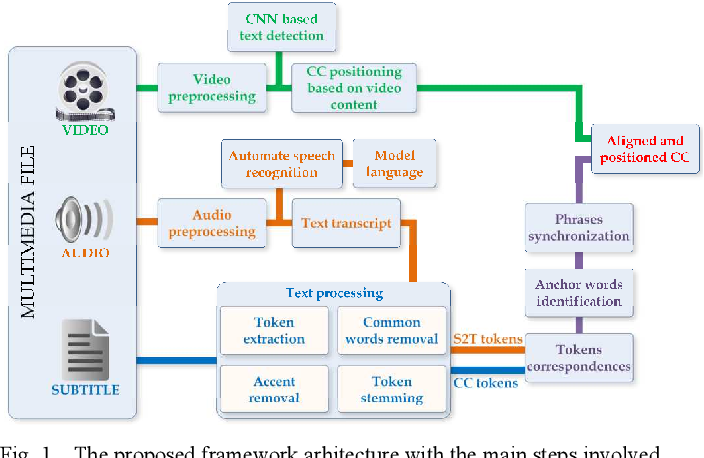
Figure 1 from Automatic Alignment of Human Generated Transcripts to ...
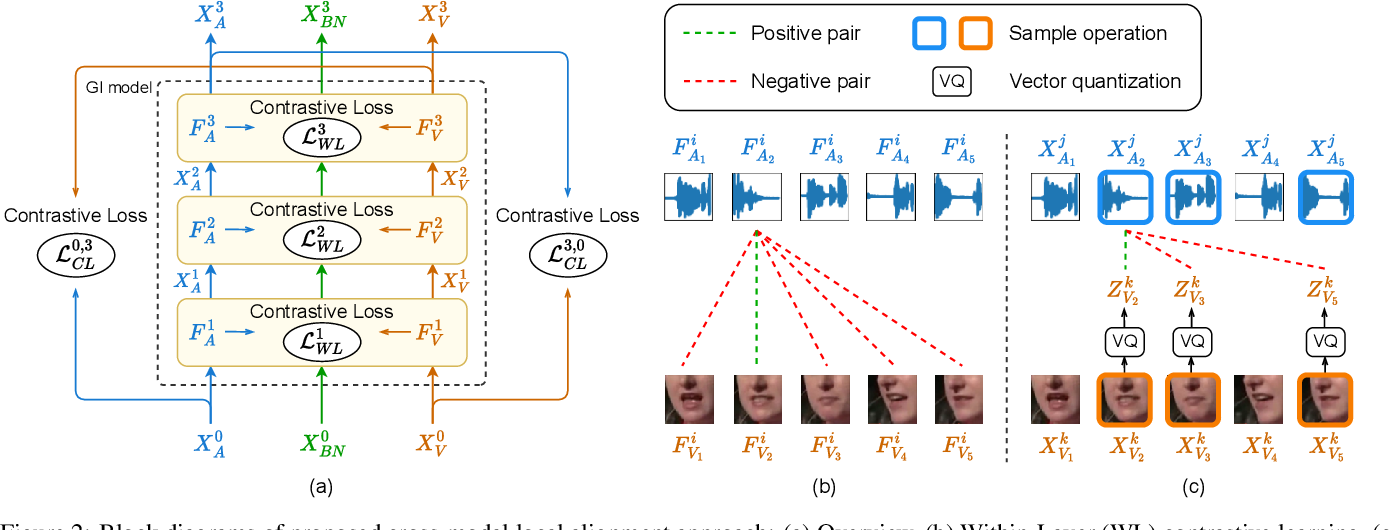
Figure 1 from Cross-Modal Global Interaction and Local Alignment for ...
Advertisement Space (336x280)

Figure 1 from Multi-Source Discriminant Subspace Alignment for Cross ...

Figure 1 from End-to-end speech recognition with Alignment RNN ...
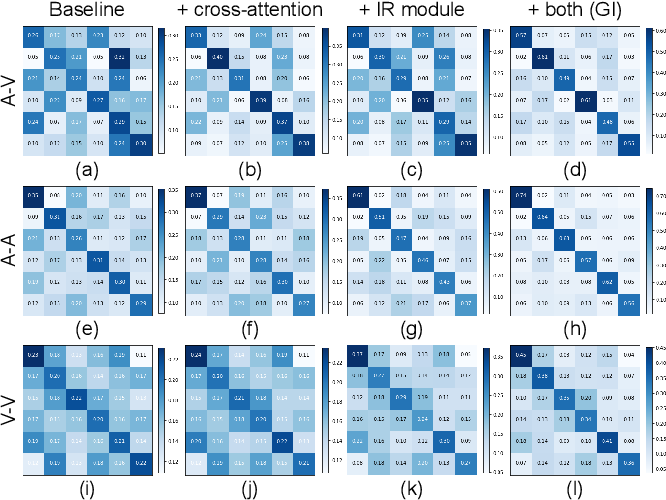
Figure 1 from Cross-Modal Global Interaction and Local Alignment for ...
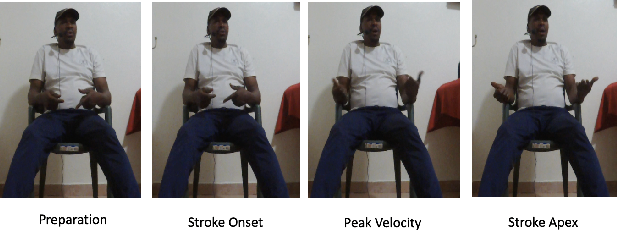
Figure 1 from The Influence of Tone on the Alignment of Speech and Co ...

Figure 1 from DANCE: Dual-View Distribution Alignment for Dataset ...

TADA — Text-Acoustic Dual Alignment for Speech - a Hugging Face Space ...

Figure 1 from A Combination of Model-Based and Feature-Based Strategy ...
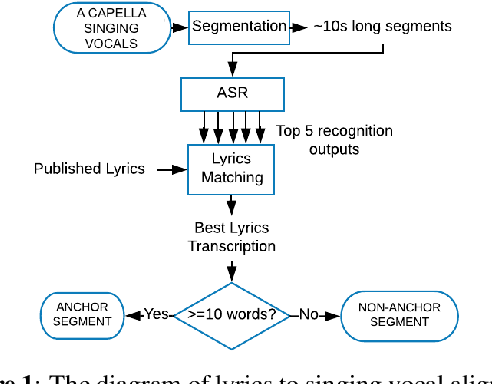
Figure 1 from Semi-supervised Lyrics and Solo-singing Alignment ...

Figure 1 from LYRICS-TO-AUDIO ALIGNMENT USING SINGING-ADAPTED ACOUSTIC ...

Figure 1 from Text-to-Speech With Lip Synchronization Based on Speech ...
Advertisement Space (336x280)

TADA: A Generative Framework for Speech Modeling via Text-Acoustic Dual ...

TADA: A Generative Framework for Speech Modeling via Text-Acoustic Dual ...

Figure 1 from Coarse-to-fine Alignment Makes Better Speech-image ...

Figure 1 from Dual-Stage Low-Complexity Reconfigurable Speech ...
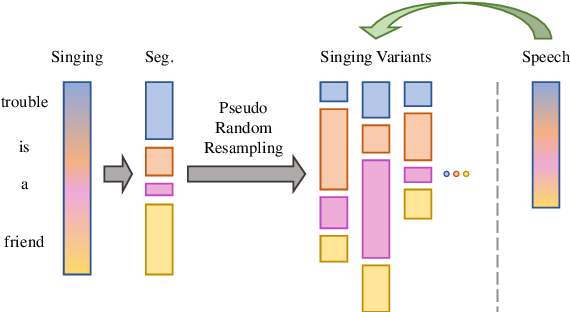
Figure 2 from Self-Supervised Singing Voice Pre-Training towards Speech ...

Figure 1 from GDA: Geometry-Guided Dual-Alignment Learning for RGB ...