
Figure 1 From A Multimodal Framework For Video Caption Generation

Figure 1 from A Multimodal Framework for Video Caption Generation ...

Figure 1 from A Multimodal Framework for Video Caption Generation ...

Figure 1 from A Multimodal Framework for Video Caption Generation ...

Figure 1 from A Multimodal Framework for Video Caption Generation ...

Figure 1 from A Multimodal Framework for Video Caption Generation ...

Figure 1 from A Multimodal Framework for Video Caption Generation ...

Figure 1 from A Multimodal Framework for Video Ads Understanding ...
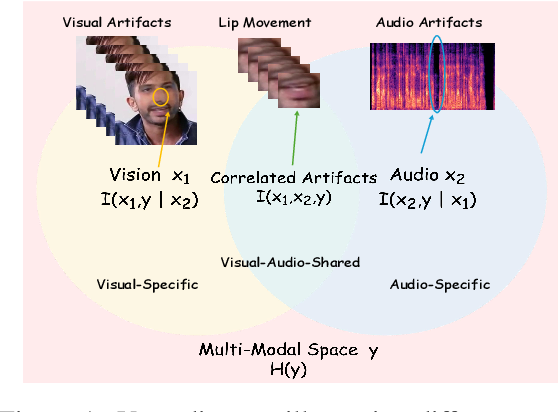
Figure 1 from CAD: A General Multimodal Framework for Video Deepfake ...

Table 5 from A Multimodal Framework for Video Caption Generation ...

(PDF) A Multimodal Framework For Video Caption Generation
Advertisement Space (300x250)

Figure 1 from A Vision Enhanced Framework for Indonesian Multimodal ...
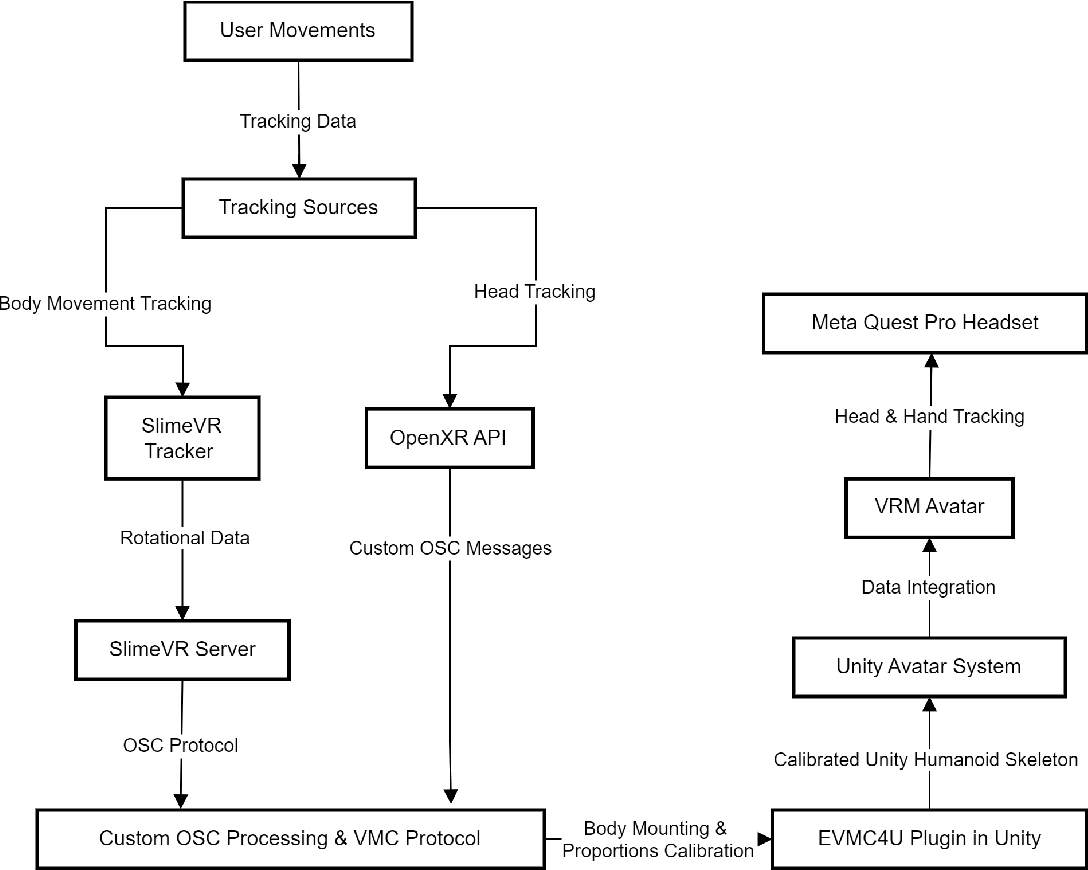
Figure 1 from A Multimodal Framework for Integrating Motion Capture ...
(PDF) A Multimodal Framework for Video Caption Generation

Figure 1 from GuideCAD: A Lightweight Multimodal Framework for 3D CAD ...

Figure 1 from Automated Image Caption Generation Framework using ...
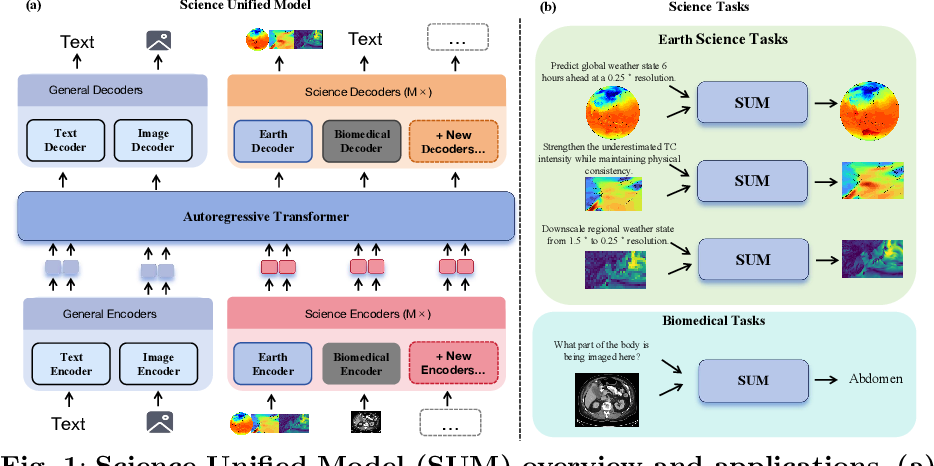
Figure 1 from A unified multimodal understanding and generation model ...
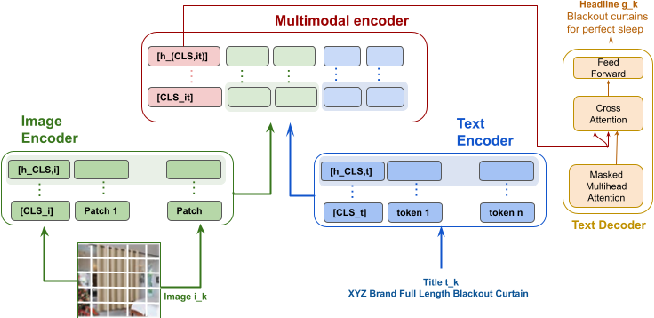
Figure 1 from Contrastive Multimodal Text Generation for E-Commerce ...

Figure 1 from Automated Image Caption Generation Framework using ...

Figure 1 from A Multi-Modal Framework for Fake News Analysis for ...

Figure 1 from A Multitask Learning Encoder-Decoders Framework for ...
Advertisement Space (336x280)
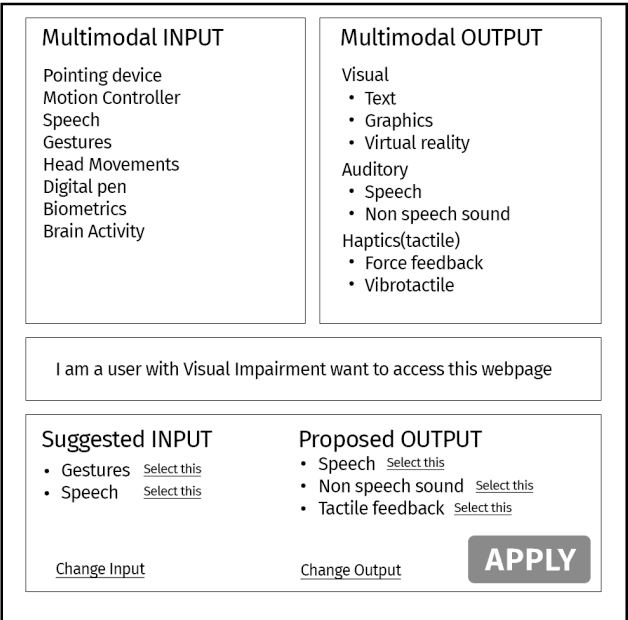
Figure 1 from A Configurable Multimodal Framework | Semantic Scholar
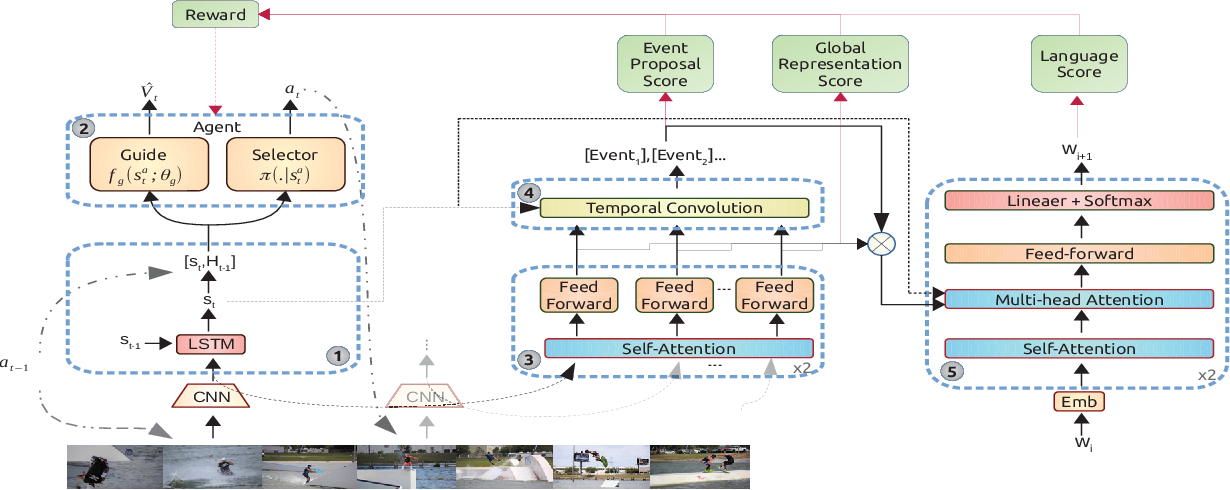
Figure 1 from An Efficient Framework for Dense Video Captioning ...

UniVidX: A Unified Multimodal Framework for Versatile Video Generation ...

Figure 1 from A Graph Learning Based Multi-Modal Video Action ...

Figure 1 from Prototype-Aware Multimodal Alignment for Open-Vocabulary ...

Figure 1 from Exploiting Pseudo Image Captions for Multimodal ...
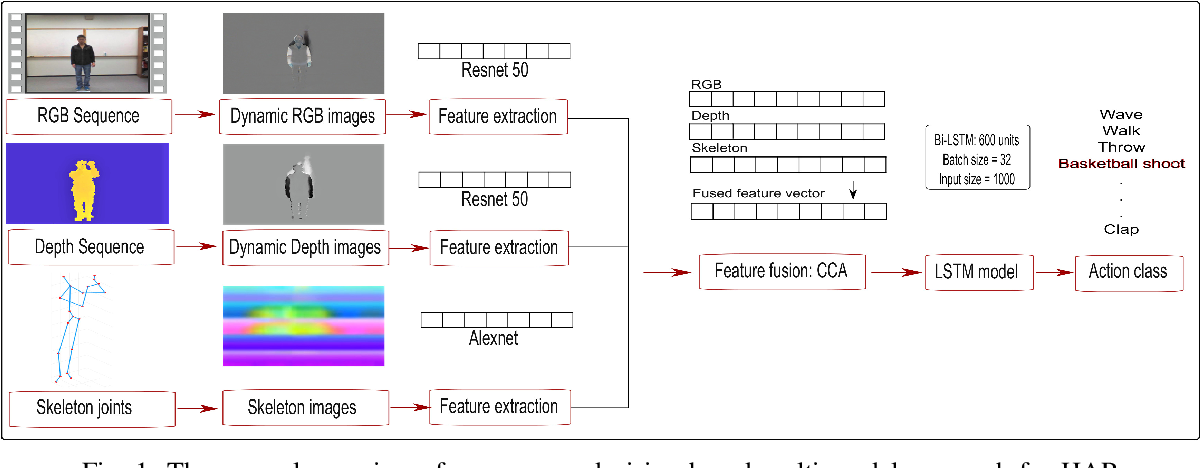
Figure 1 from Vision-Based Multi-Modal Framework for Action Recognition ...

Figure 1 from A Multimodal Interpretable Visual Question Answering ...
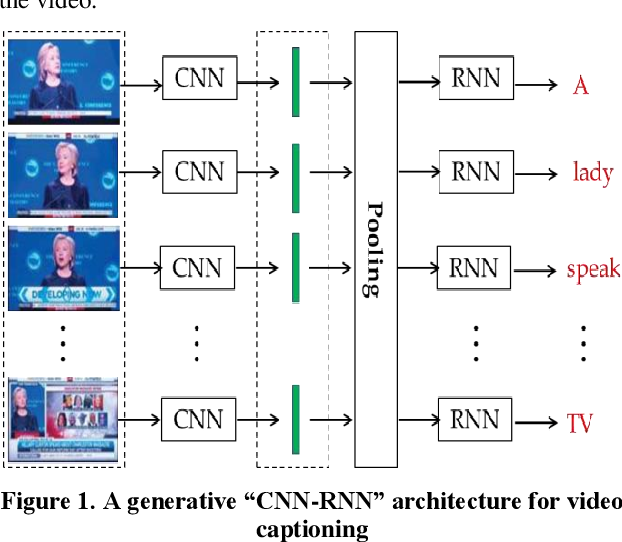
Figure 1 from Multi-Feature Fusion for Video Captioning | Semantic Scholar
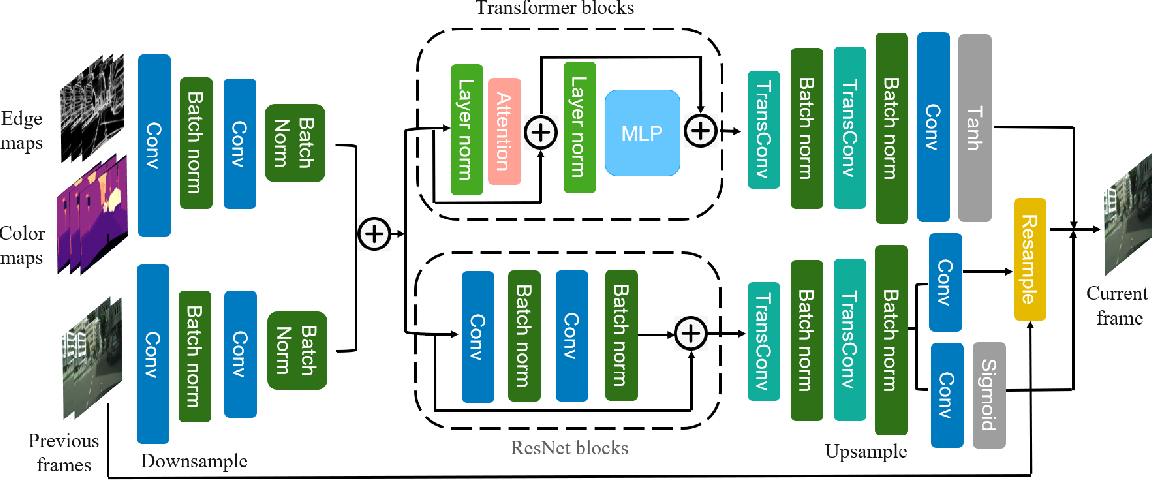
Figure 1 from Video Reconstruction with Multimodal Information ...
Advertisement Space (336x280)

Figure 5 from A Challenging Multimodal Video Summary: Simultaneously ...
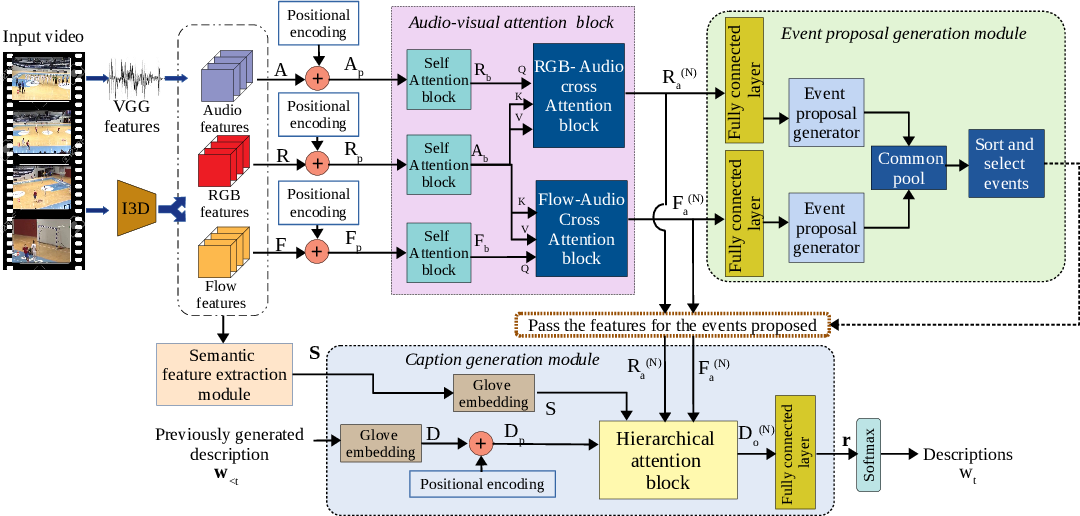
Figure 1 from Multi-Modal Hierarchical Attention-Based Dense Video ...

Figure 1 from Caption-Aware Multimodal Relation Extraction with Mutual ...

Multimodal feature generation framework for semantic image ...

Multimodal feature generation framework for semantic image ...

Figure 2 from MMT: Image-guided Story Ending Generation with Multimodal ...