
Figure 1 From A Strategy For Enhancing Modal Fusion Based On Llava
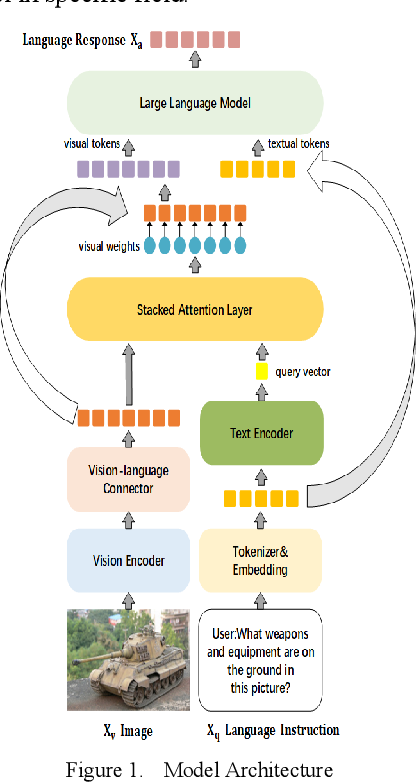
Figure 1 from A Strategy for Enhancing Modal Fusion Based on LLaVA ...

Figure 1 from Multi-Modal Fusion Based on Depth Adaptive Mechanism for ...

Figure 1 from A Comparative Study on Multi-Modal Fusion Methods for ...
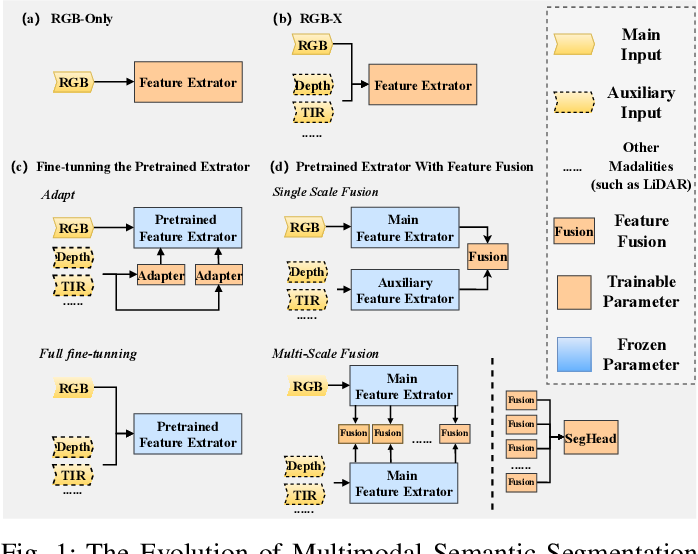
Figure 1 from U3M: Unbiased Multiscale Modal Fusion Model for ...
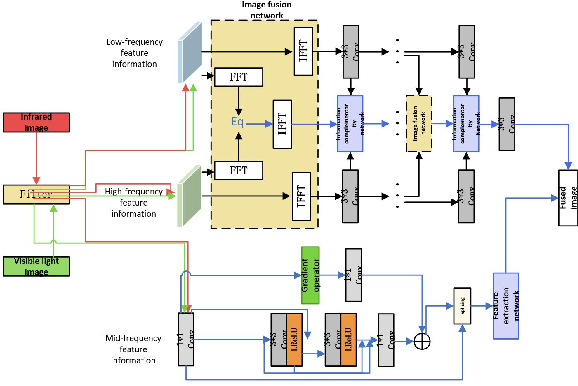
Figure 1 from Dual-modal Fusion Method based on Hierarchical Frequency ...

Figure 1 from A Multi-modal Fusion Algorithm for Cross-modal Video ...

Figure 5 from Multi-Modal Fusion Based on Depth Adaptive Mechanism for ...

Figure 1 from A Cross-modal Fusion Method for Multispectral Small Ship ...

Figure 1 from Fusion Is Not Enough: Single Modal Attacks on Fusion ...

Figure 1 from A Cross-Modal Fusion Network with Reinforcement Learning ...
Advertisement Space (300x250)
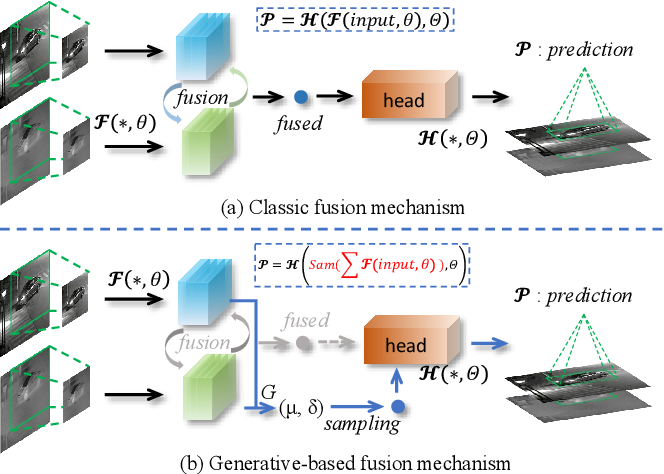
Figure 1 from Generative-based Fusion Mechanism for Multi-Modal ...

Figure 1 from Fusion Machine Learning Strategies for Multi-modal Sensor ...

Figure 1 from Enhancing Incomplete Multimodal Learning via Modal ...
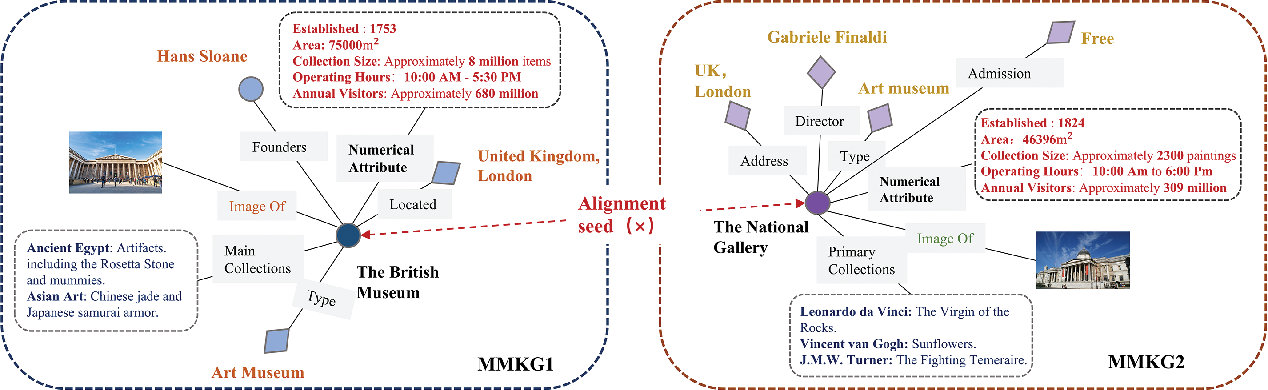
Figure 1 from Multi-Modal Pre-Synergistic Fusion Entity Alignment Based ...

Figure 1 from A Robust Mutual-Reinforcing Framework for 3D Multi-Modal ...

Figure 2 from Mixture of Attention Variants for Modal Fusion in Multi ...
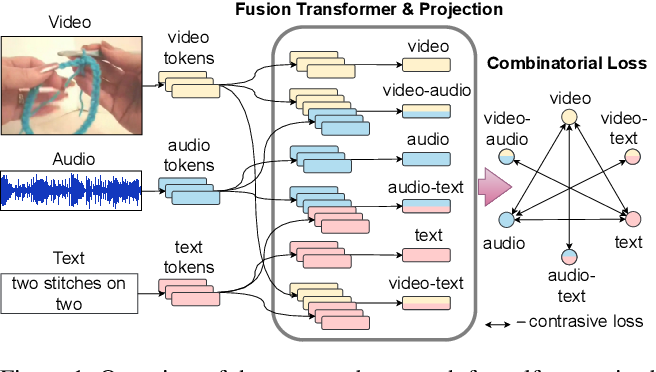
Figure 1 from Everything at Once – Multi-modal Fusion Transformer for ...

Figure 1 from Optical Flow-Aware-Based Multi-Modal Fusion Network for ...

Figure 1 from Cross-modal Feature Alignment and Fusion for Composed ...

Figure 2 from Unveiling the Depths: A Multi-Modal Fusion Framework for ...
Advertisement Space (336x280)

Figure 1 from Progressive Multi-Modal Fusion for Robust 3D Object ...

Figure 1 from LLaVA-Plus: Learning to Use Tools for Creating Multimodal ...

Figure 1 from Enhancing Emotion Recognition in Conversation through ...
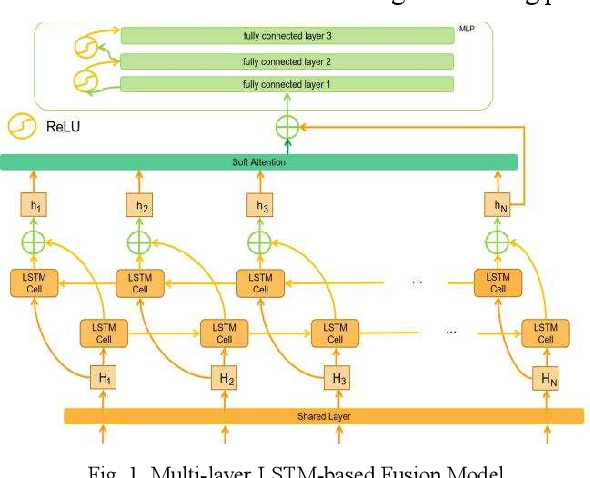
Figure 1 from A Model-Level Fusion-Based Multi-Modal Object Detection ...

Figure 1 from Enhancing Recommendations with Adaptive Multi-Modal ...

Figure 1 from Enhancing Multi-modal Models with Heterogeneous MoE ...
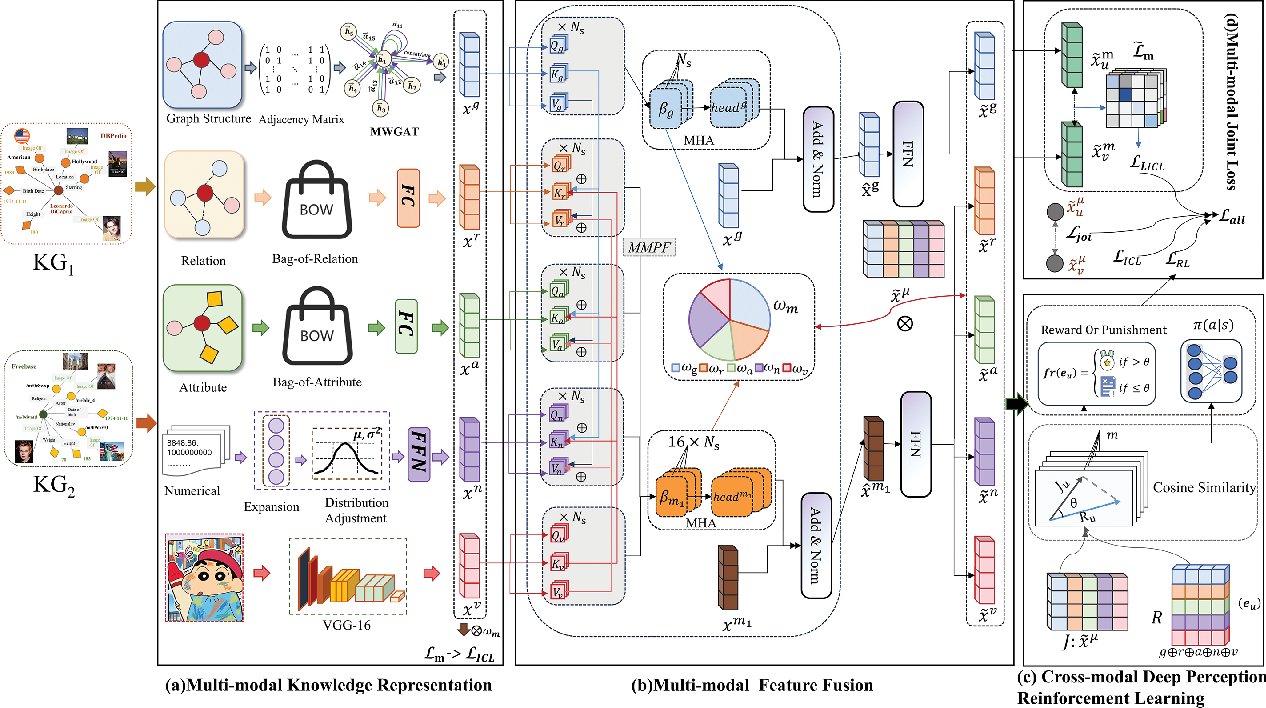
Figure 2 from Multi-Modal Pre-Synergistic Fusion Entity Alignment Based ...

Figure 1 from Rethink Cross-Modal Fusion in Weakly-Supervised Audio ...
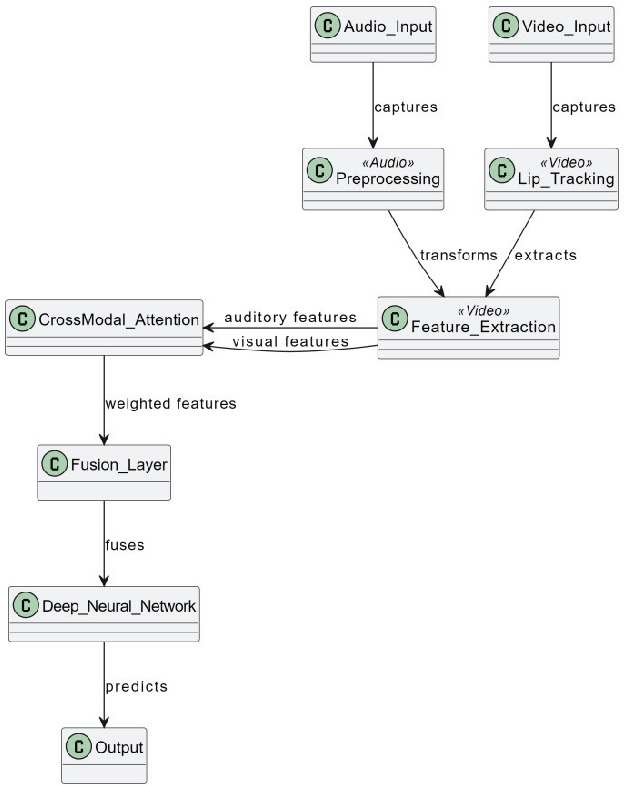
Figure 1 from Multi-Modal Signal Fusion: Enhancing Speech Recognition ...

Figure 1 from DrFuse: Learning Disentangled Representation for Clinical ...
Advertisement Space (336x280)
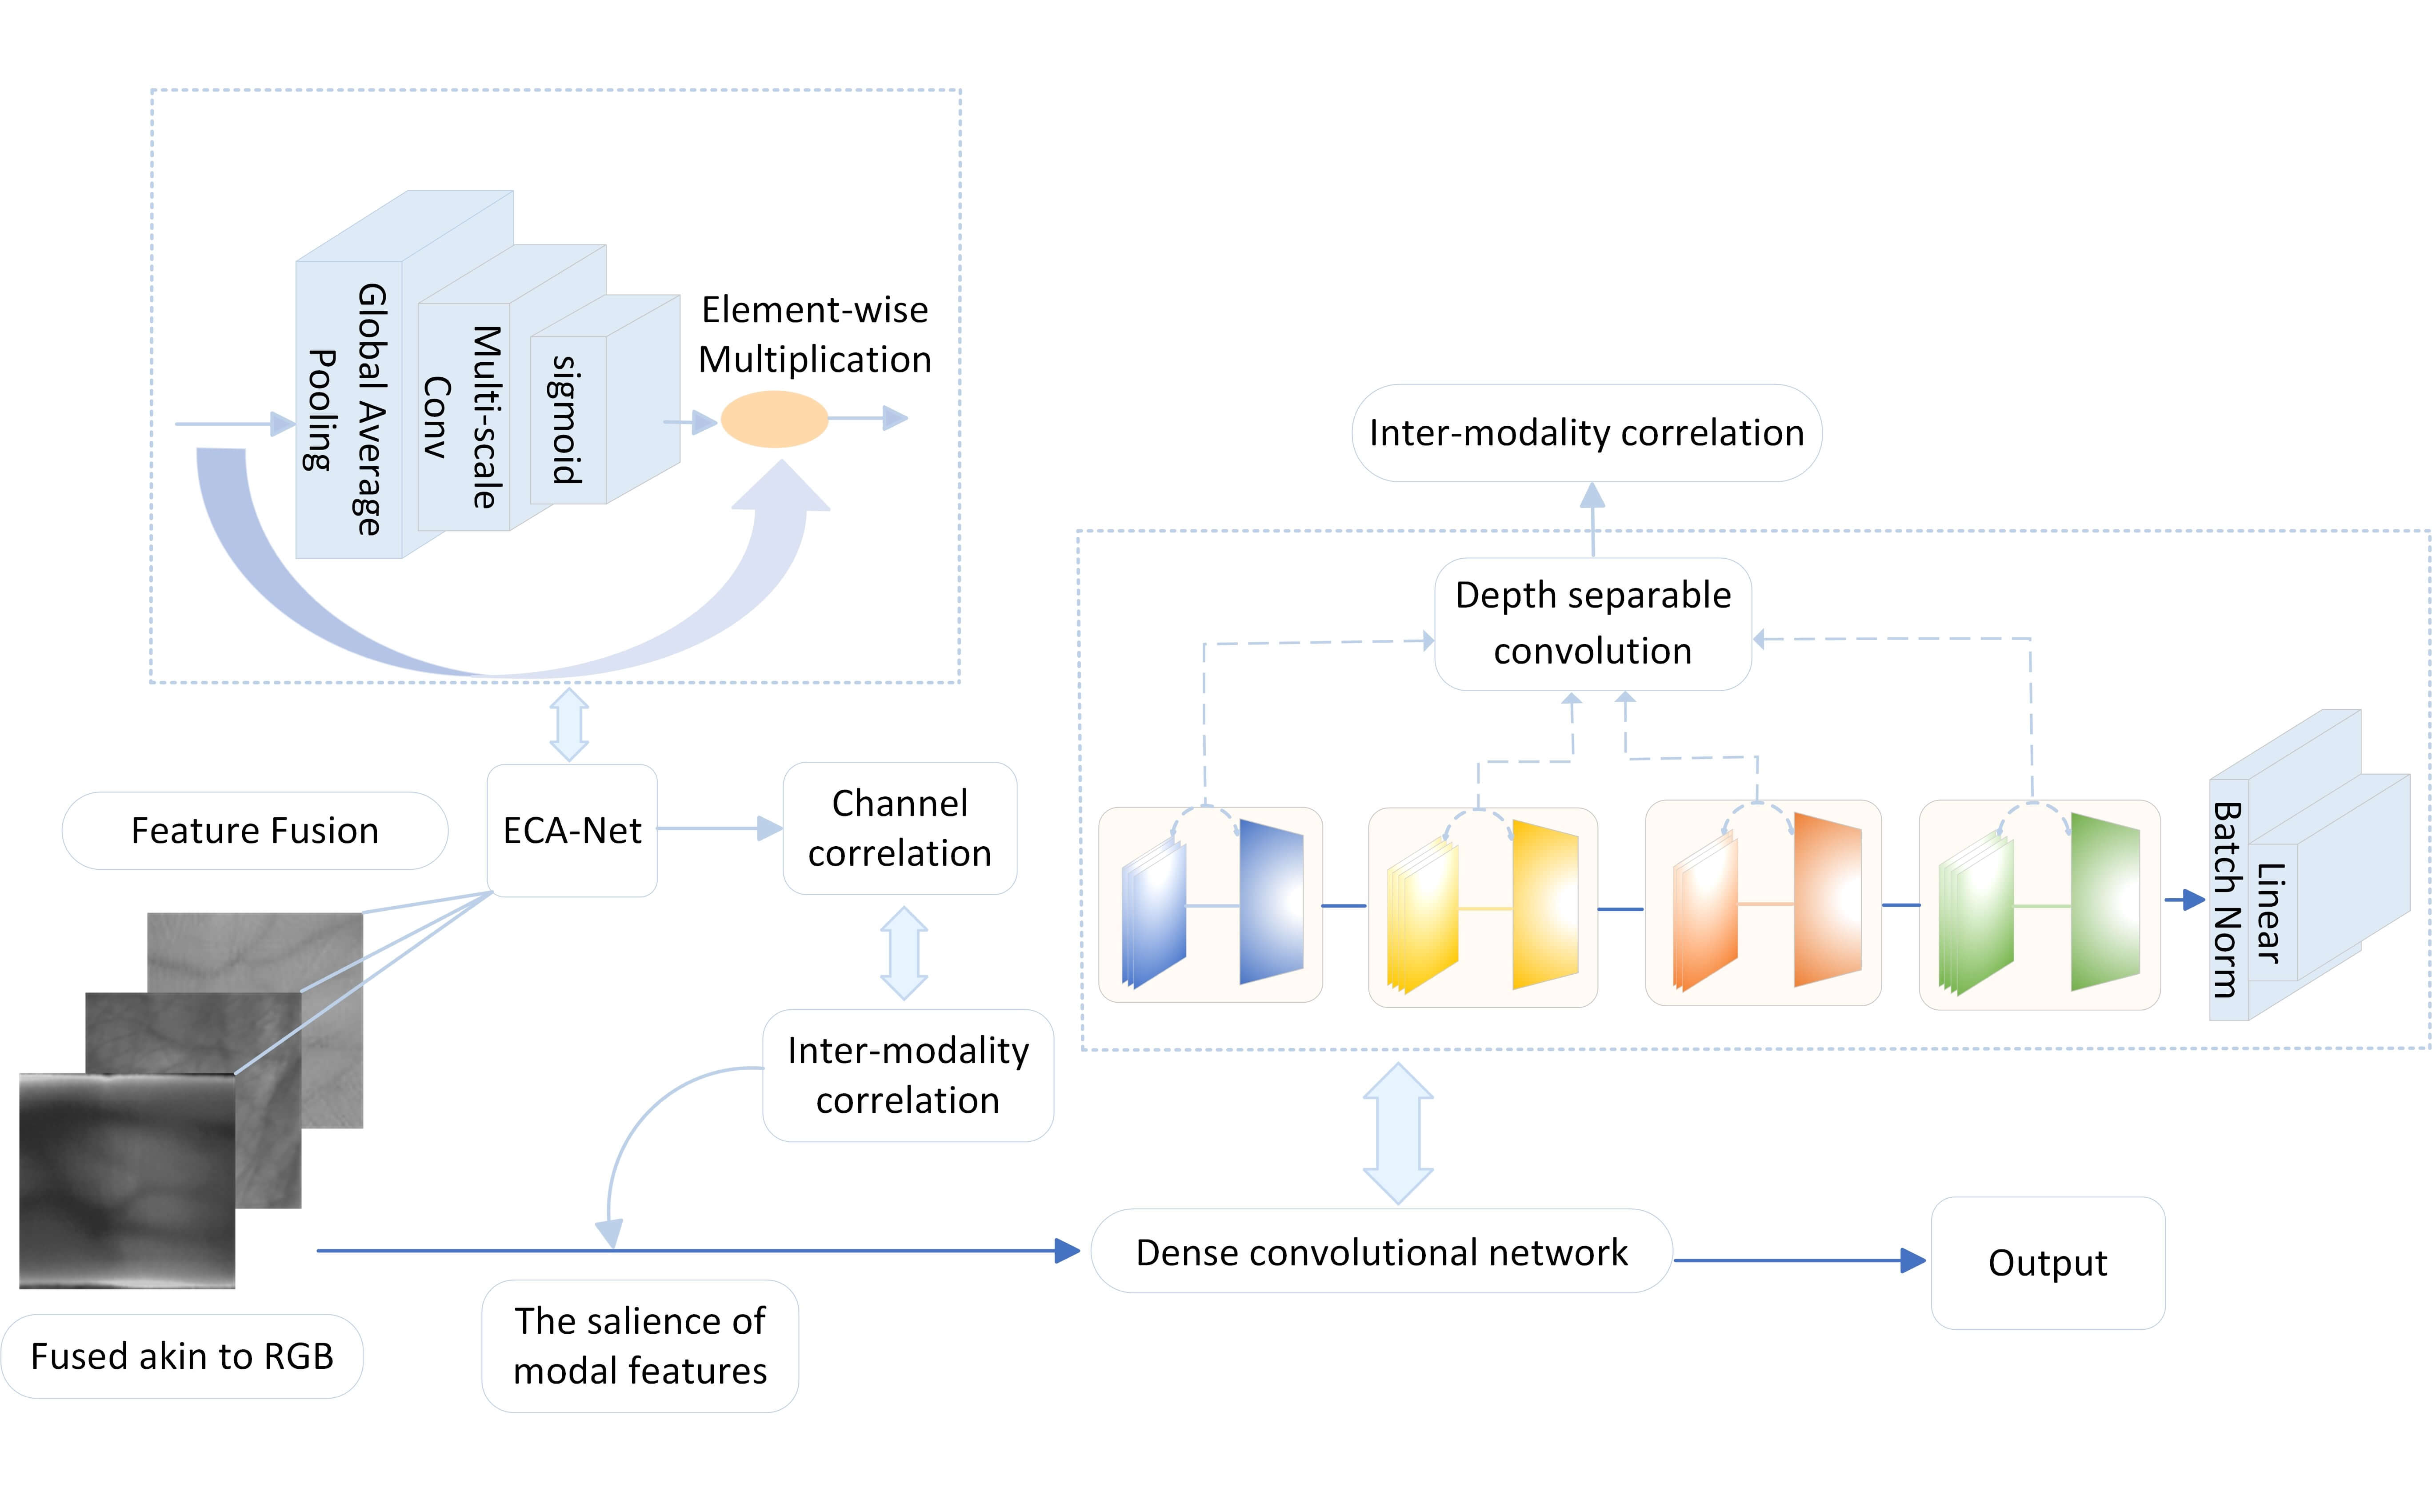
CMES | A Hand Features Based Fusion Recognition Network with Enhancing ...

[论文评述] Enhancing Modal Fusion by Alignment and Label Matching for ...
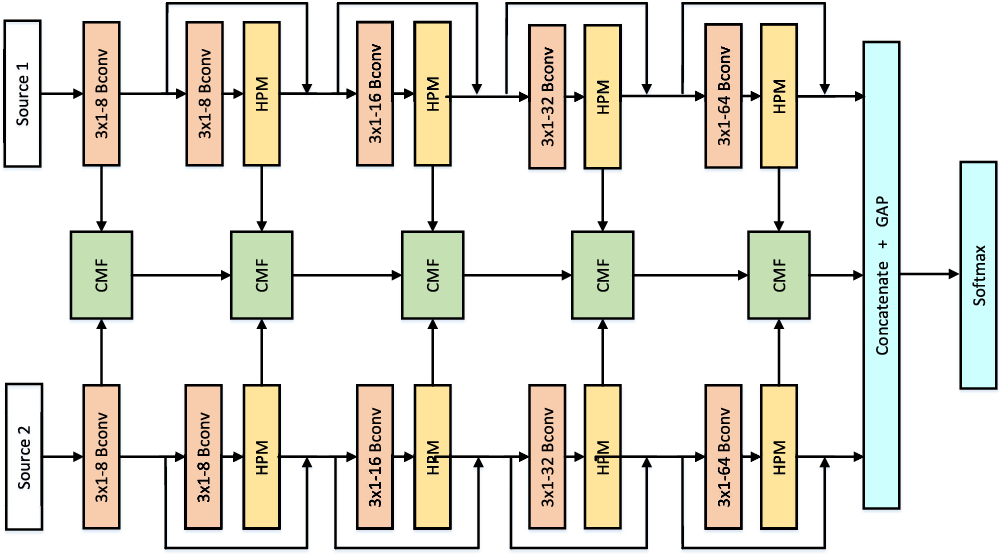
Figure 1 from Cross-Modal Fusion Convolutional Neural Networks With ...
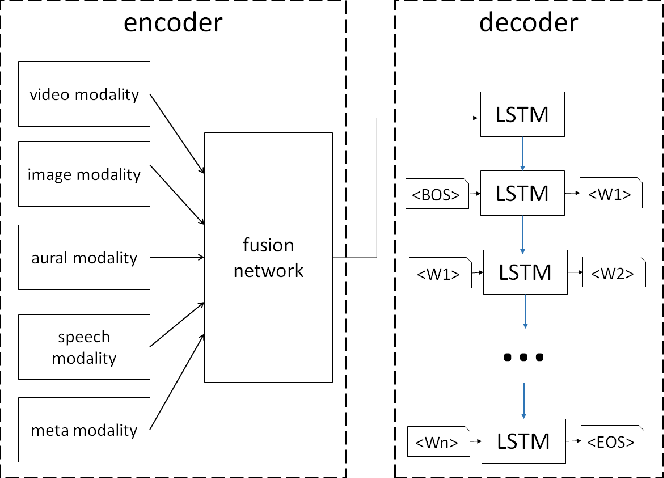
Figure 1 from Describing Videos using Multi-modal Fusion | Semantic Scholar
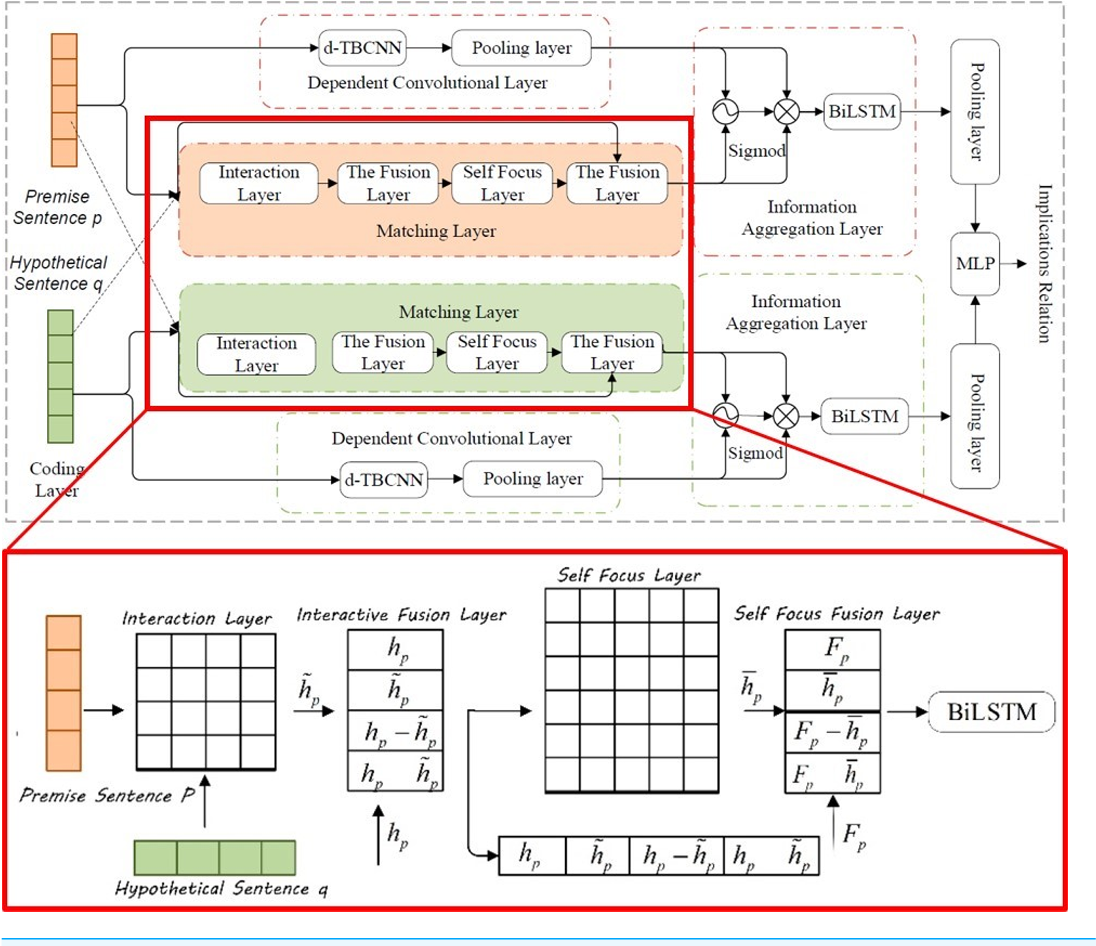
Figure 9 from The multi-modal fusion in visual question answering: a ...

(PDF) Multi-Modal Fusion Based on Depth Adaptive Mechanism for 3D ...