
Figure 1 From A Vision Language Pre Training Model Based On Cross

Figure 1 from A Vision-Language Pre-training model based on Cross ...

Table I from A Vision-Language Pre-training model based on Cross ...

Figure 1 from Retrieval-based Knowledge Augmented Vision Language Pre ...
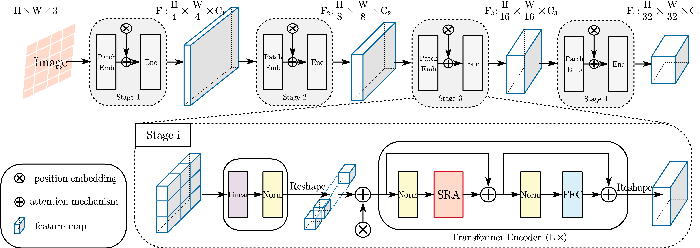
Figure 1 from Research on Image Captioning Based on Vision-language Pre ...
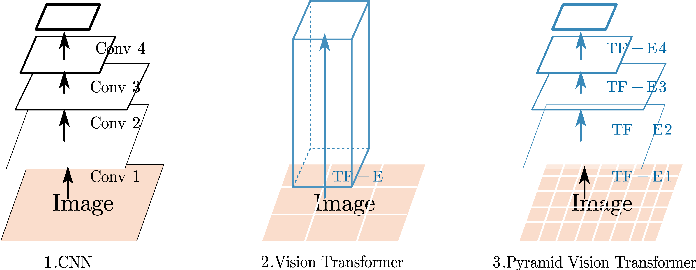
Figure 1 from Research on Image Captioning Based on Vision-language Pre ...

Figure 1 from Research on Image Captioning Based on Vision-language Pre ...
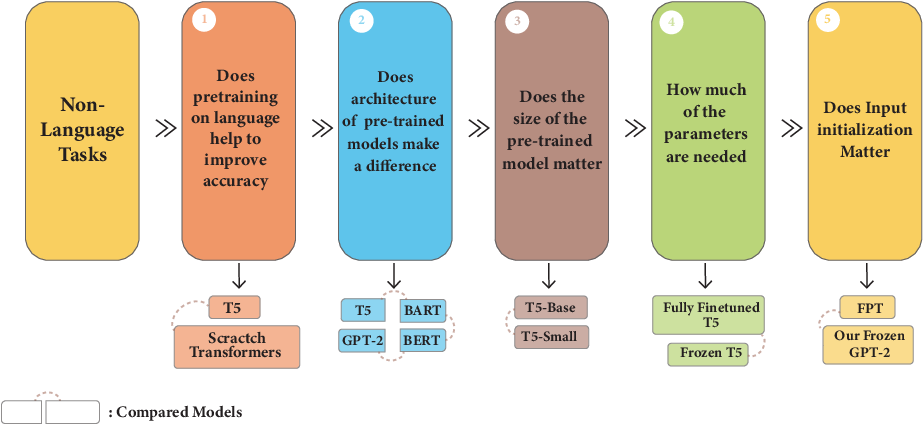
Figure 1 from Investigating Pre-trained Language Models on Cross-Domain ...
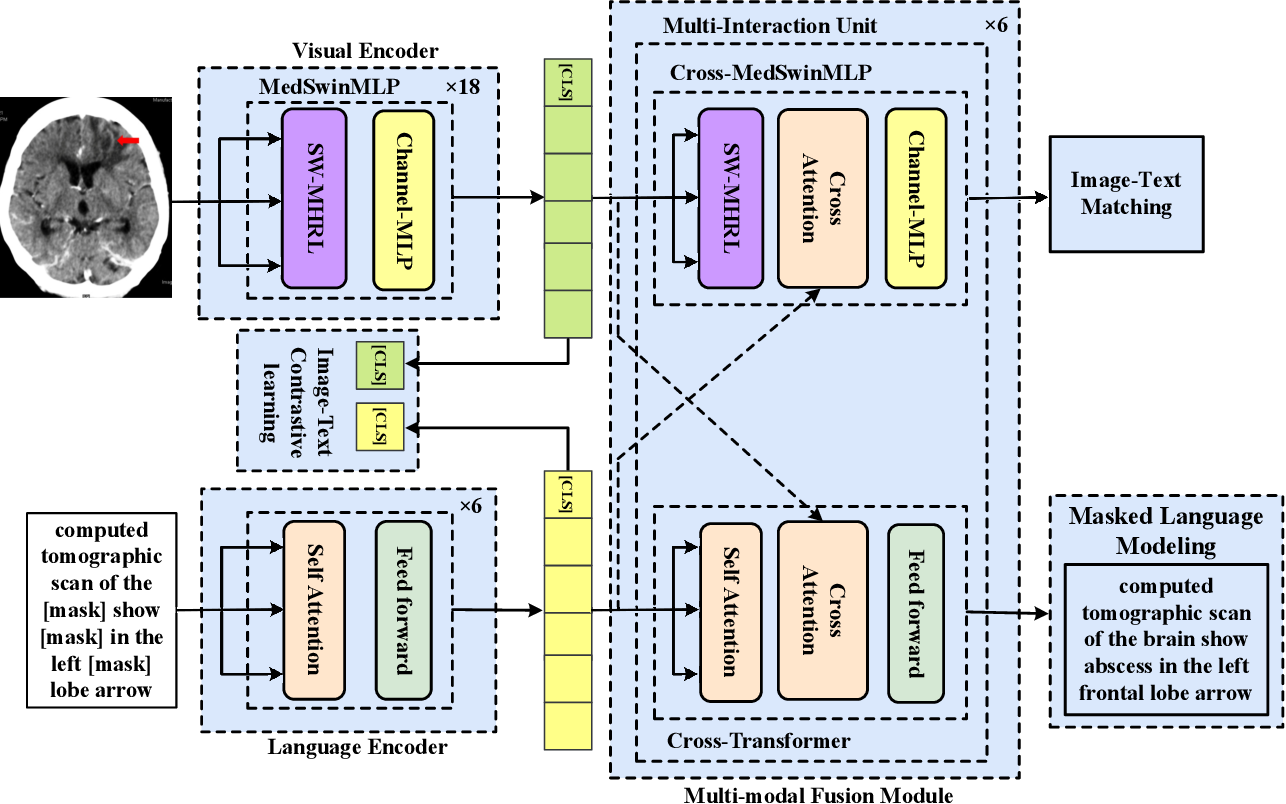
Figure 1 from MLP-Based Vision Language Pre-Training for Medical Visual ...

Figure 1 from Vision-and-Language or Vision-for-Language? On Cross ...

Figure 1 from PiTL: Cross-modal Retrieval with Weakly-supervised Vision ...
Advertisement Space (300x250)
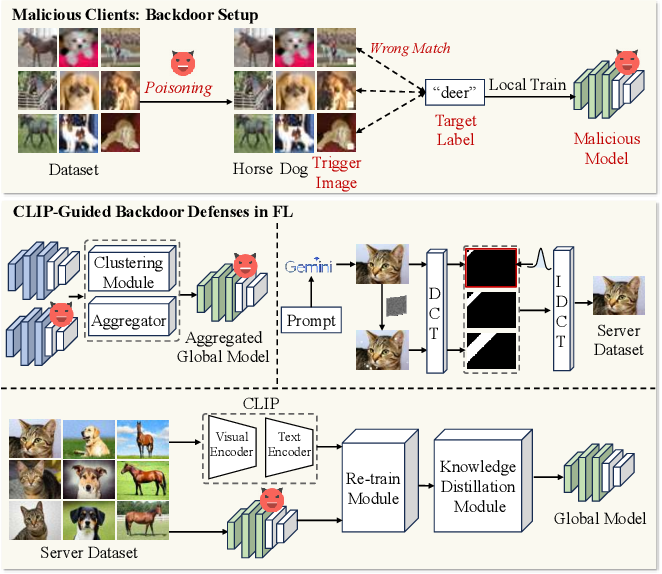
Figure 1 from A Vision-Language Pre-training Model-Guided Approach for ...

Figure 1 from A Closer Look at the Robustness of Vision-and-Language ...

Figure 1 from Alternating Cross-attention Vision-Language Model for ...

Figure 1 from Knowledge Boosting: Rethinking Medical Contrastive Vision ...
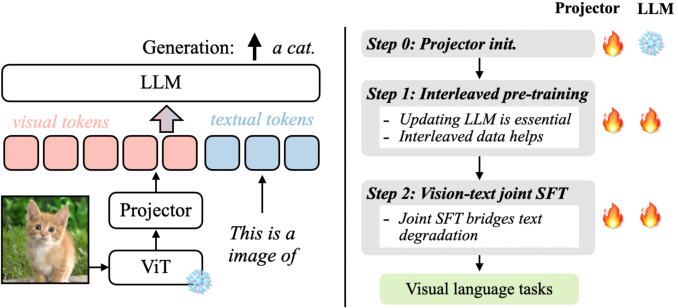
Figure 2 from VILA: On Pre-training for Visual Language Models ...

Figure 1 from Vision-Language Pre-Training for Boosting Scene Text ...
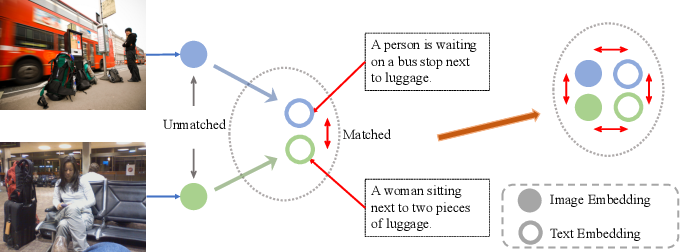
Figure 1 from Contrastive Cross-Modal Knowledge Sharing Pre-training ...

Figure 1 from Cross-Modal Alignment Learning of Vision-Language ...

Figure 1 from Unified Vision-Language Pre-Training for Image Captioning ...

Figure 1 from Incorporating Structured Representations into Pretrained ...
Advertisement Space (336x280)

Figure 1 from Unifying Cross-Lingual and Cross-Modal Modeling Towards ...

Figure 1 from Instruction-Following Agents with Jointly Pre-Trained ...

Figure 1 from Unleashing the Potential of Vision-Language Pre-Training ...

Figure 1 from Generalizing Multimodal Pre-training into Multilingual ...

Figure 1 from Unified Vision-Language Pre-Training for Image Captioning ...

Figure 1 from Unifying Cross-Lingual and Cross-Modal Modeling Towards ...
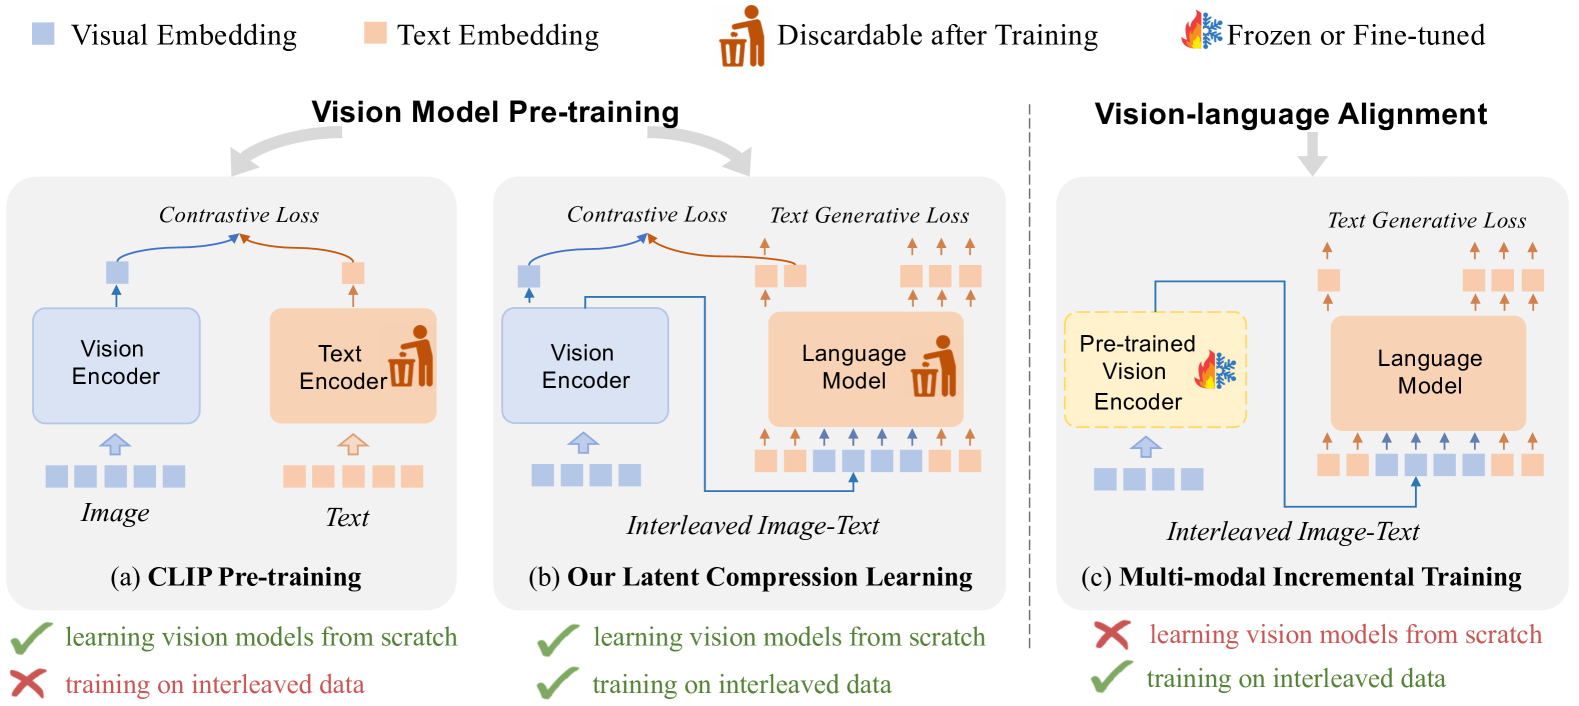
Vision Model Pre-training on Interleaved Image-Text Data via Latent ...

Figure 1 from Enhancing Vision-Language Pre-Training with Jointly ...

A Comprehensive Guide to Vision Language Models (VLMs)

Figure 1 from Are Vision-Language Transformers Learning Multimodal ...
Advertisement Space (336x280)
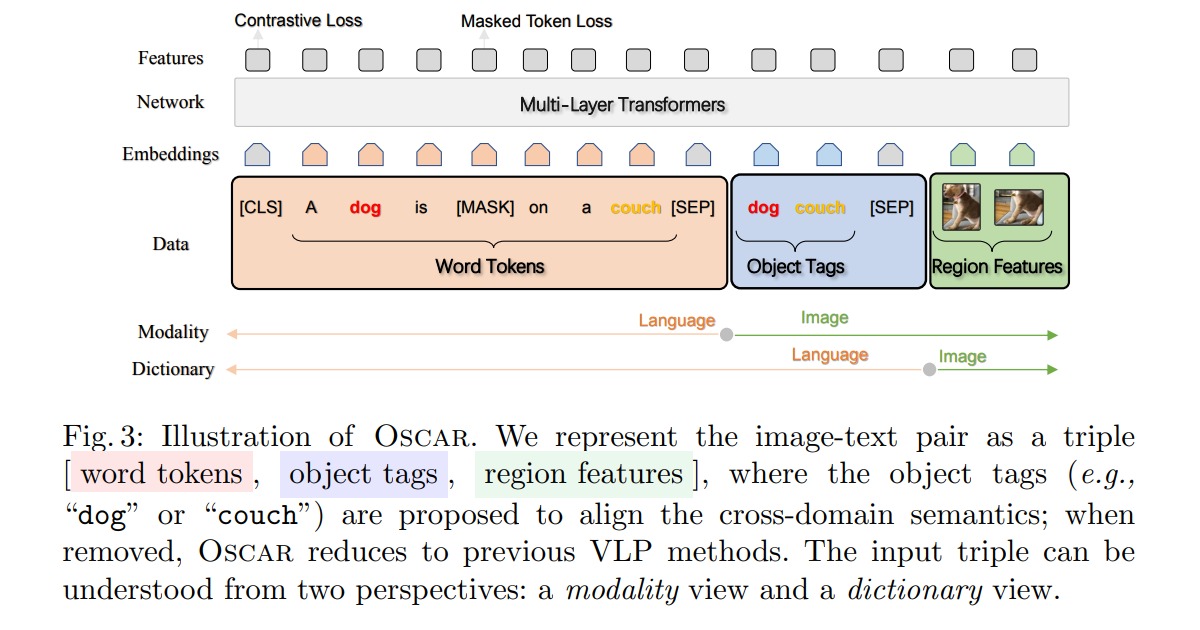
Vision Language Pre-training Model

Figure 2 from Position-Guided Text Prompt for Vision-Language Pre ...

Figure 1 from Enhancing Vision-Language Pre-Training with Jointly ...

(PDF) COSMOS: Cross-Modality Self-Distillation for Vision Language Pre ...

Figure 1 from Efficient Vision-Language Pretraining with Visual ...

Figure 1 from Improved baselines for vision-language pre-training ...