
Figure 1 From Adder Attention For Vision Transformer Semantic Scholar
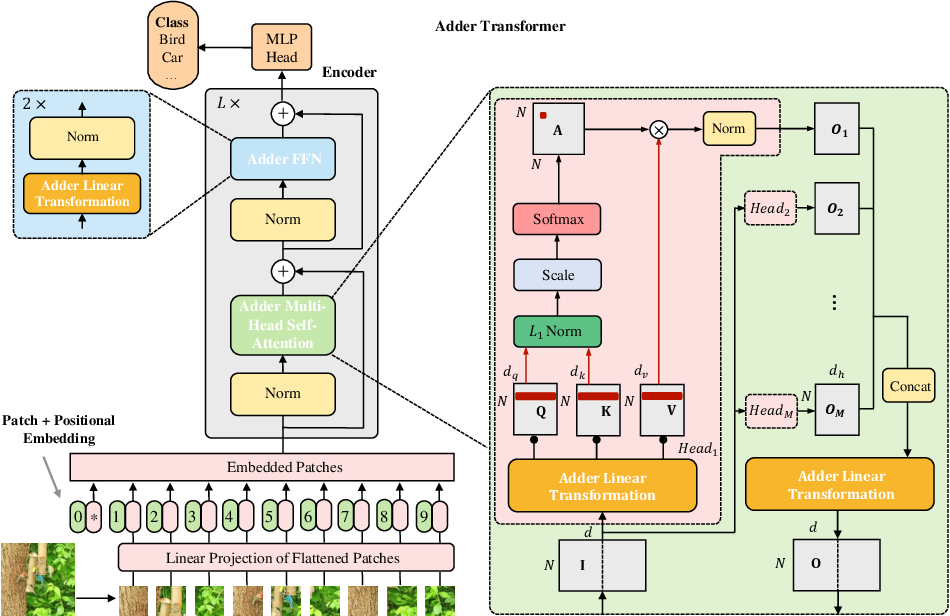
Figure 1 from Adder Attention for Vision Transformer | Semantic Scholar
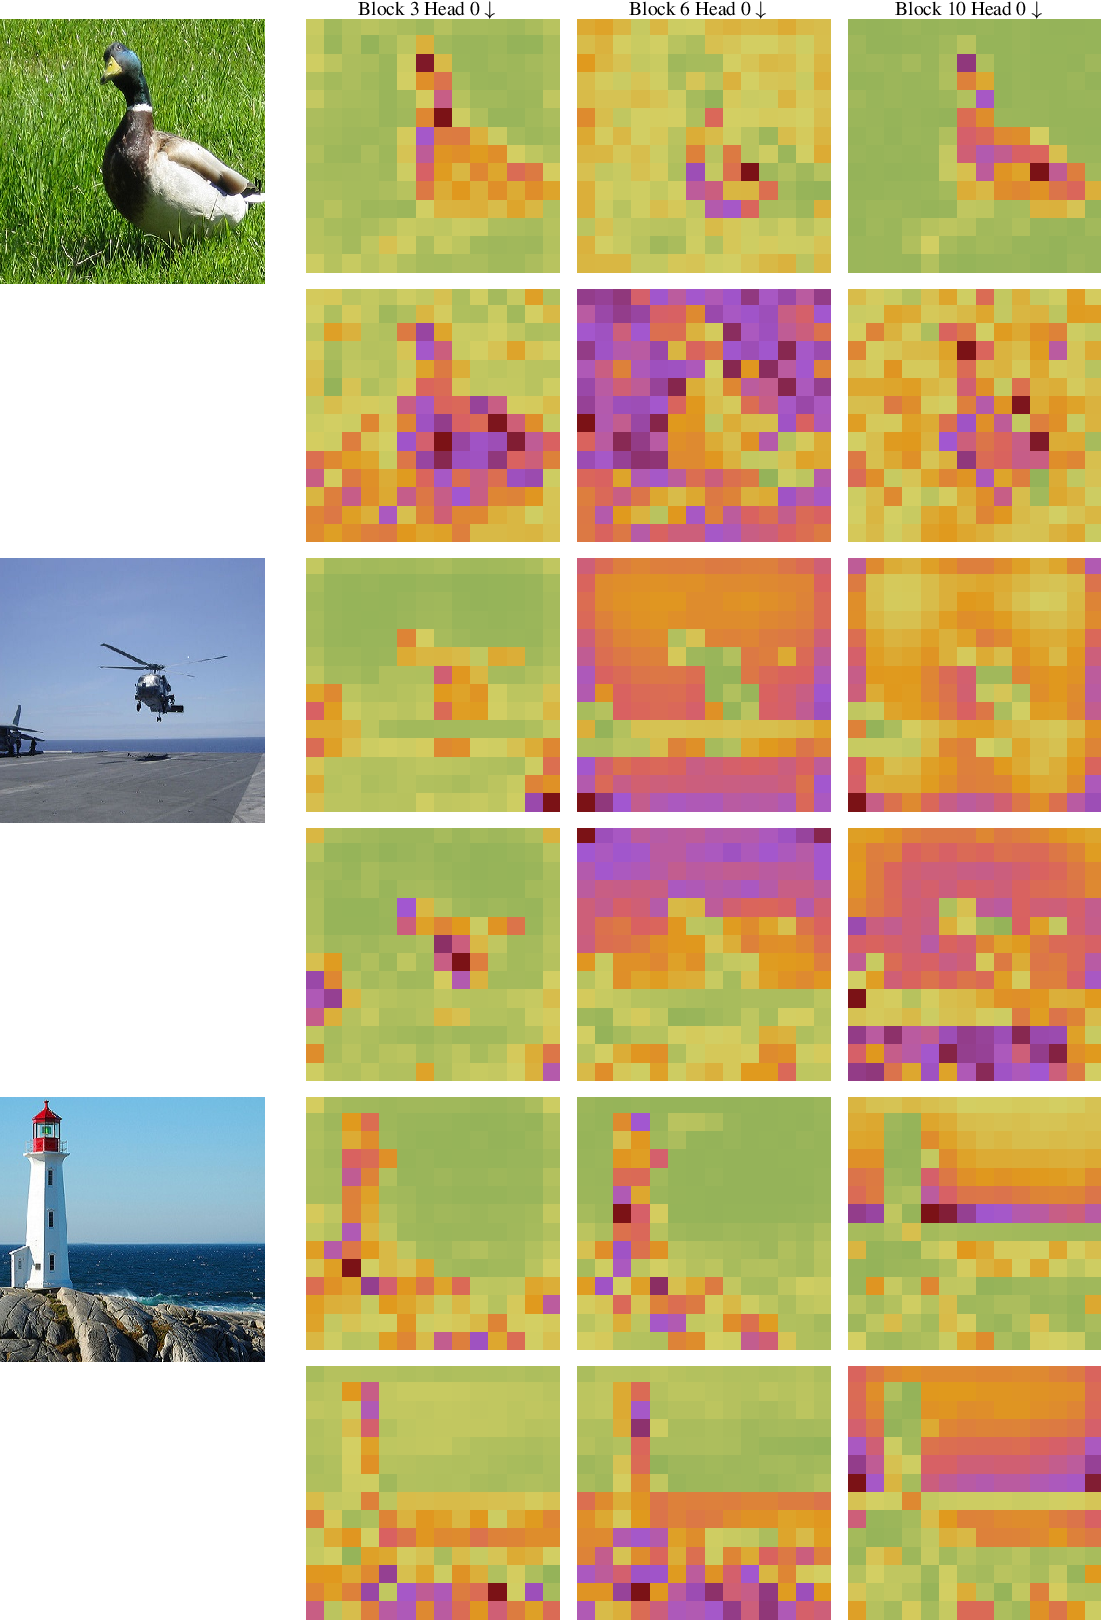
Figure 3 from Adder Attention for Vision Transformer | Semantic Scholar

Figure 1 from Vision Transformer for Pansharpening | Semantic Scholar
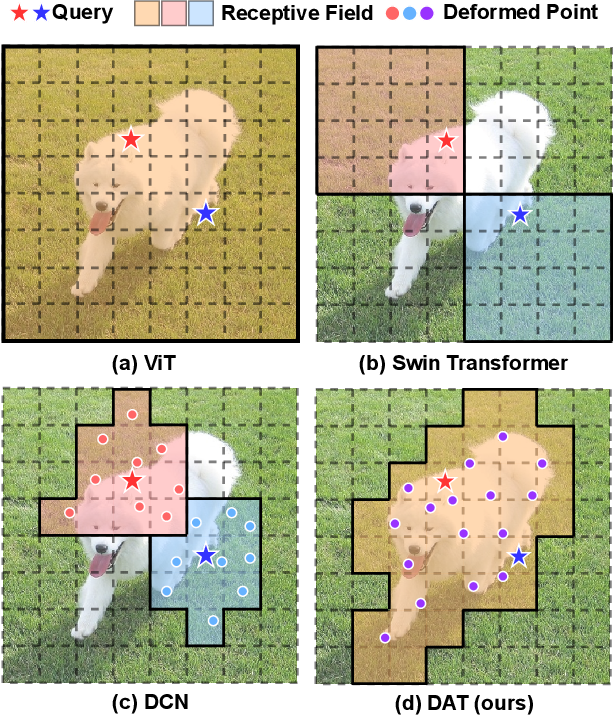
Figure 1 from Vision Transformer with Deformable Attention | Semantic ...

Figure 1 from Vision Transformer With Quadrangle Attention | Semantic ...

Figure 1 from Adversarial Vision Transformer for Medical Image Semantic ...
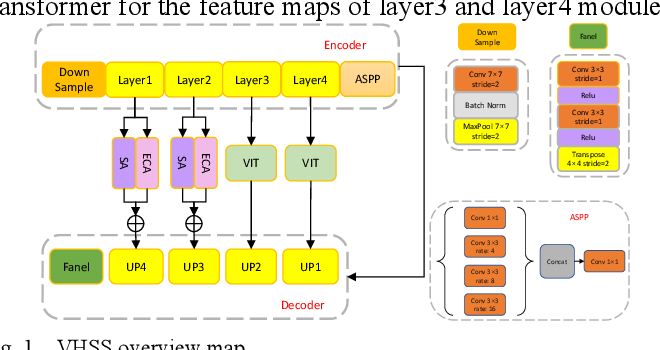
Figure 1 from Vision Transformer is Required for Hyperspectral Semantic ...

Figure 1 from Local-Aware Residual Attention Vision Transformer for ...
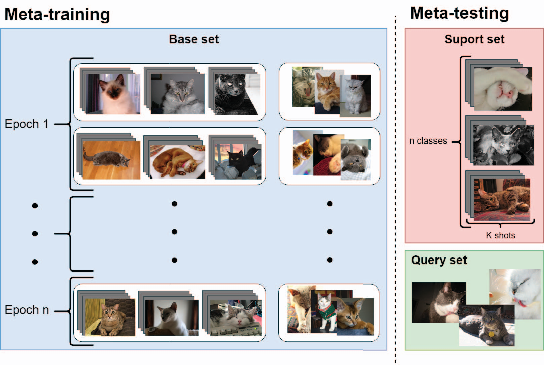
Figure 1 from Cross-Attention Vision Transformer for Few-Shot Semantic ...

Figure 1 from A Convolutional Vision Transformer for Semantic ...
Advertisement Space (300x250)
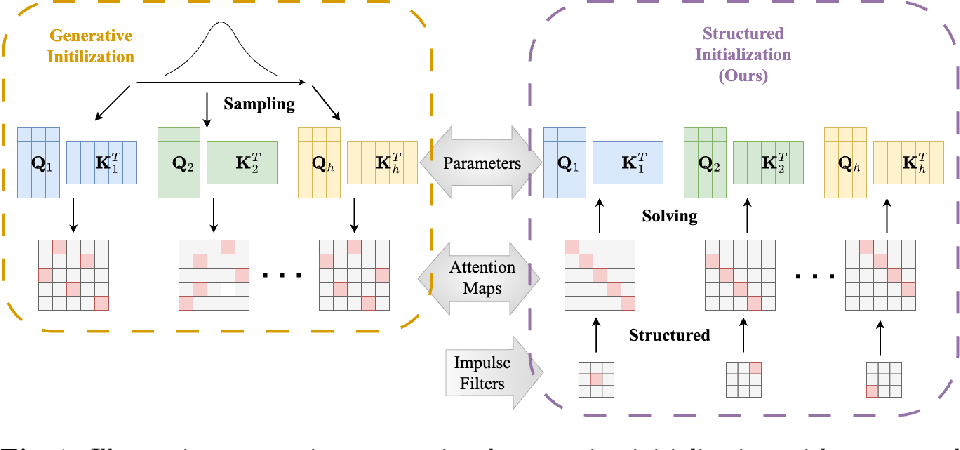
Figure 1 from Structured Initialization for Attention in Vision ...

Figure 1 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...
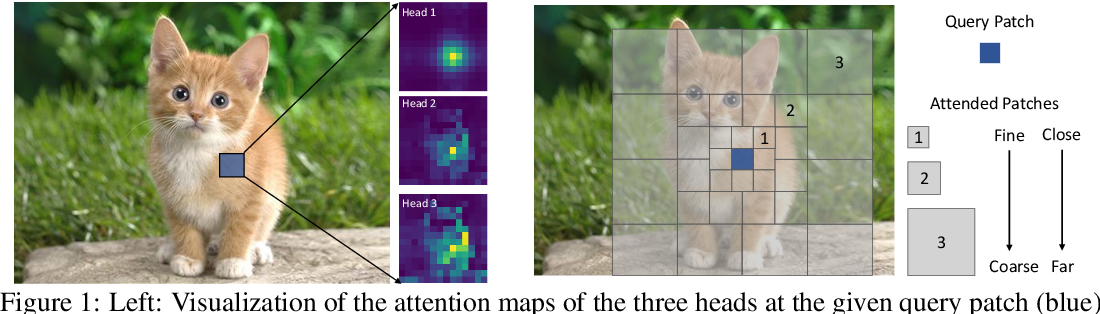
Figure 1 from Focal Attention for Long-Range Interactions in Vision ...
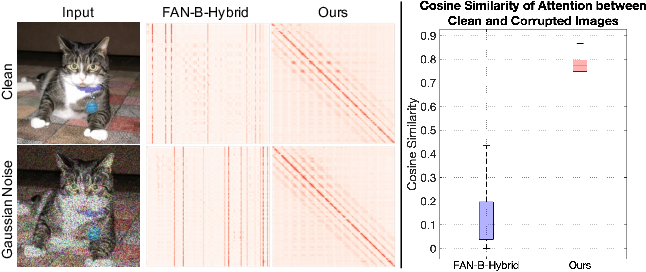
Figure 1 from Robustifying Token Attention for Vision Transformers ...

Figure 1 from Multi-Manifold Attention for Vision Transformers ...

Figure 1 from Semantic Representations With Attention Networks for ...

Figure 1 from Axial Attention Transformer for Fast High-quality Image ...
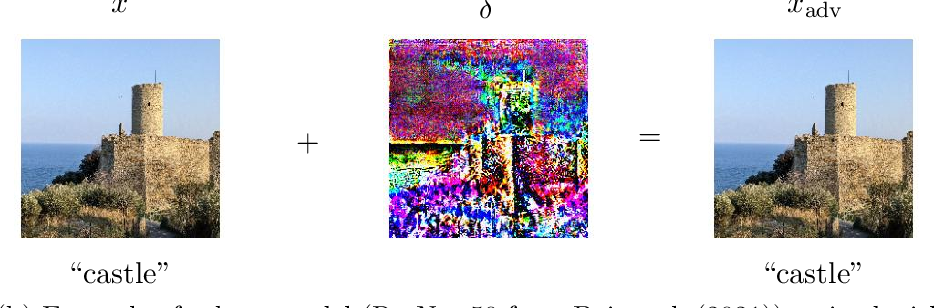
Figure 1 from Adversarially Robust Vision Transformers | Semantic Scholar
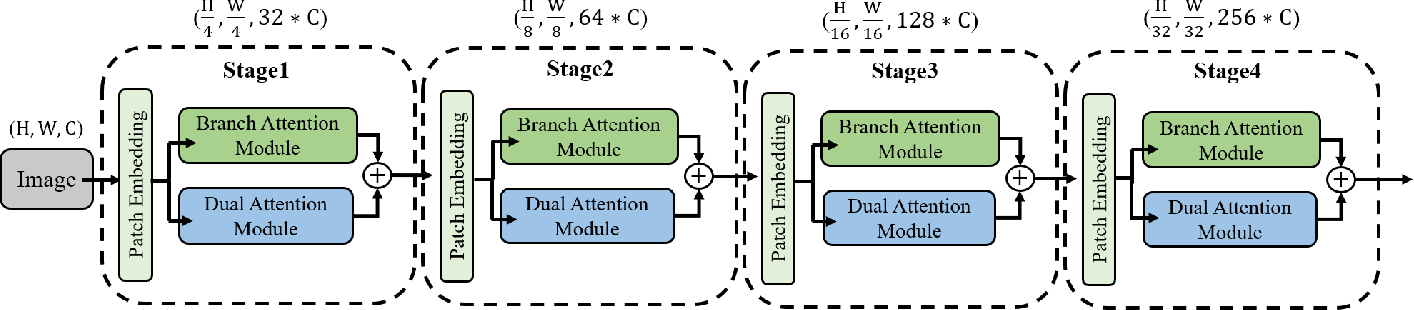
Figure 1 from Triple Attention Vision Transformers for Remote Sensing ...

Figure 1 from Attention-based Vision Transformer for Human Activity ...
Advertisement Space (336x280)
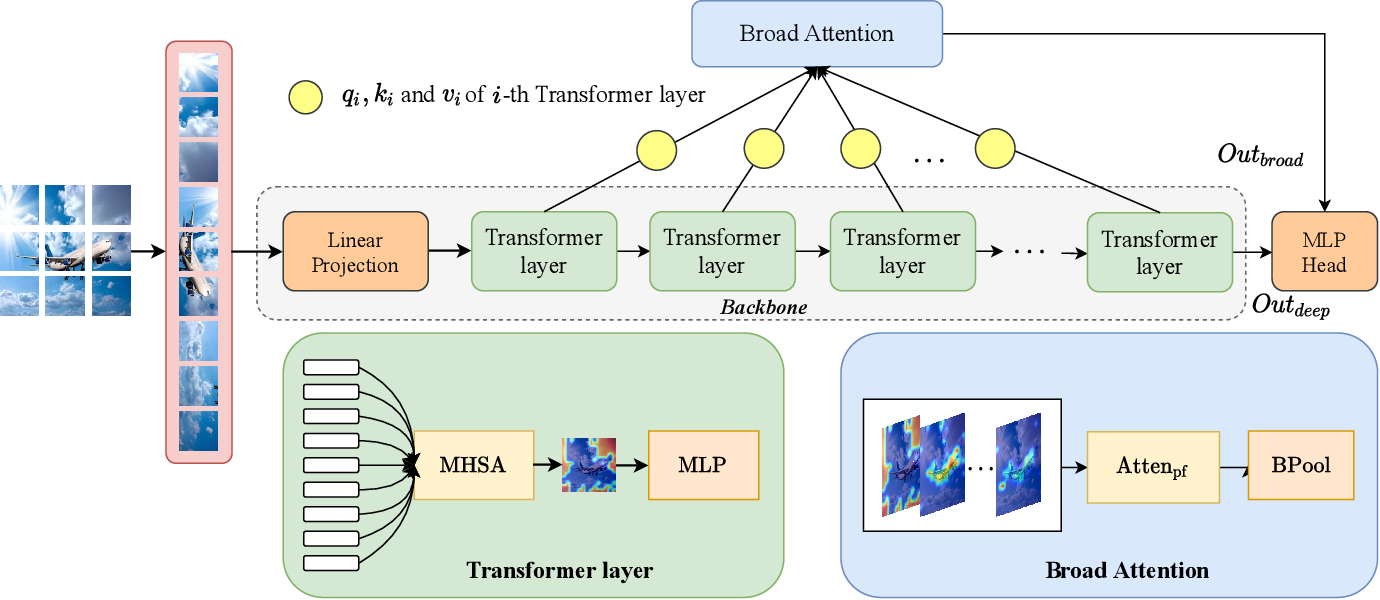
Figure 1 from BViT: Broad Attention-Based Vision Transformer | Semantic ...
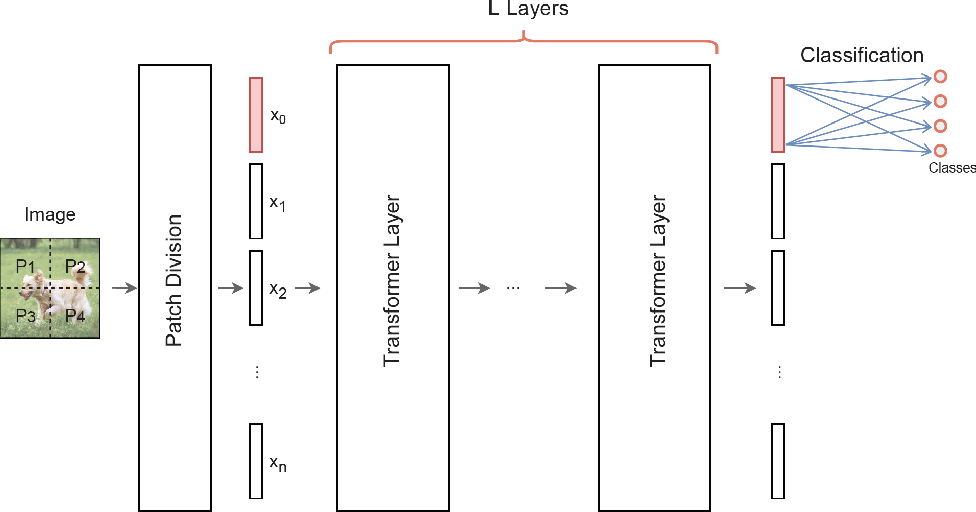
Figure 1 from Quantum Vision Transformers | Semantic Scholar

Figure 1 from Space Time Attention Transformer for Non-Event Detection ...

Figure 1 from Dual Path Transformer with Partition Attention | Semantic ...
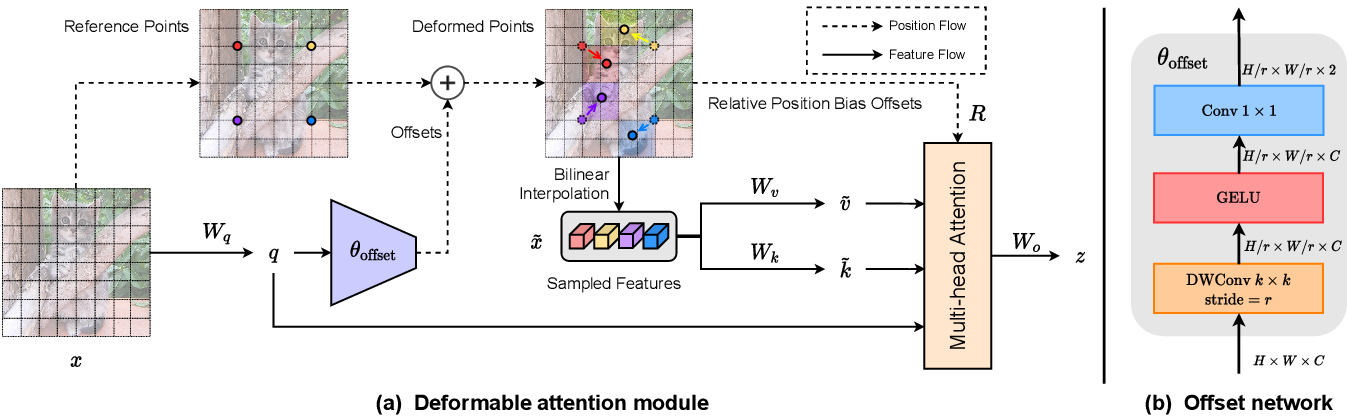
Figure 2 from Vision Transformer with Deformable Attention | Semantic ...

Figure 1 from Token-Label Alignment for Vision Transformers | Semantic ...
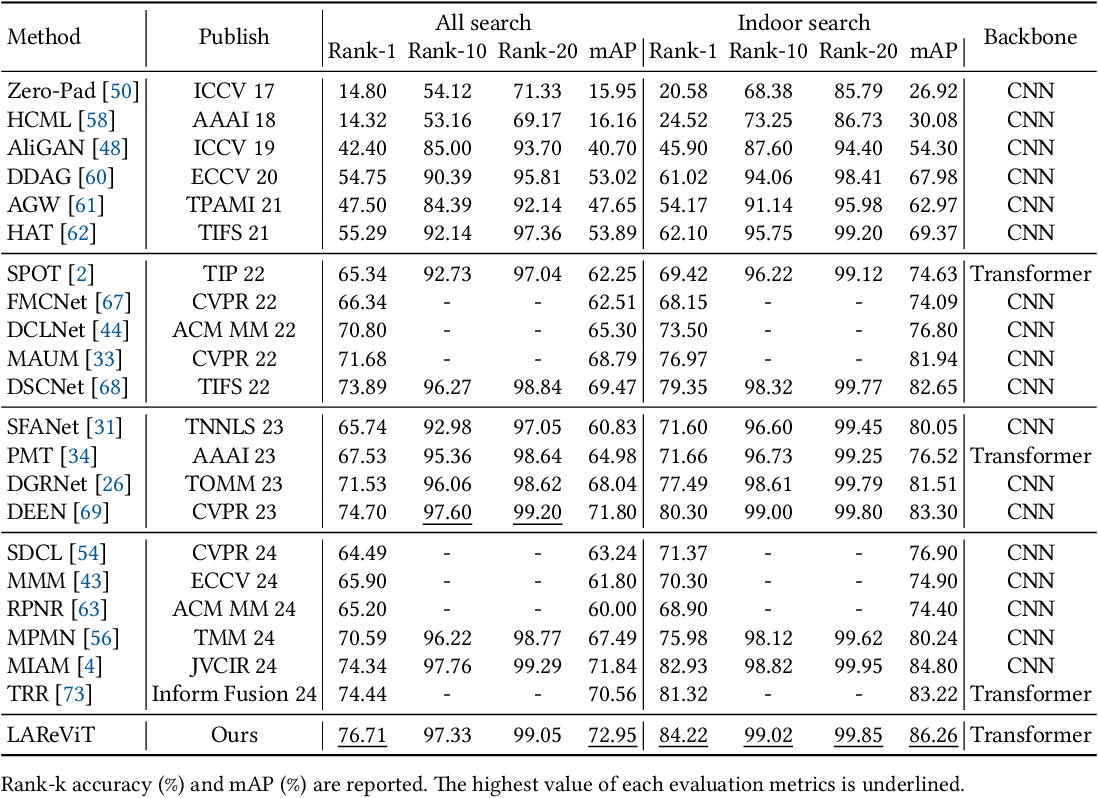
Table 1 from Local-Aware Residual Attention Vision Transformer for ...
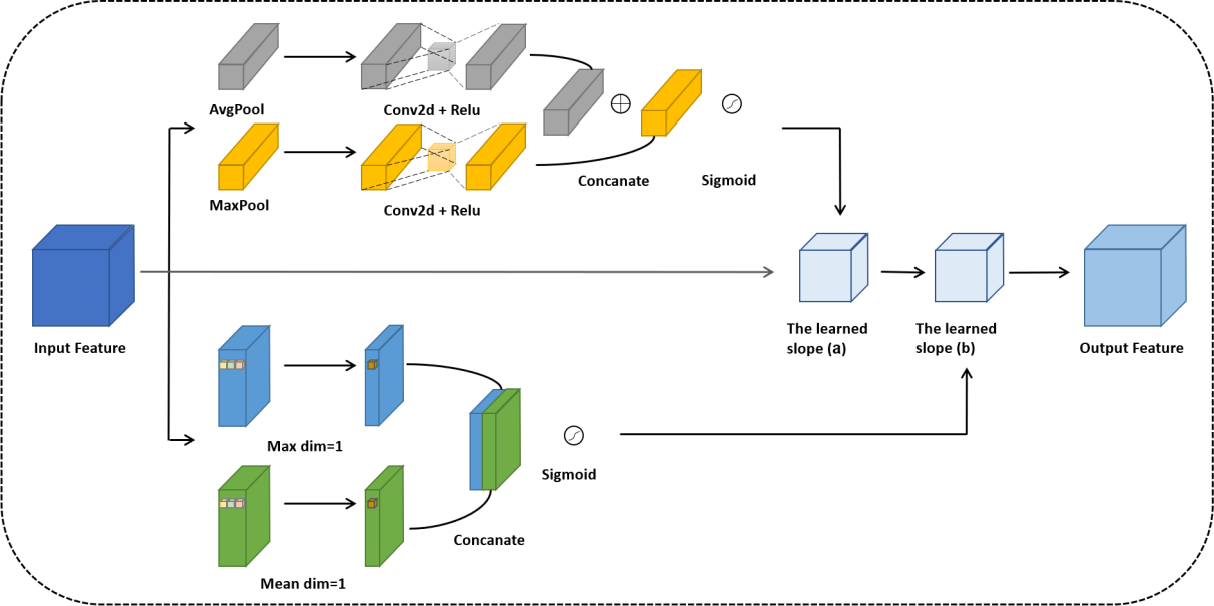
Figure 1 from Residual Attention Single-Head Vision Transformer Network ...

Figure 1 from Computationally-Efficient Vision Transformer for Medical ...

Figure 1 from DATransNet: Dynamic Attention Transformer Network for ...
Advertisement Space (336x280)

Figure 2 from Cross-Attention Vision Transformer for Few-Shot Semantic ...
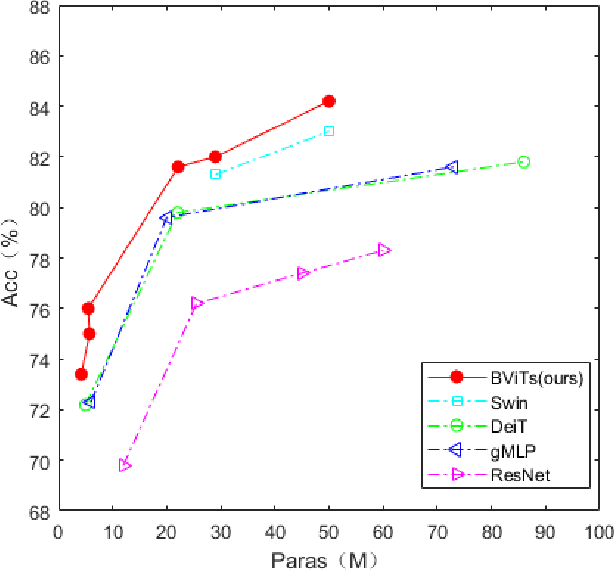
Figure 1 from BViT: Broad Attention-Based Vision Transformer | Semantic ...

Figure 3 from A Convolutional Vision Transformer for Semantic ...

Figure 1 from A 3D U-Net Based on a Vision Transformer for Radar ...

Figure 2 from Local-Aware Residual Attention Vision Transformer for ...
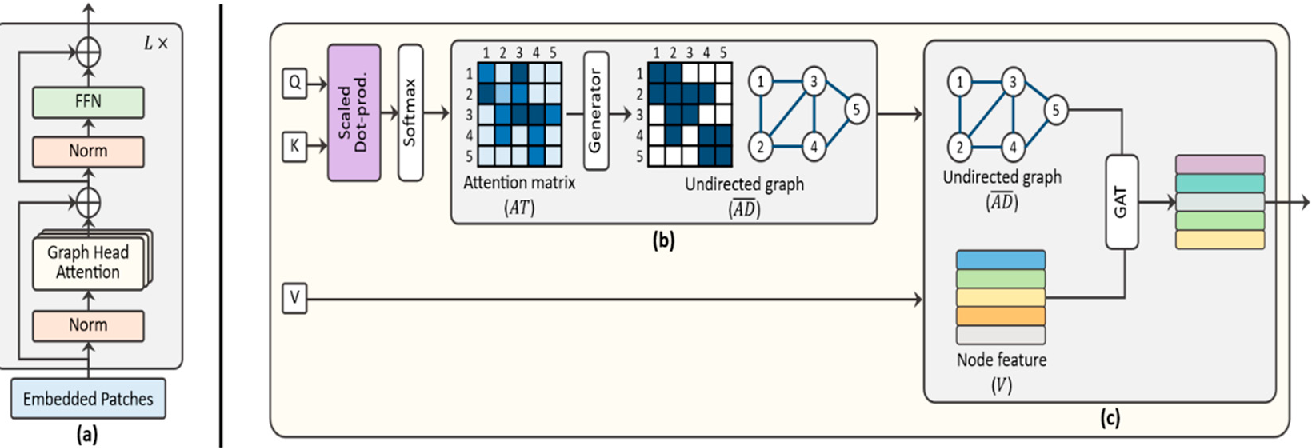
Figure 1 from Rethinking Attention Mechanisms in Vision Transformers ...