
Figure 1 From An Efficient Audio Visual Speech Enhancement Network Via
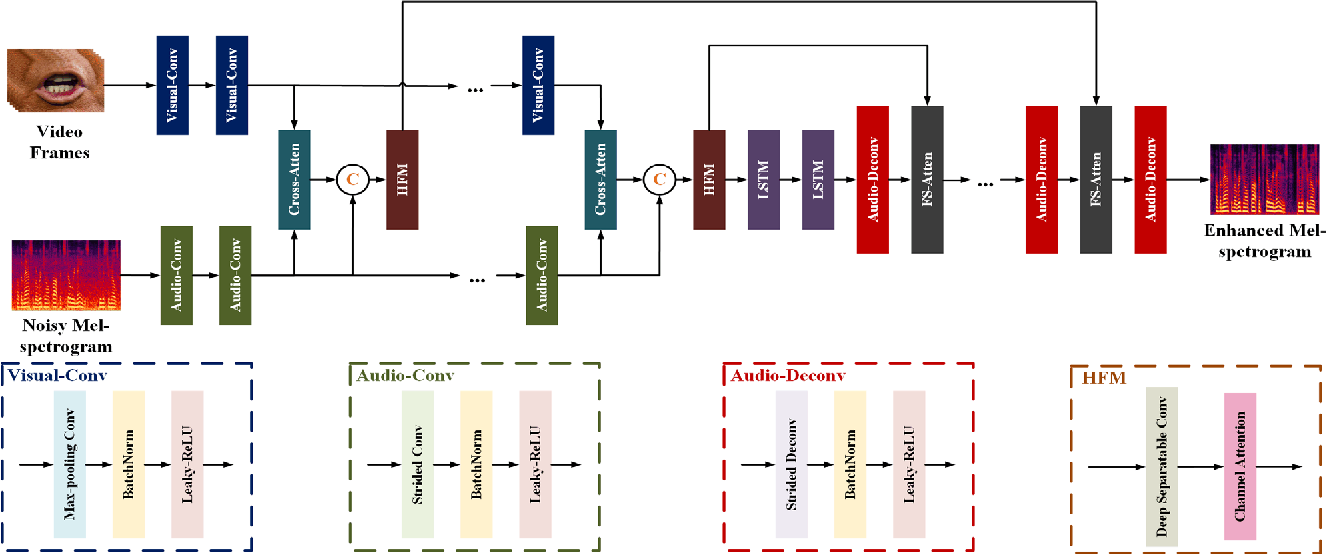
Figure 1 from An Efficient Audio-visual Speech Enhancement Network via ...
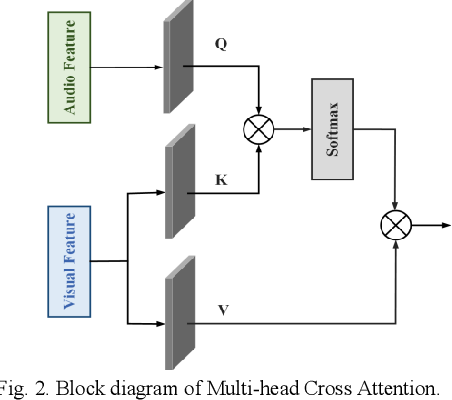
Figure 2 from An Efficient Audio-visual Speech Enhancement Network via ...
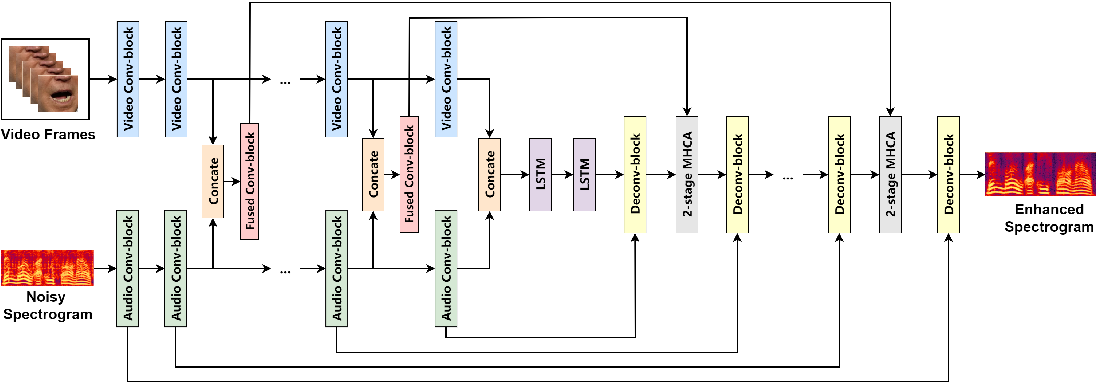
Figure 1 from Improving Visual Speech Enhancement Network by Learning ...

Figure 1 from Efficient Audio-Visual Speech Enhancement Using Deep U ...

Figure 1 from Audio-Visual Speech Enhancement in Noisy Environments via ...
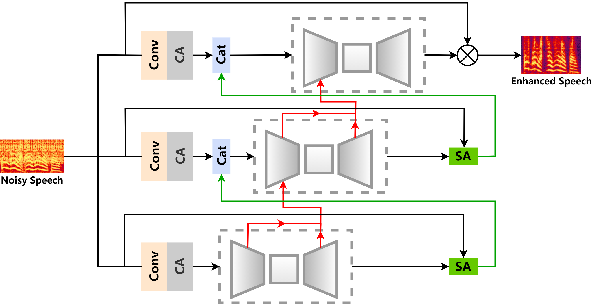
Figure 1 from Multi-Stage Progressive Speech Enhancement Network ...

Figure 1 from Visual Context-driven Audio Feature Enhancement for ...

Figure 1 from Pure Voice : Efficient Speech Separation with Audio ...

Figure 1 from An Approach for Speech Enhancement Using Deep ...

Figure 1 from Improving Speech Enhancement via Event-Based Query ...
Advertisement Space (300x250)
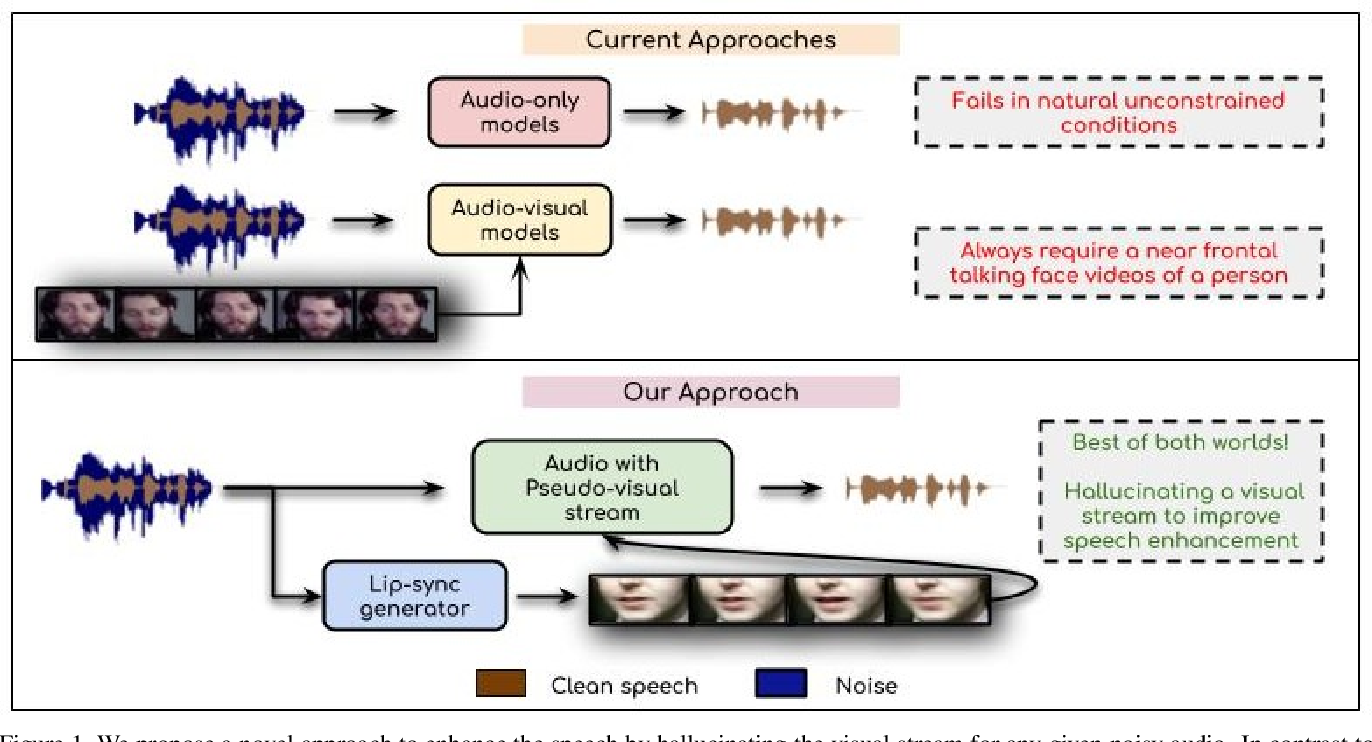
Figure 1 from Visual Speech Enhancement Without A Real Visual Stream ...
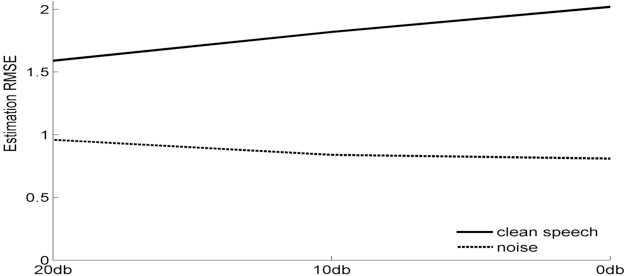
Figure 1 from Enhancing audio speech using visual speech features ...

Figure 1 from Audio-Visual Speech Enhancement Based on Multiscale ...

Figure 1 from Audio-Visual Speech Enhancement with Selective Off-Screen ...

Figure 1 from Audio-Visual Efficient Conformer for Robust Speech ...
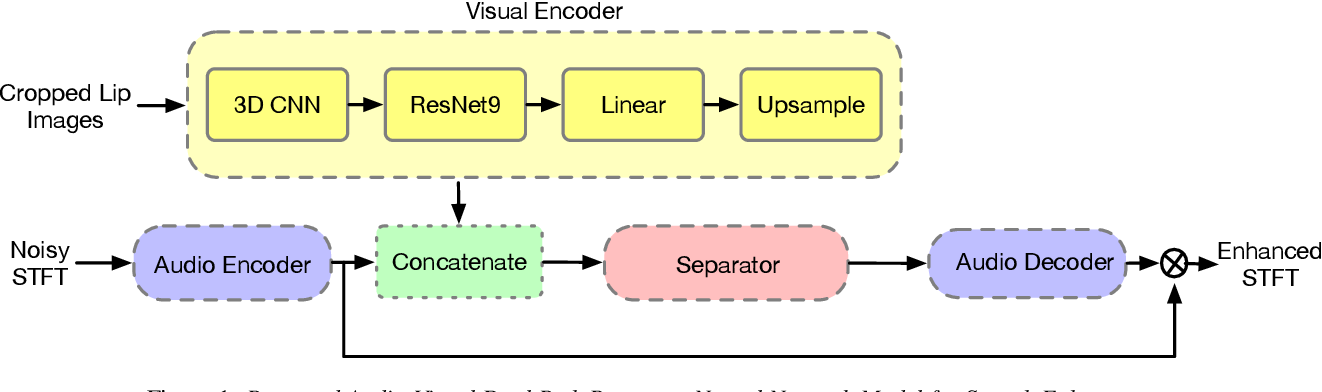
Figure 1 from A Lightweight Real-time Audio-Visual Speech Enhancement ...
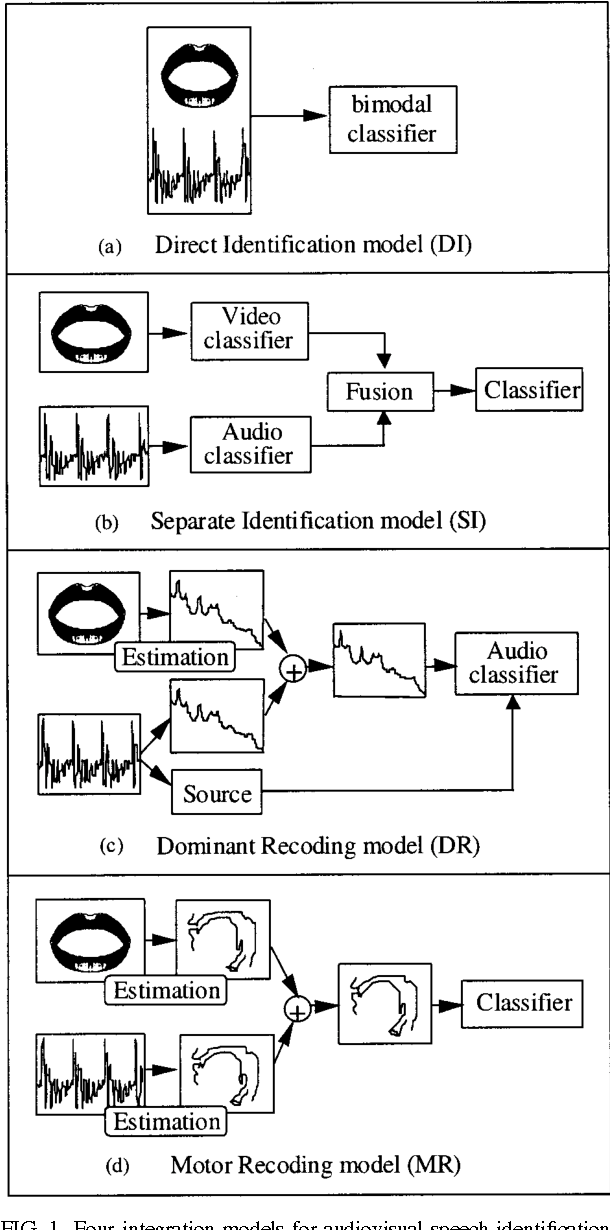
Figure 1 from Audio-visual enhancement of speech in noise. | Semantic ...

Figure 1 from Audio-visual speech recognition in noisy audio ...

Figure 1 from Self-supervised Learning of Visual Speech Features with ...

Figure 1 from Speech enhancement based on neural networks improves ...
Advertisement Space (336x280)
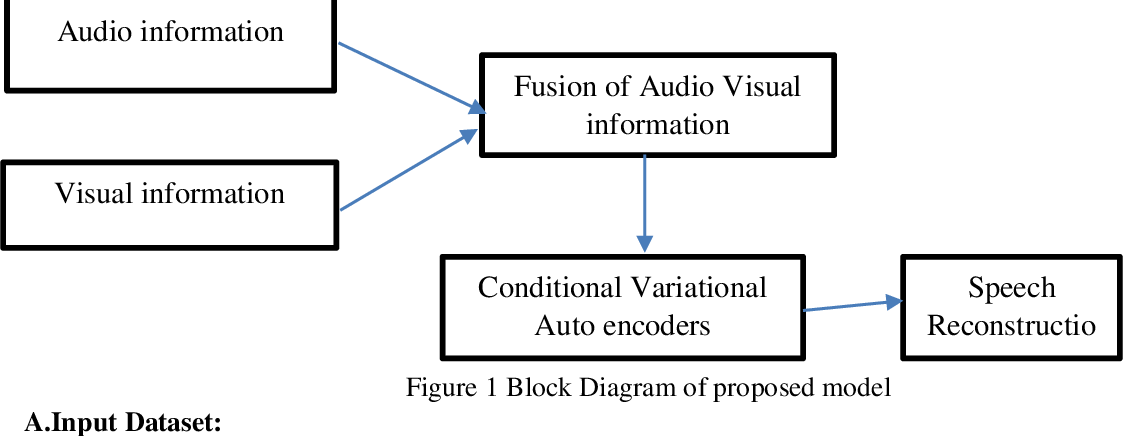
Figure 1 from SPEECH ENHANCEMENT USING DEEP LEARNING AVE-NET | Semantic ...

Figure 1 from Lightweight End-to-End Speech Enhancement Generative ...

Figure 1 from An End-to-End Mandarin Audio-Visual Speech Recognition ...

Figure 1 from Dynamic Audio-Visual Speech Enhancement using Recurrent ...
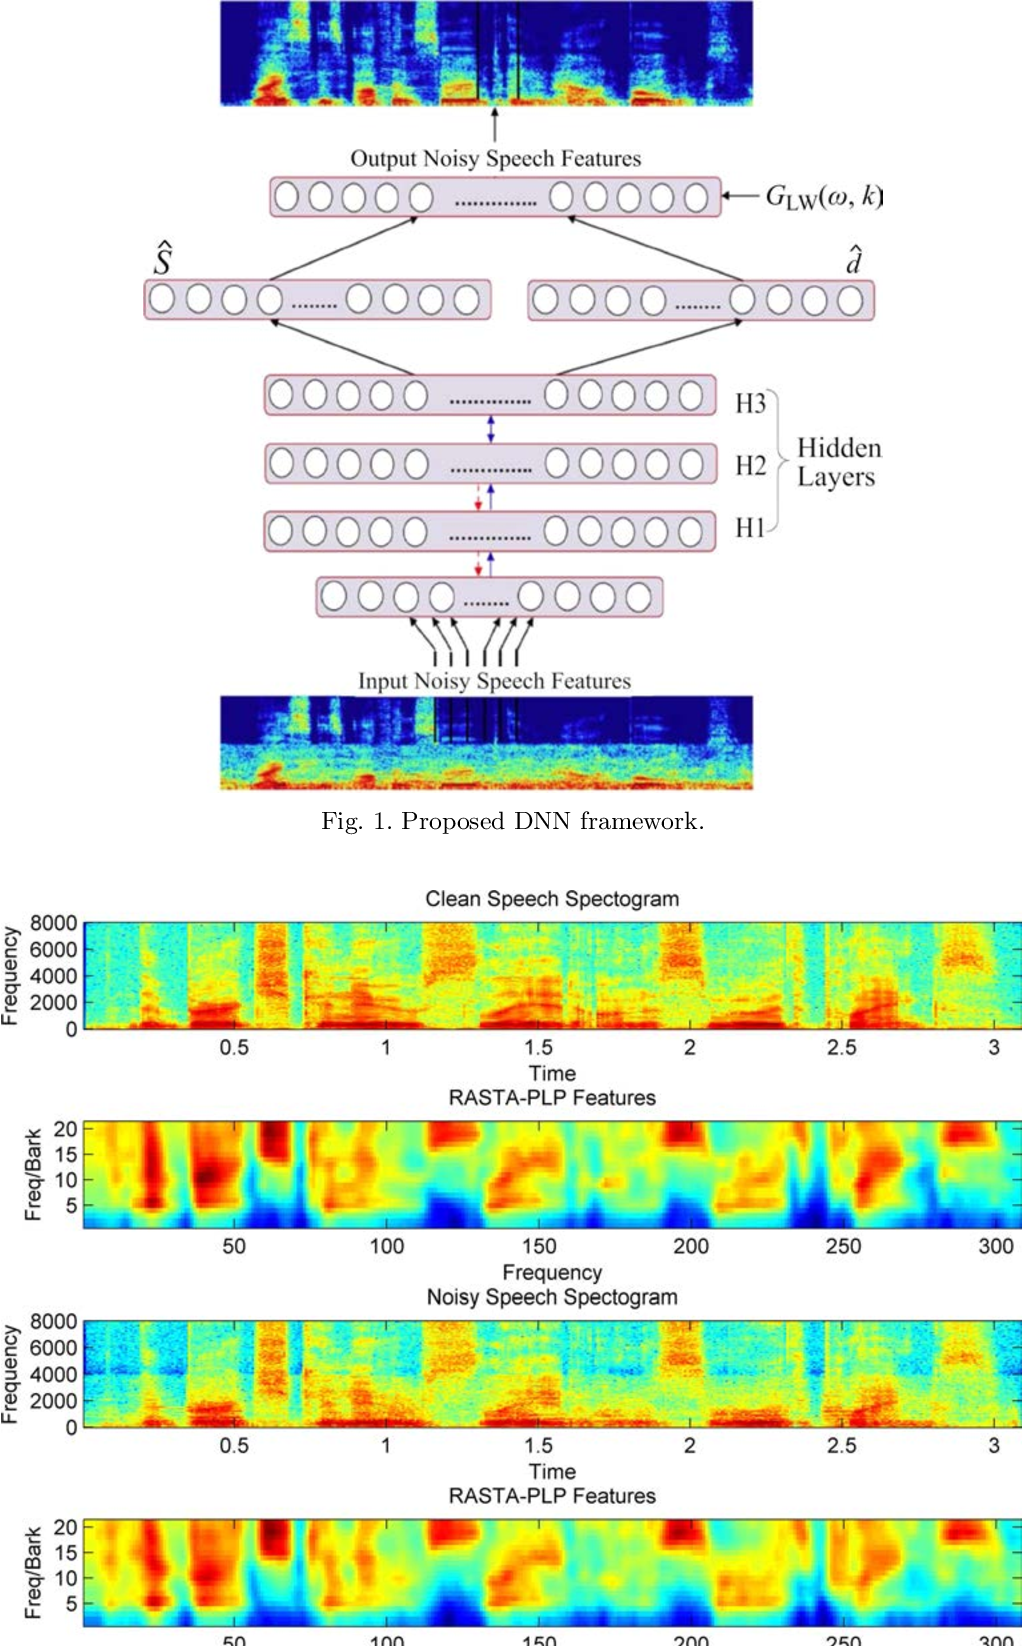
Figure 1 from Deep Neural Network for Supervised Single-Channel Speech ...

Figure 1 from Deep Neural Network Based Multi-Channel Speech ...

Figure 1 from Combined speech enhancement and auditory modelling for ...

Figure 1 from An Improved End-to-End Audio-Visual Speech Recognition ...

Figure 1 from MFFCN: Multi-layer Feature Fusion Convolution Network for ...
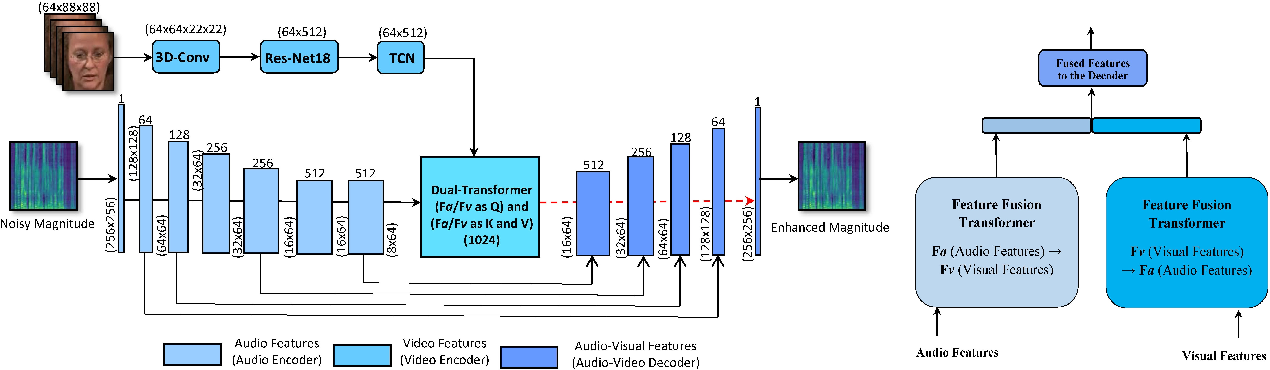
Figure 1 from Multi-Model Dual-Transformer Network for Audio-Visual ...
Advertisement Space (336x280)

Figure 1 from Multi-Task Joint Learning for Embedding Aware Audio ...

Figure 1 from Cooperative Dual Attention for Audio-Visual Speech ...

Figure 1 from Multimodal Sparse Transformer Network for Audio-Visual ...

Efficient and Adaptable Speech Enhancement via Pre-trained Generative ...

Figure 1 from Evaluation of real-time audio-visual speech recognition ...

Figure 1 from Incorporating Visual Information Reconstruction into ...