
Figure 1 From An End To End Transformer Based Model For Interactive

Figure 1 from An End-to-end Transformer-based Model for Interactive ...

Figure 1 from End-to-End Transformer Based Model for Image Captioning ...

Figure 1 from End-to-End Transformer Based Model for Image Captioning ...

Figure 1 from A Heterogeneous Chiplet Architecture for Accelerating End ...

Figure 3 from An End-to-end Transformer-based Model for Interactive ...

Table 1 from End-to-End Transformer Based Model for Image Captioning ...

Table 1 from An End-to-end Transformer-based Model for Interactive ...

Figure 1 from A Heterogeneous Chiplet Architecture for Accelerating End ...
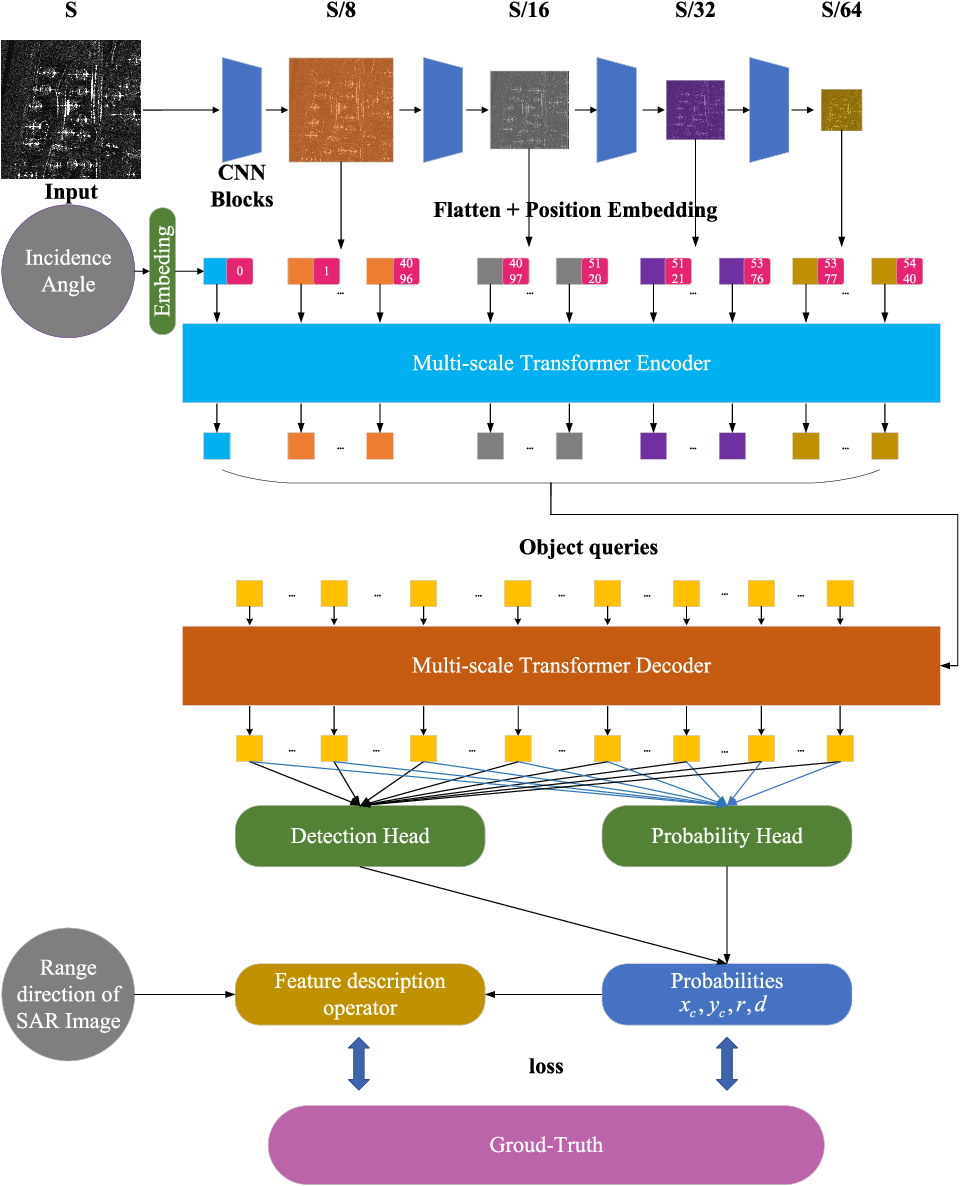
Figure 1 from End-to-End Method With Transformer for 3-D Detection of ...

Table 2 from An End-to-end Transformer-based Model for Interactive ...
Advertisement Space (300x250)

Figure 1 from TransCAD: A Hierarchical Transformer for CAD Sequence ...

Table 6 from End-to-End Transformer Based Model for Image Captioning ...

Table 4 from End-to-End Transformer Based Model for Image Captioning ...

Figure 1 from CLTR: An End-to-End, Transformer-Based System for Cell ...

End-to-End Transformer Based Model for Image Captioning

An end-to-end transformer model for dense video captioning [222]. The ...
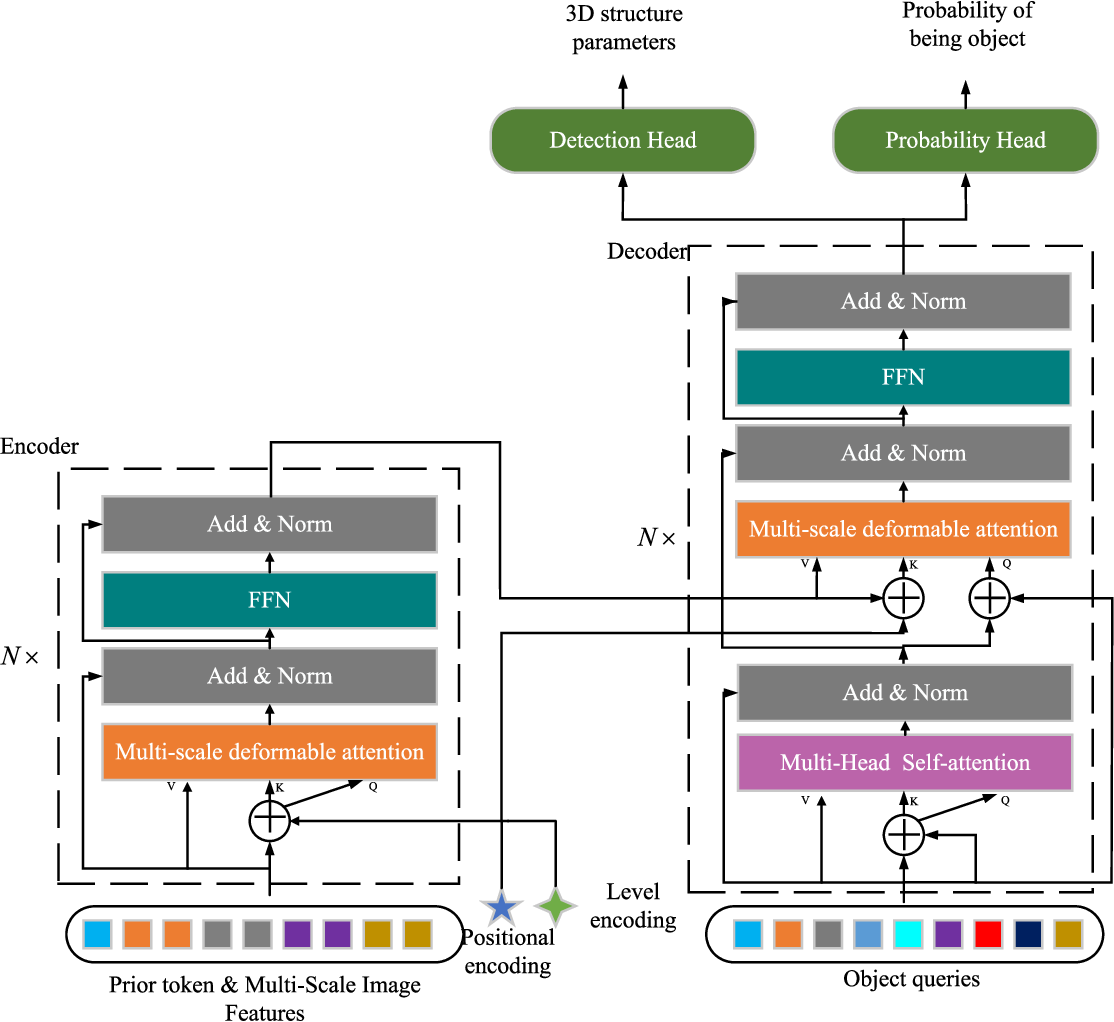
Figure 4 from End-to-End Method With Transformer for 3-D Detection of ...

Figure 1 from Neural Interaction Energy for Multi-Agent Trajectory ...

Figure 1 from OrientedFormer: An End-to-End Transformer-Based Oriented ...

(PDF) An End-to-End Transformer Model for Crowd Localization
Advertisement Space (336x280)
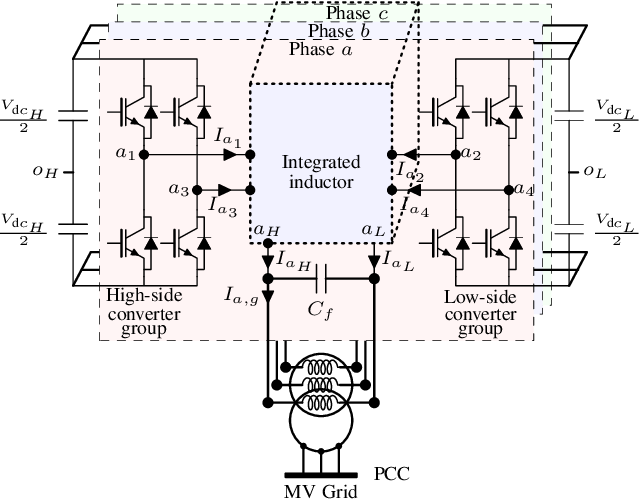
Figure 1 from Dual Converter Fed Open-End Transformer Topology with ...
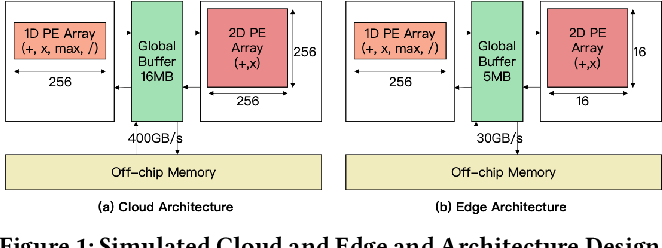
Figure 1 from TransFusion: End-to-End Transformer Acceleration via ...

An end-to-end transformer model for dense video captioning [222]. The ...

Figure 1 from End-to-End Temporal Action Detection With Transformer ...

End-to-End Transformer Based Model for Image Captioning
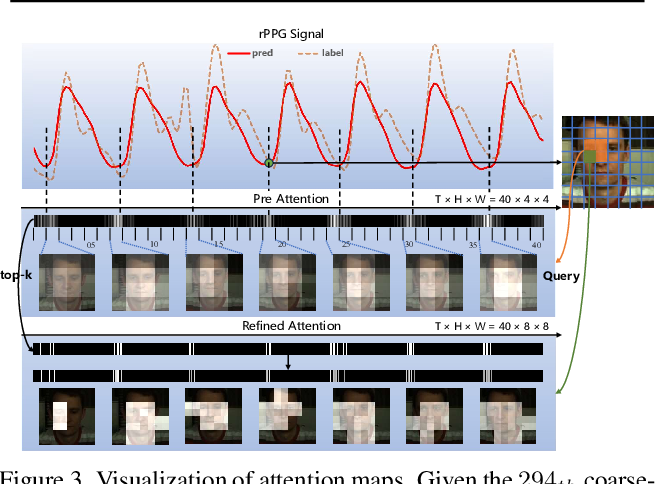
Figure 1 from RhythmFormer: Extracting rPPG Signals Based on ...
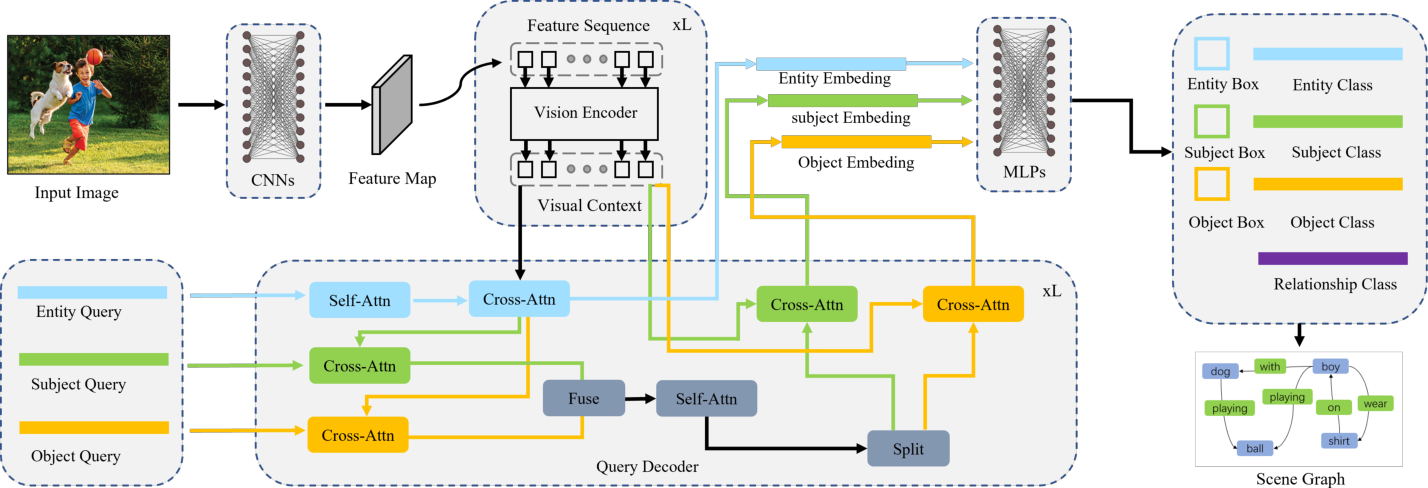
Figure 2 from A Novel End-to-End Transformer for Scene Graph Generation ...

Figure 1 from End-to-End Pedestrian Trajectory Forecasting with ...

Figure 1 from LatentFormer: Multi-Agent Transformer-Based Interaction ...
InterAcT: A generic keypoints-based lightweight transformer model for ...
Advertisement Space (336x280)

Figure 1 from Looking Beyond Two Frames: End-to-End Multi-Object ...

Figure 1 from MotionTrack: End-to-End Transformer-based Multi-Object ...

Figure 2 from Interactive Grid Interfacing System by Matrix-Converter ...
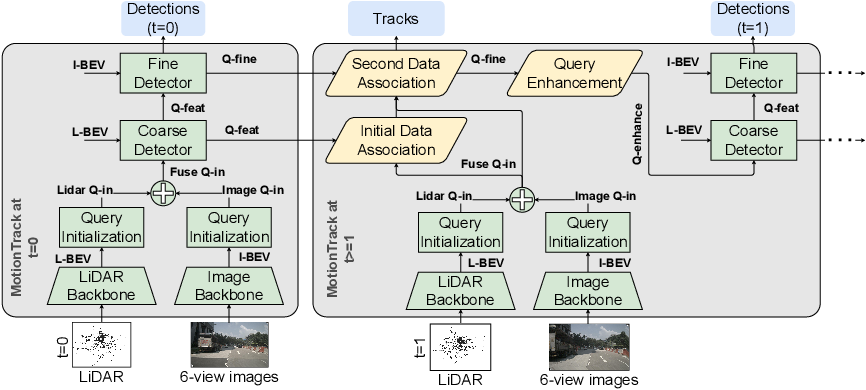
Figure 1 from MotionTrack: End-to-End Transformer-based Multi-Object ...

DLAFormer: An End-to-End Transformer For Document Layout Analysis | AI ...
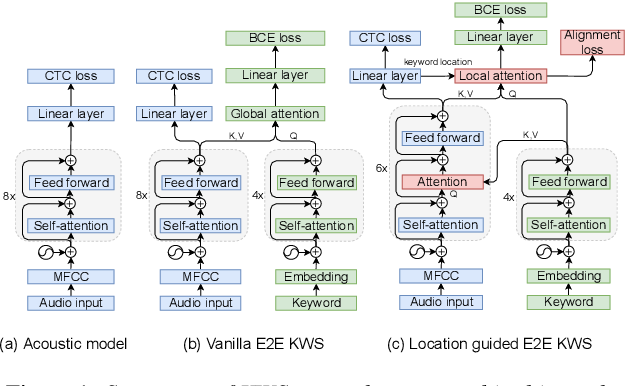
Figure 1 from End-to-End Transformer-Based Open-Vocabulary Keyword ...