
Figure 1 From Are Vision Language Transformers Learning Multimodal

Figure 1 from Are Vision-Language Transformers Learning Multimodal ...

Figure 1 from Are Vision-Language Transformers Learning Multimodal ...

Table 1 from Are Vision-Language Transformers Learning Multimodal ...

Figure 2 from Are Vision-Language Transformers Learning Multimodal ...

Figure 1 from Evaluation of Vision Transformers for Multimodal Image ...

Figure 1 from A Foundational Multimodal Vision Language AI Assistant ...

Figure 1 from Brain encoding models based on multimodal transformers ...

Table 2 from Are Vision-Language Transformers Learning Multimodal ...

Figure 1 from Dynamic Multimodal Prototype Learning in Vision-Language ...

Table 8 from Are Vision-Language Transformers Learning Multimodal ...
Advertisement Space (300x250)

Table 10 from Are Vision-Language Transformers Learning Multimodal ...

Table 7 from Are Vision-Language Transformers Learning Multimodal ...
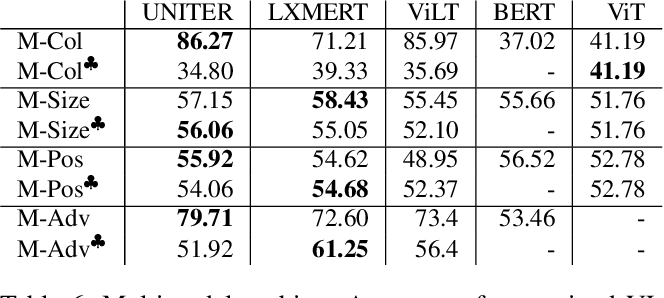
Table 6 from Are Vision-Language Transformers Learning Multimodal ...

Figure 2 from Meta Learning to Bridge Vision and Language Models for ...
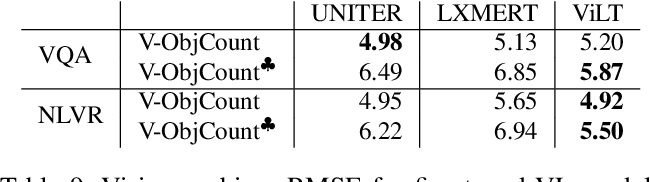
Table 9 from Are Vision-Language Transformers Learning Multimodal ...

Figure 1 from History Aware Multimodal Transformer for Vision-and ...
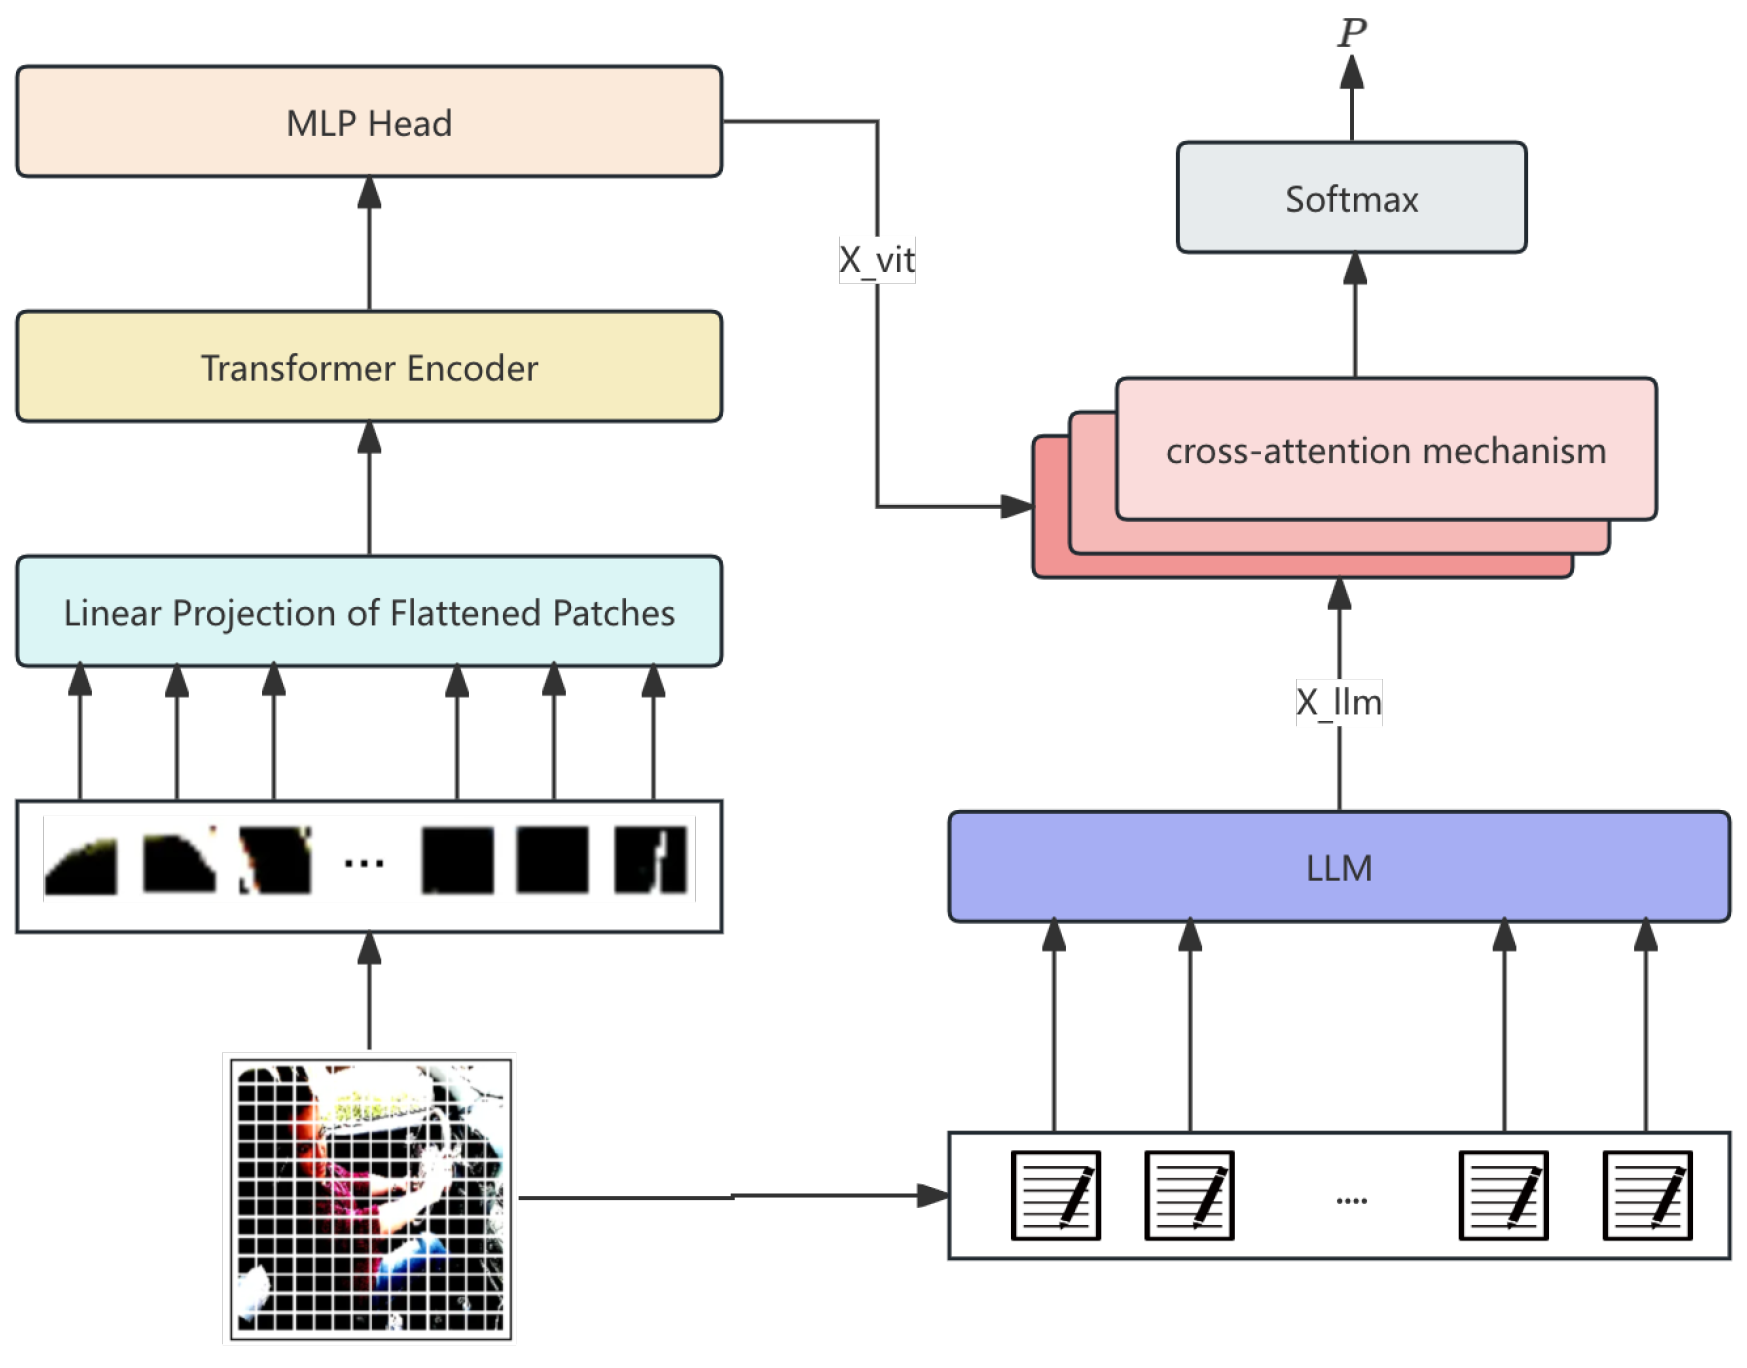
MLIF-Net: Multimodal Fusion of Vision Transformers and Large Language ...
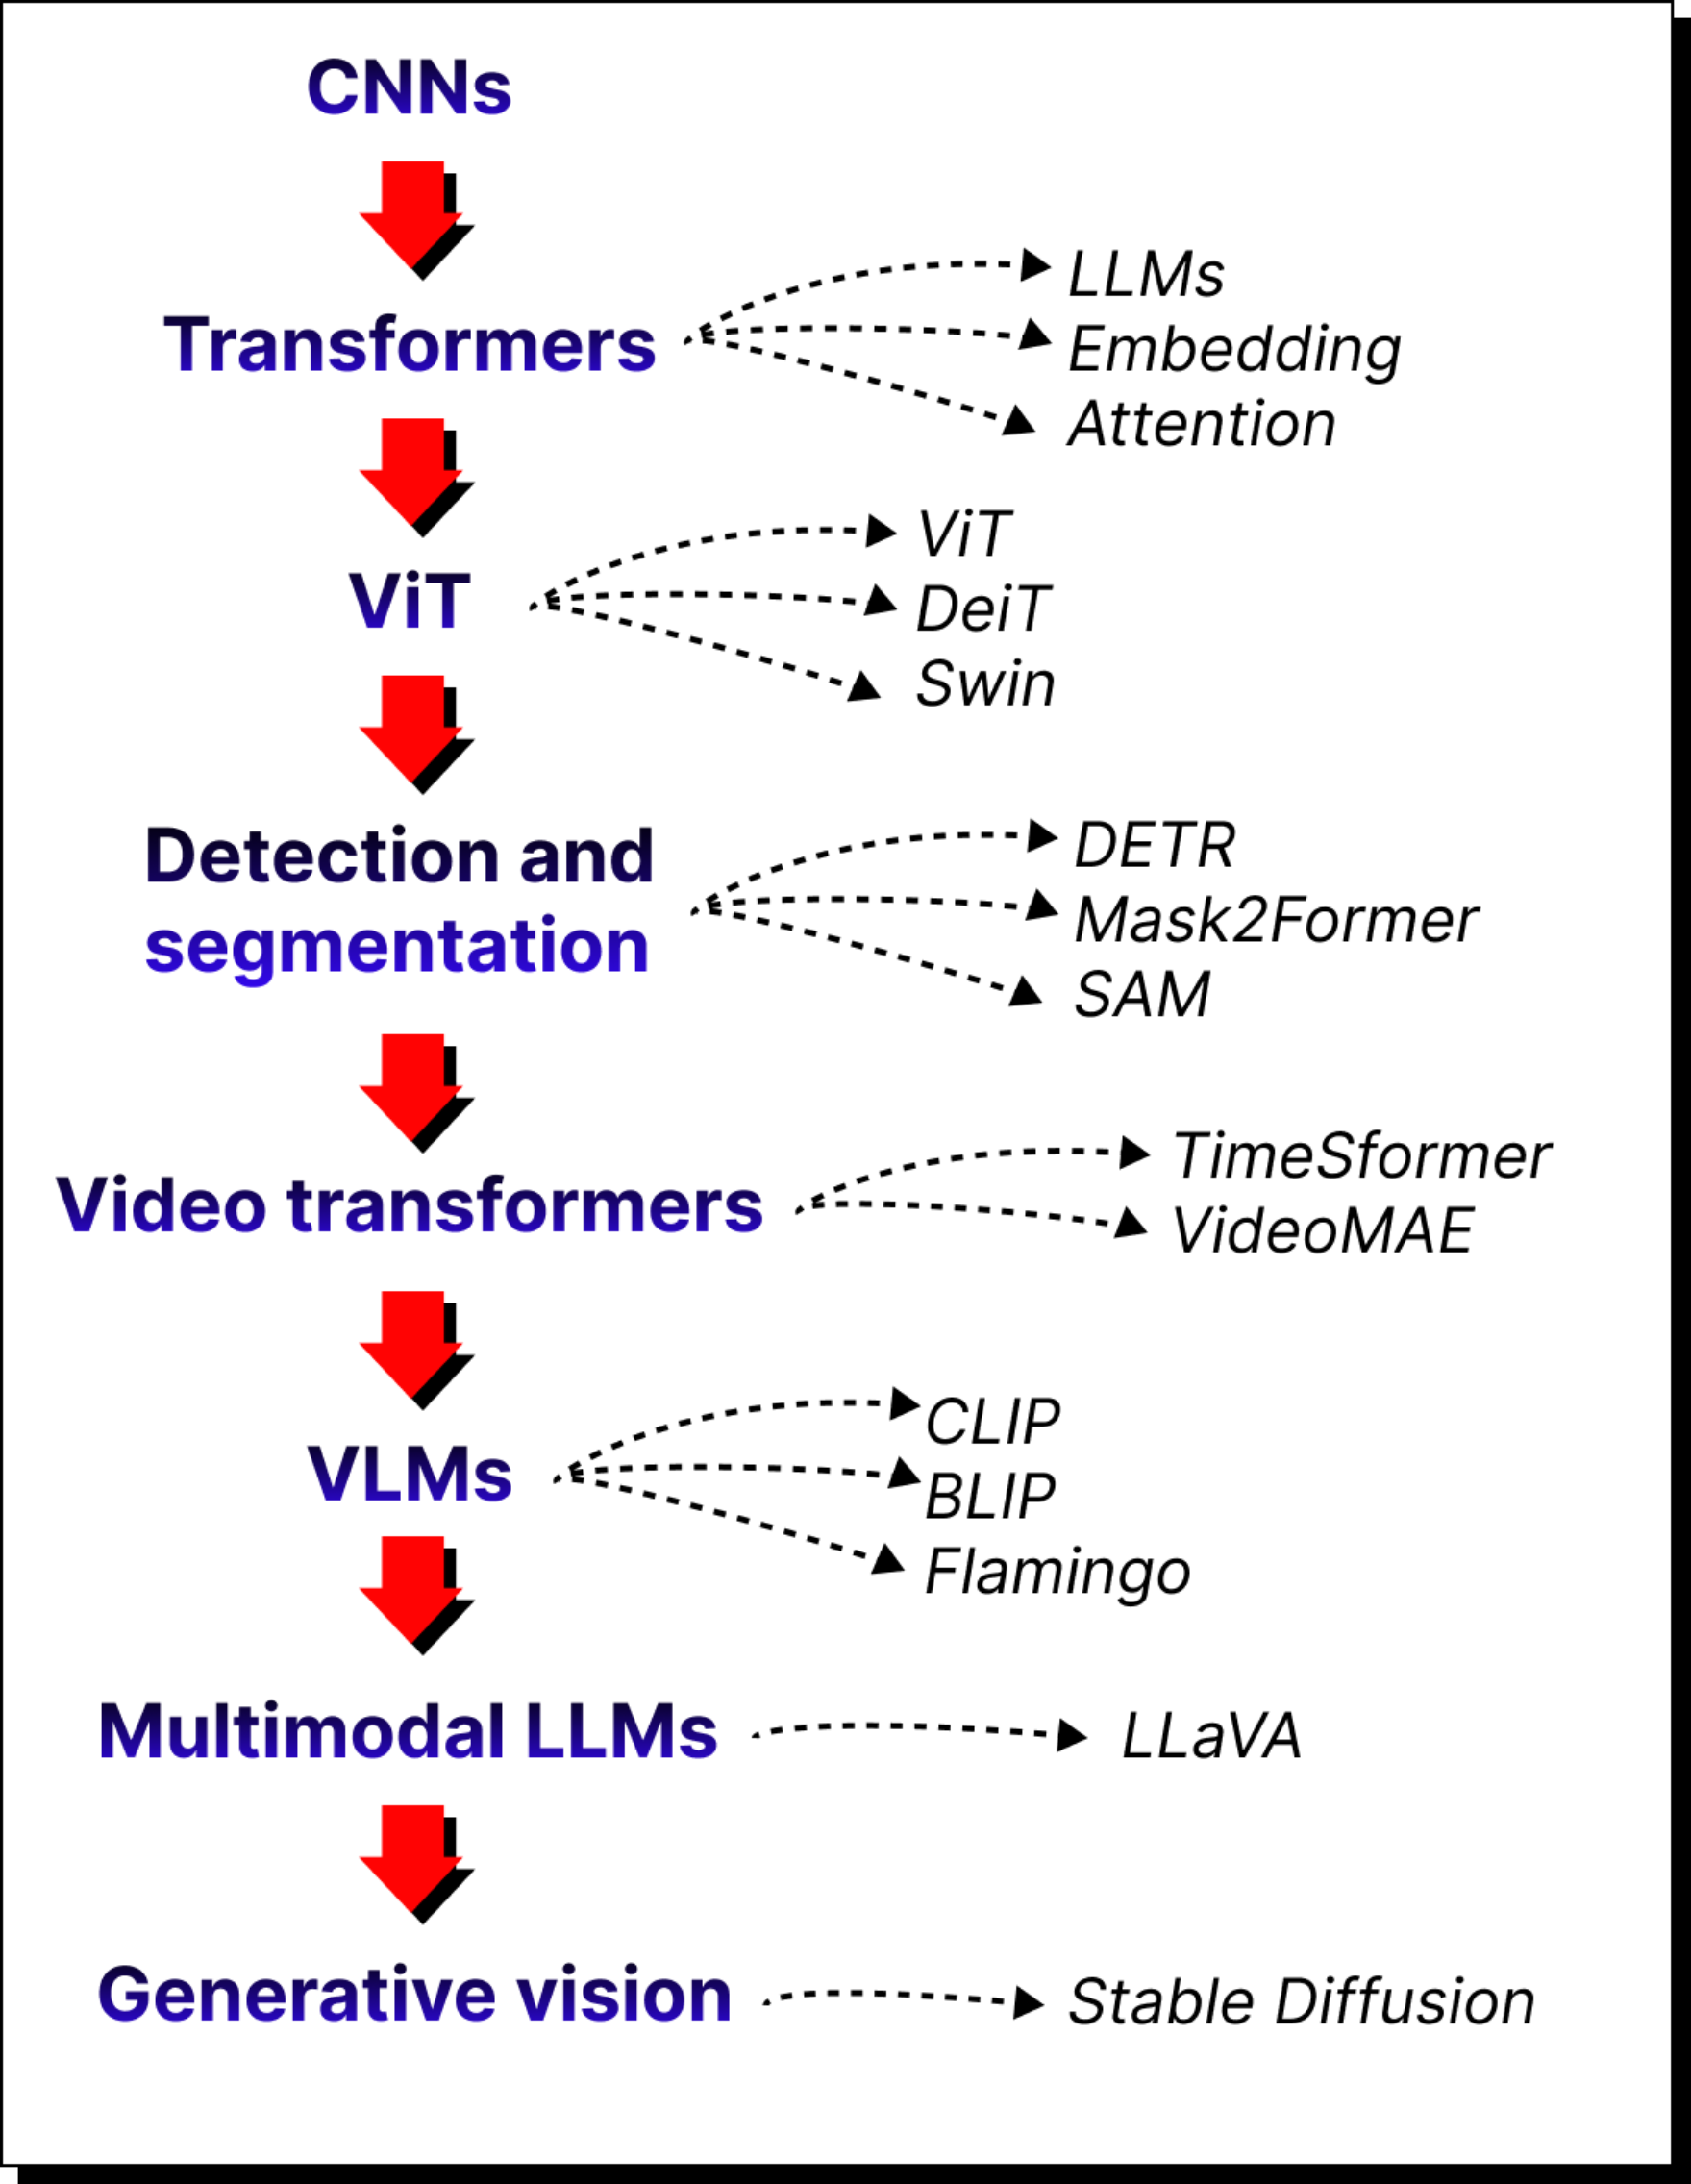
Transformers for Vision and Multimodal LLMs: Lecture 1

Figure 1 from History Aware Multimodal Transformer for Vision-and ...

(PDF) Are Vision-Language Transformers Learning Multimodal ...
Advertisement Space (336x280)

Figure 1 from Multimodal Locally Enhanced Transformer for Continuous ...

Figure 1 from Language Query-Based Transformer With Multiscale Cross ...

Figure 2 from Dynamic Multimodal Prototype Learning in Vision-Language ...
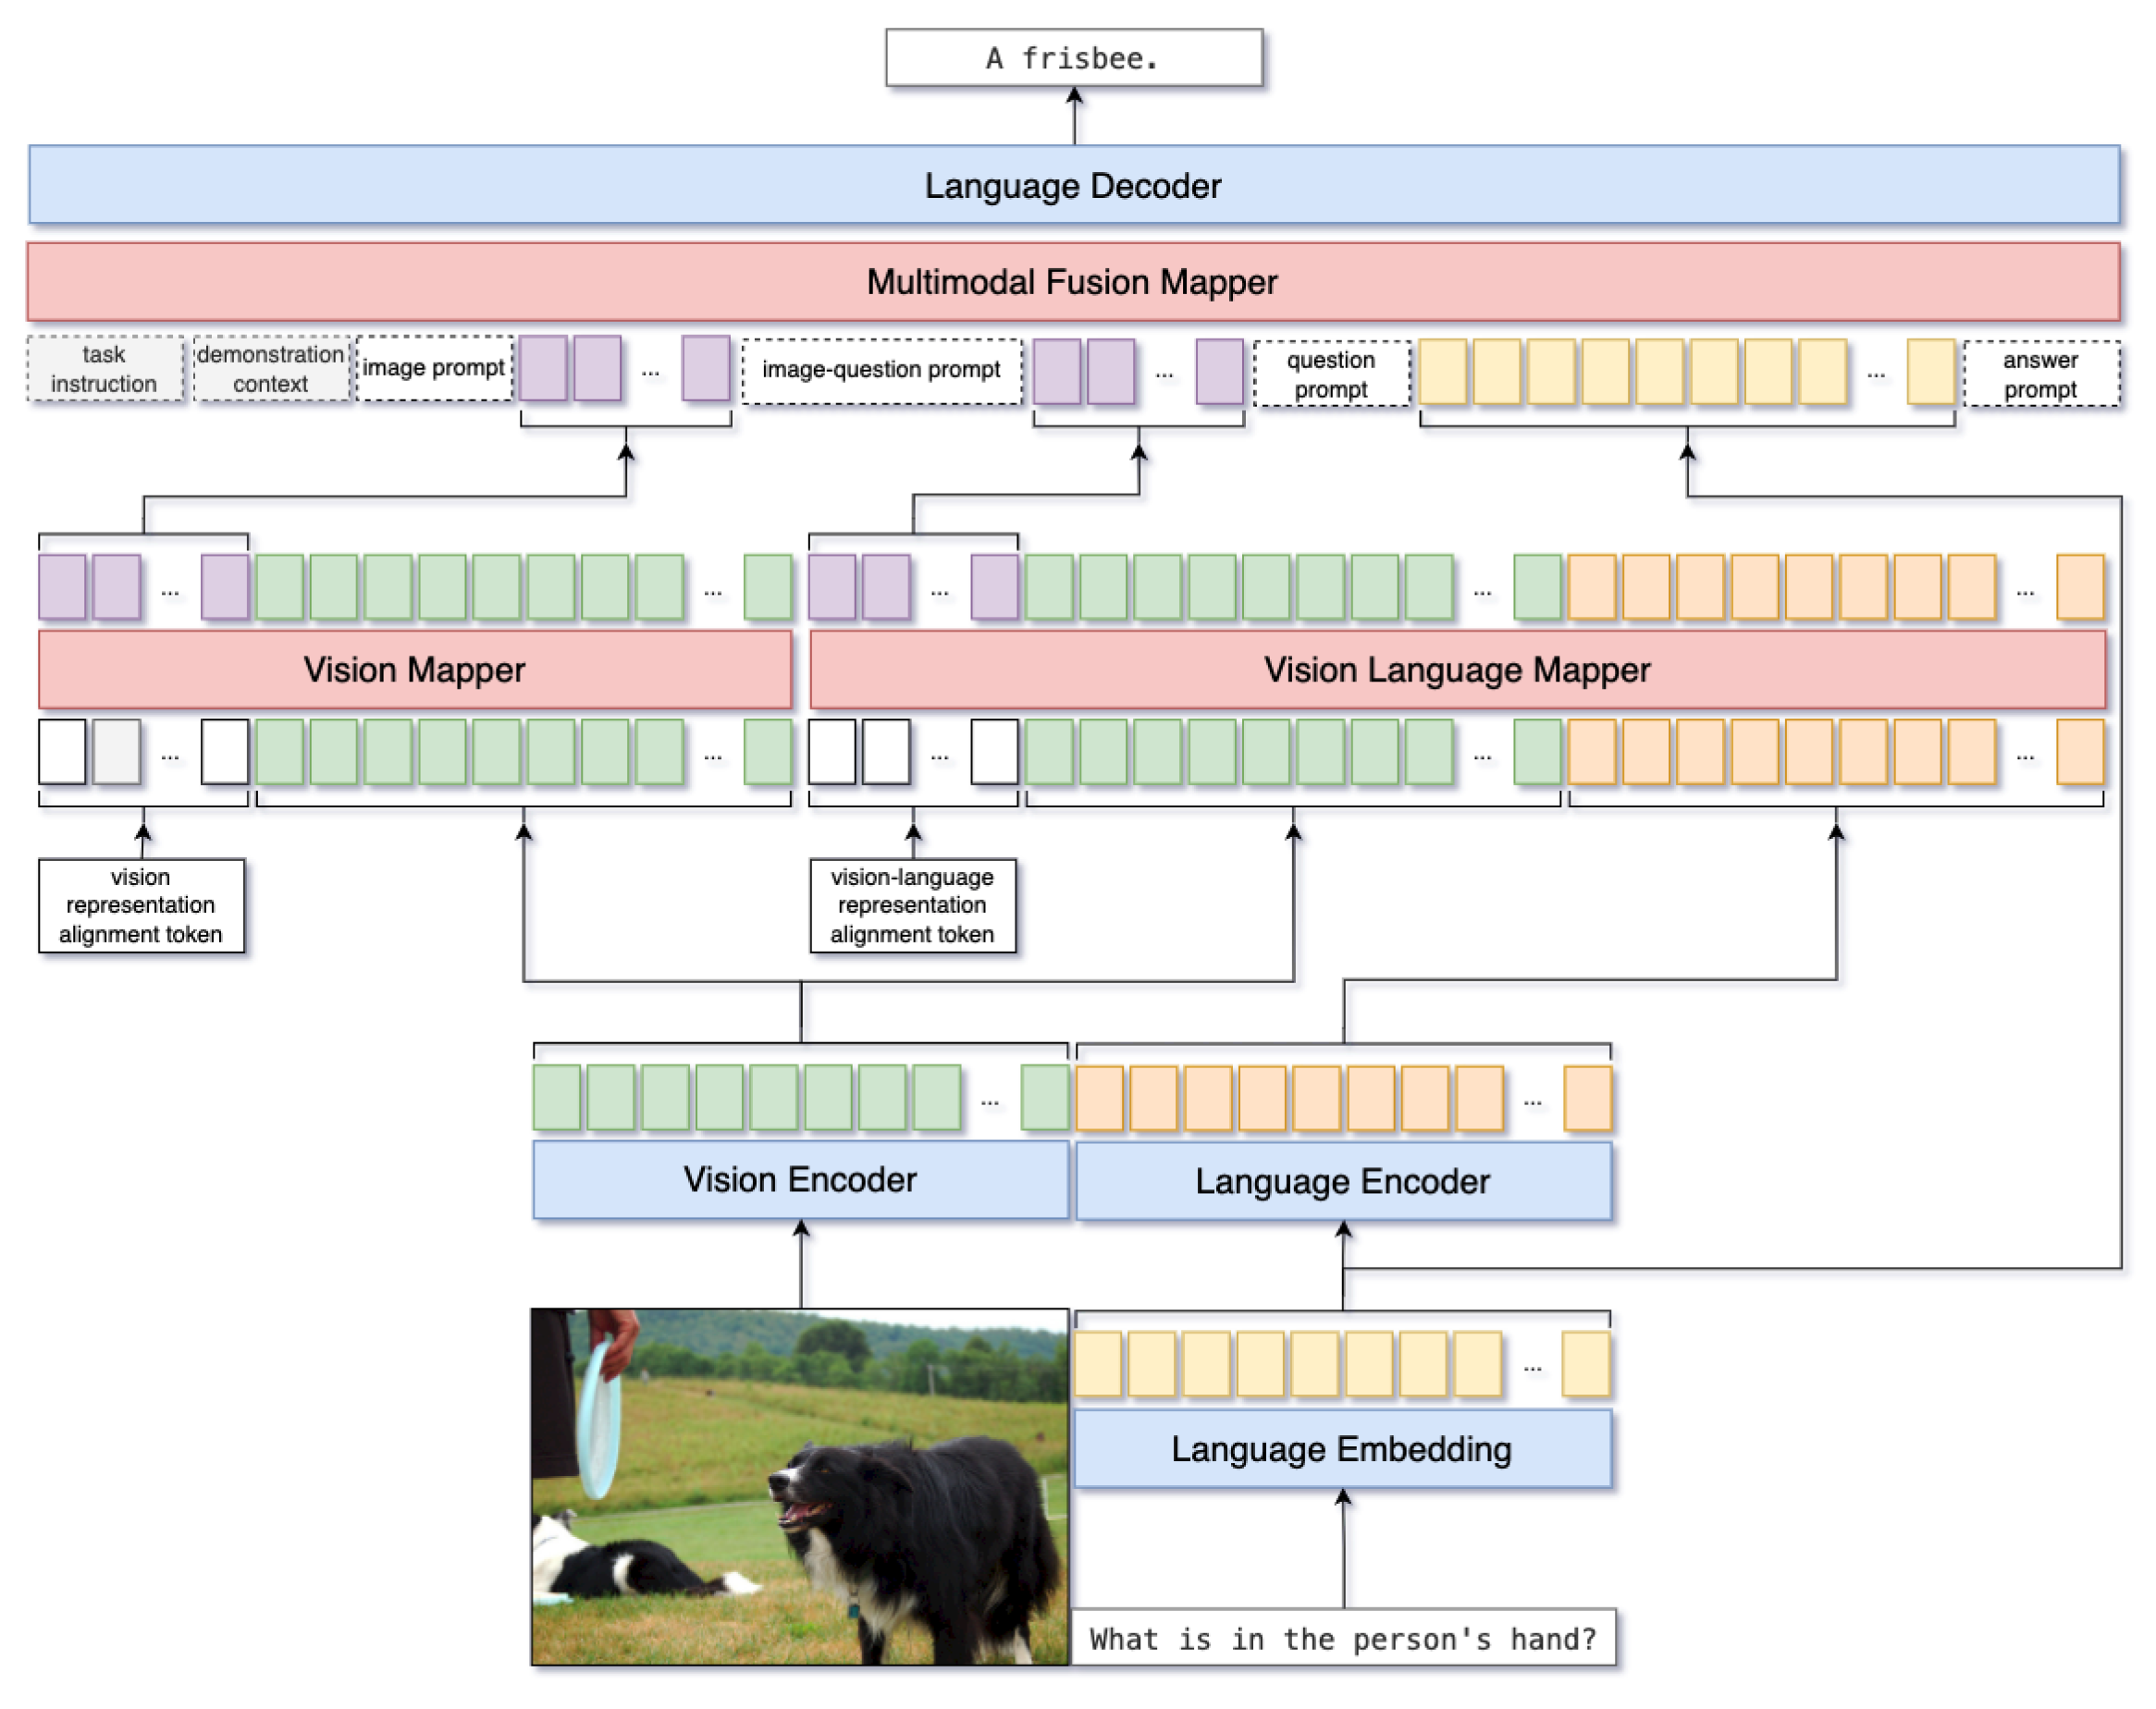
VL-Few: Vision Language Alignment for Multimodal Few-Shot Meta Learning

Figure 1 from Multimodal Transformer With Multi-View Visual ...

Figure 1 from History Aware Multimodal Transformer for Vision-and ...

Figure 1 from Improving Multi-modal Large Language Model through ...

Figure 1 from Vision-and-Language or Vision-for-Language? On Cross ...
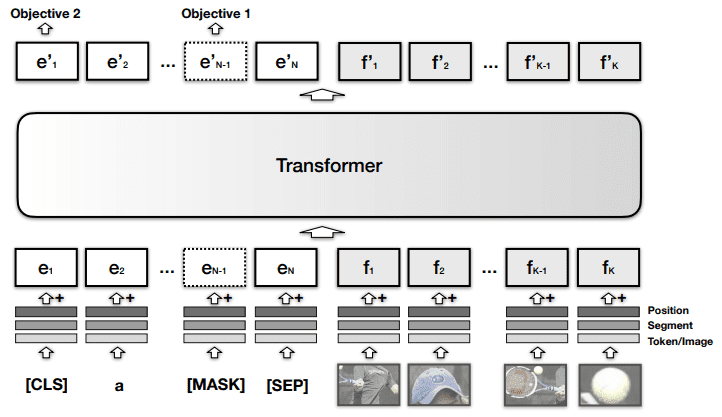
Vision Language models: towards multi-modal deep learning | AI Summer

Amazon.com: Mastering Vision Transformers and Multimodal AI ...
Advertisement Space (336x280)

Multimodal Learning With Transformers A Survey | PDF | Artificial ...

(PDF) Vision Meets Language: Multimodal Transformers Elevating ...

Vision transformer-based fuzzy semi-supervised multimodal learning for ...

Figure 1 from HSVLT: Hierarchical Scale-Aware Vision-Language ...

Figure 2 from DPL: Decoupled Prototype Learning for Enhancing ...
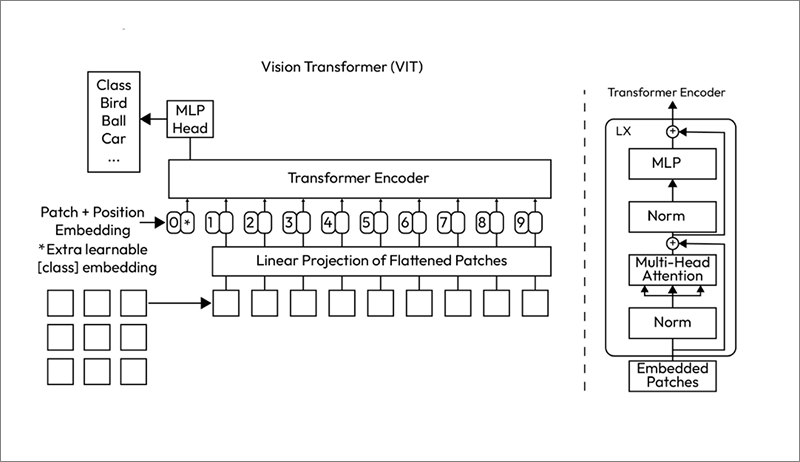
Transformers Beyond Text – Vision and Multimodal AI - Skillcurb