
Figure 1 From Atoken A Unified Tokenizer For Vision Semantic Scholar
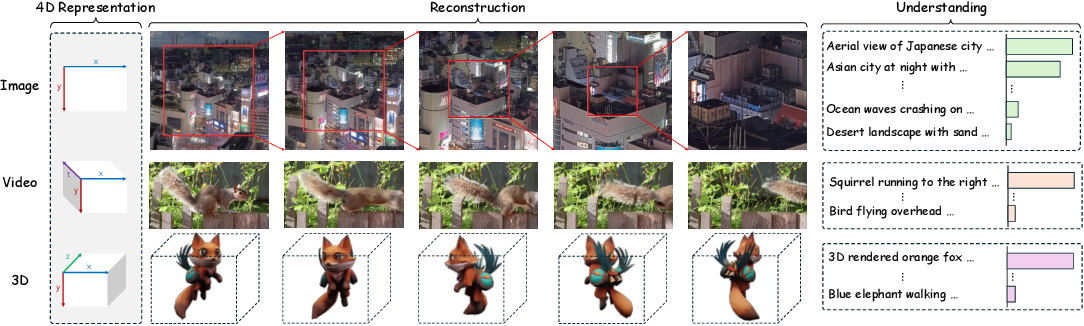
Figure 1 from AToken: A Unified Tokenizer for Vision | Semantic Scholar

Figure 1 from Robust Tokenizer for Vision Transformer | Semantic Scholar

Figure 1 from UniTok: A Unified Tokenizer for Visual Generation and ...

Figure 1 from StableToken: A Noise-Robust Semantic Speech Tokenizer for ...

Figure 2 from A Unified Sequence Interface for Vision Tasks | Semantic ...

Figure 1 from StableToken: A Noise-Robust Semantic Speech Tokenizer for ...
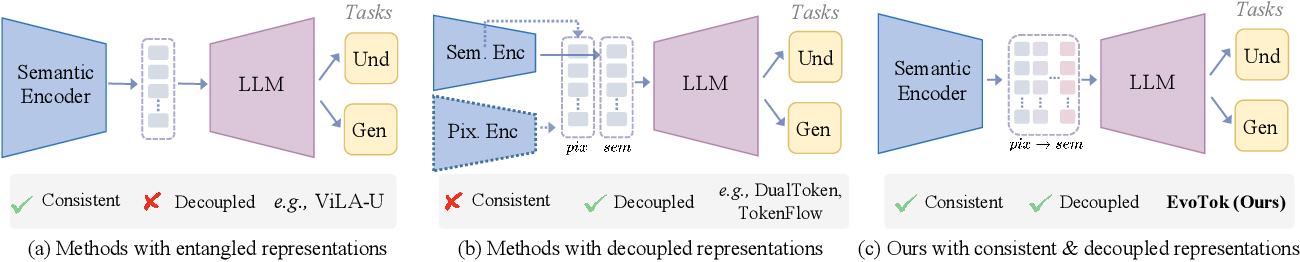
Figure 1 from EvoTok: A Unified Image Tokenizer via Residual Latent ...
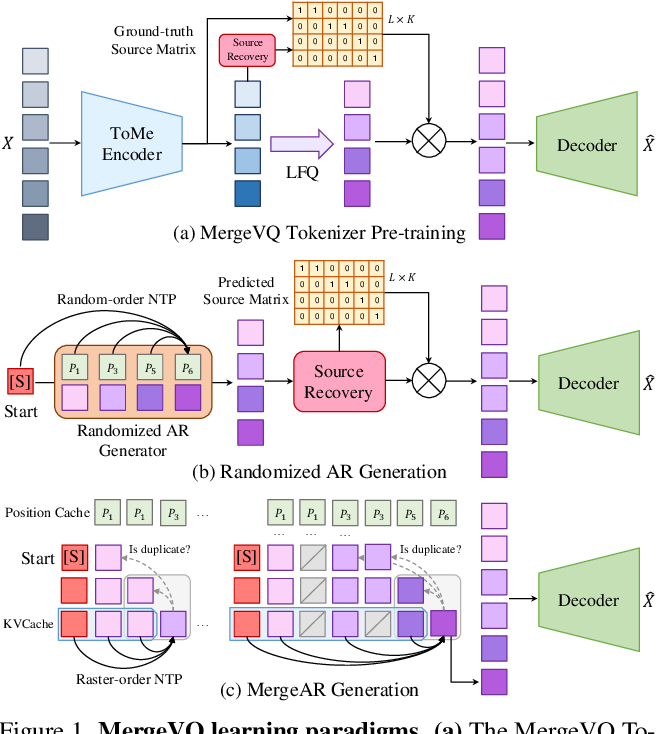
Figure 1 from MergeVQ: A Unified Framework for Visual Generation and ...
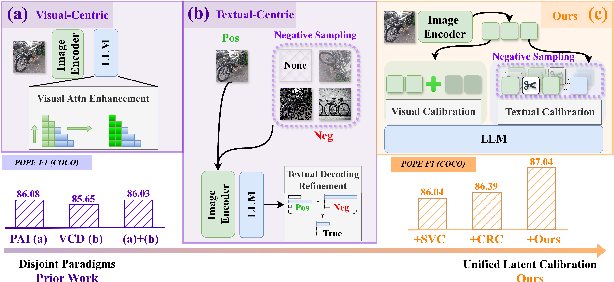
Figure 1 from One Token, Two Fates: A Unified Framework via Vision ...

Figure 1 from A Dual Stream Visual Tokenizer for LLM Image Generation ...
Advertisement Space (300x250)

Figure 1 from Token-Label Alignment for Vision Transformers | Semantic ...

AToken - A Unified Tokenizer for Vision by Apple | PDF | Data ...

Figure 1 from SpeechTokenizer: Unified Speech Tokenizer for Speech ...

Figure 1 from Unified Vision and Language Prompt Learning | Semantic ...
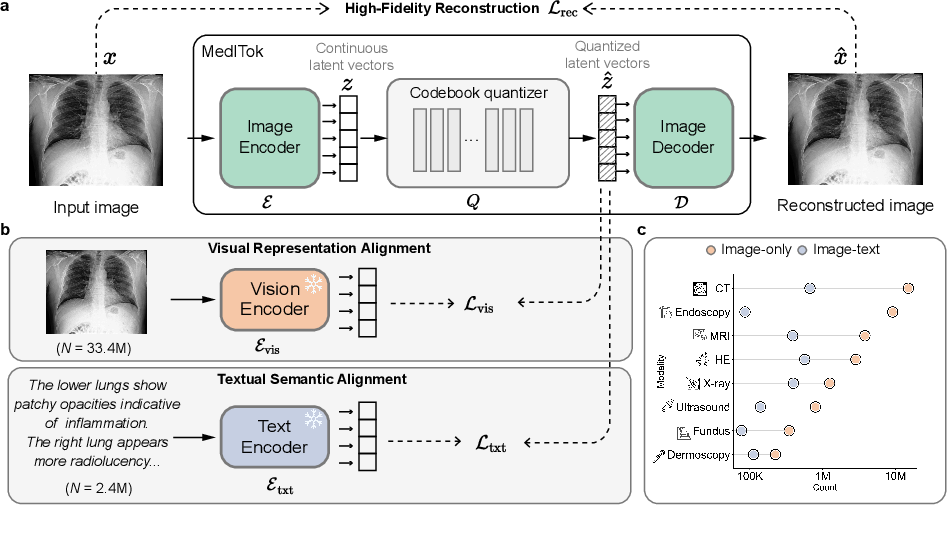
Figure 1 from Unified Medical Image Tokenizer for Autoregressive ...
SOLUTION: Atoken a unified tokenizer for vision - Studypool
SOLUTION: Atoken a unified tokenizer for vision - Studypool
SOLUTION: Atoken a unified tokenizer for vision - Studypool
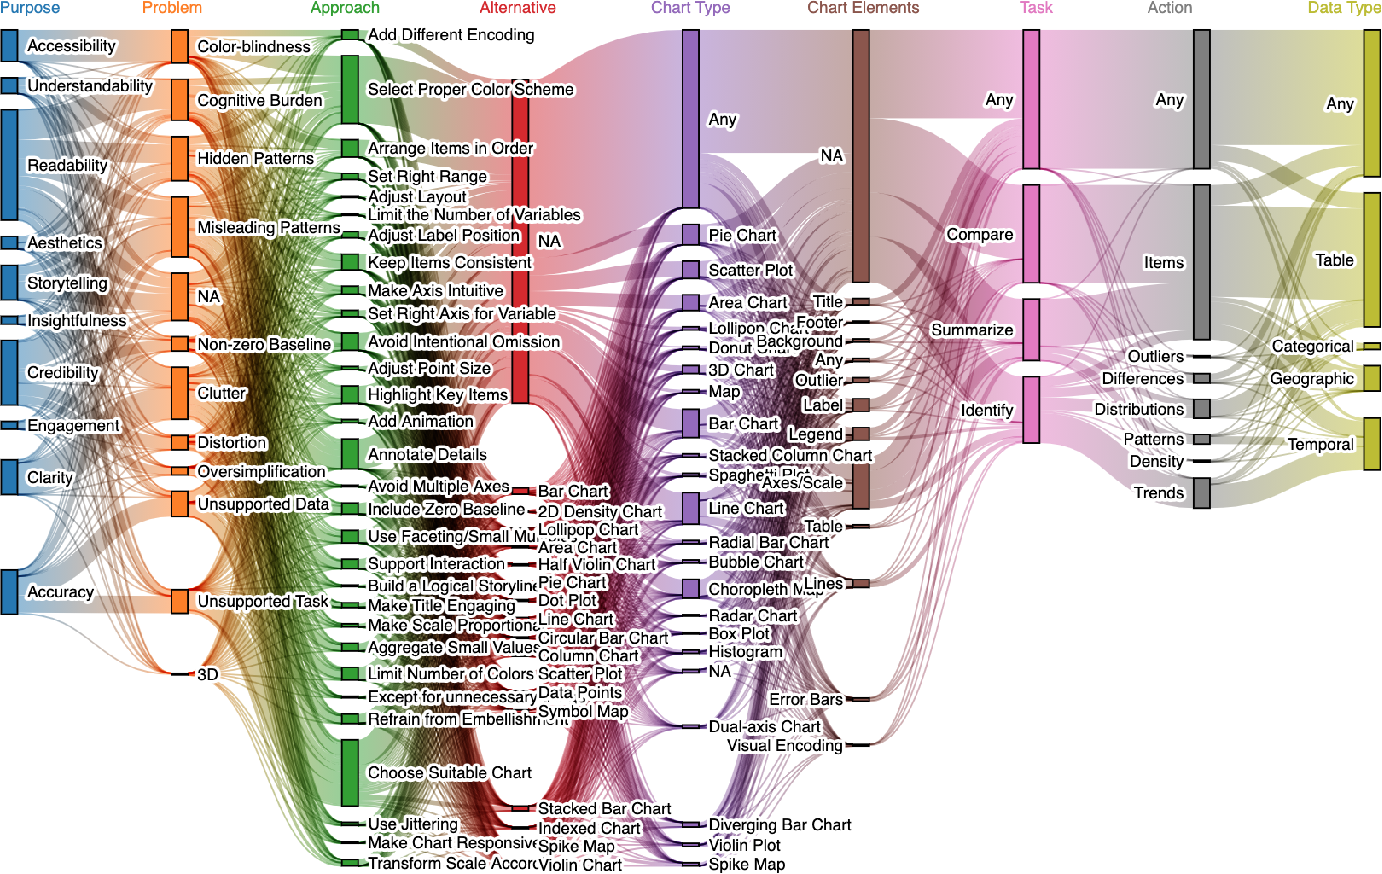
Figure 1 from Toward a Unified Framework for Visualization Design ...

Figure 2 from StableToken: A Noise-Robust Semantic Speech Tokenizer for ...
Advertisement Space (336x280)
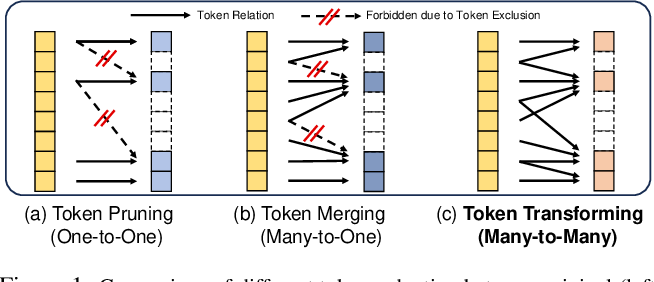
Figure 1 from Token Transforming: A Unified and Training-Free Token ...
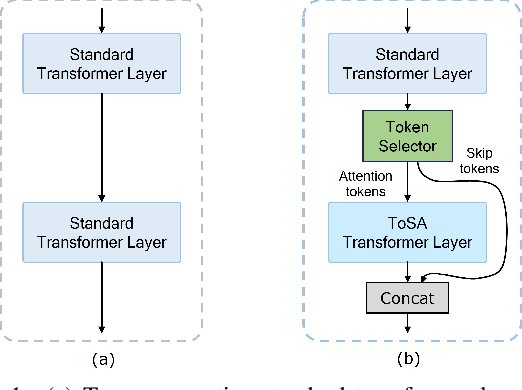
Figure 1 from ToSA: Token Selective Attention for Efficient Vision ...
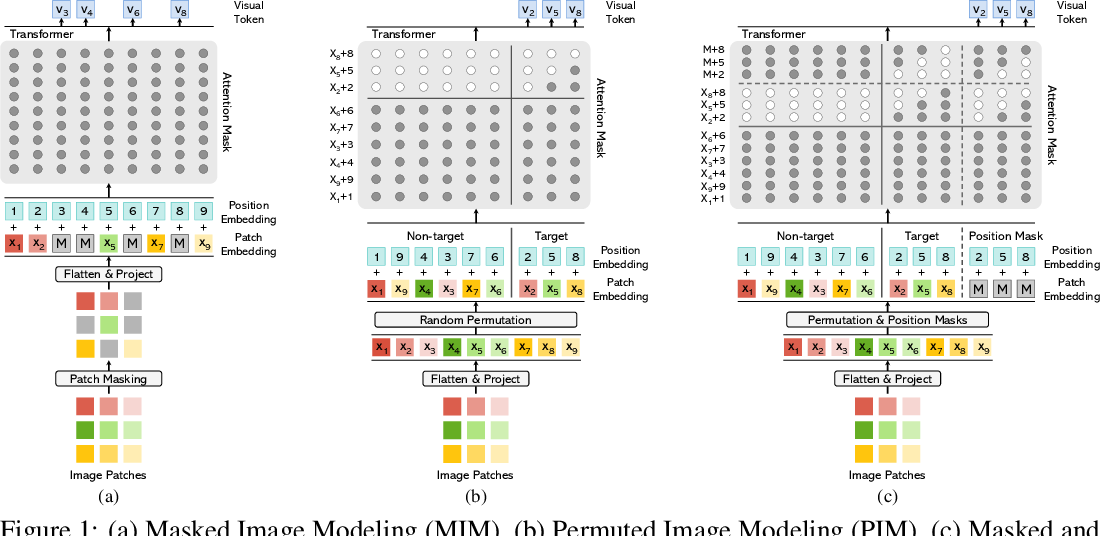
Figure 1 from Learning to Mask and Permute Visual Tokens for Vision ...

Figure 1 from Content-aware Token Sharing for Efficient Semantic ...

Figure 1 from Visual Concepts Tokenization | Semantic Scholar

Figure 1 from Content-aware Token Sharing for Efficient Semantic ...
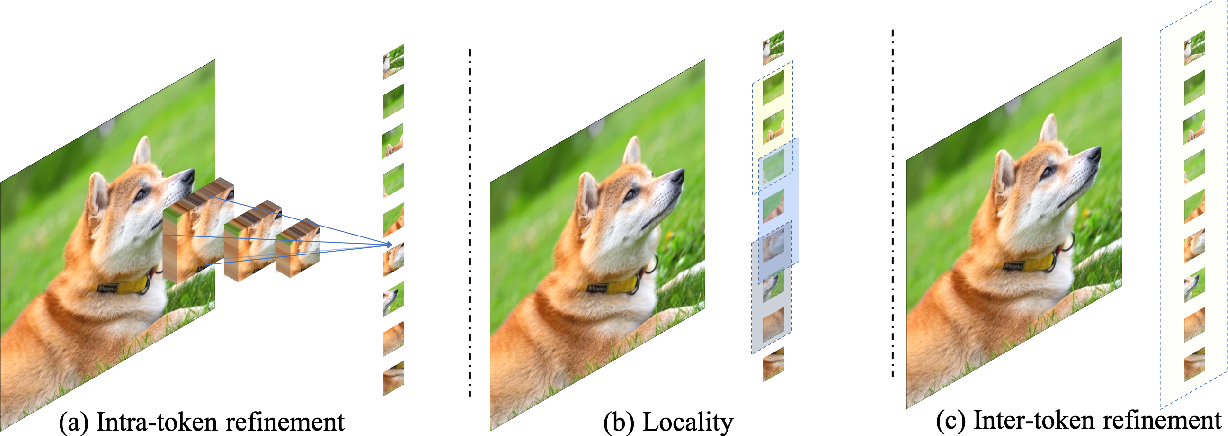
Figure 1 from What Makes for Good Tokenizers in Vision Transformer ...

Figure 1 from Token Pooling in Vision Transformers for Image ...

Paper page - AToken: A Unified Tokenizer for Vision
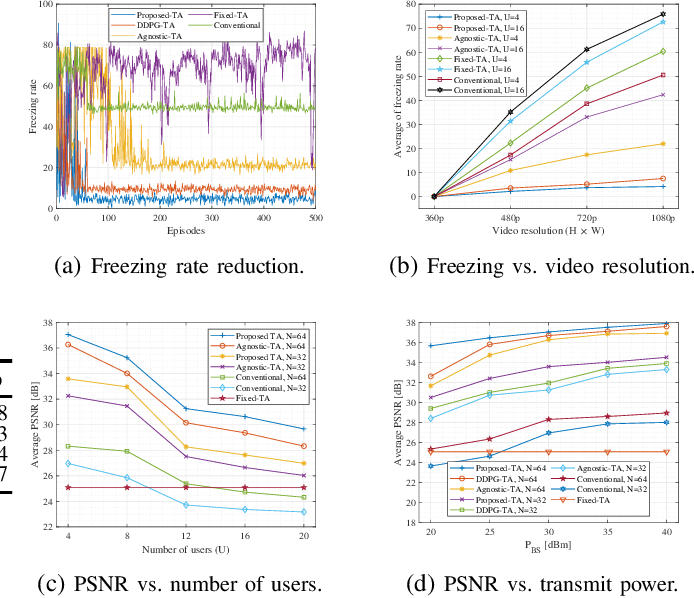
Figure 1 from Wireless TokenCom: RL-Based Tokenizer Agreement for Multi ...
Advertisement Space (336x280)

Figure 1 from Token Merging: Your ViT But Faster | Semantic Scholar

Figure 1 from Subobject-level Image Tokenization | Semantic Scholar
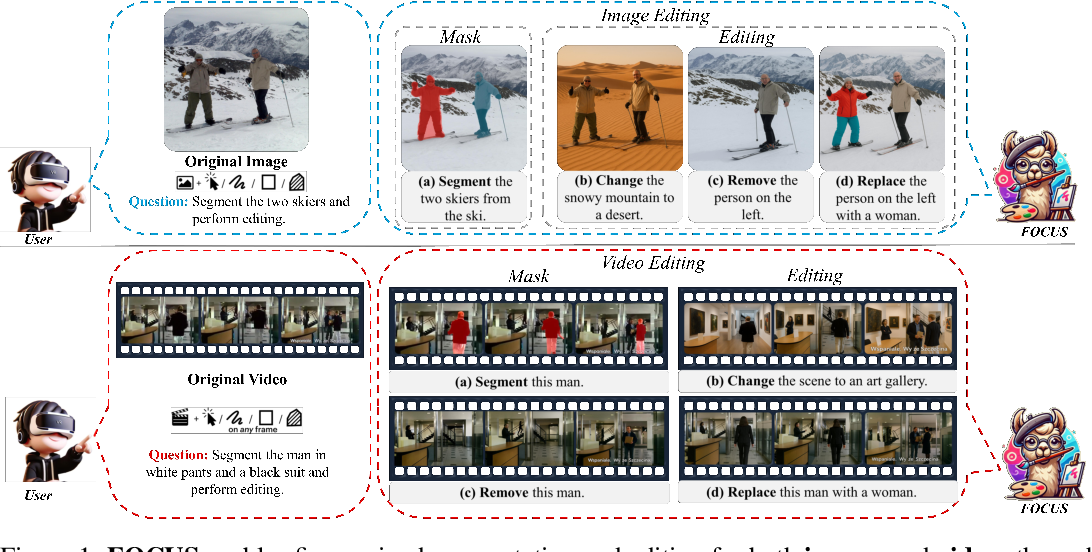
Figure 1 from FOCUS: Unified Vision-Language Modeling for Interactive ...
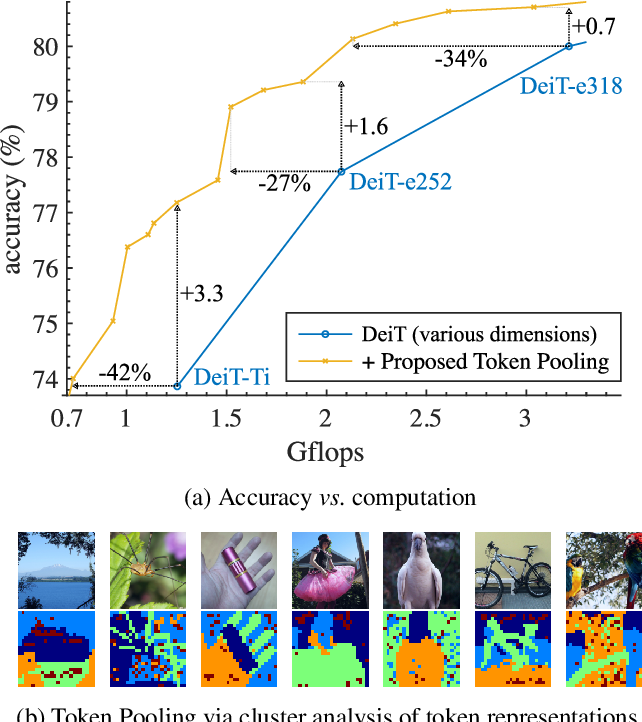
Figure 1 from Token Pooling in Vision Transformers for Image ...
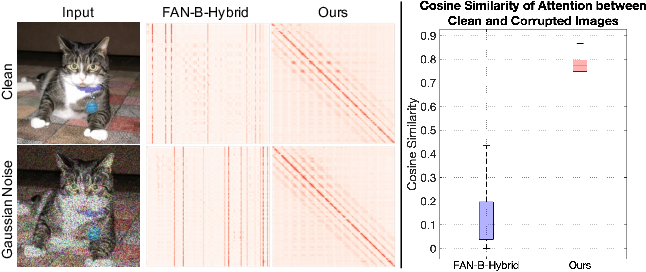
Figure 1 from Robustifying Token Attention for Vision Transformers ...

Figure 1 from Learning to Tokenize for Generative Retrieval | Semantic ...