
Figure 1 From Audio Visual Speech Recognition And Segmentation Based On

Figure 1 from Audio Visual Speech Recognition and Segmentation Based on ...

(PDF) Audio Visual Speech Recognition and Segmentation Based on DBN Models

Figure 1 from Visual Speech Recognition and Utterance Segmentation ...

Figure 1 from Speech Recognition System Based on Visual Feature for the ...

Figure 1 from Noise-Robust Speech Recognition System based on ...
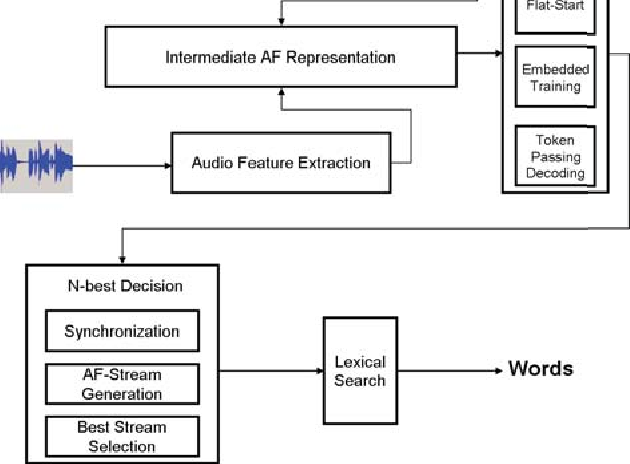
Figure 1 from An audio-visual speech recognition framework based on ...

Figure 1 from Robust Audio-Visual Speech Recognition Based on Late ...

Figure 1 from Audio visual speech recognition in noisy visual ...

Figure 1 from A robust audio-visual speech recognition using audio ...

Figure 1 from Audio-visual speech recognition in noisy audio ...
Advertisement Space (300x250)
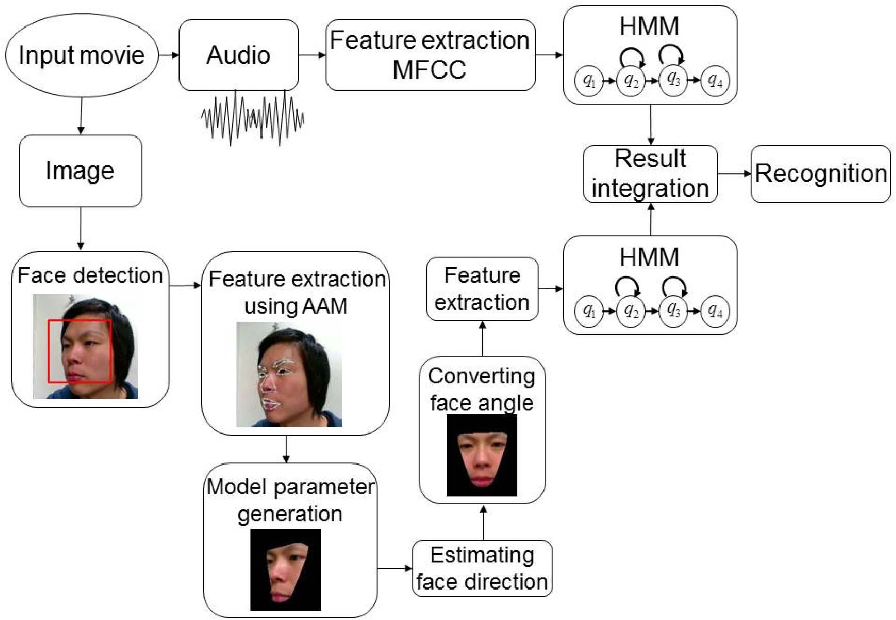
Figure 1 from AUDIO-VISUAL SPEECH RECOGNITION USING AAM-BASED VISUAL ...

Figure 1 from Audio-Visual Speech Enhancement Based on Multiscale ...

(PDF) Automatic Speech Segmentation Based On Audio and Optical Flow ...
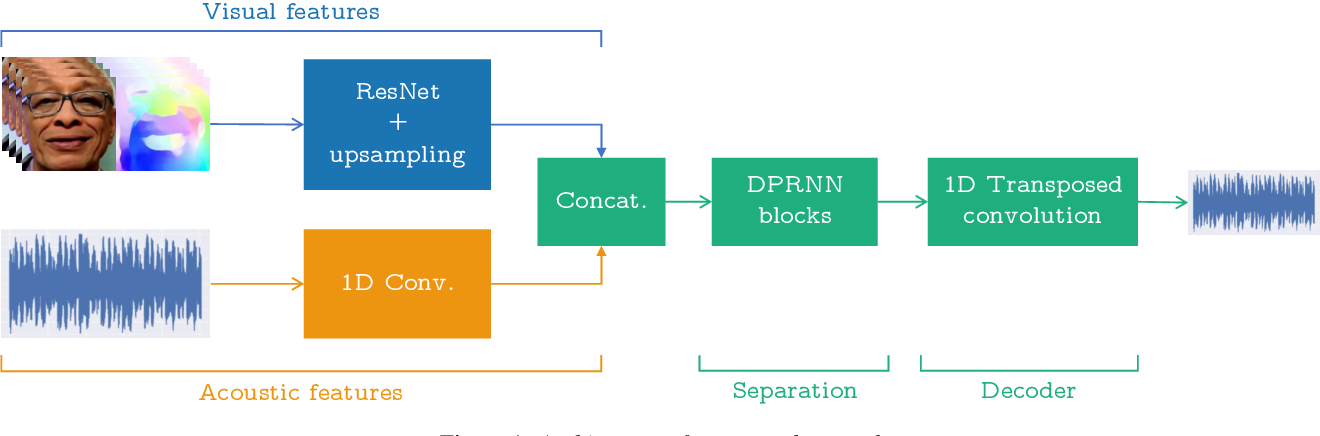
Figure 1 from Deep Audio-Visual Speech Separation Based on Facial ...
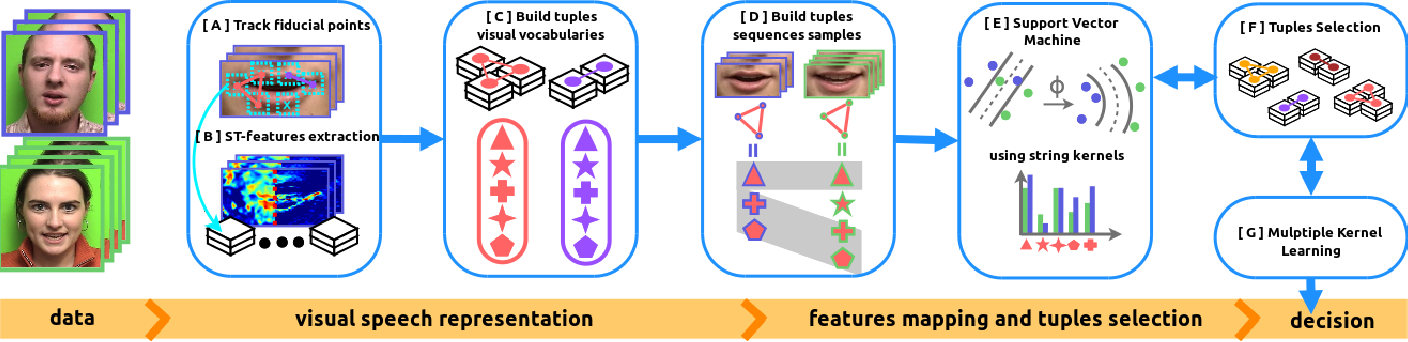
Figure 1 from Designing relevant features for visual speech recognition ...

Figure 1 from Large-Scale Visual Speech Recognition | Semantic Scholar
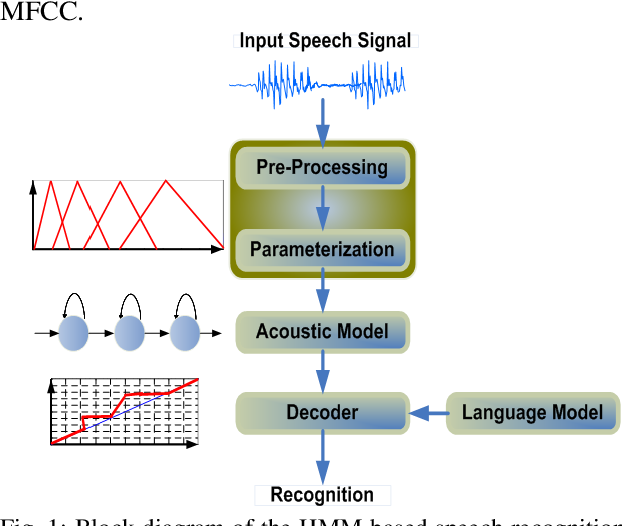
Figure 1 from Comparison of Speech Features on the Speech Recognition ...
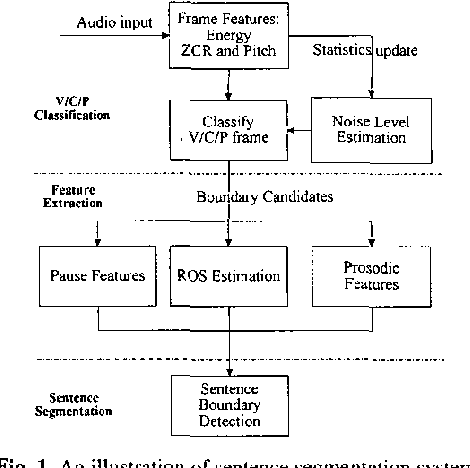
Figure 1 from Speech segmentation without speech recognition | Semantic ...

Speech recognition model based on speaker segmentation and different ...

Figure 1 from Visual Speech Recognition using MV Features | Semantic ...
Advertisement Space (336x280)

Figure 1 from Visual Speech Recognition using VGG16 Convolutional ...

Figure 1 from Evaluation of real-time audio-visual speech recognition ...

Figure 1 from Streaming Audio-Visual Speech Recognition with Alignment ...

Figure 1 from Psychologically-Inspired Audio-Visual Speech Recognition ...

Figure 1 from Deep Audio-Visual Speech Recognition | Semantic Scholar

Figure 1 from Visual Context-driven Audio Feature Enhancement for ...

Figure 1 from An extension 2DPCA based visual feature extraction method ...

Figure 1 from Improving Audio-Visual Speech Recognition by Lip-Subword ...
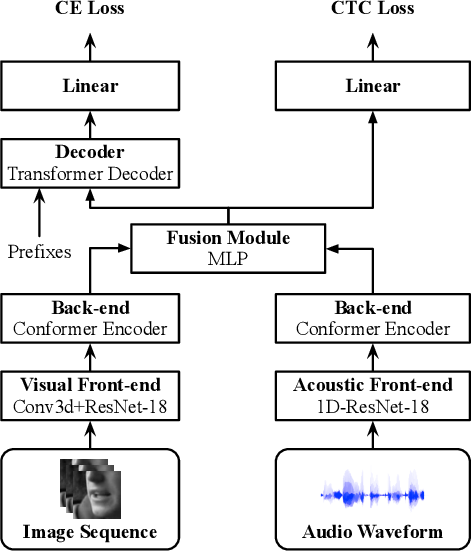
Figure 1 from End-To-End Audio-Visual Speech Recognition with ...

Figure 1 from Audio-visual speech recognition using depth information ...
Advertisement Space (336x280)

Figure 1 from Improving Audio-visual Speech Recognition Performance ...
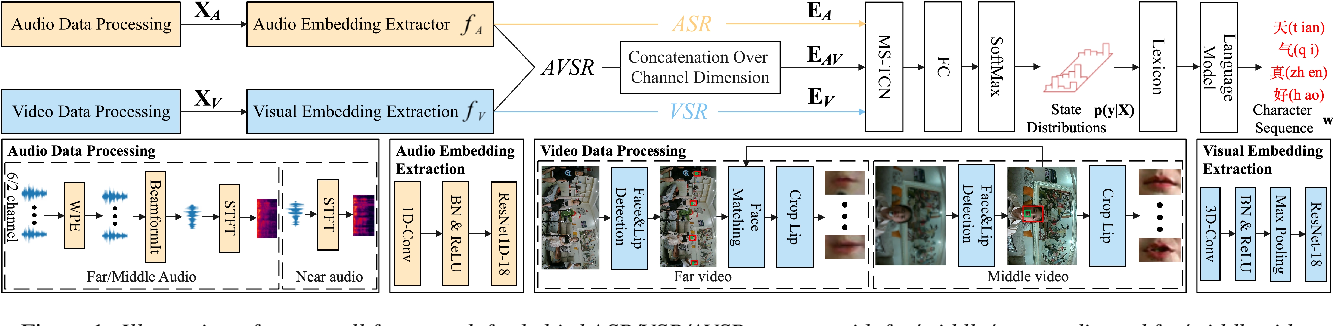
Figure 1 from Audio-Visual Speech Recognition in MISP2021 Challenge ...

Figure 1 from An Improved End-to-End Audio-Visual Speech Recognition ...

Figure 1 from Uncovering the Visual Contribution in Audio-Visual Speech ...
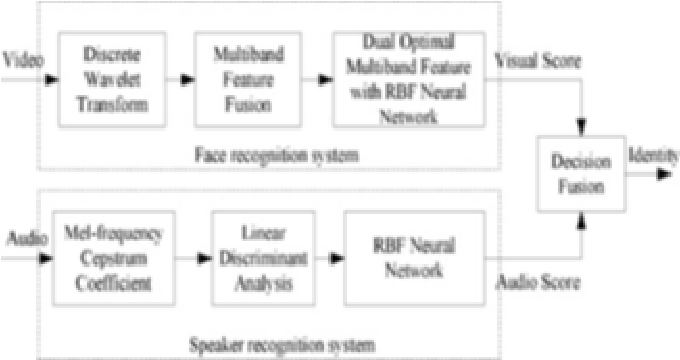
Figure 1 from A HIGHLY EFFICIENT AUDIO-VISUAL RECOGNITION SYSTEM BASED ...
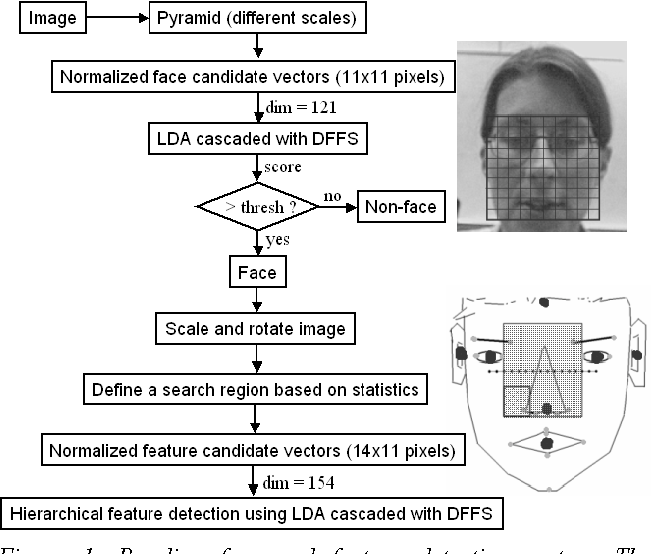
Figure 1 from Improved face and feature finding for audio-visual speech ...