
Figure 1 From Cmot Cross Modal Mixup Via Optimal Transport For Speech
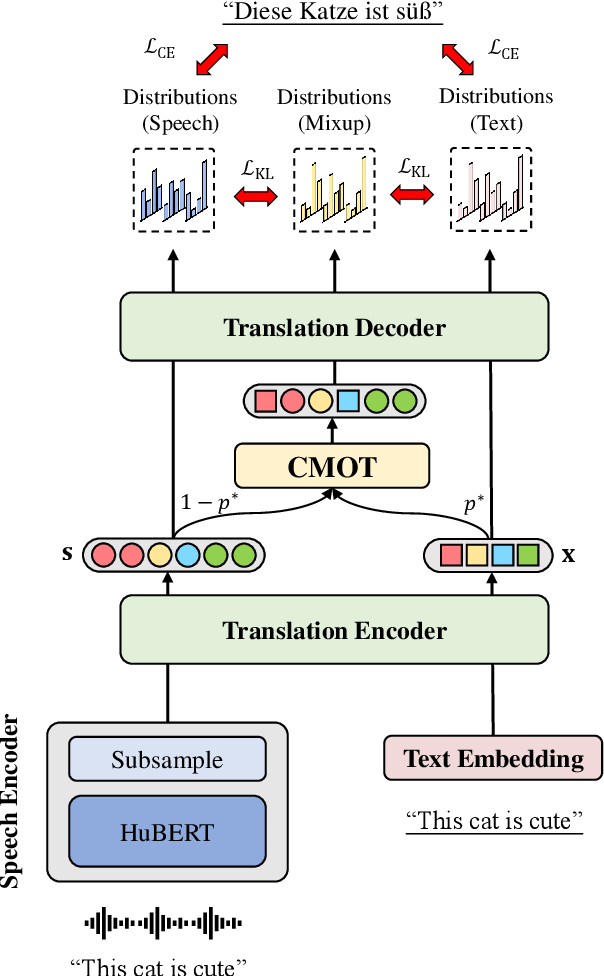
Figure 1 from CMOT: Cross-modal Mixup via Optimal Transport for Speech ...

Figure 1 from CMOT: Cross-modal Mixup via Optimal Transport for Speech ...

Figure 1 from Spatial and Modal Optimal Transport for Fast Cross-Modal ...
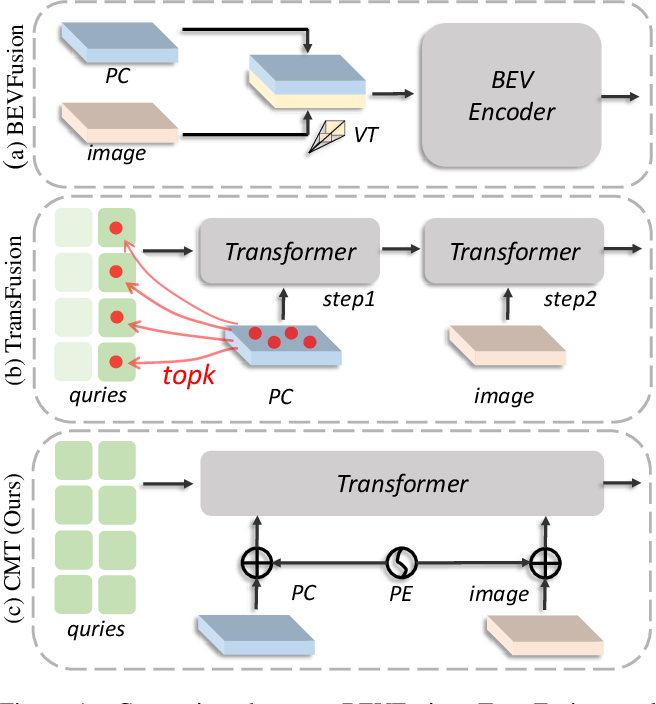
Figure 1 from Cross Modal Transformer via Coordinates Encoding for 3D ...

CMOT: Cross-modal Mixup via Optimal Transport for Speech Translation ...

CMOT: Cross-modal Mixup via Optimal Transport for Speech Translation ...
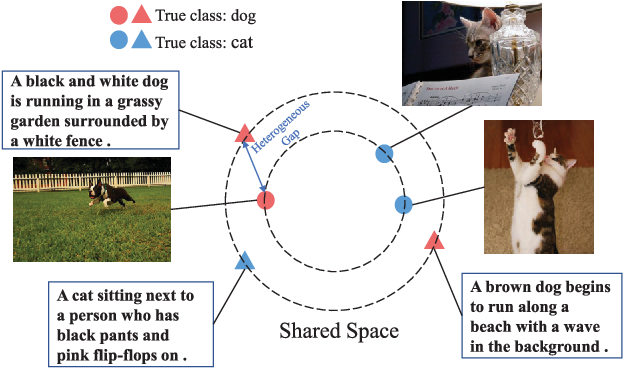
Figure 1 from A Unified Optimal Transport Framework for Cross-Modal ...

Figure 2 from Spatial and Modal Optimal Transport for Fast Cross-Modal ...
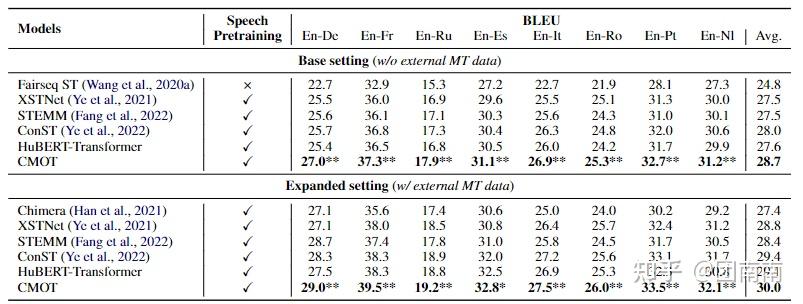
文献阅读:CMOT: Cross-modal Mixup via Optimal Transport for Speech ...

Figure 3 from Spatial and Modal Optimal Transport for Fast Cross-Modal ...
Advertisement Space (300x250)

Figure 1 from Optimal transport meets noisy label robust loss and MixUp ...
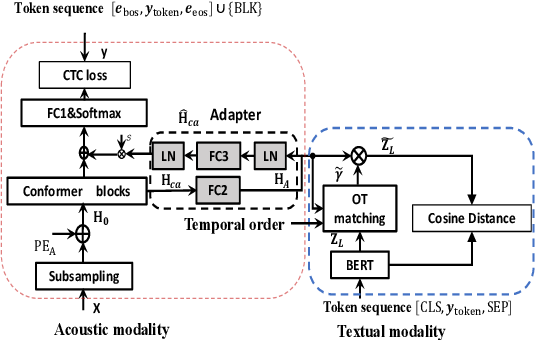
Figure 1 from Temporal Order Preserved Optimal Transport-Based Cross ...
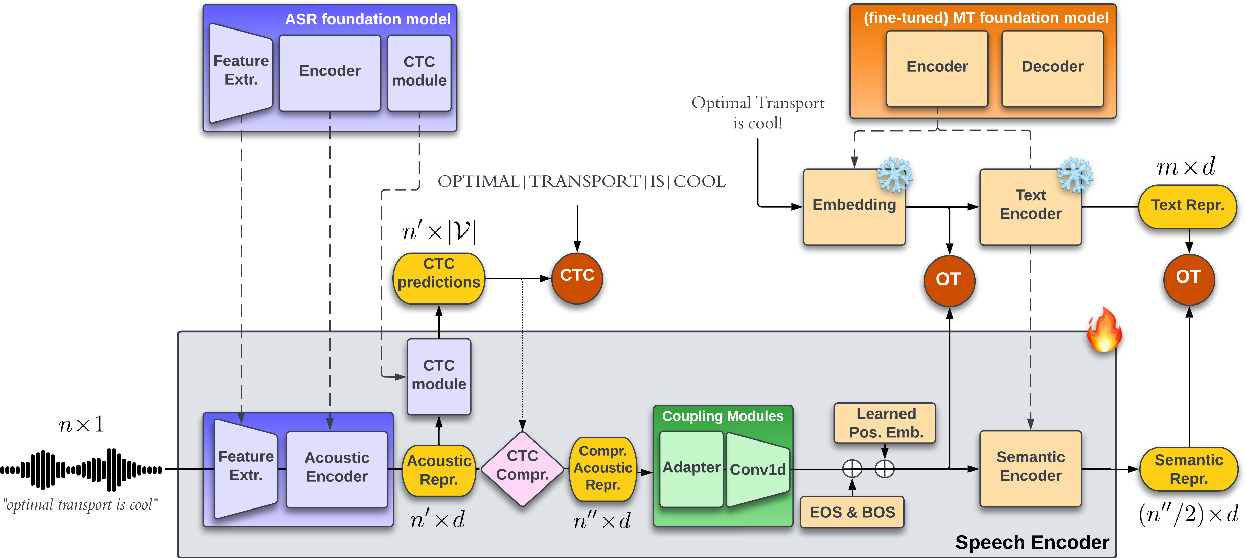
Figure 1 from Speech Translation with Foundation Models and Optimal ...

Figure 1 from Cross-Modal Mutual Learning for Audio-Visual Speech ...
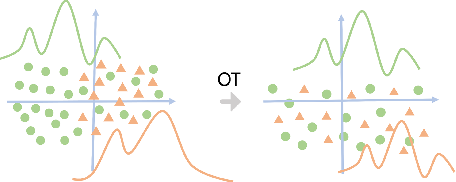
Figure 1 from OTKGE: Multi-modal Knowledge Graph Embeddings via Optimal ...
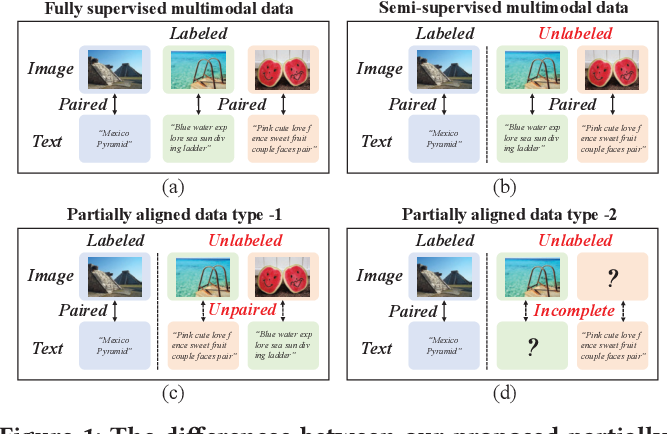
Figure 1 from Partially Aligned Cross-modal Retrieval via Optimal ...
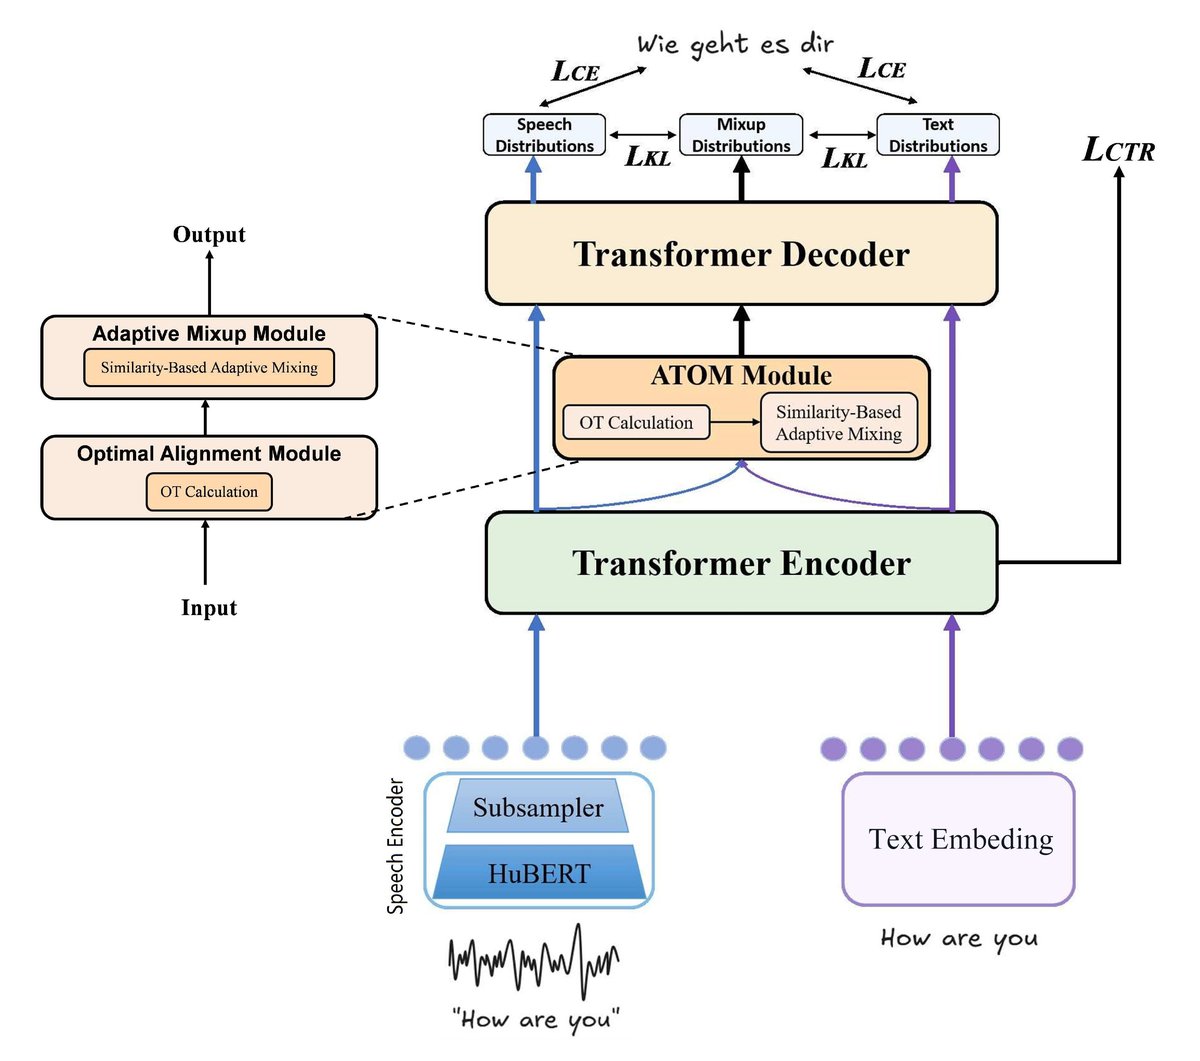
ATOM: Adaptive Token-Level Optimal Transport Mixup for Speech ...

Figure 1 from Cross-Modal Mutual Learning for Audio-Visual Speech ...

Figure 3 from Dual-View Curricular Optimal Transport for Cross-Lingual ...

Figure 2 from A Unified Optimal Transport Framework for Cross-Modal ...
Advertisement Space (336x280)
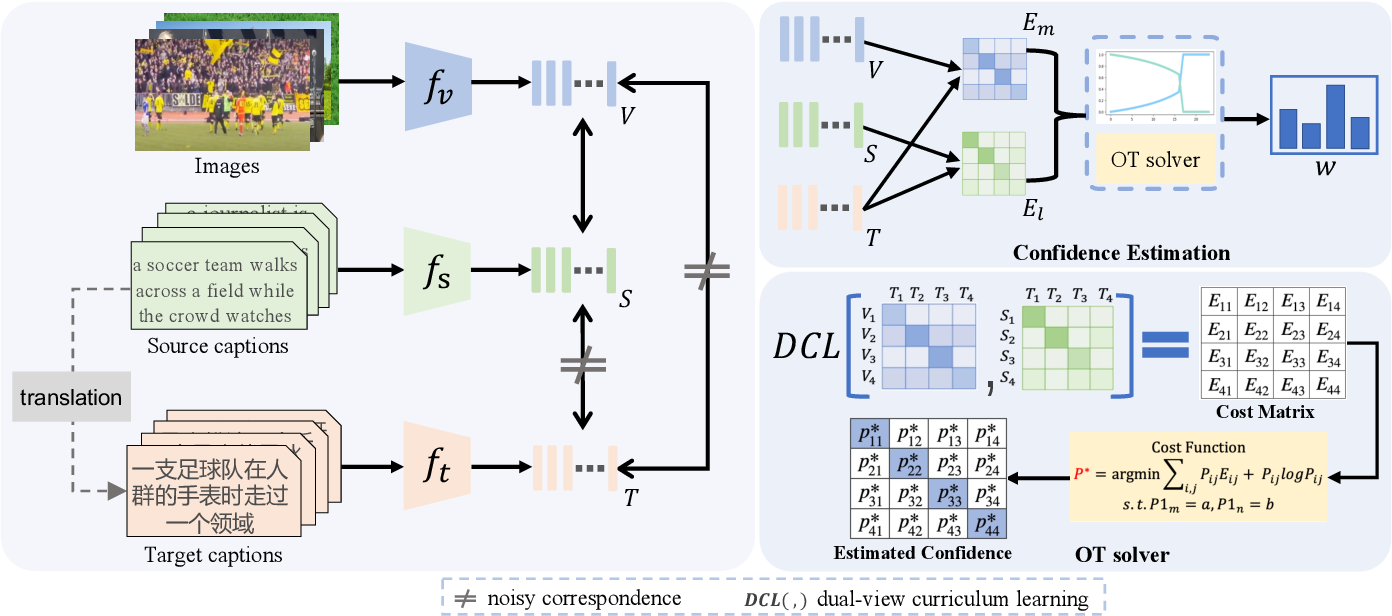
Figure 2 from Dual-View Curricular Optimal Transport for Cross-Lingual ...
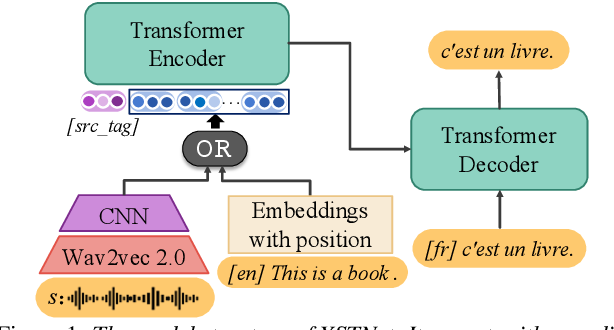
Figure 1 from End-to-end Speech Translation via Cross-modal Progressive ...
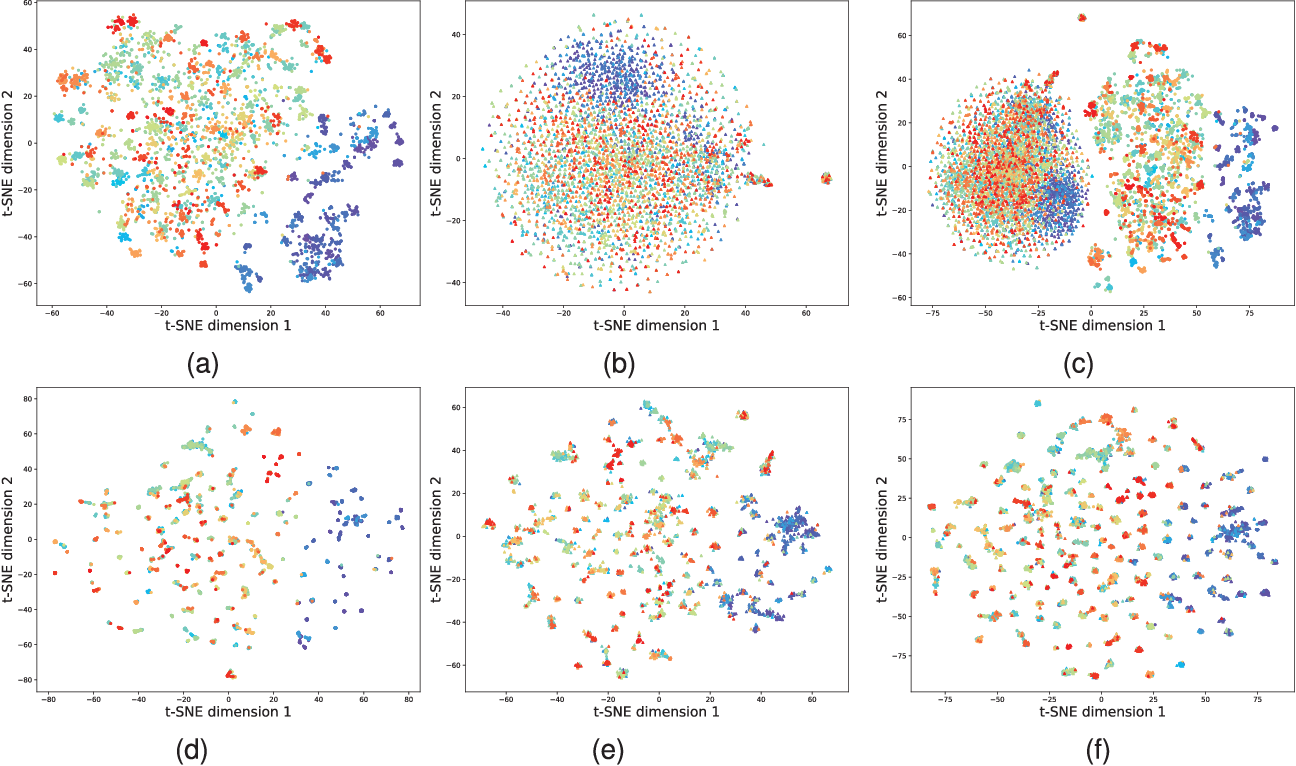
Figure 10 from A Unified Optimal Transport Framework for Cross-Modal ...
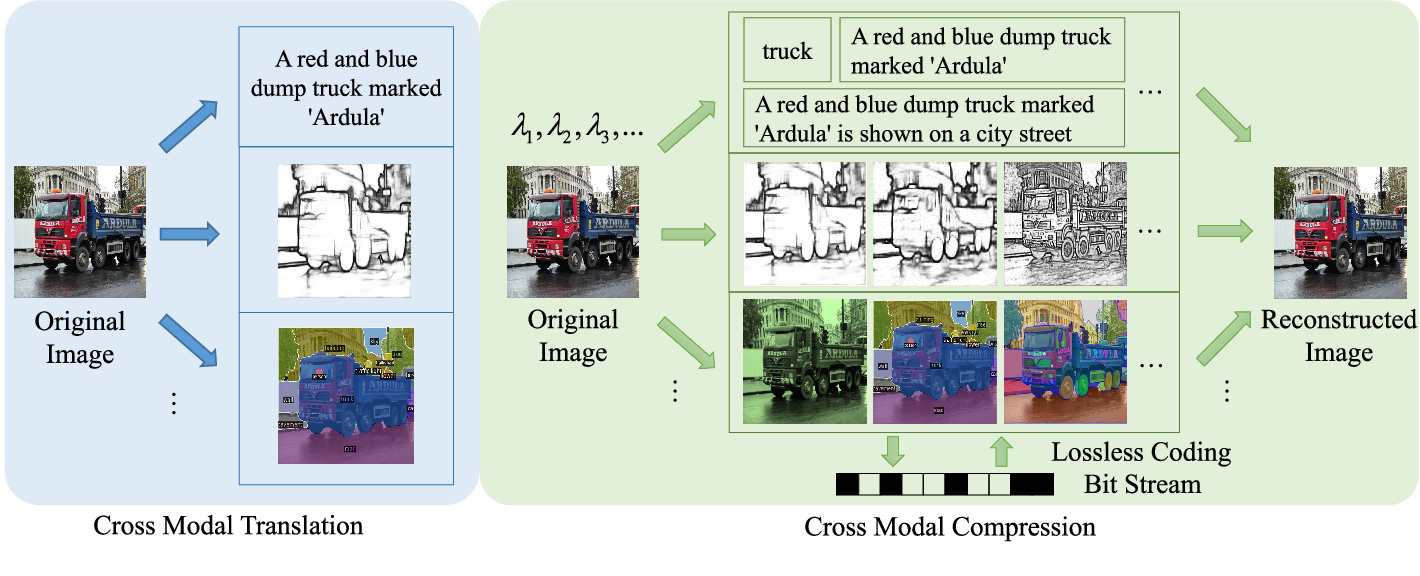
Figure 1 from Rate-Distortion Optimized Cross Modal Compression With ...

Figure 1 from Cross-modal Contrastive Learning for Speech Translation ...

Figure 2 from k-Mixup Regularization for Deep Learning via Optimal ...
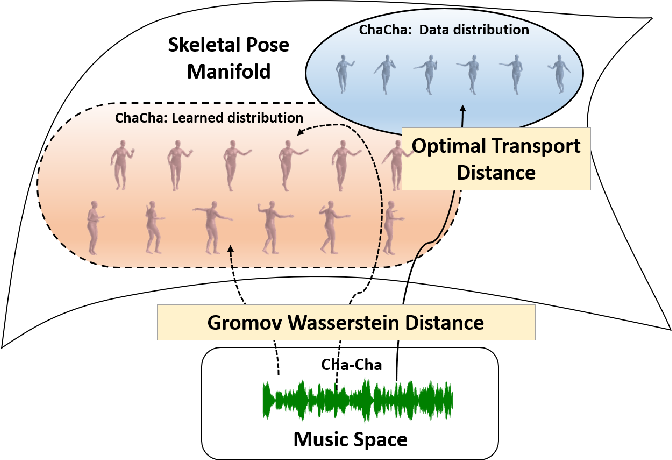
Figure 1 from Music-to-Dance Generation with Optimal Transport ...
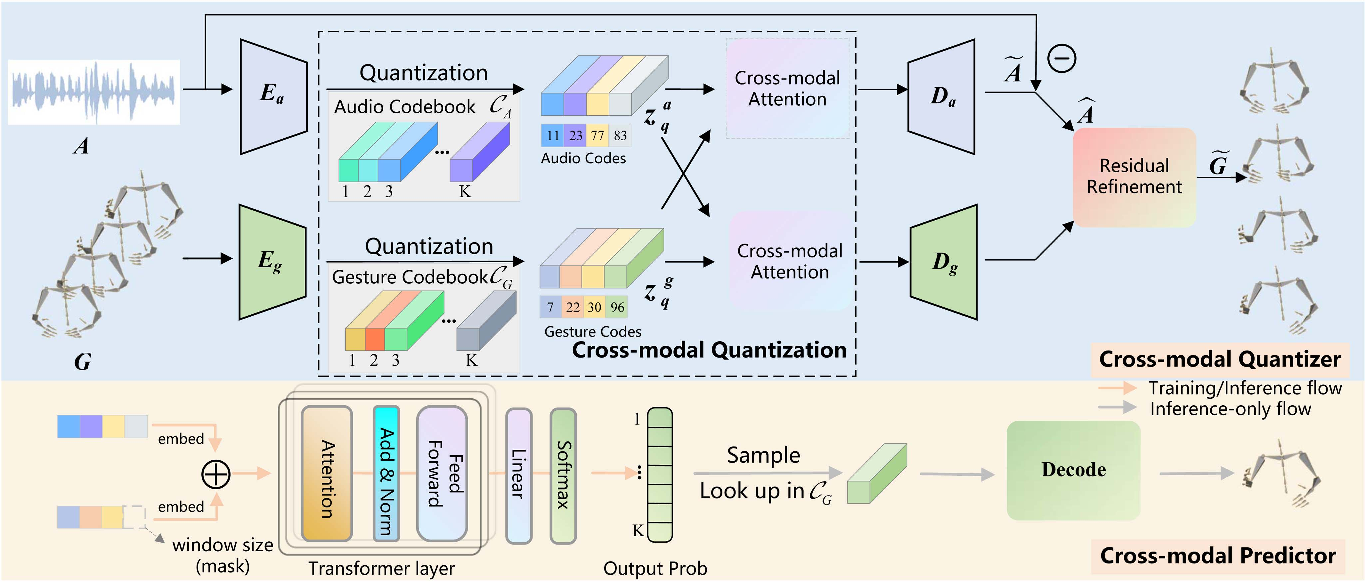
Figure 1 from Cross-Modal Quantization for Co-Speech Gesture Generation ...

Figure 1 from Cross-Modal Global Interaction and Local Alignment for ...

Figure 1 from Transfer Learning With Optimal Transportation and ...
Advertisement Space (336x280)
GitHub - daifengwanglab/CMOT: Cross Modality Optimal Transport for ...
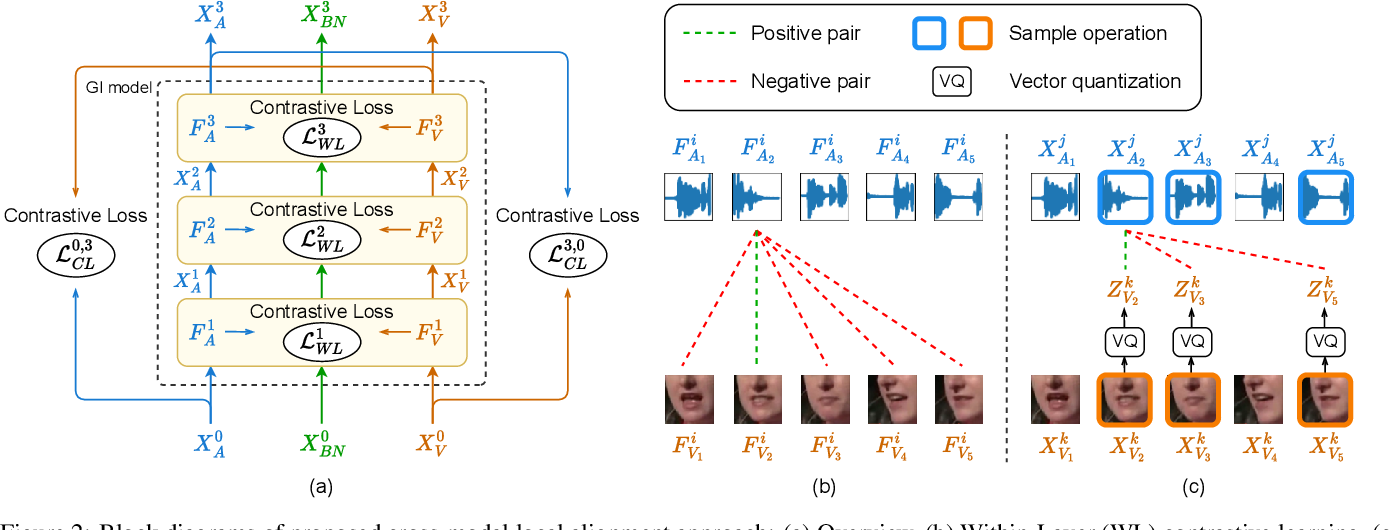
Figure 1 from Cross-Modal Global Interaction and Local Alignment for ...
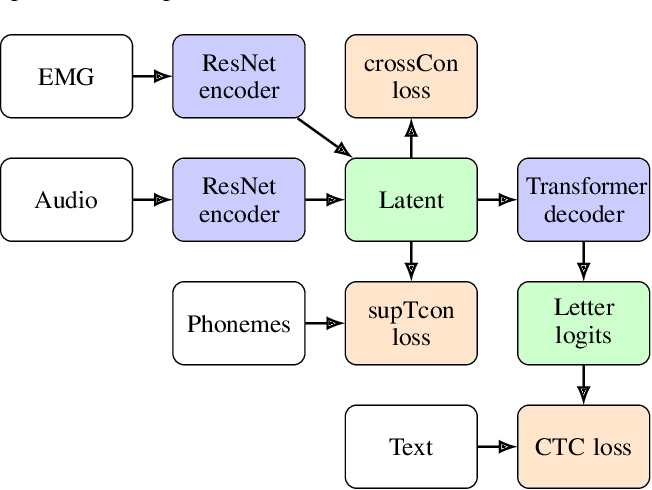
Figure 1 from A Cross-Modal Approach to Silent Speech with LLM-Enhanced ...

Figure 1 from Learning Modality Knowledge Alignment for Cross-Modality ...

Figure 1 from Audio-visual speech separation based on joint feature ...
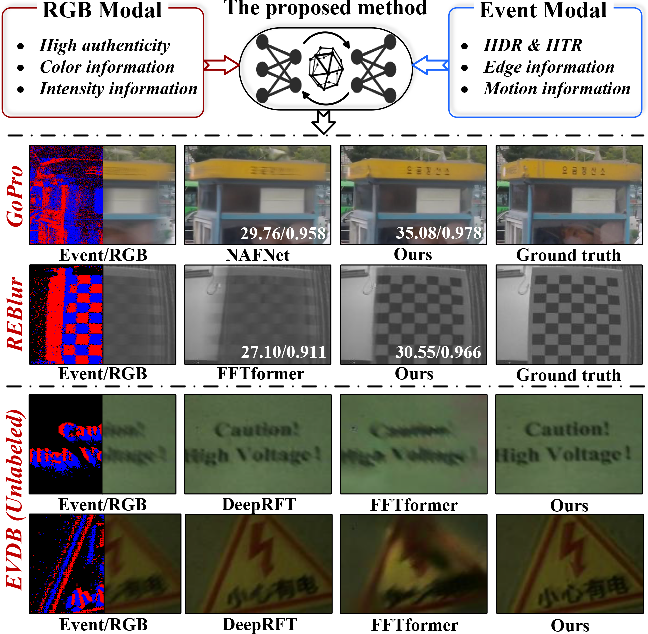
Figure 1 from Event-Based Image Deblurring via Cross-Modal Interaction ...