
Figure 1 From Cross3dvg Cross Dataset 3d Visual Grounding On Different

Figure 1 from Cross3DVG: Cross-Dataset 3D Visual Grounding on Different ...

Figure 1 from SeCG: Semantic-Enhanced 3D Visual Grounding via Cross ...
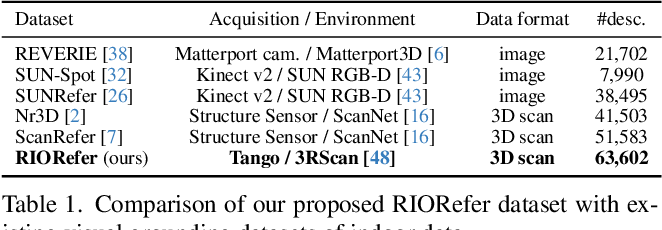
Table 1 from Cross3DVG: Cross-Dataset 3D Visual Grounding on Different ...
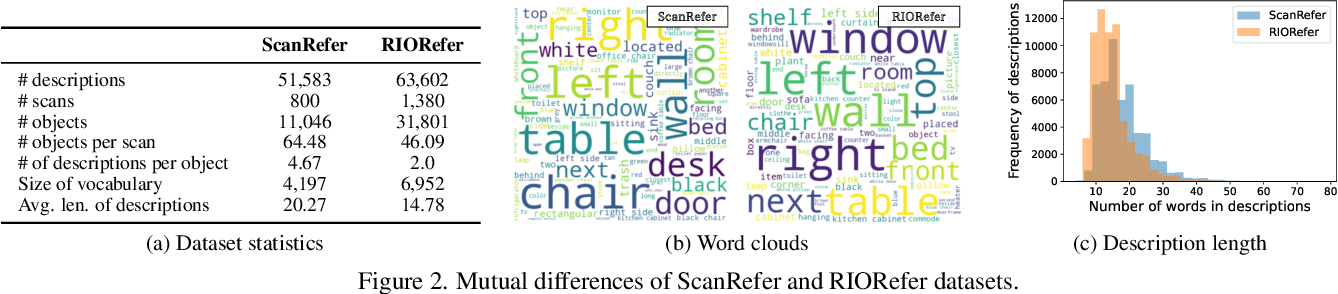
Figure 2 from Cross3DVG: Cross-Dataset 3D Visual Grounding on Different ...

Figure 1 from Weakly-Supervised 3D Visual Grounding based on Visual ...

Figure 1 from AugRefer: Advancing 3D Visual Grounding via Cross-Modal ...
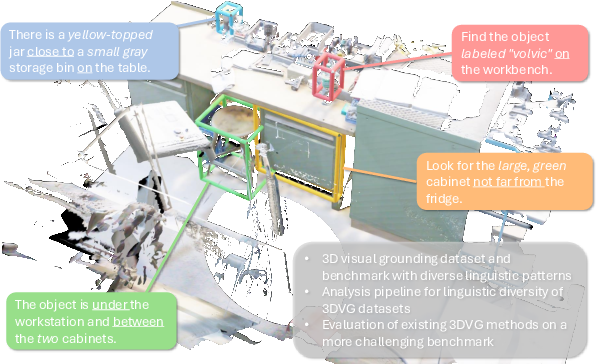
Figure 1 from ViGiL3D: A Linguistically Diverse Dataset for 3D Visual ...
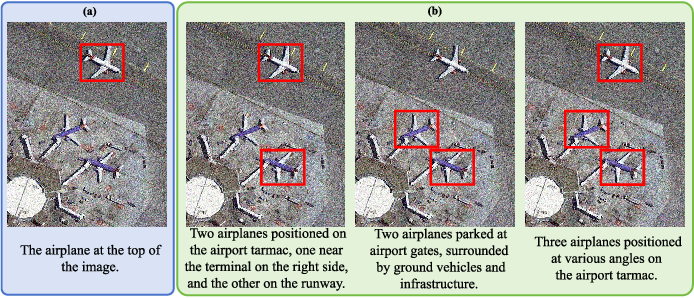
Figure 1 from MAGRET: A Dataset for Multitarget Visual Grounding in ...
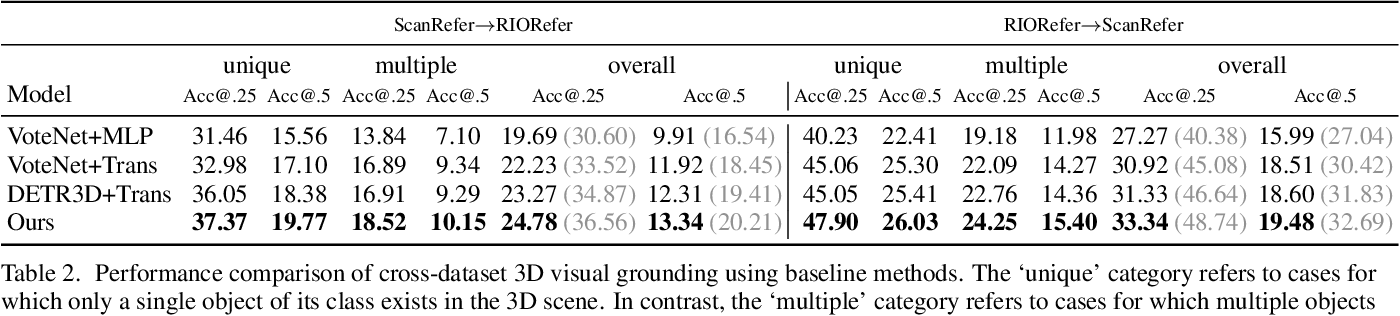
Table 2 from Cross3DVG: Cross-Dataset 3D Visual Grounding on Different ...

Figure 4 from Weakly-Supervised 3D Visual Grounding based on Visual ...
Advertisement Space (300x250)

Figure 1 from Rethinking 3D Dense Caption and Visual Grounding in A ...
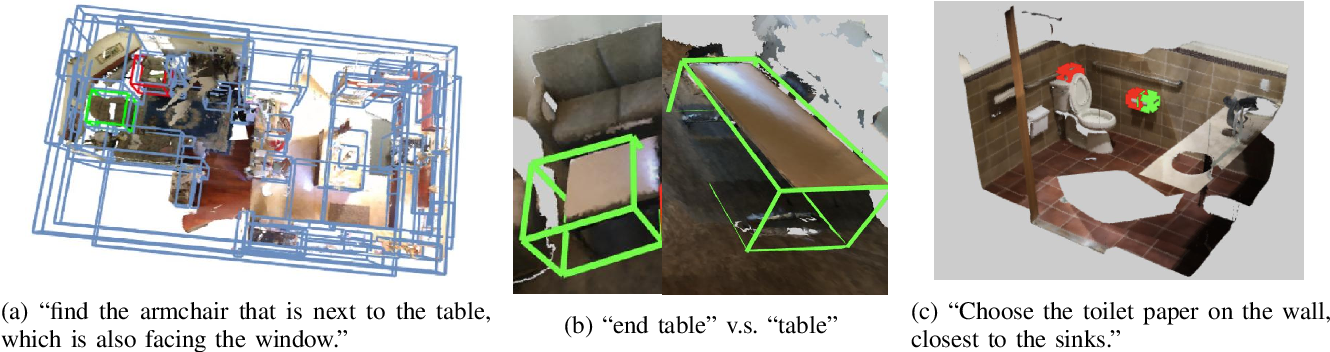
Figure 1 from 3DWG: 3D Weakly Supervised Visual Grounding via Category ...

Figure 1 from A Survey on Text-Guided 3-D Visual Grounding: Elements ...
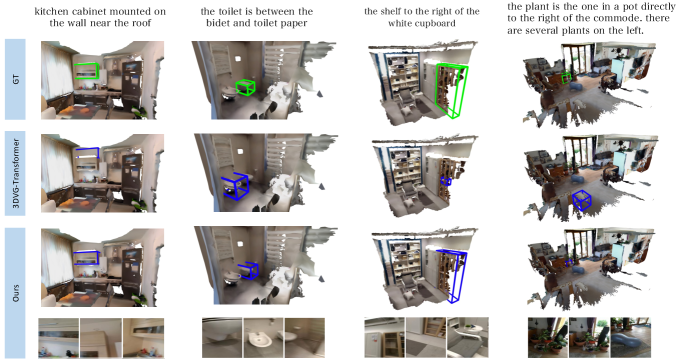
[2305.13876] Cross3DVG: Cross-Dataset 3D Visual Grounding on Different ...
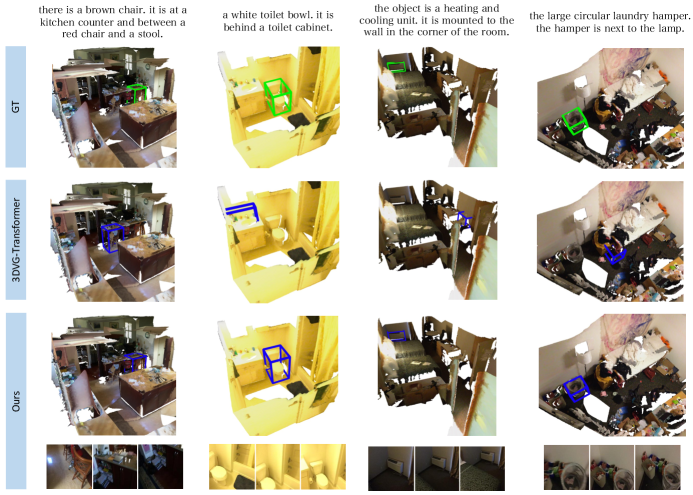
[2305.13876] Cross3DVG: Cross-Dataset 3D Visual Grounding on Different ...
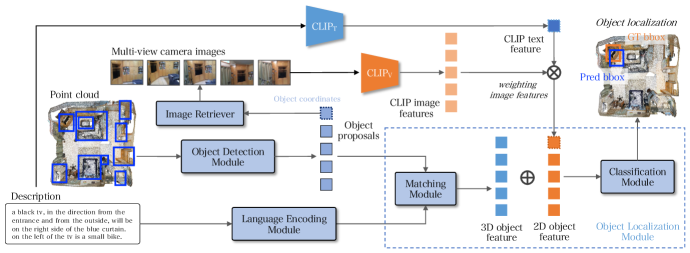
[2305.13876] Cross3DVG: Cross-Dataset 3D Visual Grounding on Different ...
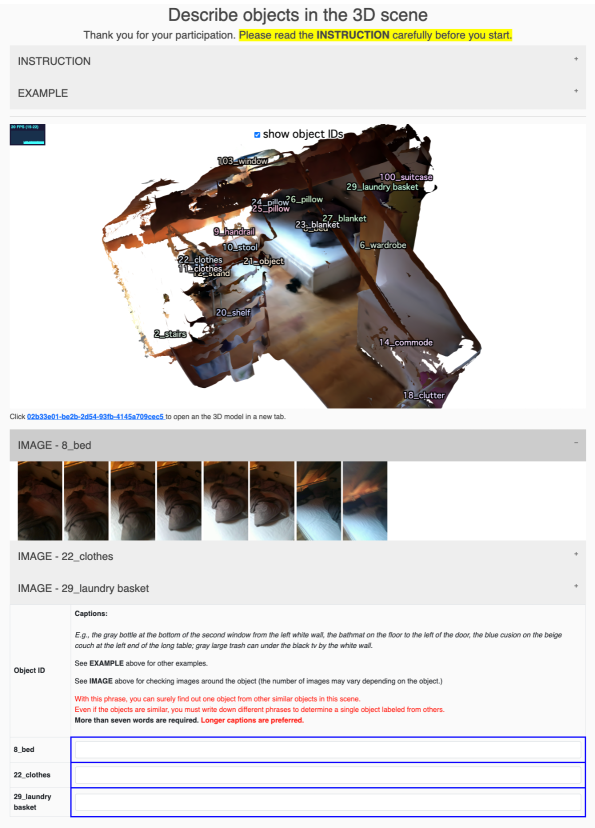
[2305.13876] Cross3DVG: Cross-Dataset 3D Visual Grounding on Different ...
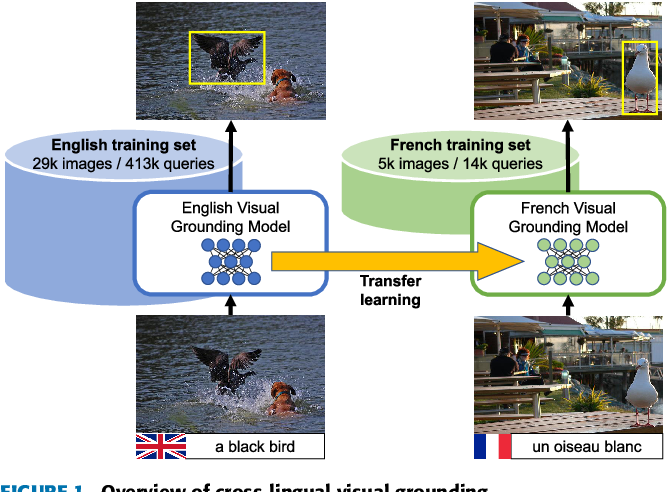
Figure 1 from Cross-Lingual Visual Grounding | Semantic Scholar
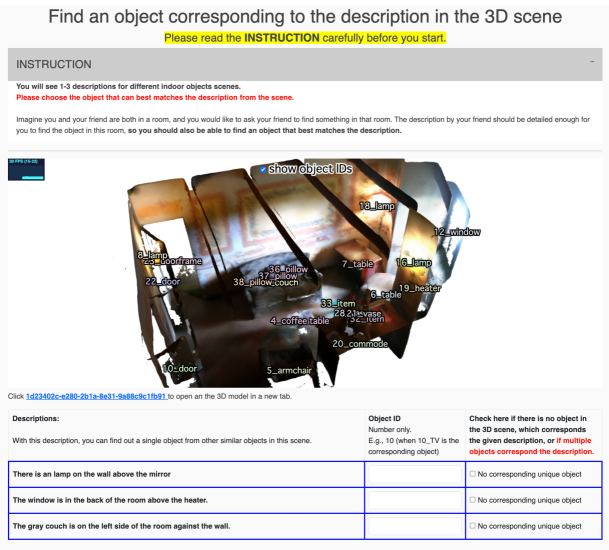
[2305.13876] Cross3DVG: Cross-Dataset 3D Visual Grounding on Different ...
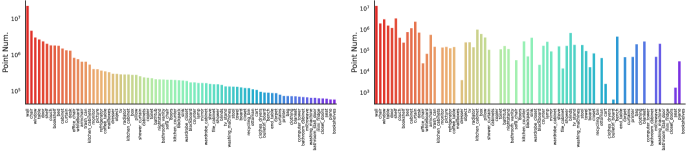
[2305.13876] Cross3DVG: Cross-Dataset 3D Visual Grounding on Different ...
Advertisement Space (336x280)
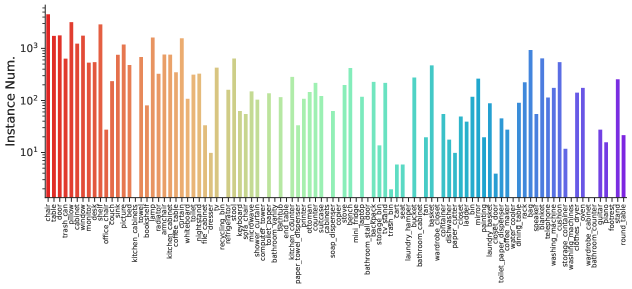
[2305.13876] Cross3DVG: Cross-Dataset 3D Visual Grounding on Different ...
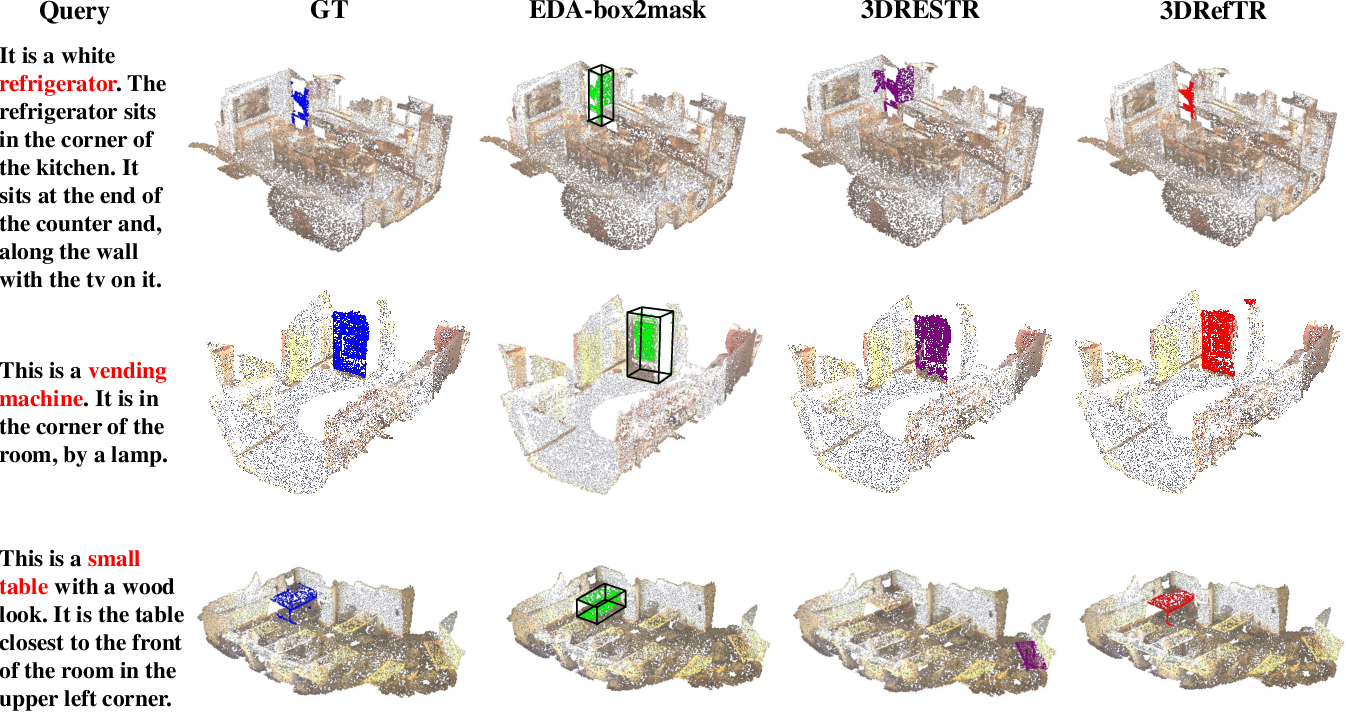
Figure 3 from A Unified Framework for 3D Point Cloud Visual Grounding ...

Figure 1 from Toward Explainable and Fine-Grained 3D Grounding through ...

Figure 6 from Naturally Supervised 3D Visual Grounding with Language ...

Figure 1 from TransVG: End-to-End Visual Grounding with Transformers ...

Figure 1 from Bridging Modality Gap for Visual Grounding with Effecitve ...

Figure 1 from ViewRefer: Grasp the Multi-view Knowledge for 3D Visual ...

Figure 1 from Cross-Dataset Sensor Alignment: Making Visual 3D Object ...
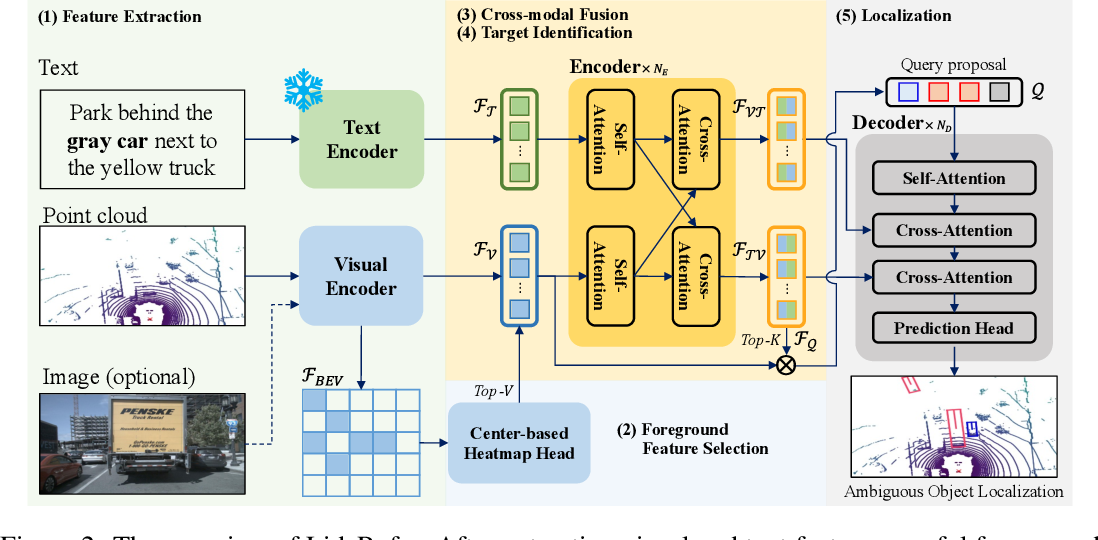
Figure 2 from LidaRefer: Outdoor 3D Visual Grounding for Autonomous ...

Figure 1 from Visual Grounding with Transformers | Semantic Scholar
Advertisement Space (336x280)
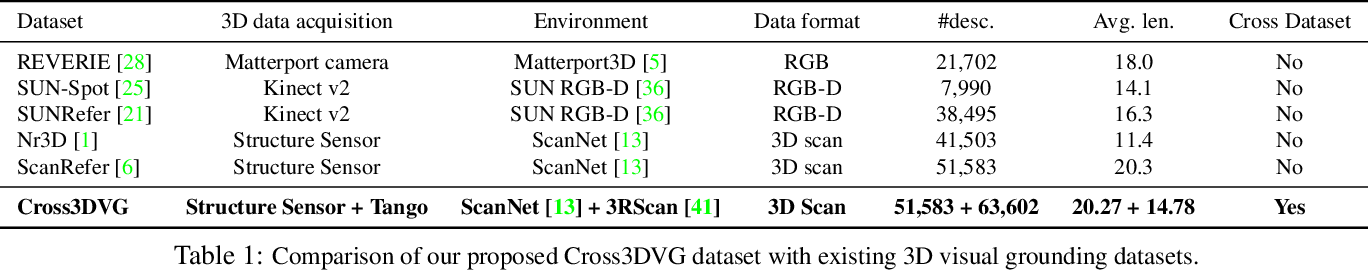
Table 1 from Cross3DVG: Baseline and Dataset for Cross-Dataset 3D ...
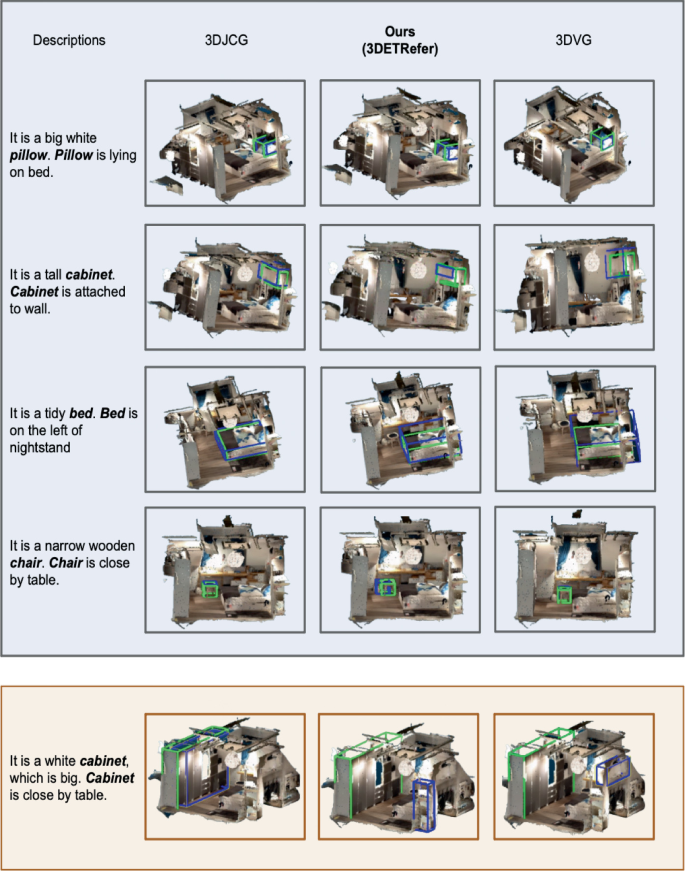
3DSSG-Cap: A Caption Enhanced Dataset for 3D Visual Grounding ...

Figure 5 from Transformer-Based Visual Grounding with Cross-Modality ...

Figure 1 from A Fast and Accurate One-Stage Approach to Visual ...

Figure 8 from Transformer-Based Visual Grounding with Cross-Modality ...

Figure 3 from Transformer-Based Visual Grounding with Cross-Modality ...