
Figure 1 From D2cache Accelerating Diffusion Based Llms Via Dual

Figure 1 from d2Cache: Accelerating Diffusion-Based LLMs via Dual ...

Figure 1 from Accelerating Diffusion LLMs via Adaptive Parallel ...
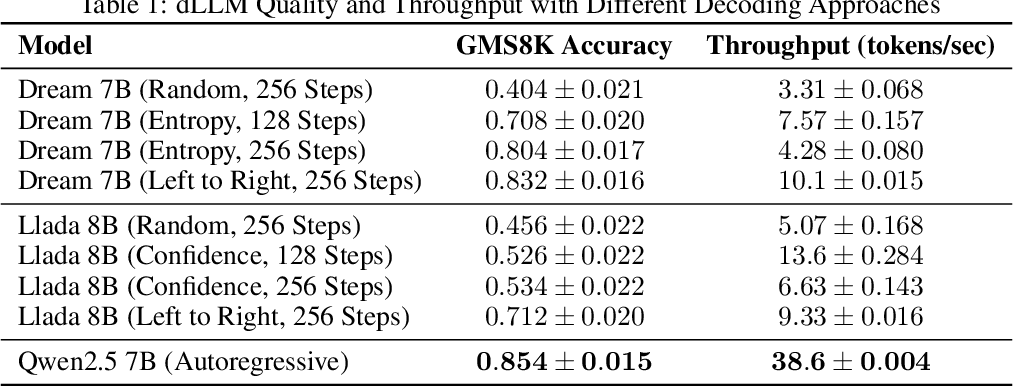
Table 1 from Accelerating Diffusion LLMs via Adaptive Parallel Decoding ...

Figure 1 from A dual diffusion model-based representation learning ...
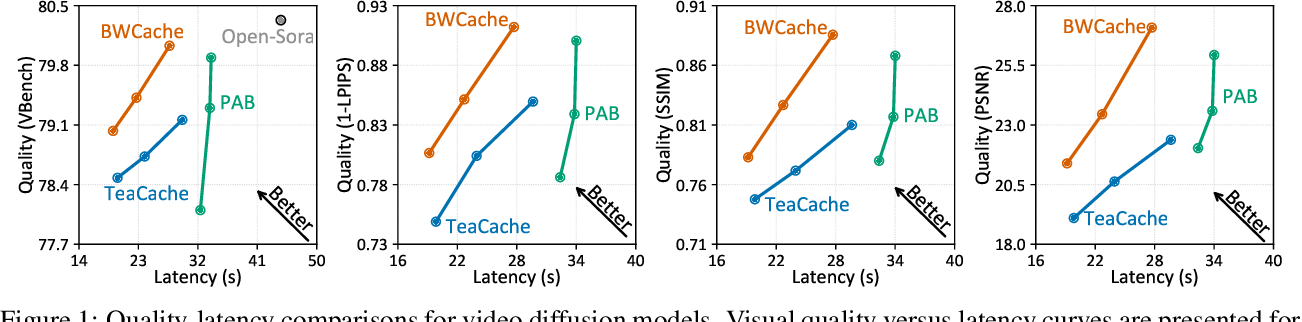
Figure 1 from BWCache: Accelerating Video Diffusion Transformers ...
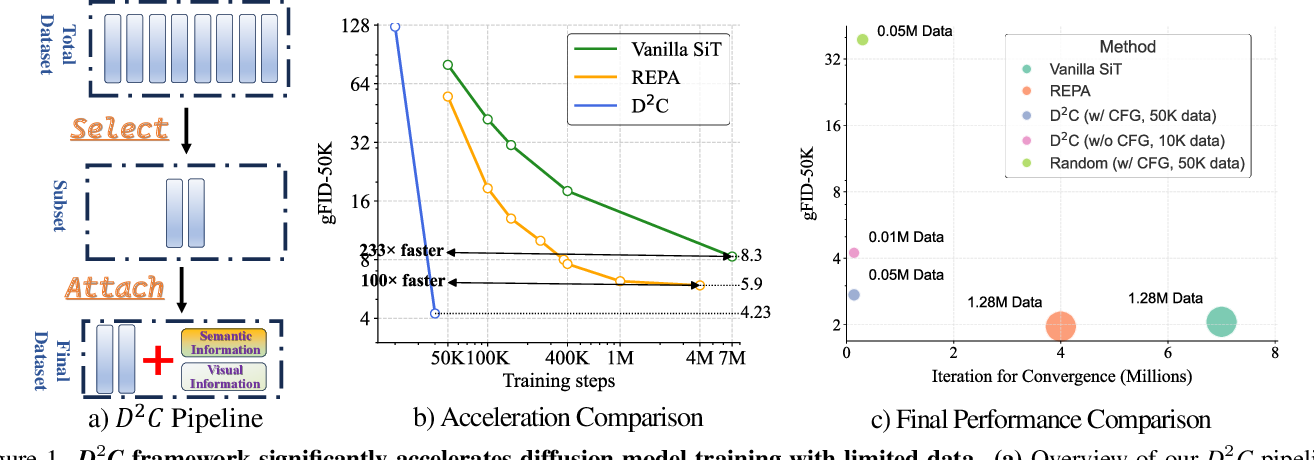
Figure 1 from Accelerating Diffusion Model Training under Minimal ...
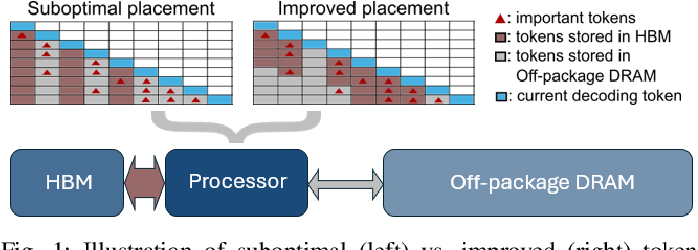
Figure 1 from Accelerating LLM Inference via Dynamic KV Cache Placement ...

Table 2 from Accelerating Diffusion LLMs via Adaptive Parallel Decoding ...
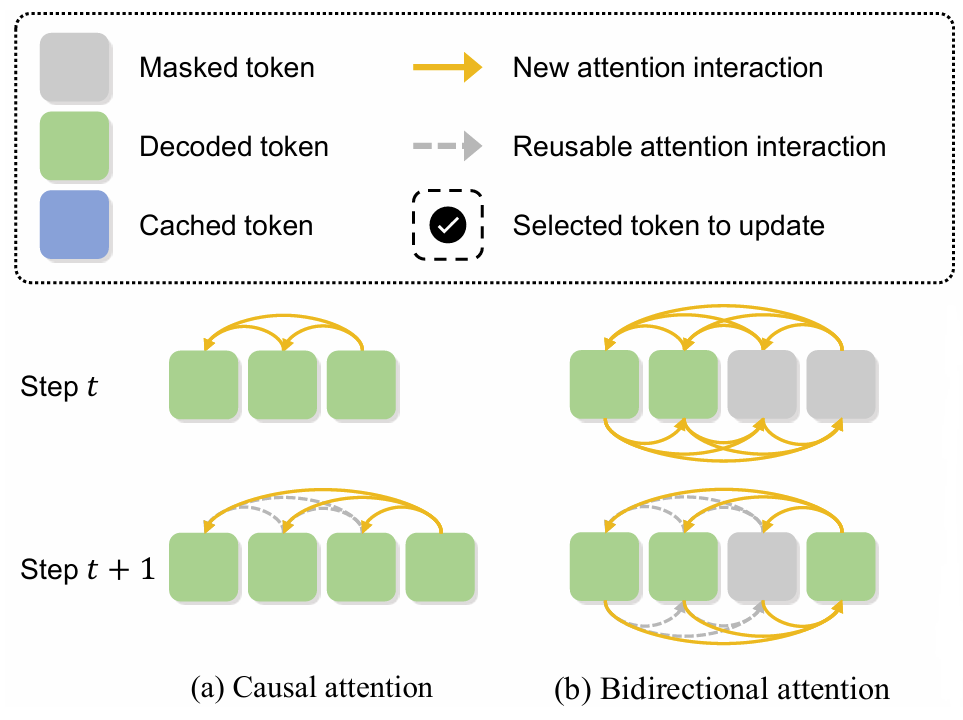
d2Cache: Accelerating Diffusion-Based LLMs via Dual Adaptive Caching ...
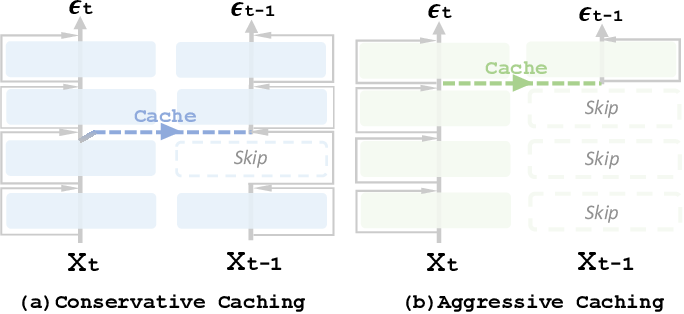
Figure 1 from Rethinking Token-wise Feature Caching: Accelerating ...
Advertisement Space (300x250)
d^2Cache: Accelerating Diffusion-Based LLMs via Dual Adaptive Caching ...

Paper page - d^2Cache: Accelerating Diffusion-Based LLMs via Dual ...
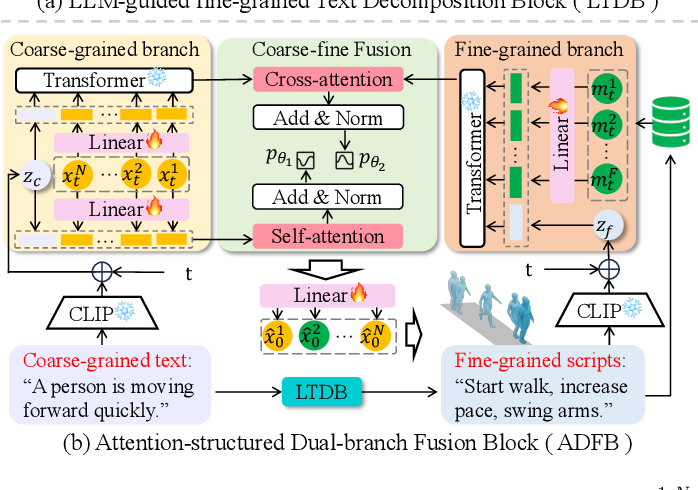
Figure 1 from LLM-Guided Dual-Branch Diffusion Model for Fine-Grained ...
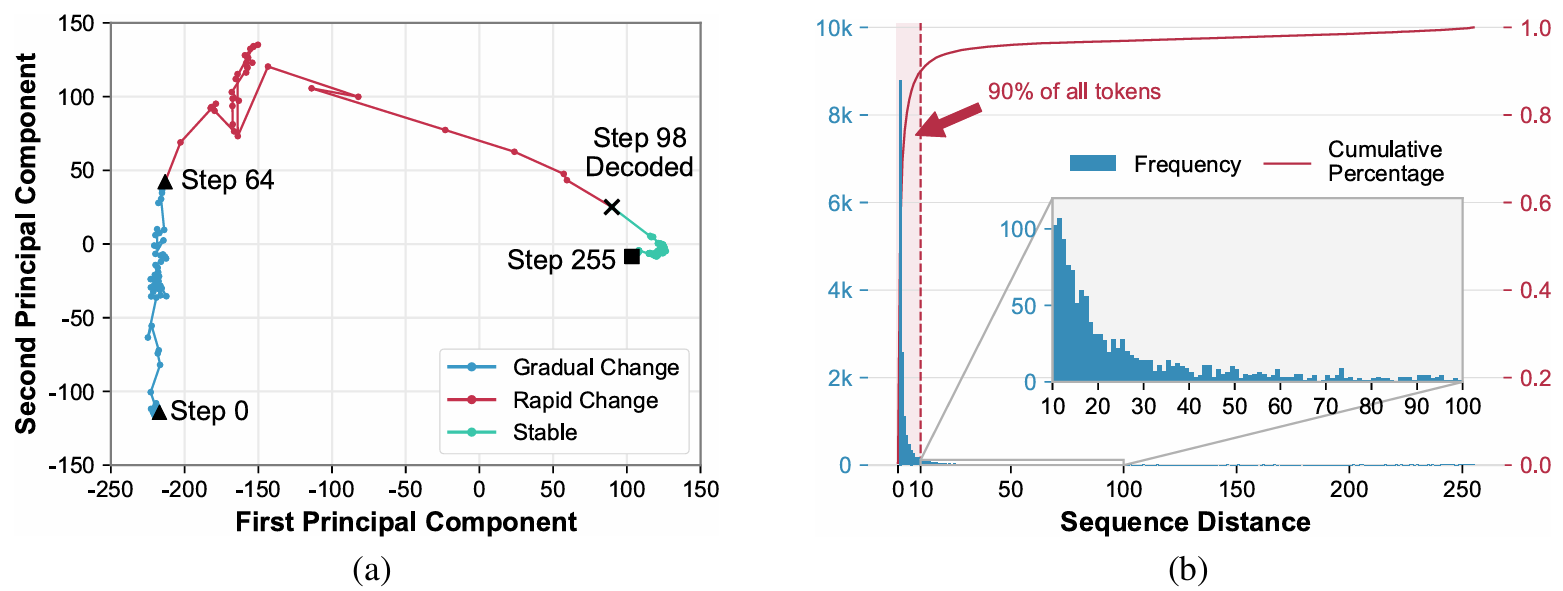
d2Cache: Accelerating Diffusion-Based LLMs via Dual Adaptive Caching ...

Accelerating Diffusion via Hybrid Data-Pipeline Parallelism Based on ...

[PDF] Accelerating Diffusion LLMs via Adaptive Parallel Decoding ...

(PDF) Accelerating Diffusion LLMs via Adaptive Parallel Decoding

Accelerating Diffusion via Hybrid Data-Pipeline Parallelism Based on ...

Streaming-dLLM: Accelerating Diffusion LLMs via Suffix Pruning and ...

Accelerating Diffusion LLMs via Adaptive Parallel Decoding - YouTube
Advertisement Space (336x280)
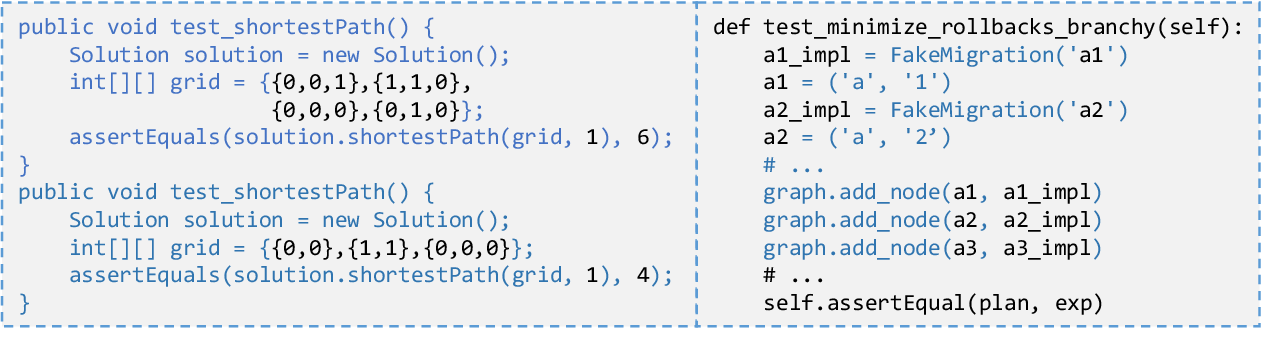
Figure 1 from DiffuTester: Accelerating Unit Test Generation for ...

[PDF] Accelerating Diffusion LLMs via Adaptive Parallel Decoding ...

Paper page - Accelerating Diffusion LLMs via Adaptive Parallel Decoding

Paper page - Streaming-dLLM: Accelerating Diffusion LLMs via Suffix ...

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...
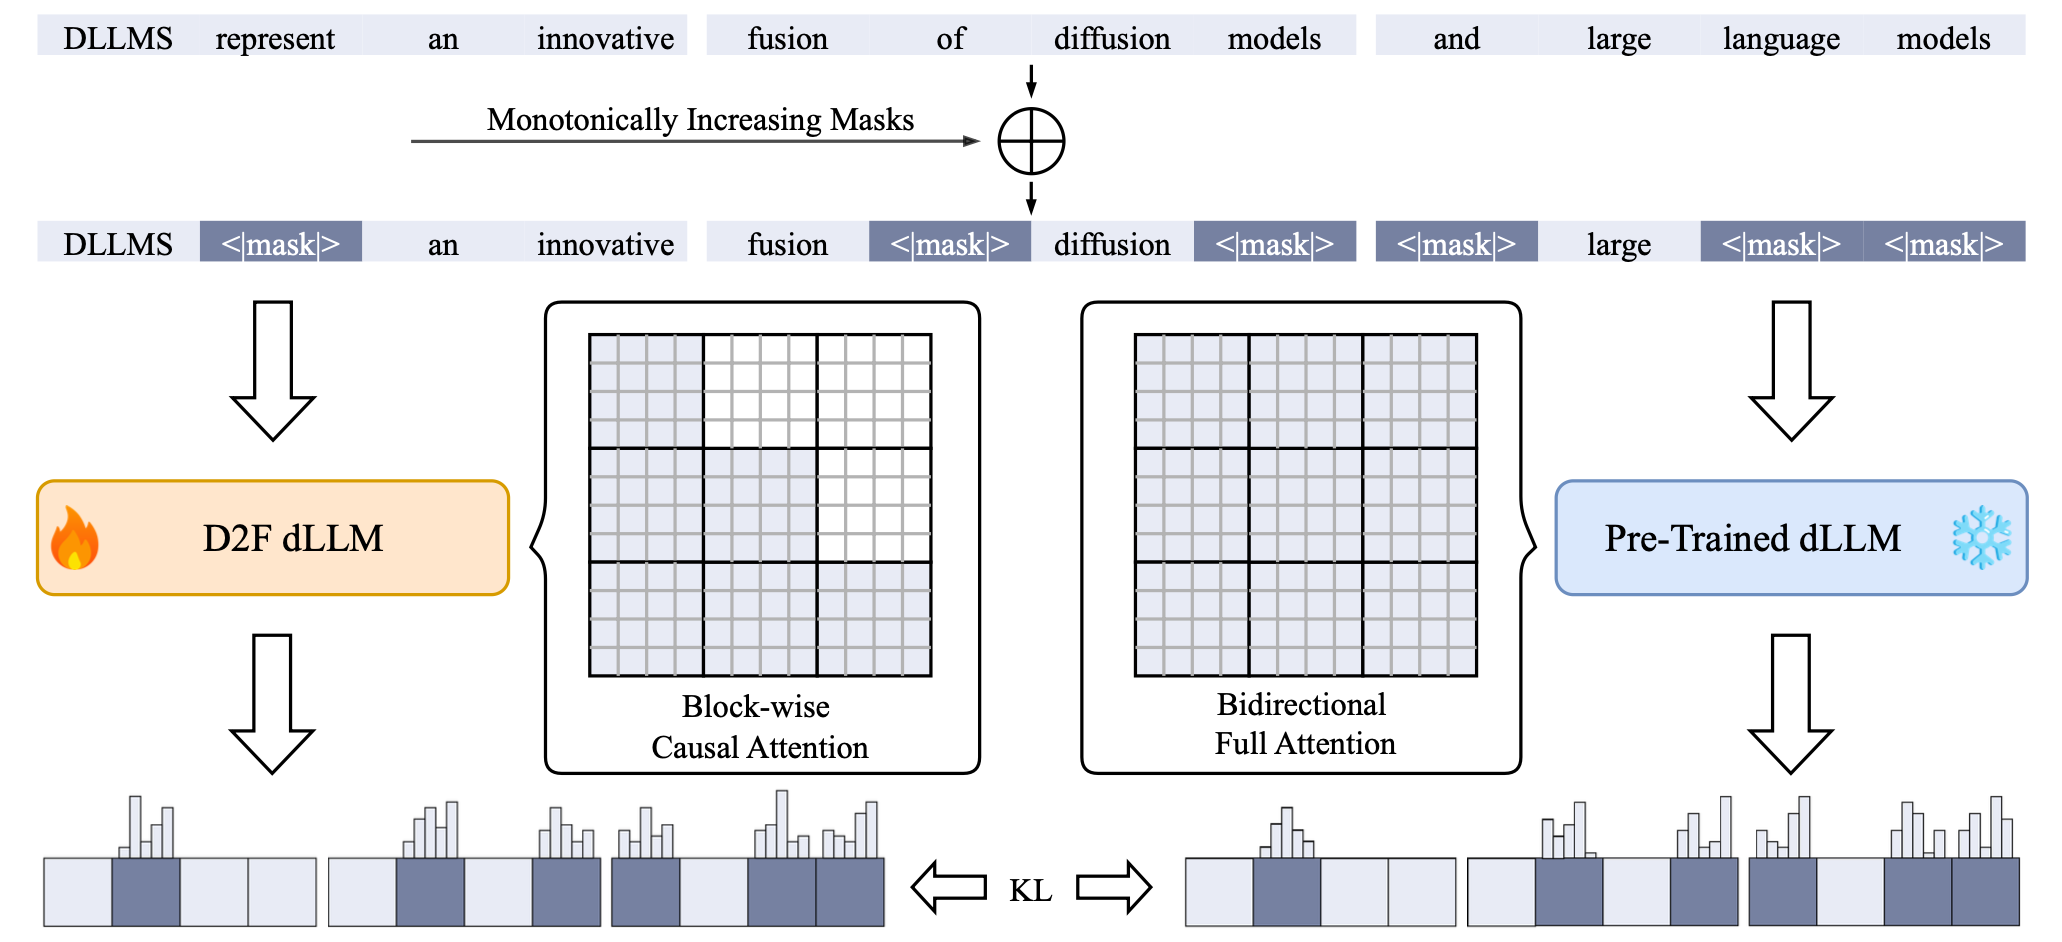
D2F: Diffusion LLMs Can Do Faster-Than-AR Inference via Discrete ...

No Cache Left Idle: Accelerating diffusion model via Extreme-slimming ...

No Cache Left Idle: Accelerating diffusion model via Extreme-slimming ...

Over the past year, we have been pushing diffusion LLMs from an ...
Sparse-dLLM: Accelerating Diffusion LLMs with Dynamic Cache Eviction ...
Advertisement Space (336x280)
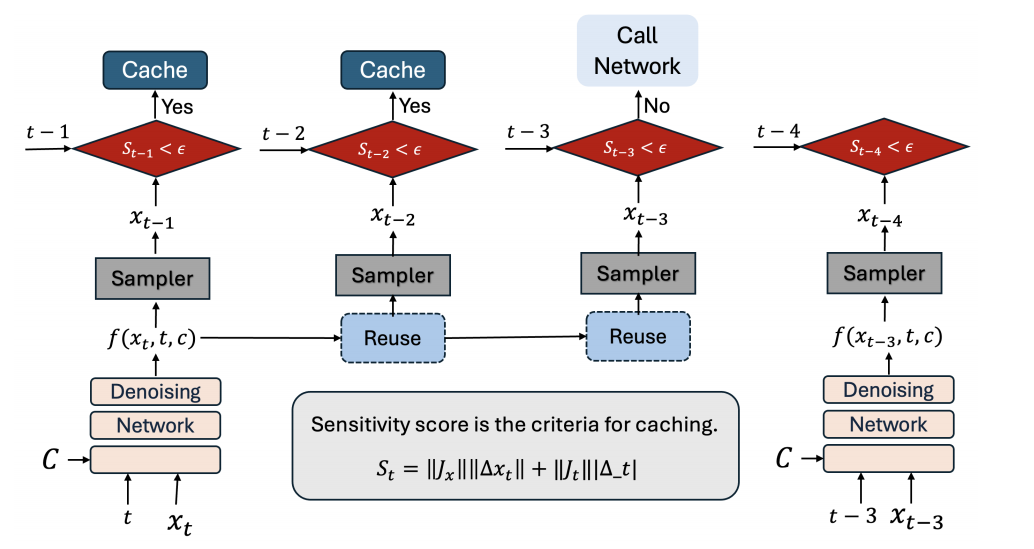
论文阅读:SenCache: Accelerating Diffusion Model Inference via Sensitivity ...

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...

[論文レビュー] Accelerating Diffusion Transformer via Error-Optimized Cache
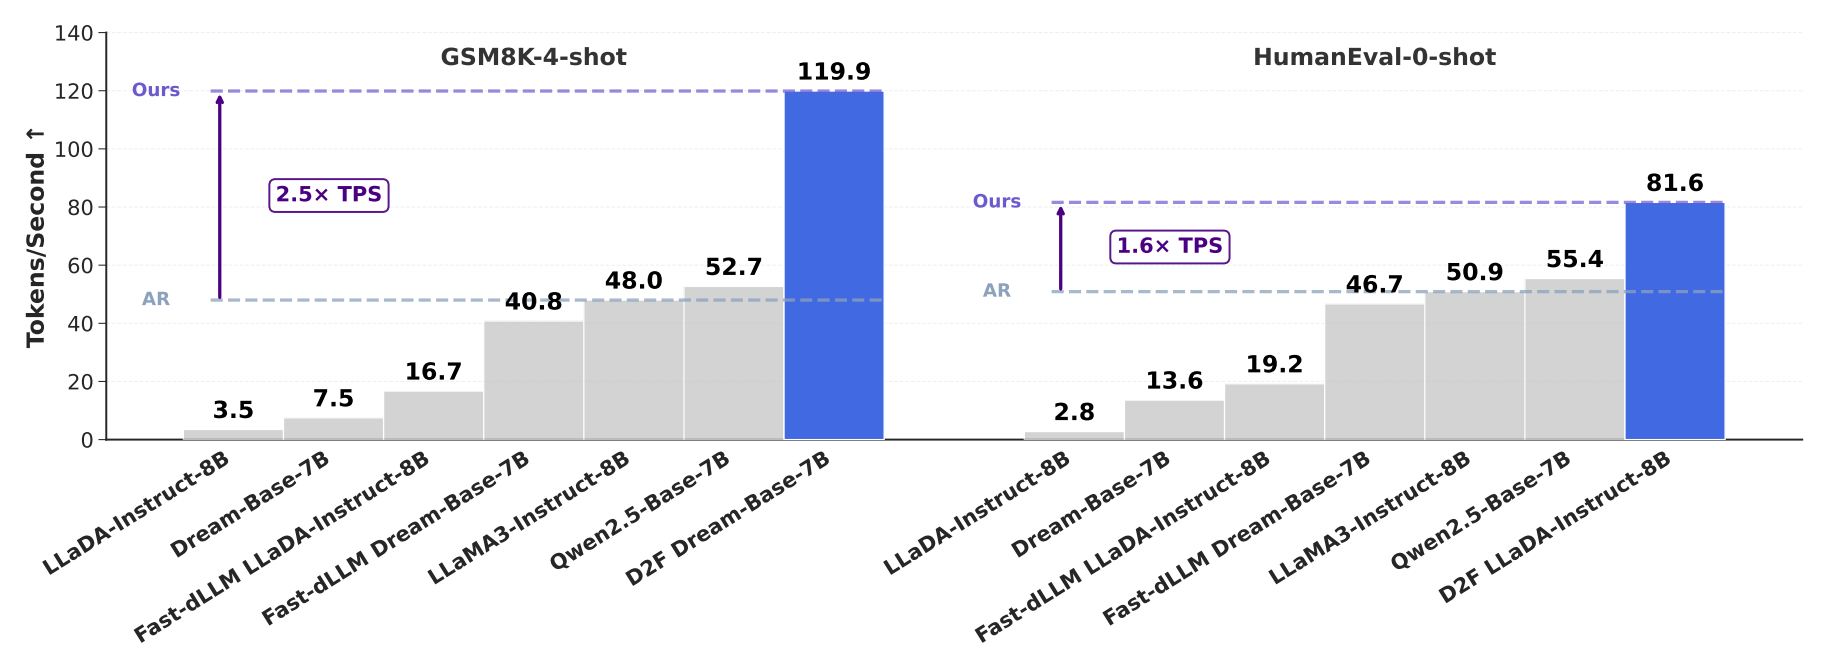
D2F: Diffusion LLMs Can Do Faster-Than-AR Inference via Discrete ...
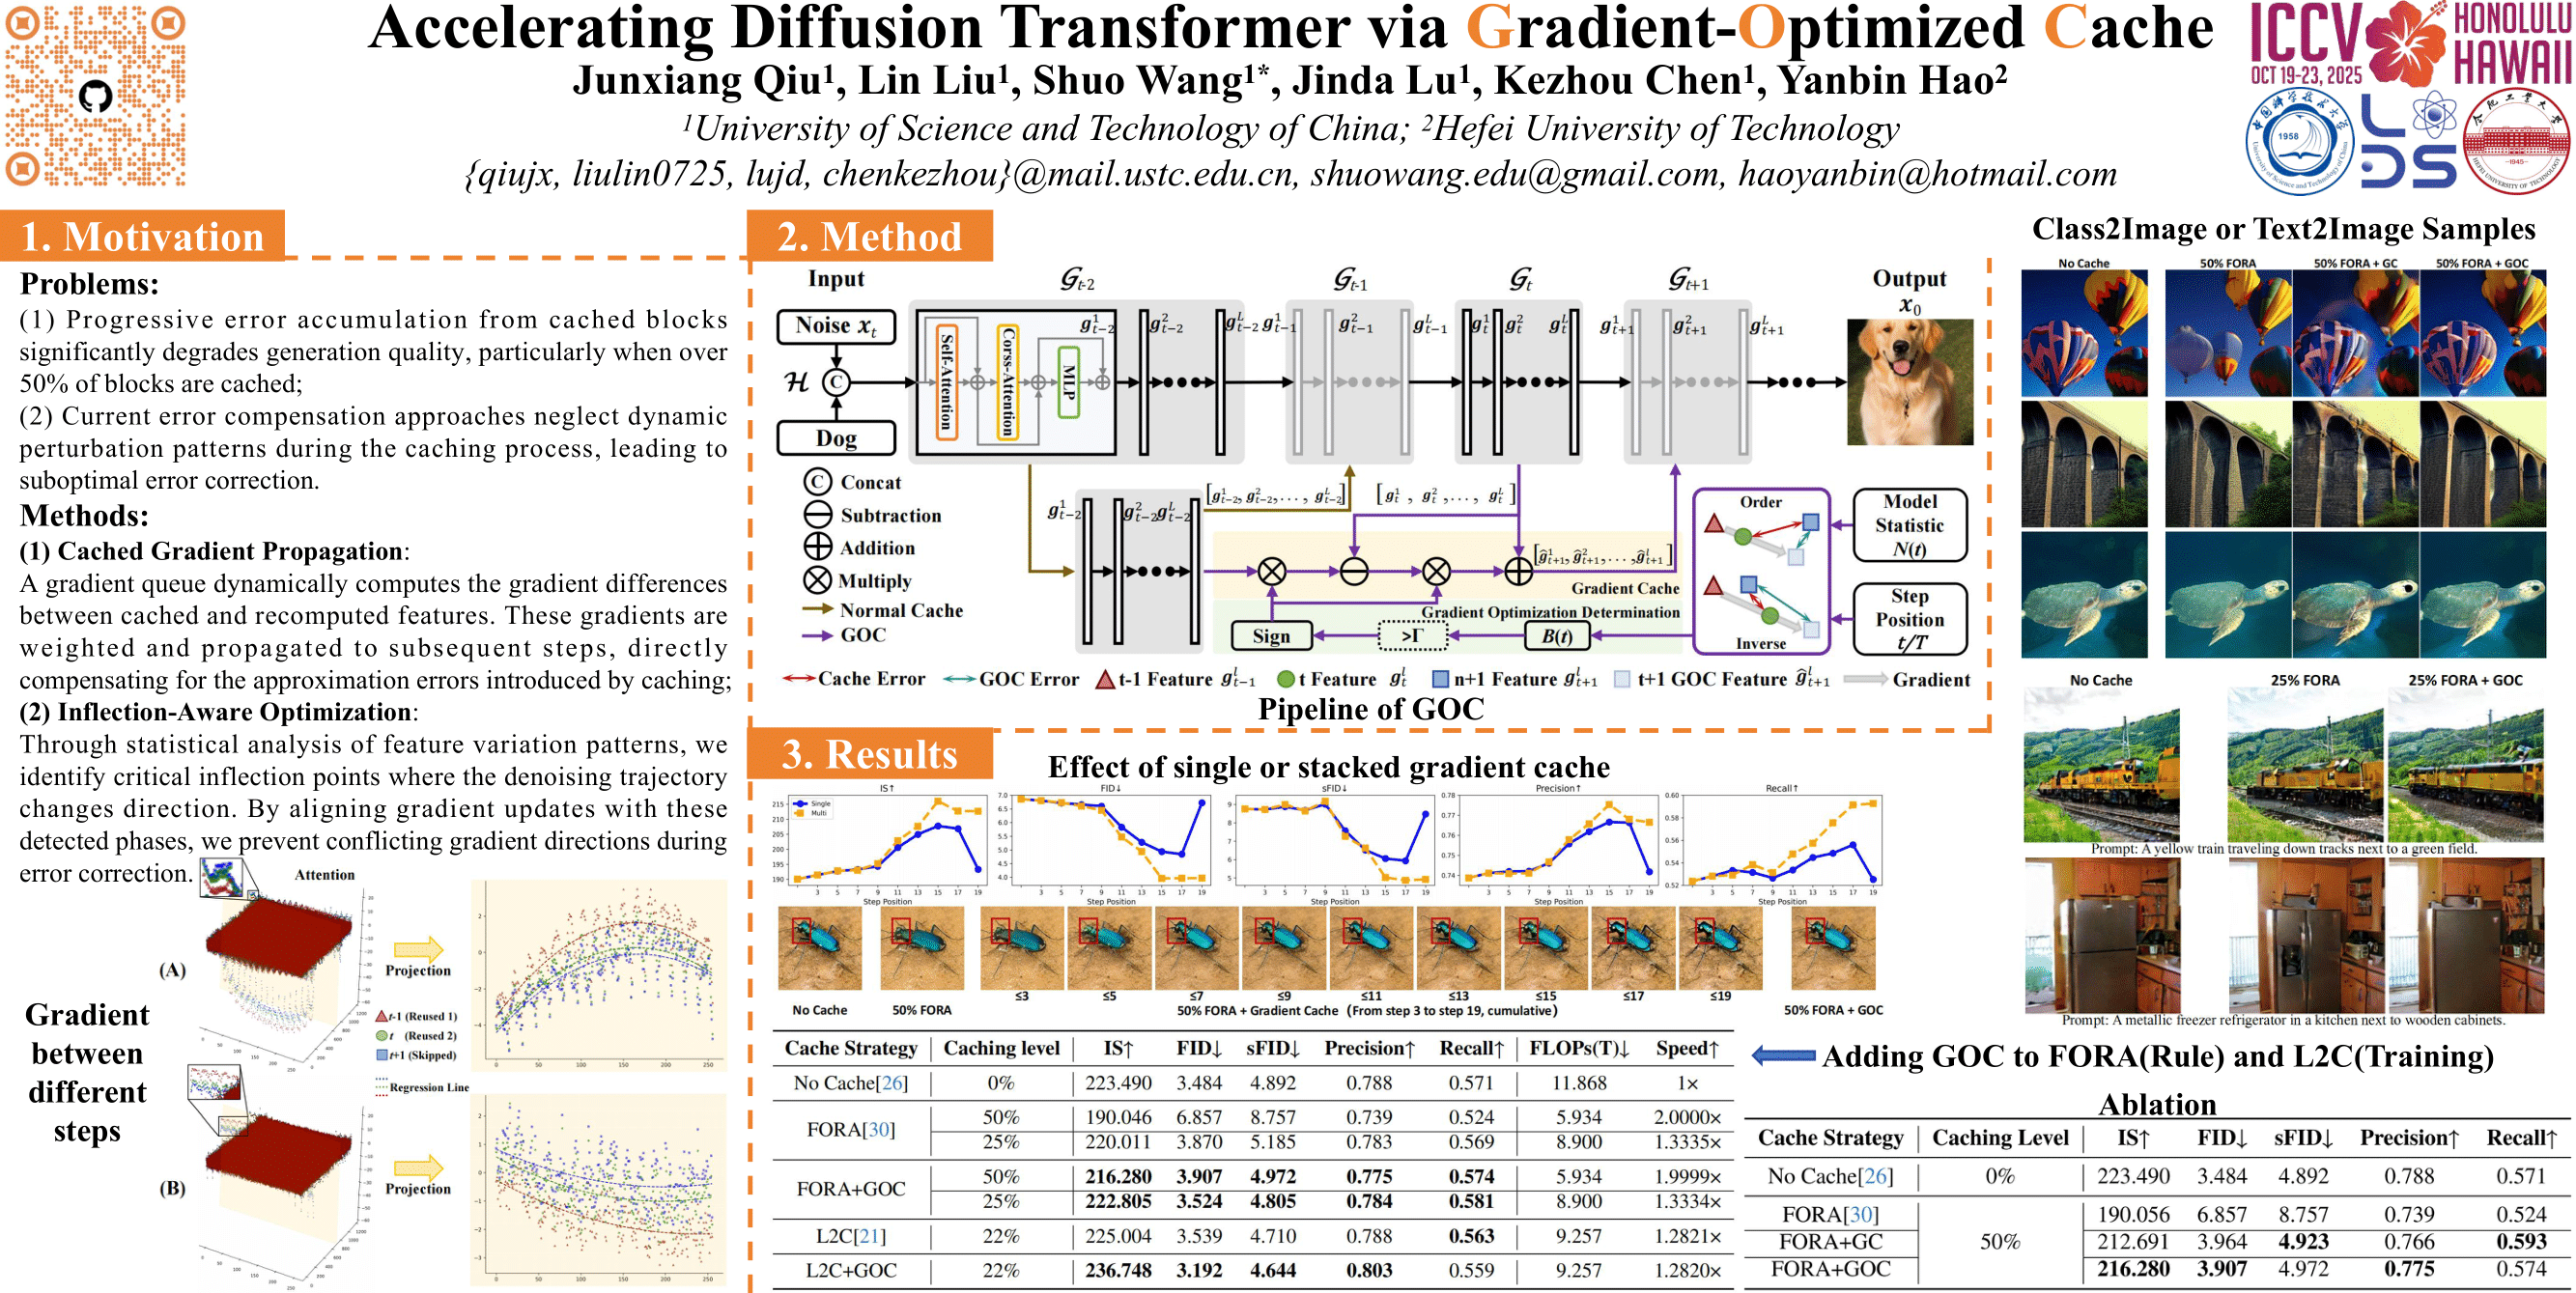
ICCV Poster Accelerating Diffusion Transformer via Gradient-Optimized Cache

Sparse-dLLM: Accelerating Diffusion LLMs with Dynamic Cache Eviction