
Figure 1 From Deep Neural Network Based Speaker Embeddings For End To
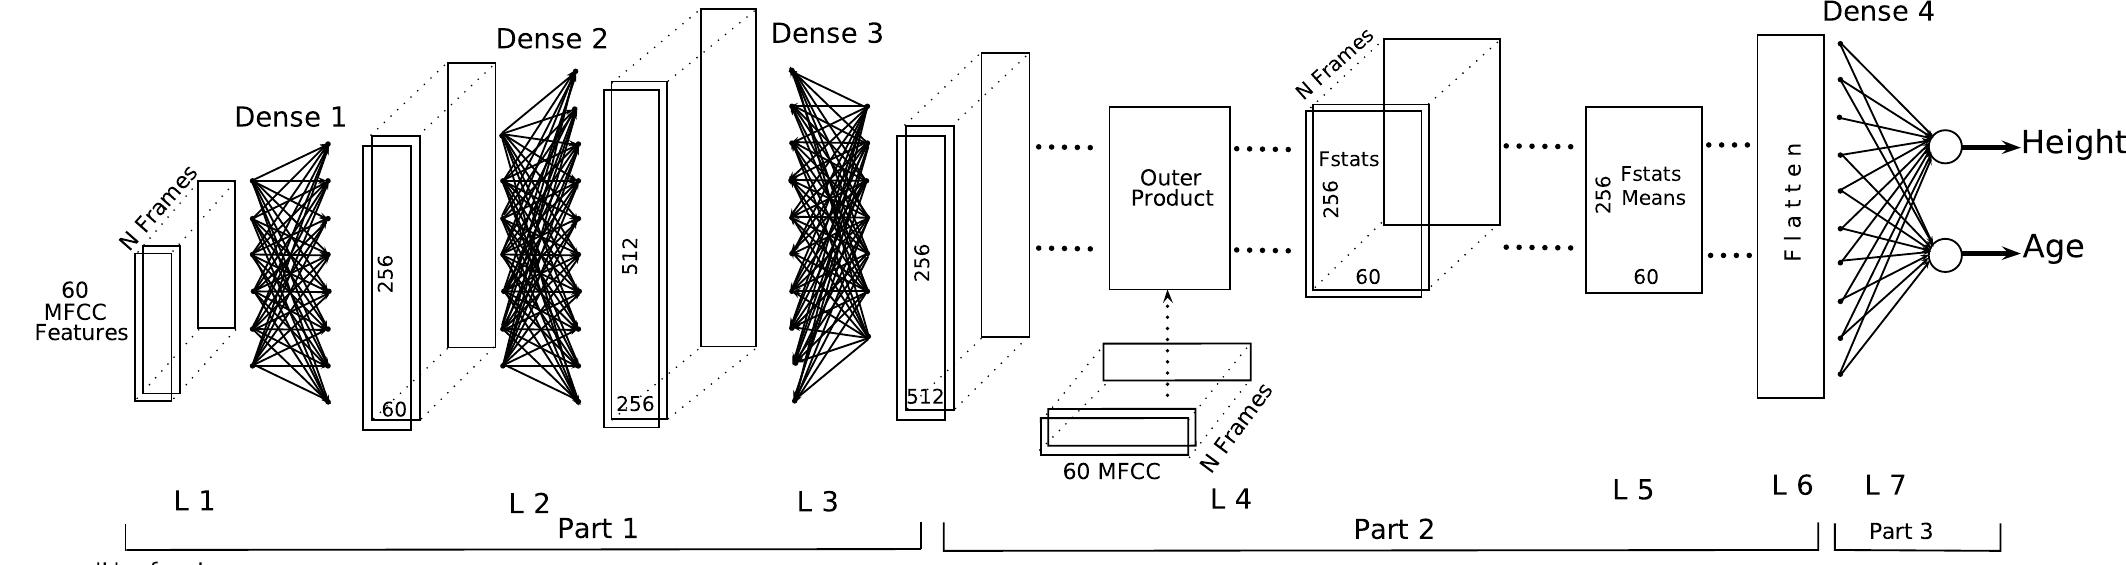
Figure 1 - from A Deep Neural Network Based End to End Model
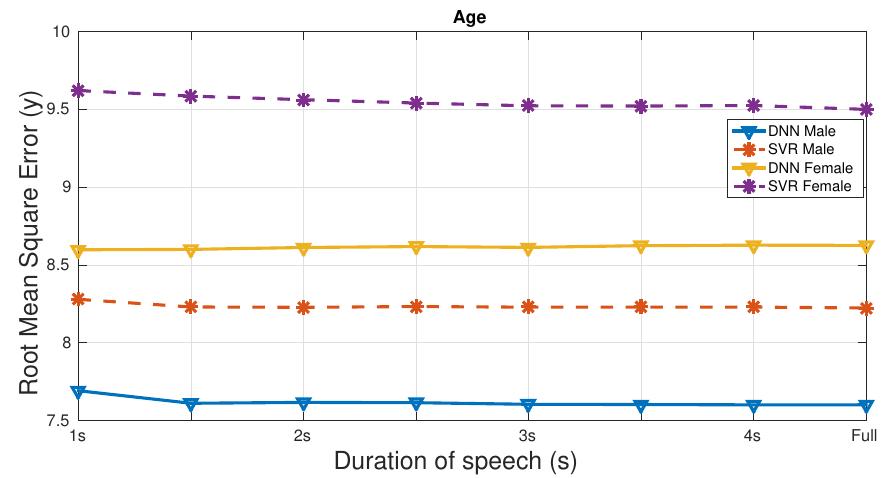
Figure 1 - from A Deep Neural Network Based End to End Model

Figure 1 from Deep neural network-based speaker embeddings for end-to ...
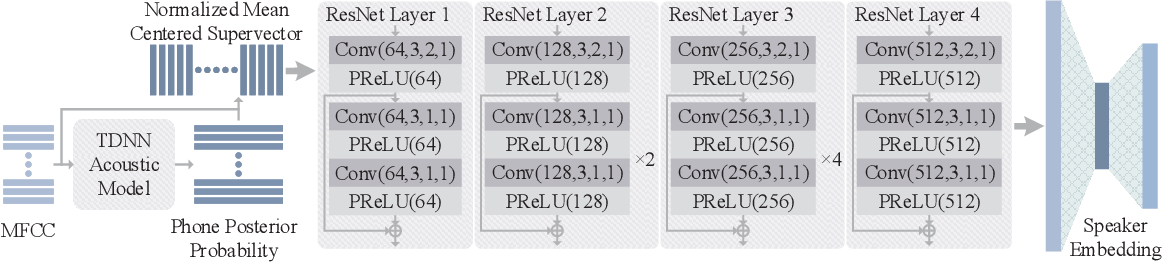
Figure 1 from Deep Speaker Embeddings with Convolutional Neural Network ...
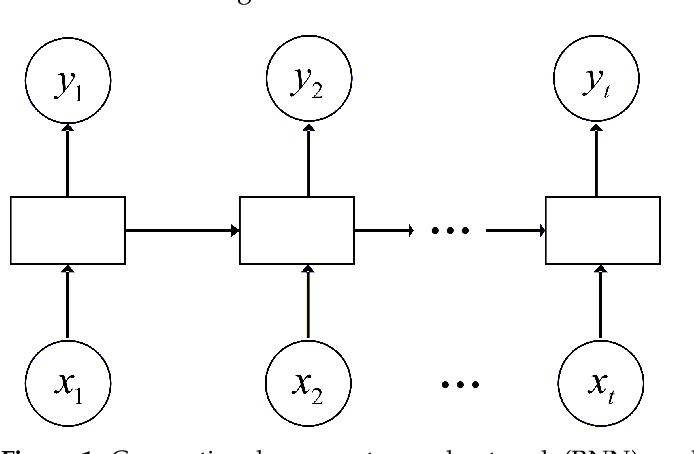
Figure 1 from A Deep Neural Network Model for Speaker Identification ...
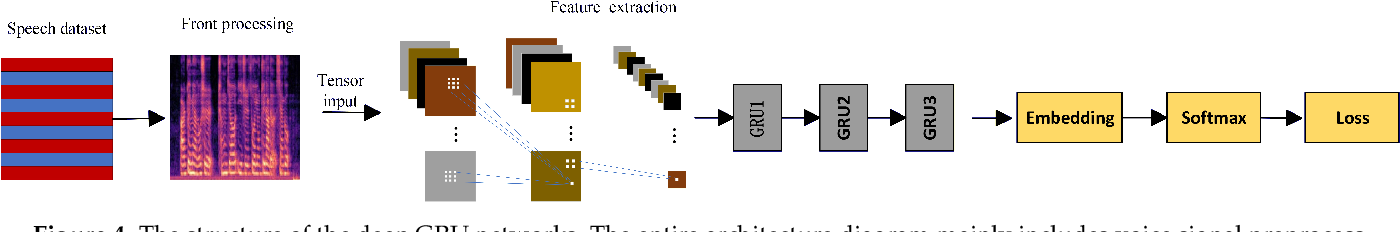
Figure 1 from A Deep Neural Network Model for Speaker Identification ...
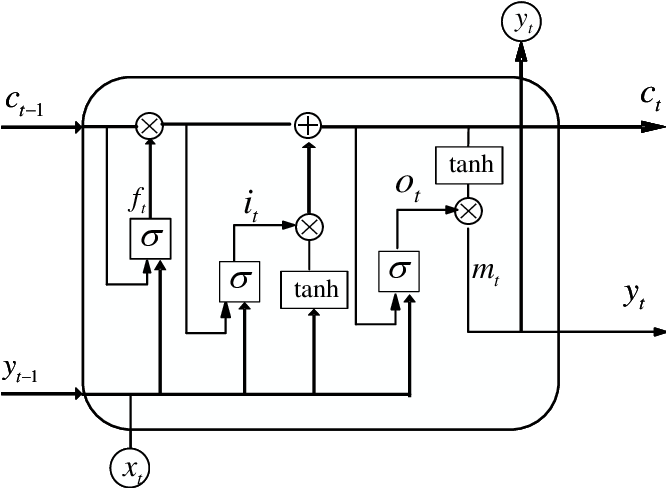
Figure 1 from A Deep Neural Network Model for Speaker Identification ...

Figure 1 from A Deep Neural Network Model for Speaker Identification ...

Figure 1 from Enhanced Feature Aggregation for Deep Neural Network ...

Figure 1 from Neural Speaker Embeddings for Ultrasound-based Silent ...
Advertisement Space (300x250)
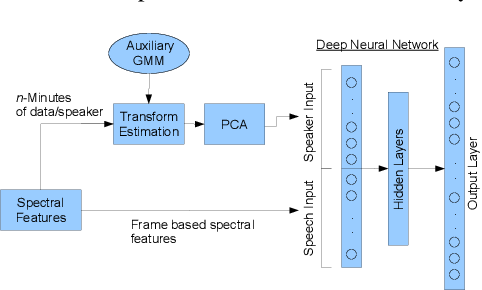
Figure 1 from Deep neural network trained with speaker representation ...

Figure 1 from Unsupervised speaker adaptation of deep neural network ...

Figure 1 from An Experimental Analysis of Deep Neural Network Based ...

Figure 1 from Neural Speech Embeddings for Speech Synthesis Based on ...

Figure 1 from Analyzing And Improving Neural Speaker Embeddings for ASR ...

Figure 1 from Neural Speaker Embeddings for Ultrasound-based Silent ...

Figure 1 from Deep Neural Networks for Automatic Speaker Recognition Do ...

Figure 1 from Speaker Embedding-aware Neural Diarization for Flexible ...

Figure 1 from Deeply Fused Speaker Embeddings for Text-Independent ...
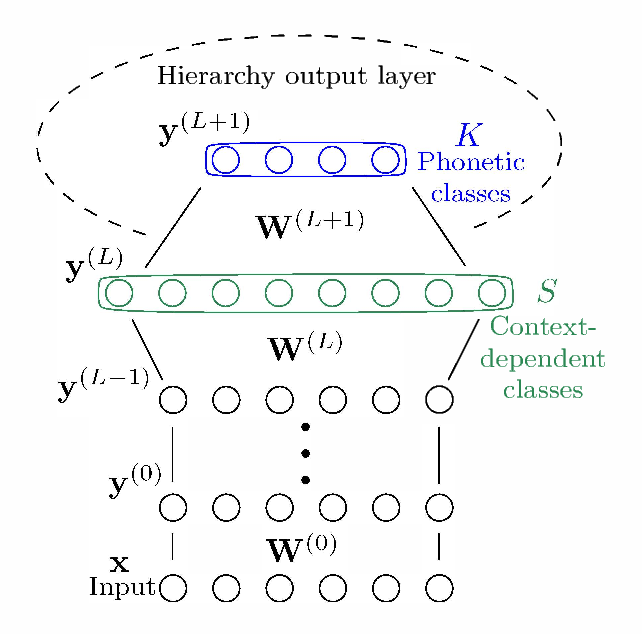
Figure 1 from Speaker adaptation of deep neural networks using a ...
Advertisement Space (336x280)

Figure 1 from Raw Waveform Based Speaker Identification Using Deep ...

Figure 1 from Neural Networks Based Text-Independent Speaker ...

Figure 1 from Multiple Temporal Scales Based Speaker Embeddings ...
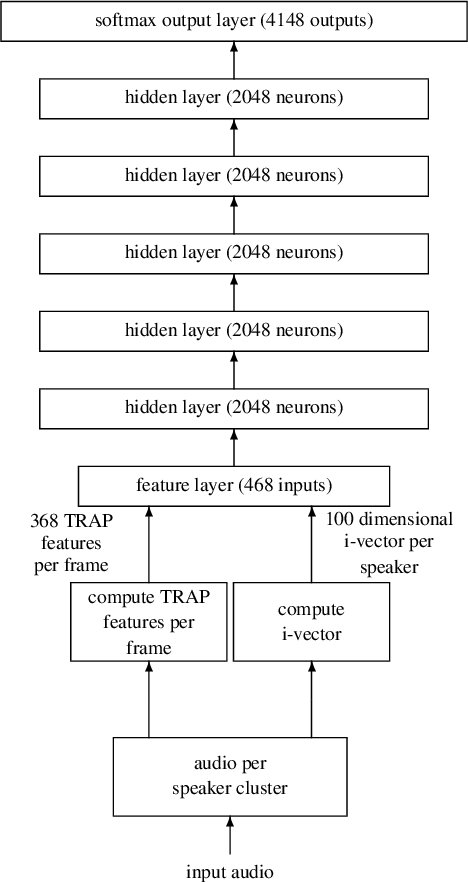
Figure 1 from I-vector-based speaker adaptation of deep neural networks ...

Figure 1 from Voice conversion using deep neural networks with speaker ...
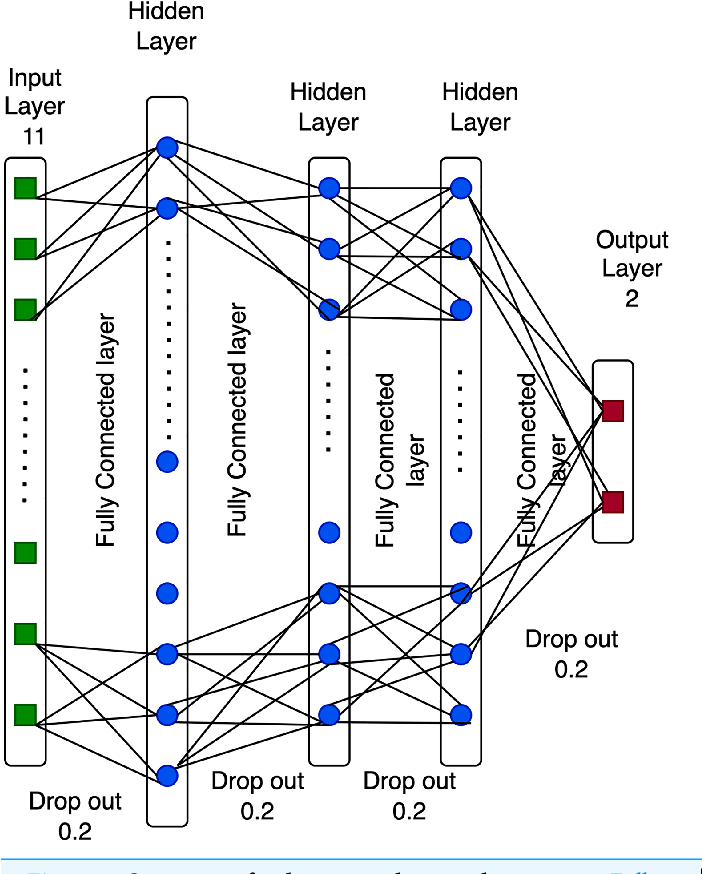
Figure 1 from Data augmentation and deep neural networks for the ...

Figure 1 from Designing Neural Speaker Embeddings with Meta Learning ...
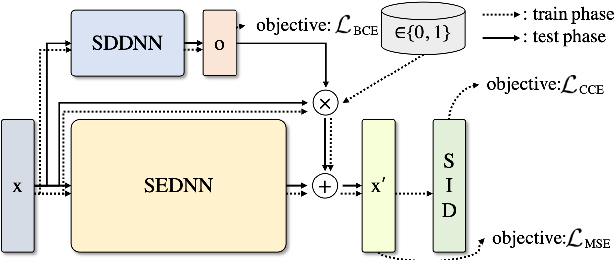
Figure 1 from Selective Deep Speaker Embedding Enhancement for Speaker ...

Figure 1 from Emotion Invariant Speaker Embeddings for Speaker ...

Figure 1 from 3D Convolutional Neural Networks Based Speaker ...
Advertisement Space (336x280)
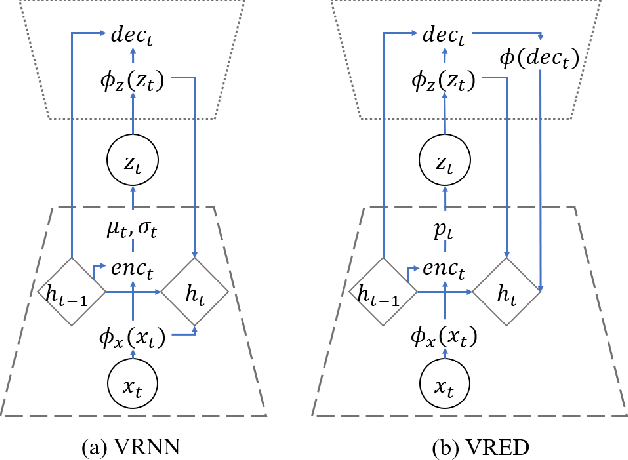
Figure 1 from Deep Neural Networks and End-to-End Learning for Audio ...
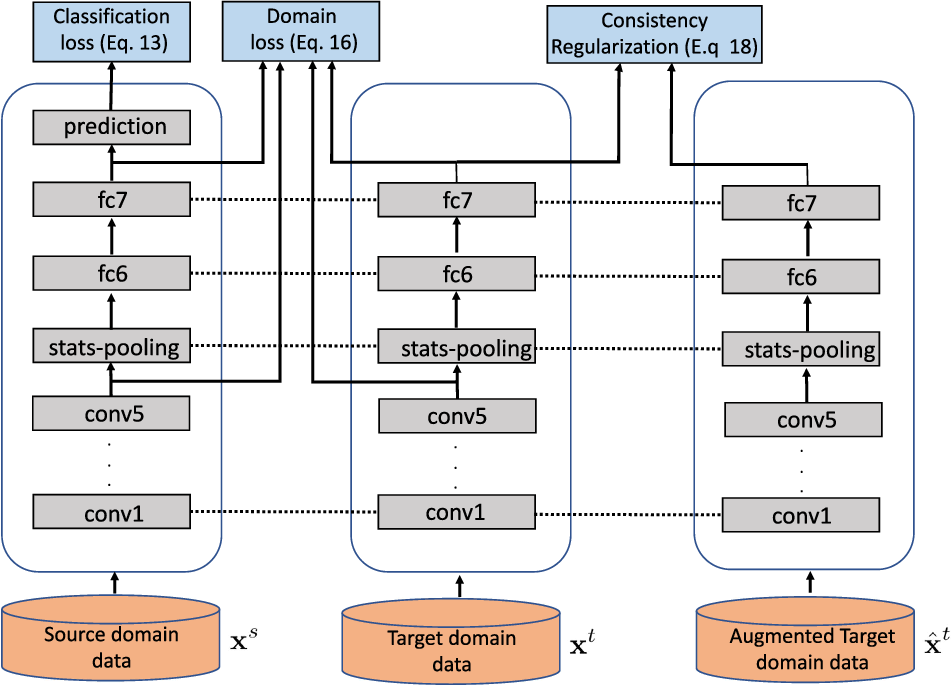
Figure 1 from A Framework for Adapting DNN Speaker Embedding Across ...

Figure 1 from Attention-based Encoder-Decoder Network for End-to-End ...

Table 1 from Hybrid Neural Network-Based Deep Embedding Extractors for ...
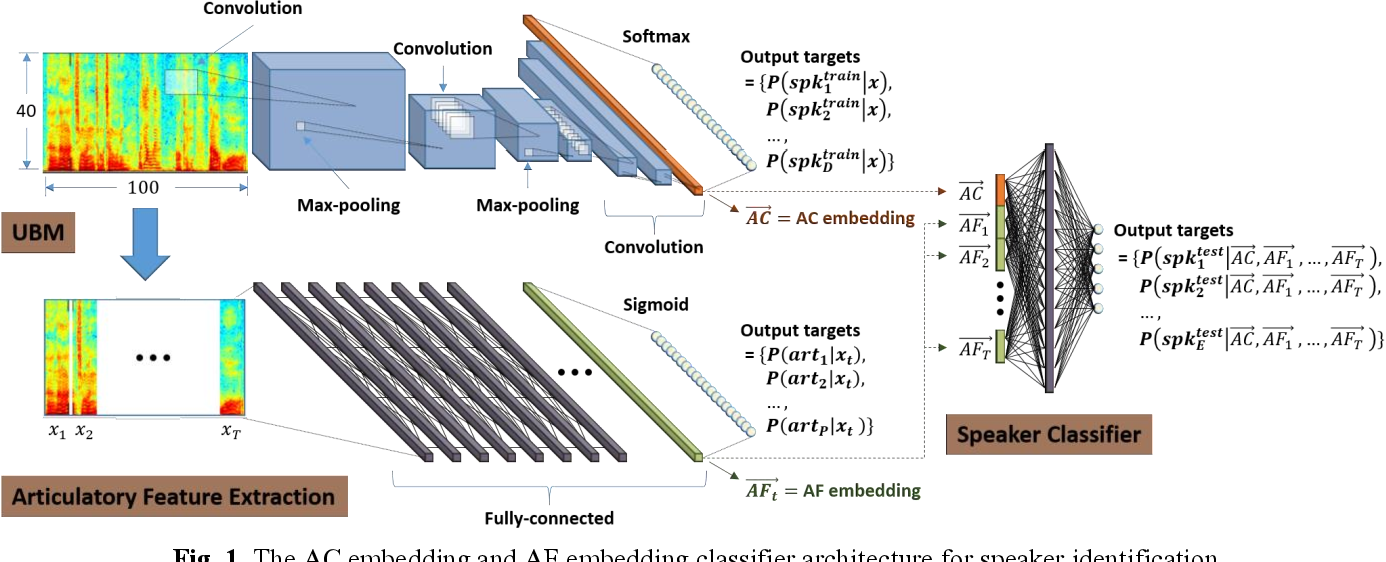
Figure 1 from Combining Deep Embeddings of Acoustic and Articulatory ...

x-vector:Deep Neural Network Embeddings for Text-Independent Speaker ...