
Figure 1 From Efficient Vision Language Pretraining With Visual

Figure 1 from Efficient Vision-Language Pretraining with Visual ...

Figure 1 from Efficient Vision-Language Pretraining with Visual ...

Figure 1 from Efficient Vision-Language Pretraining with Visual ...

Figure 1 from Efficient Vision-Language Pretraining with Visual ...

Figure 1 from Memory-Space Visual Prompting for Efficient Vision ...
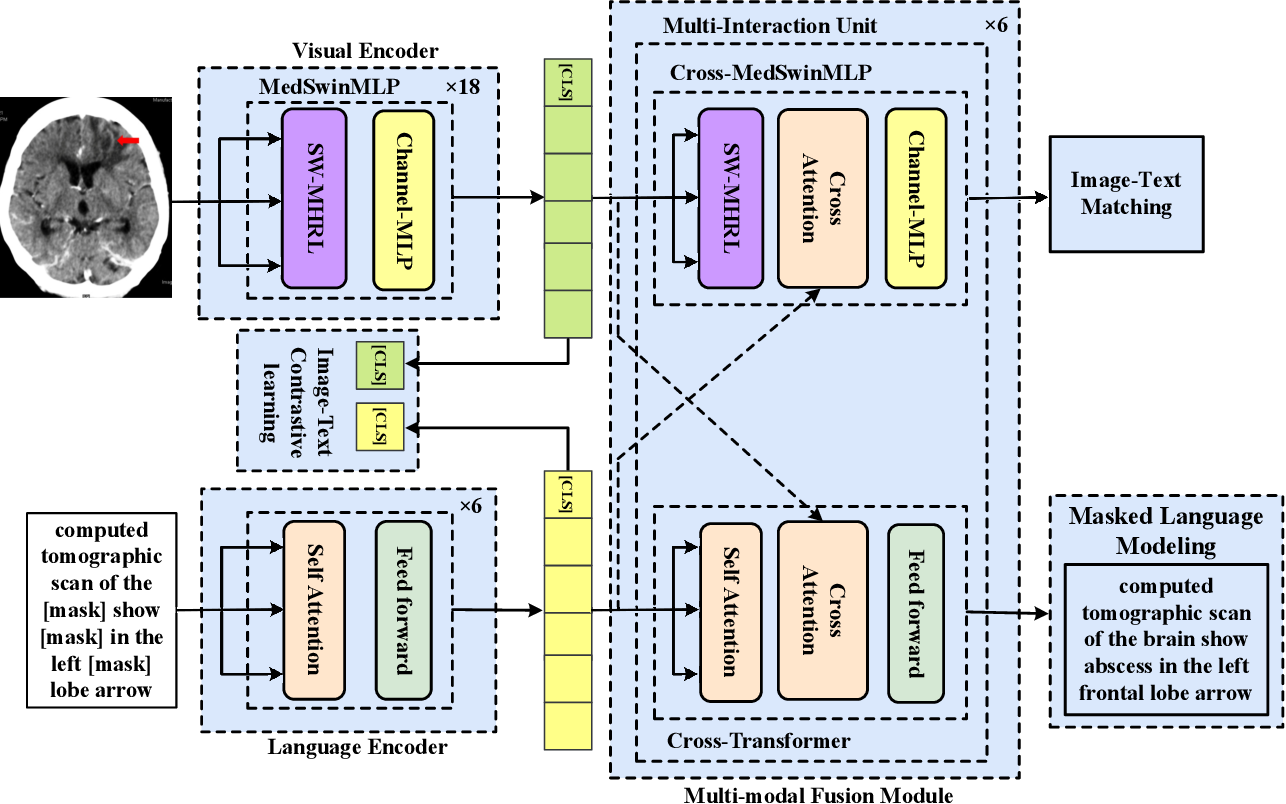
Figure 1 from MLP-Based Vision Language Pre-Training for Medical Visual ...
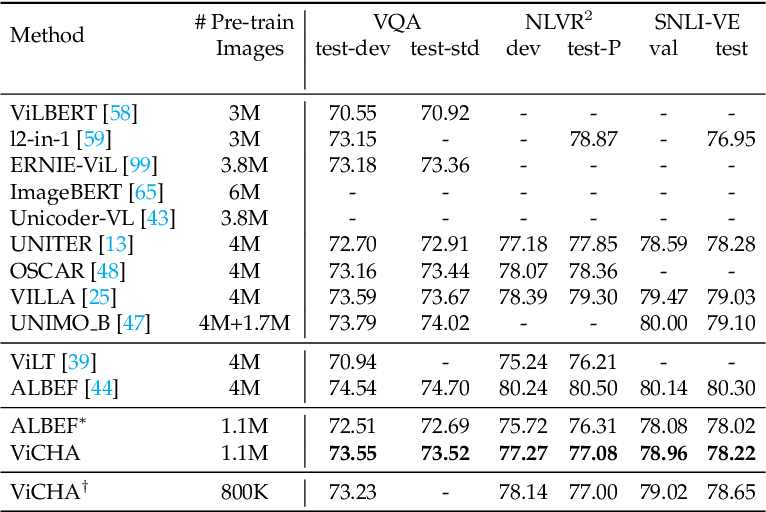
Table 1 from Efficient Vision-Language Pretraining with Visual Concepts ...
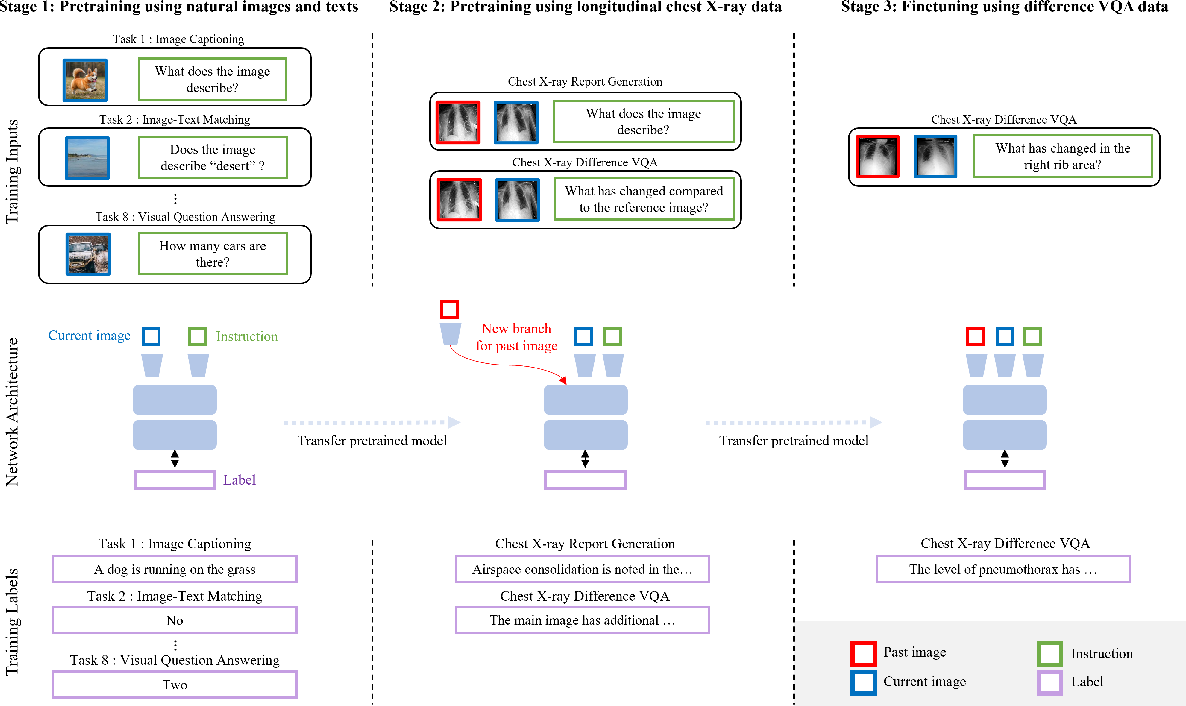
Figure 1 from Pretraining Vision-Language Model for Difference Visual ...
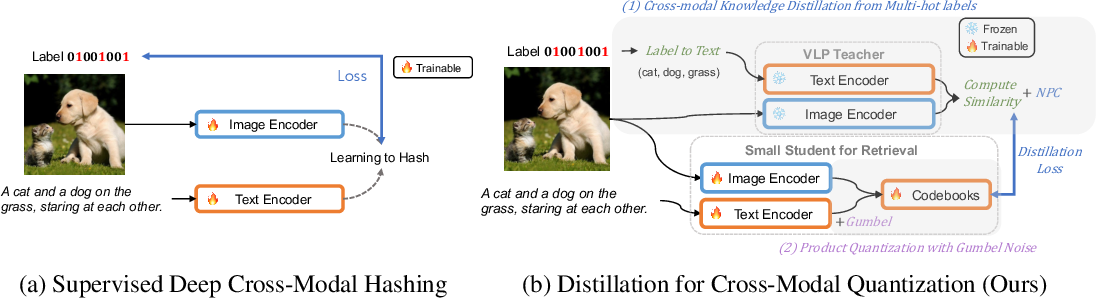
Figure 1 from Distilling Vision-Language Pretraining for Efficient ...
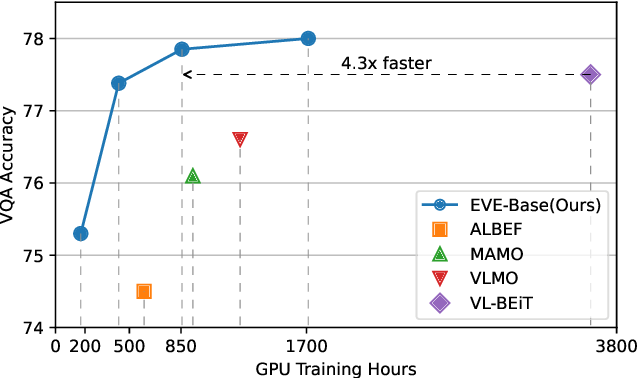
Figure 1 from EVE: Efficient Vision-Language Pre-training with Masked ...
Advertisement Space (300x250)

Augmenting Vision Language Pretraining by Learning Codebook with Visual ...

Effective End-to-End Vision Language Pretraining with Semantic Visual ...

Figure 1 from EVE: Efficient Vision-Language Pre-training with Masked ...

Figure 1 from Retrieval-based Knowledge Augmented Vision Language Pre ...

Figure 1 from Relation Enhanced Vision Language Pre-Training | Semantic ...
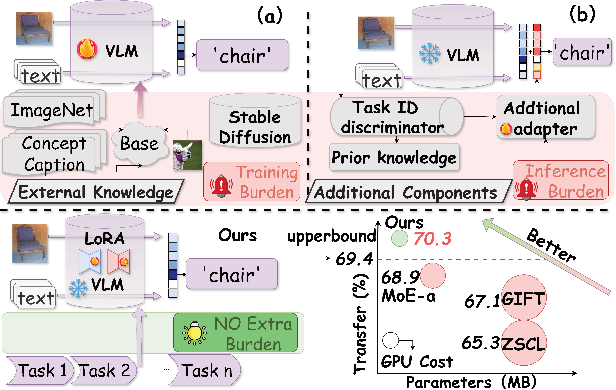
Figure 1 from Decomposing and Composing: Towards Efficient Vision ...
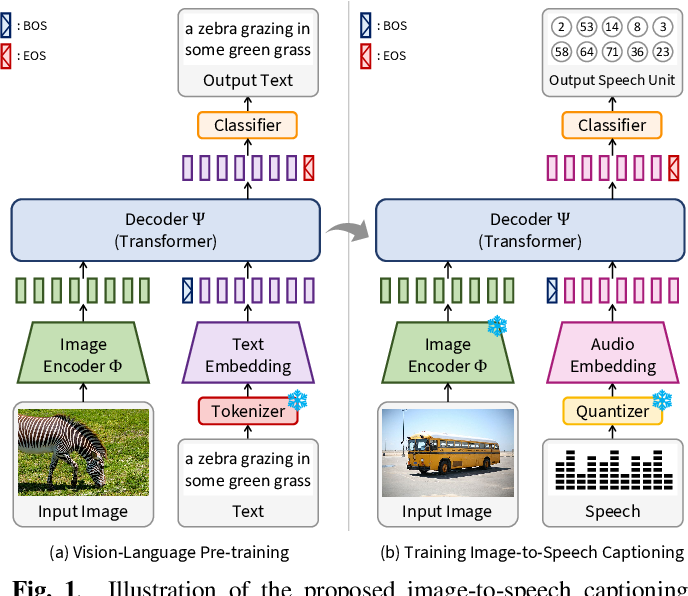
Figure 1 from Towards Practical and Efficient Image-to-Speech ...

Figure 1 from Enhancing Vision-Language Pre-Training with Jointly ...
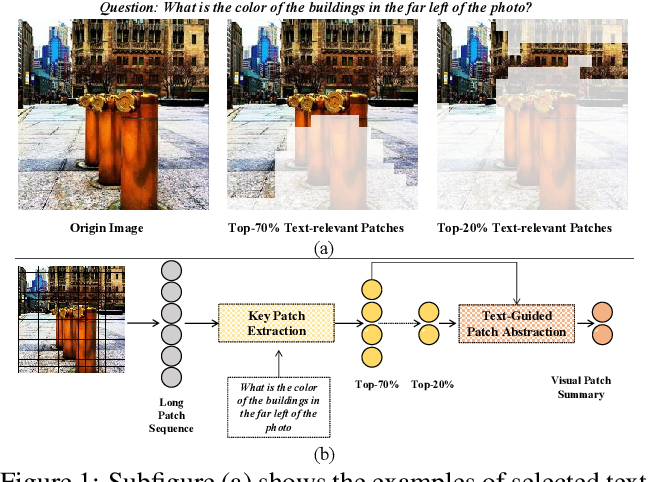
Figure 1 from BUS : Efficient and Effective Vision-language Pre ...
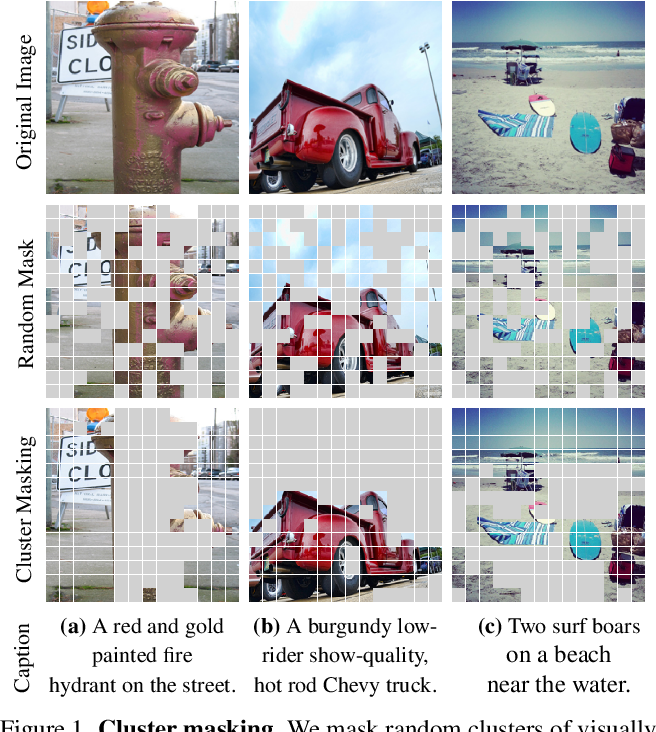
Figure 1 from Efficient Vision-Language Pre-Training by Cluster Masking ...
Advertisement Space (336x280)

Figure 1 from Instruction-Following Agents with Jointly Pre-Trained ...

Figure 1 from COPA : Efficient Vision-Language Pre-training through ...
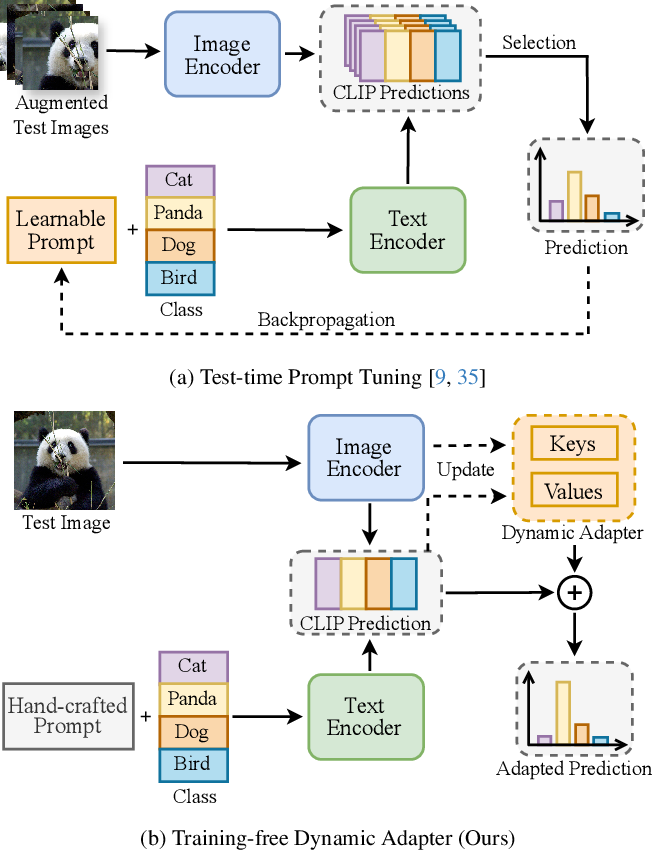
Figure 1 from Efficient Test-Time Adaptation of Vision-Language Models ...

Figure 1 from Vision-Language Pre-training with Object Contrastive ...

Figure 1 from Enhancing Vision-Language Pre-Training with Jointly ...
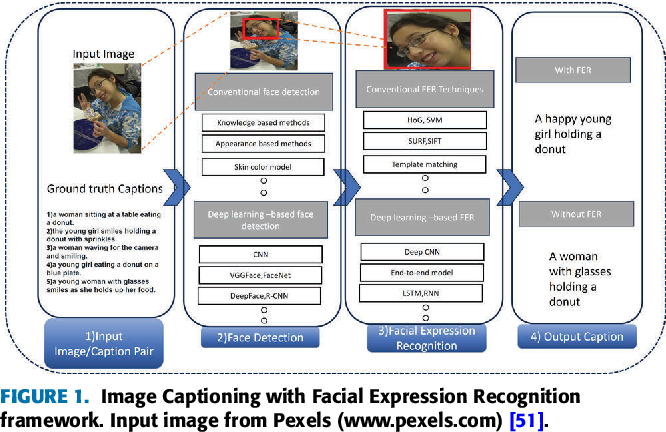
Figure 1 from Vision–Language Pretraining for Image Captioning Using ...
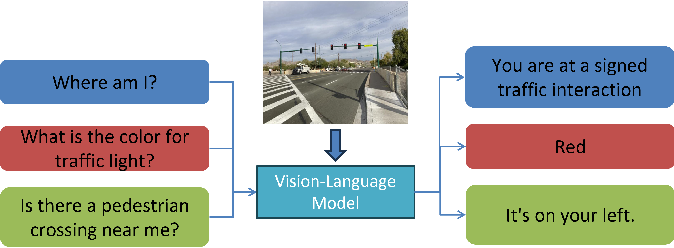
Figure 1 from Fine-Tuning Vision-Language Models for Visual Navigation ...
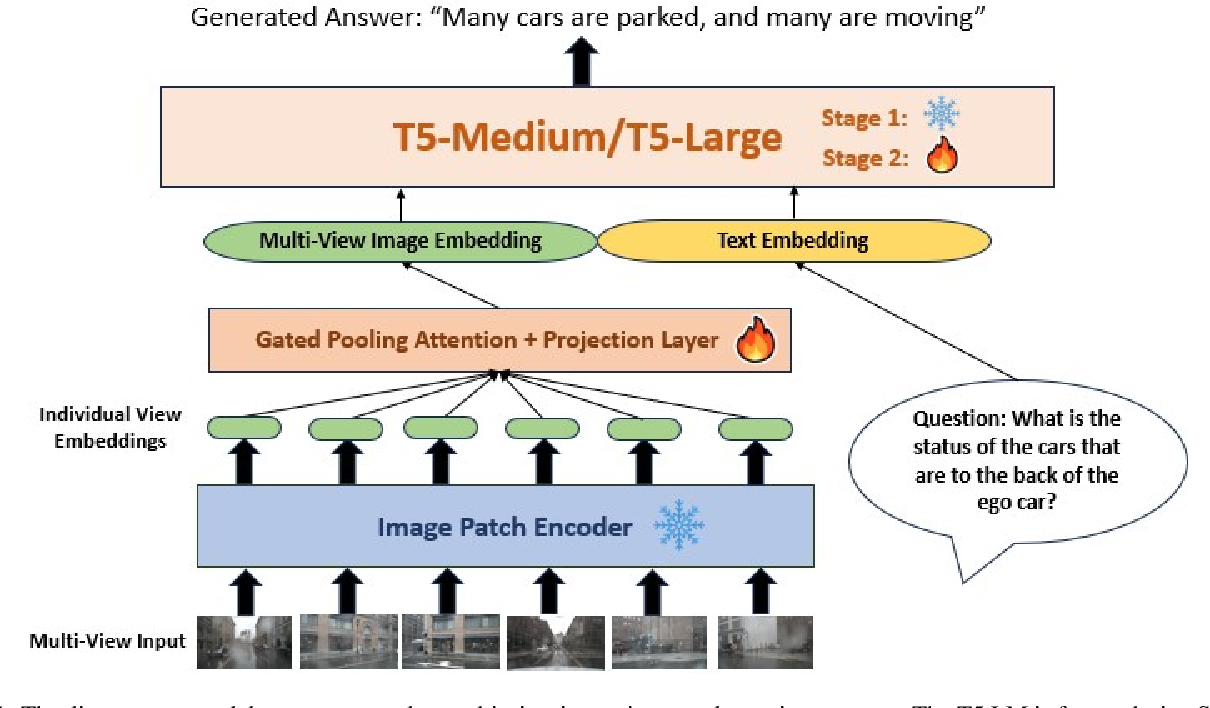
Figure 1 from Multi-Frame, Lightweight & Efficient Vision-Language ...

Figure 1 from Visual-Language Navigation Pretraining via Prompt-based ...

Figure 1 from Instruction-Following Agents with Jointly Pre-Trained ...
Advertisement Space (336x280)

Figure 1 from Knowledge Boosting: Rethinking Medical Contrastive Vision ...
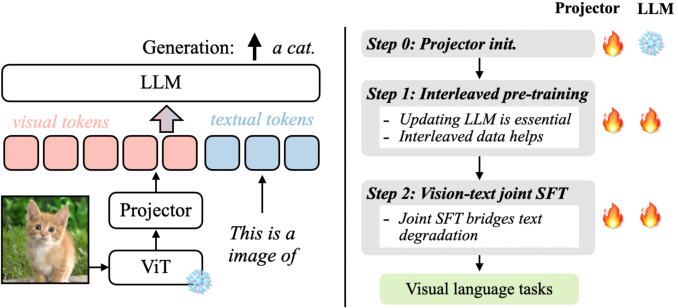
Figure 2 from VILA: On Pre-training for Visual Language Models ...
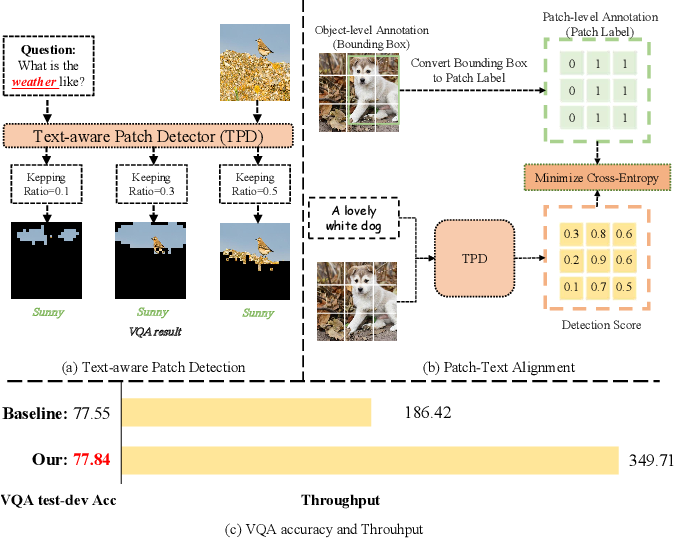
Figure 1 from COPA : Efficient Vision-Language Pre-training through ...

Figure 1 from Knowledge Boosting: Rethinking Medical Contrastive Vision ...

Efficient Vision-Language Pretraining with Visual Concepts and ...

Figure 1 from Unified Vision-Language Pre-Training for Image Captioning ...