
Figure 1 From Fixed Point Quantization For Vision Transformer

Figure 1 from Fixed-point Quantization for Vision Transformer ...
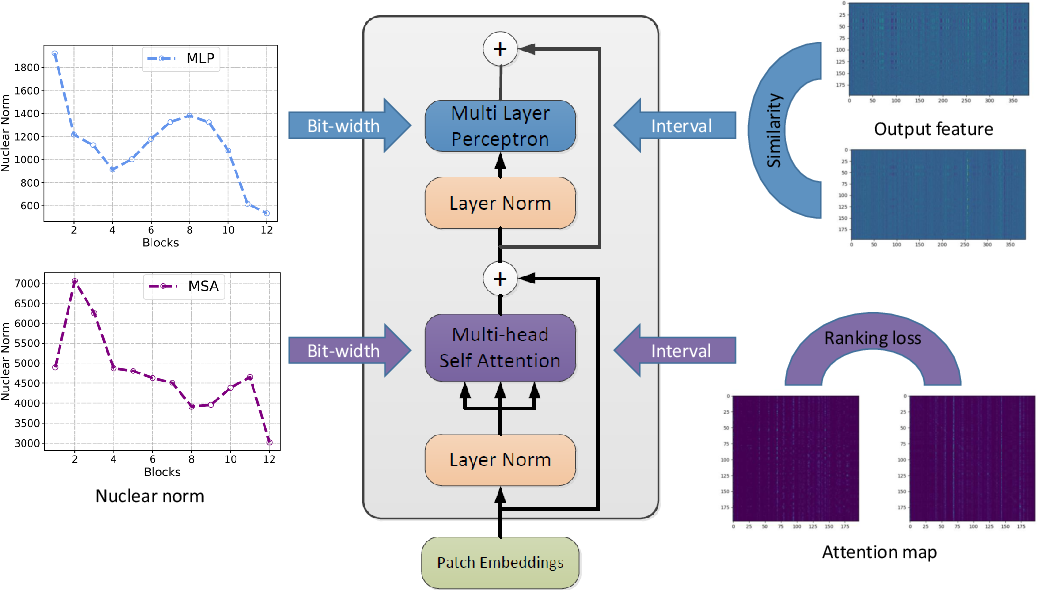
Figure 1 from Post-Training Quantization for Vision Transformer ...

Figure 1 from Post-Training Quantization for Vision Transformer in ...

Figure 1 from Fixed-point Quantization for Vision Transformer ...

Figure 1 from Fixed-point Quantization for Vision Transformer ...

Figure 1 from Fixed-point Quantization for Vision Transformer ...

Figure 1 from Towards Accurate Post-Training Quantization for Vision ...
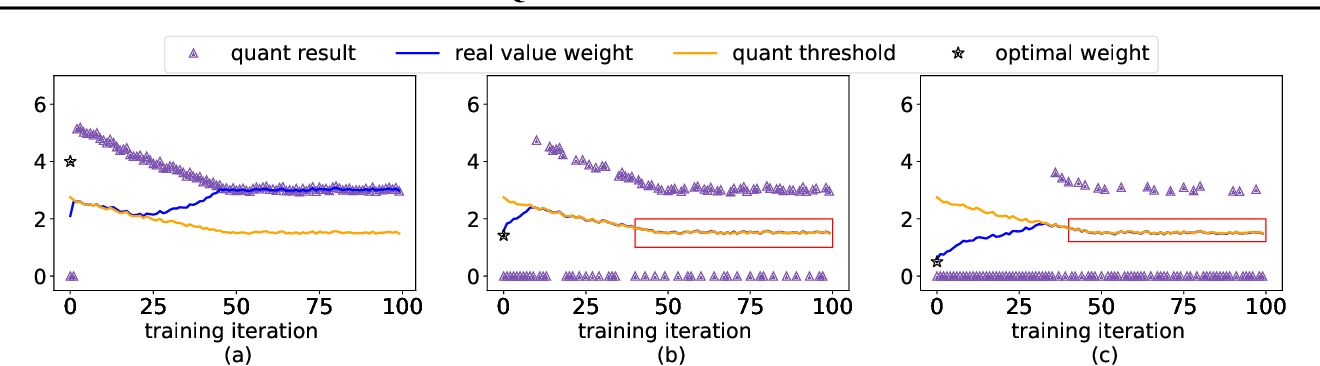
Figure 1 from Oscillation-free Quantization for Low-bit Vision ...

Figure 1 from Vector Quantization for Machine Vision | Semantic Scholar
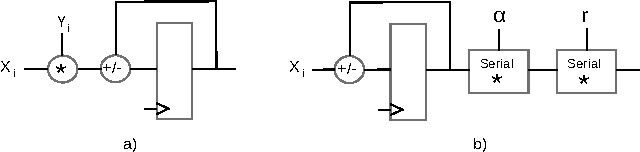
Figure 1 from Vector Quantization for Machine Vision | Semantic Scholar
Advertisement Space (300x250)
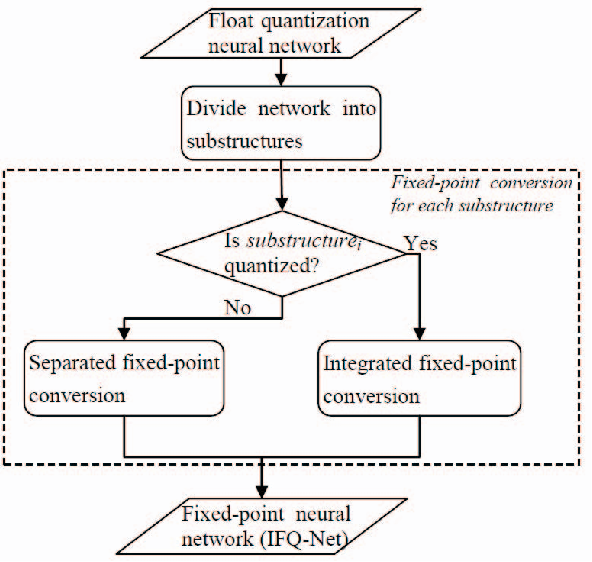
Figure 1 from IFQ-Net: Integrated Fixed-Point Quantization Networks for ...

Figure 1 from Boost Vision Transformer with GPU-Friendly Sparsity and ...

Figure 1 from Trained Uniform Quantization for Accurate and Efficient ...

Figure 1 from Towards Vision Transformer Unrolling Fixed-Point ...

Figure 1 from Boost Vision Transformer with GPU-Friendly Sparsity and ...

Figure 1 from Boost Vision Transformer with GPU-Friendly Sparsity and ...

Figure 1 from Vision Transformer With Quadrangle Attention | Semantic ...

Figure 8 from Model Quantization and Hardware Acceleration for Vision ...
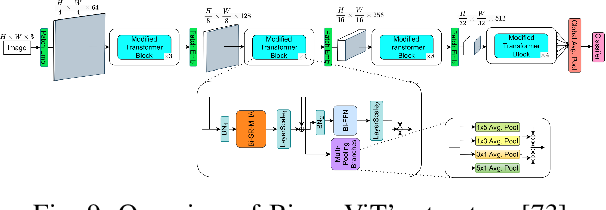
Figure 9 from Model Quantization and Hardware Acceleration for Vision ...
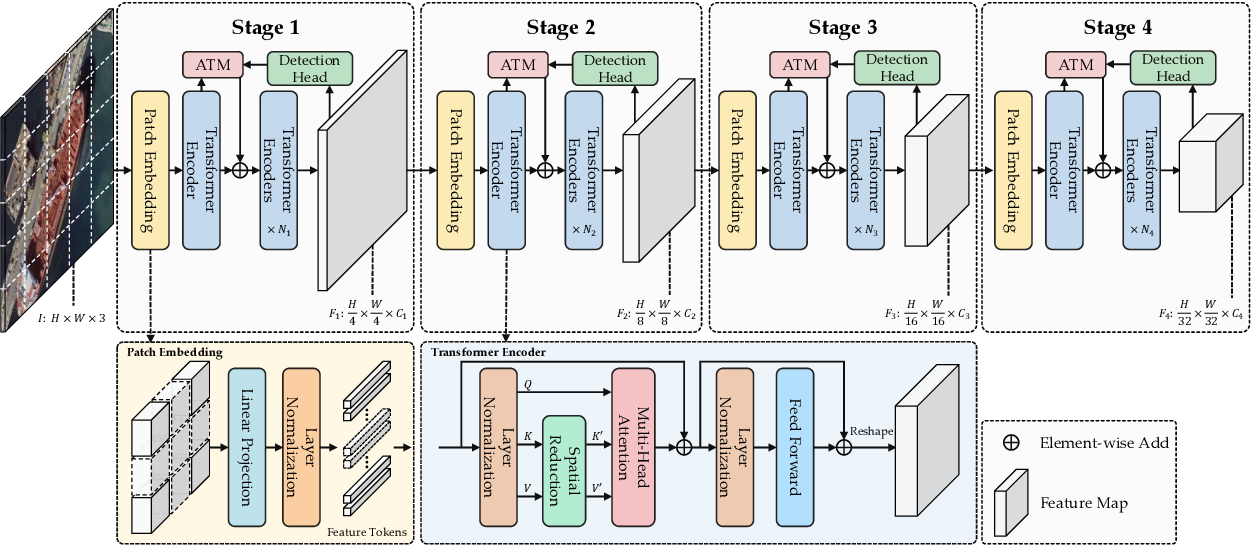
Figure 1 from Angle Tokenization Guided Multi-Scale Vision Transformer ...
Advertisement Space (336x280)

Figure 2 from A Simple Vision Transformer for Weakly Semi-supervised 3D ...
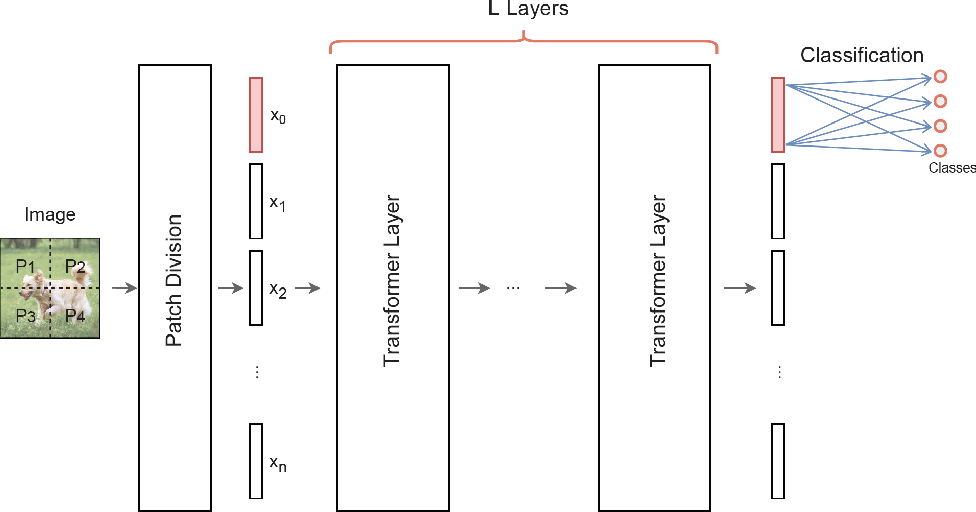
Figure 1 from Quantum Vision Transformers | Semantic Scholar

Figure 1 from M2-ViT: Accelerating Hybrid Vision Transformers With Two ...

Figure 1 from A Comprehensive Study of Vision Transformers on Dense ...

Figure 1 from Quantformer: Learning Extremely Low-Precision Vision ...
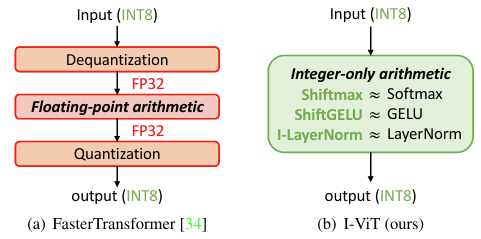
I-ViT Integer-only Quantization for Efficient Vision Transformer ...
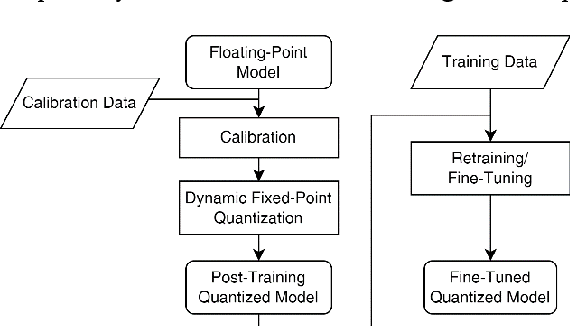
Figure 1 from Multi-Scale Dynamic Fixed-Point Quantization and Training ...

(PDF) Scaled Quantization for the Vision Transformer

Figure 1 from M2-ViT: Accelerating Hybrid Vision Transformers With Two ...

Robustness-Enhanced Data-Free Quantization for Vision Transformer ...
Advertisement Space (336x280)

Figure 1 from Zero-Centered Fixed-Point Quantization With Iterative ...

(PDF) Q-ViT: Fully Differentiable Quantization for Vision Transformer
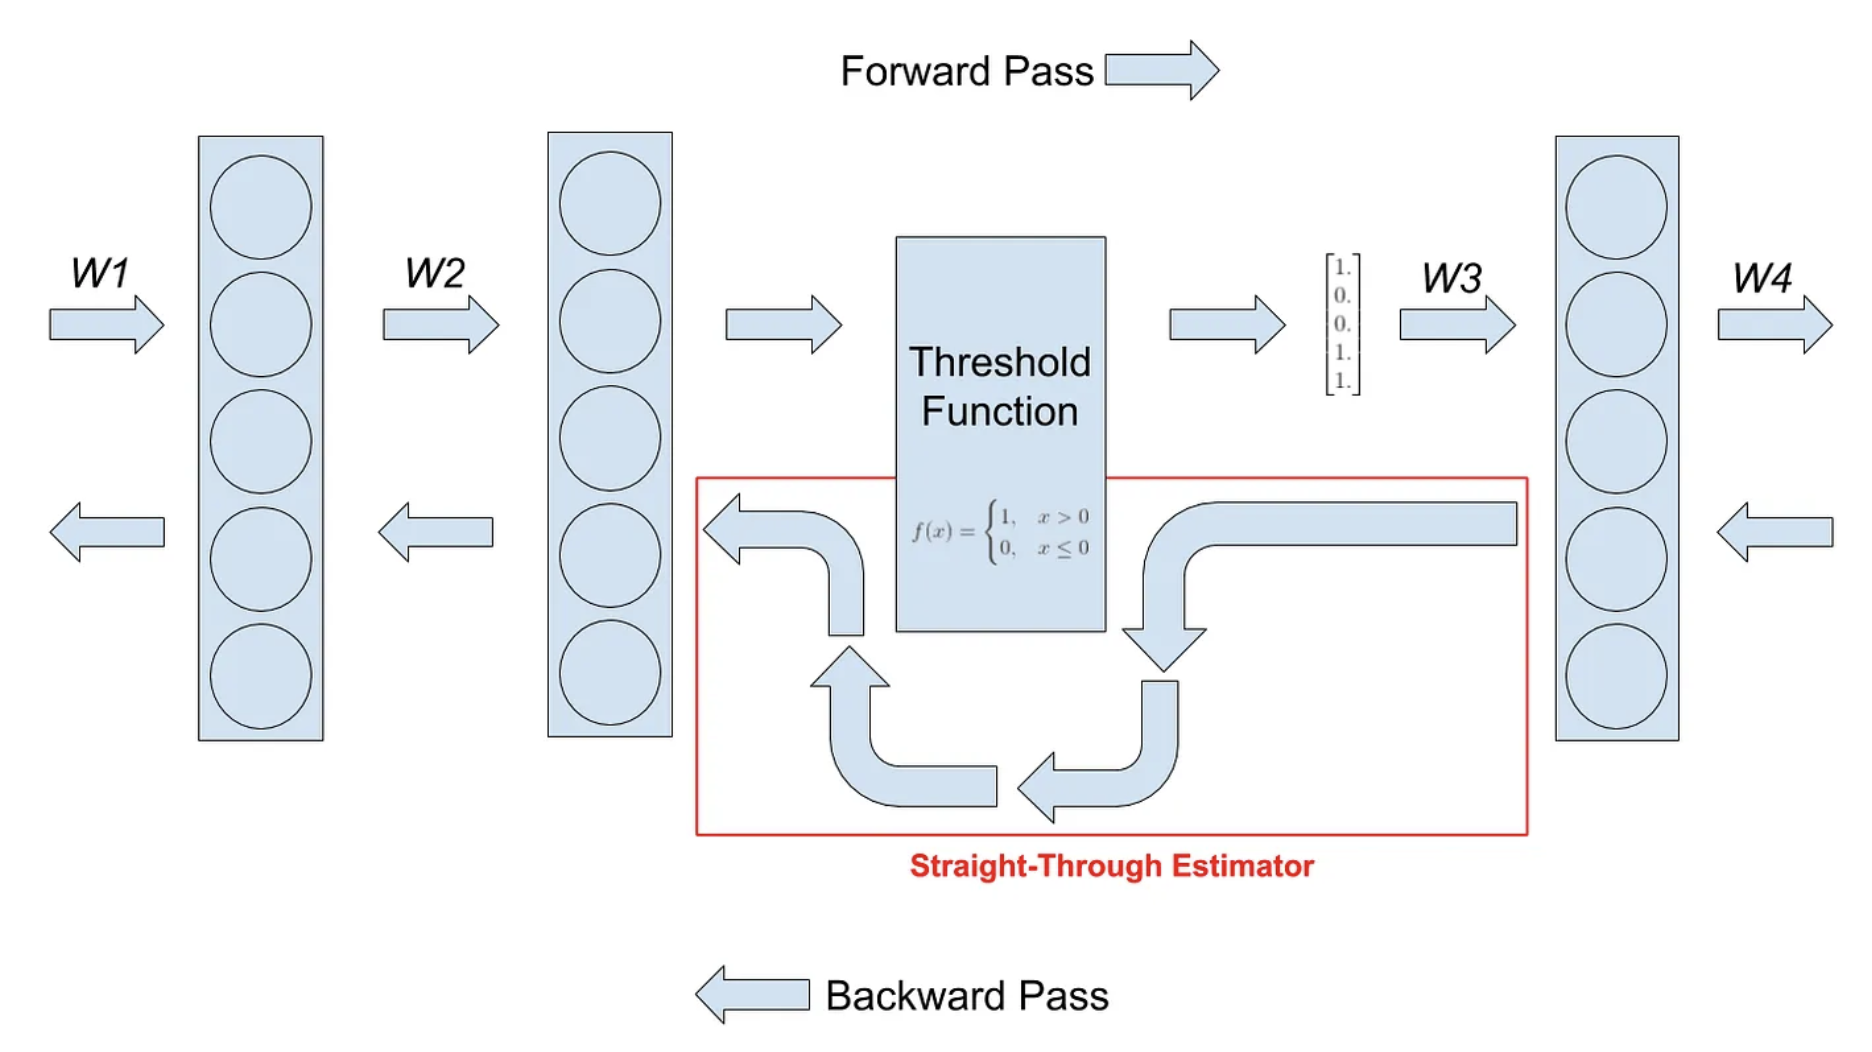
I-ViT Integer-only Quantization for Efficient Vision Transformer ...

Robustness-Enhanced Data-Free Quantization for Vision Transformer ...

(PDF) Q-HyViT: Post-Training Quantization for Hybrid Vision Transformer ...
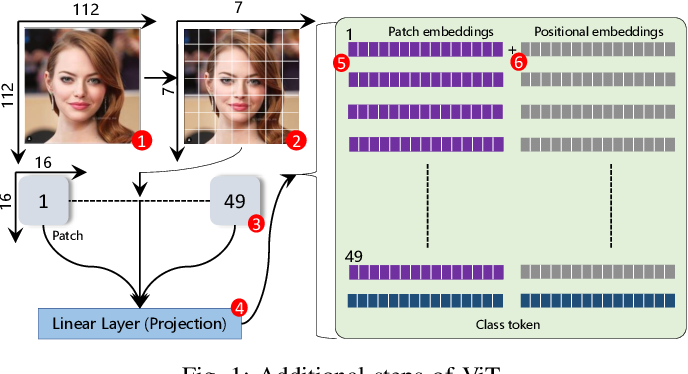
Figure 1 from Recent Advances in Vision Transformer: A Survey and ...