
Figure 1 From Improved Knowledge Distillation For Pre Trained Language

Figure 1 from Improved Knowledge Distillation for Pre-trained Language ...
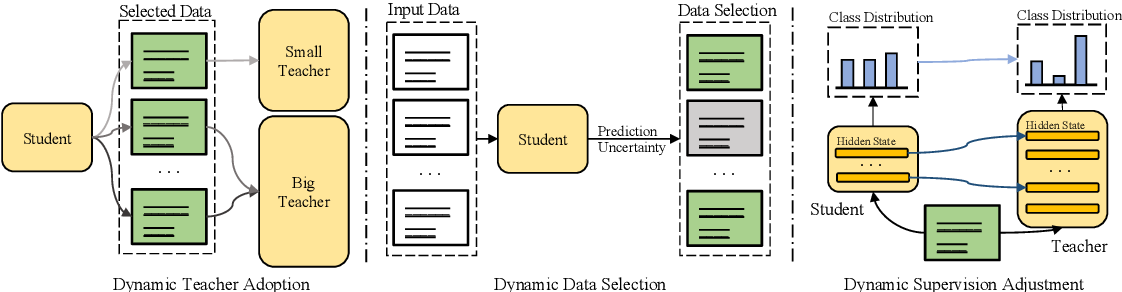
Figure 1 from Dynamic Knowledge Distillation for Pre-trained Language ...
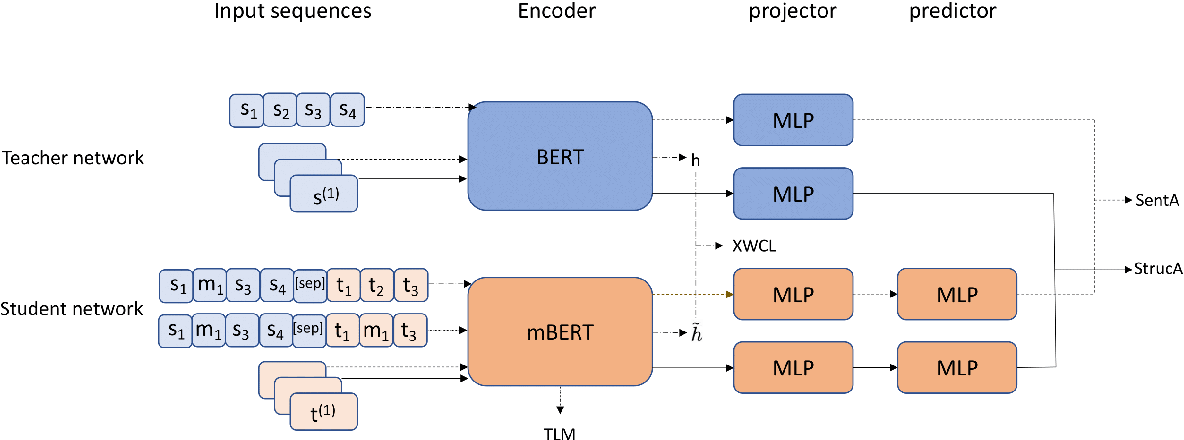
Figure 1 from Multi-level Distillation of Semantic Knowledge for Pre ...
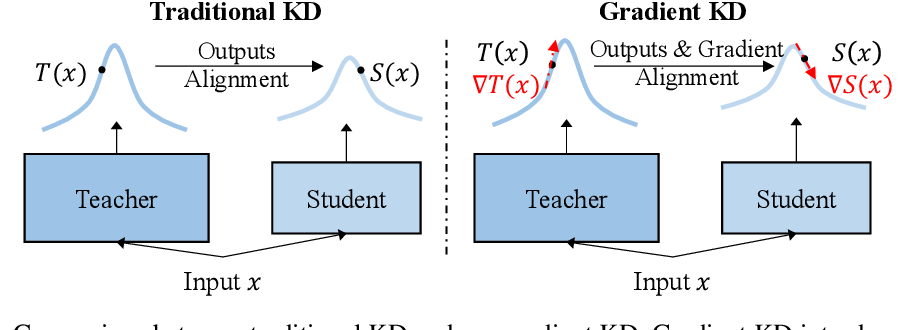
Figure 1 from Gradient Knowledge Distillation for Pre-trained Language ...
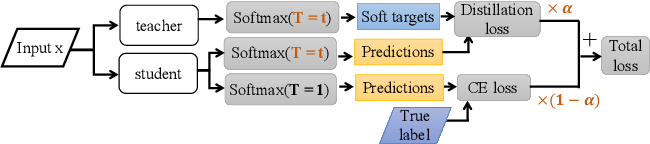
Figure 1 from Practical Insights into Knowledge Distillation for Pre ...

Figure 1 from Survey on Knowledge Distillation for Large Language ...

Figure 1 from Ensemble Knowledge Distillation for Learning Improved and ...

Figure 1 from A Study on Knowledge Distillation from Weak Teacher for ...

Figure 1 from Knowledge Distillation Framework of Pre-Trained Language ...

Figure 1 from Domain Knowledge Transferring for Pre-trained Language ...
Advertisement Space (300x250)
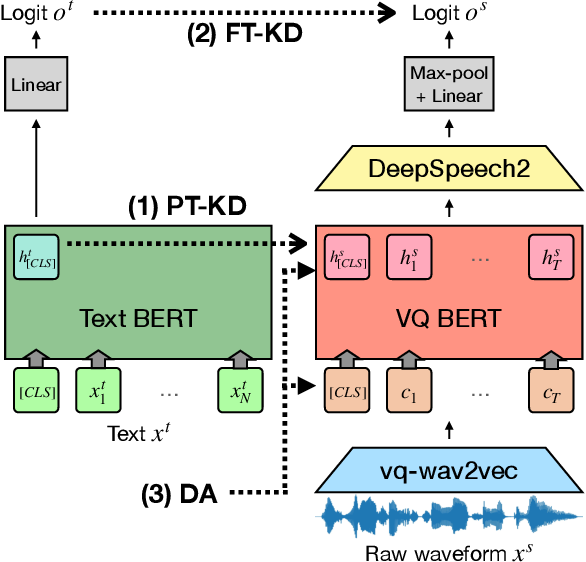
Figure 1 from Two-Stage Textual Knowledge Distillation for End-to-End ...

Figure 1 from Commonsense Knowledge Transfer for Pre-trained Language ...
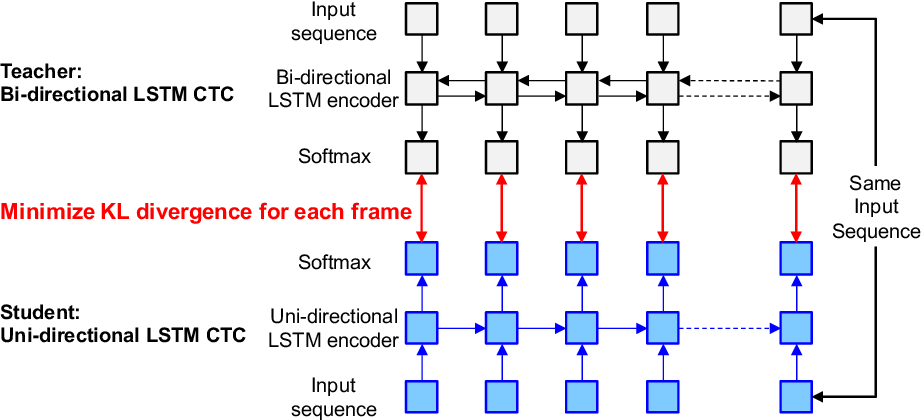
Figure 1 from Improved Knowledge Distillation from Bi-Directional to ...

Figure 1 from Improved Knowledge Distillation via Adversarial ...
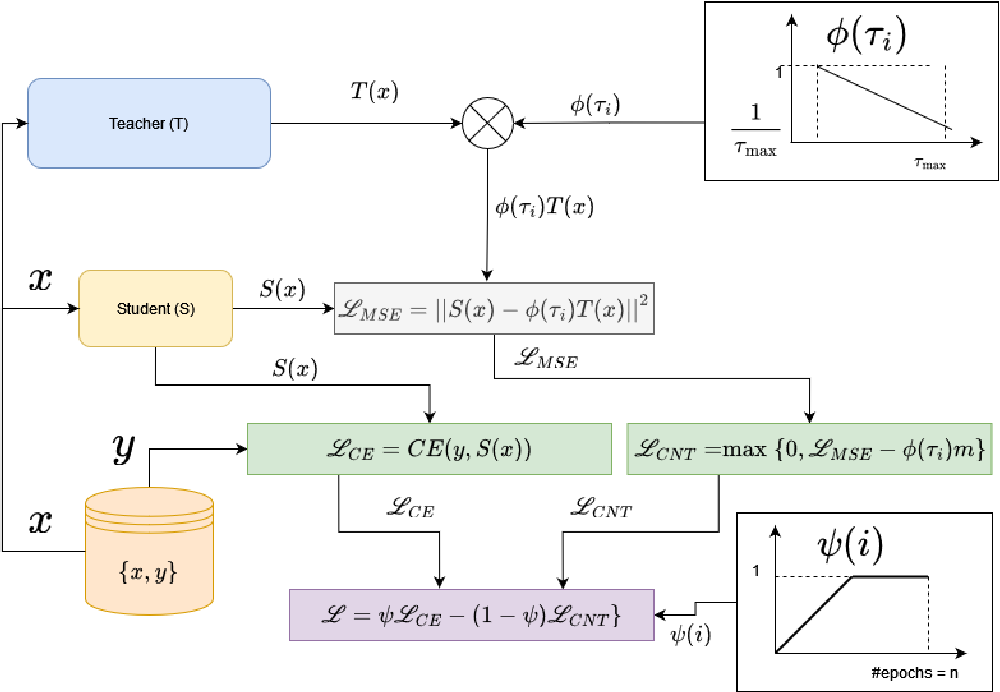
Figure 1 from Continuation KD: Improved Knowledge Distillation through ...

Figure 1 from Knowledge Base Grounded Pre-trained Language Models via ...

Figure 1 from Distilling Knowledge from Pre-trained Language Models via ...

(PDF) Improved Knowledge Distillation for Pre-trained Language Models ...

Improved Knowledge Distillation for Pre-trained Language Models via ...

Improved Knowledge Distillation for Pre-trained Language Models via ...
Advertisement Space (336x280)
Improved Knowledge Distillation for Pre-trained Language Models via ...

Improved Knowledge Distillation for Pre-trained Language Models via ...
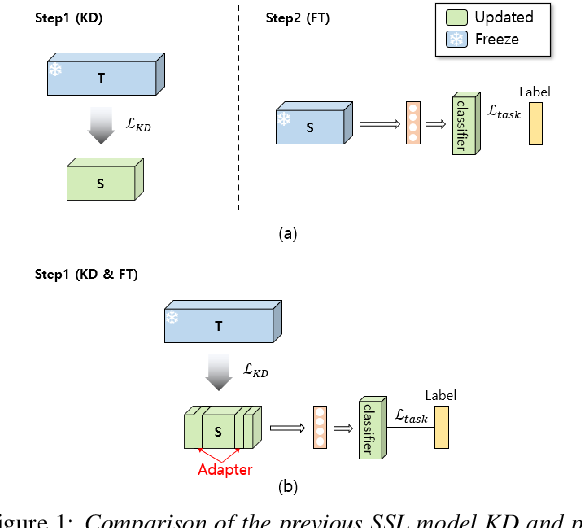
Figure 1 from One-Step Knowledge Distillation and Fine-Tuning in Using ...

Figure 1 from Knowledge-Augmented Reasoning Distillation for Small ...

Figure 2 from Domain Knowledge Transferring for Pre-trained Language ...
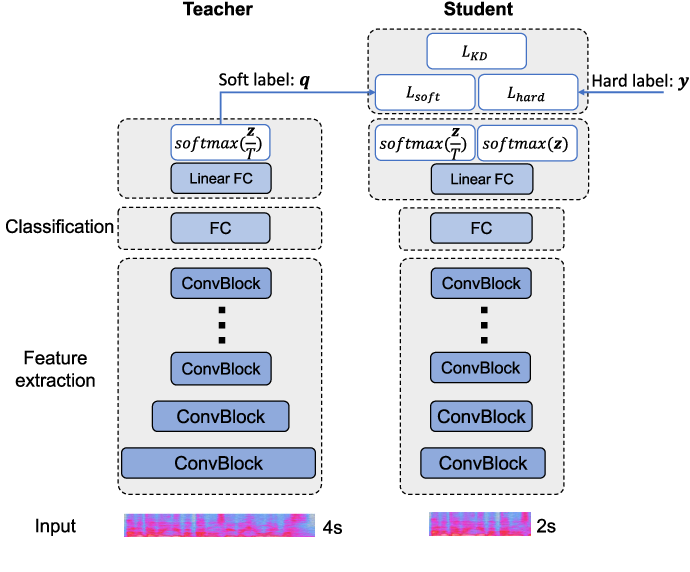
Figure 1 from Knowledge Distillation-Based Representation Learning for ...

Figure 1 from One Teacher is Enough? Pre-trained Language Model ...

Figure 1 from K-AID: Enhancing Pre-trained Language Models with Domain ...
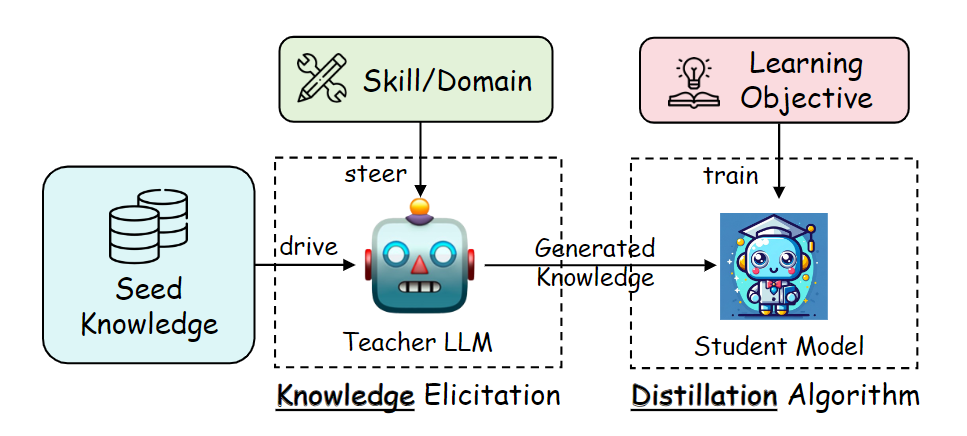
Knowledge Distillation for Large Language Models: A Deep Dive - Zilliz ...
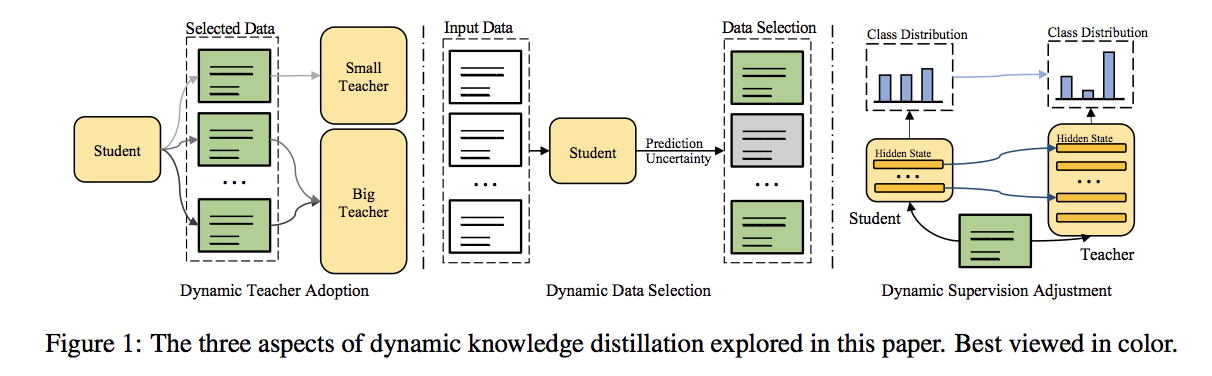
【简读】Dynamic Knowledge Distillation for Pre-trained Language Models - 知乎
Advertisement Space (336x280)
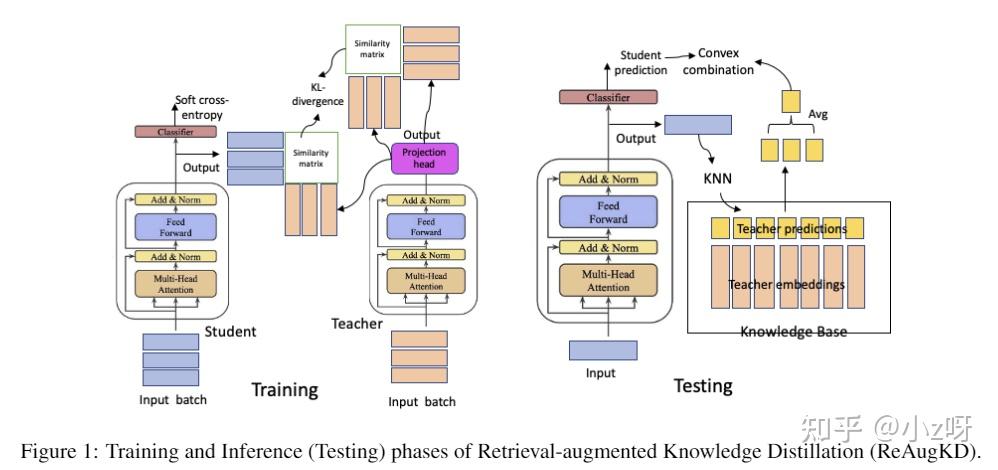
【43论文泛读】ReAugKD: Retrieval-Augmented Knowledge Distillation For Pre ...

(PDF) MiniPLM: Knowledge Distillation for Pre-Training Language Models

(PDF) Gradient Knowledge Distillation for Pre-trained Language Models

MLKD-BERT: Multi-level Knowledge Distillation for Pre-trained Language ...

GKD: A General Knowledge Distillation Framework for Large-scale Pre ...

(PDF) Dynamic Knowledge Distillation for Pre-trained Language Models